





State sviluppando una schermata di gestione documentale. L'obiettivo sembra semplice: proporre una categoria per ogni documento, per facilitarne la classificazione. Iniziate con alcune condizioni: un titolo contiene « brouillon », un paragrafo chiede una revisione, un'altra frase annuncia un'approvazione.
Poi arriva il documento fittizio V-033. Il suo titolo contiene « validé », ma il corpo indica « pour relecture ». A quale regola bisogna credere? Dare sistematicamente priorità al titolo non risolve il problema: un titolo può contenere anche una negazione o un'indicazione ormai superata.
È il punto di partenza della supervisione debole: usare indizi imperfetti per costruire dati di apprendimento, senza trattarli come risposte certe. Qui scriveremo delle regole, impareremo a combinarne i pareri, quindi addestreremo un classificatore testuale a partire dal risultato.
Il programma propone classi per documenti fittizi. Non modifica alcuno stato amministrativo e non deduce un'approvazione reale da un titolo. La nostra domanda sarà più modesta, ma misurabile: questa catena apprende qualcosa di utile, oppure fa peggio di un metodo più semplice?
Scaricare il progetto completo del tutorial
Cosa costruirete
Il percorso segue documento → voti delle regole → probabilità delle classi → classificatore testuale → proposta.
Una classe è semplicemente una categoria da prevedere. Una regola può proporne una, oppure non esprimersi. Il primo modello riceve questi voti e stima una distribuzione di probabilità fra le tre classi. Per esempio, può attribuire maggiore probabilità a EN_REVUE pur mantenendo un'incertezza rispetto a ANNONCE_APPROUVE.
Un secondo modello, il classificatore testuale, apprende poi dal testo dei documenti e da queste distribuzioni. I due modelli hanno quindi ingressi diversi: il primo combina i pareri delle regole; il secondo impara a classificare il testo. Questo tutorial non usa un grande modello linguistico incaricato di redigere una risposta.
Perché non fermarsi alle regole? Perché vogliamo verificare se la loro combinazione possa fornire al classificatore un segnale di apprendimento utile. È una possibilità da valutare, non un vantaggio acquisito. Il principio generale è presentato in questa introduzione alla supervisione debole del gruppo di ricerca di Stanford. Il progetto nello ZIP ne espone un meccanismo limitato, di cui possiamo seguire i calcoli.
Confronteremo quattro metodi: il voto di maggioranza, il modello che combina i voti, un classificatore addestrato su alcune annotazioni affidabili e il classificatore che usa la supervisione debole. Lungo il percorso spiegheremo l'astensione, le variabili latenti e l'algoritmo EM, senza presumere che li conosciate già.
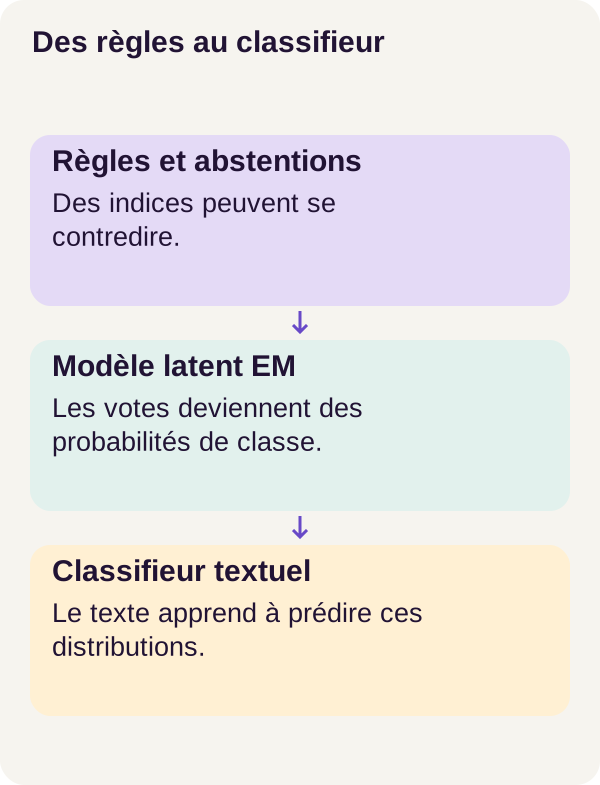
Una regola costituisce un indizio imperfetto, non un'annotazione affidabile.
Preparare un ambiente CPU riproducibile
Dovete saper leggere Python, usare un terminale e avviare Docker. Qui una tabella numerica è un insieme di numeri organizzati in righe e colonne; preciseremo cosa rappresentano le sue dimensioni a ogni passaggio.
Questo progetto è validato su CPU, cioè sul processore della macchina. Non è necessaria alcuna GPU NVIDIA. Il README consiglia 12 Gio di RAM e 6 Gio di spazio di lavoro su disco, a cui si aggiunge lo spazio di archiviazione Docker. Sono indicazioni per la preparazione, non misure di consumo garantite.
Decomprimete lo ZIP e aprite un terminale nella sua cartella radice, quella che contiene README.md. Tutti i comandi che seguono partono da questa directory. Verificate l'ambiente, preparate le cartelle, quindi costruite i servizi.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference
Il primo script esegue i controlli preliminari. Il secondo prepara le directory. docker compose config --quiet verifica la configurazione Compose; build costruisce gli ambienti necessari per il percorso. Correggete un errore bloccante prima di passare alla fase successiva.
I servizi separano i ruoli: tutorial prepara i dati e le valutazioni; learning riceve gli input di apprendimento e le annotazioni autorizzate; inference produce le previsioni senza consultare le risposte attese. assets/ conserva gli stati appresi e outputs/ i risultati. Il file Compose dello ZIP dettaglia i montaggi e le restrizioni.
Il modello viene inizializzato localmente: non scaricheremo i pesi di un modello preaddestrato. Qui la fase acquisition verifica un registro vuoto e non scarica pesi di terze parti. Rimane nel percorso, prima del controllo dell'ambiente containerizzato e dei test.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Il percorso di riferimento riporta 24 test superati. Verificano comportamenti del programma e il rifiuto di casi non validi. Non confondeteli con una misura della qualità documentale: test superati non significano che tutte le proposte di classe siano corrette.
Leggere i dati e le annotazioni
Le tre classi del progetto sono BROUILLON, EN_REVUE e ANNONCE_APPROUVE. L'ultima designa un annuncio in un documento fittizio, non una convalida legale. I testi possono contenere negazioni, indicazioni superate o titoli fuorvianti.
Il codice rappresenta le classi con numeri interi. Ecco il piccolo dizionario da tenere a mente:
| Valore | Significato |
|---|---|
0 |
BROUILLON |
1 |
EN_REVUE |
2 |
ANNONCE_APPROUVE |
-1 |
Astensione: nessuna classe proposta. |
-1 non è una quarta categoria di documento. È un'informazione sul comportamento di una regola o di un metodo: non si esprime.
Un'annotazione, chiamata anche label o etichetta, indica la classe di riferimento di un esempio. Il corpus comprende insiemi separati per apprendimento, validazione e test. L'apprendimento serve ad aggiustare i parametri; la validazione permette di esaminare il comportamento durante lo sviluppo; il test serve a misurare il risultato finale su documenti separati.
Il test contiene 360 documenti, con 120 riferimenti per ogni classe. Disponiamo inoltre di 90 ancore: esempi di apprendimento la cui classe è nota. La parola « ancora » descrive il loro ruolo: forniscono punti di riferimento affidabili al modello intermedio. Servono anche ad addestrare un piccolo classificatore di confronto, senza supervisione debole.
Non siamo quindi in un apprendimento privo di qualunque annotazione. La domanda è sapere cosa apportino le regole in aggiunta a questi esempi affidabili.
Creiamo i dati.
docker compose run --rm tutorial python -m ged_supervision_faible_statuts.cli prepare --config configs/minimum.yaml
Osservate la separazione fra testi e annotazioni. Il programma può leggere il titolo, il corpo e i metadati autorizzati di un documento. Non deve leggere la sua risposta di test per fabbricare una previsione. Le 90 ancore sono una parte esplicitamente autorizzata della supervisione; i riferimenti del test restano riservati alla valutazione.
Costruire regole che possono astenersi
Una regola produce un parere, non una certezza
Una funzione di etichettatura è una funzione Python che cerca un indizio e restituisce una classe, oppure -1 quando non ha alcun parere. Per uno sviluppatore web, pensate alla distinzione fra un valore assente e un valore uguale a zero: qui « non so » non deve mai diventare BROUILLON per impostazione predefinita.
Il progetto comprende otto regole. Alcune esaminano il titolo, altre il corpo; un'altra usa una data di esportazione. Quest'ultima codifica deliberatamente una fragile correlazione fittizia: un'esportazione tardiva non prova un'approvazione.
Ecco la funzione centrale. Gli estratti dell'articolo vanno letti con le costanti e le funzioni ausiliarie dello ZIP; i comandi eseguono il progetto completo.
def apply_label_functions(document):
    title = normalize(document["title"])
    body = normalize(document["text"])
    date = document.get("export_date")
    # Deliberately imperfect: title rule ignores negation, body approval excludes quoted and negated mentions.
    tests = [
        ("valide" in title, 2, "validé dans le titre"),
        ("provisoire" in title or "brouillon" in title, 0, "titre provisoire"),
        ("relecture" in title, 1, "titre relecture"),
        (
            "pour relecture" in body and "pas pour relecture" not in body,
            1,
            "corps pour relecture",
        ),
        ("version de travail" in body, 0, "corps version de travail"),
        (
            "annonce une approbation obtenue" in body
            and "aucune signature" not in body,
            2,
            "annonce positive et absence de négation détectée",
        ),
        (
            bool(date and date >= "2026-08-26"),
            2,
            "export tardif : corrélation fictive, pas approbation",
        ),
        ("commentaires attendus" in body, 1, "commentaires attendus"),
    ]
    return [
        {
            "rule": name,
            "vote": k if active else ABSTAIN,
            "reason": reason if active else "aucun motif reconnu",
        }
        for name, (active, k, reason) in zip(RULES, tests)
    ]
normalize() uniforma maiuscole, minuscole e accenti prima della ricerca. Questo facilita il confronto di stringhe, ma non dà alla regola una comprensione della frase.
Ogni elemento di tests contiene tre informazioni: una condizione, il numero della classe proposta se è vera e una giustificazione testuale. zip(RULES, tests) associa questi elementi ai nomi delle regole. Il risultato conserva rule, vote e reason, permettendo di ritrovare l'origine di un parere.
Osservate la prima condizione: cerca semplicemente valide nel titolo normalizzato. Ignora deliberatamente la negazione. Come controesempio pedagogico, anche un titolo « Non validé » contiene questa stringa dopo la normalizzazione. La regola può quindi votare nel senso sbagliato pur eseguendo esattamente il codice previsto.
Le condizioni sul corpo sono un po' più selettive: una esclude la formulazione pas pour relecture, un'altra verifica l'assenza di aucune signature. Sono test precisi su stringhe, non un analizzatore generale di negazioni o citazioni. Il commento dell'estratto va letto entro questo perimetro ristretto.
Infine, la data 2026-08-26 è la soglia fissata nella regola di esportazione del corpus fittizio. Non è né una data da sostituire con quella odierna, né una regola di business da trasporre tale e quale.
Per V-033, il titolo e il corpo ci forniscono dunque indizi contraddittori. Li conserveremo invece di nascondere il conflitto con un ordine arbitrario di condizioni.
Iniziare con una maggioranza semplice
Prima di imparare a combinare le regole, calcoliamo un riferimento senza apprendimento, o baseline: contare i voti.
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli baseline --config configs/minimum.yaml
outputs/rules.json descrive i conflitti e le astensioni. La maggioranza restituisce un parere vuoto se nessuna regola vota o se più classi arrivano a pari merito. Non sceglie la prima classe soltanto per produrre una risposta.
La tabella votes ha una riga per documento e una colonna per regola, dunque otto colonne nel percorso principale. La funzione seguente trasforma questa tabella in proporzioni di voti e decisioni.
def majority_vote(votes):
    counts = np.stack([(votes == k).sum(1) for k in range(3)], axis=1)
    total = counts.sum(1)
    probabilities = np.divide(
        counts,
        total[:, None],
        out=np.full(counts.shape, 1 / 3, dtype=np.float64),
        where=total[:, None] > 0,
    )
    tied = (counts == counts.max(1, keepdims=True)).sum(1) > 1
    predicted = np.where((total == 0) | tied, -1, counts.argmax(1))
    return probabilities, predicted
Per ogni classe k, (votes == k).sum(1) conta i pareri corrispondenti per ciascun documento. np.stack(..., axis=1) riunisce questi conteggi in tre colonne, nell'ordine BROUILLON, EN_REVUE, ANNONCE_APPROUVE. total conta soltanto i voti espressi: i -1 non vengono aggiunti ad alcuna classe.
total[:, None] dà al totale una forma a colonna, per dividere i tre conteggi di una riga per lo stesso numero. Il parametro where evita una divisione per zero. Quando nessuna regola parla, out fornisce una distribuzione uniforme: un terzo per ogni classe.
Ma una distribuzione non è ancora una decisione. tied individua le parità, e np.where impone una previsione -1 quando il totale è nullo oppure quando più classi prevalgono.
Prendiamo tre piccoli esempi pedagogici, limitati a tre regole per leggere facilmente i calcoli. Non sono gli output completi di V-033.
Con i voti [1, 1, 2], i conteggi sono [0, 2, 1]. La distribuzione vale [0 ; 2/3 ; 1/3] e la decisione è 1, quindi EN_REVUE.
Con [2, 1, -1], i conteggi sono [0, 1, 1]. La distribuzione vale [0 ; 0,5 ; 0,5], ma la decisione resta -1: c'è parità.
Con [-1, -1, -1], la distribuzione vale [1/3 ; 1/3 ; 1/3] e anche la decisione è -1. Questa volta nessuno ha votato.
Gli ultimi due casi portano alla stessa astensione, ma non per la stessa ragione. Conservare voti e probabilità permette di comprendere questa differenza.
Stimare una classe nascosta con EM
Il problema: conoscere le classi per valutare le regole… e viceversa
Il voto di maggioranza attribuisce lo stesso peso a tutti i pareri. Vorremmo andare oltre: una regola sbaglia spesso su una classe? Confondere una bozza con un documento in revisione? Il suo parere apporta qualcosa quando altre regole la contraddicono?
La difficoltà è circolare. Per conoscere gli errori delle regole, bisognerebbe conoscere le classi dei documenti. Per stimare queste classi, vogliamo proprio usare le regole.
Una variabile latente è un'informazione non osservata direttamente. Qui è la classe di riferimento di un documento quando non fa parte delle ancore. Il modello manterrà ipotesi probabilistiche su questa classe, invece di decidere subito che valga 0, 1 o 2.
Tre tabelle da comprendere
pi contiene le proporzioni stimate delle classi. Per esempio, [0,2 ; 0,5 ; 0,3] significa che, senza un nuovo indizio, il modello distribuisce le sue probabilità al 20%, 50% e 30%. Questi valori appartengono all'esempio numerico fornito più avanti; non sono le proporzioni apprese del corpus annunciate in anticipo.
theta descrive il comportamento di ogni regola. Le sue dimensioni seguono l'ordine regola, classe latente, voto osservato. Con otto regole e tre classi, la sua forma è (8, 3, 3). Una cella theta[j, k, c] rappresenta la probabilità attribuita al voto c della regola j quando la classe supposta è k. Una cella fuori diagonale rappresenta dunque una possibile confusione, non necessariamente un errore di programmazione.
q contiene una distribuzione per documento. Con N documenti, la sua forma è (N, 3). Una riga indica quanto ogni classe sia plausibile secondo i parametri attuali. Nel vocabolario di EM, questi valori sono chiamati anche responsabilità: durante l'aggiornamento faranno contribuire parzialmente il documento a più classi.
Qui theta non comporta una colonna per -1. Le astensioni sono ignorate nel calcolo dei voti; la loro frequenza non è modellata come una quarta uscita.
Alternare stima e aggiornamento
EM significa Expectation-Maximization. L'algoritmo alterna due operazioni: il passaggio E stima q con i parametri correnti; il passaggio M ricalcola pi e theta con queste distribuzioni. Le ancore mantengono la loro classe nota durante questo processo.
In altri termini: « Con ciò che so delle regole, quali classi sono plausibili? Poi, con queste classi plausibili, come devo stimare di nuovo il comportamento delle regole? »
Il modello fa una semplificazione importante: suppone che i voti siano indipendenti quando la classe reale è nota. Questo permette di moltiplicarne i contributi. Ma due regole copiate non costituiscono due osservazioni indipendenti: seguono esattamente lo stesso indizio. Verificheremo questo limite nell'esercizio.
Sommare gli indizi senza perdere le piccole probabilità
Il calcolo inizia nei logaritmi. Il logaritmo trasforma un prodotto in una somma: invece di moltiplicare più probabilità, il programma somma i loro logaritmi.
def log_joint(votes, pi, theta):
    result = np.broadcast_to(np.log(pi), (len(votes), 3)).copy()
    for j in range(votes.shape[1]):
        rows = np.flatnonzero(votes[:, j] >= 0)
        for k in range(3):
            result[rows, k] += np.log(theta[j, k, votes[rows, j]])
    return result
np.broadcast_to(...).copy() prepara una riga di tre punteggi per documento, inizializzata con log(pi). Il ciclo percorre poi le regole. np.flatnonzero(votes[:, j] >= 0) seleziona soltanto i documenti per i quali la regola j ha espresso un parere.
Per ogni classe possibile k, il programma aggiunge il contributo del voto effettivamente osservato. Non conta quindi più soltanto « quante regole hanno scelto questa classe? »; chiede « questi voti sono plausibili se questa classe è quella corretta? ».
A questo punto, i punteggi non formano ancora una distribuzione normalizzata. Questo è il ruolo del passaggio E.
def e_step(votes, pi, theta, anchors):
    validate_inputs(votes, pi, theta, anchors)
    joint = log_joint(votes, pi, theta)
    q = np.exp(joint - logsumexp(joint)[:, None])
    for i, k in anchors.items():
        q[i] = np.eye(3)[k]
    return q
La riga che costruisce q riporta i tre punteggi di un documento nella forma di probabilità la cui somma è uno. logsumexp serve a effettuare questa normalizzazione in modo stabile, anche con probabilità molto piccole.
La normalizzazione deve essere eseguita documento per documento. L'espressione logsumexp(joint)[:, None] attende qui un normalizzatore per riga, da sottrarre ai tre punteggi corrispondenti. Conservate la funzione ausiliaria del progetto: una funzione di libreria con lo stesso nome può richiedere un asse esplicito. La documentazione SciPy di logsumexp spiega questo calcolo e il ruolo di tale asse; non è un'istruzione per sostituire il codice.
Infine, np.eye(3)[k] costruisce un target certo per un'ancora. Se la sua classe nota è 1, la sua riga diventa [0, 1, 0]. Le regole non possono sostituirla con la propria ipotesi.
Per un documento senza voto e senza ancora, non è stato aggiunto alcun nuovo indizio: q resta uguale a pi. Se si tratta di un'ancora, la sua classe nota prevale, anche senza voto.
Contare contributi parziali con il passaggio M
Passiamo ora da queste ipotesi ai nuovi parametri.
def m_step_map(votes, q, alpha=1.1):
    if (
        alpha <= 1
        or q.shape != (len(votes), 3)
        or (q < 0).any()
        or not np.isfinite(q).all()
        or not np.allclose(q.sum(1), 1)
    ):
        raise ValueError("Invalid responsibilities or Dirichlet prior")
    pi = q.sum(0) + alpha - 1
    pi /= pi.sum()
    theta = np.full((votes.shape[1], 3, 3), alpha - 1, dtype=np.float64)
    for j in range(votes.shape[1]):
        for c in range(3):
            theta[j, :, c] += q[votes[:, j] == c].sum(0)
    theta /= theta.sum(2, keepdims=True)
    return pi, theta
I controlli iniziali richiedono una distribuzione valida per documento: tre componenti, nessun valore negativo o non finito e una somma prossima a uno. Un valore « non finito » designa in particolare un infinito o NaN, il risultato numerico di un calcolo indefinito.
q.sum(0) somma i contributi di tutti i documenti a ogni classe. Un documento la cui distribuzione è [0,1 ; 0,7 ; 0,2] contribuisce quindi per 0,1 alla prima classe, 0,7 alla seconda e 0,2 alla terza. È un conteggio ponderato, non una conversione prematura in un'etichetta certa.
Per theta, q[votes[:, j] == c].sum(0) conserva soltanto i documenti sui quali la regola j ha votato c. I loro contributi vengono aggiunti alla colonna di quel voto, poi ogni distribuzione viene normalizzata sui tre voti possibili.
Il parametro alpha=1.1 fornisce un piccolo prior di Dirichlet. In concreto, questo codice aggiunge alpha - 1, cioè 0,1, ai conteggi prima della normalizzazione. Evita una probabilità esattamente nulla solo perché una combinazione non ha ricevuto alcun contributo. Il suffisso map indica la stima maximum a posteriori: le osservazioni sono combinate con questo prior.
Questo livellamento evita alcuni blocchi numerici; non crea nuove conoscenze sui documenti. Le ipotesi del modello e la qualità delle regole continuano a limitare il risultato.
Osservare il piccolo esempio prima dell'apprendimento completo
Eseguiamo innanzitutto il calcolo illustrativo fornito.
docker compose run --rm tutorial python -m ged_supervision_faible_statuts.cli inspect-mechanism --config configs/minimum.yaml
In outputs/mechanism.json, la matrice illustrativa non è il risultato addestrato del corpus. Per i voti [2, 1, -1], la distribuzione ottenuta vale circa [0,0403 ; 0,5369 ; 0,4228]. La sua somma vale uno, salvo arrotondamento. Per la riga senza voto, resta [0,2 ; 0,5 ; 0,3].
Confrontate con la maggioranza: gli stessi due pareri contraddittori le davano una parità. Qui le proporzioni delle classi e i parametri delle regole producono un'altra distribuzione. Non c'è stato alcun nuovo voto: è cambiato il modo di interpretare i voti. Questi numeri non indicano da soli che l'interpretazione sia corretta.
Ora adattiamo EM ai dati di apprendimento, con un'interruzione, un riferimento continuo, poi una ripresa e il suo controllo.
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli fit-em --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli fit-em --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli fit-em --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli verify-em --config configs/minimum.yaml
interrupt interrompe il calcolo previsto per il test di ripresa; continuous fornisce il percorso di riferimento; resume riprende lo stato salvato. verify-em confronta i percorsi interessati.
Un checkpoint è uno stato registrato che permette di ritrovare un calcolo. Riprendere non consiste nel ricominciare con parametri qualsiasi: bisogna ritrovare lo stato e l'avanzamento previsti. Esaminate le distribuzioni ottenute e il controllo di ripresa prima di passare al classificatore.
Addestrare il classificatore su target morbidi
Non trasformare un'incertezza in una certezza
Un target è il risultato che si chiede al modello di apprendere. Un target classico indica una classe unica. Un target morbido conserva invece una distribuzione fra le classi.
Prendiamo la distribuzione pedagogica [0,04 ; 0,54 ; 0,42], vicina all'esempio precedente. Sostituirla con [0, 1, 0] farebbe sparire l'incertezza fra EN_REVUE e ANNONCE_APPROUVE. Con il target morbido, il classificatore riceve anche questa incertezza stimata. Ciò non rende il target più vero, ma evita di presentarlo come una certezza che non possiede.
Trasformare il testo in numeri con TF-IDF
Il classificatore riceve una rappresentazione TF-IDF del titolo e del corpo, non direttamente la tabella degli otto voti. Un vettore è una sequenza di numeri; qui le sue coordinate descrivono i termini selezionati nel testo.
TF, per term frequency, riflette la frequenza di un termine nel documento. IDF, per inverse document frequency, tiene conto della sua rarità nei documenti di apprendimento. La loro combinazione pondera i termini, poi il progetto normalizza il vettore.
Per intuizione, immaginate che quasi tutti i documenti contengano la parola « document », ma solo alcuni contengano « relecture ». Il secondo termine può fornire un indizio più distintivo. Ciò non significa che un termine raro riveli automaticamente la classe corretta: il suo valore dipende dai dati e dall'apprendimento. La documentazione scikit-learn su TF-IDF approfondisce questa rappresentazione; le scelte esatte del percorso restano quelle dello ZIP.
Abbiamo quindi due oggetti da non confondere: il vettore di testo, che serve da input, e la distribuzione sulle tre classi, che serve da target. Il numero di caratteristiche del testo non è il numero di classi da prevedere.
Comprendere la funzione di perdita
Il progetto usa un MLP, o perceptron multistrato: una rete di strati lineari separati da attivazioni. Gli strati combinano i valori di input con parametri appresi; le attivazioni permettono di non limitarsi a una semplice trasformazione lineare.
La rete produce tre logit, cioè tre punteggi grezzi. Non sono ancora probabilità e non devono avere somma uguale a uno. Durante l'addestramento, una funzione di perdita misura lo scarto dal target. L'apprendimento aggiusta i parametri per ridurre questa perdita; i gradienti indicano come una variazione dei parametri influenzi il calcolo.
Ecco la perdita usata con i target morbidi.
def soft_cross_entropy(logits, targets):
    if (
        logits.shape != targets.shape
        or logits.ndim != 2
        or not torch.isfinite(targets).all()
        or (targets < 0).any()
        or not torch.allclose(
            targets.sum(1), torch.ones(len(targets), dtype=targets.dtype)
        )
    ):
        raise ValueError("Expected a distribution per example")
    return -(targets * F.log_softmax(logits, dim=-1)).sum(1).mean()
logits e targets devono avere la stessa forma: una riga per esempio del lotto e tre colonne. Il lotto, o batch, è il gruppo di documenti trattato insieme. I controlli verificano in particolare che i target siano finiti, positivi o nulli e normalizzati.
F.log_softmax(logits, dim=-1) trasforma i punteggi in logaritmi di probabilità sulle classi. La moltiplicazione per targets pondera ogni contributo secondo il target. .sum(1) somma i contributi delle tre classi per ogni documento, poi .mean() calcola la media sul lotto. Il segno meno produce la perdita di entropia incrociata.
La documentazione PyTorch dell'entropia incrociata descrive anch'essa questo caso di target probabilistici. Ricorda che la loro validità deve essere controllata dal codice chiamante: numeri qualsiasi non diventano una distribuzione soltanto perché vengono passati a una funzione di perdita.
Apprendere con più target non aiuta necessariamente se sono poco informativi. Se le distribuzioni esitano quasi allo stesso modo fra le classi, la rete riceve un segnale molto diverso da quello di un'annotazione affidabile. Bisogna misurare ciò che ne fa, non supporre che il secondo modello corregga automaticamente il primo.
Addestrare e verificare la ripresa
Eseguite gli addestramenti interrotto, continuo e ripreso, quindi confrontate gli stati.
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli verify-resume --config configs/minimum.yaml
Il percorso controlla separatamente la ripresa di EM e quella del classificatore. Sono due calcoli distinti, con i propri stati appresi. I risultati di riferimento ne stabiliscono la riproducibilità in questo ambiente CPU; non garantiscono un'identità numerica dopo un cambiamento di dipendenze o ambiente.
Produciamo poi le due previsioni: il classificatore che usa soltanto le 90 ancore, quindi quello che usa la supervisione debole.
docker compose run --rm inference python -m ged_supervision_faible_statuts.cli predict --config configs/minimum.yaml --variant anchors
docker compose run --rm inference python -m ged_supervision_faible_statuts.cli predict --config configs/minimum.yaml --variant main
A questo punto facciamo inferenza: usiamo i parametri appresi per prevedere. Non è più la fase in cui aggiustiamo i parametri a partire dai target. Il servizio inference non vede le classi di riferimento.
I file predictions-anchors.json e predictions-main.json permettono di confrontare i metodi documento per documento. Ritrovate V-033 e chiedetevi: i due classificatori propongono la stessa classe? Quale incertezza esprimono le loro distribuzioni? Non deducete la risposta dalla sola parola « validé »: ispezionate gli output realmente prodotti.
Comprendere le metriche prima dei risultati
Una metrica è una misura scelta per valutare il programma. Qui vogliamo esaminare tre aspetti diversi: il metodo si esprime, classifica correttamente e attribuisce probabilità utili? Un solo numero non risponde a queste tre domande.
Copertura e accuracy: rispondere non significa riuscire
La copertura è la quota di documenti per i quali un metodo prende una decisione. Su dieci documenti, un metodo che ne classifica sette e si astiene su tre ha una copertura di 0,7, anche se le sue sette decisioni sono corrette.
L'accuracy, o accuratezza, conta le decisioni corrette. In questo progetto, il suo denominatore comprende i 360 documenti di test, astensioni incluse. Non si rimuovono dunque i documenti difficili per migliorare artificialmente il punteggio.
Una copertura di 1 significa « una decisione per ogni documento », non « tutte le decisioni sono corrette ». Al contrario, un metodo può fare buone proposte lasciando molti documenti senza risposta.
Precisione, richiamo e macro-F1: osservare le classi separatamente
Per una classe data, la precisione chiede: fra i documenti che ho collocato in questa classe, quanti vi appartengono davvero? Il richiamo chiede: fra i documenti che vi dovevano essere collocati, quanti ne ho ritrovati?
Prendiamo un esempio pedagogico: prevedete quattro documenti EN_REVUE, di cui tre corretti, mentre ne erano attesi cinque. La precisione vale 3/4, cioè 0,75; il richiamo vale 3/5, cioè 0,60. L'F1 combina i due con 2 × precisione × richiamo / (precisione + richiamo), cioè circa 0,6667 qui.
Il macro-F1 calcola l'F1 di ciascuna delle tre classi, poi ne fa la media. Ogni classe pesa allo stesso modo in questa media. Un'astensione su un documento atteso in una classe costituisce un riferimento mancato: ne diminuisce il richiamo.
Il macro-F1 non rappresenta quindi direttamente la percentuale di documenti ben classificati. Non verifica neppure se la fiducia mostrata dal metodo sia giustificata.
Brier e log-loss: valutare anche le probabilità
Il punteggio di Brier confronta l'intera distribuzione prevista con il vettore della classe di riferimento. Nella convenzione del progetto, si sommano i tre errori al quadrato, poi si fa la media sui documenti. Il suo intervallo è da 0 a 2, e un valore più basso è preferibile. La documentazione del Brier multiclasse presenta questa definizione; verificate sempre la convenzione usata prima di confrontare punteggi provenienti da progetti diversi.
Per un calcolo pedagogico, supponiamo che il riferimento sia EN_REVUE. Il suo vettore è [0, 1, 0]. Con la previsione [0,1 ; 0,7 ; 0,2], l'errore è:
(0,1 - 0)² + (0,7 - 1)² + (0,2 - 0)² = 0,14.
Una previsione esattamente uguale al riferimento dà zero. Una certezza totale collocata sulla classe sbagliata dà due.
La log-loss osserva la probabilità attribuita alla classe corretta, con il calcolo -log(probabilità corretta) per un documento. Se questa probabilità vale 0,9, la perdita è circa 0,1054; se vale 0,01, la perdita sale a circa 4,6052. Un errore molto sicuro viene quindi fortemente penalizzato. Il principio è dettagliato nella documentazione della log-loss.
Questi due punteggi valutano le probabilità, ma non sono intercambiabili. Non costituiscono neppure, da soli, una diagnosi completa della calibrazione, ossia dell'accordo fra la fiducia dichiarata e la frequenza dei successi. La documentazione sulla calibrazione spiega in particolare perché il Brier mescoli più aspetti della qualità predittiva.
Calcolare e interpretare i risultati
Avviamo la valutazione.
docker compose run --rm tutorial python -m ged_supervision_faible_statuts.cli evaluate --config configs/minimum.yaml
I valori seguenti sono arrotondati; riguardano i 360 documenti di test.
Su mobile, scorrete orizzontalmente la tabella.
| Metodo | Copertura | Macro-F1 | Brier | Log-loss |
|---|---|---|---|---|
| Voto di maggioranza | 0,7444 | 0,7721 | 0,2735 | 1,4439 |
| Modello latente EM | 1,0000 | 0,3789 | 0,6666 | 1,0985 |
| Classificatore su 90 ancore | 1,0000 | 0,7666 | 0,4260 | 0,7594 |
| Classificatore con supervisione debole | 1,0000 | 0,6118 | 0,6344 | 1,0511 |
La maggioranza ottiene il miglior macro-F1 della tabella, ma si astiene su 92 documenti. Prende dunque una decisione su 360 - 92 = 268 documenti, cioè una copertura di 268/360 ≈ 0,7444. Bisogna leggere insieme le due colonne.
Anche il suo Brier è il più basso, ma la sua log-loss è la più alta. Non è una contraddizione: le misure non penalizzano allo stesso modo le distribuzioni. Probabilità molto basse attribuite alla classe corretta possono in particolare pesare molto nella log-loss. Per spiegare con precisione gli errori del percorso, bisogna consultare gli output per documento; la tabella da sola non ne fornisce il dettaglio.
Il modello latente EM risponde ovunque, ma le sue distribuzioni restano vicine all'uniforme. Ecco un riferimento puramente matematico, non una nuova esperienza: una distribuzione [1/3 ; 1/3 ; 1/3] dà un Brier di 2/3 ≈ 0,6667 e una log-loss di log(3) ≈ 1,0986, qualunque sia la classe corretta. I valori osservati per EM, 0,6666 e 1,0985, sono molto vicini a questo riferimento. Scegliere la componente più alta non significa che il modello disponga di un indizio netto per decidere.
Qui il classificatore sulle 90 ancore fa meglio di quello che usa la supervisione debole. Entrambi coprono tutti i documenti, ma il primo ha un macro-F1 superiore e errori probabilistici inferiori. In questo corpus, passare dalle regole e dal modello latente non migliora quindi questo termine di confronto.
Questo risultato negativo è centrale. Non dimostra che ogni supervisione debole fallisca; mostra che questa combinazione di dati, regole e modelli non basta a ottenere un miglioramento. Un'architettura più elaborata deve essere confrontata con i risultati, anche quando contraddicono l'intuizione iniziale.
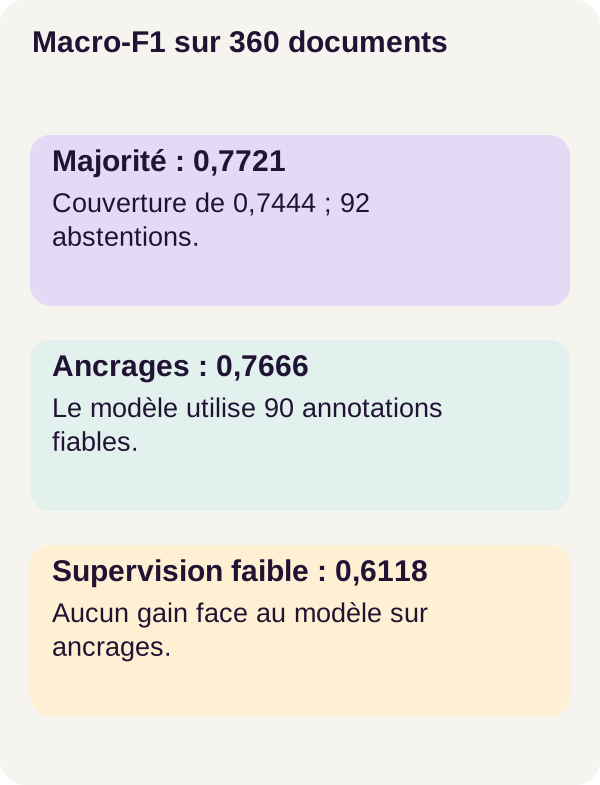
I metodi non hanno la stessa copertura: la maggioranza si astiene su 92 documenti.
Cosa abbiamo imparato
Una regola fornisce un parere parziale. Può essere corretta, sbagliare o non esprimersi. L'astensione non deve diventare una classe di business predefinita, e un conflitto non deve essere nascosto per produrre una risposta a ogni costo.
EM stima una classe nascosta basandosi su ipotesi riguardo ai voti. Le ancore gli forniscono riferimenti affidabili, ma distribuzioni poco informative restano un segnale di apprendimento limitato per il classificatore successivo.
Infine, copertura, macro-F1 ed errori probabilistici raccontano cose diverse. Il percorso ci insegna tanto a costruire una catena di supervisione debole quanto a riconoscere il caso in cui non fa meglio delle annotazioni affidabili già disponibili.
Esercizio: una regola copiata è una nuova informazione?
Prima di avviare l'esperienza, annotate la vostra ipotesi: cosa succede se copiamo la regola « validé dans le titre »? Cambia il numero di voti? Abbiamo appreso qualcosa di nuovo sul documento? Prevedete separatamente l'effetto sul modello latente e sul classificatore testuale.
Per aiutarvi a ragionare, riprendete l'esempio pedagogico [2, 1, -1]. Duplicando il primo parere, si ottiene [2, 1, -1, 2]. La maggioranza non vede più una parità, mentre non è stata osservata alcuna nuova informazione. Due copie della stessa condizione restano dipendenti, anche se occupano due colonne distinte.
La variante fornita duplica questa regola, riaddestra la catena interessata e valuta sugli stessi documenti.
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli exercise --config configs/minimum.yaml
docker compose run --rm inference python -m ged_supervision_faible_statuts.cli predict --config configs/minimum.yaml --variant duplicate
docker compose run --rm tutorial python -m ged_supervision_faible_statuts.cli evaluate-exercise --config configs/minimum.yaml
Aprite outputs/exercise-comparison.json e confrontate le misure con le vostre previsioni. Nel percorso di riferimento, il macro-F1 del modello latente diminuisce di circa 0,2122, mentre quello del classificatore aumenta di circa 0,0144. Sono scarti di punteggio, non variazioni percentuali relative.
Il Brier del classificatore aumenta leggermente: il miglioramento del suo macro-F1 non è dunque accompagnato da un miglioramento di questa misura probabilistica. La copia non ha fornito alcuna osservazione indipendente e i suoi effetti non sono identici nelle due fasi della catena.
Non trattenete dunque una regola semplicistica come « duplicare fa sempre diminuire tutti i punteggi ». Tenete piuttosto a mente la domanda da porre: quale informazione è stata realmente aggiunta e in quale fase se ne osserva l'effetto?
Per la vostra esperienza personale, scegliete poi una sola regola e modificatene il trattamento di una negazione. Scrivete prima ciò che dovrebbe cambiare. Rieseguite il percorso in un'estrazione separata, conservando gli stessi insiemi di valutazione, quindi confrontate voti, astensioni, esempi e metriche.
Questa modifica personale è distinta dalla variante di riferimento: il suo risultato non è noto in anticipo. Per un approccio di sviluppo, usate la validazione per scegliere un miglioramento e tenete il test finale separato da queste scelte, invece di aggiustare continuamente le regole per migliorarne il punteggio.
Ispezionare le figure e controllare i file
Generate le figure a partire dai vostri output, quindi controllate i checkpoint.
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
I file outputs/rules.json, outputs/evaluation.json e le figure permettono di risalire dalle medie agli esempi. Per V-033, seguite lo stesso percorso del programma: gli indizi presenti nel documento, i pareri delle regole, le distribuzioni stimate, poi le proposte dei classificatori. Un risultato medio non sostituisce l'ispezione di questo percorso.
I test negativi verificano che il programma rifiuti un input incoerente. Coprono in particolare i voti fuori dalle classi autorizzate, le probabilità non finite, le distribuzioni normalizzate male e le ancore non valide. Il successo del test consiste allora nel constatare il rifiuto atteso, non nell'ottenere una classe a ogni costo.
Risolvere problemi e pulire
Compose fallisce? Iniziate dal suo controllo di configurazione, presente nei primi comandi. Verificate l'errore prima di attribuire il problema al modello.
Esiste già uno stato di addestramento? Usate un'estrazione pulita invece di sovrascriverlo. Mescolare i risultati di due prove renderebbe difficili da interpretare i confronti.
Una distribuzione viene rifiutata? Ispezionate gli input e la loro costruzione. Una somma errata, un valore negativo o non finito rivelano un problema da comprendere. Non sostituite silenziosamente le probabilità con una classe arbitraria per superare il controllo.
Prima della pulizia, conservate le figure e i risultati utili. I comandi seguenti arrestano il progetto, cancellano solo outputs/, poi terminano il percorso. Il corpus e i checkpoint sono conservati.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Dal tutorial a un'applicazione reale
Il corpus sintetico permette di studiare il meccanismo; non rappresenta tutte le formulazioni e tutte le pratiche di un'organizzazione. Per un'applicazione di gestione elettronica dei documenti, o GED, iniziate con annotazioni affidabili rappresentative dei testi e delle loro evoluzioni.
Misurate le correlazioni fra regole, la copertura, gli errori per classe e la calibrazione su un insieme separato. Una regola che sfrutta un'abitudine di redazione o una data può smettere di essere utile quando le pratiche cambiano. Titoli, citazioni e date non devono diventare prove di uno stato amministrativo.
Dal lato dell'applicazione, distinguete chiaramente la proposta del modello e lo stato ufficiale. Una schermata potrebbe presentare il parere proposto, gli indizi usati e una possibilità di controllo umano; questa interfaccia è una pista di integrazione, non una funzionalità già fornita dal tutorial.
Aggiungete i diritti di accesso, la riservatezza, il versionamento delle regole, la tracciabilità delle proposte, il monitoraggio del servizio e il controllo umano. Queste misure completano la valutazione statistica: anche un punteggio migliore non sostituisce le regole che determinano chi può consultare un documento o modificarne lo stato.
Per andare oltre
Migliorare una regola a partire da errori identificati. Scegliete una confusione osservabile, formulate un'ipotesi, poi misurate se la modifica riduce questo errore senza spostarne semplicemente il costo verso un'altra classe.
Confrontare più budget di annotazioni affidabili. Il risultato delle 90 ancore fornisce un punto di partenza per studiare l'effetto di più o meno esempi verificati. Non permette di prevedere i punteggi di queste nuove esperienze.
Esaminare le dipendenze fra regole. Due regole possono essere diverse nel codice pur sfruttando quasi sempre lo stesso indizio. L'esercizio di duplicazione è un caso particolarmente visibile di questo problema.
Costruire un'interfaccia di revisione dei casi contraddittori. Potrebbe mostrare il documento, i voti, le probabilità e la correzione umana. L'interesse sarebbe rendere gli errori ispezionabili, non nascondere l'incertezza dietro una sola etichetta.
Riferimenti per approfondire le spiegazioni
Il codice completo dello ZIP descrive i calcoli EM e il percorso riproducibile R001. I collegamenti aggiunti nel testo rimandano alla presentazione della supervisione debole da parte di Stanford e alle documentazioni di SciPy, PyTorch e scikit-learn per i meccanismi numerici e le misure.
Questi riferimenti completano le spiegazioni; non costituiscono né una nuova validazione del progetto né un invito a sostituirne le implementazioni. Per riprodurre i risultati, conservate dipendenze, configurazioni e comandi dello ZIP. Gli esempi pedagogici di voti e probabilità sono distinti dalle misure del corpus.