





Está desarrollando una pantalla de gestión documental. El objetivo parece sencillo: proponer una categoría para cada documento para facilitar su clasificación. Empieza con algunas condiciones: un título contiene «borrador», un párrafo solicita una revisión y otra frase anuncia una aprobación.
Después llega el documento ficticio V-033. Su título contiene «validado», pero el cuerpo indica «para revisión». ¿En qué regla hay que confiar? Dar siempre prioridad al título no resuelve el problema: un título también puede contener una negación o una mención antigua.
Este es el punto de partida de la supervisión débil: usar indicios imperfectos para construir datos de entrenamiento, sin tratarlos como respuestas seguras. Aquí escribiremos reglas, aprenderemos a combinar sus opiniones y entrenaremos después un clasificador de texto a partir del resultado.
El programa propone clases para documentos ficticios. No modifica ningún estado administrativo ni deduce una aprobación real a partir de un título. Nuestra pregunta será más modesta, pero medible: ¿esta cadena aprende algo útil o lo hace peor que un método más sencillo?
Descargar el proyecto completo del tutorial
Lo que va a construir
El recorrido sigue documento → votos de reglas → probabilidades de clases → clasificador de texto → propuesta.
Una clase es simplemente una categoría que se debe predecir. Una regla puede proponer una o abstenerse. El primer modelo recibe estos votos y estima una distribución de probabilidades entre las tres clases. Por ejemplo, puede asignar más probabilidad a EN_REVUE y conservar al mismo tiempo una duda con ANNONCE_APPROUVE.
Un segundo modelo, el clasificador de texto, aprende después a partir del texto de los documentos y de estas distribuciones. Por tanto, los dos modelos tienen entradas distintas: el primero combina las opiniones de las reglas; el segundo aprende a clasificar el texto. Este tutorial no utiliza un modelo de lenguaje grande encargado de redactar una respuesta.
¿Por qué no detenerse en las reglas? Porque queremos comprobar si su combinación puede proporcionar una señal de aprendizaje útil para el clasificador. Es una posibilidad que hay que evaluar, no un beneficio adquirido. El principio general se presenta en esta introducción a la supervisión débil del equipo de investigación de Stanford. El proyecto del ZIP muestra un mecanismo limitado cuyos cálculos podemos seguir.
Compararemos cuatro métodos: el voto mayoritario, el modelo que combina los votos, un clasificador entrenado con algunas anotaciones fiables y el clasificador que usa supervisión débil. De paso, explicaremos la abstención, las variables latentes y el algoritmo EM, sin suponer que ya los conoce.
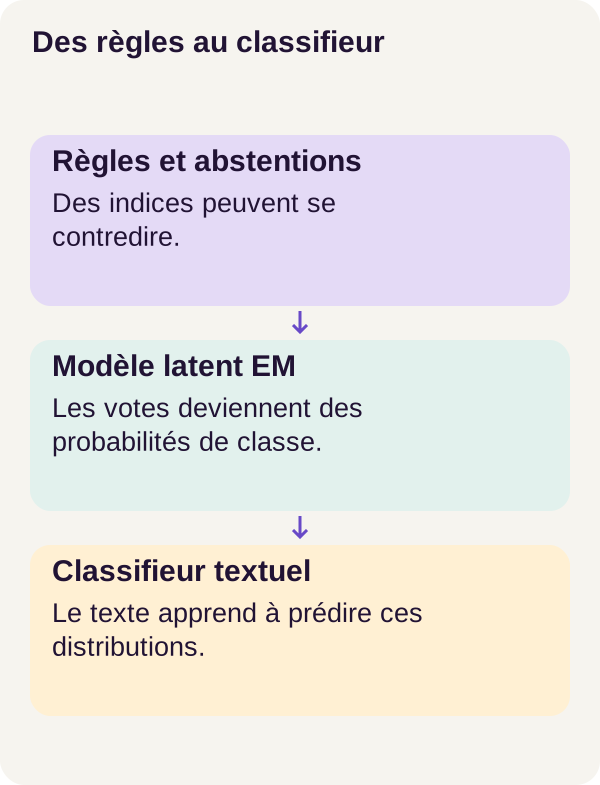
Una regla constituye un indicio imperfecto, no una anotación fiable.
Preparar un entorno de CPU reproducible
Debe saber leer Python, usar un terminal y ejecutar Docker. Una matriz numérica es aquí un conjunto de números organizado en filas y columnas; precisaremos qué representan sus dimensiones en cada etapa.
Este proyecto está validado en CPU, es decir, en el procesador de la máquina. No se necesita ninguna GPU NVIDIA. El README recomienda 12 GiB de RAM y 6 GiB de espacio de trabajo, además del almacenamiento de Docker. Son indicaciones de preparación, no medidas de consumo garantizadas.
Descomprima el ZIP y abra un terminal en su carpeta raíz, la que contiene README.md. Todos los comandos siguientes parten de este directorio. Compruebe el entorno, prepare las carpetas y construya después los servicios.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference
El primer script realiza las comprobaciones previas. El segundo prepara los directorios. docker compose config --quiet verifica la configuración de Compose; build construye los entornos necesarios para el recorrido. Corrija un error bloqueante antes de pasar a la siguiente etapa.
Los servicios separan las funciones: tutorial prepara los datos y las evaluaciones; learning recibe las entradas de aprendizaje y las anotaciones autorizadas; inference produce las predicciones sin consultar las respuestas esperadas. assets/ conserva los estados aprendidos y outputs/, los resultados. El archivo Compose del ZIP detalla los montajes y las restricciones.
El modelo se inicializa localmente: no vamos a descargar los pesos de un modelo preentrenado. La etapa acquisition comprueba aquí un registro vacío y no descarga pesos de terceros. Permanece en el recorrido, antes del control del entorno en contenedores y de las pruebas.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
El recorrido de referencia informa de 24 pruebas correctas. Comprueban comportamientos del programa y el rechazo de casos no válidos. No las confunda con una medida de calidad documental: que las pruebas tengan éxito no significa que todas las propuestas de clase sean correctas.
Leer los datos y las anotaciones
Las tres clases del proyecto son BROUILLON, EN_REVUE y ANNONCE_APPROUVE. La última designa un anuncio en un documento ficticio, no una validación legal. Los textos pueden contener negaciones, menciones antiguas o títulos engañosos.
El código representa las clases mediante enteros. Este es el pequeño diccionario que debe tener presente:
| Valor | Significado |
|---|---|
0 |
BROUILLON |
1 |
EN_REVUE |
2 |
ANNONCE_APPROUVE |
-1 |
Abstención: no se propone ninguna clase. |
-1 no es una cuarta categoría de documento. Es una información sobre el comportamiento de una regla o de un método: no se pronuncia.
Una anotación, también llamada label o etiqueta, indica la clase de referencia de un ejemplo. El corpus incluye conjuntos separados para el aprendizaje, la validación y la prueba. El aprendizaje sirve para ajustar los parámetros; la validación permite examinar el comportamiento durante el desarrollo; la prueba sirve para medir el resultado final en documentos separados.
La prueba contiene 360 documentos, con 120 referencias de cada clase. También disponemos de 90 anclajes: ejemplos de aprendizaje cuya clase se conoce. La palabra «anclaje» describe su función: proporcionan puntos de referencia fiables al modelo intermedio. También sirven para entrenar un pequeño clasificador de comparación, sin supervisión débil.
Por tanto, no estamos ante un aprendizaje desprovisto de toda anotación. La pregunta es qué aportan las reglas además de estos ejemplos fiables.
Creemos los datos.
docker compose run --rm tutorial python -m ged_supervision_faible_statuts.cli prepare --config configs/minimum.yaml
Observe la separación entre los textos y las anotaciones. El programa puede leer el título, el cuerpo y los metadatos autorizados de un documento. No debe leer su respuesta de prueba para fabricar una predicción. Los 90 anclajes son una parte explícitamente autorizada de la supervisión; las referencias de prueba siguen reservadas para la evaluación.
Construir reglas que pueden abstenerse
Una regla produce una opinión, no una certeza
Una función de etiquetado es una función de Python que busca un indicio y devuelve una clase, o -1 cuando no tiene ninguna opinión. Para un desarrollador web, piense en la diferencia entre un valor ausente y un valor igual a cero: aquí, «no lo sé» nunca debe convertirse en BROUILLON de forma predeterminada.
El proyecto incluye ocho reglas. Algunas inspeccionan el título y otras el cuerpo; otra usa una fecha de exportación. Esta última codifica deliberadamente una correlación ficticia frágil: una exportación tardía no prueba una aprobación.
Esta es la función central. Los extractos del artículo se leen junto con las constantes y funciones auxiliares del ZIP; los comandos ejecutan el proyecto completo.
def apply_label_functions(document):
    title = normalize(document["title"])
    body = normalize(document["text"])
    date = document.get("export_date")
    # Deliberately imperfect: title rule ignores negation, body approval excludes quoted and negated mentions.
    tests = [
        ("valide" in title, 2, "validé dans le titre"),
        ("provisoire" in title or "brouillon" in title, 0, "titre provisoire"),
        ("relecture" in title, 1, "titre relecture"),
        (
            "pour relecture" in body and "pas pour relecture" not in body,
            1,
            "corps pour relecture",
        ),
        ("version de travail" in body, 0, "corps version de travail"),
        (
            "annonce une approbation obtenue" in body
            and "aucune signature" not in body,
            2,
            "annonce positive et absence de négation détectée",
        ),
        (
            bool(date and date >= "2026-08-26"),
            2,
            "export tardif : corrélation fictive, pas approbation",
        ),
        ("commentaires attendus" in body, 1, "commentaires attendus"),
    ]
    return [
        {
            "rule": name,
            "vote": k if active else ABSTAIN,
            "reason": reason if active else "aucun motif reconnu",
        }
        for name, (active, k, reason) in zip(RULES, tests)
    ]
normalize() armoniza las mayúsculas y los acentos antes de la búsqueda. Esto facilita la comparación de cadenas, pero no da a la regla comprensión de la frase.
Cada elemento de tests contiene tres informaciones: una condición, el número de clase propuesto si es verdadera y una justificación textual. zip(RULES, tests) asocia estos elementos con los nombres de las reglas. El resultado conserva rule, vote y reason, lo que permite recuperar el origen de una opinión.
Observe la primera condición: busca simplemente valide en el título normalizado. Ignora deliberadamente la negación. Como contraejemplo pedagógico, un título «Non validé» también contiene esta cadena tras la normalización. Por tanto, la regla puede votar en el sentido equivocado mientras ejecuta exactamente el código previsto.
Las condiciones del cuerpo son algo más selectivas: una excluye la formulación pas pour relecture, otra comprueba la ausencia de aucune signature. Son pruebas de cadenas precisas, no un analizador general de negaciones o citas. El comentario del extracto debe leerse dentro de este alcance limitado.
Por último, la fecha 2026-08-26 es el umbral fijado en la regla de exportación del corpus ficticio. No es una fecha que deba sustituirse por la actual ni una regla de negocio que se pueda trasladar tal cual.
Para V-033, el título y el cuerpo nos dan indicios contradictorios. Los conservaremos en lugar de ocultar el conflicto mediante un orden arbitrario de condiciones.
Empezar por una mayoría simple
Antes de aprender a combinar las reglas, calculemos una referencia sin aprendizaje, o baseline: contar los votos.
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli baseline --config configs/minimum.yaml
outputs/rules.json describe los conflictos y las abstenciones. La mayoría devuelve una opinión vacía si ninguna regla vota o si varias clases empatan en primer lugar. No elige la primera clase solo para producir una respuesta.
La matriz votes tiene una fila por documento y una columna por regla, es decir, ocho columnas en el recorrido principal. La función siguiente transforma esta matriz en proporciones de votos y decisiones.
def majority_vote(votes):
    counts = np.stack([(votes == k).sum(1) for k in range(3)], axis=1)
    total = counts.sum(1)
    probabilities = np.divide(
        counts,
        total[:, None],
        out=np.full(counts.shape, 1 / 3, dtype=np.float64),
        where=total[:, None] > 0,
    )
    tied = (counts == counts.max(1, keepdims=True)).sum(1) > 1
    predicted = np.where((total == 0) | tied, -1, counts.argmax(1))
    return probabilities, predicted
Para cada clase k, (votes == k).sum(1) cuenta las opiniones correspondientes en cada documento. np.stack(..., axis=1) reúne estos recuentos en tres columnas, en el orden BROUILLON, EN_REVUE, ANNONCE_APPROUVE. total cuenta únicamente los votos emitidos: los -1 no se añaden a ninguna clase.
total[:, None] da al total una forma de columna para dividir los tres recuentos de una fila por el mismo número. El parámetro where evita una división por cero. Cuando ninguna regla habla, out proporciona una distribución uniforme: un tercio para cada clase.
Pero una distribución aún no es una decisión. tied detecta los empates y np.where impone una predicción -1 cuando el total es nulo o cuando ganan varias clases.
Tomemos tres pequeños ejemplos pedagógicos, limitados a tres reglas para leer los cálculos con facilidad. No son las salidas completas de V-033.
Con los votos [1, 1, 2], los recuentos son [0, 2, 1]. La distribución es [0 ; 2/3 ; 1/3] y la decisión es 1, por tanto EN_REVUE.
Con [2, 1, -1], los recuentos son [0, 1, 1]. La distribución es [0 ; 0,5 ; 0,5], pero la decisión sigue siendo -1: hay empate.
Con [-1, -1, -1], la distribución es [1/3 ; 1/3 ; 1/3] y la decisión también es -1. Esta vez nadie ha votado.
Los dos últimos casos llevan a la misma abstención, pero no por la misma razón. Conservar los votos y las probabilidades permite comprender esta diferencia.
Estimar una clase oculta con EM
El problema: conocer las clases para evaluar las reglas… y a la inversa
El voto mayoritario da el mismo peso a todas las opiniones. Nos gustaría ir más lejos: ¿una regla se equivoca a menudo en una clase? ¿Confunde un borrador con un documento en revisión? ¿Aporta su opinión algo cuando otras reglas la contradicen?
La dificultad es circular. Para conocer los errores de las reglas, habría que conocer las clases de los documentos. Para estimar estas clases, precisamente queremos usar las reglas.
Una variable latente es información que no se observa directamente. Aquí es la clase de referencia de un documento cuando no forma parte de los anclajes. El modelo mantendrá hipótesis probabilísticas sobre esta clase, en lugar de decidir de inmediato que vale 0, 1 o 2.
Tres matrices que comprender
pi contiene las proporciones estimadas de clases. Por ejemplo, [0,2 ; 0,5 ; 0,3] significa que, sin un nuevo indicio, el modelo reparte sus probabilidades en 20 %, 50 % y 30 %. Estos valores pertenecen al ejemplo numérico presentado más adelante; no son las proporciones aprendidas del corpus anunciadas de antemano.
theta describe el comportamiento de cada regla. Sus dimensiones siguen el orden regla, clase latente, voto observado. Con ocho reglas y tres clases, su forma es (8, 3, 3). Una celda theta[j, k, c] representa la probabilidad atribuida al voto c de la regla j cuando la clase supuesta es k. Por tanto, una celda fuera de la diagonal representa una posible confusión, no necesariamente un error de programación.
q contiene una distribución por documento. Con N documentos, su forma es (N, 3). Una fila indica hasta qué punto cada clase es plausible según los parámetros actuales. En el vocabulario de EM, estos valores también se llaman responsabilidades: harán que el documento contribuya parcialmente a varias clases durante la actualización.
Aquí, theta no tiene una columna para -1. Las abstenciones se ignoran en el cálculo de los votos; su frecuencia no se modela como una cuarta salida.
Alternar estimación y actualización
EM significa Expectation-Maximization. El algoritmo alterna dos operaciones: el paso E estima q con los parámetros actuales; el paso M recalcula pi y theta con estas distribuciones. Los anclajes conservan su clase conocida durante este proceso.
Dicho de otro modo: «Con lo que sé de las reglas, ¿qué clases son plausibles? Después, con estas clases plausibles, ¿cómo debo volver a estimar el comportamiento de las reglas?»
El modelo hace una simplificación importante: supone que los votos son independientes cuando se conoce la clase real. Esto permite multiplicar sus contribuciones. Pero dos reglas copiadas no constituyen dos observaciones independientes: siguen exactamente el mismo indicio. Probaremos este límite en el ejercicio.
Sumar los indicios sin perder las probabilidades pequeñas
El cálculo empieza en logaritmos. El logaritmo transforma un producto en una suma: en lugar de multiplicar varias probabilidades, el programa suma sus logaritmos.
def log_joint(votes, pi, theta):
    result = np.broadcast_to(np.log(pi), (len(votes), 3)).copy()
    for j in range(votes.shape[1]):
        rows = np.flatnonzero(votes[:, j] >= 0)
        for k in range(3):
            result[rows, k] += np.log(theta[j, k, votes[rows, j]])
    return result
np.broadcast_to(...).copy() prepara una fila de tres puntuaciones por documento, inicializada con log(pi). A continuación, el bucle recorre las reglas. np.flatnonzero(votes[:, j] >= 0) selecciona únicamente los documentos para los que la regla j ha expresado una opinión.
Para cada clase posible k, el programa añade la contribución del voto observado realmente. Por tanto, ya no cuenta solo «cuántas reglas eligieron esta clase», sino que pregunta «¿son plausibles estos votos si esta clase es la correcta?».
En este punto, las puntuaciones todavía no forman una distribución normalizada. Esa es la función del paso E.
def e_step(votes, pi, theta, anchors):
    validate_inputs(votes, pi, theta, anchors)
    joint = log_joint(votes, pi, theta)
    q = np.exp(joint - logsumexp(joint)[:, None])
    for i, k in anchors.items():
        q[i] = np.eye(3)[k]
    return q
La línea que construye q vuelve a convertir las tres puntuaciones de un documento en probabilidades cuya suma es uno. logsumexp sirve para realizar esta normalización de forma estable, incluso con probabilidades muy pequeñas.
La normalización debe hacerse documento por documento. La expresión logsumexp(joint)[:, None] espera aquí un normalizador por fila para restarlo a las tres puntuaciones correspondientes. Conserve la función auxiliar del proyecto: una función de biblioteca con el mismo nombre puede requerir un eje explícito. La documentación de SciPy sobre logsumexp explica este cálculo y la función de ese eje; no es una instrucción para sustituir el código.
Por último, np.eye(3)[k] construye un objetivo seguro para un anclaje. Si su clase conocida es 1, su fila pasa a ser [0, 1, 0]. Las reglas no pueden sustituirla por su propia hipótesis.
Para un documento sin voto y sin anclaje, no se ha añadido ningún indicio nuevo: q sigue siendo igual a pi. Si se trata de un anclaje, su clase conocida prevalece, incluso sin voto.
Contar contribuciones parciales con el paso M
Pasemos ahora de estas hipótesis a los nuevos parámetros.
def m_step_map(votes, q, alpha=1.1):
    if (
        alpha <= 1
        or q.shape != (len(votes), 3)
        or (q < 0).any()
        or not np.isfinite(q).all()
        or not np.allclose(q.sum(1), 1)
    ):
        raise ValueError("Invalid responsibilities or Dirichlet prior")
    pi = q.sum(0) + alpha - 1
    pi /= pi.sum()
    theta = np.full((votes.shape[1], 3, 3), alpha - 1, dtype=np.float64)
    for j in range(votes.shape[1]):
        for c in range(3):
            theta[j, :, c] += q[votes[:, j] == c].sum(0)
    theta /= theta.sum(2, keepdims=True)
    return pi, theta
Los controles iniciales exigen una distribución válida por documento: tres componentes, ningún valor negativo o no finito y una suma próxima a uno. Un valor «no finito» designa, entre otros, un infinito o NaN, el resultado numérico de un cálculo indefinido.
q.sum(0) suma las contribuciones de todos los documentos a cada clase. Un documento cuya distribución es [0,1 ; 0,7 ; 0,2] contribuye así con 0,1 a la primera clase, 0,7 a la segunda y 0,2 a la tercera. Es un recuento ponderado, no una conversión prematura en una etiqueta segura.
Para theta, q[votes[:, j] == c].sum(0) conserva únicamente los documentos en los que la regla j ha votado c. Sus contribuciones se añaden a la columna de ese voto y después cada distribución se normaliza sobre los tres votos posibles.
El parámetro alpha=1.1 aporta un pequeño a priori de Dirichlet. En concreto, este código añade alpha - 1, es decir, 0,1, a los recuentos antes de normalizarlos. Esto evita una probabilidad exactamente nula solo porque una combinación no haya recibido ninguna contribución. El sufijo map designa la estimación maximum a posteriori: las observaciones se combinan con este a priori.
Este suavizado evita algunos bloqueos numéricos; no crea nuevos conocimientos sobre los documentos. Las hipótesis del modelo y la calidad de las reglas siguen limitando el resultado.
Observar el pequeño ejemplo antes del aprendizaje completo
Ejecutemos primero el cálculo ilustrativo proporcionado.
docker compose run --rm tutorial python -m ged_supervision_faible_statuts.cli inspect-mechanism --config configs/minimum.yaml
En outputs/mechanism.json, la matriz ilustrativa no es el resultado entrenado del corpus. Para los votos [2, 1, -1], la distribución obtenida es aproximadamente [0,0403 ; 0,5369 ; 0,4228]. Su suma es uno, salvo el redondeo. Para la fila sin voto, sigue siendo [0,2 ; 0,5 ; 0,3].
Compárela con la mayoría: las mismas dos opiniones contradictorias le daban un empate. Aquí, las proporciones de clases y los parámetros de las reglas producen otra distribución. No ha habido un voto nuevo: ha cambiado la manera de interpretar los votos. Estos números no indican por sí solos que la interpretación sea correcta.
Ajustemos ahora EM sobre los datos de aprendizaje, con una interrupción, un testigo continuo, después una reanudación y su control.
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli fit-em --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli fit-em --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli fit-em --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli verify-em --config configs/minimum.yaml
interrupt interrumpe el cálculo previsto para la prueba de reanudación; continuous proporciona el recorrido testigo; resume retoma el estado guardado. verify-em compara los recorridos correspondientes.
Un checkpoint es un estado guardado que permite recuperar un cálculo. Reanudar no consiste en volver a empezar con parámetros cualesquiera: hay que recuperar el estado y el avance esperados. Examine las distribuciones obtenidas y el control de reanudación antes de pasar al clasificador.
Entrenar el clasificador con objetivos suaves
No convertir una duda en una certeza
Un objetivo es el resultado que se pide al modelo aprender. Un objetivo clásico indica una única clase. Un objetivo suave, en cambio, conserva una distribución entre las clases.
Tomemos la distribución pedagógica [0,04 ; 0,54 ; 0,42], próxima al ejemplo anterior. Sustituirla por [0, 1, 0] haría desaparecer la duda entre EN_REVUE y ANNONCE_APPROUVE. Con el objetivo suave, el clasificador también recibe esta incertidumbre estimada. Esto no hace que el objetivo sea más verdadero, pero evita presentarlo como una certeza que no tiene.
Transformar el texto en números con TF-IDF
El clasificador recibe una representación TF-IDF del título y del cuerpo, no directamente la matriz de los ocho votos. Un vector es una secuencia de números; aquí, sus coordenadas describen los términos conservados en el texto.
TF, por term frequency, refleja la frecuencia de un término en el documento. IDF, por inverse document frequency, tiene en cuenta su rareza en los documentos de aprendizaje. Su combinación pondera los términos y el proyecto normaliza después el vector.
Para la intuición, imagine que casi todos los documentos contienen la palabra «document», pero solo algunos contienen «relecture». La segunda puede proporcionar un indicio más distintivo. Esto no significa que un término raro revele automáticamente la clase correcta: su valor depende de los datos y del aprendizaje. La documentación de scikit-learn sobre TF-IDF profundiza en esta representación; las elecciones exactas del recorrido siguen siendo las del ZIP.
Por tanto, tenemos dos objetos que no deben confundirse: el vector de texto, que sirve como entrada, y la distribución sobre las tres clases, que sirve como objetivo. El número de características del texto no es el número de clases que hay que predecir.
Comprender la función de pérdida
El proyecto utiliza un MLP, o perceptrón multicapa: una red de capas lineales separadas por activaciones. Las capas combinan los valores de entrada con parámetros aprendidos; las activaciones permiten no limitarse a una simple transformación lineal.
La red produce tres logits, es decir, tres puntuaciones brutas. Aún no son probabilidades y no tienen que sumar uno. Durante el entrenamiento, una función de pérdida mide la diferencia con el objetivo. El aprendizaje ajusta los parámetros para reducir esta pérdida; los gradientes indican cómo afecta una variación de los parámetros al cálculo.
Esta es la pérdida utilizada con los objetivos suaves.
def soft_cross_entropy(logits, targets):
    if (
        logits.shape != targets.shape
        or logits.ndim != 2
        or not torch.isfinite(targets).all()
        or (targets < 0).any()
        or not torch.allclose(
            targets.sum(1), torch.ones(len(targets), dtype=targets.dtype)
        )
    ):
        raise ValueError("Expected a distribution per example")
    return -(targets * F.log_softmax(logits, dim=-1)).sum(1).mean()
logits y targets deben tener la misma forma: una fila por ejemplo del lote y tres columnas. El lote, o batch, es el grupo de documentos procesado conjuntamente. Los controles comprueban, entre otras cosas, que los objetivos sean finitos, positivos o nulos y estén normalizados.
F.log_softmax(logits, dim=-1) transforma las puntuaciones en logaritmos de probabilidades sobre las clases. La multiplicación por targets pondera cada contribución según el objetivo. .sum(1) suma las contribuciones de las tres clases para cada documento y .mean() calcula la media sobre el lote. El signo menos produce la pérdida de entropía cruzada.
La documentación de PyTorch sobre la entropía cruzada también describe este caso de objetivos probabilísticos. Recuerda que su validez debe controlarla el código que llama: unos números cualesquiera no se convierten en una distribución solo porque se transmitan a una función de pérdida.
Aprender con más objetivos no ayuda necesariamente si son poco informativos. Si las distribuciones dudan casi por igual entre las clases, la red recibe una señal muy distinta de la de una anotación fiable. Hay que medir qué hace con ella, no suponer que el segundo modelo corregirá automáticamente al primero.
Entrenar y comprobar la reanudación
Ejecute los entrenamientos interrumpido, continuo y reanudado, y compare los estados.
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli verify-resume --config configs/minimum.yaml
El recorrido controla por separado la reanudación de EM y la del clasificador. Son dos cálculos distintos, con sus propios estados aprendidos. Los resultados de referencia establecen su reproducibilidad en este entorno de CPU; no garantizan una identidad numérica después de un cambio de dependencias o de entorno.
Produzcamos después las dos predicciones: el clasificador que utiliza solo los 90 anclajes y el que utiliza la supervisión débil.
docker compose run --rm inference python -m ged_supervision_faible_statuts.cli predict --config configs/minimum.yaml --variant anchors
docker compose run --rm inference python -m ged_supervision_faible_statuts.cli predict --config configs/minimum.yaml --variant main
En este punto hacemos inferencia: utilizamos los parámetros aprendidos para predecir. Ya no es la etapa en la que ajustamos los parámetros a partir de los objetivos. El servicio inference no ve las clases de referencia.
Los archivos predictions-anchors.json y predictions-main.json permiten comparar los métodos documento por documento. Busque V-033 y pregúntese: ¿los dos clasificadores proponen la misma clase? ¿Qué duda expresan sus distribuciones? No deduzca la respuesta solo de la palabra «validé»: inspeccione las salidas producidas realmente.
Comprender las métricas antes de los resultados
Una métrica es una medida elegida para evaluar el programa. Aquí queremos examinar tres cosas diferentes: ¿el método se pronuncia?, ¿clasifica correctamente? y ¿asigna probabilidades útiles? Un solo número no responde a estas tres preguntas.
Cobertura y accuracy: responder no es acertar
La cobertura es la proporción de documentos para los que un método toma una decisión. En diez documentos, un método que clasifica siete y se abstiene en tres tiene una cobertura de 0,7, aunque sus siete decisiones sean correctas.
La accuracy, o exactitud, cuenta las decisiones correctas. En este proyecto, su denominador incluye los 360 documentos de prueba, abstenciones incluidas. Por tanto, no se retiran los documentos difíciles para mejorar artificialmente la puntuación.
Una cobertura de 1 significa «una decisión para cada documento», no «todas las decisiones son correctas». A la inversa, un método puede hacer buenas propuestas y dejar muchos documentos sin respuesta.
Precisión, recall y macro-F1: observar las clases por separado
Para una clase determinada, la precisión pregunta: entre los documentos que he colocado en esta clase, ¿cuántos pertenecen realmente a ella? El recall pregunta: entre los documentos que debían colocarse en ella, ¿cuántos he recuperado?
Tomemos un ejemplo pedagógico: predice cuatro documentos EN_REVUE, tres de ellos correctos, mientras que se esperaban cinco. La precisión es 3/4, es decir, 0,75; el recall es 3/5, es decir, 0,60. El F1 combina ambos mediante 2 × precisión × recall / (precisión + recall), aproximadamente 0,6667 aquí.
El macro-F1 calcula el F1 de cada una de las tres clases y después hace su media. Cada clase cuenta lo mismo en esta media. Una abstención sobre un documento esperado en una clase constituye una referencia no recuperada: disminuye su recall.
Por tanto, el macro-F1 no representa directamente el porcentaje de documentos bien clasificados. Tampoco comprueba si la confianza mostrada por el método está justificada.
Brier y log-loss: evaluar también las probabilidades
El score de Brier compara toda la distribución predicha con el vector de la clase de referencia. En la convención del proyecto, se suman los tres errores al cuadrado y después se calcula la media sobre los documentos. Su intervalo va de 0 a 2, y un valor más bajo es preferible. La documentación del Brier multiclase presenta esta definición; compruebe siempre la convención utilizada antes de comparar puntuaciones de proyectos distintos.
Para un cálculo pedagógico, supongamos que la referencia es EN_REVUE. Su vector es [0, 1, 0]. Con la predicción [0,1 ; 0,7 ; 0,2], el error es:
(0,1 - 0)² + (0,7 - 1)² + (0,2 - 0)² = 0,14.
Una predicción exactamente igual a la referencia da cero. Una certeza total situada en la clase equivocada da dos.
La log-loss observa la probabilidad asignada a la clase correcta mediante el cálculo -log(probabilidad correcta) para un documento. Si esta probabilidad vale 0,9, la pérdida es aproximadamente 0,1054; si vale 0,01, la pérdida sube a aproximadamente 4,6052. Por tanto, un error del que se está muy seguro se penaliza mucho. El principio se detalla en la documentación de la log-loss.
Estas dos puntuaciones evalúan las probabilidades, pero no son intercambiables. Tampoco constituyen por sí solas un diagnóstico completo de la calibración, es decir, de la concordancia entre la confianza anunciada y la frecuencia de los aciertos. La documentación sobre calibración explica, en particular, por qué el Brier mezcla varios aspectos de la calidad predictiva.
Calcular e interpretar los resultados
Ejecutemos la evaluación.
docker compose run --rm tutorial python -m ged_supervision_faible_statuts.cli evaluate --config configs/minimum.yaml
Los valores siguientes están redondeados; se refieren a los 360 documentos de prueba.
En móvil, desplace la tabla horizontalmente.
| Método | Cobertura | Macro-F1 | Brier | Log-loss |
|---|---|---|---|---|
| Voto mayoritario | 0,7444 | 0,7721 | 0,2735 | 1,4439 |
| Modelo latente EM | 1,0000 | 0,3789 | 0,6666 | 1,0985 |
| Clasificador sobre 90 anclajes | 1,0000 | 0,7666 | 0,4260 | 0,7594 |
| Clasificador con supervisión débil | 1,0000 | 0,6118 | 0,6344 | 1,0511 |
La mayoría obtiene el mejor macro-F1 de la tabla, pero se abstiene en 92 documentos. Por tanto, toma una decisión en 360 - 92 = 268 documentos, es decir, 268/360 ≈ 0,7444 de cobertura. Hay que leer las dos columnas juntas.
Su Brier también es el más bajo, pero su log-loss es la más alta. No es una contradicción: las medidas no penalizan las distribuciones de la misma manera. Las probabilidades muy bajas asignadas a la clase correcta pueden, en particular, pesar mucho en la log-loss. Para explicar con precisión los errores del recorrido, hay que consultar las salidas por documento; la tabla sola no da sus detalles.
El modelo latente EM responde en todas partes, pero sus distribuciones se mantienen cerca de la uniforme. Esta es una referencia puramente matemática, no un experimento nuevo: una distribución [1/3 ; 1/3 ; 1/3] da un Brier de 2/3 ≈ 0,6667 y una log-loss de log(3) ≈ 1,0986, cualquiera que sea la clase correcta. Los valores observados para EM, 0,6666 y 1,0985, están muy cerca de esta referencia. Elegir el componente más alto no significa que el modelo disponga de un indicio claro para decidir.
El clasificador sobre 90 anclajes funciona aquí mejor que el que utiliza la supervisión débil. Ambos cubren todos los documentos, pero el primero tiene un macro-F1 superior y errores probabilísticos menores. En este corpus, pasar por las reglas y el modelo latente no mejora por tanto este punto de comparación.
Este resultado negativo es central. No prueba que toda supervisión débil fracase; muestra que esta combinación de datos, reglas y modelos no basta para obtener una mejora. Una arquitectura más elaborada debe enfrentarse a los resultados, incluso cuando contradicen la intuición inicial.
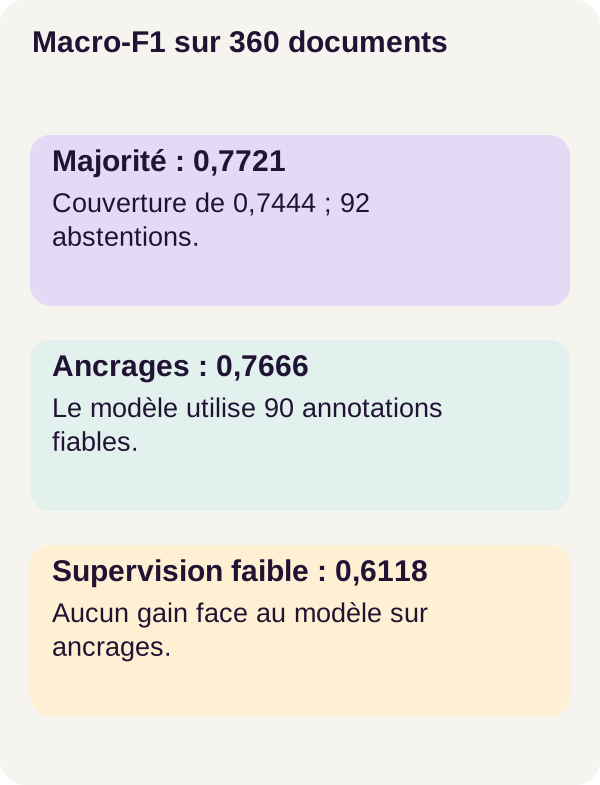
Los métodos no comparten la misma cobertura: la mayoría se abstiene en 92 documentos.
Lo que hemos aprendido
Una regla proporciona una opinión parcial. Puede acertar, equivocarse o no pronunciarse. La abstención no debe convertirse en una clase de negocio predeterminada, y un conflicto no debe ocultarse para producir una respuesta a toda costa.
EM estima una clase oculta apoyándose en hipótesis sobre los votos. Los anclajes le dan referencias fiables, pero las distribuciones poco informativas siguen siendo una señal de aprendizaje limitada para el clasificador siguiente.
Por último, la cobertura, el macro-F1 y los errores probabilísticos cuentan cosas distintas. El recorrido nos enseña tanto a construir una cadena de supervisión débil como a reconocer el caso en que no lo hace mejor que las anotaciones fiables ya disponibles.
Ejercicio: ¿una regla copiada es información nueva?
Antes de ejecutar el experimento, anote su hipótesis: ¿qué ocurre si copiamos la regla «validé dans le titre»? ¿Cambia el número de votos? ¿Hemos aprendido algo nuevo sobre el documento? Anticipe por separado el efecto en el modelo latente y en el clasificador de texto.
Para ayudarle a razonar, retome el ejemplo pedagógico [2, 1, -1]. Al duplicar la primera opinión, obtenemos [2, 1, -1, 2]. La mayoría deja de ver un empate, aunque no se haya observado información nueva. Dos copias de la misma condición siguen siendo dependientes, aunque ocupen dos columnas distintas.
La variante proporcionada duplica esta regla, vuelve a entrenar la cadena correspondiente y evalúa con los mismos documentos.
docker compose run --rm learning python -m ged_supervision_faible_statuts.cli exercise --config configs/minimum.yaml
docker compose run --rm inference python -m ged_supervision_faible_statuts.cli predict --config configs/minimum.yaml --variant duplicate
docker compose run --rm tutorial python -m ged_supervision_faible_statuts.cli evaluate-exercise --config configs/minimum.yaml
Abra outputs/exercise-comparison.json y compare las medidas con sus predicciones. En el recorrido de referencia, el macro-F1 del modelo latente disminuye aproximadamente 0,2122, mientras que el del clasificador aumenta aproximadamente 0,0144. Son diferencias de puntuación, no variaciones porcentuales relativas.
El Brier del clasificador aumenta ligeramente: por tanto, la mejora de su macro-F1 no va acompañada de una mejora de esta medida probabilística. La copia no ha proporcionado ninguna observación independiente y sus efectos no son idénticos en las dos etapas de la cadena.
No retenga, pues, una regla simplista como «duplicar siempre hace bajar todas las puntuaciones». Retenga más bien la pregunta que hay que plantear: ¿qué información se ha añadido realmente y en qué etapa observamos su efecto?
Para su experimento personal, elija después una sola regla y modifique su tratamiento de una negación. Escriba primero qué debería cambiar. Vuelva a ejecutar el recorrido en una extracción separada, conservando los mismos conjuntos de evaluación, y compare los votos, las abstenciones, los ejemplos y las métricas.
Esta modificación personal es distinta de la variante de referencia: su resultado no se conoce de antemano. Para un enfoque de desarrollo, use la validación para elegir una mejora y mantenga la prueba final al margen de estas decisiones, en lugar de ajustar sin parar las reglas para mejorar su puntuación.
Inspeccionar las figuras y controlar los archivos
Produzca las figuras a partir de sus salidas y compruebe después los checkpoints.
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Los archivos outputs/rules.json, outputs/evaluation.json y las figuras permiten volver de las medias a los ejemplos. Para V-033, siga el mismo camino que el programa: los indicios presentes en el documento, las opiniones de las reglas, las distribuciones estimadas y después las propuestas de los clasificadores. Un resultado medio no sustituye la inspección de este recorrido.
Las pruebas negativas verifican que el programa rechaza una entrada incoherente. Cubren, entre otros aspectos, los votos fuera de las clases autorizadas, las probabilidades no finitas, las distribuciones mal normalizadas y los anclajes no válidos. El éxito de la prueba consiste entonces en constatar el rechazo esperado, no en obtener una clase a toda costa.
Solucionar problemas y limpiar
¿Falla Compose? Empiece por su comprobación de configuración, presente en los primeros comandos. Verifique el error antes de atribuir el problema al modelo.
¿Ya existe un estado de entrenamiento? Use una extracción limpia en lugar de sobrescribirlo. Mezclar los resultados de dos intentos haría las comparaciones difíciles de interpretar.
¿Se rechaza una distribución? Inspeccione las entradas y su construcción. Una suma incorrecta, un valor negativo o no finito revela un problema que hay que comprender. No sustituya silenciosamente las probabilidades por una clase arbitraria para superar el control.
Antes de limpiar, conserve las figuras y resultados útiles. Los comandos siguientes detienen el proyecto, borran solamente outputs/ y después terminan el recorrido. El corpus y los checkpoints se conservan.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Del tutorial a una aplicación real
El corpus sintético permite estudiar el mecanismo; no representa todas las formulaciones ni todas las prácticas de una organización. Para una aplicación de gestión electrónica de documentos, o GED, empiece por anotaciones fiables que sean representativas de los textos y de sus evoluciones.
Mida las correlaciones entre reglas, la cobertura, los errores por clase y la calibración en un conjunto separado. Una regla que aprovecha un hábito de redacción o una fecha puede dejar de ser útil cuando cambian las prácticas. Los títulos, las citas y las fechas no deben convertirse en pruebas de un estado administrativo.
En la aplicación, distinga claramente la propuesta del modelo y el estado oficial. Una pantalla podría presentar la opinión propuesta, los indicios utilizados y una posibilidad de control humano; esta interfaz es una pista de integración, no una funcionalidad ya proporcionada por el tutorial.
Añada los derechos de acceso, la confidencialidad, el versionado de las reglas, la trazabilidad de las propuestas, la supervisión del servicio y el control humano. Estas medidas completan la evaluación estadística: incluso una mejor puntuación no sustituye las reglas que determinan quién puede consultar un documento o modificar su estado.
Para ir más lejos
Mejorar una regla a partir de errores identificados. Elija una confusión observable, formule una hipótesis y mida después si la modificación reduce este error sin desplazar simplemente su coste a otra clase.
Comparar varios presupuestos de anotaciones fiables. El resultado de los 90 anclajes da un punto de partida para estudiar el efecto de más o menos ejemplos verificados. No permite predecir las puntuaciones de estos nuevos experimentos.
Examinar las dependencias entre reglas. Dos reglas pueden ser distintas en el código y aun así explotar casi siempre el mismo indicio. El ejercicio de duplicación es un caso especialmente visible de este problema.
Construir una interfaz de revisión de los casos contradictorios. Podría mostrar el documento, los votos, las probabilidades y la corrección humana. El interés sería hacer que los errores se puedan inspeccionar, no ocultar la duda tras una sola etiqueta.
Referencias para profundizar en las explicaciones
El código completo del ZIP describe los cálculos de EM y el recorrido reproducible R001. Los enlaces añadidos a lo largo del texto remiten a la presentación de la supervisión débil de Stanford y a las documentaciones de SciPy, PyTorch y scikit-learn para los mecanismos numéricos y las medidas.
Estas referencias complementan las explicaciones; no constituyen ni una nueva validación del proyecto ni una invitación a sustituir sus implementaciones. Para reproducir los resultados, conserve las dependencias, configuraciones y comandos del ZIP. Los ejemplos pedagógicos de votos y probabilidades se distinguen de las medidas del corpus.