





Vous ajoutez un import de documents à un back-office. Un utilisateur dépose un seul PDF, mais ce fichier contient en réalité plusieurs pièces à ranger séparément : une facture, une autre facture, puis un rapport. Où faut-il couper ?
La première idée paraît simple : repérer les changements de type. Mais deux factures qui se suivent restent deux factures, même lorsqu’elles concernent des dossiers distincts. Autre idée : couper quand la numérotation recommence à 1. C’est un indice utile, mais nous allons mesurer pourquoi il ne suffit pas toujours.
Ce tutoriel construit une chaîne qui estime la présence d’une frontière entre deux pages voisines, puis rassemble ces décisions en documents complets. Nous travaillons sur des liasses « Atlas » fictives. Le but est de comprendre et de reproduire le mécanisme, pas de livrer un service de classement de documents réels.
Télécharger le ZIP du tutoriel r002
Pour une liasse de neuf pages, le résultat peut être une suite de plages : [0, 3], [3, 5], [5, 9]. Chaque plage donnera un PDF séparé. Attention à la convention : le début est inclus, la fin est exclue, comme dans une tranche de tableau Python pages[start:end].
| Plage | Indices des pages conservées | Pages pour le lecteur |
|---|---|---|
[0, 3] |
0, 1, 2 | 1 à 3 |
[3, 5] |
3, 4 | 4 à 5 |
[5, 9] |
5, 6, 7, 8 | 6 à 9 |
La page d’indice 3 n’est donc pas dupliquée : elle appartient uniquement à la deuxième plage. Cet exemple illustre le format de sortie, sans décrire une nouvelle exécution du corpus.
Notre objectif comporte deux exigences distinctes : retrouver les bonnes coupures, puis exporter les bonnes pages, dans l’ordre et sans perte. Un export fidèle peut contenir une mauvaise coupure ; un découpage juste ne garantit pas la conservation de toutes les propriétés du PDF.
Les notions utiles avant de lancer le modèle
Une petite question binaire plutôt qu’un classement métier
Une liasse est ici un fichier contenant plusieurs documents successifs. Entre deux pages, nous posons toujours la même question : « La page suivante commence-t-elle un nouveau document ? » La réponse attendue vaut 1 pour une frontière et 0 pour une continuation. C’est une classification binaire : il n’y a que deux possibilités.
Une liasse de n pages possède n - 1 positions de coupure internes. Quatre pages donnent donc trois décisions. Le début et la fin du fichier sont déjà connus : il n’est pas nécessaire de demander au modèle s’il existe une page avant la première ou après la dernière.
Une vraie frontière oubliée provoque une fusion : deux documents restent dans le même PDF. Une frontière ajoutée à tort provoque une surcoupe : un document se retrouve réparti sur plusieurs fichiers. Ces erreurs sont différentes, et nous les compterons séparément.
Le modèle n’apprend pas à dire « ceci est une facture valide ». Il apprend à proposer une séparation. Identifier ensuite le type, le dossier ou le statut d’une pièce serait une autre tâche.
Transformer le texte des pages en nombres
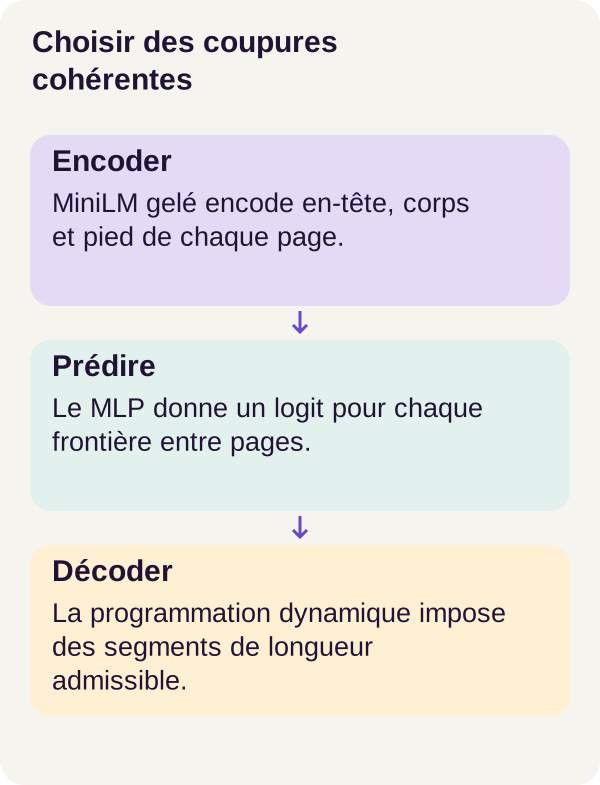
MiniLM joue ici le rôle d’encodeur textuel. Il ne rédige pas de réponse : il transforme du texte en vecteurs, c’est-à-dire en listes de nombres que le classifieur pourra utiliser. On appelle aussi ces représentations des embeddings.
Le parcours encode séparément l’en-tête, le corps et le pied de chaque page. Cela conserve une distinction entre les zones, au lieu de les mélanger immédiatement en une seule représentation. Des mesures de géométrie observable complètent ensuite les informations textuelles.
Avant l’encodage, le tokenizer découpe le texte en unités appelées tokens. Un token peut être un mot, un fragment de mot ou un signe ; ce n’est pas nécessairement un mot complet. Des jetons spéciaux délimitent aussi la séquence. MiniLM produit une représentation pour chaque position.
Reste une difficulté pratique : deux textes n’ont pas forcément le même nombre de tokens. Pour les traiter ensemble, on peut compléter le plus court par du padding, ou remplissage. Ces positions servent au calcul par lots, pas à décrire la page.
Le masque d’attention distingue les positions conservées du remplissage. Le pooling masqué calcule ensuite une moyenne des vecteurs retenus pour obtenir une représentation de taille fixe. La documentation de Sentence Transformers sur le pooling présente ce passage d’une séquence de longueur variable à un vecteur de taille fixe.
Prenons un petit calcul illustratif, avec des vecteurs de deux dimensions qui ne proviennent pas de MiniLM. Deux positions valides valent [2, 4] et [4, 2] ; une position de remplissage vaut [100, 100]. Avec le masque [1, 1, 0], la moyenne est [3, 3]. Sans masque, elle serait environ [35,33 ; 35,33] : le remplissage aurait complètement déformé la représentation.
Il faut donc retirer sa contribution et diviser par le nombre de positions valides, pas par la longueur du tableau complété. Le code officiel du pooling masqué permet de retrouver ces deux opérations.
Ce qui apprend, et ce qui reste fixe
Les poids de MiniLM sont gelés : ils ne sont pas modifiés pendant cet apprentissage. L’encodeur doit toujours effectuer des calculs pour représenter les pages ; « gelé » ne veut pas dire « sans coût de calcul ».
Seule la tête MLP, pour perceptron multicouche, est entraînée. Vous pouvez la voir comme une petite fonction numérique à paramètres ajustables : elle reçoit les caractéristiques des deux pages et produit un score de frontière. Ses paramètres sont des nombres appris, à distinguer des caractéristiques, qui sont les nombres fournis en entrée.
Pendant l’entraînement, une fonction de perte mesure l’écart entre la sortie du modèle et la réponse attendue. La BCE, ou entropie croisée binaire, pénalise une forte confiance du mauvais côté. Pour une vraie frontière, annoncer une probabilité de 0,9 donne une pénalité -ln(0,9), environ 0,1054 ; annoncer 0,1 donne environ 2,3026. Ces valeurs expliquent le calcul, ce ne sont pas des pertes mesurées sur Atlas.
Le projet utilise PyTorch et BCEWithLogitsLoss, qui reçoit directement les scores bruts et combine les opérations de manière numériquement stable. Nous expliquerons ces scores, ou logits, avant de lire le décodeur.
Trois méthodes, trois rôles à comparer
La première méthode est une baseline, un point de comparaison simple : couper lors d’une remise à 1 du numéro de page visible. Ce n’est pas un classifieur de types de documents.
La deuxième utilise le MLP, puis un seuil : chaque position de coupure est décidée séparément à partir de sa probabilité.
La troisième reprend les scores du MLP, mais choisit une partition complète sous une longueur maximale de document. Elle utilise la programmation dynamique, que nous allons lire comme une recherche de solutions réutilisant des résultats intermédiaires.
Les méthodes sont comparées sur le même ensemble de test. Les annotations, aussi appelées labels ou gold, sont les réponses de référence. Elles servent à apprendre ou à mesurer, selon leur partition ; elles ne sont pas une caractéristique observable de la page. Les labels test ne sont jamais montés dans les conteneurs inference et learning.
L’entraînement ajuste les paramètres, la validation choisit le seuil, et le test mesure la règle obtenue. Les contraintes de longueur sont également déclarées avant le test. Régler ces choix après avoir regardé les réponses de test reviendrait à préparer la correction avec le corrigé ouvert.
Prérequis et contrôle de l'environnement
Vous devez savoir lire du Python, utiliser un terminal et lancer Docker. PyTorch effectue l’apprentissage ; NumPy intervient notamment dans le décodeur. Les notions de classification binaire sont celles que nous venons d’introduire.
Le parcours de référence est prévu sous Linux avec GPU. Une RTX 3090 de 24 Gio, 24 Gio de RAM et 25 Gio de disque sont conseillés. La VRAM est la mémoire de la carte graphique ; la RAM est celle de la machine. Le parcours r002 a réellement utilisé une RTX 3090, mais ces indications ne constituent pas des minima garantis sur toutes les configurations. Aucun parcours CPU équivalent n’est établi par les résultats présentés ici.
Décompressez le ZIP et ouvrez un terminal à sa racine. Toutes les commandes suivantes partent de ce dossier, dans l’ordre indiqué. Les versions et les fichiers verrouillés du projet constituent la référence à reproduire ; les documentations liées servent à comprendre les mécanismes, pas à remplacer ses dépendances.
Un GPU visible avec nvidia-smi sur l’hôte n’est pas forcément utilisable dans Docker. NVIDIA Container Toolkit fournit l’intégration nécessaire avec le moteur de conteneurs. Le diagnostic du parcours signale son absence et l’action attendue, sans l’installer à votre place. La variable GPU_DEVICE=1 peut sélectionner une autre carte avant le lancement du parcours, selon la configuration fournie.
Vérifier l’hôte et construire les services
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference learning
Le préflight est le contrôle préalable : Docker, Compose, mémoire, espace disque et visibilité du GPU sous Linux. Le script de préparation est ensuite lancé, puis Compose vérifie la configuration et construit les quatre services.
docker compose config --quiet réussit sans afficher la configuration lorsqu’elle est valide ; c’est le comportement documenté de l’option --quiet. L’absence de texte n’est pas une invitation à ignorer un code de retour en erreur.
Acquérir MiniLM et calculer réellement dans Docker
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
L’acquisition télécharge les fichiers MiniLM, puis compare leur taille et leur empreinte SHA-256 aux valeurs attendues. Cette empreinte identifie le contenu des fichiers. Le remplacement atomique évite d’installer un fichier partiellement acquis à la place de la ressource attendue. Aucun poids n’est inclus dans le ZIP.
check_environment.py va plus loin que le contrôle de l’hôte : il charge réellement MiniLM dans Docker et calcule sur le GPU. Enfin, les tests vérifient notamment la programmation dynamique, les exports et la contrainte de longueur. Le parcours de référence rapporte 35 tests réussis ; leur réussite ne signifie pas que toutes les liasses réelles seront correctement séparées.
Fabriquer des décisions de frontière
Préparer les documents sans donner leurs réponses à l’encodeur
docker compose run --rm tutorial python -m pdfbundles.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m pdfbundles.cli features --config configs/minimum.yaml
prepare génère les liasses fictives et sépare leurs annotations. features construit les caractéristiques des pages adjacentes dans le conteneur qui ne voit pas ces labels. L’entraînement utilisera ensuite la supervision autorisée, mais les coupures gold de test restent réservées à l’évaluation.
Pour une paire de pages, le rapport r002 indique un vecteur de 3 480 valeurs fourni au MLP et 462 209 paramètres entraînables dans la tête. Le premier nombre décrit l’entrée ; le second décrit la fonction apprise. Ne les confondez pas avec un nombre de pages ou de documents.
Ces dimensions concernent la configuration du ZIP. Le seul nom « MiniLM » ne permet pas de reconstituer l’assemblage exact des caractéristiques : pour le modifier, il faut suivre leur construction dans le projet, sans inventer des colonnes supplémentaires à partir du total.
Entraîner, interrompre, reprendre
docker compose run --rm learning python -m pdfbundles.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m pdfbundles.cli train --mode continuous --config configs/minimum.yaml
docker compose run --rm learning python -m pdfbundles.cli train --mode resume --config configs/minimum.yaml
docker compose run --rm learning python -m pdfbundles.cli verify-resume --config configs/minimum.yaml
Une époque est un passage sur les exemples d’entraînement. Le budget total est ici de quinze époques. Le mode interrupt crée un parcours interrompu ; continuous fournit un témoin entraîné sans cette interruption ; resume reprend le calcul interrompu. Il ne s’agit pas d’entraîner trois fois de suite le même modèle pour accumuler quarante-cinq époques.
Un checkpoint est un état sauvegardé permettant de poursuivre ou de contrôler le calcul. verify-resume compare les états obtenus afin de vérifier que l’interruption et la reprise retrouvent le résultat du parcours continu.
C’est un contrôle de reproductibilité, pas une mesure de qualité documentaire. Deux exécutions peuvent reproduire exactement les mêmes erreurs. L’identité observée vaut également pour cet environnement : la documentation PyTorch sur la reproductibilité rappelle qu’un changement de plateforme ou de version peut modifier les résultats.
Choisir le seuil sur la validation
docker compose run --rm learning python -m pdfbundles.cli calibrate --config configs/minimum.yaml
calibrate sélectionne le seuil avec l’ensemble de validation. Un seuil plus bas peut déclencher davantage de coupures ; un seuil plus haut peut en oublier davantage. L’évaluation doit mesurer ce compromis plutôt que supposer qu’un choix est toujours préférable.
Le parcours retient 0,5. Ici, le nom de commande calibrate décrit le choix de cette règle de décision. Il ne prouve pas que toutes les probabilités annoncées par le modèle correspondent aux fréquences d’erreur d’une application réelle.
De logits locaux à des documents complets
Lire un logit avant de prendre une décision
Un logit est un nombre brut, qui peut être négatif ou positif. La fonction sigmoïde le transforme en probabilité de frontière : p = 1 / (1 + exp(-logit)). Sa définition est donnée dans la documentation PyTorch de Sigmoid.
| Logit illustratif | Probabilité approximative | Tendance au seuil 0,5 |
|---|---|---|
| -2 | 0,1192 | Continuer le document |
| 0 | 0,5000 | Égalité à départager selon la convention |
| 3 | 0,9526 | Couper |
À seuil 0,5, un logit strictement positif favorise donc la frontière et un logit strictement négatif favorise la continuation. Un score de 3 ne signifie pas « trois frontières » ou « trois pages ».
Le seuil indépendant traite chaque position séparément. Cela suffit à produire des plages consécutives, mais ne leur impose pas de longueur maximale. La programmation dynamique ajoute précisément cette contrainte.
Noter une partition entière
Pour évaluer un découpage, le programme choisit une contribution à chaque position interne : log(p) s’il coupe, log(1 - p) s’il garde les deux pages ensemble. Il additionne ensuite ces contributions.
Pourquoi des logarithmes ? Multiplier beaucoup de probabilités peut produire des nombres minuscules. Additionner leurs logarithmes conserve le classement des produits tout en facilitant le calcul. Le score obtenu est négatif ou nul ; le plus grand est le meilleur, même lorsqu’ils sont tous négatifs. Un score de -0,5 est donc préférable à -3.
Ce score est un critère de comparaison construit à partir des sorties du MLP. Ce n’est pas une probabilité calibrée que toute la liasse soit parfaitement séparée. Le décodeur ne consulte aucune annotation pour le calculer.
Le code complet du décodeur
La fonction suivante reçoit les logits des positions internes et la longueur maximale. np désigne NumPy ; score_segments et boundaries_of sont des auxiliaires du projet complet. Ce bloc n’est pas, à lui seul, un lecteur ou un exporteur PDF.
def decode(logits, maximum):
    logits = np.asarray(logits, dtype=np.float64)
    if (
        logits.ndim != 1
        or not np.isfinite(logits).all()
        or not isinstance(maximum, int)
        or maximum < 1
    ):
        raise ValueError("Invalid logits or length constraint")
    n = len(logits) + 1
    boundary = -np.logaddexp(0, -logits)
    within = -np.logaddexp(0, logits)
    prefix = np.concatenate([[0.0], np.cumsum(within)])
    best = np.full(n + 1, -np.inf)
    previous = np.full(n + 1, -1, dtype=int)
    best[0] = 0
    for end in range(1, n + 1):
        candidates = []
        for start in range(max(0, end - maximum), end):
            # Internal non-boundaries are start..end-2, then one boundary at
            # end-1 unless this is the final segment of the whole bundle.
            segment = (
                prefix[end - 1]
                - prefix[start]
                + (boundary[end - 1] if end < n else 0.0)
            )
            candidates.append((best[start] + segment, -start, start))
        value, _, start = max(candidates)
        best[end] = value
        previous[end] = start
    segments = []
    end = n
    while end:
        start = int(previous[end])
        segments.append([start, end])
        end = start
    segments.reverse()
    direct = score_segments(logits, segments)
    if abs(direct - float(best[n])) > 1e-8:
        raise ValueError("Boundary counted more than once")
    return {
        "segments": segments,
        "boundaries": boundaries_of(segments),
        "score": direct,
        "maximum": maximum,
    }
Nous allons suivre les quatre opérations importantes : contrôler l’entrée, noter un segment, mémoriser le meilleur parcours, puis reconstruire les plages.
1. Vérifier l’entrée et poser les bons indices
np.asarray(..., dtype=np.float64) prépare un tableau numérique à double précision. La fonction refuse un tableau qui n’est pas à une dimension, des valeurs non finies comme NaN ou l’infini, ainsi qu’une longueur qui ne satisfait pas le contrôle d’entier positif.
Il existe une nuance de Python : isinstance(True, int) vaut vrai, car bool est un sous-type de int. L’extrait accepte donc maximum=True comme une limite de 1. Ce contrôle ne doit pas être présenté comme un validateur strict de paramètres d’API ; cette validation serait à ajouter à l’interface d’une application réelle, sans modifier silencieusement le parcours de référence.
Le nombre de pages est déduit de n = len(logits) + 1. Trois logits décrivent quatre pages. Un tableau de logits vide décrit, dans cette convention, une liasse d’une page ; il ne permet pas à la fonction de distinguer un véritable PDF vide. La validation du document source appartient à une autre étape.
Les plages doivent respecter trois invariants, des propriétés qui restent toujours vraies : commencer à 0, finir à n et se toucher sans trou ni chevauchement. Elles doivent aussi être non vides et ne pas dépasser maximum.
2. Calculer les scores sans compter une frontière deux fois
Les tableaux boundary et within contiennent respectivement log(p) et log(1 - p). Ils utilisent np.logaddexp, qui calcule log(exp(a) + exp(b)) de façon adaptée à ces opérations numériques. Ainsi, le code travaille directement depuis les logits, sans arrondir d’abord une sigmoïde vers 0 ou 1 puis prendre son logarithme.
Pour un segment [start, end], les pages vont de start à end - 1. Les continuations à l’intérieur du segment se trouvent donc aux indices start à end - 2.
Prenons [0, 3] : il contient les pages 0, 1 et 2. On garde ensemble 0–1 et 1–2. Si d’autres pages suivent, on ajoute une coupure entre 2 et 3. Si 2 est la dernière page du fichier, cette coupure de sortie n’existe pas.
C’est exactement le rôle de boundary[end - 1] if end < n else 0.0. La fin du fichier n’ajoute pas une frontière interne artificielle.
Le tableau prefix contient les sommes cumulées de within. Pour additionner les continuations d’un segment, une soustraction suffit : prefix[end - 1] - prefix[start]. On retrouve le même principe qu’un total cumulé permettant de calculer un sous-total entre deux positions, sans refaire toute l’addition.
La frontière qui précède un segment a déjà été comptée par le segment précédent. Le nouveau segment compte ses continuations et, s’il y en a une, sa frontière de sortie. C’est ce partage qui évite le double comptage.
3. Garder le meilleur résultat pour chaque fin possible
La programmation dynamique repose ici sur une question : « Pour terminer un segment à cette page, quel début donne le meilleur score total ? »
best[end] mémorise le meilleur score pour les end premières pages. Une précision est importante dans cette implémentation : lorsque end < n, ce score inclut déjà la coupure de sortie après ces pages. previous[end] conserve le début du dernier segment retenu.
best[0] = 0 initialise le parcours avant toute page. Les autres scores commencent à moins l’infini, afin qu’un état non encore atteint ne gagne pas une comparaison.
Pour une fin end, la boucle explore tous les débuts de max(0, end - maximum) jusqu’à end - 1. Cela autorise des segments de 1 à maximum pages. Chaque candidat additionne le meilleur score déjà connu pour le préfixe et le score du nouveau segment.
Pourquoi un seul meilleur score par position suffit-il ? Dans ce code, le score du segment suivant ne dépend que de ses bornes et des logits qu’il utilise. Il n’a pas besoin de connaître le type ou le nombre des documents précédents. Réutiliser le meilleur préfixe ne retire donc aucune meilleure continuation possible pour ce critère.
À score exactement égal, le tuple (score, -start, start) départage les candidats. Python compare les tuples élément par élément : max préfère alors le plus petit start, donc le segment courant le plus long. C’est une convention déterministe, pas une information sur la nature du document. Elle ne signifie pas que le code minimise explicitement le nombre total de documents.
4. Revenir du score aux plages
Une fois la dernière position atteinte, while end remonte les prédécesseurs. La dernière plage est trouvée d’abord, puis l’avant-dernière, et ainsi de suite. segments.reverse() remet la liste dans l’ordre de lecture.
Le score des plages reconstruites est ensuite recalculé par score_segments. Un écart de plus de 1e-8 avec le score dynamique déclenche une erreur. Ce contrôle repère une incohérence de calcul ; il ne vérifie pas que les coupures correspondent aux documents attendus.
La sortie contient les plages segments, leurs frontières boundaries, le score et la limite maximum. Ni le nom du dossier cible ni un type métier de document ne sont inventés par cette fonction.
Refaire le calcul sur quatre pages
Voici un exemple pédagogique indépendant d’Atlas : les trois logits valent [-2, 3, -1] et maximum vaut 2. Le modèle favorise une seule coupure, entre la deuxième et la troisième page.
Les contributions utiles sont approximativement -0,1269 pour continuer à la première position, -0,0486 pour couper à la deuxième, et -0,3133 pour continuer à la troisième. La partition [0, 2], [2, 4] obtient donc un score de -0,4888.
La progression complète de best est la suivante. Rappelez-vous que les états intermédiaires incluent leur coupure de sortie.
Fin end |
Début retenu previous[end] |
Score best[end] |
|---|---|---|
| 1 | 0 | -2,1269 |
| 2 | 0 | -0,1755 |
| 3 | 2 | -1,4888 |
| 4 | 2 | -0,4888 |
Le retour arrière part de 4, trouve le début 2, puis repart de 2 et trouve 0. Après inversion de la liste, nous obtenons les deux plages attendues dans cet exemple. Les quatre pages sont présentes une seule fois.
La contrainte peut aussi forcer un compromis. Avec quatre pages, les logits illustratifs [-3, -0.2, -1] ne favorisent aucune coupure. Mais maximum=3 interdit de garder les quatre pages ensemble. Couper après la deuxième page ajoute la pénalité la moins forte, -0,2, contre -3 ou -1 aux autres positions. Le décodeur retient ici [0, 2], [2, 4], plutôt que de remplir mécaniquement un premier document de trois pages.
Ces petits calculs expliquent l’algorithme. Ils ne constituent pas de nouveaux résultats du corpus principal.
Ce que la contrainte ajoute — et ce qu’elle n’ajoute pas
Sans contrainte active, ce score global retrouve les décisions indépendantes au seuil 0,5, hors différences possibles de départage des égalités. On peut le voir directement : remplacer une continuation par une frontière fait varier le score de log(p) - log(1 - p), c’est-à-dire du logit. Un logit positif améliore le score en coupant ; un logit négatif le dégrade.
La programmation dynamique n’apporte donc pas un nouveau modèle de compréhension des documents. Elle optimise les mêmes indices locaux parmi les partitions autorisées. L’extrait ne reçoit d’ailleurs pas de seuil calibré en argument : il utilise directement les log-probabilités et maximum. On ne doit pas supposer qu’il reproduirait n’importe quel autre seuil choisi pour la méthode indépendante.
Cette contrainte est dure : un segment trop long est interdit, même si le modèle estime avec une très forte confiance qu’il faut garder ses pages ensemble. À l’inverse, pour tout maximum positif accepté, une solution en documents d’une page reste possible. Le décodeur ne s’abstient donc pas automatiquement lorsqu’une longueur semble incompatible avec le contenu. Une mise en revue demanderait une règle supplémentaire.
Comparer les méthodes et exporter les pages
docker compose run --rm inference python -m pdfbundles.cli baseline --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfbundles.cli evaluate --config configs/minimum.yaml
baseline calcule la référence simple ; evaluate produit les sorties de test et exporte les plages dans outputs/separated/. Ces commandes ne réentraînent pas le MLP et ne choisissent pas un nouveau seuil. L’exercice viendra ensuite.
Les 600 pages de test sont comparées aux sources par leur texte natif et par leurs pixels rendus à l’échelle du cours, dans le même ordre. Regardez ces contrôles comme vous regarderiez la vérification d’un export applicatif : a-t-on copié les éléments attendus, sans en oublier ni en répéter ?
Cela ne vérifie pas leur bon regroupement. Exporter fidèlement les pages 1 à 6 dans un même fichier reste une fusion incorrecte si elles appartiennent à deux documents de trois pages.
Le contrôle ne prouve pas non plus qu’un PDF arbitraire conservera ses signatures, formulaires ou annotations. Il compare les propriétés effectivement vérifiées sur les PDF générés, pas tous les objets et comportements possibles d’un PDF.
Interpréter le test sans masquer les faiblesses
Compter les décisions, puis les liasses complètes
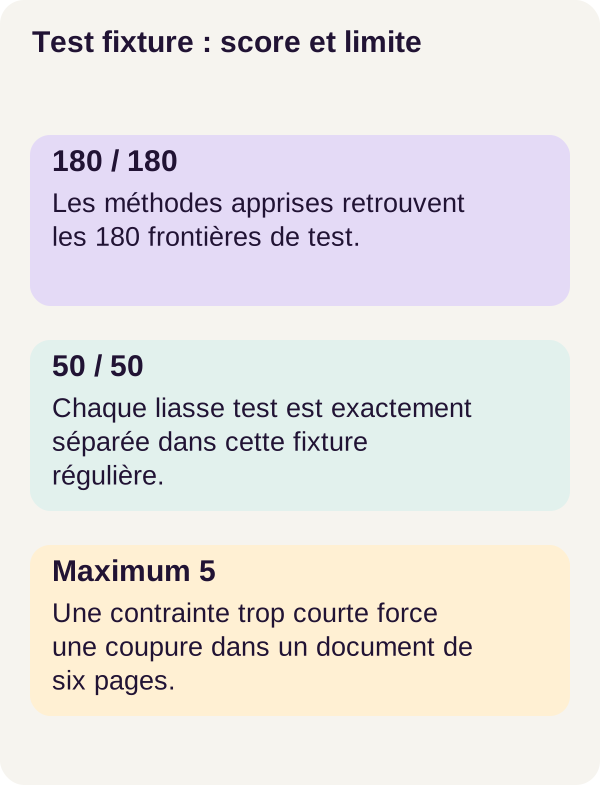
Le test contient 50 liasses, 600 pages et 550 décisions internes. Le compte se retrouve simplement : chaque liasse de n pages apporte n - 1 décisions ; sur l’ensemble, 600 - 50 = 550. Parmi ces positions, 180 sont de vraies frontières.
La précision demande : parmi les coupures prédites, combien sont justes ? Le rappel demande : parmi les coupures attendues, combien avons-nous retrouvées ? Le F1 est leur moyenne harmonique : 2 × précision × rappel / (précision + rappel).
Pour lire les résultats directement à partir des comptes, on peut aussi écrire F1 = 2 × TP / (2 × TP + FP + FN). Ici, TP compte les vraies frontières retrouvées, FP les surcoupes et FN les fusions dues à une frontière oubliée.
Enfin, une liasse exacte exige toutes ses plages correctes. Une seule mauvaise coupure suffit à faire échouer ce critère pour la liasse, même si les autres décisions sont justes. Le F1 des frontières et la fraction de liasses exactes répondent donc à deux questions différentes.
Résultats du parcours r002
Le tableau reprend les comptes publiés. Les deux méthodes apprises ont les mêmes résultats de qualité sur ce test ; elles partagent donc une colonne, sans être confondues avec une même implémentation.
| Mesure | Règle de numérotation | MLP + seuil 0,5 / MLP + décodeur dynamique |
|---|---|---|
| Vraies frontières retrouvées | 109/180 | 180/180 |
| Surcoupes | 22 | 0 |
| Fusions | 71 | 0 |
| F1 des frontières | 0,700965 | 1,00 |
| Liasses entièrement exactes | 30/50 | 50/50 |
| Frontières entre documents du même type retrouvées | 53/89 | 89/89 |
Refaisons le calcul pour la règle simple. Elle prédit 109 + 22 = 131 coupures. Sa précision vaut donc 109/131, environ 0,8321, et son rappel 109/180, environ 0,6056. Le F1 vaut 218/311, soit 0,700965 après arrondi. Ces deux premières valeurs sont calculées à partir des comptes publiés, pas issues d’une nouvelle expérience.
La règle donne 30 liasses entièrement exactes sur 50, soit 60 %. Elle retrouve seulement 53 des 89 frontières entre documents du même type. Une remise à 1 est un indice de pagination, pas un identifiant de dossier : c’est la faiblesse concrète que cette comparaison met en évidence.
Le MLP avec le seuil choisi sur validation et le décodeur dynamique atteignent tous deux F1 = 1,00, sans surcoupe ni fusion. La programmation dynamique ne gagne donc aucune qualité sur le test principal. Elle ajoute ici une politique de longueur, pas un bénéfice de précision démontré.
Temps de calcul et portée du résultat
Le décodage dynamique prend environ 0,000060 seconde par liasse, contre 0,000016 seconde pour le seuil. Cela correspond à environ 60 et 16 microsecondes. Ces temps concernent le décodage, pas la lecture des PDF, l’encodage MiniLM, l’apprentissage ou l’export complet.
Le parcours observé a duré 485,526 secondes, avec cache Docker public, dont 35 tests en 8,78 secondes. Ce n’est pas une mesure à froid ni un engagement de performance pour une autre machine.
Un jeu de données synthétique préparé pour un test est souvent appelé une fixture. Ici, les contenus, références et équipes suivent des patrons très réguliers. MiniLM reste gelé ; une seule graine aléatoire, ou seed, est utilisée. Il n’y a ni OCR — reconnaissance de texte à partir d’images — ni revue humaine dans les résultats présentés.
Le score parfait décrit donc cette fixture. Il ne démontre ni une réussite sur des scans, ni une robustesse aux documents de vos utilisateurs, ni l’utilité de la même limite de longueur dans un autre contexte.
Synthèse avant l’exercice
Nous avons construit trois niveaux séparés. Les textes et la géométrie fournissent les observations. Le MLP apprend un score par position de coupure, puis le seuil ou la programmation dynamique choisit les plages. Enfin, l’évaluation compare les coupures aux annotations et vérifie séparément les pages exportées.
La distinction importante est maintenant la suivante : une solution peut être optimale pour l’algorithme tout en étant fausse pour le document. C’est notamment le cas lorsque la bonne partition a été interdite par une contrainte. L’exercice va isoler cette situation, sans changer le modèle.
Exercice : une contrainte peut interdire la bonne réponse
Prédire avant de lancer
Imaginez une liasse de douze pages formée de deux documents de six pages. La référence attend les plages [0, 6] et [6, 12]. Le modèle fournit onze logits favorables à cette séparation.
Mais la configuration impose maximum=5. Le décodeur peut-il quand même conserver un document de six pages ? Une très forte confiance suffit-elle à passer outre cette limite ? Écrivez votre réponse avant d’exécuter la commande, puis prédisez ce qui change si la limite devient 8.
docker compose run --rm tutorial python -m pdfbundles.cli exercise --config configs/exercise.yaml
Observer, puis expliquer
La bonne partition est impossible avec une limite de 5 : aucun segment de six pages n’est admissible. Ce n’est pas nécessairement une erreur du MLP. La recherche n’a tout simplement pas le droit de retourner les deux documents entiers.
Dans l’exercice fourni, decode est relancé sur les mêmes onze logits, avec les limites 5 puis 8. Aucun modèle n’est réentraîné et le test principal n’est pas utilisé.
Avec 5, le résultat conserve la vraie frontière mais ajoute deux surcoupes. Cela donne une bonne coupure sur trois prédites : précision 1/3, rappel 1, puis F1 frontière = 0,5. Quatre segments remplacent les deux documents attendus.
Pourquoi quatre segments, alors que trois segments suffiraient à couvrir douze pages avec une limite de cinq ? Parce que couvrir toutes les pages n’est pas le seul critère. Pour conserver la vraie frontière après la sixième page, chacun des deux documents de six pages doit lui-même être coupé au moins une fois. C’est bien ce qui se produit dans cet exercice ; une simple division du nombre total de pages par la limite ne décrit pas la partition choisie.
Avec 8, les plages de six pages redeviennent admissibles et sont retrouvées ici : F1 = 1. La limite autorise cette réponse, elle ne commande pas de créer des documents de huit pages.
Relâcher une contrainte agrandit l’ensemble des solutions possibles, mais ne garantit pas de retrouver la référence dans toutes les liasses. Dans cet exercice, les scores privilégient la bonne solution dès qu’elle redevient autorisée. Sur un autre document, des scores erronés pourraient privilégier une mauvaise fusion.
La correction à retenir n’est donc pas « choisir 8 pour tous les PDF ». Il faut définir une politique compatible avec les documents attendus, puis la mesurer sur un ensemble distinct avant de l’exploiter.
Figures, jalons et nettoyage
Lire les sorties avant de les effacer
Consultez outputs/evaluation.json pour les mesures et outputs/exports.json pour les contrôles d’export. Ouvrez également les PDF de outputs/separated/ et les PNG disponibles. Revenez à une liasse précise : les frontières sont-elles justes, et chaque page a-t-elle été exportée au bon endroit ?
Les commandes suivantes génèrent les figures à partir des résultats existants, contrôlent les jalons, puis nettoient les sorties. Conservez les fichiers utiles avant de lancer le nettoyage, car les PDF exportés seront eux aussi supprimés.
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Le contrôle des jalons compare les copies de sources pédagogiques. Il ne remplace pas la comparaison des états d’entraînement déjà réalisée par verify-resume.
Le premier docker compose down est intentionnellement placé avant clean dans le parcours r002. clean --outputs-only affiche puis supprime uniquement outputs/ ; les sources, le corpus et les actifs restent présents. Le dernier down termine le parcours. Il n’y a pas lieu d’effectuer une purge globale de vos autres projets Docker.
Diagnostiquer le bon niveau
Le GPU fonctionne sous Linux mais pas dans le conteneur ? Reprenez le diagnostic du préflight et du contrôle d’environnement. La difficulté se situe alors dans l’accès au GPU depuis Docker, pas dans la décision de frontière.
L’acquisition refuse un fichier ? Vérifiez l’espace disponible et les contrôles de taille et d’empreinte. Substituer un autre modèle changerait l’expérience au lieu de résoudre le problème de reproduction.
La reprise diffère du continu ? Conservez les états et les messages de contrôle avant tout nettoyage. Une similarité de F1 ne suffit pas à conclure à une reprise identique.
Les exports sont fidèles, mais les documents sont mal regroupés ? Inspectez les scores et la limite de longueur. C’est le découpage qui doit être expliqué ; la copie des pages peut avoir parfaitement fonctionné.
Passer du cours à une application
Commencez par des liasses autorisées et représentatives, avec des annotations fiables et un test conservé à part. Définissez les longueurs admissibles avec les équipes qui connaissent les documents. Une limite choisie seulement pour faciliter le calcul peut interdire une pièce parfaitement normale.
Prévoyez une revue des cas peu confiants ou dont les longueurs semblent incompatibles. Dans une interface de back-office, cela pourrait prendre la forme d’aperçus des pages de part et d’autre d’une coupure, avec une possibilité de la confirmer ou de la déplacer. Cette interface est une piste d’adaptation, pas une fonctionnalité démontrée par le parcours r002.
Ajoutez des contrôles dédiés lorsque les documents comportent des signatures, formulaires, annotations, scans à traiter par OCR ou exigences d’accessibilité. Le contrôle du texte et des pixels de la fixture ne remplace pas ces vérifications.
Le fil conducteur reste simple : le modèle fournit des indices, le décodeur applique une politique, et l’évaluation vérifie séparément la justesse du découpage et la fidélité de l’export.
Téléchargez le cours r002 : ZIP r002.
Références pour approfondir
Les liens vers Sentence Transformers, PyTorch, NumPy, Python, Docker et NVIDIA éclairent les opérations expliquées au fil de l’article. Les petits exemples numériques sont pédagogiques ; les résultats Atlas restent ceux du parcours r002. Pour reproduire ce dernier, conservez les commandes, les configurations et les fichiers verrouillés du ZIP, sans les remplacer par les exemples d’installation des documentations courantes.