





Está añadiendo una importación de documentos a un back-office. Un usuario deposita un único PDF, pero este archivo contiene en realidad varias piezas que deben clasificarse por separado: una factura, otra factura y después un informe. ¿Dónde hay que cortar?
La primera idea parece sencilla: detectar los cambios de tipo. Pero dos facturas consecutivas siguen siendo dos facturas, incluso cuando corresponden a expedientes distintos. Otra idea es cortar cuando la numeración vuelve a 1. Es una pista útil, pero vamos a medir por qué no siempre basta.
Este tutorial construye una cadena que estima la presencia de una frontera entre dos páginas contiguas y luego reúne esas decisiones en documentos completos. Trabajamos con lotes ficticios «Atlas». El objetivo es entender y reproducir el mecanismo, no entregar un servicio de clasificación de documentos reales.
Descargar el ZIP del tutorial r002
Para un lote de nueve páginas, el resultado puede ser una sucesión de rangos: [0, 3], [3, 5], [5, 9]. Cada rango generará un PDF separado. Atención a la convención: el inicio se incluye y el final se excluye, como en un corte de array de Python pages[start:end].
| Rango | Índices de páginas conservadas | Páginas para el lector |
|---|---|---|
[0, 3] |
0, 1, 2 | 1 a 3 |
[3, 5] |
3, 4 | 4 a 5 |
[5, 9] |
5, 6, 7, 8 | 6 a 9 |
Por tanto, la página de índice 3 no se duplica: pertenece únicamente al segundo rango. Este ejemplo ilustra el formato de salida, sin describir una nueva ejecución del corpus.
Nuestro objetivo tiene dos requisitos distintos: encontrar los cortes correctos y después exportar las páginas correctas, en orden y sin pérdidas. Una exportación fiel puede contener un corte equivocado; una segmentación correcta no garantiza conservar todas las propiedades del PDF.
Conceptos útiles antes de ejecutar el modelo
Una pequeña pregunta binaria en lugar de una clasificación de negocio
Un lote es aquí un archivo que contiene varios documentos sucesivos. Entre dos páginas planteamos siempre la misma pregunta: «¿La página siguiente inicia un documento nuevo?». La respuesta esperada vale 1 para una frontera y 0 para una continuación. Es una clasificación binaria: solo hay dos posibilidades.
Un lote de n páginas tiene n - 1 posiciones de corte internas. Cuatro páginas dan por tanto tres decisiones. El comienzo y el final del archivo ya se conocen: no hace falta preguntar al modelo si existe una página antes de la primera o después de la última.
Una frontera real olvidada provoca una fusión: dos documentos permanecen en el mismo PDF. Una frontera añadida por error provoca una sobrecorte: un documento queda repartido en varios archivos. Estos errores son distintos y los contaremos por separado.
El modelo no aprende a decir «esto es una factura válida». Aprende a proponer una separación. Identificar después el tipo, el expediente o el estado de una pieza sería otra tarea.
Transformar el texto de las páginas en números
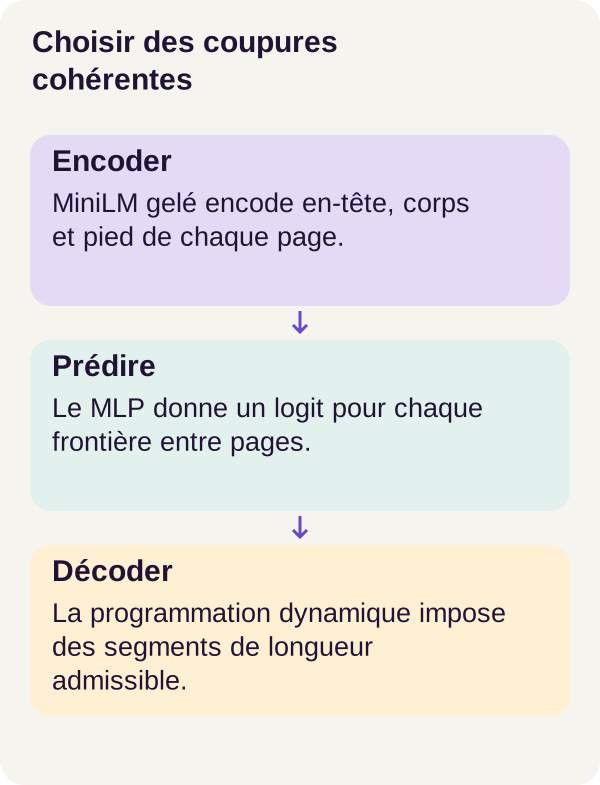
MiniLM cumple aquí el papel de codificador textual. No redacta una respuesta: transforma texto en vectores, es decir, listas de números que podrá usar el clasificador. Estas representaciones también se llaman embeddings.
El recorrido codifica por separado el encabezado, el cuerpo y el pie de cada página. Así conserva una distinción entre zonas, en vez de mezclarlas inmediatamente en una sola representación. Después, medidas de geometría observable completan la información textual.
Antes de codificar, el tokenizer divide el texto en unidades llamadas tokens. Un token puede ser una palabra, un fragmento de palabra o un signo; no es necesariamente una palabra completa. Tokens especiales también delimitan la secuencia. MiniLM produce una representación para cada posición.
Queda una dificultad práctica: dos textos no tienen necesariamente el mismo número de tokens. Para tratarlos juntos, se puede completar el más corto con padding, o relleno. Estas posiciones sirven para el cálculo por lotes, no para describir la página.
La máscara de atención distingue las posiciones conservadas del relleno. El pooling enmascarado calcula después una media de los vectores retenidos para obtener una representación de tamaño fijo. La documentación de Sentence Transformers sobre pooling presenta este paso de una secuencia de longitud variable a un vector de tamaño fijo.
Tomemos un pequeño cálculo ilustrativo, con vectores de dos dimensiones que no proceden de MiniLM. Dos posiciones válidas valen [2, 4] y [4, 2]; una posición de relleno vale [100, 100]. Con la máscara [1, 1, 0], la media es [3, 3]. Sin máscara sería aproximadamente [35,33 ; 35,33]: el relleno habría deformado por completo la representación.
Por ello hay que retirar su contribución y dividir por el número de posiciones válidas, no por la longitud del array completado. El código oficial del pooling enmascarado permite encontrar ambas operaciones.
Lo que aprende y lo que permanece fijo
Los pesos de MiniLM están congelados: no se modifican durante este aprendizaje. El codificador debe seguir calculando para representar las páginas; «congelado» no significa «sin coste de cálculo».
Solo se entrena la cabeza MLP, de perceptrón multicapa. Puede verla como una pequeña función numérica con parámetros ajustables: recibe las características de las dos páginas y produce una puntuación de frontera. Sus parámetros son números aprendidos, distintos de las características, que son los números recibidos como entrada.
Durante el entrenamiento, una función de pérdida mide la diferencia entre la salida del modelo y la respuesta esperada. La BCE, o entropía cruzada binaria, penaliza una confianza alta en el lado equivocado. Para una frontera real, anunciar una probabilidad de 0,9 da una penalización de -ln(0,9), aproximadamente 0,1054; anunciar 0,1 da aproximadamente 2,3026. Estos valores explican el cálculo, no son pérdidas medidas en Atlas.
El proyecto usa PyTorch y BCEWithLogitsLoss, que recibe directamente las puntuaciones brutas y combina las operaciones de forma numéricamente estable. Explicaremos estas puntuaciones, o logits, antes de leer el decodificador.
Tres métodos, tres funciones que comparar
El primer método es una baseline, un punto de comparación sencillo: cortar cuando el número de página visible vuelve a 1. No es un clasificador de tipos de documentos.
El segundo usa el MLP y después un umbral: cada posición de corte se decide por separado a partir de su probabilidad.
El tercero reutiliza las puntuaciones del MLP, pero elige una partición completa con una longitud máxima de documento. Usa programación dinámica, que leeremos como una búsqueda de soluciones que reutiliza resultados intermedios.
Los métodos se comparan sobre el mismo conjunto de prueba. Las anotaciones, también llamadas labels o gold, son las respuestas de referencia. Sirven para aprender o medir según su partición; no son una característica observable de la página. Los labels de prueba nunca se montan en los contenedores inference y learning.
El entrenamiento ajusta los parámetros, la validación escoge el umbral y la prueba mide la regla obtenida. Las restricciones de longitud también se declaran antes de la prueba. Ajustar esas opciones después de mirar las respuestas de prueba equivaldría a preparar la corrección con las soluciones abiertas.
Requisitos previos y comprobación del entorno
Debe saber leer Python, usar una terminal y ejecutar Docker. PyTorch realiza el aprendizaje; NumPy interviene especialmente en el decodificador. Los conceptos de clasificación binaria son los que acabamos de introducir.
El recorrido de referencia está previsto para Linux con GPU. Se recomiendan una RTX 3090 de 24 GiB, 24 GiB de RAM y 25 GiB de disco. La VRAM es la memoria de la tarjeta gráfica; la RAM es la de la máquina. El recorrido r002 usó realmente una RTX 3090, pero estas indicaciones no son mínimos garantizados para todas las configuraciones. Los resultados presentados no establecen un recorrido equivalente en CPU.
Descomprima el ZIP y abra una terminal en su raíz. Todos los comandos siguientes parten de esta carpeta, en el orden indicado. Las versiones y los archivos bloqueados del proyecto constituyen la referencia que debe reproducirse; las documentaciones enlazadas sirven para comprender los mecanismos, no para sustituir sus dependencias.
Una GPU visible con nvidia-smi en el host no es necesariamente utilizable en Docker. NVIDIA Container Toolkit proporciona la integración necesaria con el motor de contenedores. El diagnóstico del recorrido indica su ausencia y la acción esperada, sin instalarlo por usted. La variable GPU_DEVICE=1 puede seleccionar otra tarjeta antes de iniciar el recorrido, según la configuración proporcionada.
Comprobar el host y construir los servicios
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference learning
El preflight es la comprobación previa: Docker, Compose, memoria, espacio en disco y visibilidad de la GPU en Linux. Después se ejecuta el script de preparación, Compose valida la configuración y construye los cuatro servicios.
docker compose config --quiet termina correctamente sin mostrar la configuración cuando esta es válida; es el comportamiento documentado de la opción --quiet. La ausencia de texto no invita a ignorar un código de salida de error.
Adquirir MiniLM y calcular realmente en Docker
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
La adquisición descarga los archivos de MiniLM y compara su tamaño y su huella SHA-256 con los valores esperados. Esta huella identifica el contenido de los archivos. El reemplazo atómico evita instalar un archivo adquirido parcialmente en lugar del recurso esperado. El ZIP no incluye pesos.
check_environment.py va más allá de la comprobación del host: carga realmente MiniLM en Docker y calcula en la GPU. Por último, las pruebas verifican especialmente la programación dinámica, las exportaciones y la restricción de longitud. El recorrido de referencia informa de 35 pruebas superadas; superarlas no significa que todos los lotes reales se separen correctamente.
Fabricar decisiones de frontera
Preparar los documentos sin dar sus respuestas al codificador
docker compose run --rm tutorial python -m pdfbundles.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m pdfbundles.cli features --config configs/minimum.yaml
prepare genera los lotes ficticios y separa sus anotaciones. features construye las características de las páginas adyacentes en el contenedor que no ve esos labels. El entrenamiento utilizará después la supervisión permitida, pero los cortes gold de prueba permanecen reservados para la evaluación.
Para un par de páginas, el informe r002 indica un vector de 3 480 valores suministrado al MLP y 462 209 parámetros entrenables en la cabeza. El primer número describe la entrada; el segundo, la función aprendida. No los confunda con un número de páginas o documentos.
Estas dimensiones corresponden a la configuración del ZIP. El nombre «MiniLM» por sí solo no permite reconstruir el ensamblaje exacto de características: para modificarlo hay que seguir su construcción en el proyecto, sin inventar columnas adicionales a partir del total.
Entrenar, interrumpir, reanudar
docker compose run --rm learning python -m pdfbundles.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m pdfbundles.cli train --mode continuous --config configs/minimum.yaml
docker compose run --rm learning python -m pdfbundles.cli train --mode resume --config configs/minimum.yaml
docker compose run --rm learning python -m pdfbundles.cli verify-resume --config configs/minimum.yaml
Una época es un paso por los ejemplos de entrenamiento. El presupuesto total es aquí de quince épocas. El modo interrupt crea un recorrido interrumpido; continuous proporciona un testigo entrenado sin esa interrupción; resume retoma el cálculo interrumpido. No se trata de entrenar tres veces seguidas el mismo modelo para acumular cuarenta y cinco épocas.
Un checkpoint es un estado guardado que permite continuar o controlar el cálculo. verify-resume compara los estados obtenidos para comprobar que la interrupción y la reanudación recuperan el resultado del recorrido continuo.
Es una comprobación de reproducibilidad, no una medida de calidad documental. Dos ejecuciones pueden reproducir exactamente los mismos errores. La identidad observada también vale para este entorno: la documentación de PyTorch sobre reproducibilidad recuerda que un cambio de plataforma o versión puede modificar los resultados.
Elegir el umbral en la validación
docker compose run --rm learning python -m pdfbundles.cli calibrate --config configs/minimum.yaml
calibrate selecciona el umbral con el conjunto de validación. Un umbral más bajo puede activar más cortes; uno más alto puede olvidar más. La evaluación debe medir este compromiso en lugar de suponer que una elección siempre es preferible.
El recorrido retiene 0,5. Aquí el nombre del comando calibrate describe la elección de esta regla de decisión. No demuestra que todas las probabilidades anunciadas por el modelo correspondan a las frecuencias de error de una aplicación real.
De logits locales a documentos completos
Leer un logit antes de decidir
Un logit es un número bruto que puede ser negativo o positivo. La función sigmoide lo transforma en una probabilidad de frontera: p = 1 / (1 + exp(-logit)). Su definición aparece en la documentación de PyTorch de Sigmoid.
| Logit ilustrativo | Probabilidad aproximada | Tendencia con umbral 0,5 |
|---|---|---|
| -2 | 0,1192 | Continuar el documento |
| 0 | 0,5000 | Empate que se resuelve según la convención |
| 3 | 0,9526 | Cortar |
Con un umbral de 0,5, un logit estrictamente positivo favorece por tanto la frontera y uno estrictamente negativo favorece la continuación. Una puntuación de 3 no significa «tres fronteras» ni «tres páginas».
El umbral independiente trata cada posición por separado. Basta para producir rangos consecutivos, pero no les impone una longitud máxima. La programación dinámica añade precisamente esta restricción.
Puntuar una partición completa
Para evaluar una segmentación, el programa elige una contribución en cada posición interna: log(p) si corta, log(1 - p) si mantiene juntas las dos páginas. Después suma esas contribuciones.
¿Por qué logaritmos? Multiplicar muchas probabilidades puede producir números diminutos. Sumar sus logaritmos conserva la clasificación de los productos y facilita el cálculo. La puntuación obtenida es negativa o nula; la mayor es la mejor, incluso cuando todas son negativas. Por tanto, una puntuación de -0,5 es preferible a -3.
Esta puntuación es un criterio de comparación construido a partir de las salidas del MLP. No es una probabilidad calibrada de que todo el lote esté perfectamente separado. El decodificador no consulta ninguna anotación para calcularla.
El código completo del decodificador
La función siguiente recibe los logits de las posiciones internas y la longitud máxima. np designa NumPy; score_segments y boundaries_of son auxiliares del proyecto completo. Este bloque no es, por sí solo, un lector ni un exportador de PDF.
def decode(logits, maximum):
    logits = np.asarray(logits, dtype=np.float64)
    if (
        logits.ndim != 1
        or not np.isfinite(logits).all()
        or not isinstance(maximum, int)
        or maximum < 1
    ):
        raise ValueError("Invalid logits or length constraint")
    n = len(logits) + 1
    boundary = -np.logaddexp(0, -logits)
    within = -np.logaddexp(0, logits)
    prefix = np.concatenate([[0.0], np.cumsum(within)])
    best = np.full(n + 1, -np.inf)
    previous = np.full(n + 1, -1, dtype=int)
    best[0] = 0
    for end in range(1, n + 1):
        candidates = []
        for start in range(max(0, end - maximum), end):
            # Internal non-boundaries are start..end-2, then one boundary at
            # end-1 unless this is the final segment of the whole bundle.
            segment = (
                prefix[end - 1]
                - prefix[start]
                + (boundary[end - 1] if end < n else 0.0)
            )
            candidates.append((best[start] + segment, -start, start))
        value, _, start = max(candidates)
        best[end] = value
        previous[end] = start
    segments = []
    end = n
    while end:
        start = int(previous[end])
        segments.append([start, end])
        end = start
    segments.reverse()
    direct = score_segments(logits, segments)
    if abs(direct - float(best[n])) > 1e-8:
        raise ValueError("Boundary counted more than once")
    return {
        "segments": segments,
        "boundaries": boundaries_of(segments),
        "score": direct,
        "maximum": maximum,
    }
Seguiremos las cuatro operaciones importantes: comprobar la entrada, puntuar un segmento, guardar el mejor recorrido y reconstruir los rangos.
1. Comprobar la entrada y establecer los índices correctos
np.asarray(..., dtype=np.float64) prepara un array numérico de doble precisión. La función rechaza un array que no tenga una dimensión, valores no finitos como NaN o infinito, y una longitud que no cumpla la comprobación de entero positivo.
Hay un matiz de Python: isinstance(True, int) vale verdadero, porque bool es un subtipo de int. Por ello, el extracto acepta maximum=True como límite de 1. Este control no debe presentarse como un validador estricto de parámetros de API; habría que añadir esa validación a la interfaz de una aplicación real, sin modificar silenciosamente el recorrido de referencia.
El número de páginas se deduce de n = len(logits) + 1. Tres logits describen cuatro páginas. Un array de logits vacío describe, según esta convención, un lote de una página; no permite a la función distinguir un PDF vacío real. La validación del documento de origen pertenece a otra etapa.
Los rangos deben respetar tres invariantes, propiedades que siempre siguen siendo verdaderas: empezar en 0, terminar en n y tocarse sin hueco ni solapamiento. También deben ser no vacíos y no superar maximum.
2. Calcular las puntuaciones sin contar dos veces una frontera
Los arrays boundary y within contienen respectivamente log(p) y log(1 - p). Usan np.logaddexp, que calcula log(exp(a) + exp(b)) de una manera adaptada a estas operaciones numéricas. Así, el código trabaja directamente desde los logits, sin redondear primero una sigmoide a 0 o 1 y luego tomar su logaritmo.
Para un segmento [start, end], las páginas van de start a end - 1. Las continuaciones dentro del segmento se sitúan por tanto en los índices start a end - 2.
Tomemos [0, 3]: contiene las páginas 0, 1 y 2. Se mantienen juntas 0–1 y 1–2. Si siguen más páginas, se añade un corte entre 2 y 3. Si 2 es la última página del archivo, ese corte de salida no existe.
Ese es exactamente el papel de boundary[end - 1] if end < n else 0.0. El final del archivo no añade una frontera interna artificial.
El array prefix contiene las sumas acumuladas de within. Para sumar las continuaciones de un segmento basta una resta: prefix[end - 1] - prefix[start]. Es el mismo principio que un total acumulado para calcular un subtotal entre dos posiciones sin repetir toda la suma.
La frontera que precede a un segmento ya fue contada por el segmento anterior. El nuevo segmento cuenta sus continuaciones y, si existe, su frontera de salida. Este reparto evita el doble conteo.
3. Conservar el mejor resultado para cada final posible
La programación dinámica se basa aquí en una pregunta: «Para terminar un segmento en esta página, ¿qué inicio da la mejor puntuación total?».
best[end] guarda la mejor puntuación de las end primeras páginas. Un detalle importante de esta implementación: cuando end < n, esta puntuación ya incluye el corte de salida después de esas páginas. previous[end] conserva el inicio del último segmento retenido.
best[0] = 0 inicializa el recorrido antes de cualquier página. Las otras puntuaciones empiezan en menos infinito, para que un estado aún no alcanzado no gane una comparación.
Para un final end, el bucle explora todos los inicios desde max(0, end - maximum) hasta end - 1. Esto autoriza segmentos de 1 a maximum páginas. Cada candidato suma la mejor puntuación ya conocida para el prefijo y la puntuación del nuevo segmento.
¿Por qué basta un único mejor resultado por posición? En este código, la puntuación del segmento siguiente solo depende de sus límites y de los logits que usa. No necesita conocer el tipo ni el número de documentos anteriores. Reutilizar el mejor prefijo no elimina por ello ninguna continuación mejor posible para este criterio.
Con una puntuación exactamente igual, la tupla (score, -start, start) desempata los candidatos. Python compara las tuplas elemento a elemento: max prefiere entonces el menor start, es decir, el segmento actual más largo. Es una convención determinista, no información sobre la naturaleza del documento. No significa que el código minimice explícitamente el número total de documentos.
4. Volver de la puntuación a los rangos
Una vez alcanzada la última posición, while end remonta los predecesores. Primero se encuentra el último rango, luego el anterior, y así sucesivamente. segments.reverse() devuelve la lista al orden de lectura.
Después se recalcula la puntuación de los rangos reconstruidos con score_segments. Una diferencia superior a 1e-8 con la puntuación dinámica desencadena un error. Esta comprobación detecta una incoherencia de cálculo; no verifica que los cortes correspondan a los documentos esperados.
La salida contiene los rangos segments, sus fronteras boundaries, la score y el límite maximum. Esta función no inventa ni el nombre de la carpeta de destino ni un tipo de documento de negocio.
Rehacer el cálculo con cuatro páginas
Este es un ejemplo pedagógico independiente de Atlas: los tres logits valen [-2, 3, -1] y maximum vale 2. El modelo favorece un único corte, entre la segunda y la tercera página.
Las contribuciones útiles son aproximadamente -0,1269 para continuar en la primera posición, -0,0486 para cortar en la segunda y -0,3133 para continuar en la tercera. La partición [0, 2], [2, 4] obtiene por tanto una puntuación de -0,4888.
La evolución completa de best es la siguiente. Recuerde que los estados intermedios incluyen su corte de salida.
Final end |
Inicio retenido previous[end] |
Puntuación best[end] |
|---|---|---|
| 1 | 0 | -2,1269 |
| 2 | 0 | -0,1755 |
| 3 | 2 | -1,4888 |
| 4 | 2 | -0,4888 |
El recorrido hacia atrás parte de 4, encuentra el inicio 2, vuelve a partir de 2 y encuentra 0. Tras invertir la lista, obtenemos los dos rangos esperados en este ejemplo. Las cuatro páginas están presentes una sola vez.
La restricción también puede forzar un compromiso. Con cuatro páginas, los logits ilustrativos [-3, -0.2, -1] no favorecen ningún corte. Pero maximum=3 impide mantener juntas las cuatro páginas. Cortar tras la segunda añade la penalización menos fuerte, -0,2, frente a -3 o -1 en las demás posiciones. El decodificador retiene aquí [0, 2], [2, 4], en vez de llenar mecánicamente un primer documento de tres páginas.
Estos pequeños cálculos explican el algoritmo. No constituyen resultados nuevos del corpus principal.
Lo que añade la restricción y lo que no añade
Sin restricción activa, esta puntuación global recupera las decisiones independientes con umbral 0,5, salvo posibles diferencias al desempatar. Se ve directamente: sustituir una continuación por una frontera cambia la puntuación en log(p) - log(1 - p), es decir, en el logit. Un logit positivo mejora la puntuación al cortar; uno negativo la empeora.
La programación dinámica no aporta por tanto un nuevo modelo de comprensión de documentos. Optimiza los mismos indicios locales entre las particiones autorizadas. Además, el extracto no recibe un umbral calibrado como argumento: usa directamente las log-probabilidades y maximum. No debe suponerse que reproduciría cualquier otro umbral elegido para el método independiente.
Esta restricción es dura: un segmento demasiado largo queda prohibido, incluso si el modelo estima con mucha confianza que sus páginas deben mantenerse juntas. A la inversa, para cualquier maximum positivo aceptado, siempre sigue siendo posible una solución de documentos de una página. Por tanto, el decodificador no se abstiene automáticamente cuando una longitud parece incompatible con el contenido. Una revisión requeriría una regla adicional.
Comparar los métodos y exportar las páginas
docker compose run --rm inference python -m pdfbundles.cli baseline --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfbundles.cli evaluate --config configs/minimum.yaml
baseline calcula la referencia sencilla; evaluate produce las salidas de prueba y exporta los rangos a outputs/separated/. Estos comandos no vuelven a entrenar el MLP ni eligen un nuevo umbral. El ejercicio viene después.
Las 600 páginas de prueba se comparan con las fuentes por su texto nativo y por sus píxeles renderizados a la escala del curso, en el mismo orden. Observe estos controles como la verificación de una exportación de aplicación: ¿se copiaron los elementos esperados sin olvidar ni repetir ninguno?
Esto no verifica que estén bien agrupadas. Exportar fielmente las páginas 1 a 6 en un mismo archivo sigue siendo una fusión incorrecta si pertenecen a dos documentos de tres páginas.
El control tampoco prueba que un PDF arbitrario conservará sus firmas, formularios o anotaciones. Compara las propiedades realmente comprobadas en los PDF generados, no todos los objetos y comportamientos posibles de un PDF.
Interpretar la prueba sin ocultar sus debilidades
Contar las decisiones y después los lotes completos
La prueba contiene 50 lotes, 600 páginas y 550 decisiones internas. El cálculo es sencillo: cada lote de n páginas aporta n - 1 decisiones; en total, 600 - 50 = 550. Entre estas posiciones, 180 son fronteras reales.
La precisión pregunta: entre los cortes predichos, ¿cuántos son correctos? El recall pregunta: entre los cortes esperados, ¿cuántos hemos encontrado? El F1 es su media armónica: 2 × precisión × recall / (precisión + recall).
Para leer los resultados directamente a partir de los recuentos, también se puede escribir F1 = 2 × TP / (2 × TP + FP + FN). Aquí, TP cuenta las fronteras reales encontradas, FP los sobrecortes y FN las fusiones debidas a una frontera olvidada.
Por último, un lote exacto exige que todos sus rangos sean correctos. Basta un corte erróneo para que este criterio falle para el lote, aunque las demás decisiones sean correctas. El F1 de fronteras y la proporción de lotes exactos responden por tanto a dos preguntas diferentes.
Resultados del recorrido r002
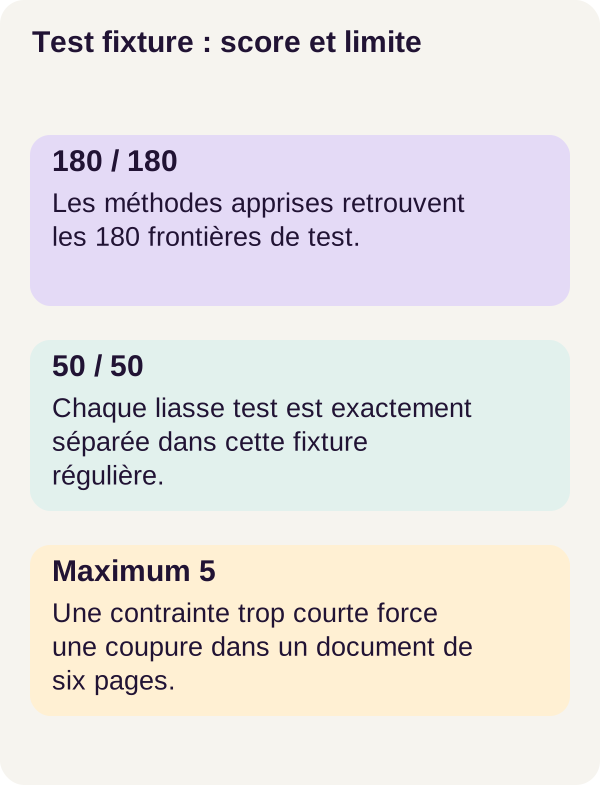
La tabla recoge los recuentos publicados. Los dos métodos aprendidos tienen los mismos resultados de calidad en esta prueba; por eso comparten una columna, sin confundirse con una misma implementación.
| Medida | Regla de numeración | MLP + umbral 0,5 / MLP + decodificador dinámico |
|---|---|---|
| Fronteras reales encontradas | 109/180 | 180/180 |
| Sobrecortes | 22 | 0 |
| Fusiones | 71 | 0 |
| F1 de fronteras | 0,700965 | 1,00 |
| Lotes completamente exactos | 30/50 | 50/50 |
| Fronteras encontradas entre documentos del mismo tipo | 53/89 | 89/89 |
Rehagamos el cálculo para la regla sencilla. Predice 109 + 22 = 131 cortes. Su precisión vale por tanto 109/131, aproximadamente 0,8321, y su recall 109/180, aproximadamente 0,6056. El F1 vale 218/311, es decir, 0,700965 tras redondear. Estos dos primeros valores se calculan a partir de los recuentos publicados, no proceden de una nueva experiencia.
La regla da 30 lotes completamente exactos de 50, es decir, el 60 %. Solo encuentra 53 de las 89 fronteras entre documentos del mismo tipo. Una vuelta a 1 es una pista de paginación, no un identificador de expediente: esa es la debilidad concreta que pone de manifiesto esta comparación.
El MLP con el umbral elegido en validación y el decodificador dinámico alcanzan ambos F1 = 1,00, sin sobrecorte ni fusión. Por tanto, la programación dinámica no gana ninguna calidad en la prueba principal. Añade aquí una política de longitud, no una mejora de precisión demostrada.
Tiempo de cálculo y alcance del resultado
El decodificado dinámico tarda aproximadamente 0,000060 segundos por lote, frente a 0,000016 segundos para el umbral. Esto equivale a unos 60 y 16 microsegundos. Estos tiempos se refieren al decodificado, no a la lectura de PDF, la codificación MiniLM, el aprendizaje ni la exportación completa.
El recorrido observado duró 485,526 segundos, con caché pública de Docker, incluidas 35 pruebas en 8,78 segundos. No es una medición en frío ni un compromiso de rendimiento para otra máquina.
Un conjunto de datos sintético preparado para una prueba suele llamarse fixture. Aquí, los contenidos, referencias y equipos siguen patrones muy regulares. MiniLM permanece congelado; se usa una sola semilla aleatoria, o seed. No hay OCR —reconocimiento de texto a partir de imágenes— ni revisión humana en los resultados presentados.
La puntuación perfecta describe por tanto esta fixture. No demuestra éxito en escaneos, robustez con documentos de sus usuarios ni la utilidad del mismo límite de longitud en otro contexto.
Síntesis antes del ejercicio
Hemos construido tres niveles separados. Los textos y la geometría aportan las observaciones. El MLP aprende una puntuación por posición de corte; después, el umbral o la programación dinámica elige los rangos. Por último, la evaluación compara los cortes con las anotaciones y verifica por separado las páginas exportadas.
La distinción importante es ahora la siguiente: una solución puede ser óptima para el algoritmo y, al mismo tiempo, falsa para el documento. Esto ocurre especialmente cuando una restricción prohibió la partición correcta. El ejercicio aislará esta situación sin cambiar el modelo.
Ejercicio: una restricción puede prohibir la respuesta correcta
Predecir antes de ejecutar
Imagine un lote de doce páginas formado por dos documentos de seis páginas. La referencia espera los rangos [0, 6] y [6, 12]. El modelo proporciona once logits favorables a esta separación.
Pero la configuración impone maximum=5. ¿Puede el decodificador conservar aun así un documento de seis páginas? ¿Basta una confianza muy alta para ignorar este límite? Escriba su respuesta antes de ejecutar el comando y prediga qué cambia si el límite pasa a ser 8.
docker compose run --rm tutorial python -m pdfbundles.cli exercise --config configs/exercise.yaml
Observar y después explicar
La partición correcta es imposible con un límite de 5: ningún segmento de seis páginas es admisible. No es necesariamente un error del MLP. La búsqueda simplemente no tiene derecho a devolver los dos documentos completos.
En el ejercicio proporcionado, decode se ejecuta de nuevo sobre los mismos once logits, con los límites 5 y después 8. No se vuelve a entrenar ningún modelo ni se usa la prueba principal.
Con 5, el resultado conserva la frontera real pero añade dos sobrecortes. Esto da un corte correcto entre tres predichos: precisión 1/3, recall 1 y después F1 de frontera = 0,5. Cuatro segmentos sustituyen a los dos documentos esperados.
¿Por qué cuatro segmentos, cuando tres bastarían para cubrir doce páginas con un límite de cinco? Porque cubrir todas las páginas no es el único criterio. Para conservar la frontera real tras la sexta página, cada uno de los dos documentos de seis páginas debe cortarse a su vez al menos una vez. Eso es lo que ocurre en este ejercicio; una simple división del número total de páginas por el límite no describe la partición elegida.
Con 8, los rangos de seis páginas vuelven a ser admisibles y se recuperan aquí: F1 = 1. El límite autoriza esta respuesta, no ordena crear documentos de ocho páginas.
Relajar una restricción amplía el conjunto de soluciones posibles, pero no garantiza recuperar la referencia en todos los lotes. En este ejercicio, las puntuaciones favorecen la solución correcta desde que vuelve a estar autorizada. En otro documento, puntuaciones erróneas podrían favorecer una fusión equivocada.
La conclusión no es por tanto «elegir 8 para todos los PDF». Hay que definir una política compatible con los documentos esperados y medirla en un conjunto distinto antes de utilizarla.
Figuras, hitos y limpieza
Leer las salidas antes de borrarlas
Consulte outputs/evaluation.json para las medidas y outputs/exports.json para los controles de exportación. Abra también los PDF de outputs/separated/ y los PNG disponibles. Vuelva a un lote concreto: ¿son correctas las fronteras y se exportó cada página en el lugar adecuado?
Los comandos siguientes generan las figuras a partir de resultados existentes, controlan los hitos y después limpian las salidas. Conserve los archivos útiles antes de iniciar la limpieza, porque los PDF exportados también se eliminarán.
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
El control de hitos compara las copias de fuentes pedagógicas. No sustituye la comparación de estados de entrenamiento ya realizada por verify-resume.
El primer docker compose down se coloca intencionadamente antes de clean en el recorrido r002. clean --outputs-only muestra y después elimina únicamente outputs/; las fuentes, el corpus y los activos permanecen presentes. El último down termina el recorrido. No hay razón para realizar una purga global de sus otros proyectos Docker.
Diagnosticar el nivel correcto
¿La GPU funciona en Linux pero no en el contenedor? Retome el diagnóstico del preflight y del control de entorno. La dificultad está entonces en el acceso a la GPU desde Docker, no en la decisión de frontera.
¿La adquisición rechaza un archivo? Compruebe el espacio disponible y los controles de tamaño y huella. Sustituir otro modelo cambiaría la experiencia en vez de resolver el problema de reproducción.
¿La reanudación difiere de la ejecución continua? Conserve los estados y los mensajes de control antes de limpiar. Una similitud de F1 no basta para concluir que la reanudación es idéntica.
¿Las exportaciones son fieles, pero los documentos están mal agrupados? Inspeccione las puntuaciones y el límite de longitud. Hay que explicar la segmentación; la copia de páginas puede haber funcionado perfectamente.
Pasar del curso a una aplicación
Empiece con lotes autorizados y representativos, con anotaciones fiables y una prueba reservada aparte. Defina las longitudes admisibles con los equipos que conocen los documentos. Un límite elegido solo para facilitar el cálculo puede prohibir una pieza perfectamente normal.
Prevea una revisión de los casos poco confiables o cuyas longitudes parezcan incompatibles. En una interfaz de back-office, podría adoptar la forma de vistas previas de las páginas a ambos lados de un corte, con la posibilidad de confirmarlo o desplazarlo. Esta interfaz es una pista de adaptación, no una funcionalidad demostrada por el recorrido r002.
Añada controles específicos cuando los documentos tengan firmas, formularios, anotaciones, escaneos que deban tratarse con OCR o requisitos de accesibilidad. El control del texto y los píxeles de la fixture no sustituye estas comprobaciones.
El hilo conductor sigue siendo sencillo: el modelo proporciona indicios, el decodificador aplica una política y la evaluación comprueba por separado la corrección de la segmentación y la fidelidad de la exportación.
Descargue el curso r002: ZIP r002.
Referencias para profundizar
Los enlaces a Sentence Transformers, PyTorch, NumPy, Python, Docker y NVIDIA aclaran las operaciones explicadas a lo largo del artículo. Los pequeños ejemplos numéricos son pedagógicos; los resultados de Atlas siguen siendo los del recorrido r002. Para reproducir este último, conserve los comandos, las configuraciones y los archivos bloqueados del ZIP, sin sustituirlos por los ejemplos de instalación de las documentaciones actuales.