





State aggiungendo un’importazione di documenti a un back office. Un utente carica un solo PDF, ma il file contiene in realtà più documenti da archiviare separatamente: una fattura, un’altra fattura, poi un rapporto. Dove occorre separarlo?
La prima idea sembra semplice: individuare i cambiamenti di tipo. Ma due fatture consecutive restano due fatture, anche quando riguardano pratiche diverse. Un’altra idea è separare quando la numerazione ricomincia da 1. È un indizio utile, ma misureremo perché non basta sempre.
Questo tutorial costruisce una catena che stima la presenza di un confine tra due pagine adiacenti, poi riunisce queste decisioni in documenti completi. Lavoriamo su fascicoli fittizi «Atlas». L’obiettivo è capire e riprodurre il meccanismo, non fornire un servizio di classificazione di documenti reali.
Scaricare lo ZIP del tutorial r002
Per un fascicolo di nove pagine, il risultato può essere una sequenza di intervalli: [0, 3], [3, 5], [5, 9]. Ogni intervallo genererà un PDF separato. Attenzione alla convenzione: l’inizio è incluso, la fine è esclusa, come in una slice di array Python pages[start:end].
| Intervallo | Indici delle pagine conservate | Pagine per il lettore |
|---|---|---|
[0, 3] |
0, 1, 2 | da 1 a 3 |
[3, 5] |
3, 4 | da 4 a 5 |
[5, 9] |
5, 6, 7, 8 | da 6 a 9 |
La pagina con indice 3 non viene quindi duplicata: appartiene soltanto al secondo intervallo. Questo esempio illustra il formato di output, senza descrivere una nuova esecuzione sul corpus.
Il nostro obiettivo ha due requisiti distinti: ritrovare le separazioni corrette, poi esportare le pagine giuste, nell’ordine e senza perdite. Un’esportazione fedele può contenere una separazione errata; una segmentazione corretta non garantisce la conservazione di tutte le proprietà del PDF.
Concetti utili prima di eseguire il modello
Una piccola domanda binaria invece di una classificazione professionale
Un fascicolo è qui un file che contiene più documenti consecutivi. Tra due pagine poniamo sempre la stessa domanda: «La pagina seguente inizia un nuovo documento?» La risposta attesa vale 1 per un confine e 0 per una continuazione. È una classificazione binaria: esistono soltanto due possibilità.
Un fascicolo di n pagine possiede n - 1 posizioni di separazione interne. Quattro pagine producono quindi tre decisioni. L’inizio e la fine del file sono già noti: non è necessario chiedere al modello se esista una pagina prima della prima o dopo l’ultima.
Un vero confine dimenticato provoca una fusione: due documenti rimangono nello stesso PDF. Un confine aggiunto per errore provoca una sovrasegmentazione: un documento si ritrova distribuito in più file. Questi errori sono diversi e li conteremo separatamente.
Il modello non impara a dire «questa è una fattura valida». Impara a proporre una separazione. Identificare poi il tipo, la pratica o lo stato di un documento sarebbe un altro compito.
Trasformare il testo delle pagine in numeri
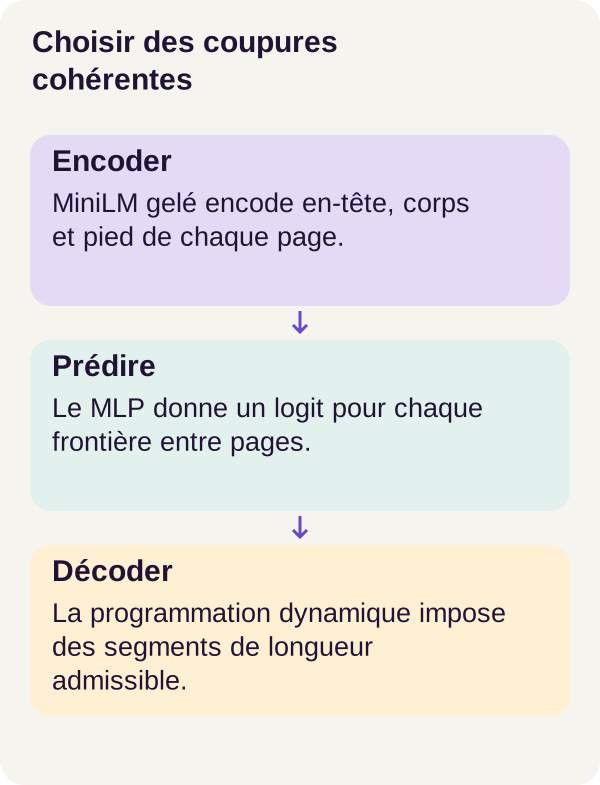
MiniLM svolge qui il ruolo di codificatore testuale. Non redige una risposta: trasforma il testo in vettori, cioè liste di numeri che il classificatore potrà usare. Queste rappresentazioni sono anche chiamate embedding.
Il percorso codifica separatamente intestazione, corpo e piè di pagina di ogni pagina. In questo modo conserva una distinzione tra le zone, invece di mescolarle subito in un’unica rappresentazione. Misure della geometria osservabile completano poi le informazioni testuali.
Prima della codifica, il tokenizer suddivide il testo in unità chiamate token. Un token può essere una parola, un frammento di parola o un segno; non è necessariamente una parola completa. Token speciali delimitano inoltre la sequenza. MiniLM produce una rappresentazione per ogni posizione.
Resta una difficoltà pratica: due testi non hanno necessariamente lo stesso numero di token. Per elaborarli insieme, si può completare il più breve con del padding, o riempimento. Queste posizioni servono al calcolo in batch, non a descrivere la pagina.
La maschera di attenzione distingue le posizioni conservate dal riempimento. Il pooling mascherato calcola poi una media dei vettori mantenuti per ottenere una rappresentazione di dimensione fissa. La documentazione di Sentence Transformers sul pooling presenta questo passaggio da una sequenza di lunghezza variabile a un vettore di dimensione fissa.
Prendiamo un piccolo calcolo illustrativo, con vettori a due dimensioni che non provengono da MiniLM. Due posizioni valide valgono [2, 4] e [4, 2]; una posizione di riempimento vale [100, 100]. Con la maschera [1, 1, 0], la media è [3, 3]. Senza maschera sarebbe circa [35,33 ; 35,33]: il riempimento avrebbe completamente deformato la rappresentazione.
Occorre quindi rimuoverne il contributo e dividere per il numero di posizioni valide, non per la lunghezza dell’array completato. Il codice ufficiale del pooling mascherato permette di ritrovare queste due operazioni.
Ciò che apprende e ciò che rimane fisso
I pesi di MiniLM sono congelati: non vengono modificati durante questo apprendimento. Il codificatore deve comunque eseguire calcoli per rappresentare le pagine; «congelato» non significa «senza costo di calcolo».
Viene addestrata soltanto la testa MLP, acronimo di percettrone multistrato. Potete considerarla una piccola funzione numerica con parametri regolabili: riceve le caratteristiche delle due pagine e produce un punteggio di confine. I suoi parametri sono numeri appresi, da distinguere dalle caratteristiche, che sono i numeri forniti in ingresso.
Durante l’addestramento, una funzione di perdita misura lo scarto tra l’output del modello e la risposta attesa. La BCE, o entropia incrociata binaria, penalizza una forte confidenza dal lato sbagliato. Per un vero confine, annunciare una probabilità di 0,9 dà una penalità -ln(0,9), circa 0,1054; annunciare 0,1 dà circa 2,3026. Questi valori spiegano il calcolo, non sono perdite misurate su Atlas.
Il progetto usa PyTorch e BCEWithLogitsLoss, che riceve direttamente i punteggi grezzi e combina le operazioni in modo numericamente stabile. Spiegheremo questi punteggi, o logit, prima di leggere il decodificatore.
Tre metodi, tre ruoli da confrontare
Il primo metodo è una baseline, un semplice punto di confronto: separare quando il numero di pagina visibile torna a 1. Non è un classificatore di tipi di documenti.
Il secondo usa l’MLP, quindi una soglia: ogni posizione di separazione viene decisa separatamente a partire dalla sua probabilità.
Il terzo riprende i punteggi dell’MLP, ma sceglie una partizione completa soggetta a una lunghezza massima del documento. Usa la programmazione dinamica, che leggeremo come una ricerca di soluzioni che riutilizza risultati intermedi.
I metodi vengono confrontati sullo stesso insieme di test. Le annotazioni, chiamate anche label o gold, sono le risposte di riferimento. Servono per apprendere o misurare, secondo la loro partizione; non sono una caratteristica osservabile della pagina. Le label di test non vengono mai montate nei container inference e learning.
L’addestramento regola i parametri, la validazione sceglie la soglia e il test misura la regola ottenuta. Anche i vincoli di lunghezza vengono dichiarati prima del test. Regolare queste scelte dopo aver guardato le risposte di test equivarrebbe a preparare la correzione con le soluzioni aperte.
Prerequisiti e controllo dell’ambiente
Dovete saper leggere Python, usare un terminale e avviare Docker. PyTorch svolge l’addestramento; NumPy interviene in particolare nel decodificatore. I concetti di classificazione binaria sono quelli appena introdotti.
Il percorso di riferimento è previsto su Linux con GPU. Sono consigliati una RTX 3090 da 24 GiB, 24 GiB di RAM e 25 GiB di spazio su disco. La VRAM è la memoria della scheda grafica; la RAM è quella della macchina. Il percorso r002 ha usato realmente una RTX 3090, ma queste indicazioni non sono minimi garantiti per tutte le configurazioni. I risultati qui presentati non stabiliscono un percorso CPU equivalente.
Decomprimete lo ZIP e aprite un terminale nella sua radice. Tutti i comandi che seguono partono da questa cartella, nell’ordine indicato. Le versioni e i file bloccati del progetto costituiscono il riferimento da riprodurre; le documentazioni collegate servono a capire i meccanismi, non a sostituirne le dipendenze.
Una GPU visibile con nvidia-smi sull’host non è necessariamente utilizzabile in Docker. NVIDIA Container Toolkit fornisce l’integrazione necessaria con il motore dei container. Il controllo del percorso segnala la sua assenza e l’azione attesa, senza installarlo al posto vostro. La variabile GPU_DEVICE=1 può selezionare un’altra scheda prima dell’avvio del percorso, secondo la configurazione fornita.
Verificare l’host e costruire i servizi
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference learning
Il preflight è il controllo preliminare: Docker, Compose, memoria, spazio su disco e visibilità della GPU su Linux. Viene quindi eseguito lo script di preparazione, poi Compose verifica la configurazione e costruisce i quattro servizi.
docker compose config --quiet riesce senza visualizzare la configurazione quando essa è valida; è il comportamento documentato dell’opzione --quiet. L’assenza di testo non invita a ignorare un codice di ritorno che segnala un errore.
Acquisire MiniLM e calcolare realmente in Docker
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
L’acquisizione scarica i file di MiniLM, poi confronta dimensione e impronta SHA-256 con i valori attesi. Questa impronta identifica il contenuto dei file. La sostituzione atomica evita di installare un file acquisito solo in parte al posto della risorsa attesa. Nessun peso è incluso nello ZIP.
check_environment.py va oltre il controllo dell’host: carica realmente MiniLM in Docker e calcola sulla GPU. Infine, i test verificano in particolare la programmazione dinamica, le esportazioni e il vincolo di lunghezza. Il percorso di riferimento riporta 35 test riusciti; il loro successo non significa che tutti i fascicoli reali saranno correttamente separati.
Produrre decisioni di confine
Preparare i documenti senza dare le loro risposte al codificatore
docker compose run --rm tutorial python -m pdfbundles.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m pdfbundles.cli features --config configs/minimum.yaml
prepare genera i fascicoli fittizi e separa le loro annotazioni. features costruisce le caratteristiche delle pagine adiacenti nel container che non vede queste label. L’addestramento userà poi la supervisione autorizzata, ma le separazioni gold di test restano riservate alla valutazione.
Per una coppia di pagine, il rapporto r002 indica un vettore di 3 480 valori fornito all’MLP e 462 209 parametri addestrabili nella testa. Il primo numero descrive l’input; il secondo la funzione appresa. Non confondeteli con un numero di pagine o di documenti.
Queste dimensioni riguardano la configurazione dello ZIP. Il solo nome «MiniLM» non consente di ricostruire l’assemblaggio esatto delle caratteristiche: per modificarlo, occorre seguire la loro costruzione nel progetto, senza inventare colonne aggiuntive a partire dal totale.
Addestrare, interrompere, riprendere
docker compose run --rm learning python -m pdfbundles.cli train --config configs/minimum.yaml --mode interrupt
docker compose run --rm learning python -m pdfbundles.cli train --mode continuous --config configs/minimum.yaml
docker compose run --rm learning python -m pdfbundles.cli train --mode resume --config configs/minimum.yaml
docker compose run --rm learning python -m pdfbundles.cli verify-resume --config configs/minimum.yaml
Un’epoca è un passaggio sugli esempi di addestramento. Il budget totale è qui di quindici epoche. La modalità interrupt crea un percorso interrotto; continuous fornisce un riferimento addestrato senza questa interruzione; resume riprende il calcolo interrotto. Non si tratta di addestrare tre volte di seguito lo stesso modello per accumulare quarantacinque epoche.
Un checkpoint è uno stato salvato che permette di proseguire o controllare il calcolo. verify-resume confronta gli stati ottenuti per verificare che l’interruzione e la ripresa ritrovino il risultato del percorso continuo.
È un controllo di riproducibilità, non una misura della qualità documentale. Due esecuzioni possono riprodurre esattamente gli stessi errori. L’identità osservata vale anche per questo ambiente: la documentazione PyTorch sulla riproducibilità ricorda che un cambiamento di piattaforma o di versione può modificare i risultati.
Scegliere la soglia sulla validazione
docker compose run --rm learning python -m pdfbundles.cli calibrate --config configs/minimum.yaml
calibrate seleziona la soglia con l’insieme di validazione. Una soglia più bassa può attivare più separazioni; una soglia più alta può dimenticarne di più. La valutazione deve misurare questo compromesso invece di presumere che una scelta sia sempre preferibile.
Il percorso mantiene 0,5. Qui il nome del comando calibrate descrive la scelta di questa regola decisionale. Non dimostra che tutte le probabilità annunciate dal modello corrispondano alle frequenze d’errore di un’applicazione reale.
Dai logit locali a documenti completi
Leggere un logit prima di prendere una decisione
Un logit è un numero grezzo, che può essere negativo o positivo. La funzione sigmoide lo trasforma in probabilità di confine: p = 1 / (1 + exp(-logit)). La sua definizione è riportata nella documentazione PyTorch di Sigmoid.
| Logit illustrativo | Probabilità approssimativa | Tendenza alla soglia 0,5 |
|---|---|---|
| -2 | 0,1192 | Continuare il documento |
| 0 | 0,5000 | Parità da risolvere secondo la convenzione |
| 3 | 0,9526 | Separare |
Con soglia 0,5, un logit strettamente positivo favorisce quindi il confine e un logit strettamente negativo favorisce la continuazione. Un punteggio di 3 non significa «tre confini» o «tre pagine».
La soglia indipendente tratta ogni posizione separatamente. Basta a produrre intervalli consecutivi, ma non impone loro una lunghezza massima. La programmazione dinamica aggiunge proprio questo vincolo.
Assegnare un punteggio a un’intera partizione
Per valutare una segmentazione, il programma sceglie un contributo a ogni posizione interna: log(p) se separa, log(1 - p) se mantiene insieme le due pagine. Poi somma questi contributi.
Perché i logaritmi? Moltiplicare molte probabilità può produrre numeri minuscoli. Sommarne i logaritmi conserva l’ordinamento dei prodotti facilitando il calcolo. Il punteggio ottenuto è negativo o nullo; il più grande è il migliore, anche quando sono tutti negativi. Un punteggio di -0,5 è quindi preferibile a -3.
Questo punteggio è un criterio di confronto costruito a partire dagli output dell’MLP. Non è una probabilità calibrata che l’intero fascicolo sia separato perfettamente. Il decodificatore non consulta alcuna annotazione per calcolarlo.
Il codice completo del decodificatore
La funzione seguente riceve i logit delle posizioni interne e la lunghezza massima. np indica NumPy; score_segments e boundaries_of sono funzioni di supporto del progetto completo. Questo blocco non è, da solo, un lettore o un esportatore PDF.
def decode(logits, maximum):
    logits = np.asarray(logits, dtype=np.float64)
    if (
        logits.ndim != 1
        or not np.isfinite(logits).all()
        or not isinstance(maximum, int)
        or maximum < 1
    ):
        raise ValueError("Invalid logits or length constraint")
    n = len(logits) + 1
    boundary = -np.logaddexp(0, -logits)
    within = -np.logaddexp(0, logits)
    prefix = np.concatenate([[0.0], np.cumsum(within)])
    best = np.full(n + 1, -np.inf)
    previous = np.full(n + 1, -1, dtype=int)
    best[0] = 0
    for end in range(1, n + 1):
        candidates = []
        for start in range(max(0, end - maximum), end):
            # Internal non-boundaries are start..end-2, then one boundary at
            # end-1 unless this is the final segment of the whole bundle.
            segment = (
                prefix[end - 1]
                - prefix[start]
                + (boundary[end - 1] if end < n else 0.0)
            )
            candidates.append((best[start] + segment, -start, start))
        value, _, start = max(candidates)
        best[end] = value
        previous[end] = start
    segments = []
    end = n
    while end:
        start = int(previous[end])
        segments.append([start, end])
        end = start
    segments.reverse()
    direct = score_segments(logits, segments)
    if abs(direct - float(best[n])) > 1e-8:
        raise ValueError("Boundary counted more than once")
    return {
        "segments": segments,
        "boundaries": boundaries_of(segments),
        "score": direct,
        "maximum": maximum,
    }
Seguiremo le quattro operazioni importanti: controllare l’input, assegnare un punteggio a un segmento, memorizzare il miglior percorso, poi ricostruire gli intervalli.
1. Verificare l’input e impostare gli indici corretti
np.asarray(..., dtype=np.float64) prepara un array numerico a doppia precisione. La funzione rifiuta un array che non sia unidimensionale, valori non finiti come NaN o l’infinito, nonché una lunghezza che non supera il controllo di intero positivo.
Esiste una sfumatura di Python: isinstance(True, int) vale vero, perché bool è un sottotipo di int. L’estratto accetta quindi maximum=True come limite pari a 1. Questo controllo non deve essere presentato come un validatore rigoroso di parametri API; una simile validazione andrebbe aggiunta all’interfaccia di un’applicazione reale, senza modificare silenziosamente il percorso di riferimento.
Il numero di pagine viene dedotto da n = len(logits) + 1. Tre logit descrivono quattro pagine. Un array vuoto di logit descrive, secondo questa convenzione, un fascicolo di una pagina; non consente alla funzione di distinguere un vero PDF vuoto. La validazione del documento sorgente appartiene a un’altra fase.
Gli intervalli devono rispettare tre invarianti, proprietà che restano sempre vere: iniziare a 0, terminare a n e toccarsi senza buchi né sovrapposizioni. Devono inoltre essere non vuoti e non superare maximum.
2. Calcolare i punteggi senza contare due volte un confine
Gli array boundary e within contengono rispettivamente log(p) e log(1 - p). Usano np.logaddexp, che calcola log(exp(a) + exp(b)) in modo adatto a queste operazioni numeriche. Il codice lavora così direttamente dai logit, senza prima arrotondare una sigmoide a 0 o 1 e poi prenderne il logaritmo.
Per un segmento [start, end], le pagine vanno da start a end - 1. Le continuazioni all’interno del segmento si trovano quindi agli indici da start a end - 2.
Prendiamo [0, 3]: contiene le pagine 0, 1 e 2. Manteniamo insieme 0–1 e 1–2. Se seguono altre pagine, aggiungiamo una separazione tra 2 e 3. Se 2 è l’ultima pagina del file, questa separazione in uscita non esiste.
È esattamente il ruolo di boundary[end - 1] if end < n else 0.0. La fine del file non aggiunge un confine interno artificiale.
L’array prefix contiene le somme cumulative di within. Per sommare le continuazioni di un segmento basta una sottrazione: prefix[end - 1] - prefix[start]. Ritroviamo lo stesso principio di un totale cumulato che consente di calcolare un subtotale tra due posizioni, senza rifare tutta l’addizione.
Il confine che precede un segmento è già stato contato dal segmento precedente. Il nuovo segmento conta le sue continuazioni e, se ce n’è uno, il suo confine in uscita. Questa ripartizione evita il doppio conteggio.
3. Conservare il miglior risultato per ogni possibile fine
La programmazione dinamica si basa qui su una domanda: «Per terminare un segmento in questa pagina, quale inizio produce il miglior punteggio totale?»
best[end] memorizza il miglior punteggio per le prime end pagine. Un dettaglio importante in questa implementazione: quando end < n, questo punteggio include già il confine in uscita dopo queste pagine. previous[end] conserva l’inizio dell’ultimo segmento selezionato.
best[0] = 0 inizializza il percorso prima di qualsiasi pagina. Gli altri punteggi iniziano a meno infinito, affinché uno stato non ancora raggiunto non vinca un confronto.
Per una fine end, il ciclo esplora tutti gli inizi da max(0, end - maximum) fino a end - 1. Ciò autorizza segmenti da 1 a maximum pagine. Ogni candidato aggiunge il miglior punteggio già noto per il prefisso e il punteggio del nuovo segmento.
Perché basta un solo miglior punteggio per posizione? In questo codice, il punteggio del segmento successivo dipende soltanto dai suoi limiti e dai logit che usa. Non ha bisogno di conoscere il tipo o il numero dei documenti precedenti. Riutilizzare il miglior prefisso non elimina quindi alcuna migliore continuazione possibile per questo criterio.
A punteggio esattamente uguale, la tupla (score, -start, start) risolve il pareggio tra i candidati. Python confronta le tuple elemento per elemento: max preferisce quindi il più piccolo start, ossia il segmento corrente più lungo. È una convenzione deterministica, non un’informazione sulla natura del documento. Non significa che il codice minimizzi esplicitamente il numero totale di documenti.
4. Tornare dal punteggio agli intervalli
Una volta raggiunta l’ultima posizione, while end risale i predecessori. Si trova prima l’ultimo intervallo, poi il penultimo e così via. segments.reverse() rimette l’elenco nell’ordine di lettura.
Il punteggio degli intervalli ricostruiti viene poi ricalcolato con score_segments. Uno scarto superiore a 1e-8 rispetto al punteggio dinamico attiva un errore. Questo controllo rileva un’incoerenza di calcolo; non verifica che le separazioni corrispondano ai documenti attesi.
L’output contiene gli intervalli segments, i loro confini boundaries, il score e il limite maximum. Questa funzione non inventa né il nome della cartella di destinazione né un tipo professionale di documento.
Rifare il calcolo su quattro pagine
Ecco un esempio didattico indipendente da Atlas: i tre logit valgono [-2, 3, -1] e maximum vale 2. Il modello favorisce una sola separazione, tra la seconda e la terza pagina.
I contributi utili sono approssimativamente -0,1269 per continuare nella prima posizione, -0,0486 per separare nella seconda e -0,3133 per continuare nella terza. La partizione [0, 2], [2, 4] ottiene quindi un punteggio di -0,4888.
L’intera progressione di best è la seguente. Ricordate che gli stati intermedi includono il loro confine in uscita.
Fine end |
Inizio scelto previous[end] |
Punteggio best[end] |
|---|---|---|
| 1 | 0 | -2,1269 |
| 2 | 0 | -0,1755 |
| 3 | 2 | -1,4888 |
| 4 | 2 | -0,4888 |
La risalita parte da 4, trova l’inizio 2, poi riparte da 2 e trova 0. Dopo aver invertito l’elenco, otteniamo i due intervalli attesi in questo esempio. Le quattro pagine sono presenti una sola volta.
Il vincolo può anche forzare un compromesso. Con quattro pagine, i logit illustrativi [-3, -0.2, -1] non favoriscono alcuna separazione. Ma maximum=3 vieta di mantenere insieme tutte e quattro le pagine. Separare dopo la seconda pagina aggiunge la penalità meno forte, -0,2, contro -3 o -1 nelle altre posizioni. Il decodificatore sceglie qui [0, 2], [2, 4], invece di riempire meccanicamente un primo documento di tre pagine.
Questi piccoli calcoli spiegano l’algoritmo. Non costituiscono nuovi risultati del corpus principale.
Ciò che il vincolo aggiunge — e ciò che non aggiunge
Senza vincolo attivo, questo punteggio globale ritrova le decisioni indipendenti alla soglia 0,5, salvo possibili differenze nella risoluzione delle parità. Si vede direttamente: sostituire una continuazione con un confine fa variare il punteggio di log(p) - log(1 - p), cioè del logit. Un logit positivo migliora il punteggio separando; un logit negativo lo peggiora.
La programmazione dinamica non apporta quindi un nuovo modello di comprensione dei documenti. Ottimizza gli stessi indizi locali tra le partizioni autorizzate. L’estratto non riceve peraltro una soglia calibrata come argomento: usa direttamente le log-probabilità e maximum. Non bisogna presumere che riprodurrebbe qualsiasi altra soglia scelta per il metodo indipendente.
Questo vincolo è rigido: un segmento troppo lungo è vietato, anche se il modello stima con grande confidenza che le sue pagine debbano restare insieme. Al contrario, per ogni maximum positivo accettato, resta possibile una soluzione in documenti di una pagina. Il decodificatore non si astiene quindi automaticamente quando una lunghezza sembra incompatibile con il contenuto. Una revisione richiederebbe una regola aggiuntiva.
Confrontare i metodi ed esportare le pagine
docker compose run --rm inference python -m pdfbundles.cli baseline --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfbundles.cli evaluate --config configs/minimum.yaml
baseline calcola il riferimento semplice; evaluate produce gli output di test ed esporta gli intervalli in outputs/separated/. Questi comandi non riaddestrano l’MLP e non scelgono una nuova soglia. L’esercizio verrà dopo.
Le 600 pagine di test vengono confrontate con le sorgenti tramite il loro testo nativo e i pixel renderizzati alla scala del corso, nello stesso ordine. Guardate questi controlli come guardereste la verifica di un’esportazione applicativa: gli elementi attesi sono stati copiati, senza omissioni né ripetizioni?
Ciò non verifica che siano raggruppate correttamente. Esportare fedelmente le pagine da 1 a 6 in un unico file resta una fusione errata se appartengono a due documenti di tre pagine.
Il controllo non dimostra neppure che un PDF arbitrario conserverà firme, moduli o annotazioni. Confronta le proprietà effettivamente verificate sui PDF generati, non tutti gli oggetti e i comportamenti possibili di un PDF.
Interpretare il test senza nascondere i punti deboli
Contare le decisioni, poi i fascicoli completi
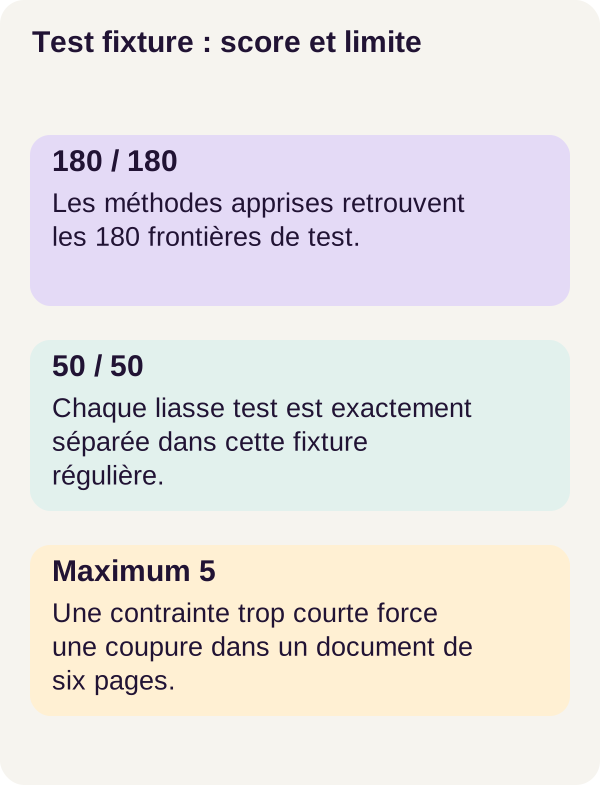
Il test contiene 50 fascicoli, 600 pagine e 550 decisioni interne. Il conto è semplice: ogni fascicolo di n pagine apporta n - 1 decisioni; sull’insieme, 600 - 50 = 550. Tra queste posizioni, 180 sono veri confini.
La precisione chiede: tra le separazioni previste, quante sono corrette? Il richiamo chiede: tra le separazioni attese, quante ne abbiamo ritrovate? L’F1 è la loro media armonica: 2 × precisione × richiamo / (precisione + richiamo).
Per leggere i risultati direttamente dai conteggi, possiamo anche scrivere F1 = 2 × TP / (2 × TP + FP + FN). Qui TP conta i veri confini ritrovati, FP le sovrasegmentazioni e FN le fusioni dovute a un confine dimenticato.
Infine, un fascicolo esatto richiede che tutti i suoi intervalli siano corretti. Basta una sola separazione errata perché questo criterio fallisca per il fascicolo, anche se le altre decisioni sono giuste. L’F1 dei confini e la quota di fascicoli esatti rispondono quindi a due domande diverse.
Risultati del percorso r002
La tabella riprende i conteggi pubblicati. I due metodi appresi hanno gli stessi risultati di qualità in questo test; condividono quindi una colonna, senza essere confusi con un’unica implementazione.
| Misura | Regola di numerazione | MLP + soglia 0,5 / MLP + decodificatore dinamico |
|---|---|---|
| Veri confini ritrovati | 109/180 | 180/180 |
| Sovrasegmentazioni | 22 | 0 |
| Fusioni | 71 | 0 |
| F1 dei confini | 0,700965 | 1,00 |
| Fascicoli interamente esatti | 30/50 | 50/50 |
| Confini tra documenti dello stesso tipo ritrovati | 53/89 | 89/89 |
Rifacciamo il calcolo per la regola semplice. Predice 109 + 22 = 131 separazioni. La sua precisione vale quindi 109/131, circa 0,8321, e il suo richiamo 109/180, circa 0,6056. L’F1 vale 218/311, ossia 0,700965 dopo arrotondamento. Questi primi due valori sono calcolati dai conteggi pubblicati, non provengono da un nuovo esperimento.
La regola produce 30 fascicoli interamente esatti su 50, ossia il 60 %. Ritrova soltanto 53 degli 89 confini tra documenti dello stesso tipo. Un ritorno a 1 è un indizio di paginazione, non un identificativo di pratica: è il punto debole concreto evidenziato da questo confronto.
L’MLP con la soglia scelta in validazione e il decodificatore dinamico raggiungono entrambi F1 = 1,00, senza sovrasegmentazioni né fusioni. La programmazione dinamica non apporta quindi alcun guadagno di qualità nel test principale. Aggiunge qui una politica di lunghezza, non un beneficio di precisione dimostrato.
Tempo di calcolo e portata del risultato
La decodifica dinamica richiede circa 0,000060 secondi per fascicolo, contro 0,000016 secondi per la soglia. Ciò corrisponde a circa 60 e 16 microsecondi. Questi tempi riguardano la decodifica, non la lettura dei PDF, la codifica MiniLM, l’apprendimento o l’esportazione completa.
Il percorso osservato è durato 485,526 secondi, con cache Docker pubblica, di cui 35 test in 8,78 secondi. Non è una misura a freddo né un impegno di prestazioni per un’altra macchina.
Un insieme di dati sintetici preparato per un test è spesso chiamato una fixture. Qui contenuti, riferimenti e squadre seguono schemi molto regolari. MiniLM resta congelato; viene usato un solo seme casuale, o seed. Nei risultati presentati non ci sono né OCR — riconoscimento di testo dalle immagini — né revisione umana.
Il punteggio perfetto descrive quindi questa fixture. Non dimostra né un successo sulle scansioni, né robustezza sui documenti dei vostri utenti, né l’utilità dello stesso limite di lunghezza in un altro contesto.
Sintesi prima dell’esercizio
Abbiamo costruito tre livelli separati. I testi e la geometria forniscono le osservazioni. L’MLP apprende un punteggio per posizione di separazione, poi la soglia o la programmazione dinamica sceglie gli intervalli. Infine, la valutazione confronta le separazioni con le annotazioni e verifica separatamente le pagine esportate.
La distinzione importante è ora questa: una soluzione può essere ottimale per l’algoritmo pur essendo errata per il documento. È in particolare il caso quando la partizione corretta è stata vietata da un vincolo. L’esercizio isolerà questa situazione, senza modificare il modello.
Esercizio: un vincolo può vietare la risposta corretta
Prevedere prima di eseguire
Immaginate un fascicolo di dodici pagine formato da due documenti di sei pagine. Il riferimento attende gli intervalli [0, 6] e [6, 12]. Il modello fornisce undici logit favorevoli a questa separazione.
Ma la configurazione impone maximum=5. Il decodificatore può comunque conservare un documento di sei pagine? Una confidenza molto alta basta a superare questo limite? Scrivete la vostra risposta prima di eseguire il comando, poi prevedete cosa cambia se il limite diventa 8.
docker compose run --rm tutorial python -m pdfbundles.cli exercise --config configs/exercise.yaml
Osservare, poi spiegare
La partizione corretta è impossibile con un limite di 5: nessun segmento di sei pagine è ammissibile. Non è necessariamente un errore dell’MLP. La ricerca non ha semplicemente il diritto di restituire i due documenti interi.
Nell’esercizio fornito, decode viene rieseguito sugli stessi undici logit, con limiti 5 poi 8. Nessun modello viene riaddestrato e il test principale non viene usato.
Con 5, il risultato conserva il vero confine ma aggiunge due sovrasegmentazioni. Si ottiene una separazione corretta su tre previste: precisione 1/3, richiamo 1, quindi F1 dei confini = 0,5. Quattro segmenti sostituiscono i due documenti attesi.
Perché quattro segmenti, quando tre segmenti basterebbero a coprire dodici pagine con un limite di cinque? Perché coprire tutte le pagine non è l’unico criterio. Per mantenere il vero confine dopo la sesta pagina, ognuno dei due documenti di sei pagine deve a sua volta essere separato almeno una volta. È proprio ciò che accade in questo esercizio; una semplice divisione del numero totale di pagine per il limite non descrive la partizione scelta.
Con 8, gli intervalli di sei pagine tornano ammissibili e qui vengono ritrovati: F1 = 1. Il limite autorizza questa risposta, non ordina di creare documenti di otto pagine.
Allentare un vincolo amplia l’insieme delle soluzioni possibili, ma non garantisce di ritrovare il riferimento in tutti i fascicoli. In questo esercizio, i punteggi favoriscono la soluzione corretta non appena torna autorizzata. Su un altro documento, punteggi errati potrebbero favorire una fusione sbagliata.
La correzione da ricordare non è quindi «scegliere 8 per tutti i PDF». Occorre definire una politica compatibile con i documenti attesi, poi misurarla su un insieme distinto prima di utilizzarla.
Figure, checkpoint e pulizia
Leggere gli output prima di eliminarli
Consultate outputs/evaluation.json per le misure e outputs/exports.json per i controlli di esportazione. Aprite anche i PDF in outputs/separated/ e i PNG disponibili. Tornate a un fascicolo preciso: i confini sono corretti e ogni pagina è stata esportata nel posto giusto?
I comandi seguenti generano le figure dai risultati esistenti, controllano i checkpoint, quindi puliscono gli output. Conservate i file utili prima di avviare la pulizia, perché verranno eliminati anche i PDF esportati.
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Il controllo dei checkpoint confronta le copie delle sorgenti didattiche. Non sostituisce il confronto degli stati di addestramento già eseguito da verify-resume.
Il primo docker compose down viene collocato intenzionalmente prima di clean nel percorso r002. clean --outputs-only visualizza e poi elimina soltanto outputs/; sorgenti, corpus e risorse restano presenti. L’ultimo down termina il percorso. Non è necessario eseguire una pulizia globale degli altri vostri progetti Docker.
Diagnosticare il livello giusto
La GPU funziona su Linux ma non nel container? Riprendete la diagnosi del preflight e del controllo dell’ambiente. La difficoltà si trova allora nell’accesso alla GPU da Docker, non nella decisione di confine.
L’acquisizione rifiuta un file? Verificate lo spazio disponibile e i controlli di dimensione e impronta. Sostituire il modello con un altro cambierebbe l’esperimento invece di risolvere il problema di riproduzione.
La ripresa differisce dal percorso continuo? Conservate gli stati e i messaggi di controllo prima di qualsiasi pulizia. Una somiglianza di F1 non basta per concludere che la ripresa sia identica.
Le esportazioni sono fedeli, ma i documenti sono raggruppati male? Ispezionate i punteggi e il limite di lunghezza. È la segmentazione che va spiegata; la copia delle pagine può avere funzionato perfettamente.
Passare dal corso a un’applicazione
Cominciate con fascicoli autorizzati e rappresentativi, con annotazioni affidabili e un test mantenuto separato. Definite le lunghezze ammissibili con le squadre che conoscono i documenti. Un limite scelto soltanto per facilitare il calcolo può vietare un documento del tutto normale.
Prevedete una revisione dei casi poco sicuri o le cui lunghezze sembrano incompatibili. In un’interfaccia di back office, potrebbe assumere la forma di anteprime delle pagine ai due lati di una separazione, con la possibilità di confermarla o spostarla. Questa interfaccia è una pista di adattamento, non una funzionalità dimostrata dal percorso r002.
Aggiungete controlli dedicati quando i documenti includono firme, moduli, annotazioni, scansioni da trattare con OCR o requisiti di accessibilità. Il controllo del testo e dei pixel della fixture non sostituisce queste verifiche.
Il filo conduttore resta semplice: il modello fornisce indizi, il decodificatore applica una politica e la valutazione verifica separatamente la correttezza della segmentazione e la fedeltà dell’esportazione.
Scaricate il corso r002: ZIP r002.
Riferimenti per approfondire
I collegamenti a Sentence Transformers, PyTorch, NumPy, Python, Docker e NVIDIA chiariscono le operazioni spiegate nel corso dell’articolo. I piccoli esempi numerici sono didattici; i risultati Atlas restano quelli del percorso r002. Per riprodurre quest’ultimo, conservate i comandi, le configurazioni e i file bloccati dello ZIP, senza sostituirli con gli esempi di installazione delle documentazioni correnti.