





Imaginez la barre de recherche d’une boutique de pièces détachées. Un client décrit son appareil, sa version et la pièce recherchée. Le moteur retrouve la bonne famille de produits… mais place une pièce presque compatible avant celle qui répond exactement à la demande.
Le problème n’est plus seulement de trouver des fiches. Il faut aussi bien les ordonner.
C’est le rôle d’un reranker, ou modèle de reclassement : relire la demande avec chacun des candidats déjà récupérés, attribuer des scores, puis modifier leur ordre. Pour un développeur web, la frontière ressemble à celle d’une fonction qui trie un tableau renvoyé par une API : elle peut déplacer ses éléments, mais pas retrouver un élément que l’API ne lui a jamais envoyé.
Dans ce tutoriel, nous allons entraîner ce reclassement, comprendre son calcul et mesurer sa limite. Un excellent ordre ne peut pas réparer à lui seul une liste qui ne contient aucune réponse pertinente.
Télécharger le projet complet du tutoriel
Ce que nous construisons
Nous construisons un catalogue synthétique, c’est-à-dire un catalogue fictif fabriqué pour l’expérience. Pour chaque demande, une recherche lexicale, fondée sur les termes des textes, récupère huit fiches candidates. Un modèle BERT utilisé comme cross-encodeur attribue ensuite un score à chaque paire (requête, document).
Pendant l’entraînement, nous réunissons les huit scores d’une même requête pour apprendre une répartition qui favorise les candidats pertinents. C’est l’approche listwise : la fonction d’apprentissage tient compte de la liste, et pas seulement de chaque paire prise isolément.
À l’arrivée, les identifiants des candidats restent les mêmes. Leur position change, pas leur appartenance à la liste. Le programme ne rédige pas de réponse, ne crée pas de fiche produit et ne certifie pas la compatibilité d’une pièce réelle.
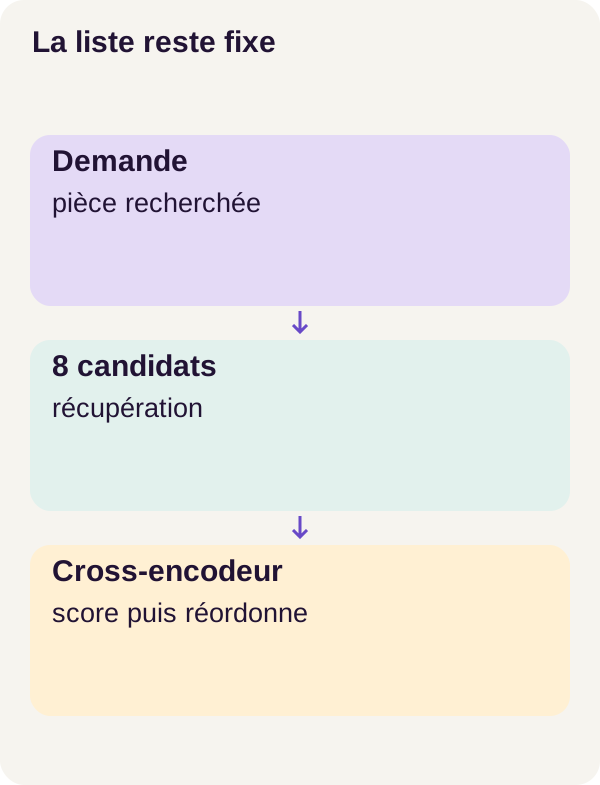
Nous comparerons trois classements : celui de la recherche lexicale, celui d’un modèle entraîné pointwise, puis celui du modèle entraîné listwise. Nous vérifierons également la reprise après interruption et lirons les résultats dans outputs/ranking-metrics.json.
Vous n’avez pas besoin de connaître BERT ou les fonctions de perte pour commencer. Les listes, les fonctions, quelques bases de Python et un terminal suffisent pour suivre les explications. Le parcours exécutable demande aussi les prérequis Docker et GPU indiqués plus bas.
Concepts expliqués
Récupérer n’est pas reclasser
La récupération répond à la question : « Parmi toutes les fiches, lesquelles allons-nous examiner ? » Le reranking répond ensuite : « Dans quel ordre afficher les fiches retenues ? »
Prenons un exemple inventé, distinct du corpus r1. Un utilisateur cherche le filtre d’un appareil fictif Atlas, version 2024. Pour alléger l’explication, nous ne montrons que trois candidats, alors que le parcours réel en utilise huit.
| Candidat pédagogique | Lecture de la fiche | Grade attribué pour cet exemple |
|---|---|---|
| A | Répond complètement à la demande | 2 |
| B | Répond seulement à une partie des critères | 1 |
| C | Ne répond pas à la demande | 0 |
La recherche pourrait rendre l’ordre B, C, A. Nous aimerions obtenir A, B, C. En revanche, si A n’est pas dans la liste reçue, aucun tri ne peut l’y ajouter.
Les grades sont des annotations : des valeurs de référence définies pour dire ce qui est pertinent. Le modèle apprend à partir de ces valeurs ; il ne les invente pas pour noter ses propres réponses. Dans ce tutoriel, un « positif » est un candidat de grade 1 ou 2. Positif ne signifie donc pas nécessairement pleinement compatible.
Comment BERT transforme une paire de textes en score
Un modèle ne calcule pas directement sur des chaînes de caractères. Le tokenizer découpe le texte en unités appelées tokens, puis les remplace par des identifiants numériques. Un token peut être un mot, un morceau de mot ou un signe : compter les mots ne suffit pas à connaître la longueur que recevra le modèle.
La paire peut se représenter schématiquement ainsi : [CLS] requête [SEP] fiche [SEP]. Il s’agit d’un schéma de lecture, pas d’une sortie de tokenisation capturée dans l’expérience. [SEP] sépare les deux textes ; [CLS] est une position spéciale dont la représentation servira ici au calcul du score. La fiche de BERT décrit ce format d’entrée.
BERT calcule des représentations numériques qui tiennent compte du contexte des tokens. Dans notre cross-encodeur, la requête et la fiche sont traitées ensemble : leurs mots peuvent donc être mis en relation pendant ce calcul. Une tête linéaire transforme ensuite le vecteur associé à [CLS] en un seul nombre. Pensez à une dernière fonction qui combine les coordonnées du vecteur avec des coefficients appris.
Ce nombre est un score, aussi appelé logit avant sa transformation éventuelle en distribution. Il sert à classer les fiches d’une même demande. Un score de 3 ne signifie ni « grade 3 », ni « trois fois plus compatible », ni « probabilité de compatibilité de 300 % ».
Un bi-encodeur ferait autrement : il encoderait séparément la requête et les documents, puis comparerait leurs vecteurs. Le cross-encodeur refait au contraire une lecture de paire pour chaque candidat. C’est ce qui permet une comparaison directe des deux textes, avec un coût de calcul supplémentaire. La documentation CrossEncoder de Sentence Transformers présente cette architecture de reclassement.
Ce que « listwise » change réellement
Ici, BERT continue de noter les paires séparément. Nous ne lui envoyons pas les huit fiches dans un seul grand texte. C’est la fonction de perte qui regroupe leurs scores par requête.
Une perte, ou loss, est un nombre que l’entraînement cherche à réduire. Dans une approche pointwise, chaque paire contribue indépendamment à l’objectif. Dans notre approche listwise, les scores des candidats sont normalisés ensemble : augmenter la part accordée à l’un change les parts relatives des autres.
L’objectif est cohérent avec notre besoin : nous ne voulons pas seulement reconnaître plusieurs fiches intéressantes ; nous voulons donner davantage de place à une réponse complète qu’à une réponse partielle. Ce choix reste une hypothèse à évaluer, pas une garantie que listwise battra toujours pointwise.
La documentation des pertes CrossEncoder permet de replacer cette famille de méthodes. Le projet utilise néanmoins sa propre fonction graded_listwise_loss, détaillée ci-dessous. Le nom d’une famille ne suffit pas à connaître la formule exacte d’une implémentation.
Du grade à une répartition attendue
La transformation utilisée est gain = 2^grade − 1. Pour A, B et C, elle donne les gains [3, 1, 0]. Nous divisons ensuite chaque gain par leur somme, soit 4 : la cible devient [0.75, 0.25, 0].
Autrement dit, la répartition attendue accorde les trois quarts de sa masse à A et un quart à B. Le mot masse désigne simplement ici une part d’un total égal à 1. Ce n’est pas une probabilité métier : le grade 2 de A est connu par annotation, et non estimé comme un événement ayant 75 % de chances de se produire.
La cible ne correspond pas à un softmax appliqué aux grades. Le calcul est bien : grades → gains → division par la somme des gains. Changer cette transformation changerait l’objectif d’apprentissage.
Pour convertir les scores du modèle en une distribution comparable, nous utilisons en revanche un softmax : p_i = exp(score_i) / somme_j exp(score_j). Les valeurs sont positives et leur somme vaut 1. Avec trois scores égaux, chacun reçoit un tiers. Avec huit scores égaux, chacun reçoit un huitième.
Cette normalisation est relative à la liste. Même huit mauvaises fiches peuvent recevoir huit parts dont la somme vaut 1. Le softmax ne constitue donc pas, à lui seul, un détecteur de « aucune pièce compatible ».
Entraînement et utilisation du modèle
Les poids sont les coefficients numériques appris par le réseau. Pendant l’entraînement, les scores sont comparés aux cibles ; la rétropropagation calcule des gradients, c’est-à-dire la sensibilité de la perte à ces coefficients. Un optimiseur utilise ces gradients pour mettre à jour les paramètres entraînables.
Pendant l’utilisation, appelée inférence, le modèle calcule les scores sans recevoir les grades attendus comme informations à exploiter. Les annotations servent ensuite à évaluer le classement, pas à lui souffler la bonne réponse.
Prérequis Docker et GPU
Le parcours r1 a été défini pour Linux x86_64, Docker Compose, NVIDIA Container Toolkit et une RTX 3090 de 24 Gio. Le README prévoit 16 Gio de RAM et 16 Gio de disque. Il ne décrit pas de parcours CPU validé.
La RAM est la mémoire de la machine ; la mémoire de la carte graphique sert aux calculs GPU. Ces provisions sont celles du projet : elles ne démontrent pas un minimum universel pour toute carte ou toute configuration.
Docker fournit l’environnement d’exécution. Le NVIDIA Container Toolkit permet de rendre le GPU accessible à cet environnement ; CUDA est la pile utilisée pour y effectuer les calculs. Une carte visible depuis Linux ne suffit pas : le contrôle CUDA doit réussir dans le conteneur avant l’entraînement.
Le fichier locks/models.lock.json verrouille google-bert/bert-base-uncased à la révision 86b5e0934494bd15c9632b12f734a8a67f723594. Le fichier locks/environment.lock.json décrit l’environnement verrouillé. Pour un développeur web, ces verrous jouent un rôle comparable à celui d’un fichier de dépendances figées : ils évitent que deux installations utilisent silencieusement des versions différentes.
Le service acquire récupère les actifs publics ; le service gpu exécute le code local. Conservez les références du projet pour reproduire r1 : remplacer le modèle ou les dépendances crée une autre expérience.
Données et fonction centrale
Séparer les exemples avant d’apprendre
Le catalogue synthétique contient 480 documents et 480 requêtes. Le découpage par familles prévoit 336 pour l’entraînement, 72 pour la validation et 72 pour le test. Chaque liste contient huit candidats. Les grades 0, 1 et 2 représentent respectivement une incompatibilité, une compatibilité partielle et une compatibilité complète.
L’entraînement sert à modifier les poids. La validation sert à examiner les choix d’apprentissage. Le test sert à la mesure finale. La séparation par familles vise à éviter que des exemples très apparentés soient utilisés à la fois pour apprendre et pour juger le résultat. Les labels d’entraînement ne sont présents que pour les candidats de train.
Dans une application web, vous avez probablement déjà utilisé des données de test dont les réponses attendues sont connues. Le principe est similaire, avec une contrainte supplémentaire : ne pas entraîner le modèle sur les réponses qui serviront à son examen final.
Les entrées et la sortie de la fonction
Un tenseur est un tableau numérique, éventuellement à plusieurs dimensions. Ici, scores et grades ont une ligne par requête et une colonne par candidat. Pour un lot de B requêtes du parcours, leur forme est donc B × 8.
mask est un tableau de booléens de même organisation. Une valeur True indique une position à prendre en compte ; False désigne une position ignorée. Le parcours annonce huit candidats par liste : la présence de ce paramètre dans la fonction ne signifie pas que ses données contiennent nécessairement des positions de remplissage.
Voici l’extrait continu de src/listwise_ranker/losses.py. Il suppose que PyTorch est importé sous le nom torch dans son module.
def graded_listwise_loss(scores, grades, mask=None):
    mask = torch.ones_like(grades, dtype=torch.bool) if mask is None else mask
    gains = (torch.pow(2.0, grades) - 1) * mask
    included = gains.sum(-1) > 0
    n = int(included.sum())
    if not n:
        return scores.sum() * 0, {"included": 0, "excluded": scores.shape[0]}
    selected = scores[included].masked_fill(~mask[included], -torch.inf)
    target = gains[included] / gains[included].sum(-1, keepdim=True)
    logp = torch.log_softmax(selected, dim=-1).masked_fill(~mask[included], 0.0)
    return -(target * logp).sum(-1).mean(), {
        "included": n,
        "excluded": scores.shape[0] - n,
    }
Cette fonction retourne une perte et des compteurs. Elle ne tokenise aucun texte, n’appelle pas BERT, ne trie pas les identifiants et ne met pas elle-même les poids à jour. Elle constitue une étape du programme d’entraînement, pas ce programme tout entier.
Suivre le calcul, ligne par ligne
Créer le masque et les gains. Sans masque fourni, torch.ones_like(..., dtype=torch.bool) prend toutes les positions en compte. torch.pow(2.0, grades) - 1 transforme ensuite les grades en gains. Leur multiplication par le masque annule la contribution des positions ignorées.
Choisir les listes utilisables. gains.sum(-1) additionne les gains de chaque ligne : -1 désigne la dernière dimension, celle des candidats. included garde les lignes dont cette somme est strictement positive. Le compteur n est donc un nombre de listes incluses, pas un nombre de documents positifs.
Une liste de huit grades 0 n’a pas de distribution cible à normaliser : sa somme de gains est nulle. Elle est exclue de la perte. Cela ne signifie pas qu’il faut la faire disparaître de l’évaluation de bout en bout.
Écarter les positions masquées. Pour les listes retenues, masked_fill remplace les scores ignorés par -torch.inf, soit moins l’infini. Dans le softmax, leur exponentielle vaut zéro : ces positions ne prennent aucune part de la distribution.
Former la cible. Les gains de chaque ligne sont divisés par leur somme. keepdim=True conserve une dimension de largeur 1 pour que chaque ligne soit divisée par son propre total. Notre exemple [3, 1, 0] donne bien [0.75, 0.25, 0].
Calculer les logarithmes des parts prédites. torch.log_softmax produit directement les logarithmes du softmax. C’est préférable au calcul séparé du softmax puis de son logarithme pour la stabilité numérique, comme l’explique la documentation PyTorch.
Le second masked_fill remplace par 0 les valeurs des positions ignorées dans logp. Pourquoi refaire un masquage ? Parce que la multiplication 0 × (−inf) ne fournit pas un zéro numérique utilisable : elle peut produire NaN, une valeur « pas un nombre ». La position ignorée doit contribuer exactement zéro au produit final.
Additionner puis moyenner. -(target * logp).sum(-1) calcule une perte par liste, appelée ici entropie croisée. La dernière moyenne porte sur les seules listes incluses. Les compteurs included et excluded permettent de suivre cette population.
Un grade 0 n’est pas une position absente
Il faut distinguer deux situations. Un candidat de grade 0, avec un masque True, reste un concurrent dans le softmax. Son gain cible est nul, mais lui accorder une forte part prive les positifs de cette part et augmente la perte. Une position masquée False est retirée de la comparaison.
Reprenons trois scores égaux et les grades [2, 1, 0]. Sans masquage, les probabilités sont [1/3, 1/3, 1/3]. Si nous masquons seulement le troisième candidat, les deux parts restantes deviennent [0.5, 0.5]. Retirer les négatifs du dénominateur n’est donc pas neutre : cela change l’exercice que nous demandons au modèle.
Il existe aussi un cas limite : si le masque retire tous les positifs d’une ligne, cette ligne devient exclue de la perte, même si ses grades initiaux en contenaient.
Calculer la perte à la main
Dans l’exemple pédagogique A, B, C, la cible est [0.75, 0.25, 0]. Pour des scores finis et des positions actives, la formule devient : L = −0.75 × ln(p_A) − 0.25 × ln(p_B). ln désigne le logarithme naturel. La cible nulle de C ne lui donne pas de terme propre, mais C reste dans le dénominateur du softmax.
Les distributions ci-dessous sont choisies pour l’explication ; ce ne sont pas des prédictions capturées pendant r1.
| Parts prédites A, B, C | Perte approximative | Lecture |
|---|---|---|
| Un tiers, un tiers, un tiers | 1,098612 | Les trois candidats reçoivent la même part |
| 0,74 ; 0,25 ; 0,01 | 0,572402 | La répartition est proche de la cible |
| 0,95 ; 0,04 ; 0,01 | 0,843189 | A est favorisé, mais B reçoit trop peu de place |
Les deux dernières distributions donnent pourtant le même ordre : A, B, C. La perte ne regarde donc pas seulement qui arrive premier. Elle compare la répartition complète à celle définie par les grades.
Autre conséquence : une bonne perte n’a pas forcément vocation à atteindre zéro. Pour la cible [0.75, 0.25, 0], sa borne inférieure est −0.75 × ln(0.75) − 0.25 × ln(0.25) ≈ 0,562335. Avec des scores finis, la part de C reste strictement positive ; cette borne est approchée à mesure qu’elle tend vers zéro. Chercher une perte nulle ici reviendrait à attendre le mauvais résultat.
Pour creuser : un positif peut recevoir un gradient qui baisse son score
Pour une seule liste incluse, le gradient par rapport à chaque score vaut part prédite − part cible. Avec trois scores égaux, il vaut donc environ [-0.416667, +0.083333, +0.333333].
Une descente de gradient effectuée directement sur ces scores augmenterait A et diminuerait B et C. B est pourtant positif. Ce n’est pas une erreur d’annotation : il reçoit actuellement un tiers du total, alors que la cible lui en attribue un quart. Le calcul cherche à corriger cette surreprésentation, pas à transformer B en candidat incompatible. Le réseau réel traduit ensuite ces gradients en modifications de poids partagés ; chaque score n’est pas un paramètre indépendant.
Le cas où aucune liste ne contribue
Quand n vaut zéro, scores.sum() * 0 retourne un zéro relié au calcul des scores, avec un gradient nul lorsque les scores et leur somme sont finis. Les compteurs signalent que toutes les listes ont été exclues.
Ce retour ne signifie pas que l’entraînement vient de réussir ni que l’optimiseur doit avancer : la décision de poursuivre ou de sauter une mise à jour appartient à la boucle appelante. L’extrait ne contient aucun optimizer.step().
Enfin, cette fonction n’est pas un validateur général d’entrées. Elle ne vérifie pas explicitement toutes les formes, la finitude des scores ou l’appartenance des grades à {0, 1, 2}. Il faut garder les contrats et contrôles du projet autour d’elle, plutôt que supposer qu’elle accepte n’importe quels tableaux.
Installer et préparer les listes
Vérifier l’environnement avant de toucher aux poids
Téléchargez le ZIP, extrayez-le et placez le terminal à sa racine. Toutes les commandes suivantes partent de ce même répertoire. Elles suivent le parcours r1 de README.md et de lesson/tutorial.json.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prépare le projet. docker compose config --quiet vérifie la configuration Compose, puis build construit les images des services acquire et gpu. L’acquisition récupère les actifs publics selon les verrous. Le script check_environment.py contrôle ensuite l’accès CUDA dans le conteneur.
La dernière commande exécute la suite de tests du projet. Ces tests vérifient la mécanique du programme ; leur réussite ne signifie pas encore qu’une fiche sera pertinente pour une vraie demande client. À ce stade, l’objectif est d’obtenir un environnement conforme et des contrôles sans échec avant l’apprentissage.
La forme répétée docker compose run --rm gpu … lance une commande dans le service gpu, puis retire le conteneur temporaire à sa fin. Elle ne veut pas dire que vous devez entrer manuellement dans le conteneur pour saisir la suite.
Préparer, inspecter et vérifier la formule
Nous pouvons maintenant construire les listes, regarder ce que reçoit le modèle et contrôler la perte sur des nombres connus.
docker compose run --rm gpu python -m listwise_ranker.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m listwise_ranker.cli inspect-pairs --config configs/minimum.yaml
docker compose run --rm gpu python -m listwise_ranker.cli check-loss --config configs/minimum.yaml
Après prepare, examinez les partitions et les huit candidats de chaque liste. Il faut pouvoir rapprocher une requête, ses identifiants candidats et les grades utilisés par le protocole. Cette association doit rester stable : si une colonne change de document sans que son grade la suive, le programme apprendrait à favoriser le mauvais candidat.
inspect-pairs rend visible la troncature à la longueur fixée pour le modèle. Tronquer signifie retirer une partie des tokens lorsque la paire est trop longue. La limite porte sur l’entrée de la paire, pas seulement sur le nombre de mots de la fiche. Sa valeur utilisée dans r1 doit être lue dans la configuration du ZIP.
Dans notre exemple fictif, une phrase finale telle que « uniquement pour la version 2023 » peut être décisive. Si elle est retirée avant BERT, elle ne participe pas au score. Le modèle peut alors noter une entrée privée d’une information essentielle, même si la fiche originale la contient.
check-loss vérifie le calcul sur des tenseurs connus. Reliez son résultat à la transformation des grades et à la normalisation des gains, avant de démarrer l’entraînement. Vérifier la formule et vérifier la tokenisation sont deux contrôles complémentaires : une formule juste ne rétablit pas un texte tronqué.
Entraîner, reprendre et mesurer
Comparer deux objectifs d’apprentissage
La première commande entraîne la variante listwise. La deuxième lance la variante pointwise. Les trois suivantes créent une exécution interrompue, la reprennent et comparent la reprise.
docker compose run --rm gpu python -m listwise_ranker.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m listwise_ranker.cli train --config configs/minimum.yaml --variant pointwise
docker compose run --rm gpu python -m listwise_ranker.cli train --config configs/minimum.yaml --stop-after 20 --run-name interrupted
docker compose run --rm gpu python -m listwise_ranker.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m listwise_ranker.cli compare-resume --config configs/minimum.yaml
Conservez cet ordre : resumed dépend du fichier artifacts/checkpoints/interrupted/state.pt créé par interrupted. L’option --stop-after 20 fixe ici le point d’interruption de l’essai ; elle ne donne pas à elle seule le nombre total de mises à jour de la recette.
Un checkpoint est un point de sauvegarde de l’entraînement. Une reprise complète ne se réduit pas au chargement de poids pour faire une prédiction : elle doit retrouver l’état nécessaire à la continuation du calcul. Le parcours prévoit ce contrôle avec compare-resume. Consultez sa sortie pour connaître le résultat de votre exécution ; les mesures de classement ci-dessous ne remplacent pas ce contrôle de reprise.
La variante pointwise sert de comparaison. Le code de sa perte n’est pas reproduit dans cet article : n’en déduisez pas une formule précise à partir du seul mot « pointwise ». Pour étudier cette différence d’implémentation, utilisez le code de l’archive, en gardant la configuration de référence.
Mesurer le lot, puis expliquer un cas
Une fois l’apprentissage et la reprise contrôlés, évaluez les classements avant de vous attarder sur une recherche particulièrement convaincante.
docker compose run --rm gpu python -m listwise_ranker.cli evaluate --config configs/minimum.yaml
docker compose run --rm gpu python -m listwise_ranker.cli inspect-case --config configs/minimum.yaml
outputs/ranking-metrics.json contient les agrégats, c’est-à-dire les mesures qui résument plusieurs requêtes. inspect-case aide ensuite à relire un cas individuel.
Pour ce cas, rapprochez la demande, les fiches, leurs grades et leurs positions avant et après reclassement. Vérifiez que les identifiants sont restés les mêmes. Le cas explique une partie du résultat ; il ne suffit pas à conclure sur la moyenne des 72 requêtes de test.
Métriques avant les mesures
La couverture@8 : existe-t-il au moins un candidat pertinent ?
La couverture@8 est la proportion de requêtes dont les huit candidats contiennent au moins un positif :
couverture@8 = nombre de listes avec au moins un grade positif / nombre total de requêtes.
Cette mesure répond seulement à une question de présence. Une liste dont l’unique positif arrive huitième est couverte. Une liste contenant seulement une compatibilité partielle de grade 1 l’est aussi. La couverture ne signifie donc ni « bonne pièce en tête », ni « toutes les pièces pertinentes retrouvées », ni « compatibilité complète ».
Dans un exemple pédagogique de quatre demandes dont trois ont au moins un positif, la couverture vaut 3 / 4 = 0,75. Réordonner ces mêmes listes ne change pas ce nombre.
Le NDCG@5 : quelle qualité dans les premières positions ?
Le NDCG, pour normalized discounted cumulative gain, mesure un gain de pertinence cumulé, réduit selon la position, puis normalisé. Derrière ce nom, trois idées simples : une fiche plus pertinente rapporte davantage ; une fiche placée plus bas rapporte moins ; le résultat est comparé à un classement idéal.
Le suffixe @5 indique que seules les cinq premières positions contribuent au score observé. Avec des grades non négatifs et un idéal défini sur le même ensemble de référence, 1 correspond à l’idéal et 0 à l’absence de gain dans les cinq premières places.
Faisons le calcul sur notre exemple pédagogique. Nous choisissons les gains 2^grade − 1 et une réduction de rang 1 / log2(rang + 1), une convention documentée dans TensorFlow Ranking. Cette référence explique la métrique ; elle n’ajoute aucune dépendance TensorFlow au projet.
Avec cette convention, DCG@5 = somme des gains aux cinq premiers rangs, divisés chacun par log2(rang + 1). log2 est le logarithme en base 2 : au rang 1, le dénominateur vaut 1 ; au rang 3, il vaut 2. Le grade 2 rapporte donc 3 en première position, mais seulement 1,5 en troisième position.
Pour les huit grades [2, 1, 0, 0, 0, 0, 0, 0], l’ordre idéal vaut :
IDCG@5 = 3 / log2(2) + 1 / log2(3) ≈ 3,630930.
Le NDCG est ensuite DCG / IDCG. Voici plusieurs permutations des mêmes grades, calculées uniquement pour l’explication :
| Grades dans l’ordre proposé | Couverture@8 pour cette requête | NDCG@5 pédagogique |
|---|---|---|
| 2, 1, 0, 0, 0, 0, 0, 0 | 1 | 1,000000 |
| 1, 2, 0, 0, 0, 0, 0, 0 | 1 | 0,796708 |
| 0, 1, 2, 0, 0, 0, 0, 0 | 1 | 0,586883 |
| 0, 0, 0, 0, 0, 2, 1, 0 | 1 | 0,000000 |
La dernière ligne est importante : les pertinents sont bien présents, mais trop bas pour contribuer au top 5. Le reranker dispose donc d’une possibilité d’amélioration, contrairement au cas où aucun positif ne figure parmi ses candidats.
Le calcul complet de la métrique du projet n’est pas inclus dans l’extrait Python précédent : celui-ci calcule la perte d’entraînement. Pour adapter l’évaluation, vérifiez aussi sur quels documents l’idéal est construit. Trier idéalement les candidats disponibles et comparer à tous les pertinents du catalogue ne donnent pas toujours le même dénominateur. Les petits calculs ci-dessus utilisent explicitement les huit grades affichés comme ensemble de référence.
Enfin, deux ordres identiques peuvent avoir le même NDCG et des pertes différentes. C’était le cas des distributions [0.74, 0.25, 0.01] et [0.95, 0.04, 0.01] : toutes deux classent A, B, C, mais ne répartissent pas les scores de la même façon. La perte sert à apprendre ; la métrique sert à juger le résultat selon un critère donné.
Conditionnel et bout en bout : deux moyennes, deux dénominateurs
Le NDCG@5 conditionnel se calcule seulement sur les listes couvertes, celles où le reranker dispose d’au moins un positif. Il décrit le classement dans les situations où un document pertinent était disponible.
Le NDCG@5 de bout en bout garde aussi les listes sans positif dans le dénominateur. Dans le protocole présenté, elles contribuent zéro. Ce choix rend visible la part des demandes pour lesquelles le système ne présente aucune réponse pertinente.
Reprenons nos quatre demandes fictives. Si les trois listes couvertes atteignent chacune un NDCG de 1, leur moyenne conditionnelle vaut 1. Mais sur les quatre demandes, la moyenne vaut (1 + 1 + 1 + 0) / 4 = 0,75.
Avec une moyenne non pondérée et cette convention de zéro pour les listes non couvertes, nous avons :
NDCG de bout en bout = couverture × NDCG conditionnel.
Puisque le NDCG conditionnel ne dépasse pas 1, la couverture fixe un plafond au score de bout en bout. Ce plafond est une borne ; il n’est pas automatiquement atteignable par n’importe quel modèle ou avec n’importe quel choix de classement idéal.
Une requête sans réponse mérite un statut explicite
Il faut encore distinguer deux raisons possibles de ne pas avoir de positif dans une liste : la bonne fiche existe dans le catalogue mais n’a pas été récupérée, ou aucune fiche du catalogue ne répond à la demande.
Dans le premier cas, améliorer la récupération peut aider. Dans le second, il faut aussi savoir signaler une absence de réponse. Le protocole choisi conserve ces cas dans le score de bout en bout ; ce n’est pas une convention universelle permettant, à elle seule, de diagnostiquer leur cause.
Résultats réels
Les mesures r1
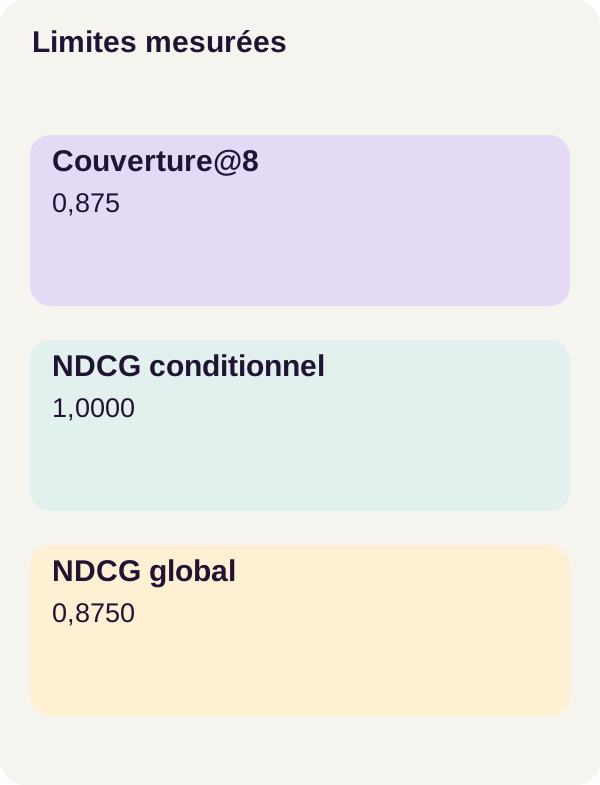
Le test porte sur 72 requêtes, dont 63 listes couvertes. Le bilan décrit les 9 autres cas comme n’ayant « aucun positif global ». La couverture@8 vaut 63 / 72 = 0,875.
Cette formulation compte : ne transformons pas ces neuf cas en neuf bonnes pièces nécessairement présentes dans le catalogue mais manquées par la recherche. Le nombre de listes non couvertes ne suffit pas à démontrer ce diagnostic.
Voici les mesures publiées, conservées avec leur précision d’origine :
| Classement | NDCG@5 conditionnel | NDCG@5 de bout en bout |
|---|---|---|
| Lexical | 0,9903969127585871 | 0,8665972986637638 |
| Pointwise | 0,8838329034231467 | 0,7733537904952533 |
| Listwise | 1,0 | 0,875 |
La couverture@8 reste 0,875 : les rerankers travaillent sur les mêmes candidats. Le modèle listwise atteint ici un ordre conditionnel parfait selon la métrique utilisée. La moyenne de bout en bout reste néanmoins limitée : (63 × 1 + 9 × 0) / 72 = 0,875.
Les valeurs des autres méthodes suivent la même relation, aux arrondis numériques près. Pour pointwise, 0,8838329034231467 × 0,875 ≈ 0,7733537904952533. Il n’y a pas de contradiction entre deux scores différents : ils ne divisent pas par la même population.
Le résultat utile n’est pas « l’IA bat la recherche »
La recherche lexicale est déjà très forte sur ce corpus : son NDCG conditionnel vaut environ 0,9904. Le modèle listwise améliore ce résultat, mais la marge disponible était petite. Par soustraction des mesures publiées, le gain est d’environ 0,009603 sur le NDCG conditionnel et 0,008403 sur le score de bout en bout. Ce sont des écarts de score calculés, pas de nouvelles mesures ni des pourcentages de pièces compatibles.
La variante pointwise se classe, elle, moins bien que la référence lexicale dans cette expérience. Ajouter un modèle et l’entraîner n’est donc pas une amélioration par définition. Il faut conserver une référence simple pour vérifier ce qu’apporte réellement la nouvelle étape.
Le tableau ne permet pas non plus d’affirmer que listwise sera toujours supérieur à pointwise. Il décrit ce corpus synthétique, ce modèle et cette recette. Il ne donne pas de mesure de latence sous charge ni de preuve de généralisation à d’autres catalogues.
Ce que le score parfait ne garantit pas
Un NDCG conditionnel de 1 signifie que les premières positions satisfont l’idéal retenu par l’évaluation pour les listes couvertes. Ce n’est pas une certification de compatibilité physique, une absence de cas sans réponse ou une preuve que les annotations sont parfaites.
La leçon principale est donc double : apprendre l’ordre peut aider, mais l’ordre reste limité par les candidats et par la définition de la pertinence. La récupération, l’apprentissage et l’évaluation ont chacun leur rôle ; un bon chiffre à une étape ne remplace pas les autres.
Exercice : prédire, puis exécuter
Retirer le meilleur candidat
Imaginez que nous retirions A, le meilleur document de notre exemple, en gardant les identifiants des autres candidats. Sans exécuter le programme, formulez votre prédiction : un entraînement supplémentaire ou un score très élevé peut-il faire réapparaître A dans le classement de cette liste ?
Le scénario fourni effectue cette comparaison sans vous demander de modifier le moteur de référence.
docker compose run --rm gpu python -m listwise_ranker.cli exercise --config configs/exercise.yaml
La sortie confirme que le reranker reçoit et retourne les mêmes candidats : il peut les réordonner, mais ne récupère jamais un identifiant absent. Pour vérifier cette propriété, comparez les identifiants de la liste après retrait à ceux du classement final. Ne les comparez pas à la liste initiale en oubliant la suppression volontaire.
Attention à une seconde prédiction : retirer le meilleur document ne rend pas forcément la liste entièrement non pertinente. Si B, de grade 1, reste présent, la liste est encore couverte. Si nous avons retiré son unique positif, elle ne l’est plus. Dans les deux cas, le meilleur document absent reste impossible à retrouver par un simple reclassement.
Cette distinction explique pourquoi l’exercice vérifie d’abord une propriété des identifiants. Un meilleur ordre des candidats restants ne prouverait pas que la récupération a été réparée.
Conserver les artefacts avant de terminer
Un artefact est un fichier produit par le parcours : figure, mesure ou sauvegarde d’entraînement. Terminez par la génération des figures, le contrôle des checkpoints, la prévisualisation du nettoyage et l’arrêt des services, dans cet ordre.
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
Les checkpoints sont contrôlés après l’exercice. --dry-run demande une prévisualisation : clean.py indique ce qu’il viserait, sans supprimer les fichiers. La commande docker compose down --remove-orphans termine les services du projet ; les fichiers du parcours conservés sur l’hôte restent disponibles.
Adaptation, limites, dépannage et nettoyage
Passer d’un catalogue fictif à vos fiches
La première étape n’est pas de changer BERT. C’est d’écrire une définition de la pertinence revue par les personnes qui connaissent le catalogue. Que signifie exactement « partiellement compatible » ? Est-ce un résultat à afficher avec réserve, une alternative utile ou une pièce à exclure de toute proposition d’achat ? La graduation choisie pour un tutoriel ne remplace pas cette décision métier.
Versionnez les fiches, les requêtes, les annotations et les partitions. Les textes peuvent évoluer alors que les identifiants restent stables ; sans version du catalogue, vous risquez de comparer un ancien score à une nouvelle fiche. Conservez aussi la liste des candidats afin de distinguer une modification du classement d’une modification de la récupération.
Mesurez séparément la couverture, les rangs, la troncature et le coût du reranking. Si vous augmentez le nombre de candidats, vous modifiez à la fois ce qui devient accessible au modèle et le nombre de paires à traiter. Le nouveau résultat doit être évalué comme une nouvelle expérience, pas ajouté aux chiffres r1 comme s’il décrivait le même protocole.
Vérifier les langues et les informations réellement lues
La fiche du modèle BERT base uncased indique un préentraînement en anglais et un traitement qui ne distingue pas les majuscules des minuscules. Le nom « BERT » ne garantit donc pas une adaptation automatique à des demandes françaises, à des références techniques ou à toutes les conventions de votre catalogue. L’exemple français utilisé dans nos explications n’est pas un résultat multilingue mesuré.
Le max_length du cross-encodeur peut aussi retirer la partie décisive d’une fiche. Un texte visible dans un fichier source n’est pas nécessairement entièrement visible par le réseau après tokenisation. Inspectez les paires avant d’attribuer une erreur au seul apprentissage.
Ne pas confondre classement et décision
Le mécanisme retourne un ordre, pas une autorisation d’achat ou d’installation. Contrôlez les cas à enjeu élevé avant toute automatisation. Un système réel doit notamment gérer les demandes sans réponse, les annotations incertaines et les règles qui interdisent certaines substitutions.
La cible listwise demande une répartition relative entre candidats ; elle n’apprend pas ici un seuil universel de compatibilité. Concevoir un rejet ou une validation humaine demande des données et des contrôles spécifiques, distincts de la seule amélioration du NDCG.
Dépanner sans changer l’expérience en silence
Le GPU n’est pas visible. Relancez le contrôle d’environnement avant l’entraînement, puis vérifiez l’intégration Docker avec le guide NVIDIA Container Toolkit. Ne remplacez pas discrètement l’exécution GPU par un parcours CPU non validé.
L’acquisition échoue. Vérifiez l’accès réseau du service acquire, corrigez sa cause d’échec et relancez la même commande. Modifier la révision du modèle pour contourner un actif manquant ferait perdre la référence de l’expérience.
La perte paraît anormalement basse. Relisez included et excluded avant de conclure. Un lot entièrement exclu donne zéro sans avoir fourni de supervision. Un masque qui retire des candidats gênants peut aussi rendre l’objectif artificiellement plus facile.
Le NDCG conditionnel est excellent, mais le score global plafonne. Regardez la couverture et les demandes sans positif. Ne demandez pas au reranker de restituer des fiches qu’il n’a pas reçues, ni de créer une pièce absente du catalogue.
Vous souhaitez nettoyer les essais. Les commandes de fin de parcours sont déjà données dans l’exercice. clean.py --dry-run ne supprime aucun résultat ; docker compose down --remove-orphans ne remplace pas un nettoyage de vos fichiers locaux. Examinez et conservez les mesures utiles avant toute suppression distincte.
Nous avons ainsi un parcours qui relie un besoin d’interface — mieux présenter les résultats — à une formule d’apprentissage vérifiable. Sa conclusion reste concrète : un bon reranker remet les bons candidats à la bonne place ; il ne dispense jamais de vérifier quels candidats étaient disponibles.
Sources officielles
Les références suivantes servent à approfondir les concepts. Pour reproduire les mesures r1, conservez les versions et la configuration de l’archive : les documentations externes ne les remplacent pas.
- Sentence Transformers : entraînement d’un CrossEncoder, pour le principe de notation des paires et l’entraînement d’un reranker.
- Sentence Transformers : losses CrossEncoder, pour comparer les familles de pertes sans confondre leurs implémentations.
- BERT base uncased, pour le modèle, sa langue de préentraînement et la représentation des paires.
- PyTorch :
log_softmax, pour le calcul stable des logarithmes des probabilités. Cette page versionnée documente l’opération ; elle ne déclare pas la version installée par le projet. - TensorFlow Ranking : définition de NDCG, pour la normalisation du gain et les conventions du calcul pédagogique, sans utilisation de TensorFlow dans le parcours.
- Docker Compose : prise en charge GPU et NVIDIA Container Toolkit : installation, pour l’accès à la carte depuis un conteneur.