





Immaginate la barra di ricerca di un negozio di ricambi. Un cliente descrive il suo apparecchio, la versione e il pezzo cercato. Il motore ritrova la giusta famiglia di prodotti… ma colloca un pezzo quasi compatibile prima di quello che risponde esattamente alla richiesta.
Il problema non è più soltanto trovare le schede. Occorre anche ordinarle correttamente.
Questo è il ruolo di un reranker, ossia un modello di riclassificazione: rilegge la richiesta con ciascuno dei candidati già recuperati, assegna punteggi e ne modifica l'ordine. Per uno sviluppatore web, il confine ricorda una funzione che ordina un array restituito da un'API: può spostarne gli elementi, ma non ritrovare un elemento che l'API non gli ha mai inviato.
In questo tutorial addestreremo questa riclassificazione, ne comprenderemo il calcolo e ne misureremo il limite. Un ordine eccellente non può riparare da solo una lista che non contiene alcuna risposta pertinente.
Scaricare il progetto completo del tutorial
Che cosa costruiamo
Costruiamo un catalogo sintetico, cioè un catalogo fittizio creato per l'esperimento. Per ogni richiesta, una ricerca lessicale, basata sui termini dei testi, recupera otto schede candidate. Un modello BERT usato come cross-encoder assegna poi un punteggio a ogni coppia (query, documento).
Durante l'addestramento riuniamo gli otto punteggi della stessa query per apprendere una distribuzione che favorisca i candidati pertinenti. È l'approccio listwise: la funzione di apprendimento considera la lista, non soltanto ogni coppia isolata.
Alla fine, gli identificativi dei candidati restano gli stessi. Cambia la loro posizione, non l'appartenenza alla lista. Il programma non redige risposte, non crea schede prodotto e non certifica la compatibilità di un pezzo reale.
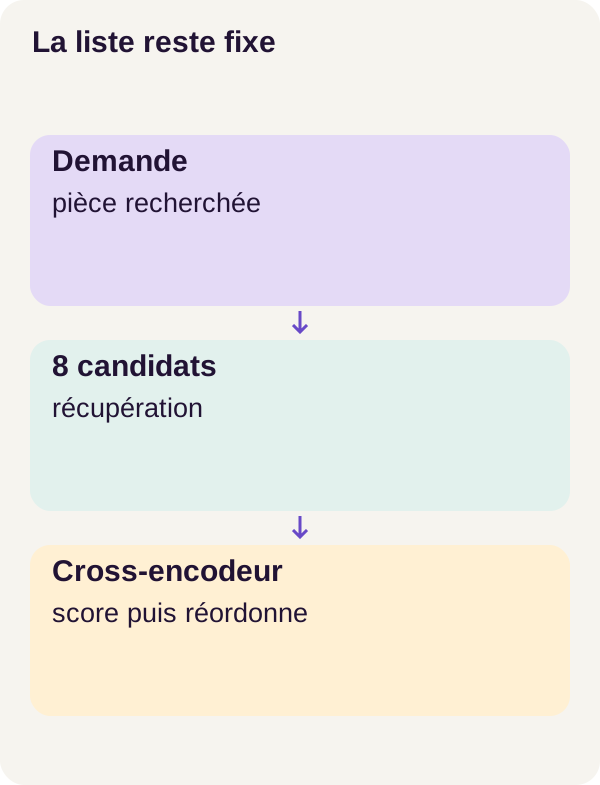
Confronteremo tre classifiche: quella della ricerca lessicale, quella di un modello addestrato pointwise, poi quella del modello addestrato listwise. Verificheremo anche la ripresa dopo un'interruzione e leggeremo i risultati in outputs/ranking-metrics.json.
Non occorre conoscere BERT o le funzioni di perdita per iniziare. Liste, funzioni, alcune basi di Python e un terminale bastano per seguire le spiegazioni. Il percorso eseguibile richiede anche i prerequisiti Docker e GPU indicati più avanti.
Concetti spiegati
Recuperare non è riclassificare
Il recupero risponde alla domanda: «Tra tutte le schede, quali esamineremo?» Il reranking risponde poi: «In quale ordine visualizzare le schede selezionate?»
Prendiamo un esempio inventato, distinto dal corpus r1. Un utente cerca il filtro di un apparecchio fittizio Atlas, versione 2024. Per alleggerire la spiegazione mostriamo solo tre candidati, mentre il percorso reale ne usa otto.
| Candidato didattico | Lettura della scheda | Grado assegnato per questo esempio |
|---|---|---|
| A | Risponde completamente alla richiesta | 2 |
| B | Risponde solo a una parte dei criteri | 1 |
| C | Non risponde alla richiesta | 0 |
La ricerca potrebbe restituire l'ordine B, C, A. Vorremmo ottenere A, B, C. Tuttavia, se A non è nella lista ricevuta, nessun ordinamento può aggiungerla.
I gradi sono annotazioni: valori di riferimento definiti per indicare ciò che è pertinente. Il modello apprende da questi valori; non li inventa per valutare le proprie risposte. In questo tutorial, un «positivo» è un candidato di grado 1 o 2. Positivo non significa quindi necessariamente pienamente compatibile.
Come BERT trasforma una coppia di testi in un punteggio
Un modello non calcola direttamente su stringhe di caratteri. Il tokenizer divide il testo in unità chiamate token, poi le sostituisce con identificativi numerici. Un token può essere una parola, una parte di parola o un segno: contare le parole non basta a conoscere la lunghezza che riceverà il modello.
La coppia può essere rappresentata schematicamente così: [CLS] query [SEP] scheda [SEP]. È uno schema di lettura, non un output di tokenizzazione catturato nell'esperimento. [SEP] separa i due testi; [CLS] è una posizione speciale la cui rappresentazione servirà qui al calcolo del punteggio. La scheda di BERT descrive questo formato di input.
BERT calcola rappresentazioni numeriche che tengono conto del contesto dei token. Nel nostro cross-encoder, query e scheda sono trattate insieme: le loro parole possono quindi essere messe in relazione durante il calcolo. Una testa lineare trasforma poi il vettore associato a [CLS] in un solo numero. Pensatela come una funzione finale che combina le coordinate del vettore con coefficienti appresi.
Questo numero è un punteggio, chiamato anche logit prima della sua eventuale trasformazione in distribuzione. Serve a classificare le schede di una stessa richiesta. Un punteggio di 3 non significa né «grado 3», né «tre volte più compatibile», né «probabilità di compatibilità del 300%».
Un bi-encoder farebbe diversamente: codificherebbe separatamente la query e i documenti, poi confronterebbe i loro vettori. Il cross-encoder, al contrario, ripete una lettura della coppia per ogni candidato. Questo consente un confronto diretto dei due testi, con un costo di calcolo aggiuntivo. La documentazione CrossEncoder di Sentence Transformers presenta questa architettura di riclassificazione.
Che cosa cambia davvero «listwise»
Qui BERT continua a valutare le coppie separatamente. Non gli inviamo le otto schede in un unico grande testo. È la funzione di perdita a raggruppare i loro punteggi per query.
Una perdita, o loss, è un numero che l'addestramento cerca di ridurre. In un approccio pointwise, ogni coppia contribuisce indipendentemente all'obiettivo. Nel nostro approccio listwise, i punteggi dei candidati sono normalizzati insieme: aumentare la quota assegnata a uno modifica le quote relative degli altri.
L'obiettivo è coerente con il nostro bisogno: non vogliamo soltanto riconoscere più schede interessanti; vogliamo dare più spazio a una risposta completa che a una risposta parziale. Questa scelta rimane un'ipotesi da valutare, non una garanzia che listwise superi sempre pointwise.
La documentazione delle loss CrossEncoder permette di collocare questa famiglia di metodi. Il progetto usa però la propria funzione graded_listwise_loss, illustrata sotto. Il nome di una famiglia non basta a conoscere la formula esatta di un'implementazione.
Dal grado a una distribuzione attesa
La trasformazione utilizzata è gain = 2^grade − 1. Per A, B e C produce i guadagni [3, 1, 0]. Dividiamo poi ciascun guadagno per la loro somma, ossia 4: il target diventa [0.75, 0.25, 0].
In altre parole, la distribuzione attesa assegna tre quarti della propria massa ad A e un quarto a B. Qui la parola massa indica semplicemente una quota di un totale pari a 1. Non è una probabilità di business: il grado 2 di A è noto tramite annotazione, non stimato come un evento con il 75% di probabilità di verificarsi.
Il target non corrisponde a un softmax applicato ai gradi. Il calcolo è proprio: gradi → guadagni → divisione per la somma dei guadagni. Cambiare questa trasformazione cambierebbe l'obiettivo di apprendimento.
Per convertire invece i punteggi del modello in una distribuzione confrontabile usiamo un softmax: p_i = exp(score_i) / somma_j exp(score_j). I valori sono positivi e la loro somma vale 1. Con tre punteggi uguali, ciascuno riceve un terzo. Con otto punteggi uguali, ciascuno riceve un ottavo.
Questa normalizzazione è relativa alla lista. Anche otto schede sbagliate possono ricevere otto quote la cui somma vale 1. Il softmax non è dunque, da solo, un rilevatore di «nessun pezzo compatibile».
Addestramento e uso del modello
I pesi sono i coefficienti numerici appresi dalla rete. Durante l'addestramento, i punteggi sono confrontati con i target; la retropropagazione calcola gradienti, cioè la sensibilità della perdita a questi coefficienti. Un ottimizzatore usa tali gradienti per aggiornare i parametri addestrabili.
Durante l'uso, chiamato inferenza, il modello calcola i punteggi senza ricevere i gradi attesi come informazioni da sfruttare. Le annotazioni servono poi a valutare la classifica, non a suggerirle la risposta giusta.
Prerequisiti Docker e GPU
Il percorso r1 è stato definito per Linux x86_64, Docker Compose, NVIDIA Container Toolkit e una RTX 3090 da 24 GiB. Il README prevede 16 GiB di RAM e 16 GiB di disco. Non descrive un percorso CPU convalidato.
La RAM è la memoria della macchina; la memoria della scheda grafica serve ai calcoli GPU. Queste dotazioni sono quelle del progetto: non dimostrano un minimo universale per ogni scheda o configurazione.
Docker fornisce l'ambiente di esecuzione. NVIDIA Container Toolkit rende la GPU accessibile a tale ambiente; CUDA è lo stack usato per eseguire i calcoli. Una scheda visibile da Linux non basta: il controllo CUDA deve riuscire nel contenitore prima dell'addestramento.
Il file locks/models.lock.json blocca google-bert/bert-base-uncased alla revisione 86b5e0934494bd15c9632b12f734a8a67f723594. Il file locks/environment.lock.json descrive l'ambiente bloccato. Per uno sviluppatore web, questi blocchi svolgono un ruolo paragonabile a un file di dipendenze fissate: evitano che due installazioni usino silenziosamente versioni diverse.
Il servizio acquire recupera gli asset pubblici; il servizio gpu esegue il codice locale. Conservate i riferimenti del progetto per riprodurre r1: sostituire il modello o le dipendenze crea un altro esperimento.
Dati e funzione centrale
Separare gli esempi prima di apprendere
Il catalogo sintetico contiene 480 documenti e 480 query. La divisione per famiglie prevede 336 per l'addestramento, 72 per la validazione e 72 per il test. Ogni lista contiene otto candidati. I gradi 0, 1 e 2 rappresentano rispettivamente incompatibilità, compatibilità parziale e compatibilità completa.
L'addestramento serve a modificare i pesi. La validazione serve a esaminare le scelte di apprendimento. Il test serve alla misurazione finale. La separazione per famiglie mira a evitare che esempi molto affini siano usati sia per apprendere sia per valutare il risultato. Le etichette di addestramento sono presenti solo per i candidati di train.
In un'applicazione web avete probabilmente già usato dati di test con risposte attese note. Il principio è simile, con un vincolo aggiuntivo: non addestrare il modello sulle risposte che serviranno al suo esame finale.
Gli input e l'output della funzione
Un tensore è un array numerico, eventualmente con più dimensioni. Qui scores e grades hanno una riga per query e una colonna per candidato. Per un lotto di B query del percorso, la loro forma è quindi B × 8.
mask è un array di booleani con la stessa organizzazione. Un valore True indica una posizione da considerare; False indica una posizione ignorata. Il percorso annuncia otto candidati per lista: la presenza di questo parametro nella funzione non significa che i dati contengano necessariamente posizioni di riempimento.
Ecco l'estratto continuo di src/listwise_ranker/losses.py. Presuppone che PyTorch sia importato nel modulo con il nome torch.
def graded_listwise_loss(scores, grades, mask=None):
    mask = torch.ones_like(grades, dtype=torch.bool) if mask is None else mask
    gains = (torch.pow(2.0, grades) - 1) * mask
    included = gains.sum(-1) > 0
    n = int(included.sum())
    if not n:
        return scores.sum() * 0, {"included": 0, "excluded": scores.shape[0]}
    selected = scores[included].masked_fill(~mask[included], -torch.inf)
    target = gains[included] / gains[included].sum(-1, keepdim=True)
    logp = torch.log_softmax(selected, dim=-1).masked_fill(~mask[included], 0.0)
    return -(target * logp).sum(-1).mean(), {
        "included": n,
        "excluded": scores.shape[0] - n,
    }
Questa funzione restituisce una perdita e dei contatori. Non tokenizza testi, non chiama BERT, non ordina gli identificativi e non aggiorna da sé i pesi. Costituisce una fase del programma di addestramento, non l'intero programma.
Seguire il calcolo riga per riga
Creare la maschera e i guadagni. Senza una maschera fornita, torch.ones_like(..., dtype=torch.bool) considera tutte le posizioni. torch.pow(2.0, grades) - 1 trasforma quindi i gradi in guadagni. La moltiplicazione per la maschera annulla il contributo delle posizioni ignorate.
Scegliere le liste utilizzabili. gains.sum(-1) somma i guadagni di ogni riga: -1 indica l'ultima dimensione, quella dei candidati. included conserva le righe la cui somma è strettamente positiva. Il contatore n è dunque un numero di liste incluse, non di documenti positivi.
Una lista di otto gradi 0 non ha una distribuzione target da normalizzare: la somma dei suoi guadagni è nulla. È esclusa dalla perdita. Ciò non significa che debba sparire dalla valutazione end-to-end.
Escludere le posizioni mascherate. Per le liste selezionate, masked_fill sostituisce i punteggi ignorati con -torch.inf, cioè meno infinito. Nel softmax la loro esponenziale vale zero: queste posizioni non partecipano alla distribuzione.
Formare il target. I guadagni di ogni riga sono divisi per la loro somma. keepdim=True conserva una dimensione di larghezza 1 affinché ogni riga sia divisa per il proprio totale. Il nostro esempio [3, 1, 0] produce proprio [0.75, 0.25, 0].
Calcolare i logaritmi delle quote predette. torch.log_softmax produce direttamente i logaritmi del softmax. È preferibile calcolare separatamente softmax e logaritmo per la stabilità numerica, come spiega la documentazione PyTorch.
Il secondo masked_fill sostituisce con 0 i valori delle posizioni ignorate in logp. Perché mascherare di nuovo? Perché la moltiplicazione 0 × (−inf) non fornisce uno zero numerico utilizzabile: può produrre NaN, un valore «non numerico». La posizione ignorata deve contribuire esattamente zero al prodotto finale.
Sommare poi fare la media. -(target * logp).sum(-1) calcola una perdita per lista, qui chiamata entropia incrociata. L'ultima media riguarda soltanto le liste incluse. I contatori included ed excluded permettono di seguire questa popolazione.
Un grado 0 non è una posizione assente
Occorre distinguere due situazioni. Un candidato di grado 0, con una maschera True, resta un concorrente nel softmax. Il suo guadagno target è nullo, ma assegnargli una quota alta priva i positivi di tale quota e aumenta la perdita. Una posizione mascherata False viene rimossa dal confronto.
Riprendiamo tre punteggi uguali e i gradi [2, 1, 0]. Senza mascheramento, le probabilità sono [1/3, 1/3, 1/3]. Se mascheriamo soltanto il terzo candidato, le due quote rimanenti diventano [0.5, 0.5]. Rimuovere i negativi dal denominatore non è quindi neutro: cambia l'esercizio richiesto al modello.
Esiste anche un caso limite: se la maschera rimuove tutti i positivi di una riga, quella riga è esclusa dalla perdita, anche se i suoi gradi iniziali ne contenevano.
Calcolare la perdita a mano
Nell'esempio didattico A, B, C, il target è [0.75, 0.25, 0]. Per punteggi finiti e posizioni attive, la formula diventa: L = −0.75 × ln(p_A) − 0.25 × ln(p_B). ln indica il logaritmo naturale. Il target nullo di C non gli assegna un termine proprio, ma C resta nel denominatore del softmax.
Le distribuzioni seguenti sono scelte per la spiegazione; non sono predizioni catturate durante r1.
| Quote predette A, B, C | Perdita approssimativa | Lettura |
|---|---|---|
| Un terzo, un terzo, un terzo | 1,098612 | I tre candidati ricevono la stessa quota |
| 0,74 ; 0,25 ; 0,01 | 0,572402 | La distribuzione è vicina al target |
| 0,95 ; 0,04 ; 0,01 | 0,843189 | A è favorito, ma B riceve troppo poco spazio |
Le ultime due distribuzioni danno tuttavia lo stesso ordine: A, B, C. La perdita non guarda quindi solo chi arriva primo. Confronta l'intera distribuzione con quella definita dai gradi.
Altra conseguenza: una buona perdita non deve necessariamente raggiungere zero. Per il target [0.75, 0.25, 0], il suo limite inferiore è −0.75 × ln(0.75) − 0.25 × ln(0.25) ≈ 0,562335. Con punteggi finiti, la quota di C resta strettamente positiva; il limite è avvicinato quando tende a zero. Cercare qui una perdita nulla significherebbe attendere il risultato sbagliato.
Per approfondire: un positivo può ricevere un gradiente che abbassa il suo punteggio
Per una sola lista inclusa, il gradiente rispetto a ogni punteggio vale quota predetta − quota target. Con tre punteggi uguali vale quindi circa [-0.416667, +0.083333, +0.333333].
Una discesa del gradiente eseguita direttamente su questi punteggi aumenterebbe A e diminuirebbe B e C. B è comunque positivo. Non è un errore di annotazione: riceve attualmente un terzo del totale, mentre il target gli assegna un quarto. Il calcolo cerca di correggere questa sovrarappresentazione, non di trasformare B in candidato incompatibile. La rete reale traduce poi questi gradienti in modifiche di pesi condivisi; ogni punteggio non è un parametro indipendente.
Il caso in cui nessuna lista contribuisce
Quando n vale zero, scores.sum() * 0 restituisce uno zero collegato al calcolo dei punteggi, con gradiente nullo quando i punteggi e la loro somma sono finiti. I contatori segnalano che tutte le liste sono state escluse.
Questo ritorno non significa che l'addestramento sia riuscito né che l'ottimizzatore debba avanzare: la decisione di continuare o saltare un aggiornamento appartiene al ciclo chiamante. L'estratto non contiene alcun optimizer.step().
Infine, questa funzione non è un validatore generale degli input. Non verifica esplicitamente tutte le forme, la finitezza dei punteggi o l'appartenenza dei gradi a {0, 1, 2}. Occorre mantenere i contratti e i controlli del progetto attorno a essa, invece di supporre che accetti qualsiasi array.
Installare e preparare le liste
Verificare l'ambiente prima di toccare i pesi
Scaricate lo ZIP, estraetelo e posizionate il terminale nella sua radice. Tutti i comandi seguenti partono da questa stessa directory. Seguono il percorso r1 di README.md e lesson/tutorial.json.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prepara il progetto. docker compose config --quiet verifica la configurazione Compose, poi build costruisce le immagini dei servizi acquire e gpu. L'acquisizione recupera gli asset pubblici secondo i lock. Lo script check_environment.py controlla quindi l'accesso CUDA nel contenitore.
L'ultimo comando esegue la suite di test del progetto. Questi test verificano la meccanica del programma; il loro successo non significa ancora che una scheda sarà pertinente per una richiesta reale del cliente. In questa fase l'obiettivo è ottenere un ambiente conforme e controlli senza errori prima dell'addestramento.
La forma ripetuta docker compose run --rm gpu … avvia un comando nel servizio gpu, poi rimuove il contenitore temporaneo al termine. Non significa che dobbiate entrare manualmente nel contenitore per digitare il seguito.
Preparare, ispezionare e verificare la formula
Possiamo ora costruire le liste, osservare ciò che riceve il modello e controllare la perdita su numeri noti.
docker compose run --rm gpu python -m listwise_ranker.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m listwise_ranker.cli inspect-pairs --config configs/minimum.yaml
docker compose run --rm gpu python -m listwise_ranker.cli check-loss --config configs/minimum.yaml
Dopo prepare, esaminate le partizioni e gli otto candidati di ogni lista. Occorre poter collegare una query, i suoi identificativi candidati e i gradi usati dal protocollo. Questa associazione deve restare stabile: se una colonna cambia documento senza che il suo grado la segua, il programma imparerebbe a favorire il candidato sbagliato.
inspect-pairs rende visibile il troncamento alla lunghezza fissata per il modello. Troncare significa rimuovere una parte dei token quando la coppia è troppo lunga. Il limite riguarda l'input della coppia, non solo il numero di parole della scheda. Il valore usato in r1 va letto nella configurazione dello ZIP.
Nel nostro esempio fittizio, una frase finale come «solo per la versione 2023» può essere decisiva. Se viene rimossa prima di BERT, non partecipa al punteggio. Il modello può allora valutare un input privato di un'informazione essenziale, anche se la scheda originale la contiene.
check-loss verifica il calcolo su tensori noti. Collegate il suo risultato alla trasformazione dei gradi e alla normalizzazione dei guadagni prima di avviare l'addestramento. Verificare la formula e la tokenizzazione sono due controlli complementari: una formula corretta non ripristina un testo troncato.
Addestrare, riprendere e misurare
Confrontare due obiettivi di apprendimento
Il primo comando addestra la variante listwise. Il secondo avvia la variante pointwise. I tre seguenti creano un'esecuzione interrotta, la riprendono e confrontano la ripresa.
docker compose run --rm gpu python -m listwise_ranker.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m listwise_ranker.cli train --config configs/minimum.yaml --variant pointwise
docker compose run --rm gpu python -m listwise_ranker.cli train --config configs/minimum.yaml --stop-after 20 --run-name interrupted
docker compose run --rm gpu python -m listwise_ranker.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m listwise_ranker.cli compare-resume --config configs/minimum.yaml
Mantenete quest'ordine: resumed dipende dal file artifacts/checkpoints/interrupted/state.pt creato da interrupted. L'opzione --stop-after 20 fissa qui il punto di interruzione della prova; non fornisce da sola il numero totale di aggiornamenti della ricetta.
Un checkpoint è un punto di salvataggio dell'addestramento. Una ripresa completa non si riduce a caricare pesi per fare una predizione: deve ritrovare lo stato necessario alla continuazione del calcolo. Il percorso prevede questo controllo con compare-resume. Consultatene l'output per conoscere il risultato della vostra esecuzione; le metriche di classificazione seguenti non sostituiscono tale controllo.
La variante pointwise serve da confronto. Il codice della sua perdita non è riprodotto in questo articolo: non deducetene una formula precisa dalla sola parola «pointwise». Per studiare questa differenza di implementazione, usate il codice dell'archivio mantenendo la configurazione di riferimento.
Misurare il lotto, poi spiegare un caso
Una volta controllati addestramento e ripresa, valutate le classifiche prima di soffermarvi su una ricerca particolarmente convincente.
docker compose run --rm gpu python -m listwise_ranker.cli evaluate --config configs/minimum.yaml
docker compose run --rm gpu python -m listwise_ranker.cli inspect-case --config configs/minimum.yaml
outputs/ranking-metrics.json contiene gli aggregati, cioè le misure che riassumono più query. inspect-case aiuta poi a rileggere un caso individuale.
Per questo caso, mettete a confronto la richiesta, le schede, i loro gradi e le loro posizioni prima e dopo il riordinamento. Verificate che gli identificativi siano rimasti gli stessi. Il caso spiega una parte del risultato; non basta per concludere sulla media delle 72 query di test.
Le metriche prima delle misure
La copertura@8: c'è almeno un candidato pertinente?
La copertura@8 è la proporzione di query i cui otto candidati contengono almeno un positivo:
copertura@8 = numero di liste con almeno un grado positivo / numero totale di query.
Questa misura risponde soltanto a una domanda di presenza. Una lista il cui unico positivo arriva ottavo è coperta. Lo è anche una lista che contiene soltanto una compatibilità parziale di grado 1. La copertura non significa quindi né «il pezzo giusto in testa», né «tutti i pezzi pertinenti ritrovati», né «compatibilità completa».
In un esempio didattico di quattro richieste, tre delle quali hanno almeno un positivo, la copertura vale 3 / 4 = 0,75. Riordinare queste stesse liste non cambia questo numero.
L'NDCG@5: quale qualità nelle prime posizioni?
L'NDCG, per normalized discounted cumulative gain, misura un guadagno di pertinenza cumulato, ridotto in base alla posizione e poi normalizzato. Dietro questo nome ci sono tre idee semplici: una scheda più pertinente apporta di più; una scheda collocata più in basso apporta meno; il risultato è confrontato con una classifica ideale.
Il suffisso @5 indica che soltanto le prime cinque posizioni contribuiscono al punteggio osservato. Con gradi non negativi e un ideale definito sullo stesso insieme di riferimento, 1 corrisponde all'ideale e 0 all'assenza di guadagno nelle prime cinque posizioni.
Facciamo il calcolo sul nostro esempio didattico. Scegliamo i guadagni 2^grade − 1 e una riduzione di rango 1 / log2(rang + 1), una convenzione documentata in TensorFlow Ranking. Questo riferimento spiega la metrica; non aggiunge alcuna dipendenza da TensorFlow al progetto.
Con questa convenzione, DCG@5 = somma dei guadagni nei primi cinque ranghi, ciascuno diviso per log2(rang + 1). log2 è il logaritmo in base 2: al rango 1 il denominatore vale 1; al rango 3 vale 2. Il grado 2 apporta quindi 3 in prima posizione, ma soltanto 1,5 in terza posizione.
Per gli otto gradi [2, 1, 0, 0, 0, 0, 0, 0], l'ordine ideale vale:
IDCG@5 = 3 / log2(2) + 1 / log2(3) ≈ 3,630930.
L'NDCG è poi DCG / IDCG. Ecco diverse permutazioni degli stessi gradi, calcolate soltanto per la spiegazione:
| Gradi nell'ordine proposto | Copertura@8 per questa query | NDCG@5 didattico |
|---|---|---|
| 2, 1, 0, 0, 0, 0, 0, 0 | 1 | 1,000000 |
| 1, 2, 0, 0, 0, 0, 0, 0 | 1 | 0,796708 |
| 0, 1, 2, 0, 0, 0, 0, 0 | 1 | 0,586883 |
| 0, 0, 0, 0, 0, 2, 1, 0 | 1 | 0,000000 |
L'ultima riga è importante: gli elementi pertinenti sono effettivamente presenti, ma troppo in basso per contribuire alla top 5. Il reranker ha quindi una possibilità di miglioramento, a differenza del caso in cui nessun positivo figuri tra i suoi candidati.
Il calcolo completo della metrica del progetto non è incluso nell'estratto Python precedente: quest'ultimo calcola la perdita di addestramento. Per adattare la valutazione, verificate anche su quali documenti è costruito l'ideale. Ordinare idealmente i candidati disponibili e confrontarli con tutti gli elementi pertinenti del catalogo non dà sempre lo stesso denominatore. I piccoli calcoli qui sopra usano esplicitamente gli otto gradi visualizzati come insieme di riferimento.
Infine, due ordini identici possono avere lo stesso NDCG e perdite diverse. Era il caso delle distribuzioni [0.74, 0.25, 0.01] e [0.95, 0.04, 0.01]: entrambe classificano A, B, C, ma non ripartiscono i punteggi allo stesso modo. La perdita serve per apprendere; la metrica serve per giudicare il risultato secondo un criterio dato.
Condizionale e end-to-end: due medie, due denominatori
L'NDCG@5 condizionale si calcola soltanto sulle liste coperte, quelle in cui il reranker dispone di almeno un positivo. Descrive la classifica nelle situazioni in cui era disponibile un documento pertinente.
L'NDCG@5 end-to-end mantiene nel denominatore anche le liste senza positivi. Nel protocollo presentato, contribuiscono con zero. Questa scelta rende visibile la parte delle richieste per le quali il sistema non presenta alcuna risposta pertinente.
Riprendiamo le nostre quattro richieste fittizie. Se le tre liste coperte raggiungono ciascuna un NDCG di 1, la loro media condizionale vale 1. Ma sulle quattro richieste, la media vale (1 + 1 + 1 + 0) / 4 = 0,75.
Con una media non ponderata e questa convenzione di zero per le liste non coperte, otteniamo:
NDCG end-to-end = copertura × NDCG condizionale.
Poiché l'NDCG condizionale non supera 1, la copertura fissa un tetto al punteggio end-to-end. Questo tetto è un limite; non è automaticamente raggiungibile da qualunque modello o con qualunque scelta di classifica ideale.
Una query senza risposta merita uno stato esplicito
Occorre ancora distinguere due possibili ragioni per non avere positivi in una lista: la scheda giusta esiste nel catalogo ma non è stata recuperata, oppure nessuna scheda del catalogo risponde alla richiesta.
Nel primo caso, migliorare il recupero può aiutare. Nel secondo, bisogna anche saper segnalare un'assenza di risposta. Il protocollo scelto conserva questi casi nel punteggio end-to-end; non è una convenzione universale che permetta, da sola, di diagnosticarne la causa.
Risultati reali
Le misure r1
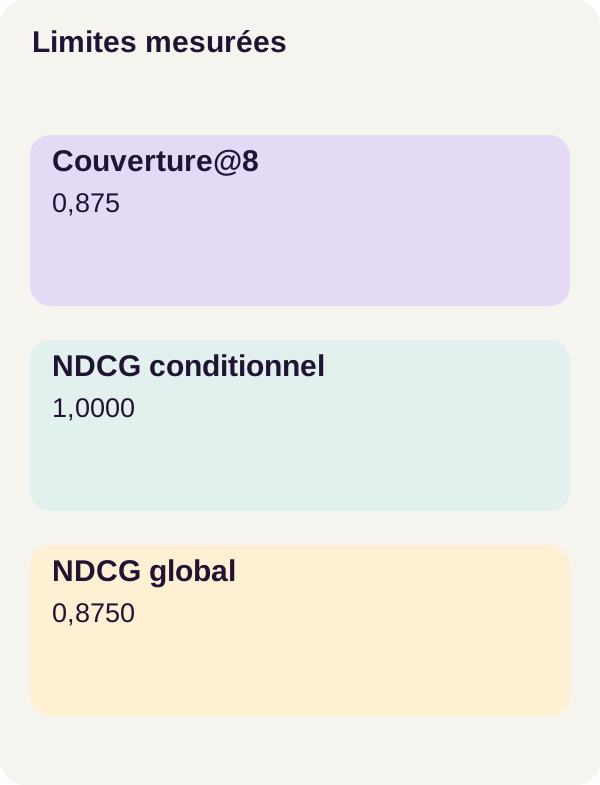
Il test riguarda 72 query, di cui 63 liste coperte. Il resoconto descrive gli altri 9 casi come privi di «alcun positivo globale». La copertura@8 vale 63 / 72 = 0,875.
Questa formulazione conta: non trasformiamo questi nove casi in nove pezzi giusti necessariamente presenti nel catalogo ma mancati dalla ricerca. Il numero di liste non coperte non basta a dimostrare questa diagnosi.
Ecco le misure pubblicate, mantenute con la loro precisione originale:
| Classifica | NDCG@5 condizionale | NDCG@5 end-to-end |
|---|---|---|
| Lessicale | 0,9903969127585871 | 0,8665972986637638 |
| Pointwise | 0,8838329034231467 | 0,7733537904952533 |
| Listwise | 1,0 | 0,875 |
La copertura@8 rimane 0,875: i reranker lavorano sugli stessi candidati. Il modello listwise raggiunge qui un ordine condizionale perfetto secondo la metrica utilizzata. La media end-to-end resta tuttavia limitata: (63 × 1 + 9 × 0) / 72 = 0,875.
I valori degli altri metodi seguono la stessa relazione, salvo gli arrotondamenti numerici. Per pointwise, 0,8838329034231467 × 0,875 ≈ 0,7733537904952533. Non c'è contraddizione tra due punteggi diversi: non dividono per la stessa popolazione.
Il risultato utile non è «l'IA batte la ricerca»
La ricerca lessicale è già molto forte su questo corpus: il suo NDCG condizionale vale circa 0,9904. Il modello listwise migliora questo risultato, ma il margine disponibile era ridotto. Sottraendo le misure pubblicate, il guadagno è di circa 0,009603 sull'NDCG condizionale e 0,008403 sul punteggio end-to-end. Si tratta di scarti di punteggio calcolati, non di nuove misure né di percentuali di pezzi compatibili.
La variante pointwise si classifica invece peggio del riferimento lessicale in questa esperienza. Aggiungere un modello e addestrarlo non è quindi un miglioramento per definizione. Occorre conservare un riferimento semplice per verificare ciò che apporta realmente il nuovo passaggio.
La tabella non consente nemmeno di affermare che listwise sarà sempre superiore a pointwise. Descrive questo corpus sintetico, questo modello e questa ricetta. Non fornisce una misura della latenza sotto carico né una prova di generalizzazione ad altri cataloghi.
Ciò che il punteggio perfetto non garantisce
Un NDCG condizionale di 1 significa che le prime posizioni soddisfano l'ideale scelto dalla valutazione per le liste coperte. Non è una certificazione di compatibilità fisica, né l'assenza di casi senza risposta, né una prova che le annotazioni siano perfette.
La lezione principale è quindi duplice: apprendere l'ordine può aiutare, ma l'ordine resta limitato dai candidati e dalla definizione di pertinenza. Il recupero, l'apprendimento e la valutazione hanno ciascuno il proprio ruolo; un buon numero in una fase non sostituisce gli altri.
Esercizio: prevedere, poi eseguire
Rimuovere il miglior candidato
Immaginate di rimuovere A, il miglior documento del nostro esempio, mantenendo gli identificativi degli altri candidati. Senza eseguire il programma, formulate la vostra previsione: un addestramento supplementare o un punteggio molto alto possono far riapparire A nella classifica di questa lista?
Lo scenario fornito effettua questo confronto senza chiedervi di modificare il motore di riferimento.
docker compose run --rm gpu python -m listwise_ranker.cli exercise --config configs/exercise.yaml
L'output conferma che il reranker riceve e restituisce gli stessi candidati: può riordinarli, ma non recupera mai un identificativo assente. Per verificare questa proprietà, confrontate gli identificativi della lista dopo la rimozione con quelli della classifica finale. Non confrontateli con la lista iniziale dimenticando la rimozione volontaria.
Attenzione a una seconda previsione: rimuovere il miglior documento non rende necessariamente la lista interamente non pertinente. Se B, di grado 1, resta presente, la lista è ancora coperta. Se abbiamo rimosso il suo unico positivo, non lo è più. In entrambi i casi, il miglior documento assente resta impossibile da ritrovare con un semplice riordinamento.
Questa distinzione spiega perché l'esercizio verifica anzitutto una proprietà degli identificativi. Un ordine migliore dei candidati rimanenti non proverebbe che il recupero è stato riparato.
Conservare gli artefatti prima di terminare
Un artefatto è un file prodotto dal percorso: figura, misura o salvataggio dell'addestramento. Terminate generando le figure, controllando i checkpoint, visualizzando in anteprima la pulizia e arrestando i servizi, in quest'ordine.
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
I checkpoint vengono controllati dopo l'esercizio. --dry-run richiede un'anteprima: clean.py indica ciò che prenderebbe di mira, senza eliminare i file. Il comando docker compose down --remove-orphans arresta i servizi del progetto; i file del percorso conservati sull'host restano disponibili.
Adattamento, limiti, risoluzione dei problemi e pulizia
Passare da un catalogo fittizio alle vostre schede
Il primo passo non è cambiare BERT. È scrivere una definizione di pertinenza rivista dalle persone che conoscono il catalogo. Che cosa significa esattamente «parzialmente compatibile»? È un risultato da mostrare con riserva, un'alternativa utile o un pezzo da escludere da ogni proposta di acquisto? La graduazione scelta per un tutorial non sostituisce questa decisione aziendale.
Versionate le schede, le query, le annotazioni e le partizioni. I testi possono evolvere mentre gli identificativi restano stabili; senza una versione del catalogo, rischiate di confrontare un vecchio punteggio con una nuova scheda. Conservate anche la lista dei candidati per distinguere una modifica della classifica da una modifica del recupero.
Misurate separatamente la copertura, i ranghi, la troncatura e il costo del reranking. Se aumentate il numero di candidati, modificate sia ciò che diventa accessibile al modello sia il numero di coppie da elaborare. Il nuovo risultato deve essere valutato come una nuova esperienza, non aggiunto alle cifre r1 come se descrivesse lo stesso protocollo.
Verificare le lingue e le informazioni realmente lette
La scheda del modello BERT base uncased indica un preaddestramento in inglese e un trattamento che non distingue maiuscole e minuscole. Il nome «BERT» non garantisce quindi un adattamento automatico a richieste francesi, a riferimenti tecnici o a tutte le convenzioni del vostro catalogo. L'esempio francese usato nelle nostre spiegazioni non è un risultato multilingue misurato.
Il max_length del cross-encoder può anche eliminare la parte decisiva di una scheda. Un testo visibile in un file sorgente non è necessariamente interamente visibile dalla rete dopo la tokenizzazione. Ispezionate le coppie prima di attribuire un errore al solo apprendimento.
Non confondere classifica e decisione
Il meccanismo restituisce un ordine, non un'autorizzazione all'acquisto o all'installazione. Controllate i casi ad alta posta in gioco prima di qualsiasi automazione. Un sistema reale deve in particolare gestire le richieste senza risposta, le annotazioni incerte e le regole che vietano alcune sostituzioni.
Il target listwise richiede una ripartizione relativa tra candidati; qui non apprende una soglia universale di compatibilità. Progettare un rifiuto o una validazione umana richiede dati e controlli specifici, distinti dal solo miglioramento dell'NDCG.
Risolvere i problemi senza cambiare silenziosamente l'esperienza
La GPU non è visibile. Riavviate il controllo dell'ambiente prima dell'addestramento, poi verificate l'integrazione Docker con la guida NVIDIA Container Toolkit. Non sostituite discretamente l'esecuzione GPU con un percorso CPU non validato.
L'acquisizione non riesce. Verificate l'accesso di rete del servizio acquire, correggete la causa dell'errore e rieseguite lo stesso comando. Modificare la revisione del modello per aggirare una risorsa mancante farebbe perdere il riferimento dell'esperienza.
La perdita sembra anormalmente bassa. Rileggete included e excluded prima di concludere. Un lotto interamente escluso dà zero senza aver fornito supervisione. Una maschera che ritira candidati scomodi può anche rendere l'obiettivo artificialmente più facile.
L'NDCG condizionale è eccellente, ma il punteggio globale raggiunge un tetto. Guardate la copertura e le richieste senza positivi. Non chiedete al reranker di restituire schede che non ha ricevuto, né di creare un pezzo assente dal catalogo.
Volete pulire le prove. I comandi di fine percorso sono già indicati nell'esercizio. clean.py --dry-run non elimina alcun risultato; docker compose down --remove-orphans non sostituisce una pulizia dei vostri file locali. Esaminate e conservate le misure utili prima di qualsiasi eliminazione separata.
Abbiamo così un percorso che collega un'esigenza di interfaccia — presentare meglio i risultati — a una formula di apprendimento verificabile. La sua conclusione resta concreta: un buon reranker rimette i candidati giusti al posto giusto; non dispensa mai dal verificare quali candidati fossero disponibili.
Fonti ufficiali
I riferimenti seguenti servono ad approfondire i concetti. Per riprodurre le misure r1, conservate le versioni e la configurazione dell'archivio: le documentazioni esterne non le sostituiscono.
- Sentence Transformers: addestramento di un CrossEncoder, per il principio di assegnazione di un punteggio alle coppie e l'addestramento di un reranker.
- Sentence Transformers: loss CrossEncoder, per confrontare le famiglie di loss senza confonderne le implementazioni.
- BERT base uncased, per il modello, la sua lingua di preaddestramento e la rappresentazione delle coppie.
- PyTorch:
log_softmax, per il calcolo stabile dei logaritmi delle probabilità. Questa pagina versionata documenta l'operazione; non dichiara la versione installata dal progetto. - TensorFlow Ranking: definizione di NDCG, per la normalizzazione del guadagno e le convenzioni del calcolo didattico, senza utilizzare TensorFlow nel percorso.
- Docker Compose: supporto GPU e NVIDIA Container Toolkit: installazione, per l'accesso alla scheda da un container.