





Imagine la barra de búsqueda de una tienda de recambios. Un cliente describe su aparato, su versión y la pieza que busca. El motor encuentra la familia de productos adecuada… pero sitúa una pieza casi compatible antes que la que responde exactamente a la solicitud.
El problema ya no consiste solo en encontrar fichas. También hay que ordenarlas bien.
Ese es el papel de un reranker, o modelo de reclasificación: releer la solicitud con cada candidato ya recuperado, asignar puntuaciones y modificar su orden. Para un desarrollador web, el límite se parece al de una función que ordena un array devuelto por una API: puede mover sus elementos, pero no recuperar un elemento que la API nunca le envió.
En este tutorial entrenaremos esta reclasificación, entenderemos su cálculo y mediremos su límite. Un orden excelente no puede reparar por sí solo una lista que no contiene ninguna respuesta pertinente.
Descargar el proyecto completo del tutorial
Lo que construimos
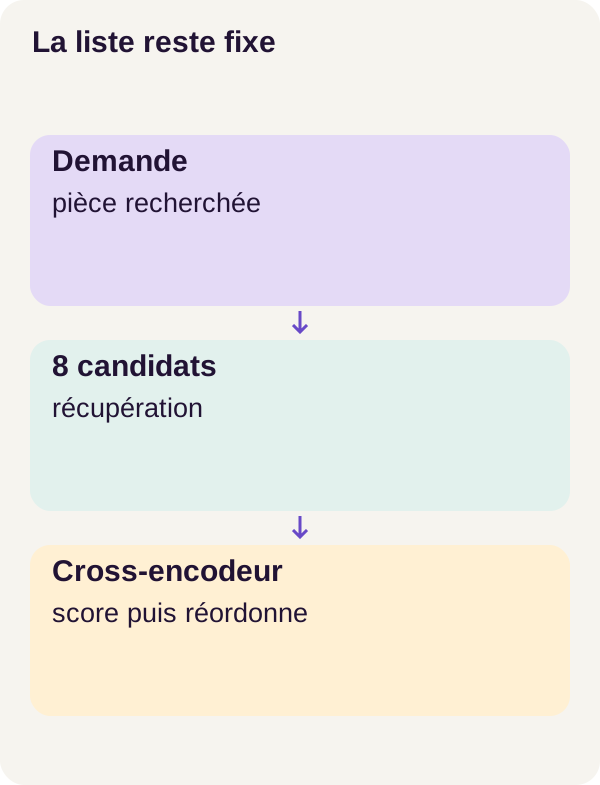
Construimos un catálogo sintético, es decir, un catálogo ficticio creado para el experimento. Para cada solicitud, una búsqueda léxica, basada en los términos de los textos, recupera ocho fichas candidatas. Un modelo BERT usado como codificador cruzado asigna después una puntuación a cada pareja (consulta, documento).
Durante el entrenamiento reunimos las ocho puntuaciones de una misma consulta para aprender una distribución que favorezca a los candidatos pertinentes. Es el enfoque listwise: la función de aprendizaje tiene en cuenta la lista y no solo cada pareja aislada.
Al final, los identificadores de los candidatos siguen siendo los mismos. Cambia su posición, no su pertenencia a la lista. El programa no redacta una respuesta, no crea una ficha de producto ni certifica la compatibilidad de una pieza real.
Compararemos tres clasificaciones: la de la búsqueda léxica, la de un modelo entrenado pointwise y la del modelo entrenado listwise. También comprobaremos la reanudación tras una interrupción y leeremos los resultados en outputs/ranking-metrics.json.
No necesita conocer BERT ni las funciones de pérdida para empezar. Las listas, las funciones, algunas bases de Python y un terminal bastan para seguir las explicaciones. El recorrido ejecutable también requiere los requisitos de Docker y GPU indicados más abajo.
Conceptos explicados
Recuperar no es reclasificar
La recuperación responde a la pregunta: «Entre todas las fichas, ¿cuáles vamos a examinar?». El reranking responde después: «¿En qué orden mostrar las fichas seleccionadas?».
Tomemos un ejemplo inventado, distinto del corpus r1. Un usuario busca el filtro de un aparato ficticio Atlas, versión 2024. Para simplificar la explicación, solo mostramos tres candidatos, mientras que el recorrido real utiliza ocho.
| Candidato pedagógico | Lectura de la ficha | Grado asignado para este ejemplo |
|---|---|---|
| A | Responde completamente a la solicitud | 2 |
| B | Responde solo a una parte de los criterios | 1 |
| C | No responde a la solicitud | 0 |
La búsqueda podría devolver el orden B, C, A. Nos gustaría obtener A, B, C. Sin embargo, si A no está en la lista recibida, ninguna ordenación puede añadirla.
Los grados son anotaciones: valores de referencia definidos para indicar qué es pertinente. El modelo aprende a partir de estos valores; no los inventa para calificar sus propias respuestas. En este tutorial, un «positivo» es un candidato de grado 1 o 2. Por tanto, positivo no significa necesariamente plenamente compatible.
Cómo BERT transforma una pareja de textos en una puntuación
Un modelo no calcula directamente sobre cadenas de caracteres. El tokenizer divide el texto en unidades llamadas tokens y las sustituye por identificadores numéricos. Un token puede ser una palabra, una parte de palabra o un signo: contar palabras no basta para conocer la longitud que recibirá el modelo.
La pareja puede representarse esquemáticamente así: [CLS] consulta [SEP] ficha [SEP]. Se trata de un esquema de lectura, no de una salida de tokenización capturada en el experimento. [SEP] separa los dos textos; [CLS] es una posición especial cuya representación servirá aquí para calcular la puntuación. La ficha de BERT describe este formato de entrada.
BERT calcula representaciones numéricas que tienen en cuenta el contexto de los tokens. En nuestro codificador cruzado, la consulta y la ficha se procesan juntas: sus palabras pueden relacionarse durante este cálculo. Una cabeza lineal transforma después el vector asociado a [CLS] en un único número. Piense en una función final que combina las coordenadas del vector con coeficientes aprendidos.
Este número es una puntuación, también llamada logit antes de su posible transformación en distribución. Sirve para clasificar las fichas de una misma solicitud. Una puntuación de 3 no significa ni «grado 3», ni «tres veces más compatible», ni «probabilidad de compatibilidad del 300 %».
Un bi-encoder funcionaría de otro modo: codificaría por separado la consulta y los documentos y después compararía sus vectores. En cambio, el codificador cruzado vuelve a leer una pareja para cada candidato. Esto permite comparar directamente ambos textos, con un coste de cálculo adicional. La documentación CrossEncoder de Sentence Transformers presenta esta arquitectura de reclasificación.
Lo que listwise cambia realmente
Aquí BERT sigue puntuando las parejas por separado. No le enviamos las ocho fichas en un único texto grande. Es la función de pérdida la que reúne sus puntuaciones por consulta.
Una pérdida, o loss, es un número que el entrenamiento intenta reducir. En un enfoque pointwise, cada pareja contribuye de forma independiente al objetivo. En nuestro enfoque listwise, las puntuaciones de los candidatos se normalizan juntas: aumentar la parte concedida a uno cambia las partes relativas de los demás.
El objetivo es coherente con nuestra necesidad: no queremos solo reconocer varias fichas interesantes; queremos dar más peso a una respuesta completa que a una respuesta parcial. Esta elección sigue siendo una hipótesis que hay que evaluar, no una garantía de que listwise siempre supere a pointwise.
La documentación de pérdidas CrossEncoder permite situar esta familia de métodos. No obstante, el proyecto utiliza su propia función graded_listwise_loss, detallada más abajo. El nombre de una familia no basta para conocer la fórmula exacta de una implementación.
Del grado a una distribución esperada
La transformación utilizada es gain = 2^grade − 1. Para A, B y C da las ganancias [3, 1, 0]. Después dividimos cada ganancia por su suma, es decir, 4: el objetivo pasa a ser [0.75, 0.25, 0].
Dicho de otro modo, la distribución esperada concede tres cuartas partes de su masa a A y una cuarta parte a B. La palabra masa designa aquí simplemente una parte de un total igual a 1. No es una probabilidad de negocio: el grado 2 de A se conoce por anotación y no se estima como un evento con un 75 % de probabilidades de ocurrir.
El objetivo no corresponde a un softmax aplicado a los grados. El cálculo es: grados → ganancias → división por la suma de las ganancias. Cambiar esta transformación cambiaría el objetivo de aprendizaje.
Para convertir las puntuaciones del modelo en una distribución comparable, usamos en cambio un softmax: p_i = exp(score_i) / suma_j exp(score_j). Los valores son positivos y su suma es 1. Con tres puntuaciones iguales, cada una recibe un tercio. Con ocho puntuaciones iguales, cada una recibe un octavo.
Esta normalización es relativa a la lista. Incluso ocho fichas malas pueden recibir ocho partes cuya suma sea 1. Por tanto, el softmax no es por sí solo un detector de «ninguna pieza compatible».
Entrenamiento y uso del modelo
Los pesos son los coeficientes numéricos aprendidos por la red. Durante el entrenamiento, las puntuaciones se comparan con los objetivos; la retropropagación calcula gradientes, es decir, la sensibilidad de la pérdida a estos coeficientes. Un optimizador utiliza estos gradientes para actualizar los parámetros entrenables.
Durante el uso, llamado inferencia, el modelo calcula las puntuaciones sin recibir los grados esperados como información que explotar. Las anotaciones sirven después para evaluar la clasificación, no para soplarle la respuesta correcta.
Requisitos de Docker y GPU
El recorrido r1 se definió para Linux x86_64, Docker Compose, NVIDIA Container Toolkit y una RTX 3090 de 24 GiB. El README prevé 16 GiB de RAM y 16 GiB de disco. No describe un recorrido de CPU validado.
La RAM es la memoria de la máquina; la memoria de la tarjeta gráfica sirve para los cálculos de GPU. Estas previsiones son las del proyecto: no demuestran un mínimo universal para cualquier tarjeta o configuración.
Docker proporciona el entorno de ejecución. NVIDIA Container Toolkit permite que la GPU sea accesible desde ese entorno; CUDA es la pila empleada para realizar allí los cálculos. No basta con que una tarjeta sea visible desde Linux: la comprobación de CUDA debe tener éxito en el contenedor antes del entrenamiento.
El archivo locks/models.lock.json fija google-bert/bert-base-uncased en la revisión 86b5e0934494bd15c9632b12f734a8a67f723594. El archivo locks/environment.lock.json describe el entorno bloqueado. Para un desarrollador web, estos bloqueos cumplen una función comparable a la de un archivo de dependencias fijadas: evitan que dos instalaciones utilicen silenciosamente versiones diferentes.
El servicio acquire recupera los activos públicos; el servicio gpu ejecuta el código local. Conserve las referencias del proyecto para reproducir r1: sustituir el modelo o las dependencias crea otro experimento.
Datos y función central
Separar los ejemplos antes de aprender
El catálogo sintético contiene 480 documentos y 480 consultas. La división por familias prevé 336 para entrenamiento, 72 para validación y 72 para prueba. Cada lista contiene ocho candidatos. Los grados 0, 1 y 2 representan respectivamente incompatibilidad, compatibilidad parcial y compatibilidad completa.
El entrenamiento sirve para modificar los pesos. La validación sirve para examinar las decisiones de aprendizaje. La prueba sirve para la medición final. La separación por familias pretende evitar que ejemplos muy relacionados se utilicen a la vez para aprender y para juzgar el resultado. Las etiquetas de entrenamiento solo están presentes para los candidatos de train.
En una aplicación web probablemente ya ha usado datos de prueba cuyas respuestas esperadas se conocen. El principio es similar, con una restricción adicional: no entrenar el modelo con las respuestas que servirán para su examen final.
Las entradas y la salida de la función
Un tensor es una matriz numérica, posiblemente de varias dimensiones. Aquí, scores y grades tienen una fila por consulta y una columna por candidato. Para un lote de B consultas del recorrido, su forma es por tanto B × 8.
mask es una matriz booleana con la misma organización. Un valor True indica una posición que se debe tener en cuenta; False designa una posición ignorada. El recorrido anuncia ocho candidatos por lista: la presencia de este parámetro en la función no significa que sus datos contengan necesariamente posiciones de relleno.
Este es el fragmento continuo de src/listwise_ranker/losses.py. Supone que PyTorch se importa con el nombre torch en su módulo.
def graded_listwise_loss(scores, grades, mask=None):
    mask = torch.ones_like(grades, dtype=torch.bool) if mask is None else mask
    gains = (torch.pow(2.0, grades) - 1) * mask
    included = gains.sum(-1) > 0
    n = int(included.sum())
    if not n:
        return scores.sum() * 0, {"included": 0, "excluded": scores.shape[0]}
    selected = scores[included].masked_fill(~mask[included], -torch.inf)
    target = gains[included] / gains[included].sum(-1, keepdim=True)
    logp = torch.log_softmax(selected, dim=-1).masked_fill(~mask[included], 0.0)
    return -(target * logp).sum(-1).mean(), {
        "included": n,
        "excluded": scores.shape[0] - n,
    }
Esta función devuelve una pérdida y contadores. No tokeniza ningún texto, no llama a BERT, no ordena los identificadores ni actualiza ella misma los pesos. Es una etapa del programa de entrenamiento, no todo el programa.
Seguir el cálculo, línea por línea
Crear la máscara y las ganancias. Sin una máscara proporcionada, torch.ones_like(..., dtype=torch.bool) tiene en cuenta todas las posiciones. Después, torch.pow(2.0, grades) - 1 transforma los grados en ganancias. Su multiplicación por la máscara anula la contribución de las posiciones ignoradas.
Elegir las listas utilizables. gains.sum(-1) suma las ganancias de cada fila: -1 designa la última dimensión, la de los candidatos. included conserva las filas cuya suma es estrictamente positiva. Por tanto, el contador n es un número de listas incluidas, no un número de documentos positivos.
Una lista de ocho grados 0 no tiene una distribución objetivo que normalizar: su suma de ganancias es nula. Se excluye de la pérdida. Eso no significa que deba desaparecer de la evaluación de extremo a extremo.
Apartar las posiciones enmascaradas. Para las listas seleccionadas, masked_fill sustituye las puntuaciones ignoradas por -torch.inf, es decir, menos infinito. En el softmax, su exponencial vale cero: esas posiciones no reciben ninguna parte de la distribución.
Formar el objetivo. Las ganancias de cada fila se dividen por su suma. keepdim=True conserva una dimensión de anchura 1 para que cada fila se divida por su propio total. Nuestro ejemplo [3, 1, 0] da efectivamente [0.75, 0.25, 0].
Calcular los logaritmos de las partes predichas. torch.log_softmax produce directamente los logaritmos del softmax. Es preferible al cálculo separado del softmax y luego de su logaritmo por su estabilidad numérica, como explica la documentación de PyTorch.
El segundo masked_fill sustituye por 0 los valores de las posiciones ignoradas en logp. ¿Por qué volver a enmascarar? Porque la multiplicación 0 × (−inf) no da un cero numérico utilizable: puede producir NaN, un valor «no es un número». La posición ignorada debe contribuir exactamente con cero al producto final.
Sumar y después promediar. -(target * logp).sum(-1) calcula una pérdida por lista, llamada aquí entropía cruzada. El promedio final solo se aplica a las listas incluidas. Los contadores included y excluded permiten seguir esta población.
Un grado 0 no es una posición ausente
Hay que distinguir dos situaciones. Un candidato de grado 0, con una máscara True, sigue siendo un competidor en el softmax. Su ganancia objetivo es nula, pero darle una parte grande priva de ella a los positivos y aumenta la pérdida. Una posición enmascarada False se retira de la comparación.
Volvamos a tres puntuaciones iguales y los grados [2, 1, 0]. Sin enmascaramiento, las probabilidades son [1/3, 1/3, 1/3]. Si enmascaramos solo al tercer candidato, las dos partes restantes pasan a ser [0.5, 0.5]. Retirar los negativos del denominador no es neutro: cambia el ejercicio que pedimos al modelo.
También existe un caso límite: si la máscara retira todos los positivos de una fila, esa fila queda excluida de la pérdida, aunque sus grados iniciales contuvieran positivos.
Calcular la pérdida a mano
En el ejemplo pedagógico A, B, C, el objetivo es [0.75, 0.25, 0]. Para puntuaciones finitas y posiciones activas, la fórmula es: L = −0.75 × ln(p_A) − 0.25 × ln(p_B). ln designa el logaritmo natural. El objetivo nulo de C no le da un término propio, pero C permanece en el denominador del softmax.
Las distribuciones siguientes se han elegido para la explicación; no son predicciones capturadas durante r1.
| Partes predichas A, B, C | Pérdida aproximada | Interpretación |
|---|---|---|
| Un tercio, un tercio, un tercio | 1,098612 | Los tres candidatos reciben la misma parte |
| 0,74 ; 0,25 ; 0,01 | 0,572402 | La distribución está próxima al objetivo |
| 0,95 ; 0,04 ; 0,01 | 0,843189 | A se favorece, pero B recibe demasiado poco espacio |
Sin embargo, las dos últimas distribuciones dan el mismo orden: A, B, C. Por tanto, la pérdida no observa solo quién llega primero. Compara la distribución completa con la definida por los grados.
Otra consecuencia: una buena pérdida no tiene necesariamente que llegar a cero. Para el objetivo [0.75, 0.25, 0], su límite inferior es −0.75 × ln(0.75) − 0.25 × ln(0.25) ≈ 0,562335. Con puntuaciones finitas, la parte de C sigue siendo estrictamente positiva; este límite se aproxima a medida que tiende a cero. Buscar aquí una pérdida nula equivaldría a esperar el resultado equivocado.
Para profundizar: un positivo puede recibir un gradiente que reduzca su puntuación
Para una sola lista incluida, el gradiente respecto a cada puntuación vale parte predicha − parte objetivo. Con tres puntuaciones iguales vale aproximadamente [-0.416667, +0.083333, +0.333333].
Un descenso de gradiente aplicado directamente a estas puntuaciones aumentaría A y reduciría B y C. Sin embargo, B es positivo. No es un error de anotación: actualmente recibe un tercio del total, mientras que el objetivo le asigna un cuarto. El cálculo busca corregir esta sobrerrepresentación, no transformar B en candidato incompatible. La red real traduce después estos gradientes en modificaciones de pesos compartidos; cada puntuación no es un parámetro independiente.
El caso en que ninguna lista contribuye
Cuando n vale cero, scores.sum() * 0 devuelve un cero ligado al cálculo de las puntuaciones, con un gradiente nulo cuando las puntuaciones y su suma son finitas. Los contadores indican que todas las listas se han excluido.
Este retorno no significa que el entrenamiento haya tenido éxito ni que el optimizador deba avanzar: la decisión de continuar o saltar una actualización corresponde al bucle que llama. El fragmento no contiene ningún optimizer.step().
Por último, esta función no es un validador general de entradas. No comprueba explícitamente todas las formas, la finitud de las puntuaciones ni que los grados pertenezcan a {0, 1, 2}. Hay que mantener los contratos y controles del proyecto a su alrededor, en vez de suponer que acepta cualquier matriz.
Instalar y preparar las listas
Comprobar el entorno antes de modificar los pesos
Descargue el ZIP, extráigalo y sitúe el terminal en su raíz. Todos los comandos siguientes parten de este mismo directorio. Siguen el recorrido r1 de README.md y de lesson/tutorial.json.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prepara el proyecto. docker compose config --quiet comprueba la configuración de Compose y luego build construye las imágenes de los servicios acquire y gpu. La adquisición recupera los activos públicos según los bloqueos. El script check_environment.py comprueba después el acceso a CUDA en el contenedor.
El último comando ejecuta la suite de pruebas del proyecto. Estas pruebas comprueban la mecánica del programa; que tengan éxito todavía no significa que una ficha sea pertinente para una solicitud real de cliente. En esta etapa, el objetivo es obtener un entorno conforme y comprobaciones sin fallos antes del aprendizaje.
La forma repetida docker compose run --rm gpu … ejecuta un comando en el servicio gpu y luego elimina el contenedor temporal al terminar. No significa que deba entrar manualmente en el contenedor para escribir lo siguiente.
Preparar, inspeccionar y comprobar la fórmula
Ahora podemos construir las listas, ver lo que recibe el modelo y comprobar la pérdida con números conocidos.
docker compose run --rm gpu python -m listwise_ranker.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m listwise_ranker.cli inspect-pairs --config configs/minimum.yaml
docker compose run --rm gpu python -m listwise_ranker.cli check-loss --config configs/minimum.yaml
Después de prepare, examine las particiones y los ocho candidatos de cada lista. Debe poder relacionar una consulta, sus identificadores candidatos y los grados usados por el protocolo. Esta asociación debe permanecer estable: si una columna cambia de documento sin que su grado la siga, el programa aprendería a favorecer al candidato equivocado.
inspect-pairs hace visible la truncación a la longitud fijada para el modelo. Truncar significa retirar una parte de los tokens cuando la pareja es demasiado larga. El límite se aplica a la entrada de la pareja, no solo al número de palabras de la ficha. El valor usado en r1 debe leerse en la configuración del ZIP.
En nuestro ejemplo ficticio, una frase final como «únicamente para la versión 2023» puede ser decisiva. Si se retira antes de BERT, no participa en la puntuación. El modelo puede entonces calificar una entrada privada de información esencial, aunque la ficha original la contenga.
check-loss comprueba el cálculo con tensores conocidos. Relacione su resultado con la transformación de los grados y la normalización de las ganancias antes de iniciar el entrenamiento. Comprobar la fórmula y comprobar la tokenización son controles complementarios: una fórmula correcta no restablece un texto truncado.
Entrenar, reanudar y medir
Comparar dos objetivos de aprendizaje
El primer comando entrena la variante listwise. El segundo inicia la variante pointwise. Los tres siguientes crean una ejecución interrumpida, la reanudan y comparan la reanudación.
docker compose run --rm gpu python -m listwise_ranker.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m listwise_ranker.cli train --config configs/minimum.yaml --variant pointwise
docker compose run --rm gpu python -m listwise_ranker.cli train --config configs/minimum.yaml --stop-after 20 --run-name interrupted
docker compose run --rm gpu python -m listwise_ranker.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m listwise_ranker.cli compare-resume --config configs/minimum.yaml
Mantenga este orden: resumed depende del archivo artifacts/checkpoints/interrupted/state.pt creado por interrupted. La opción --stop-after 20 fija aquí el punto de interrupción de la prueba; por sí sola no proporciona el número total de actualizaciones de la receta.
Un checkpoint es un punto de guardado del entrenamiento. Una reanudación completa no se reduce a cargar pesos para hacer una predicción: debe recuperar el estado necesario para continuar el cálculo. El recorrido prevé este control con compare-resume. Consulte su salida para conocer el resultado de su ejecución; las métricas de clasificación siguientes no sustituyen este control de reanudación.
La variante pointwise sirve de comparación. El código de su pérdida no se reproduce en este artículo: no deduzca una fórmula precisa a partir de la sola palabra «pointwise». Para estudiar esta diferencia de implementación, use el código del archivo, conservando la configuración de referencia.
Medir el lote y explicar después un caso
Una vez controlados el aprendizaje y la reanudación, evalúe las clasificaciones antes de detenerse en una búsqueda especialmente convincente.
docker compose run --rm gpu python -m listwise_ranker.cli evaluate --config configs/minimum.yaml
docker compose run --rm gpu python -m listwise_ranker.cli inspect-case --config configs/minimum.yaml
outputs/ranking-metrics.json contiene los agregados, es decir, las medidas que resumen varias consultas. inspect-case ayuda después a releer un caso individual.
Para este caso, relacione la solicitud, las fichas, sus grados y sus posiciones antes y después de la reclasificación. Compruebe que los identificadores siguen siendo los mismos. El caso explica una parte del resultado; no basta para concluir sobre el promedio de las 72 consultas de prueba.
Métricas antes de las mediciones
Cobertura@8: ¿hay al menos un candidato pertinente?
La cobertura@8 es la proporción de consultas cuyos ocho candidatos contienen al menos un positivo:
cobertura@8 = número de listas con al menos un grado positivo / número total de consultas.
Esta medida solo responde a una cuestión de presencia. Una lista cuyo único positivo llega en octava posición está cubierta. También lo está una lista que solo contiene una compatibilidad parcial de grado 1. Por tanto, la cobertura no significa ni «la pieza correcta en cabeza», ni «todas las piezas pertinentes recuperadas», ni «compatibilidad completa».
En un ejemplo pedagógico de cuatro solicitudes, de las que tres tienen al menos un positivo, la cobertura vale 3 / 4 = 0,75. Reordenar estas mismas listas no cambia este número.
NDCG@5: ¿qué calidad hay en las primeras posiciones?
El NDCG, por normalized discounted cumulative gain, mide una ganancia de pertinencia acumulada, reducida según la posición y después normalizada. Tras ese nombre hay tres ideas sencillas: una ficha más pertinente aporta más; una ficha colocada más abajo aporta menos; el resultado se compara con una clasificación ideal.
El sufijo @5 indica que solo las cinco primeras posiciones contribuyen a la puntuación observada. Con grados no negativos y un ideal definido sobre el mismo conjunto de referencia, 1 corresponde al ideal y 0 a la ausencia de ganancia en las cinco primeras posiciones.
Hagamos el cálculo sobre nuestro ejemplo pedagógico. Elegimos las ganancias 2^grade − 1 y una reducción por rango 1 / log2(rango + 1), una convención documentada en TensorFlow Ranking. Esta referencia explica la métrica; no añade ninguna dependencia TensorFlow al proyecto.
Con esta convención, DCG@5 = suma de las ganancias en los cinco primeros rangos, divididas cada una por log2(rango + 1). log2 es el logaritmo en base 2: en el rango 1, el denominador vale 1; en el rango 3 vale 2. Por tanto, el grado 2 aporta 3 en primera posición, pero solo 1,5 en tercera posición.
Para los ocho grados [2, 1, 0, 0, 0, 0, 0, 0], el orden ideal vale:
IDCG@5 = 3 / log2(2) + 1 / log2(3) ≈ 3,630930.
El NDCG es entonces DCG / IDCG. Estas son varias permutaciones de los mismos grados, calculadas únicamente para la explicación:
| Grados en el orden propuesto | Cobertura@8 para esta consulta | NDCG@5 pedagógico |
|---|---|---|
| 2, 1, 0, 0, 0, 0, 0, 0 | 1 | 1,000000 |
| 1, 2, 0, 0, 0, 0, 0, 0 | 1 | 0,796708 |
| 0, 1, 2, 0, 0, 0, 0, 0 | 1 | 0,586883 |
| 0, 0, 0, 0, 0, 2, 1, 0 | 1 | 0,000000 |
La última fila es importante: los pertinentes sí están presentes, pero demasiado abajo para contribuir al top 5. Por tanto, el reranker puede mejorar, a diferencia del caso en que ningún positivo figura entre sus candidatos.
El cálculo completo de la métrica del proyecto no se incluye en el fragmento Python anterior: este calcula la pérdida de entrenamiento. Para adaptar la evaluación, compruebe también sobre qué documentos se construye el ideal. Ordenar idealmente los candidatos disponibles y compararlos con todos los pertinentes del catálogo no siempre dan el mismo denominador. Los pequeños cálculos anteriores utilizan explícitamente los ocho grados mostrados como conjunto de referencia.
Por último, dos órdenes idénticos pueden tener el mismo NDCG y pérdidas diferentes. Era el caso de las distribuciones [0.74, 0.25, 0.01] y [0.95, 0.04, 0.01]: ambas clasifican A, B, C, pero no distribuyen las puntuaciones igual. La pérdida sirve para aprender; la métrica sirve para juzgar el resultado según un criterio dado.
Condicional y extremo a extremo: dos promedios, dos denominadores
El NDCG@5 condicional se calcula solo sobre las listas cubiertas, aquellas donde el reranker dispone de al menos un positivo. Describe la clasificación en situaciones en las que había un documento pertinente disponible.
El NDCG@5 de extremo a extremo también mantiene en el denominador las listas sin positivo. En el protocolo presentado, contribuyen con cero. Esta elección hace visible la parte de solicitudes para las que el sistema no presenta ninguna respuesta pertinente.
Volvamos a nuestras cuatro solicitudes ficticias. Si las tres listas cubiertas alcanzan cada una un NDCG de 1, su promedio condicional vale 1. Pero sobre las cuatro solicitudes, el promedio vale (1 + 1 + 1 + 0) / 4 = 0,75.
Con un promedio no ponderado y esta convención de cero para las listas no cubiertas, tenemos:
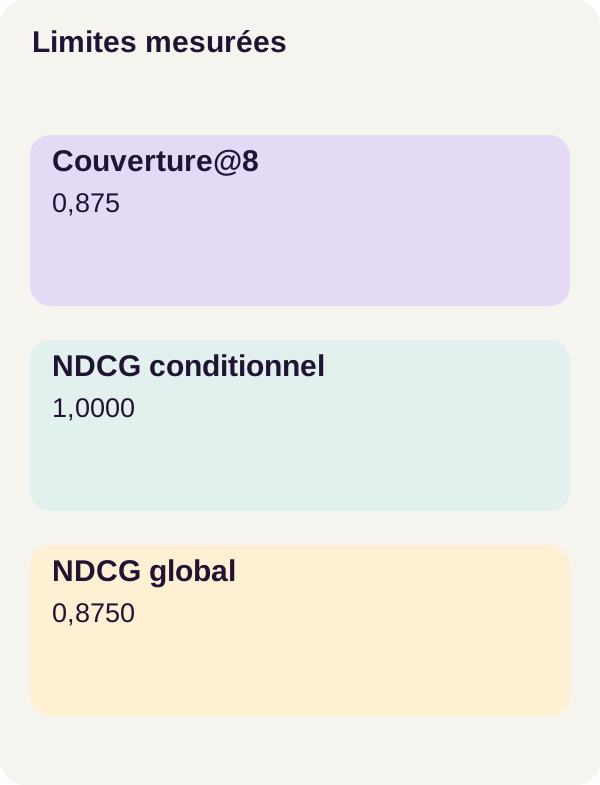
NDCG de extremo a extremo = cobertura × NDCG condicional.
Como el NDCG condicional no supera 1, la cobertura fija un techo para la puntuación de extremo a extremo. Este techo es un límite; no es automáticamente alcanzable por cualquier modelo ni con cualquier elección de clasificación ideal.
Una consulta sin respuesta merece un estado explícito
Todavía hay que distinguir dos motivos posibles para no tener un positivo en una lista: la ficha correcta existe en el catálogo pero no se recuperó, o ninguna ficha del catálogo responde a la solicitud.
En el primer caso, mejorar la recuperación puede ayudar. En el segundo, también hay que saber señalar una ausencia de respuesta. El protocolo elegido conserva estos casos en la puntuación de extremo a extremo; no es una convención universal que permita por sí sola diagnosticar su causa.
Resultados reales
Las mediciones r1
La prueba se realiza sobre 72 consultas, de las cuales 63 listas están cubiertas. El balance describe los otros 9 casos como sin «ningún positivo global». La cobertura@8 vale 63 / 72 = 0,875.
Esta formulación importa: no transformemos estos nueve casos en nueve piezas correctas necesariamente presentes en el catálogo pero omitidas por la búsqueda. El número de listas no cubiertas no basta para demostrar ese diagnóstico.
Estas son las medidas publicadas, conservadas con su precisión original:
| Clasificación | NDCG@5 condicional | NDCG@5 de extremo a extremo |
|---|---|---|
| Léxica | 0,9903969127585871 | 0,8665972986637638 |
| Pointwise | 0,8838329034231467 | 0,7733537904952533 |
| Listwise | 1,0 | 0,875 |
La cobertura@8 sigue siendo 0,875: los rerankers trabajan con los mismos candidatos. El modelo listwise alcanza aquí un orden condicional perfecto según la métrica utilizada. Sin embargo, el promedio de extremo a extremo sigue limitado: (63 × 1 + 9 × 0) / 72 = 0,875.
Los valores de los demás métodos siguen la misma relación, salvo redondeos numéricos. Para pointwise, 0,8838329034231467 × 0,875 ≈ 0,7733537904952533. No hay contradicción entre dos puntuaciones distintas: no dividen por la misma población.
El resultado útil no es «la IA supera a la búsqueda»
La búsqueda léxica ya es muy fuerte en este corpus: su NDCG condicional vale aproximadamente 0,9904. El modelo listwise mejora este resultado, pero el margen disponible era pequeño. Restando las medidas publicadas, la ganancia es de aproximadamente 0,009603 en el NDCG condicional y 0,008403 en la puntuación de extremo a extremo. Son diferencias de puntuación calculadas, no nuevas mediciones ni porcentajes de piezas compatibles.
En cambio, la variante pointwise se clasifica peor que la referencia léxica en este experimento. Añadir un modelo y entrenarlo no es una mejora por definición. Hay que conservar una referencia sencilla para comprobar qué aporta realmente la nueva etapa.
La tabla tampoco permite afirmar que listwise sea siempre superior a pointwise. Describe este corpus sintético, este modelo y esta receta. No aporta una medida de latencia bajo carga ni una prueba de generalización a otros catálogos.
Lo que no garantiza una puntuación perfecta
Un NDCG condicional de 1 significa que las primeras posiciones satisfacen el ideal retenido por la evaluación para las listas cubiertas. No es una certificación de compatibilidad física, ausencia de casos sin respuesta ni prueba de que las anotaciones sean perfectas.
Por tanto, la lección principal es doble: aprender el orden puede ayudar, pero el orden sigue limitado por los candidatos y por la definición de pertinencia. La recuperación, el aprendizaje y la evaluación tienen cada uno su papel; una buena cifra en una etapa no sustituye a las demás.
Ejercicio: predecir y después ejecutar
Retirar al mejor candidato
Imagine que retiramos A, el mejor documento de nuestro ejemplo, conservando los identificadores de los demás candidatos. Sin ejecutar el programa, formule su predicción: ¿un entrenamiento adicional o una puntuación muy alta pueden hacer reaparecer A en la clasificación de esta lista?
El escenario proporcionado realiza esta comparación sin pedirle que modifique el motor de referencia.
docker compose run --rm gpu python -m listwise_ranker.cli exercise --config configs/exercise.yaml
La salida confirma que el reranker recibe y devuelve los mismos candidatos: puede reordenarlos, pero nunca recupera un identificador ausente. Para comprobar esta propiedad, compare los identificadores de la lista después de la retirada con los de la clasificación final. No los compare con la lista inicial olvidando la eliminación voluntaria.
Atención a una segunda predicción: retirar el mejor documento no convierte necesariamente la lista en totalmente no pertinente. Si B, de grado 1, sigue presente, la lista continúa cubierta. Si retiramos su único positivo, ya no lo está. En ambos casos, el mejor documento ausente sigue siendo imposible de recuperar mediante una simple reclasificación.
Esta distinción explica por qué el ejercicio comprueba primero una propiedad de los identificadores. Un orden mejor de los candidatos restantes no demostraría que se ha reparado la recuperación.
Conservar los artefactos antes de terminar
Un artefacto es un archivo producido por el recorrido: figura, medida o guardado de entrenamiento. Termine generando las figuras, comprobando los checkpoints, previsualizando la limpieza y deteniendo los servicios, en este orden.
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
Los checkpoints se comprueban después del ejercicio. --dry-run solicita una previsualización: clean.py indica qué trataría, sin borrar archivos. El comando docker compose down --remove-orphans termina los servicios del proyecto; los archivos del recorrido conservados en el host siguen disponibles.
Adaptación, límites, resolución de problemas y limpieza
Pasar de un catálogo ficticio a sus fichas
El primer paso no es cambiar BERT. Es escribir una definición de pertinencia revisada por las personas que conocen el catálogo. ¿Qué significa exactamente «parcialmente compatible»? ¿Es un resultado que debe mostrarse con reservas, una alternativa útil o una pieza que debe excluirse de toda propuesta de compra? La graduación elegida para un tutorial no sustituye esa decisión de negocio.
Versione las fichas, las consultas, las anotaciones y las particiones. Los textos pueden evolucionar mientras los identificadores permanecen estables; sin una versión del catálogo, corre el riesgo de comparar una puntuación antigua con una ficha nueva. Conserve también la lista de candidatos para distinguir una modificación de clasificación de una modificación de recuperación.
Mida por separado la cobertura, los rangos, la truncación y el coste del reranking. Si aumenta el número de candidatos, modifica tanto lo que se vuelve accesible al modelo como el número de parejas que debe procesar. El nuevo resultado debe evaluarse como un experimento nuevo, no añadirse a las cifras r1 como si describiera el mismo protocolo.
Comprobar los idiomas y la información realmente leída
La ficha del modelo BERT base uncased indica un preentrenamiento en inglés y un procesamiento que no distingue mayúsculas de minúsculas. Por tanto, el nombre «BERT» no garantiza una adaptación automática a solicitudes francesas, referencias técnicas o todas las convenciones de su catálogo. El ejemplo francés usado en las explicaciones no es un resultado multilingüe medido.
El max_length del codificador cruzado también puede retirar la parte decisiva de una ficha. Un texto visible en un archivo fuente no es necesariamente visible entero para la red después de la tokenización. Inspeccione las parejas antes de atribuir un error solo al aprendizaje.
No confundir clasificación y decisión
El mecanismo devuelve un orden, no una autorización de compra o instalación. Controle los casos de alto riesgo antes de cualquier automatización. Un sistema real debe gestionar en particular las solicitudes sin respuesta, las anotaciones inciertas y las reglas que prohíben determinadas sustituciones.
El objetivo listwise pide una distribución relativa entre candidatos; aquí no aprende un umbral universal de compatibilidad. Diseñar un rechazo o una validación humana requiere datos y controles específicos, distintos de la sola mejora del NDCG.
Resolver problemas sin cambiar el experimento en silencio
La GPU no es visible. Vuelva a ejecutar la comprobación del entorno antes del entrenamiento y después compruebe la integración de Docker con la guía de NVIDIA Container Toolkit. No sustituya discretamente la ejecución en GPU por un recorrido de CPU no validado.
La adquisición falla. Compruebe el acceso de red del servicio acquire, corrija la causa del fallo y vuelva a ejecutar el mismo comando. Cambiar la revisión del modelo para sortear un activo ausente haría perder la referencia del experimento.
La pérdida parece anormalmente baja. Revise included y excluded antes de concluir. Un lote totalmente excluido da cero sin haber proporcionado supervisión. Una máscara que retira candidatos molestos también puede hacer el objetivo artificialmente más fácil.
El NDCG condicional es excelente, pero la puntuación global se estanca. Observe la cobertura y las solicitudes sin positivo. No pida al reranker que devuelva fichas que no recibió ni que cree una pieza ausente del catálogo.
Desea limpiar los ensayos. Los comandos de final del recorrido ya aparecen en el ejercicio. clean.py --dry-run no elimina ningún resultado; docker compose down --remove-orphans no sustituye una limpieza de sus archivos locales. Examine y conserve las medidas útiles antes de cualquier eliminación distinta.
Así tenemos un recorrido que vincula una necesidad de interfaz —presentar mejor los resultados— con una fórmula de aprendizaje verificable. Su conclusión sigue siendo concreta: un buen reranker coloca a los buenos candidatos en el lugar correcto; nunca evita comprobar qué candidatos estaban disponibles.
Fuentes oficiales
Las siguientes referencias sirven para profundizar en los conceptos. Para reproducir las mediciones r1, conserve las versiones y la configuración del archivo: las documentaciones externas no las sustituyen.
- Sentence Transformers: entrenamiento de un CrossEncoder, para el principio de puntuación de parejas y el entrenamiento de un reranker.
- Sentence Transformers: pérdidas CrossEncoder, para comparar familias de pérdidas sin confundir sus implementaciones.
- BERT base uncased, para el modelo, su idioma de preentrenamiento y la representación de parejas.
- PyTorch:
log_softmax, para el cálculo estable de los logaritmos de probabilidades. Esta página versionada documenta la operación; no declara la versión instalada por el proyecto. - TensorFlow Ranking: definición de NDCG, para la normalización de la ganancia y las convenciones del cálculo pedagógico, sin usar TensorFlow en el recorrido.
- Docker Compose: compatibilidad con GPU y NVIDIA Container Toolkit: instalación, para acceder a la tarjeta desde un contenedor.