





Vous ajoutez un moteur de recherche à une application documentaire. Un utilisateur veut retrouver la page où une vanne apparaît au-dessus d’une pompe. Votre recherche plein texte trouve bien le mot « pump » dans plusieurs manuels. Mais elle ne sait pas, à partir de ce mot seul, quel schéma correspond à la disposition recherchée.
Le manuel fictif Lumen Equipment nous servira de terrain de jeu. Il contient une courbe, un schéma de circuit et une nomenclature, c’est-à-dire une liste de pièces. Notre question est : « Which page shows the bypass valve above the pump? », autrement dit : « Quelle page montre la vanne de dérivation au-dessus de la pompe ? » La traduction aide à comprendre l’exemple ; les requêtes du parcours restent en anglais.
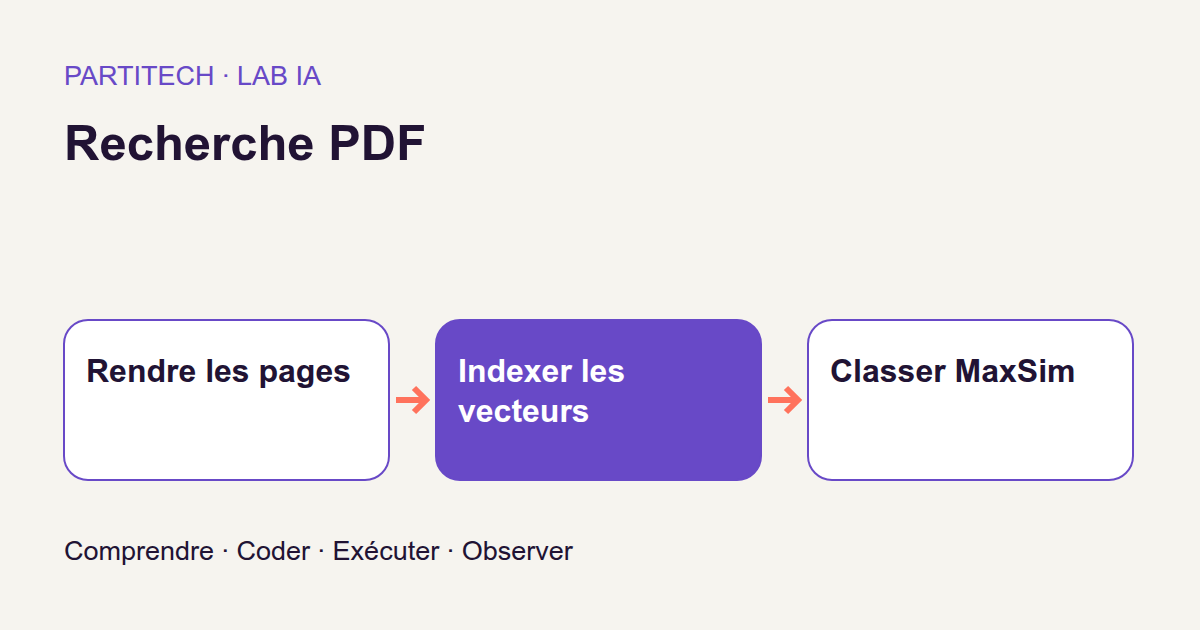
Nous allons construire un moteur qui indexe les images des pages, et pas seulement leurs mots. ColQwen2 transforme ces images et les questions en représentations numériques ; notre code calcule ensuite leur ressemblance avec une méthode appelée MaxSim. Nous comparerons cette méthode à BM25, une recherche textuelle, et à une représentation obtenue par moyenne des vecteurs.
L’objectif est précis : retourner des pages à examiner, pas fabriquer une réponse sur le fonctionnement de la machine. Le modèle est déjà entraîné et reste inchangé pendant le tutoriel. C’est l’indexation, le classement et leur évaluation que nous allons apprendre à maîtriser.
Le problème concret
Notre collection, aussi appelée corpus, comprend 24 manuels de quatre pages, soit 96 pages. Le programme reçoit leurs images et des questions. Il doit ordonner les pages de la plus proche de la requête à la moins proche, puis permettre de revenir au document d’origine.
Une annotation de pertinence, ou label, indique quelles pages sont attendues pour une question. Elle sert à mesurer le classement, pas à le produire : le service inference accède aux images et aux requêtes, tandis que les labels restent hors de son montage Docker.
Un embedding, c’est quoi au juste ?
Un vecteur est ici une liste de nombres. Un embedding est une représentation calculée par un modèle, conçue pour permettre des comparaisons utiles entre des entrées. Au lieu de comparer directement les caractères d’une question aux pixels d’un schéma, nous comparons leurs représentations numériques.
Le programme qui fabrique ces représentations s’appelle un encodeur. Dans notre cas, il peut recevoir du texte pour une requête et une image pour une page. La fiche officielle de ColQwen2 présente cette recherche documentaire associant texte et image, avec des représentations à plusieurs vecteurs.
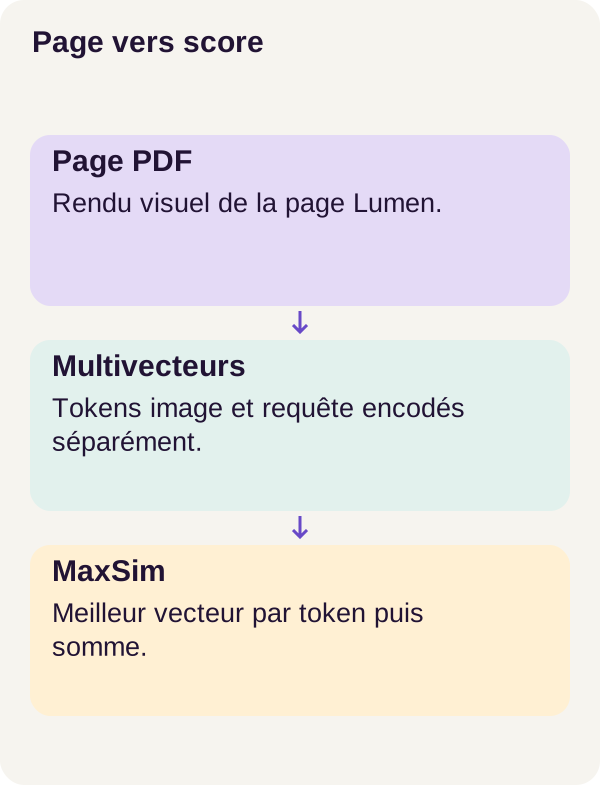
Pourquoi plusieurs ? Une page peut contenir un titre, une légende, une courbe et un petit schéma. Nous ne voulons pas nécessairement résumer tout cela dans un unique vecteur. ColQwen2 conserve une séquence de vecteurs, que nous appelons des multivecteurs. La requête possède elle aussi sa séquence.
Pour vous représenter l’idée, imaginez plusieurs indices numériques plutôt qu’une seule fiche récapitulative. Mais ne prenez pas l’image trop littéralement : il n’existe pas une colonne nommée « pompe », une autre « vanne » et une troisième « au-dessus ». Les représentations sont apprises et contextualisées. Les noms que nous leur donnerons dans les exemples servent à expliquer le calcul, pas à traduire automatiquement leurs dimensions.
Pourquoi parle-t-on d’interaction tardive ?
L’interaction tardive signifie que la page et la requête sont d’abord encodées séparément. Elles ne sont comparées qu’au moment de la recherche. C’est le principe exposé par le projet ColBERT, dont cette stratégie de recherche multivectorielle s’inspire.
Pour un développeur web, la séparation est familière. Lors de l’import des documents, vous préparez une donnée réutilisable : l’index. Lorsqu’une nouvelle recherche arrive, vous encodez la question, puis vous consultez cet index. Il reste des comparaisons à calculer, mais il n’est pas nécessaire de refaire passer toutes les images dans le modèle à chaque requête.
Indexer n’est pas entraîner. Ici, les paramètres du modèle, aussi appelés ses poids, sont gelés : nous ne les ajustons pas sur les manuels Lumen. Nous utilisons un modèle préentraîné pour calculer de nouvelles représentations. Le contenu de l’index change lorsque nous ajoutons une page ; les poids du modèle, eux, ne changent pas dans ce parcours.
Le fil rouge : expliquer un résultat, pas seulement le voir
Reprenons notre exemple conceptuel : une page montre une pompe, une flèche et une vanne. La question contient plusieurs indices, notamment bypass valve, above et pump. Le moteur doit chercher une page compatible avec ces indices, puis nous laisser l’ouvrir pour vérifier la disposition.
Le chemin suivi est : PDF → image de page → multivecteurs → comparaison avec la requête → classement → inspection de la page. Rendre le PDF en image signifie produire les pixels de la page, comme ceux qu’affiche un lecteur PDF. L’index conserve la page, l’identifiant du manuel, les vecteurs et un masque qui indique lesquels utiliser.
La sortie comporte un rang et des contributions au score. Le rang répond à « où le moteur place-t-il cette page ? ». Les contributions permettent d’examiner les rapprochements numériques qui ont participé au score.
Aucune de ces sorties n’autorise à affirmer « la vanne est ouverte ». Cette information n’est ni demandée ni établie par le classement. Une éventuelle réponse rédigée dans votre application serait une étape supplémentaire, à relier à ses sources et à évaluer séparément. Le moteur de recherche nous indique où regarder ; il ne remplace pas la lecture de ce qu’il a trouvé.
Pourquoi une moyenne perd le détail utile
Une moyenne de vecteurs rassemble plusieurs représentations en une seule en moyennant leurs composantes. Cette simplification conserve une information globale, mais elle ne garde pas toutes les différences entre les représentations d’origine.
Imaginez, pour l’intuition, qu’un vecteur de requête cherche un indice lié à la pompe et qu’un autre cherche un indice lié à sa disposition. Chacun pourrait trouver une forte ressemblance avec une partie différente de la page. En mélangeant les représentations du schéma, du texte et du fond, une moyenne peut atténuer un détail rare.
MaxSim prend une autre décision : pour chaque vecteur de requête, conserver sa meilleure ressemblance avec la page. Ces meilleurs résultats sont ensuite additionnés. Les différents indices n’ont pas besoin de trouver leur meilleur voisin au même endroit.
Ce choix ne garantit pas la pertinence. Un maximum peut aussi retenir une ressemblance accidentelle, et plusieurs vecteurs de requête peuvent sélectionner le même vecteur de page. Rien dans cette opération n’impose, à elle seule, une vérification géométrique de la relation « au-dessus ». Le modèle fournit les représentations ; MaxSim les compare. Nous devons encore mesurer si cette combinaison retrouve les bonnes pages.
Comprendre MaxSim avant le code
Des tableaux de nombres à un score
Dans le code, query contient les vecteurs de la requête et document ceux d’une page. Un tenseur est simplement, pour les opérations qui nous intéressent, un tableau numérique. Chaque ligne de ces deux tableaux est un vecteur.
Lq désigne le nombre de positions de la requête, Ld celui de la page et D le nombre de composantes d’un vecteur. Les entrées ont donc les formes [Lq, D] et [Ld, D]. Elles doivent partager la même dimension D pour que leurs vecteurs puissent être comparés.
Vous rencontrerez aussi le mot token. Côté texte, c’est une unité manipulée par le modèle, qui ne correspond pas nécessairement à un mot entier. Côté image, le traitement exploite des représentations visuelles. Dans les fonctions ci-dessous, le calcul manipule surtout des positions dans les séquences et leurs vecteurs : il n’a pas besoin de leur attribuer un nom en français.
La ressemblance est calculée par un produit scalaire : on multiplie les composantes correspondantes des deux vecteurs, puis on additionne. Exemple purement numérique : les vecteurs [1, 0] et [0.6, 0.8], écrits avec la notation décimale de Python, donnent 1 × 0,6 + 0 × 0,8 = 0,6. Nous multiplions les deux premières composantes entre elles, puis les deux secondes, et additionnons les résultats.
Le contrat du code indique que l’encodeur fournit des vecteurs normalisés. Lorsque leur norme vaut 1, ce produit scalaire correspond à la similarité cosinus, qui compare leur direction. Cette normalisation appartient à la préparation des entrées : la fonction check() ne la calcule pas et ne la vérifie pas elle-même.
Un MaxSim calculable à la main
Prenons un exemple pédagogique inventé, avec deux vecteurs de requête et trois vecteurs de page. Voici les produits scalaires obtenus ; ce ne sont pas des mesures du corpus Lumen.
| Vecteur de requête | Page : vecteur 0 | Page : vecteur 1 | Page : vecteur 2 |
|---|---|---|---|
| Requête : vecteur 0 | 0,8 | 0,1 | 0,2 |
| Requête : vecteur 1 | 0,1 | 0,9 | 0,2 |
Pour la première ligne, le maximum vaut 0,8, trouvé dans le vecteur 0 de la page. Pour la seconde, il vaut 0,9, trouvé dans le vecteur 1. Le score MaxSim est donc 0,8 + 0,9 = 1,7.
Nous n’avons pris ni le maximum unique du tableau, qui vaudrait 0,9, ni la somme de toutes les cases. La règle se lit : chercher un maximum par ligne de requête, puis additionner ces maxima. Seules les positions déclarées valides participent au résultat.
Ce score de 1,7 n’est pas une probabilité. Il peut dépasser 1, puisqu’il additionne plusieurs contributions. Le nombre de vecteurs de requête influence aussi cette somme : ne transformez pas un seuil choisi sur une question en garantie universelle de pertinence pour toutes les autres.
Le padding : des positions ajoutées, pas du contenu
Pour traiter ensemble plusieurs séquences de longueurs différentes, on peut compléter les plus courtes avec des positions artificielles : c’est le padding, ou remplissage. Le masque est une liste de booléens de même longueur que la séquence. True signifie « utiliser cette position » et False « l’exclure ».
Pourquoi ne pas laisser simplement des zéros ? Prenons un autre exemple numérique : les deux vrais vecteurs d’une page donnent des similarités de −0,6 et −0,8 avec un vecteur de requête. Un vecteur nul ajouté pour le remplissage donne 0. Sans masque, zéro gagne le maximum, alors qu’il ne correspond à aucune information réelle.
Le programme remplace donc les similarités des positions documentaires invalides par moins l’infini, écrit -torch.inf. Le maximum revient à −0,6, le meilleur des deux résultats autorisés. Le masque de requête intervient ensuite pour exclure de la somme ses propres positions artificielles.
L’implémentation du projet
Le bloc suivant contient le contrôle des entrées, trois façons de calculer le même score et une fonction d’inspection. Nous conservons le code du parcours r001.
"""Exact masked MaxSim; inputs are normalized by the pretrained encoder."""

import torch


def check(query, document, query_mask, document_mask):
    if query.ndim != 2 or document.ndim != 2 or query.shape[1] != document.shape[1]:
        raise ValueError("Expected [Lq,D] and [Ld,D] with the same D")
    if query_mask.shape != query.shape[:1] or document_mask.shape != document.shape[:1]:
        raise ValueError("Mask length does not match embeddings")
    if query_mask.dtype != torch.bool or document_mask.dtype != torch.bool:
        raise ValueError("Masks must be boolean")
    if not query_mask.any() or not document_mask.any():
        raise ValueError("Empty valid query or document sequence")
    if not torch.isfinite(query).all() or not torch.isfinite(document).all():
        raise ValueError("Non-finite embeddings")


def maxsim_dense(query, document, query_mask, document_mask):
    check(query, document, query_mask, document_mask)
    similarities = query.float() @ document.float().T
    similarities = similarities.masked_fill(~document_mask[None, :], -torch.inf)
    best = similarities.max(dim=1).values
    return best[query_mask].sum()


def maxsim_scalar(query, document, query_mask, document_mask):
    check(query, document, query_mask, document_mask)
    return sum(
        max(
            float(torch.dot(query[i].float(), document[j].float()))
            for j in range(len(document))
            if document_mask[j]
        )
        for i in range(len(query))
        if query_mask[i]
    )


def maxsim_blocked(query, document, query_mask, document_mask, block_size=128):
    check(query, document, query_mask, document_mask)
    if not isinstance(block_size, int) or block_size <= 0:
        raise ValueError("Positive integer vector block size required")
    best = torch.full((len(query),), -torch.inf, device=query.device)
    for start in range(0, len(document), block_size):
        scores = query.float() @ document[start : start + block_size].float().T
        scores = scores.masked_fill(
            ~document_mask[None, start : start + block_size], -torch.inf
        )
        best = torch.maximum(best, scores.max(dim=1).values)
    return best[query_mask].sum()


def contributions(query, document, query_mask, document_mask):
    check(query, document, query_mask, document_mask)
    matrix = query.float() @ document.float().T
    values, positions = matrix.masked_fill(~document_mask[None, :], -torch.inf).max(
        dim=1
    )
    return [
        {
            "query_vector": i,
            "document_vector": int(positions[i]),
            "similarity": float(values[i]),
        }
        for i in range(len(query))
        if query_mask[i]
    ]
Lire les fonctions pas à pas
check() vérifie le contrat d’entrée. Les tableaux doivent avoir deux dimensions et des vecteurs de même taille. Chaque masque doit correspondre à la longueur de sa séquence et être de type booléen. Il faut au moins une position valide de chaque côté. Enfin, les tableaux ne doivent contenir ni NaN, qui indique une valeur numérique indéfinie, ni infinité. Ce dernier contrôle porte sur toutes leurs valeurs, y compris celles des positions masquées.
Ces refus évitent de retourner un score qui semble exploitable malgré des entrées incohérentes. Ils ne vérifient pas pour autant que la représentation a capturé la bonne information visuelle.
maxsim_dense() construit toutes les ressemblances d’un coup. .float() convertit les tableaux en nombres flottants sur 32 bits. .T transpose le tableau de la page : ses lignes deviennent des colonnes. L’opérateur @ réalise alors une multiplication matricielle, décrite dans la documentation PyTorch. Le résultat possède Lq lignes et Ld colonnes, comme notre petit tableau d’exemple.
document_mask[None, :] donne au masque une ligne, applicable à toutes les lignes du tableau. Le signe ~ inverse ses booléens : les positions invalides deviennent celles à remplacer par moins l’infini. max(dim=1) cherche ensuite le maximum sur les colonnes de chaque ligne. Enfin, best[query_mask].sum() conserve les lignes de requête autorisées et additionne leurs meilleurs scores.
maxsim_scalar() déroule la même règle avec des boucles. Pour chaque position valide de requête, elle calcule les produits scalaires avec les positions documentaires valides, prend le maximum, puis additionne. C’est une référence facile à relire pour comprendre le calcul, pas une stratégie destinée à exploiter efficacement le parallélisme du GPU. Cette version retourne un nombre Python, là où les versions vectorisées retournent un tenseur scalaire.
maxsim_blocked() évite de construire tout le tableau à la fois. Elle visite les vecteurs de la page par tranches, de 128 positions par défaut. Le tableau best conserve un meilleur score pour chaque position de requête. À chaque tranche, torch.maximum compare ce meilleur score aux nouveaux maxima et garde le plus grand, position par position. La somme n’arrive qu’après avoir parcouru toutes les tranches.
C’est le point à retenir : on conserve le maximum global de chaque vecteur de requête, pas un score indépendant à additionner pour chaque bloc. Sinon, le résultat changerait simplement parce que l’on a découpé la page différemment.
Ce que les blocs économisent réellement
La version dense matérialise Lq × Ld similarités. Avec des blocs de taille B, le tableau temporaire n’en contient qu’environ Lq × B à la fois, plus les maxima conservés. Le nombre de comparaisons reste du même ordre : nous calculons autrement le même score, nous ne sautons pas une partie de la page.
Prenons un dimensionnement illustratif, sans rapport avec une mesure mémoire du parcours : 32 vecteurs de requête et 1 024 vecteurs de page donnent 32 768 similarités. Sur 32 bits, leur tableau occupe 128 Kio. Avec des blocs de 128, le tableau de similarités d’un bloc contient 4 096 valeurs, soit 16 Kio.
Cette réduction concerne le tableau temporaire de scores. Elle ne compresse pas l’index enregistré, n’efface pas les vecteurs d’entrée et ne réduit pas les poids du modèle. Les conversions numériques et les autres calculs consomment également de la mémoire. Un index trop volumineux sur disque et un calcul temporaire trop volumineux sur GPU sont deux problèmes différents.
Les versions dense et par blocs calculent le même MaxSim mathématique ; les tests du projet vérifient cette parité. En complément, la documentation PyTorch sur la précision numérique rappelle qu’une équivalence mathématique ne garantit pas une identité bit à bit après tout changement de matériel ou de calcul flottant. Gardez les contrôles du projet lorsque vous adaptez l’implémentation.
Lire une contribution concrète
contributions() reprend la matrice de similarités, mais conserve la position gagnante, en plus de sa valeur. Dans notre exemple pédagogique, le vecteur 0 de requête choisit le vecteur 0 de page avec 0,8 ; le vecteur 1 choisit le vecteur 1 avec 0,9.
Dans les objets retournés, query_vector est l’indice dans la requête, document_vector l’indice dans la séquence de la page et similarity la valeur retenue. En les additionnant, on retrouve le score de l’exemple. Ces objets permettent donc de relier le total à ses contributions.
Un indice n’est cependant ni un mot traduit, ni une boîte de détection. Pour le reporter sur l’image, il faut conserver la correspondance avec la préparation de cette image. Même lorsqu’une visualisation montre une zone proche de la pompe, elle ne constitue pas une preuve que le modèle a correctement interprété toute la relation spatiale.
Si un résultat inattendu semble dépendre du fond de page, inspectez le rendu, les masques et la question. Ne modifiez pas d’abord les données ou un seuil pour rendre le classement plus convaincant. Le rôle des contributions est de rendre le calcul inspectable, pas d’habiller chaque résultat d’une explication forcément juste.
Prérequis et environnement
Vous devez pouvoir lire du Python, manipuler des listes et des tableaux, et utiliser Docker depuis un terminal. Il n’est pas nécessaire de savoir entraîner un réseau pour suivre ce parcours : nous utilisons un encodeur préentraîné, sans modifier ses poids.
La référence utilise Linux, Docker Engine, Compose, un pilote NVIDIA et NVIDIA Container Toolkit, avec une RTX 3090 de 24 Gio. Aucun profil CPU n’est validé. Les 32 Gio de RAM et 40 Gio de disque indiqués sont des estimations de préparation, pas des minima mesurés pour toutes les machines. La RAM est la mémoire de l’ordinateur ; les 24 Gio de la carte correspondent à sa mémoire vidéo, ou VRAM.
NVIDIA Container Toolkit relie Docker aux périphériques et aux bibliothèques du pilote NVIDIA de l’hôte. Un GPU visible sous Linux n’est donc pas nécessairement utilisable par le programme conteneurisé. Consultez sa documentation d’installation pour l’intégration adaptée à votre système. Le contrôle du projet exécute ensuite le modèle dans Docker ; nvidia-smi sur l’hôte ne remplace pas cette vérification.
Décompressez le ZIP et placez-vous dans son dossier racine. Toutes les commandes suivantes partent de ce répertoire. L’acquisition est le seul service du parcours disposant du réseau ; elle vérifie la révision, la taille et l’empreinte SHA-256 des poids. Une empreinte permet de contrôler l’identité du contenu téléchargé. Conservez les dépendances et les fichiers verrouillés du ZIP plutôt que de substituer une installation trouvée dans un exemple plus récent.
Étape 1 — vérifier le runtime
Le runtime est ici l’environnement dans lequel le programme s’exécute. Préparons les dossiers, validons Compose, construisons les services, puis acquérons le modèle et lançons les contrôles.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Chaque commande doit terminer avec un code de retour nul, qui indique une exécution réussie. Les tests couvrent les masques, MaxSim, la compatibilité de l’index et les coordonnées PDF. Ils contrôlent le fonctionnement du programme ; ils ne signifient pas que tous ses classements seront pertinents.
Étape 2 — préparer et indexer
Nous pouvons maintenant produire les pages Lumen et leurs représentations, inspecter un score, puis calculer la référence textuelle.
docker compose run --rm tutorial python -m pdfmaxsim.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m pdfmaxsim.cli index --config configs/minimum.yaml
docker compose run --rm inference python -m pdfmaxsim.cli explain-score --config configs/minimum.yaml
docker compose run --rm inference python -m pdfmaxsim.cli baseline --config configs/minimum.yaml
prepare rend les pages. Vous devez retrouver les 96 images du catalogue. Vérifiez visuellement le texte et les schémas : une image coupée ou illisible est déjà une mauvaise entrée, avant tout calcul d’embedding.
index enregistre les multivecteurs et leurs masques. Les images sont ainsi transformées en données réutilisables lors des recherches. Le lien avec la page et le manuel doit rester disponible : retrouver un vecteur sans pouvoir ouvrir sa source ne suffirait pas.
explain-score expose les contributions. Retrouvez la requête fil rouge et rapprochez le score de ses meilleurs voisins. Ne remplacez pas cette inspection par l’intuition « la première page a l’air bonne ».
baseline calcule le repère BM25. Une baseline est une méthode de comparaison. BM25 classe du texte en tenant compte notamment des termes présents, de leur fréquence, de leur rareté dans la collection et de la longueur des documents. Le chapitre consacré à BM25 dans le manuel de Stanford détaille ces mécanismes.
Ici, BM25 utilise le texte disponible : il ne reçoit pas les pixels du schéma pour interpréter sa disposition. Il peut néanmoins retrouver une bonne page grâce à ses libellés. C’est justement l’intérêt de la comparaison : vérifier ce que la recherche visuelle apporte au-delà de ces indices textuels, sans supposer qu’elle gagnera partout.
Étape 3 — mesurer et expérimenter
L’évaluation peut alors comparer les classements aux pages attendues, dans un service distinct de celui qui produit les représentations et les recherches.
docker compose run --rm tutorial python -m pdfmaxsim.cli evaluate --config configs/minimum.yaml
Nous allons lire ses mesures dans la section suivante. Ne changez pas les réglages après avoir regardé les résultats du test pour ne retenir que la meilleure variante.
Ce que chaque sortie permet de vérifier
Après index, inspectez les dimensions, les masques et l’empreinte de l’encodeur dans les fichiers de sortie. Après explain-score, revenez à la page du fil rouge et à ses contributions. Les contrôles de parité doivent retrouver le même calcul avec les versions dense et par blocs.
Le catalogue de 96 pages est commun ; ce sont les requêtes qui sont séparées. Le parcours comporte 48 requêtes de développement et 144 requêtes de test. Il n’entraîne pas le modèle sur un premier groupe de pages pour le tester ensuite sur un autre.
Le jeu de développement sert à prendre une décision de conception. Le jeu de test sert à mesurer la décision une fois fixée. Même sans entraînement, choisir un réglage parce qu’il réussit mieux sur le test ferait perdre à ce dernier son rôle de mesure finale indépendante du choix.
Les deux budgets de résolution sont fixés à l’avance : 200704 et 401408. Ils influencent la taille des représentations et le coût de recherche. Utilisez les configurations fournies pour les reproduire. Le second budget est le double du premier ; cela ne permet pas de déduire que la taille réelle de l’index ou le temps d’exécution seront exactement doublés. Ces effets se mesurent dans les sorties du parcours.
La comparaison avec la moyenne de vecteurs sert, elle, à examiner ce que change la conservation des représentations multiples. Ses sorties restent à consulter avec celles des budgets : ne déduisez pas un résultat chiffré de la seule intuition selon laquelle une moyenne perd du détail.
Lire les métriques avant les chiffres
Une métrique est une mesure choisie pour évaluer un comportement. Pour notre moteur, la question n’est pas « le score MaxSim est-il grand ? », mais « les pages attendues sont-elles bien placées ? ». Nous allons distinguer la quantité de pages pertinentes retrouvées et la position de la première.
Recall@k : quelle part des bonnes pages retrouve-t-on ?
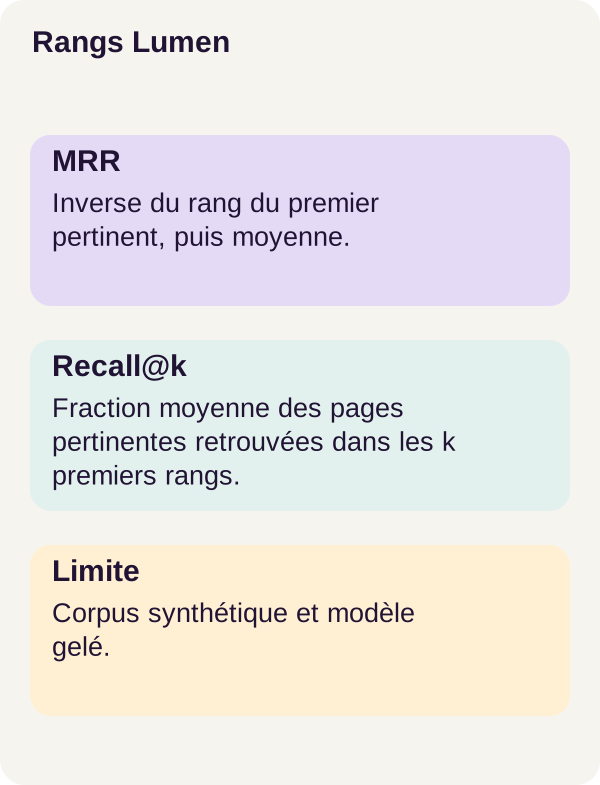
Le Recall@k, ou rappel aux k premières places, mesure pour chaque requête la fraction de ses pages pertinentes présentes dans ces places. On moyenne ensuite ces fractions sur les requêtes évaluées.
Prenons un classement fictif. Trois pages sont pertinentes, nommées A, B et C. Le moteur renvoie A, X, B, C, Y, où X et Y ne sont pas pertinentes.
Au rang 1, on a retrouvé A, soit une page pertinente sur trois : Recall@1 = 1/3. Dans les trois premiers résultats, A et B sont présentes : Recall@3 = 2/3. Dans les cinq premiers, A, B et C sont toutes présentes : Recall@5 = 1.
La première page était pourtant correcte dès le départ ! C’est pourquoi Recall@1 n’est pas ici le pourcentage de requêtes dont le premier résultat est pertinent. Une question peut avoir plusieurs bonnes pages ; n’en afficher qu’une ne permet pas de les retrouver toutes.
MRR : où apparaît la première page pertinente ?
Le MRR, pour Mean Reciprocal Rank, moyenne l’inverse du rang de la première page pertinente. Au rang 1, la contribution vaut 1/1 = 1 ; au rang 2, 1/2 = 0,5 ; au rang 4, 1/4 = 0,25.
Dans notre classement fictif A, X, B, C, Y, cette contribution vaut 1. Avec X, A, B, C, Y, elle vaut 0,5. Si ces classements correspondaient à deux requêtes, leur MRR serait (1 + 0,5) / 2 = 0,75.
Le MRR ne dit pas combien d’autres bonnes pages suivent la première. Le rappel et le MRR regardent donc deux propriétés différentes : retrouver les pages attendues et faire apparaître rapidement une première page pertinente. Aucun des deux ne vérifie le contenu d’une éventuelle réponse rédigée.
Les résultats observés sur Lumen
Les mesures suivantes concernent les 144 requêtes de test, sur le catalogue synthétique anglais de 96 pages. Elles reprennent les valeurs du parcours r001.
| Mesure | MaxSim haute résolution | BM25 |
|---|---|---|
| MRR | 0,9549 | 0,9410 |
| Recall@1 | 0,5903 | 0,5972 |
| Recall@5 | 1,0000 | Non indiqué ici |
| Recall@10 | 1,0000 | Non indiqué ici |
« Non indiqué ici » signifie que cette valeur n’est pas fournie dans les résultats chiffrés repris dans l’article ; cela ne signifie ni zéro ni un échec de la méthode.
Le MRR de MaxSim est meilleur, mais son Recall@1 ne l’est pas. Le classement est donc plus favorable selon la moyenne des inverses de rang, sans améliorer la fraction moyenne des pages pertinentes retrouvées à la première place. Nous ne pouvons pas en déduire une supériorité sur chaque requête.
BM25 reste un concurrent sérieux sur ce corpus : certains libellés textuels peuvent déjà suffire à retrouver une page. Les rappels à 5 et à 10 de MaxSim sont rapportés à 1,0000, mais ils ne démontrent ni une compréhension parfaite des schémas, ni la même qualité sur des PDF réels, d’autres langues ou une collection beaucoup plus grande.
Quand aucune page n’est pertinente
Le parcours comprend aussi 12 requêtes hors corpus. Pour celles-ci, aucune page de la collection ne constitue une réponse pertinente. Elles sont exclues des métriques de pertinence présentées ci-dessus et doivent être examinées à part.
Le moteur produit tout de même un classement : il trouve la page la plus proche parmi celles qu’il possède. Cela ne signifie pas qu’il a trouvé une bonne page. La meilleure candidate d’une mauvaise liste reste une mauvaise candidate.
Il n’existe pas de politique de rejet calibrée dans ce parcours. Autrement dit, le projet ne fournit pas une règle validée pour décider « aucune page ne répond à cette demande ». Un score MaxSim ne doit pas être lu comme une probabilité de réponse correcte. Pour ajouter un refus automatique, il faudrait concevoir puis mesurer ce comportement sur des demandes avec et sans résultat pertinent.
Ce que nous avons appris
Nous avons conservé plusieurs représentations par page, plutôt que de tout ramener à un seul vecteur. L’interaction tardive sépare la préparation de l’index et l’encodage de nouvelles questions. MaxSim cherche, pour chaque vecteur de requête valide, son meilleur voisin dans la page, puis additionne ces contributions.
Les masques font partie du calcul : ils empêchent le remplissage de participer au classement. Le traitement par blocs garde les mêmes maxima globaux tout en limitant la taille du tableau temporaire ; il ne compresse pas l’index.
Enfin, un classement pertinent n’est ni une réponse, ni une preuve de localisation fidèle. Les contributions aident à inspecter le score. Le rappel et le MRR évaluent le classement. Les demandes hors corpus posent encore un autre problème, que le parcours ne résout pas par un seuil de rejet.
Exercice — conserver les bons maxima
Avant de lancer les commandes, prenons un exemple numérique supplémentaire, choisi pour le calcul à la main. Un seul vecteur de requête compare ses similarités à deux blocs de page. Dans le premier bloc, les valeurs sont −0,8 et −0,6. Dans le second, elles sont −0,4 et −0,2. Toutes les positions sont valides.
Quel score doit rester à la fin ? Que se passerait-il si l’on additionnait le meilleur résultat de chaque bloc ? Et si best commençait à zéro au lieu de moins l’infini ? Écrivez les trois réponses avant de poursuivre.
Formulez aussi une hypothèse pour la comparaison des budgets de résolution : que peuvent devenir la taille de l’index, le temps de recherche et le rappel lorsque le budget augmente ? Le rappel doit-il forcément s’améliorer sur chaque question ? Distinguez une attente raisonnable d’un résultat déjà mesuré.
Exécutez ensuite l’exercice fourni. Il conserve l’algorithme du projet ; il vous fait comparer vos prédictions aux sorties plutôt que modifier discrètement le calcul.
docker compose run --rm inference python -m pdfmaxsim.cli exercise-index --config configs/exercise.yaml
docker compose run --rm inference python -m pdfmaxsim.cli exercise-search --config configs/exercise.yaml
docker compose run --rm tutorial python -m pdfmaxsim.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Correction du petit calcul. Le premier bloc fournit −0,6 ; le second fournit −0,2. Le maximum global est −0,2. Additionner les maxima locaux donnerait −0,8, ce qui compte deux contributions pour un seul vecteur de requête. Initialiser à zéro donnerait 0, une valeur qu’aucune comparaison réelle n’a produite.
Ces nombres illustrent le mécanisme ; ils ne sont pas annoncés comme la sortie d’un fichier du projet. La règle à retrouver dans maxsim_blocked() est bien : comparer les maxima, puis sommer une seule fois à la fin.
Pour l’expérience de résolution, consultez viewer.html, les PNG et les contributions. Comparez les mesures de taille, de temps et de rappel avec vos hypothèses. Une résolution plus élevée peut conserver davantage de détails, mais cela ne prouve pas que le modèle les utilisera mieux pour toutes les questions. N’attribuez pas un gain à la vision sur la seule base d’une vignette plus nette.
Dépanner sans fausser l’expérience
L’acquisition échoue ? Relisez la révision attendue, la taille des fichiers et leur SHA-256 avant de relancer. Ne copiez pas dans assets/ des poids trouvés ailleurs : le modèle chargé ne serait plus nécessairement celui du parcours.
CUDA échoue dans Docker ? Vérifiez le runtime, le pilote et NVIDIA Container Toolkit. Le diagnostic concerne d’abord l’accès effectif au GPU ; modifier une métrique ou un masque ne corrige pas ce problème d’environnement.
L’index est incompatible ? Reconstruisez-le avec le même encodeur, la même configuration de résolution et la même convention de masque que celles utilisées pour la recherche. Des vecteurs de même dimension ne sont pas nécessairement comparables s’ils proviennent de deux versions différentes. Conservez ensemble la représentation et la configuration qui lui donne son sens.
Le calcul manque de mémoire ? La recherche par blocs peut réduire le tableau temporaire des similarités. En revanche, si le problème est la taille de l’index lui-même, découper le calcul ne le rend pas plus petit. Réduire le budget de représentation exige de reconstruire les données concernées, puis de mesurer à nouveau taille, latence et rappel. Conservez ces essais séparément des résultats de référence.
Le classement semble absurde ? Commencez par ouvrir la page rendue, puis vérifiez les masques, les contributions et la formulation de la requête. Ne remplacez jamais les observations par les labels attendus pour rendre la sortie plus satisfaisante.
Production et nettoyage
Le tutoriel traite une petite collection contrôlée. Pour en faire un service documentaire, il reste à gérer les droits d’accès, les mises à jour, la suppression des données indexées, la qualité des rendus, les langues, la latence et les requêtes sans réponse. Ces éléments sont des travaux d’intégration à prévoir, pas des fonctionnalités démontrées par les scores de Lumen.
Conservez la provenance et les versions. Chaque résultat doit rester relié à son PDF, à sa page et à l’encodeur utilisé. Les contributions et les paramètres d’indexation permettent de revenir d’un classement à son calcul. Versionnez les index plutôt que de mélanger silencieusement des représentations incompatibles.
Appliquez les droits aux résultats comme à leurs aperçus. Une page interdite ne doit pas devenir consultable par sa vignette, son cache ou une sortie de diagnostic. La suppression d’un document doit aussi prendre en compte ses vecteurs, ses aperçus et ses caches.
Évaluez des demandes représentatives des utilisateurs. Le corpus synthétique anglais ne valide pas la robustesse aux fautes, à d’autres langues ou à la diversité de vos documents réels. Les 12 requêtes hors corpus montrent un classement forcé ; elles ne valident pas un mécanisme d’abstention. Constituez des cas avec et sans page pertinente, puis examinez les erreurs une requête à la fois, en plus des moyennes.
Une éventuelle génération de réponse doit consulter et citer des sources effectivement retrouvées. Elle ne doit pas inventer un texte à partir du seul rang d’une page. Notre programme s’arrête à un résultat de recherche inspectable.
Nettoyer uniquement les sorties prévues
Conservez les index, aperçus, figures et mesures que vous souhaitez étudier avant le nettoyage. Les commandes suivantes arrêtent le projet, lancent le nettoyage ciblé, puis arrêtent à nouveau le projet.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Le script supprime uniquement outputs/. Il conserve assets/ et data/generated/. Ne confondez pas ce nettoyage de résultats avec la suppression de tous les fichiers du modèle et du corpus.
Références pour approfondir
La documentation officielle de ColQwen décrit le modèle et ses représentations. Le dépôt ColBERT explique l’interaction tardive ; le chapitre BM25 du manuel de Stanford approfondit le repère textuel.
Pour relire les opérations du code, consultez la multiplication matricielle, le remplissage par masque et les limites de précision numérique dans PyTorch. La documentation de NVIDIA Container Toolkit couvre l’accès au GPU depuis Docker.
Ces références complètent les explications ; elles ne remplacent pas les versions, les configurations et les commandes du ZIP r001. Les petits calculs de l’article sont des exemples pédagogiques distincts des mesures obtenues sur Lumen.