





Está añadiendo un motor de búsqueda a una aplicación documental. Un usuario quiere encontrar la página en la que una válvula aparece encima de una bomba. Su búsqueda de texto completo encuentra la palabra «pump» en varios manuales. Pero, a partir de esa palabra sola, no sabe qué esquema corresponde a la disposición buscada.
El manual ficticio Lumen Equipment nos servirá de campo de pruebas. Contiene una curva, un diagrama de circuito y una lista de materiales, es decir, una lista de piezas. Nuestra pregunta es: «Which page shows the bypass valve above the pump?», es decir: «¿Qué página muestra la válvula de derivación encima de la bomba?». La traducción ayuda a entender el ejemplo; las consultas del recorrido siguen estando en inglés.
Vamos a construir un motor que indexa las imágenes de las páginas, no solo sus palabras. ColQwen2 transforma esas imágenes y las preguntas en representaciones numéricas; después, nuestro código calcula su semejanza con un método llamado MaxSim. Compararemos este método con BM25, una búsqueda textual, y con una representación obtenida mediante el promedio de vectores.
El objetivo es preciso: devolver páginas que examinar, no fabricar una respuesta sobre el funcionamiento de la máquina. El modelo ya está entrenado y no cambia durante el tutorial. Aprenderemos a dominar la indexación, la clasificación y su evaluación.
El problema concreto
Nuestra colección, también llamada corpus, incluye 24 manuales de cuatro páginas, es decir, 96 páginas. El programa recibe sus imágenes y preguntas. Debe ordenar las páginas de la más cercana a la consulta a la menos cercana y, después, permitir volver al documento de origen.
Una anotación de relevancia, o label, indica qué páginas se esperan para una pregunta. Sirve para medir la clasificación, no para producirla: el servicio inference accede a las imágenes y a las consultas, mientras que los labels permanecen fuera de su montaje Docker.
¿Qué es exactamente un embedding?
Un vector es aquí una lista de números. Un embedding es una representación calculada por un modelo, diseñada para permitir comparaciones útiles entre entradas. En lugar de comparar directamente los caracteres de una pregunta con los píxeles de un esquema, comparamos sus representaciones numéricas.
El programa que crea estas representaciones se llama codificador. En nuestro caso, puede recibir texto para una consulta e imagen para una página. La ficha oficial de ColQwen2 presenta esta búsqueda documental que asocia texto e imagen, con representaciones de varios vectores.
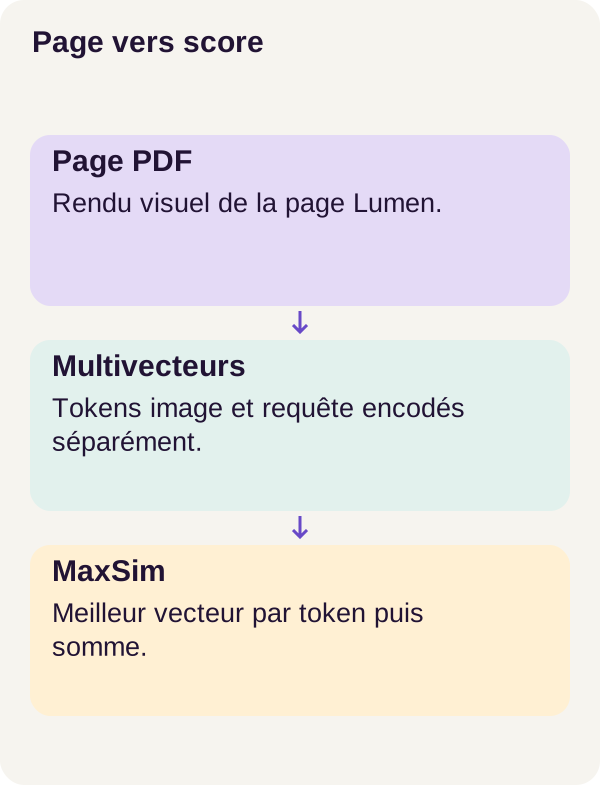
¿Por qué varios? Una página puede contener un título, una leyenda, una curva y un pequeño esquema. No queremos necesariamente resumir todo eso en un único vector. ColQwen2 conserva una secuencia de vectores, que llamamos multivectores. La consulta también tiene su propia secuencia.
Para hacerse una idea, imagine varios indicios numéricos en lugar de una sola ficha de resumen. Pero no tome la imagen de forma demasiado literal: no existe una columna llamada «bomba», otra «válvula» y una tercera «encima». Las representaciones se aprenden y dependen del contexto. Los nombres que les daremos en los ejemplos sirven para explicar el cálculo, no para traducir automáticamente sus dimensiones.
¿Por qué hablamos de interacción tardía?
La interacción tardía significa que la página y la consulta se codifican primero por separado. Solo se comparan en el momento de la búsqueda. Es el principio expuesto por el proyecto ColBERT, en el que se inspira esta estrategia de búsqueda multivectorial.
Para un desarrollador web, esta separación resulta familiar. Al importar documentos, prepara un dato reutilizable: el índice. Cuando llega una nueva búsqueda, codifica la pregunta y consulta ese índice. Quedan comparaciones por calcular, pero no es necesario volver a pasar todas las imágenes por el modelo en cada consulta.
Indexar no es entrenar. Aquí los parámetros del modelo, también llamados pesos, están congelados: no los ajustamos con los manuales Lumen. Usamos un modelo preentrenado para calcular nuevas representaciones. El contenido del índice cambia cuando añadimos una página; los pesos del modelo no cambian en este recorrido.
El hilo conductor: explicar un resultado, no solo verlo
Retomemos nuestro ejemplo conceptual: una página muestra una bomba, una flecha y una válvula. La pregunta contiene varios indicios, entre ellos bypass valve, above y pump. El motor debe buscar una página compatible con esos indicios y después permitirnos abrirla para comprobar la disposición.
El recorrido es: PDF → imagen de página → multivectores → comparación con la consulta → clasificación → inspección de la página. Renderizar el PDF como imagen significa producir los píxeles de la página, como los que muestra un lector de PDF. El índice conserva la página, el identificador del manual, los vectores y una máscara que indica cuáles utilizar.
La salida incluye una posición y contribuciones a la puntuación. La posición responde a «¿dónde coloca el motor esta página?». Las contribuciones permiten examinar las aproximaciones numéricas que participaron en la puntuación.
Ninguna de estas salidas permite afirmar «la válvula está abierta». Esa información ni se solicita ni queda establecida por la clasificación. Una posible respuesta redactada en su aplicación sería un paso adicional, que habría que vincular con sus fuentes y evaluar por separado. El motor de búsqueda nos indica dónde mirar; no sustituye la lectura de lo que ha encontrado.
Por qué un promedio pierde el detalle útil
Un promedio de vectores reúne varias representaciones en una sola al promediar sus componentes. Esta simplificación conserva información global, pero no retiene todas las diferencias entre las representaciones originales.
Imagine, para entenderlo, que un vector de consulta busca un indicio relacionado con la bomba y otro busca un indicio relacionado con su disposición. Cada uno podría encontrar una gran semejanza con una parte distinta de la página. Al mezclar las representaciones del esquema, el texto y el fondo, un promedio puede atenuar un detalle poco frecuente.
MaxSim toma otra decisión: para cada vector de consulta, conservar su mejor semejanza con la página. Después se suman esos mejores resultados. Los distintos indicios no necesitan encontrar su mejor vecino en el mismo lugar.
Esta elección no garantiza la relevancia. Un máximo también puede retener una semejanza accidental, y varios vectores de consulta pueden seleccionar el mismo vector de página. Nada en esta operación impone por sí solo una comprobación geométrica de la relación «encima». El modelo proporciona las representaciones; MaxSim las compara. Aún debemos medir si esta combinación encuentra las páginas correctas.
Entender MaxSim antes del código
De tablas de números a una puntuación
En el código, query contiene los vectores de la consulta y document los de una página. Un tensor es simplemente, para las operaciones que nos interesan, una tabla numérica. Cada fila de estas dos tablas es un vector.
Lq designa el número de posiciones de la consulta, Ld el de la página y D el número de componentes de un vector. Por tanto, las entradas tienen las formas [Lq, D] y [Ld, D]. Deben compartir la misma dimensión D para que sus vectores puedan compararse.
También encontrará la palabra token. En texto, es una unidad que manipula el modelo y que no corresponde necesariamente a una palabra completa. En imagen, el tratamiento utiliza representaciones visuales. En las funciones siguientes, el cálculo manipula sobre todo posiciones de las secuencias y sus vectores: no necesita asignarles un nombre en español.
La semejanza se calcula mediante un producto escalar: se multiplican los componentes correspondientes de los dos vectores y luego se suman. Ejemplo puramente numérico: los vectores [1, 0] y [0.6, 0.8], escritos con la notación decimal de Python, dan 1 × 0,6 + 0 × 0,8 = 0,6. Multiplicamos entre sí los dos primeros componentes, después los dos segundos y sumamos los resultados.
El contrato del código indica que el codificador proporciona vectores normalizados. Cuando su norma vale 1, este producto escalar corresponde a la similitud coseno, que compara su dirección. Esta normalización pertenece a la preparación de las entradas: la función check() no la calcula ni la comprueba por sí misma.
Un MaxSim que se puede calcular a mano
Tomemos un ejemplo pedagógico inventado, con dos vectores de consulta y tres vectores de página. Estos son los productos escalares obtenidos; no son mediciones del corpus Lumen.
| Vector de consulta | Página: vector 0 | Página: vector 1 | Página: vector 2 |
|---|---|---|---|
| Consulta: vector 0 | 0,8 | 0,1 | 0,2 |
| Consulta: vector 1 | 0,1 | 0,9 | 0,2 |
En la primera fila, el máximo es 0,8, encontrado en el vector 0 de la página. En la segunda, es 0,9, encontrado en el vector 1. Por tanto, la puntuación MaxSim es 0,8 + 0,9 = 1,7.
No hemos tomado ni el máximo único de la tabla, que sería 0,9, ni la suma de todas las celdas. La regla se lee así: buscar un máximo por fila de consulta y después sumar esos máximos. Solo las posiciones declaradas válidas participan en el resultado.
Esta puntuación de 1,7 no es una probabilidad. Puede superar 1 porque suma varias contribuciones. El número de vectores de consulta también influye en esta suma: no convierta un umbral elegido para una pregunta en una garantía universal de relevancia para todas las demás.
Padding: posiciones añadidas, no contenido
Para tratar juntas varias secuencias de longitudes distintas, se pueden completar las más cortas con posiciones artificiales: esto es el padding, o relleno. La máscara es una lista de booleanos de la misma longitud que la secuencia. True significa «usar esta posición» y False, «excluirla».
¿Por qué no dejar simplemente ceros? Tomemos otro ejemplo numérico: los dos vectores reales de una página dan similitudes de −0,6 y −0,8 con un vector de consulta. Un vector nulo añadido como relleno da 0. Sin máscara, cero obtiene el máximo, aunque no corresponde a ninguna información real.
Por tanto, el programa sustituye las similitudes de las posiciones documentales no válidas por menos infinito, escrito -torch.inf. El máximo vuelve a ser −0,6, el mejor de los dos resultados permitidos. Después interviene la máscara de consulta para excluir de la suma sus propias posiciones artificiales.
La implementación del proyecto
El siguiente bloque contiene el control de entradas, tres maneras de calcular la misma puntuación y una función de inspección. Conservamos el código del recorrido r001.
"""Exact masked MaxSim; inputs are normalized by the pretrained encoder."""

import torch


def check(query, document, query_mask, document_mask):
    if query.ndim != 2 or document.ndim != 2 or query.shape[1] != document.shape[1]:
        raise ValueError("Expected [Lq,D] and [Ld,D] with the same D")
    if query_mask.shape != query.shape[:1] or document_mask.shape != document.shape[:1]:
        raise ValueError("Mask length does not match embeddings")
    if query_mask.dtype != torch.bool or document_mask.dtype != torch.bool:
        raise ValueError("Masks must be boolean")
    if not query_mask.any() or not document_mask.any():
        raise ValueError("Empty valid query or document sequence")
    if not torch.isfinite(query).all() or not torch.isfinite(document).all():
        raise ValueError("Non-finite embeddings")


def maxsim_dense(query, document, query_mask, document_mask):
    check(query, document, query_mask, document_mask)
    similarities = query.float() @ document.float().T
    similarities = similarities.masked_fill(~document_mask[None, :], -torch.inf)
    best = similarities.max(dim=1).values
    return best[query_mask].sum()


def maxsim_scalar(query, document, query_mask, document_mask):
    check(query, document, query_mask, document_mask)
    return sum(
        max(
            float(torch.dot(query[i].float(), document[j].float()))
            for j in range(len(document))
            if document_mask[j]
        )
        for i in range(len(query))
        if query_mask[i]
    )


def maxsim_blocked(query, document, query_mask, document_mask, block_size=128):
    check(query, document, query_mask, document_mask)
    if not isinstance(block_size, int) or block_size <= 0:
        raise ValueError("Positive integer vector block size required")
    best = torch.full((len(query),), -torch.inf, device=query.device)
    for start in range(0, len(document), block_size):
        scores = query.float() @ document[start : start + block_size].float().T
        scores = scores.masked_fill(
            ~document_mask[None, start : start + block_size], -torch.inf
        )
        best = torch.maximum(best, scores.max(dim=1).values)
    return best[query_mask].sum()


def contributions(query, document, query_mask, document_mask):
    check(query, document, query_mask, document_mask)
    matrix = query.float() @ document.float().T
    values, positions = matrix.masked_fill(~document_mask[None, :], -torch.inf).max(
        dim=1
    )
    return [
        {
            "query_vector": i,
            "document_vector": int(positions[i]),
            "similarity": float(values[i]),
        }
        for i in range(len(query))
        if query_mask[i]
    ]
Leer las funciones paso a paso
check() comprueba el contrato de entrada. Las tablas deben tener dos dimensiones y vectores del mismo tamaño. Cada máscara debe corresponder a la longitud de su secuencia y ser de tipo booleano. Debe haber al menos una posición válida en cada lado. Por último, las tablas no deben contener ni NaN, que indica un valor numérico indefinido, ni infinito. Esta última comprobación abarca todos sus valores, incluidos los de las posiciones enmascaradas.
Estos rechazos evitan devolver una puntuación que parezca utilizable pese a entradas incoherentes. No comprueban, sin embargo, que la representación haya capturado la información visual correcta.
maxsim_dense() construye todas las semejanzas de una vez. .float() convierte las tablas en números de coma flotante de 32 bits. .T transpone la tabla de la página: sus filas se convierten en columnas. El operador @ realiza entonces una multiplicación matricial, descrita en la documentación de PyTorch. El resultado tiene Lq filas y Ld columnas, como nuestra pequeña tabla de ejemplo.
document_mask[None, :] da a la máscara una fila, aplicable a todas las filas de la tabla. El signo ~ invierte sus booleanos: las posiciones no válidas pasan a ser las que se sustituyen por menos infinito. Después, max(dim=1) busca el máximo en las columnas de cada fila. Por último, best[query_mask].sum() conserva las filas de consulta permitidas y suma sus mejores puntuaciones.
maxsim_scalar() despliega la misma regla con bucles. Para cada posición de consulta válida, calcula los productos escalares con las posiciones documentales válidas, toma el máximo y después suma. Es una referencia fácil de releer para entender el cálculo, no una estrategia pensada para aprovechar eficazmente el paralelismo de la GPU. Esta versión devuelve un número Python, mientras que las versiones vectorizadas devuelven un tensor escalar.
maxsim_blocked() evita construir toda la tabla de una vez. Recorre los vectores de la página por bloques, de 128 posiciones de forma predeterminada. La tabla best conserva una mejor puntuación para cada posición de consulta. En cada bloque, torch.maximum compara esa mejor puntuación con los nuevos máximos y conserva el mayor, posición por posición. La suma solo llega después de recorrer todos los bloques.
Este es el punto clave: se conserva el máximo global de cada vector de consulta, no una puntuación independiente que sumar para cada bloque. De lo contrario, el resultado cambiaría simplemente porque se hubiera dividido la página de otra forma.
Lo que los bloques ahorran realmente
La versión densa materializa Lq × Ld similitudes. Con bloques de tamaño B, la tabla temporal contiene solo unas Lq × B a la vez, además de los máximos conservados. El número de comparaciones sigue siendo del mismo orden: calculamos la misma puntuación de otra manera, no nos saltamos una parte de la página.
Tomemos un dimensionamiento ilustrativo, sin relación con una medición de memoria del recorrido: 32 vectores de consulta y 1 024 vectores de página dan 32 768 similitudes. A 32 bits, su tabla ocupa 128 KiB. Con bloques de 128, la tabla de similitudes de un bloque contiene 4 096 valores, es decir, 16 KiB.
Esta reducción afecta a la tabla temporal de puntuaciones. No comprime el índice almacenado, no borra los vectores de entrada ni reduce los pesos del modelo. Las conversiones numéricas y los demás cálculos también consumen memoria. Un índice demasiado voluminoso en disco y un cálculo temporal demasiado voluminoso en GPU son dos problemas distintos.
Las versiones densa y por bloques calculan el mismo MaxSim matemático; las pruebas del proyecto verifican esta paridad. Además, la documentación de PyTorch sobre precisión numérica recuerda que una equivalencia matemática no garantiza una identidad bit a bit después de cambiar el hardware o el cálculo en coma flotante. Mantenga los controles del proyecto al adaptar la implementación.
Leer una contribución concreta
contributions() retoma la matriz de similitudes, pero conserva la posición ganadora, además de su valor. En nuestro ejemplo pedagógico, el vector 0 de consulta elige el vector 0 de página con 0,8; el vector 1 elige el vector 1 con 0,9.
En los objetos devueltos, query_vector es el índice en la consulta, document_vector el índice en la secuencia de la página y similarity el valor conservado. Al sumarlos, se recupera la puntuación del ejemplo. Por tanto, estos objetos permiten vincular el total con sus contribuciones.
Sin embargo, un indicio no es ni una palabra traducida ni una caja de detección. Para situarlo en la imagen, hay que conservar la correspondencia con la preparación de esa imagen. Incluso cuando una visualización muestra una zona cercana a la bomba, no constituye una prueba de que el modelo haya interpretado correctamente toda la relación espacial.
Si un resultado inesperado parece depender del fondo de la página, inspeccione el renderizado, las máscaras y la pregunta. No modifique primero los datos ni un umbral para que la clasificación resulte más convincente. El papel de las contribuciones es hacer que el cálculo sea inspeccionable, no vestir cada resultado con una explicación necesariamente correcta.
Requisitos previos y entorno
Debe poder leer Python, manipular listas y tablas y usar Docker desde un terminal. No es necesario saber entrenar una red para seguir este recorrido: utilizamos un codificador preentrenado sin modificar sus pesos.
La referencia utiliza Linux, Docker Engine, Compose, un controlador NVIDIA y NVIDIA Container Toolkit, con una RTX 3090 de 24 GiB. No se valida ningún perfil de CPU. Los 32 GiB de RAM y 40 GiB de disco indicados son estimaciones de preparación, no mínimos medidos para todas las máquinas. La RAM es la memoria del ordenador; los 24 GiB de la tarjeta corresponden a su memoria de vídeo, o VRAM.
NVIDIA Container Toolkit conecta Docker con los dispositivos y las bibliotecas del controlador NVIDIA del host. Por tanto, una GPU visible en Linux no es necesariamente utilizable por el programa en contenedor. Consulte su documentación de instalación para elegir la integración adaptada a su sistema. El control del proyecto ejecuta después el modelo en Docker; nvidia-smi en el host no sustituye esta comprobación.
Descomprima el ZIP y sitúese en su carpeta raíz. Todos los comandos siguientes se ejecutan desde ese directorio. La adquisición es el único servicio del recorrido que dispone de red; verifica la revisión, el tamaño y la huella SHA-256 de los pesos. Una huella permite controlar la identidad del contenido descargado. Conserve las dependencias y los archivos bloqueados del ZIP en lugar de sustituirlos por una instalación encontrada en un ejemplo más reciente.
Paso 1: comprobar el runtime
El runtime es aquí el entorno en el que se ejecuta el programa. Preparemos las carpetas, validemos Compose, construyamos los servicios, adquiramos el modelo y ejecutemos los controles.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Cada comando debe terminar con un código de salida cero, que indica una ejecución correcta. Las pruebas cubren las máscaras, MaxSim, la compatibilidad del índice y las coordenadas PDF. Comprueban el funcionamiento del programa; no significan que todas sus clasificaciones sean pertinentes.
Paso 2: preparar e indexar
Ahora podemos producir las páginas Lumen y sus representaciones, inspeccionar una puntuación y calcular después la referencia textual.
docker compose run --rm tutorial python -m pdfmaxsim.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m pdfmaxsim.cli index --config configs/minimum.yaml
docker compose run --rm inference python -m pdfmaxsim.cli explain-score --config configs/minimum.yaml
docker compose run --rm inference python -m pdfmaxsim.cli baseline --config configs/minimum.yaml
prepare renderiza las páginas. Debe encontrar las 96 imágenes del catálogo. Compruebe visualmente el texto y los esquemas: una imagen recortada o ilegible ya es una mala entrada, antes de cualquier cálculo de embedding.
index registra los multivectores y sus máscaras. Así, las imágenes se transforman en datos reutilizables durante las búsquedas. El vínculo con la página y el manual debe seguir disponible: encontrar un vector sin poder abrir su fuente no bastaría.
explain-score expone las contribuciones. Localice la consulta del hilo conductor y relacione la puntuación con sus mejores vecinos. No sustituya esta inspección por la intuición de que «la primera página parece buena».
baseline calcula la referencia BM25. Una baseline es un método de comparación. BM25 clasifica texto considerando, entre otros aspectos, los términos presentes, su frecuencia, su rareza en la colección y la longitud de los documentos. El capítulo dedicado a BM25 en el manual de Stanford detalla estos mecanismos.
Aquí BM25 utiliza el texto disponible: no recibe los píxeles del esquema para interpretar su disposición. Sin embargo, puede encontrar una buena página gracias a sus etiquetas. Ese es precisamente el interés de la comparación: comprobar qué aporta la búsqueda visual más allá de esos indicios textuales, sin suponer que ganará en todas partes.
Paso 3: medir y experimentar
La evaluación puede entonces comparar las clasificaciones con las páginas esperadas, en un servicio distinto del que produce las representaciones y las búsquedas.
docker compose run --rm tutorial python -m pdfmaxsim.cli evaluate --config configs/minimum.yaml
Leeremos sus métricas en la sección siguiente. No cambie los ajustes después de ver los resultados de prueba para quedarse solo con la mejor variante.
Qué permite comprobar cada salida
Después de index, inspeccione las dimensiones, las máscaras y la huella del codificador en los archivos de salida. Después de explain-score, vuelva a la página del hilo conductor y a sus contribuciones. Los controles de paridad deben recuperar el mismo cálculo con las versiones densa y por bloques.
El catálogo de 96 páginas es común; lo que se separa son las consultas. El recorrido incluye 48 consultas de desarrollo y 144 consultas de prueba. No entrena el modelo con un primer grupo de páginas para probarlo después con otro.
El conjunto de desarrollo sirve para tomar una decisión de diseño. El conjunto de prueba sirve para medir la decisión una vez fijada. Incluso sin entrenamiento, elegir un ajuste porque funciona mejor en la prueba haría que esta perdiera su papel de medición final independiente de la elección.
Los dos presupuestos de resolución se fijan de antemano: 200704 y 401408. Influyen en el tamaño de las representaciones y en el coste de búsqueda. Use las configuraciones proporcionadas para reproducirlos. El segundo presupuesto duplica el primero; eso no permite deducir que el tamaño real del índice o el tiempo de ejecución se duplicarán exactamente. Estos efectos se miden en las salidas del recorrido.
La comparación con el promedio de vectores sirve para examinar qué cambia al conservar múltiples representaciones. Sus salidas deben consultarse junto con las de los presupuestos: no deduzca un resultado numérico de la sola intuición de que un promedio pierde detalle.
Leer las métricas antes que las cifras
Una métrica es una medida elegida para evaluar un comportamiento. Para nuestro motor, la pregunta no es «¿es grande la puntuación MaxSim?», sino «¿están bien colocadas las páginas esperadas?». Distinguiremos la cantidad de páginas relevantes recuperadas y la posición de la primera.
Recall@k: ¿qué proporción de las buenas páginas se recupera?
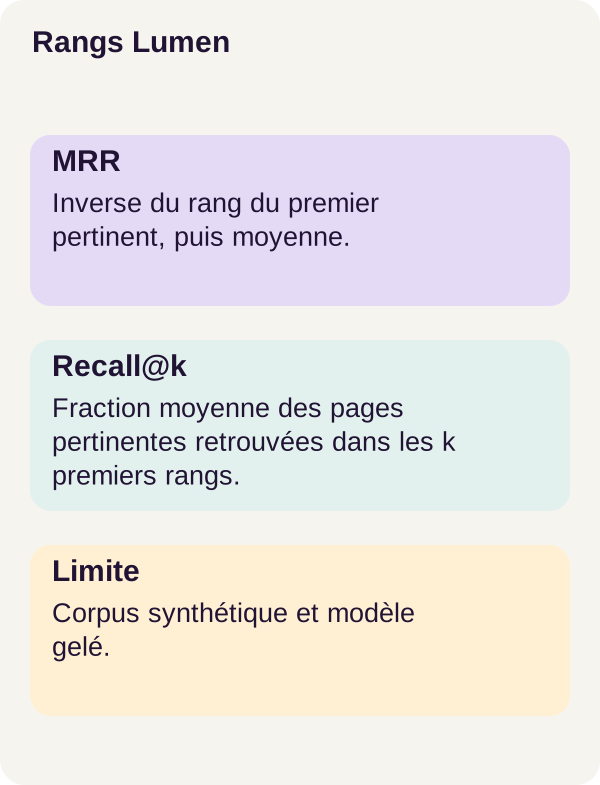
El Recall@k, o recuperación en las primeras k posiciones, mide para cada consulta la fracción de sus páginas relevantes presente en esas posiciones. Después se promedian esas fracciones sobre las consultas evaluadas.
Tomemos una clasificación ficticia. Tres páginas son relevantes, llamadas A, B y C. El motor devuelve A, X, B, C, Y, donde X e Y no son relevantes.
En la posición 1, hemos recuperado A, es decir, una página relevante de tres: Recall@1 = 1/3. En los tres primeros resultados están A y B: Recall@3 = 2/3. En los cinco primeros están A, B y C: Recall@5 = 1.
¡Sin embargo, la primera página era correcta desde el principio! Por eso Recall@1 no es aquí el porcentaje de consultas cuyo primer resultado es relevante. Una pregunta puede tener varias páginas correctas; mostrar solo una no permite recuperarlas todas.
MRR: ¿dónde aparece la primera página relevante?
El MRR, de Mean Reciprocal Rank, promedia el inverso de la posición de la primera página relevante. En la posición 1, la contribución vale 1/1 = 1; en la posición 2, 1/2 = 0,5; en la posición 4, 1/4 = 0,25.
En nuestra clasificación ficticia A, X, B, C, Y, esta contribución vale 1. Con X, A, B, C, Y, vale 0,5. Si estas clasificaciones correspondieran a dos consultas, su MRR sería (1 + 0,5) / 2 = 0,75.
El MRR no dice cuántas otras buenas páginas siguen a la primera. Por tanto, el recall y el MRR observan dos propiedades distintas: recuperar las páginas esperadas y hacer aparecer rápidamente una primera página relevante. Ninguno de los dos comprueba el contenido de una posible respuesta redactada.
Resultados observados en Lumen
Las siguientes mediciones se refieren a las 144 consultas de prueba, sobre el catálogo sintético en inglés de 96 páginas. Retoman los valores del recorrido r001.
| Medida | MaxSim de alta resolución | BM25 |
|---|---|---|
| MRR | 0,9549 | 0,9410 |
| Recall@1 | 0,5903 | 0,5972 |
| Recall@5 | 1,0000 | No indicado aquí |
| Recall@10 | 1,0000 | No indicado aquí |
«No indicado aquí» significa que ese valor no se proporciona en los resultados numéricos incluidos en el artículo; no significa ni cero ni un fallo del método.
El MRR de MaxSim es mejor, pero su Recall@1 no lo es. Por tanto, la clasificación es más favorable según el promedio de inversos de posición, sin mejorar la fracción media de páginas relevantes recuperadas en el primer lugar. No podemos deducir de ello una superioridad en cada consulta.
BM25 sigue siendo un competidor serio en este corpus: algunas etiquetas textuales ya pueden bastar para encontrar una página. Los recalls a 5 y a 10 de MaxSim se comunican como 1,0000, pero no demuestran ni una comprensión perfecta de los esquemas ni la misma calidad en PDF reales, otros idiomas o una colección mucho mayor.
Cuando ninguna página es relevante
El recorrido también incluye 12 consultas fuera del corpus. Para ellas, ninguna página de la colección constituye una respuesta relevante. Se excluyen de las métricas de relevancia presentadas más arriba y deben examinarse por separado.
El motor produce aun así una clasificación: encuentra la página más cercana entre las que posee. Eso no significa que haya encontrado una buena página. La mejor candidata de una mala lista sigue siendo una mala candidata.
No existe una política de rechazo calibrada en este recorrido. En otras palabras, el proyecto no proporciona una regla validada para decidir «ninguna página responde a esta solicitud». Una puntuación MaxSim no debe leerse como una probabilidad de respuesta correcta. Para añadir un rechazo automático, habría que diseñar y medir ese comportamiento con solicitudes que tengan y que no tengan un resultado relevante.
Lo que hemos aprendido
Hemos conservado varias representaciones por página, en lugar de reducirlo todo a un solo vector. La interacción tardía separa la preparación del índice y la codificación de nuevas preguntas. MaxSim busca, para cada vector de consulta válido, su mejor vecino en la página y después suma esas contribuciones.
Las máscaras forman parte del cálculo: impiden que el relleno participe en la clasificación. El procesamiento por bloques mantiene los mismos máximos globales al tiempo que limita el tamaño de la tabla temporal; no comprime el índice.
Por último, una clasificación relevante no es ni una respuesta ni una prueba de localización fiel. Las contribuciones ayudan a inspeccionar la puntuación. El recall y el MRR evalúan la clasificación. Las solicitudes fuera del corpus plantean otro problema, que el recorrido no resuelve mediante un umbral de rechazo.
Ejercicio: conservar los máximos correctos
Antes de ejecutar los comandos, tomemos un ejemplo numérico adicional, elegido para calcularlo a mano. Un solo vector de consulta compara sus similitudes con dos bloques de página. En el primer bloque, los valores son −0,8 y −0,6. En el segundo, son −0,4 y −0,2. Todas las posiciones son válidas.
¿Qué puntuación debe conservarse al final? ¿Qué ocurriría si sumáramos el mejor resultado de cada bloque? ¿Y si best empezara en cero en vez de menos infinito? Escriba las tres respuestas antes de continuar.
Formule también una hipótesis para comparar los presupuestos de resolución: ¿qué pueden pasar a ser el tamaño del índice, el tiempo de búsqueda y el recall cuando aumenta el presupuesto? ¿Debe el recall mejorar necesariamente en cada consulta? Distinga una expectativa razonable de un resultado ya medido.
Ejecute después el ejercicio proporcionado. Conserva el algoritmo del proyecto; le permite comparar sus predicciones con las salidas en vez de modificar discretamente el cálculo.
docker compose run --rm inference python -m pdfmaxsim.cli exercise-index --config configs/exercise.yaml
docker compose run --rm inference python -m pdfmaxsim.cli exercise-search --config configs/exercise.yaml
docker compose run --rm tutorial python -m pdfmaxsim.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Corrección del pequeño cálculo. El primer bloque proporciona −0,6; el segundo proporciona −0,2. El máximo global es −0,2. Sumar los máximos locales daría −0,8, lo que cuenta dos contribuciones para un solo vector de consulta. Inicializar en cero daría 0, un valor que ninguna comparación real ha producido.
Estos números ilustran el mecanismo; no se presentan como la salida de un archivo del proyecto. La regla que hay que encontrar en maxsim_blocked() es: comparar los máximos y sumar una sola vez al final.
Para el experimento de resolución, consulte viewer.html, los PNG y las contribuciones. Compare las mediciones de tamaño, tiempo y recall con sus hipótesis. Una resolución más alta puede conservar más detalles, pero eso no demuestra que el modelo los utilizará mejor para todas las preguntas. No atribuya una mejora a la visión solo por una miniatura más nítida.
Resolver problemas sin falsear el experimento
¿Falla la adquisición? Revise la revisión esperada, el tamaño de los archivos y su SHA-256 antes de volver a intentarlo. No copie en assets/ pesos encontrados en otro lugar: el modelo cargado ya no sería necesariamente el del recorrido.
¿Falla CUDA en Docker? Compruebe el runtime, el controlador y NVIDIA Container Toolkit. El diagnóstico se refiere primero al acceso efectivo a la GPU; modificar una métrica o una máscara no corrige este problema de entorno.
¿Es incompatible el índice? Reconstrúyalo con el mismo codificador, la misma configuración de resolución y la misma convención de máscara que se usan para la búsqueda. Los vectores de la misma dimensión no son necesariamente comparables si proceden de dos versiones distintas. Conserve juntas la representación y la configuración que le da sentido.
¿Falta memoria para el cálculo? La búsqueda por bloques puede reducir la tabla temporal de similitudes. En cambio, si el problema es el tamaño del índice, dividir el cálculo no lo hace más pequeño. Reducir el presupuesto de representación exige reconstruir los datos afectados y medir de nuevo tamaño, latencia y recall. Mantenga estos ensayos separados de los resultados de referencia.
¿La clasificación parece absurda? Empiece por abrir la página renderizada y compruebe después las máscaras, las contribuciones y la formulación de la consulta. Nunca sustituya las observaciones por los labels esperados para que la salida resulte más satisfactoria.
Producción y limpieza
El tutorial trata una pequeña colección controlada. Para convertirla en un servicio documental, aún hay que gestionar los derechos de acceso, las actualizaciones, la eliminación de los datos indexados, la calidad de los renderizados, los idiomas, la latencia y las consultas sin respuesta. Estos elementos son trabajos de integración pendientes, no funcionalidades demostradas por las puntuaciones de Lumen.
Conserve la procedencia y las versiones. Cada resultado debe seguir vinculado a su PDF, su página y el codificador utilizado. Las contribuciones y los parámetros de indexación permiten volver de una clasificación a su cálculo. Versione los índices en lugar de mezclar silenciosamente representaciones incompatibles.
Aplique los derechos a los resultados igual que a sus vistas previas. Una página prohibida no debe volverse consultable a través de su miniatura, su caché o una salida de diagnóstico. La eliminación de un documento también debe tener en cuenta sus vectores, sus vistas previas y sus cachés.
Evalúe solicitudes representativas de los usuarios. El corpus sintético en inglés no valida la solidez ante erratas, otros idiomas o la diversidad de sus documentos reales. Las 12 consultas fuera del corpus muestran una clasificación forzada; no validan un mecanismo de abstención. Cree casos con y sin página relevante y examine los errores una consulta cada vez, además de los promedios.
Una posible generación de respuesta debe consultar y citar fuentes realmente recuperadas. No debe inventar un texto a partir de la sola posición de una página. Nuestro programa se detiene en un resultado de búsqueda inspeccionable.
Limpiar solo las salidas previstas
Conserve los índices, las vistas previas, las figuras y las mediciones que quiera estudiar antes de limpiar. Los siguientes comandos detienen el proyecto, ejecutan la limpieza específica y vuelven a detener el proyecto.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
El script elimina únicamente outputs/. Conserva assets/ y data/generated/. No confunda esta limpieza de resultados con la eliminación de todos los archivos del modelo y del corpus.
Referencias para profundizar
La documentación oficial de ColQwen describe el modelo y sus representaciones. El repositorio ColBERT explica la interacción tardía; el capítulo sobre BM25 del manual de Stanford profundiza en la referencia textual.
Para revisar las operaciones del código, consulte la multiplicación matricial, el relleno mediante máscara y los límites de precisión numérica en PyTorch. La documentación de NVIDIA Container Toolkit cubre el acceso a la GPU desde Docker.
Estas referencias completan las explicaciones; no sustituyen las versiones, las configuraciones ni los comandos del ZIP r001. Los pequeños cálculos del artículo son ejemplos pedagógicos distintos de las mediciones obtenidas en Lumen.