





State aggiungendo un motore di ricerca a un'applicazione documentale. Un utente vuole ritrovare la pagina in cui una valvola compare sopra una pompa. La ricerca full-text trova bene la parola «pump» in vari manuali, ma da quella sola parola non sa quale schema corrisponda alla disposizione cercata.
Il manuale fittizio Lumen Equipment sarà il nostro banco di prova. Contiene una curva, uno schema di circuito e una distinta base, cioè un elenco di componenti. La domanda è: «Which page shows the bypass valve above the pump?», ovvero: «Quale pagina mostra la valvola di bypass sopra la pompa?». La traduzione aiuta a capire l'esempio; le query del percorso restano in inglese.
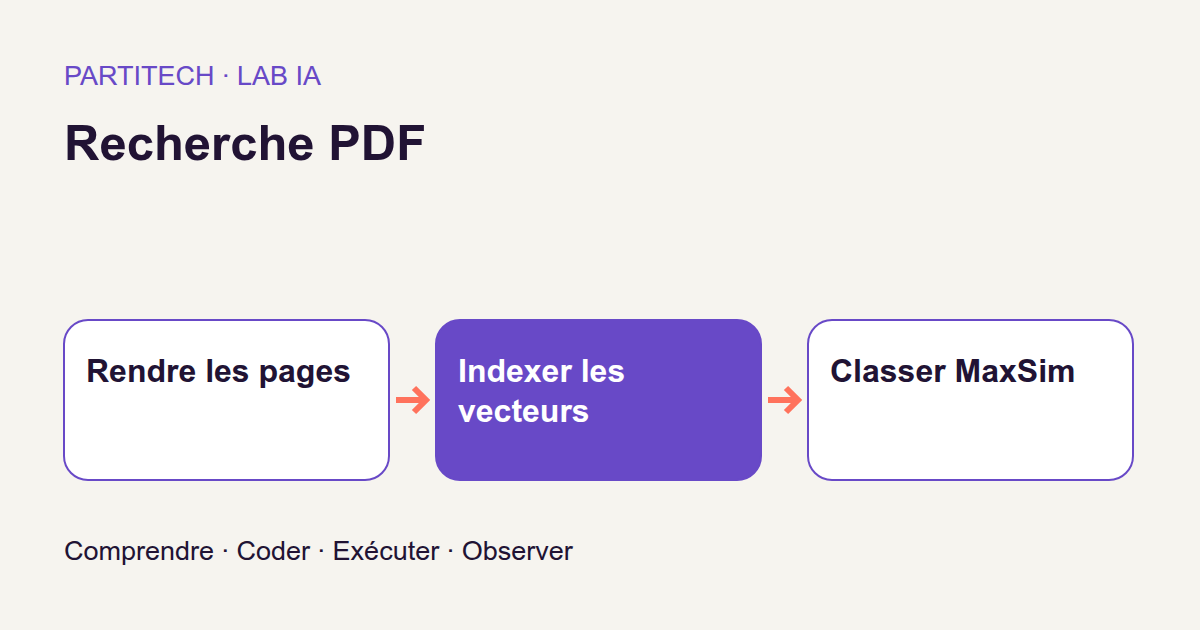
Costruiremo un motore che indicizza le immagini delle pagine, non soltanto le loro parole. ColQwen2 trasforma immagini e domande in rappresentazioni numeriche; il nostro codice ne calcola poi la somiglianza con un metodo chiamato MaxSim. Confronteremo questo metodo con BM25, una ricerca testuale, e con una rappresentazione ottenuta facendo la media dei vettori.
L'obiettivo è preciso: restituire pagine da esaminare, non produrre una risposta sul funzionamento della macchina. Il modello è già addestrato e non cambia durante il tutorial. Impareremo a padroneggiare l'indicizzazione, il ranking e la relativa valutazione.
Il problema concreto
La nostra raccolta, detta anche corpus, comprende 24 manuali di quattro pagine, per un totale di 96 pagine. Il programma riceve le loro immagini e delle domande. Deve ordinare le pagine dalla più vicina alla query alla meno vicina, quindi permettere di risalire al documento originale.
Un'annotazione di pertinenza, o label, indica quali pagine sono attese per una domanda. Serve a misurare il ranking, non a produrlo: il servizio inference accede alle immagini e alle query, mentre le label restano fuori dal suo mount Docker.
Che cos'è esattamente un embedding?
Un vettore è qui un elenco di numeri. Un embedding è una rappresentazione calcolata da un modello, pensata per rendere utili i confronti tra input. Invece di confrontare direttamente i caratteri di una domanda con i pixel di uno schema, confrontiamo le loro rappresentazioni numeriche.
Il programma che crea queste rappresentazioni è chiamato encoder. Nel nostro caso può ricevere testo per una query e un'immagine per una pagina. La scheda ufficiale di ColQwen2 presenta questa ricerca documentale che associa testo e immagine, con rappresentazioni a più vettori.
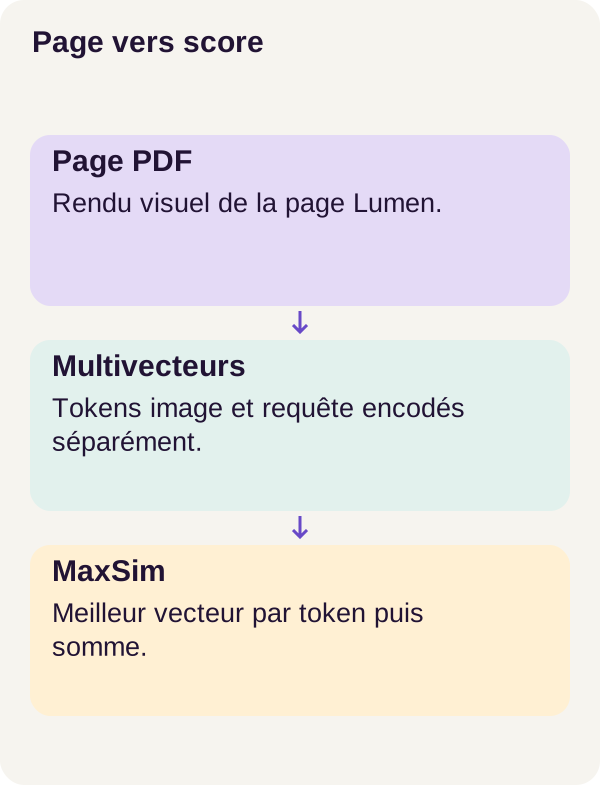
Perché più di uno? Una pagina può contenere un titolo, una didascalia, una curva e un piccolo schema. Non vogliamo necessariamente riassumere tutto in un unico vettore. ColQwen2 conserva una sequenza di vettori, che chiamiamo multivettori. Anche la query possiede la propria sequenza.
Per visualizzare l'idea, immaginate più indizi numerici invece di una sola scheda riassuntiva. Non prendete però l'immagine troppo alla lettera: non esiste una colonna chiamata «pompa», un'altra «valvola» e una terza «sopra». Le rappresentazioni sono apprese e contestualizzate. I nomi che daremo loro negli esempi servono a spiegare il calcolo, non a tradurne automaticamente le dimensioni.
Perché si parla di interazione tardiva?
L'interazione tardiva significa che la pagina e la query vengono prima codificate separatamente. Vengono confrontate solo al momento della ricerca. È il principio illustrato dal progetto ColBERT, da cui trae ispirazione questa strategia di ricerca multivettoriale.
Per uno sviluppatore web, la separazione è familiare. Durante l'importazione dei documenti si prepara un dato riutilizzabile: l'indice. Quando arriva una nuova ricerca, si codifica la domanda e poi si consulta questo indice. Restano confronti da calcolare, ma non occorre far passare di nuovo tutte le immagini nel modello a ogni query.
Indicizzare non significa addestrare. Qui i parametri del modello, chiamati anche pesi, sono congelati: non li adattiamo ai manuali Lumen. Usiamo un modello preaddestrato per calcolare nuove rappresentazioni. Il contenuto dell'indice cambia quando aggiungiamo una pagina; i pesi del modello non cambiano in questo percorso.
Il filo conduttore: spiegare un risultato, non soltanto vederlo
Riprendiamo il nostro esempio concettuale: una pagina mostra una pompa, una freccia e una valvola. La domanda contiene vari indizi, tra cui bypass valve, above e pump. Il motore deve cercare una pagina compatibile con questi indizi, poi lasciarci aprirla per verificare la disposizione.
Il percorso è: PDF → immagine della pagina → multivettori → confronto con la query → ranking → ispezione della pagina. Renderizzare il PDF in immagine significa produrre i pixel della pagina, come quelli mostrati da un lettore PDF. L'indice conserva la pagina, l'identificatore del manuale, i vettori e una maschera che indica quali usare.
L'output comprende una posizione in classifica e contributi al punteggio. La posizione risponde a «dove colloca il motore questa pagina?». I contributi permettono di esaminare gli accostamenti numerici che hanno partecipato al punteggio.
Nessuno di questi output autorizza ad affermare «la valvola è aperta». Questa informazione non è né richiesta né stabilita dal ranking. Un'eventuale risposta redatta nella vostra applicazione sarebbe un passaggio aggiuntivo, da collegare alle sue fonti e da valutare separatamente. Il motore di ricerca ci indica dove guardare; non sostituisce la lettura di ciò che ha trovato.
Perché una media perde il dettaglio utile
Una media di vettori riunisce più rappresentazioni in una sola mediandone le componenti. Questa semplificazione conserva un'informazione globale, ma non mantiene tutte le differenze tra le rappresentazioni originali.
Immaginate, per intuizione, che un vettore della query cerchi un indizio legato alla pompa e un altro alla sua disposizione. Ciascuno potrebbe trovare una forte somiglianza con una parte diversa della pagina. Mescolando le rappresentazioni dello schema, del testo e dello sfondo, una media può attenuare un dettaglio raro.
MaxSim prende un'altra decisione: per ogni vettore della query, conserva la sua migliore somiglianza con la pagina. Questi migliori risultati vengono poi sommati. I diversi indizi non devono trovare il proprio miglior vicino nello stesso punto.
Questa scelta non garantisce la pertinenza. Un massimo può anche trattenere una somiglianza accidentale e più vettori della query possono selezionare lo stesso vettore della pagina. Nulla in questa operazione impone da solo una verifica geometrica della relazione «sopra». Il modello fornisce le rappresentazioni; MaxSim le confronta. Dobbiamo ancora misurare se questa combinazione ritrova le pagine giuste.
Comprendere MaxSim prima del codice
Da tabelle di numeri a un punteggio
Nel codice, query contiene i vettori della query e document quelli di una pagina. Un tensore è semplicemente, per le operazioni che ci interessano, una tabella numerica. Ogni riga di queste due tabelle è un vettore.
Lq indica il numero di posizioni della query, Ld quello della pagina e D il numero di componenti di un vettore. Gli input hanno quindi forme [Lq, D] e [Ld, D]. Devono condividere la stessa dimensione D perché i loro vettori possano essere confrontati.
Incontrerete anche la parola token. Dal lato testo è un'unità elaborata dal modello, che non corrisponde necessariamente a una parola intera. Dal lato immagine, il trattamento sfrutta rappresentazioni visive. Nelle funzioni seguenti il calcolo manipola soprattutto posizioni nelle sequenze e i loro vettori: non deve attribuire loro un nome in italiano.
La somiglianza viene calcolata con un prodotto scalare: si moltiplicano le componenti corrispondenti dei due vettori, poi si sommano. Esempio puramente numerico: i vettori [1, 0] e [0.6, 0.8], scritti con la notazione decimale di Python, danno 1 × 0,6 + 0 × 0,8 = 0,6. Moltiplichiamo tra loro le prime componenti, poi le seconde, e sommiamo i risultati.
Il contratto del codice indica che l'encoder fornisce vettori normalizzati. Quando la loro norma vale 1, questo prodotto scalare corrisponde alla similarità coseno, che ne confronta la direzione. Questa normalizzazione appartiene alla preparazione degli input: la funzione check() non la calcola né la verifica da sola.
Un MaxSim calcolabile a mano
Prendiamo un esempio didattico inventato, con due vettori di query e tre vettori di pagina. Ecco i prodotti scalari ottenuti; non sono misure del corpus Lumen.
| Vettore della query | Pagina: vettore 0 | Pagina: vettore 1 | Pagina: vettore 2 |
|---|---|---|---|
| Query: vettore 0 | 0,8 | 0,1 | 0,2 |
| Query: vettore 1 | 0,1 | 0,9 | 0,2 |
Per la prima riga, il massimo è 0,8, trovato nel vettore 0 della pagina. Per la seconda è 0,9, trovato nel vettore 1. Il punteggio MaxSim è quindi 0,8 + 0,9 = 1,7.
Non abbiamo preso né il massimo unico della tabella, che varrebbe 0,9, né la somma di tutte le celle. La regola è: cercare un massimo per riga della query, poi sommare questi massimi. Al risultato partecipano soltanto le posizioni dichiarate valide.
Questo punteggio di 1,7 non è una probabilità. Può superare 1, perché somma più contributi. Anche il numero di vettori della query influenza questa somma: non trasformate una soglia scelta su una domanda in una garanzia universale di pertinenza per tutte le altre.
Il padding: posizioni aggiunte, non contenuto
Per elaborare insieme più sequenze di lunghezze diverse, si possono completare le più corte con posizioni artificiali: è il padding, o riempimento. La maschera è un elenco di booleani della stessa lunghezza della sequenza. True significa «usare questa posizione» e False «escluderla».
Perché non lasciare semplicemente degli zeri? Prendiamo un altro esempio numerico: i due vettori reali di una pagina danno similarità di −0,6 e −0,8 con un vettore della query. Un vettore nullo aggiunto per il riempimento dà 0. Senza maschera, zero vince il massimo, pur non corrispondendo a nessuna informazione reale.
Il programma sostituisce quindi le similarità delle posizioni documentali non valide con meno infinito, scritto -torch.inf. Il massimo torna a −0,6, il migliore dei due risultati autorizzati. La maschera della query interviene poi per escludere dalla somma le proprie posizioni artificiali.
L'implementazione del progetto
Il blocco seguente contiene il controllo degli input, tre modi di calcolare lo stesso punteggio e una funzione di ispezione. Conserviamo il codice del percorso r001.
"""Exact masked MaxSim; inputs are normalized by the pretrained encoder."""

import torch


def check(query, document, query_mask, document_mask):
    if query.ndim != 2 or document.ndim != 2 or query.shape[1] != document.shape[1]:
        raise ValueError("Expected [Lq,D] and [Ld,D] with the same D")
    if query_mask.shape != query.shape[:1] or document_mask.shape != document.shape[:1]:
        raise ValueError("Mask length does not match embeddings")
    if query_mask.dtype != torch.bool or document_mask.dtype != torch.bool:
        raise ValueError("Masks must be boolean")
    if not query_mask.any() or not document_mask.any():
        raise ValueError("Empty valid query or document sequence")
    if not torch.isfinite(query).all() or not torch.isfinite(document).all():
        raise ValueError("Non-finite embeddings")


def maxsim_dense(query, document, query_mask, document_mask):
    check(query, document, query_mask, document_mask)
    similarities = query.float() @ document.float().T
    similarities = similarities.masked_fill(~document_mask[None, :], -torch.inf)
    best = similarities.max(dim=1).values
    return best[query_mask].sum()


def maxsim_scalar(query, document, query_mask, document_mask):
    check(query, document, query_mask, document_mask)
    return sum(
        max(
            float(torch.dot(query[i].float(), document[j].float()))
            for j in range(len(document))
            if document_mask[j]
        )
        for i in range(len(query))
        if query_mask[i]
    )


def maxsim_blocked(query, document, query_mask, document_mask, block_size=128):
    check(query, document, query_mask, document_mask)
    if not isinstance(block_size, int) or block_size <= 0:
        raise ValueError("Positive integer vector block size required")
    best = torch.full((len(query),), -torch.inf, device=query.device)
    for start in range(0, len(document), block_size):
        scores = query.float() @ document[start : start + block_size].float().T
        scores = scores.masked_fill(
            ~document_mask[None, start : start + block_size], -torch.inf
        )
        best = torch.maximum(best, scores.max(dim=1).values)
    return best[query_mask].sum()


def contributions(query, document, query_mask, document_mask):
    check(query, document, query_mask, document_mask)
    matrix = query.float() @ document.float().T
    values, positions = matrix.masked_fill(~document_mask[None, :], -torch.inf).max(
        dim=1
    )
    return [
        {
            "query_vector": i,
            "document_vector": int(positions[i]),
            "similarity": float(values[i]),
        }
        for i in range(len(query))
        if query_mask[i]
    ]
Leggere le funzioni passo dopo passo
check() verifica il contratto di input. Le tabelle devono avere due dimensioni e vettori della stessa dimensione. Ogni maschera deve corrispondere alla lunghezza della sua sequenza ed essere di tipo booleano. Serve almeno una posizione valida da entrambi i lati. Infine, le tabelle non devono contenere né NaN, che indica un valore numerico indefinito, né infinito. Quest'ultimo controllo riguarda tutti i loro valori, comprese le posizioni mascherate.
Questi rifiuti evitano di restituire un punteggio che sembra utilizzabile nonostante input incoerenti. Non verificano però che la rappresentazione abbia catturato la giusta informazione visiva.
maxsim_dense() costruisce tutte le somiglianze in una volta. .float() converte le tabelle in numeri in virgola mobile a 32 bit. .T traspone la tabella della pagina: le sue righe diventano colonne. L'operatore @ esegue quindi una moltiplicazione matriciale, descritta nella documentazione PyTorch. Il risultato ha Lq righe e Ld colonne, come la nostra piccola tabella di esempio.
document_mask[None, :] dà alla maschera una riga, applicabile a tutte le righe della tabella. Il segno ~ ne inverte i booleani: le posizioni non valide diventano quelle da sostituire con meno infinito. max(dim=1) cerca poi il massimo sulle colonne di ogni riga. Infine, best[query_mask].sum() conserva le righe di query autorizzate e somma i loro migliori punteggi.
maxsim_scalar() sviluppa la stessa regola con dei cicli. Per ogni posizione valida della query calcola i prodotti scalari con le posizioni documentali valide, prende il massimo, poi somma. È un riferimento facile da rileggere per comprendere il calcolo, non una strategia pensata per sfruttare in modo efficiente il parallelismo della GPU. Questa versione restituisce un numero Python, mentre quelle vettorizzate restituiscono un tensore scalare.
maxsim_blocked() evita di costruire l'intera tabella in una volta. Visita i vettori della pagina a blocchi, di 128 posizioni per impostazione predefinita. La tabella best conserva un miglior punteggio per ogni posizione della query. A ogni blocco, torch.maximum confronta questo miglior punteggio con i nuovi massimi e conserva il più grande, posizione per posizione. La somma arriva solo dopo aver percorso tutti i blocchi.
Questo è il punto da ricordare: si conserva il massimo globale di ogni vettore della query, non un punteggio indipendente da sommare per ogni blocco. Altrimenti il risultato cambierebbe soltanto perché la pagina è stata suddivisa in modo diverso.
Ciò che i blocchi risparmiano davvero
La versione densa materializza Lq × Ld similarità. Con blocchi di dimensione B, la tabella temporanea ne contiene solo circa Lq × B alla volta, oltre ai massimi conservati. Il numero di confronti resta dello stesso ordine: calcoliamo lo stesso punteggio in modo diverso, non saltiamo una parte della pagina.
Prendiamo un dimensionamento illustrativo, senza legame con una misura di memoria del percorso: 32 vettori di query e 1 024 vettori di pagina danno 32 768 similarità. A 32 bit, la loro tabella occupa 128 KiB. Con blocchi di 128, la tabella delle similarità di un blocco contiene 4 096 valori, cioè 16 KiB.
Questa riduzione riguarda la tabella temporanea dei punteggi. Non comprime l'indice registrato, non cancella i vettori di input e non riduce i pesi del modello. Anche le conversioni numeriche e gli altri calcoli consumano memoria. Un indice troppo voluminoso su disco e un calcolo temporaneo troppo voluminoso su GPU sono due problemi diversi.
Le versioni densa e a blocchi calcolano lo stesso MaxSim matematico; i test del progetto verificano questa parità. Inoltre, la documentazione PyTorch sulla precisione numerica ricorda che un'equivalenza matematica non garantisce un'identità bit per bit dopo ogni cambiamento di hardware o di calcolo in virgola mobile. Conservate i controlli del progetto quando adattate l'implementazione.
Leggere un contributo concreto
contributions() riprende la matrice delle similarità, ma conserva la posizione vincente oltre al suo valore. Nel nostro esempio didattico, il vettore 0 della query sceglie il vettore 0 della pagina con 0,8; il vettore 1 sceglie il vettore 1 con 0,9.
Negli oggetti restituiti, query_vector è l'indice nella query, document_vector l'indice nella sequenza della pagina e similarity il valore selezionato. Sommando questi valori si ritrova il punteggio dell'esempio. Questi oggetti permettono dunque di collegare il totale ai suoi contributi.
Un indizio non è tuttavia né una parola tradotta né un riquadro di rilevamento. Per riportarlo sull'immagine, occorre conservare la corrispondenza con la preparazione di quell'immagine. Anche quando una visualizzazione mostra una zona vicina alla pompa, non costituisce una prova che il modello abbia interpretato correttamente l'intera relazione spaziale.
Se un risultato inatteso sembra dipendere dallo sfondo della pagina, ispezionate il rendering, le maschere e la domanda. Non modificate prima i dati o una soglia per rendere il ranking più convincente. Il ruolo dei contributi è rendere il calcolo ispezionabile, non rivestire ogni risultato di una spiegazione necessariamente corretta.
Prerequisiti e ambiente
Dovete saper leggere Python, manipolare elenchi e tabelle e usare Docker da un terminale. Per seguire questo percorso non è necessario saper addestrare una rete: usiamo un encoder preaddestrato, senza modificarne i pesi.
Il riferimento usa Linux, Docker Engine, Compose, un driver NVIDIA e NVIDIA Container Toolkit, con una RTX 3090 da 24 GiB. Non è validato alcun profilo CPU. I 32 GiB di RAM e 40 GiB di disco indicati sono stime di preparazione, non minimi misurati per tutte le macchine. La RAM è la memoria del computer; i 24 GiB della scheda corrispondono alla sua memoria video, o VRAM.
NVIDIA Container Toolkit collega Docker alle periferiche e alle librerie del driver NVIDIA dell'host. Una GPU visibile in Linux non è quindi necessariamente utilizzabile dal programma containerizzato. Consultate la sua documentazione di installazione per l'integrazione adatta al vostro sistema. Il controllo del progetto esegue poi il modello in Docker; nvidia-smi sull'host non sostituisce questa verifica.
Decomprimete lo ZIP e posizionatevi nella sua cartella radice. Tutti i comandi seguenti partono da questa directory. L'acquisizione è l'unico servizio del percorso che dispone della rete; verifica la revisione, la dimensione e l'impronta SHA-256 dei pesi. Un'impronta permette di controllare l'identità del contenuto scaricato. Conservate le dipendenze e i file bloccati dello ZIP invece di sostituirli con un'installazione trovata in un esempio più recente.
Passo 1 — verificare il runtime
Il runtime è qui l'ambiente in cui il programma viene eseguito. Prepariamo le cartelle, convalidiamo Compose, costruiamo i servizi, quindi acquisiamo il modello e avviamo i controlli.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Ogni comando deve terminare con un codice di uscita zero, che indica un'esecuzione riuscita. I test coprono le maschere, MaxSim, la compatibilità dell'indice e le coordinate PDF. Controllano il funzionamento del programma; non significano che tutti i suoi ranking saranno pertinenti.
Passo 2 — preparare e indicizzare
Ora possiamo produrre le pagine Lumen e le loro rappresentazioni, ispezionare un punteggio, poi calcolare il riferimento testuale.
docker compose run --rm tutorial python -m pdfmaxsim.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m pdfmaxsim.cli index --config configs/minimum.yaml
docker compose run --rm inference python -m pdfmaxsim.cli explain-score --config configs/minimum.yaml
docker compose run --rm inference python -m pdfmaxsim.cli baseline --config configs/minimum.yaml
prepare renderizza le pagine. Dovete ritrovare le 96 immagini del catalogo. Verificate visivamente il testo e gli schemi: un'immagine tagliata o illeggibile è già un input sbagliato, prima di qualunque calcolo di embedding.
index registra i multivettori e le loro maschere. Le immagini vengono così trasformate in dati riutilizzabili durante le ricerche. Il collegamento con pagina e manuale deve restare disponibile: ritrovare un vettore senza poter aprire la sua fonte non sarebbe sufficiente.
explain-score espone i contributi. Ritrovate la query del filo conduttore e avvicinate il punteggio ai suoi migliori vicini. Non sostituite questa ispezione con l'intuizione «la prima pagina sembra buona».
baseline calcola il riferimento BM25. Una baseline è un metodo di confronto. BM25 classifica il testo considerando in particolare i termini presenti, la loro frequenza, la loro rarità nella raccolta e la lunghezza dei documenti. Il capitolo dedicato a BM25 nel manuale di Stanford descrive questi meccanismi.
Qui BM25 usa il testo disponibile: non riceve i pixel dello schema per interpretarne la disposizione. Può comunque ritrovare una buona pagina grazie alle sue etichette. Questo è proprio l'interesse del confronto: verificare ciò che la ricerca visiva apporta oltre a questi indizi testuali, senza supporre che vinca ovunque.
Passo 3 — misurare e sperimentare
La valutazione può allora confrontare i ranking con le pagine attese, in un servizio distinto da quello che produce le rappresentazioni e le ricerche.
docker compose run --rm tutorial python -m pdfmaxsim.cli evaluate --config configs/minimum.yaml
Leggeremo le sue misure nella sezione seguente. Non cambiate le impostazioni dopo aver guardato i risultati del test per conservare soltanto la variante migliore.
Cosa permette di verificare ogni output
Dopo index, ispezionate dimensioni, maschere e impronta dell'encoder nei file di output. Dopo explain-score, tornate alla pagina del filo conduttore e ai suoi contributi. I controlli di parità devono ritrovare lo stesso calcolo con le versioni densa e a blocchi.
Il catalogo di 96 pagine è comune; sono le query a essere separate. Il percorso comprende 48 query di sviluppo e 144 query di test. Non addestra il modello su un primo gruppo di pagine per testarlo poi su un altro.
Il set di sviluppo serve a prendere una decisione progettuale. Il set di test serve a misurare la decisione una volta fissata. Anche senza addestramento, scegliere un'impostazione perché riesce meglio sul test farebbe perdere a quest'ultimo il suo ruolo di misura finale indipendente dalla scelta.
I due budget di risoluzione sono fissati in anticipo: 200704 e 401408. Influenzano la dimensione delle rappresentazioni e il costo della ricerca. Usate le configurazioni fornite per riprodurli. Il secondo budget è il doppio del primo; ciò non consente di dedurre che la dimensione reale dell'indice o il tempo di esecuzione saranno esattamente raddoppiati. Questi effetti si misurano negli output del percorso.
Il confronto con la media dei vettori serve invece a esaminare cosa cambia conservando rappresentazioni multiple. I suoi output vanno letti insieme a quelli dei budget: non deducete un risultato numerico dalla sola intuizione che una media perda dettaglio.
Leggere le metriche prima dei numeri
Una metrica è una misura scelta per valutare un comportamento. Per il nostro motore, la domanda non è «il punteggio MaxSim è alto?», bensì «le pagine attese sono ben posizionate?». Distingueremo la quantità di pagine pertinenti ritrovate dalla posizione della prima.
Recall@k: quale quota delle pagine giuste ritroviamo?
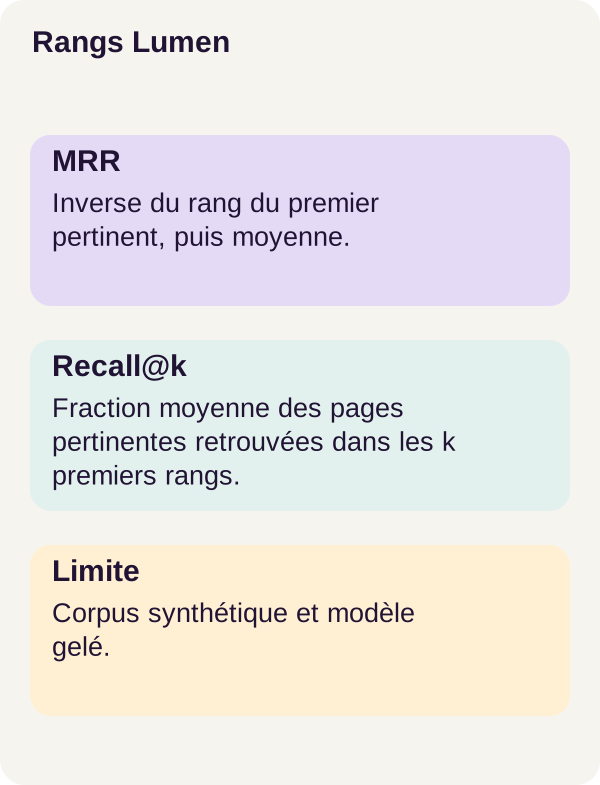
Il Recall@k, o richiamo nelle prime k posizioni, misura per ogni query la frazione delle sue pagine pertinenti presente in quelle posizioni. Si fa poi la media di queste frazioni sulle query valutate.
Prendiamo un ranking fittizio. Tre pagine sono pertinenti, chiamate A, B e C. Il motore restituisce A, X, B, C, Y, dove X e Y non sono pertinenti.
Alla posizione 1 abbiamo ritrovato A, cioè una pagina pertinente su tre: Recall@1 = 1/3. Nei primi tre risultati sono presenti A e B: Recall@3 = 2/3. Nei primi cinque sono presenti A, B e C: Recall@5 = 1.
La prima pagina era già corretta! Per questo Recall@1 non è qui la percentuale di query il cui primo risultato è pertinente. Una domanda può avere più pagine giuste; mostrarne una sola non permette di ritrovarle tutte.
MRR: dove compare la prima pagina pertinente?
Il MRR, per Mean Reciprocal Rank, fa la media dell'inverso della posizione della prima pagina pertinente. Alla posizione 1 il contributo vale 1/1 = 1; alla posizione 2, 1/2 = 0,5; alla posizione 4, 1/4 = 0,25.
Nel nostro ranking fittizio A, X, B, C, Y, questo contributo vale 1. Con X, A, B, C, Y, vale 0,5. Se questi ranking corrispondessero a due query, il loro MRR sarebbe (1 + 0,5) / 2 = 0,75.
Il MRR non dice quante altre pagine giuste seguono la prima. Il richiamo e l'MRR osservano dunque due proprietà diverse: ritrovare le pagine attese e far comparire rapidamente una prima pagina pertinente. Nessuno dei due verifica il contenuto di un'eventuale risposta redatta.
I risultati osservati su Lumen
Le misure seguenti riguardano le 144 query di test, sul catalogo sintetico inglese di 96 pagine. Riprendono i valori del percorso r001.
| Misura | MaxSim ad alta risoluzione | BM25 |
|---|---|---|
| MRR | 0,9549 | 0,9410 |
| Recall@1 | 0,5903 | 0,5972 |
| Recall@5 | 1,0000 | Non indicato qui |
| Recall@10 | 1,0000 | Non indicato qui |
«Non indicato qui» significa che questo valore non è fornito nei risultati numerici riportati nell'articolo; non significa né zero né un fallimento del metodo.
L'MRR di MaxSim è migliore, ma il suo Recall@1 non lo è. Il ranking è quindi più favorevole secondo la media degli inversi di posizione, senza migliorare la frazione media delle pagine pertinenti ritrovate al primo posto. Non possiamo dedurne una superiorità per ogni query.
BM25 resta un concorrente serio su questo corpus: alcune etichette testuali possono già bastare per ritrovare una pagina. I richiami a 5 e a 10 di MaxSim sono riportati a 1,0000, ma non dimostrano né una comprensione perfetta degli schemi né la stessa qualità su PDF reali, altre lingue o una raccolta molto più grande.
Quando nessuna pagina è pertinente
Il percorso comprende anche 12 query fuori corpus. Per queste, nessuna pagina della raccolta costituisce una risposta pertinente. Sono escluse dalle metriche di pertinenza presentate sopra e vanno esaminate a parte.
Il motore produce comunque un ranking: trova la pagina più vicina tra quelle che possiede. Ciò non significa che abbia trovato una buona pagina. La migliore candidata di una lista sbagliata resta una candidata sbagliata.
In questo percorso non esiste una politica di rifiuto calibrata. In altre parole, il progetto non fornisce una regola validata per decidere «nessuna pagina risponde a questa richiesta». Un punteggio MaxSim non deve essere letto come una probabilità di risposta corretta. Per aggiungere un rifiuto automatico, bisognerebbe progettare e poi misurare questo comportamento su richieste con e senza risultato pertinente.
Cosa abbiamo imparato
Abbiamo conservato più rappresentazioni per pagina, invece di ricondurre tutto a un solo vettore. L'interazione tardiva separa la preparazione dell'indice dalla codifica delle nuove domande. MaxSim cerca, per ogni vettore valido della query, il suo miglior vicino nella pagina, poi somma questi contributi.
Le maschere fanno parte del calcolo: impediscono al riempimento di partecipare al ranking. L'elaborazione a blocchi conserva gli stessi massimi globali limitando la dimensione della tabella temporanea; non comprime l'indice.
Infine, un ranking pertinente non è né una risposta né una prova di localizzazione fedele. I contributi aiutano a ispezionare il punteggio. Il richiamo e l'MRR valutano il ranking. Le richieste fuori corpus pongono ancora un altro problema, che il percorso non risolve con una soglia di rifiuto.
Esercizio — conservare i massimi giusti
Prima di eseguire i comandi, prendiamo un ulteriore esempio numerico, scelto per il calcolo a mano. Un solo vettore della query confronta le sue similarità con due blocchi della pagina. Nel primo blocco i valori sono −0,8 e −0,6. Nel secondo sono −0,4 e −0,2. Tutte le posizioni sono valide.
Quale punteggio deve restare alla fine? Cosa accadrebbe se sommassimo il miglior risultato di ogni blocco? E se best iniziasse da zero invece che da meno infinito? Scrivete le tre risposte prima di proseguire.
Formulate anche un'ipotesi per il confronto dei budget di risoluzione: cosa possono diventare la dimensione dell'indice, il tempo di ricerca e il richiamo quando il budget aumenta? Il richiamo deve necessariamente migliorare per ogni domanda? Distinguete un'aspettativa ragionevole da un risultato già misurato.
Eseguite poi l'esercizio fornito. Conserva l'algoritmo del progetto; vi fa confrontare le vostre previsioni con gli output invece di modificare discretamente il calcolo.
docker compose run --rm inference python -m pdfmaxsim.cli exercise-index --config configs/exercise.yaml
docker compose run --rm inference python -m pdfmaxsim.cli exercise-search --config configs/exercise.yaml
docker compose run --rm tutorial python -m pdfmaxsim.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Correzione del piccolo calcolo. Il primo blocco fornisce −0,6; il secondo fornisce −0,2. Il massimo globale è −0,2. Sommare i massimi locali darebbe −0,8, contando due contributi per un solo vettore della query. Inizializzare a zero darebbe 0, un valore che nessun confronto reale ha prodotto.
Questi numeri illustrano il meccanismo; non sono presentati come l'output di un file del progetto. La regola da ritrovare in maxsim_blocked() è: confrontare i massimi, poi sommare una sola volta alla fine.
Per l'esperimento di risoluzione, consultate viewer.html, i PNG e i contributi. Confrontate le misure di dimensione, tempo e richiamo con le vostre ipotesi. Una risoluzione più alta può conservare più dettagli, ma non prova che il modello li userà meglio per tutte le domande. Non attribuite un guadagno alla visione sulla sola base di una miniatura più nitida.
Risolvere i problemi senza falsare l'esperimento
L'acquisizione fallisce? Rileggete la revisione attesa, la dimensione dei file e il loro SHA-256 prima di rilanciare. Non copiate in assets/ pesi trovati altrove: il modello caricato non sarebbe più necessariamente quello del percorso.
CUDA fallisce in Docker? Verificate il runtime, il driver e NVIDIA Container Toolkit. La diagnosi riguarda anzitutto l'accesso effettivo alla GPU; modificare una metrica o una maschera non corregge questo problema di ambiente.
L'indice è incompatibile? Ricostruitelo con lo stesso encoder, la stessa configurazione di risoluzione e la stessa convenzione di maschera usati per la ricerca. Vettori della stessa dimensione non sono necessariamente confrontabili se provengono da due versioni diverse. Conservate insieme la rappresentazione e la configurazione che le dà significato.
Il calcolo esaurisce la memoria? La ricerca a blocchi può ridurre la tabella temporanea delle similarità. Se però il problema è la dimensione dell'indice stesso, suddividere il calcolo non lo rende più piccolo. Ridurre il budget di rappresentazione richiede di ricostruire i dati interessati, poi misurare di nuovo dimensione, latenza e richiamo. Tenete questi tentativi separati dai risultati di riferimento.
Il ranking sembra assurdo? Cominciate aprendo la pagina renderizzata, poi verificate le maschere, i contributi e la formulazione della query. Non sostituite mai le osservazioni con le label attese per rendere l'output più soddisfacente.
Produzione e pulizia
Il tutorial tratta una piccola raccolta controllata. Per trasformarla in un servizio documentale restano da gestire diritti di accesso, aggiornamenti, cancellazione dei dati indicizzati, qualità dei rendering, lingue, latenza e query senza risposta. Sono lavori di integrazione da pianificare, non funzionalità dimostrate dai punteggi Lumen.
Conservate provenienza e versioni. Ogni risultato deve restare collegato al suo PDF, alla sua pagina e all'encoder usato. I contributi e i parametri di indicizzazione permettono di risalire da un ranking al suo calcolo. Versionate gli indici invece di mescolare silenziosamente rappresentazioni incompatibili.
Applicate i diritti ai risultati come alle loro anteprime. Una pagina vietata non deve diventare consultabile tramite miniatura, cache o output diagnostico. La cancellazione di un documento deve considerare anche vettori, anteprime e cache.
Valutate richieste rappresentative degli utenti. Il corpus sintetico inglese non convalida la robustezza agli errori, ad altre lingue o alla varietà dei vostri documenti reali. Le 12 query fuori corpus mostrano un ranking forzato; non convalidano un meccanismo di astensione. Costruite casi con e senza pagina pertinente, poi esaminate gli errori una query alla volta, oltre alle medie.
Un'eventuale generazione di risposta deve consultare e citare fonti effettivamente ritrovate. Non deve inventare un testo a partire dalla sola posizione di una pagina. Il nostro programma si ferma a un risultato di ricerca ispezionabile.
Pulire soltanto gli output previsti
Conservate indici, anteprime, figure e misure che desiderate studiare prima della pulizia. I comandi seguenti fermano il progetto, avviano la pulizia mirata, quindi fermano di nuovo il progetto.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Lo script elimina soltanto outputs/. Conserva assets/ e data/generated/. Non confondete questa pulizia dei risultati con l'eliminazione di tutti i file del modello e del corpus.
Riferimenti per approfondire
La documentazione ufficiale di ColQwen descrive il modello e le sue rappresentazioni. Il repository ColBERT spiega l'interazione tardiva; il capitolo BM25 del manuale di Stanford approfondisce il riferimento testuale.
Per rileggere le operazioni del codice, consultate la moltiplicazione matriciale, il riempimento tramite maschera e i limiti della precisione numerica in PyTorch. La documentazione di NVIDIA Container Toolkit tratta l'accesso alla GPU da Docker.
Questi riferimenti completano le spiegazioni; non sostituiscono le versioni, le configurazioni e i comandi dello ZIP r001. I piccoli calcoli dell'articolo sono esempi didattici distinti dalle misure ottenute su Lumen.