





Imaginez un écran de back-office où arrivent des notes de visite à ranger dans des dossiers. La note O-035 mentionne l’équipement BX-07 et le site Cèdre, mais aucun numéro de dossier. Quatre dossiers sont proposés à l’application. Lequel suggérer à la personne chargée du classement ? Et surtout : quand vaut-il mieux ne rien proposer ?
Si vous développez des applications web, vous avez peut-être déjà résolu une partie de ce problème avec des recherches textuelles et des jointures. Mais deux dossiers peuvent avoir une formulation identique, et une relation connue avec un équipement ne fournit pas forcément une correspondance certaine.
Nous allons donc comparer plusieurs approches : le texte seul, un réseau de neurones sans relations, puis un réseau qui exploite un graphe, c’est-à-dire des objets reliés entre eux. Nous suivrons le chemin texte et relations disponibles → représentations numériques → scores des quatre candidats → proposition ou abstention.
L’objectif est de comprendre ce que le contexte apporte réellement, sans lui donner discrètement la réponse à retrouver. Un modèle qui voit encore le lien document–dossier caché dans ses entrées ne résout pas le problème : il relit la solution.
Ce tutoriel produit une proposition de rattachement, jamais un rattachement administratif. Les données sont synthétiques. Les résultats décrivent le protocole r001, pas une validation sur les documents d’une entreprise.
Télécharger le projet complet, révision r001
Partir de ce qui est réellement disponible
Un graphe n’est pas forcément une nouvelle base de données
Une GED, ou gestion électronique des documents, organise des pièces, leurs métadonnées et leurs liens. Dans notre exemple, une pièce est une note de visite ; un dossier regroupe des informations relatives à une affaire ou à une intervention.
Pour représenter ce petit monde, chaque objet devient un nœud : une pièce, un équipement, un site ou un dossier. Une arête est une relation orientée entre deux nœuds. Son type indique ce que cette relation signifie.
Nous savons par exemple que O-035 — concerne → BX-07 et que BX-07 — situé à → Cèdre. En termes de base relationnelle, cela ressemble à des associations entre enregistrements, avec un sens et une nature précis. Utiliser un graphe dans le calcul ne signifie pas que l’extrait Python installe ou nécessite une base de données graphe : il manipule ici des tableaux de nœuds et de relations.
Le lien que nous cherchons à proposer est différent : à quel dossier la pièce O-035 devrait-elle être rattachée ? Il ne doit pas déjà être présent parmi les entrées utilisées pour répondre.
Le texte et les relations observées sont fournis au programme. Le tutoriel ne démontre pas une extraction automatique de ces relations à partir d’un PDF ou d’une note libre.
Classer quatre candidats, puis décider de répondre
Les quatre dossiers candidats sont eux aussi fournis en entrée. Le programme ne les sélectionne pas après avoir consulté le dossier attendu. C’est une distinction importante : retrouver la bonne réponse parmi quatre candidats déjà connus n’est pas rechercher librement dans toute une GED.
Le calcul produit quatre scores. Le dossier le mieux classé devient une proposition seulement si son score passe le seuil prévu ; sinon, le programme s’abstient.
Prenons un exemple fictif de scores, uniquement pour comprendre cette règle : 0,64 ; 0,62 ; 0,21 ; 0,08. Avec un seuil de 0,60, le premier dossier est proposé. Pourtant, son score est proche de celui du deuxième. La règle décrite ici examine le meilleur score, pas l’écart entre les deux premiers. Elle ne détecte donc pas toute forme d’ambiguïté par construction.
Ces quatre valeurs ne sont pas nécessairement des probabilités qui s’additionnent pour faire 1. Un score de 0,64 ne veut pas dire « 64 % de chances que ce rattachement soit administrativement correct ». Nous reviendrons sur la différence entre score et probabilité calibrée.
Une relation absente n’est pas automatiquement fausse
Dans une GED réelle, un lien manquant peut vouloir dire « pas encore renseigné ». Il ne signifie pas forcément « cette pièce n’appartient pas à ce dossier ».
Le corpus synthétique donne ici un avantage expérimental : son générateur connaît les pièces pour lesquelles aucun des quatre candidats n’est correct. Ces cas sont dits hors périmètre. Ils permettent de vérifier si le programme sait rejeter une demande sans bonne réponse dans la liste proposée.
La portée du rejet reste donc locale : « aucun bon candidat parmi ces quatre dossiers » ne signifie pas « aucun bon dossier n’existe dans l’entreprise ».
Séparer des îlots entiers, pas seulement des lignes de données
Le corpus comporte 80 îlots indépendants. Un îlot est un petit groupe de nœuds et de relations qui ne partage pas son contexte avec les autres. Le découpage conserve 56 îlots pour l’entraînement, 12 pour la validation et 12 pour le test.
L’entraînement ajuste les paramètres du réseau. La validation sert notamment à choisir les seuils. Le test mesure ensuite le comportement de la règle retenue, sans la modifier après observation.
Les partitions ne partagent ni nœud, ni arête, ni équipement, ni site. En revanche, des mots, des types de documents et des fragments de phrases peuvent rester communs. Nous testons donc de nouveaux identifiants et de nouveaux contextes de graphe, pas nécessairement un vocabulaire entièrement nouveau.
Chaque îlot contient quatre dossiers. Pour chacun, six liens avec des pièces restent visibles comme contexte et six autres sont définitivement masqués. Quatre pièces supplémentaires n’ont aucun bon dossier candidat. Le détail des pièces s’écrit ainsi :
| Pièces d’un îlot | Calcul à partir du protocole | Nombre |
|---|---|---|
| Pièces dont le rattachement est visible | 4 dossiers × 6 pièces | 24 |
| Pièces dont le rattachement est caché | 4 dossiers × 6 pièces | 24 |
| Pièces sans bon candidat | Ajoutées par le générateur | 4 |
| Total des pièces | 24 + 24 + 4 | 52 |
Point de vigilance sur le décompte r001. La description d’origine indique « 80 îlots indépendants de 52 nœuds », tout en annonçant 5 600 nœuds dont 4 160 pièces. Ces formulations ne concordent pas : 80 × 52 = 4 160, pas 5 600. Le détail ci-dessus permet de retrouver 52 pièces par îlot, soit 4 160 pièces. Le total annoncé de 5 600 nœuds est conservé, mais la formulation « 52 nœuds par îlot » doit être vérifiée dans le corpus généré. Ce calcul ne constitue pas un nouveau comptage des fichiers du projet.
Pour la validation comme pour le test, les cibles sont les 24 pièces à lien caché et les quatre pièces hors périmètre de chacun des 12 îlots. Cela donne 12 × 24 = 288 cas rattachables et 12 × 4 = 48 cas hors périmètre, soit 336 cibles par partition. Les 24 pièces à lien visible de chaque îlot restent du contexte : elles ne deviennent pas des réponses à noter.
Cacher la réponse dans les deux sens
Supposons que le rattachement connu soit représenté à la fois par pièce → dossier et par sa relation inverse dossier → pièce. Retirer uniquement la première arête laisserait la même information disponible dans l’autre sens.
Le parcours enlève donc les deux orientations de chaque lien caché avant l’inférence. L’inférence est simplement l’utilisation du modèle pour calculer une prédiction, après l’apprentissage.
Il faut aussi recalculer les degrés, c’est-à-dire les nombres de relations utilisées pour normaliser les messages. Garder un ancien compteur conserverait une trace du graphe non masqué, même après le retrait des arêtes. Les voisinages et les degrés doivent tous deux provenir du graphe réellement autorisé.
Cette précaution ne supprime pas les indices légitimes : les équipements et sites restent disponibles selon le protocole. Elle évite que la relation cible soit encore fournie, directement ou à travers un calcul réalisé avant son retrait.
Transformer le texte en vecteurs avec E5
Le modèle multilingual-e5-small, au commit 614241f622f53c4eeff9890bdc4f31cfecc418b3, transforme les textes en embeddings. Un embedding est une liste de nombres qui représente le texte pour les calculs de similarité. Ici, chaque liste comporte 384 valeurs float32, des nombres à virgule flottante stockés sur 32 bits.
Ces 384 positions ne sont pas 384 champs métier que nous aurions nommés « site », « équipement », etc. Ce sont des caractéristiques apprises par l’encodeur. L’encodeur produit une représentation numérique ; il ne rédige pas une réponse conversationnelle.
Les vecteurs sont normalisés en L2 : on divise chaque vecteur par sa longueur. Pour un exemple pédagogique à deux dimensions, [3 ; 4] a une longueur de 5 et devient [0,6 ; 0,8]. Les textes sont ainsi comparés par la direction de leur représentation plutôt que par sa seule amplitude.
Tous reçoivent le préfixe littéral query: , y compris les textes des dossiers, pour cette représentation symétrique. La documentation E5 de la révision utilisée décrit ce choix pour les tâches symétriques et l’utilisation des embeddings comme caractéristiques.
Le parcours refuse une moyenne vide, non finie ou nulle, et échoue au-delà de 512 tokens. Un token est une unité de texte manipulée par le modèle, pas nécessairement un mot entier. Contrairement à un traitement qui couperait silencieusement la fin, cette limite devient une erreur explicite.
E5 reste gelé pendant l’apprentissage : ses paramètres ne sont pas modifiés. Nous apprenons les transformations qui utilisent ses vecteurs, pas un nouvel encodeur textuel. Les identifiants de dossiers ne deviennent jamais des embeddings appris individuellement ; les indices du graphe servent à retrouver des lignes de tableaux, pas à mémoriser un vecteur entraînable par dossier.
Faire circuler le bon contexte
Une couche de graphe : lire ses voisins sans oublier son propre texte
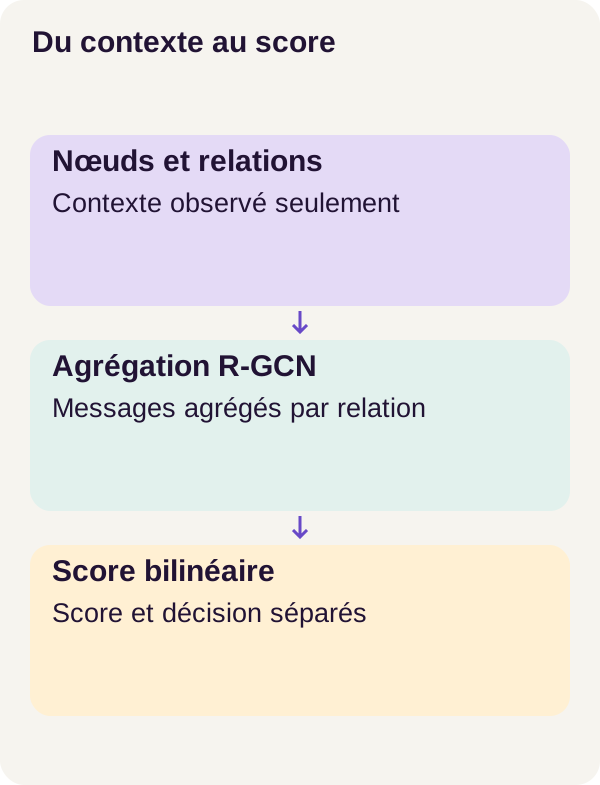
Un R-GCN, pour Relational Graph Convolutional Network, est un réseau de neurones qui combine les représentations des nœuds avec celles de leurs voisins, en distinguant les types de relations. L’article fondateur sur les R-GCN présente ce principe pour les graphes multirelationnels.
L’intuition est proche d’une jointure suivie d’un regroupement : pour un nœud destinataire, nous retrouvons ses voisins, regroupons leurs vecteurs par type de relation et calculons une moyenne. Une transformation apprise traite ensuite chaque moyenne.
Pourquoi garder les types ? Parce que « concerne un équipement » et « est situé sur un site » ne décrivent pas la même association. La variante typée peut apprendre des traitements différents. Cela lui donne une possibilité supplémentaire, pas la garantie de faire de meilleures propositions.
Pour chaque destination et chaque relation, la couche suit quatre opérations : elle additionne les vecteurs sources, divise cette somme par le nombre d’arêtes visibles correspondantes, applique la matrice de cette relation, puis ajoute le tout à une projection du nœud lui-même. Une activation ReLU termine le calcul : elle remplace les valeurs négatives par zéro.
On peut résumer la mécanique ainsi : nouvelle représentation = ReLU(texte du nœud transformé + contributions transformées des voisins).
Lire les dimensions avant les opérations
Un tenseur est ici un tableau de nombres. Avec N nœuds et E arêtes observées, la première couche manipule les dimensions suivantes :
| Objet du code | Forme et signification |
|---|---|
features |
N × 384 : un vecteur par nœud |
edges |
E × 3 : source, destination, type de relation |
relation_weights |
8 × 384 × 64 dans la première couche typée |
| Sortie de la couche | N × 64 : les mêmes nœuds, avec de nouveaux vecteurs |
Une matrice est un tableau à deux dimensions. Une projection linéaire combine les valeurs d’entrée avec des poids appris pour obtenir un vecteur de la taille voulue. Passer de 384 à 64 dimensions ne supprime pas des nœuds : cela change la longueur de la représentation de chacun.
Le projet empile deux couches : 384 → 64, puis 64 → 64. Après une couche, un nœud peut utiliser les informations de ses voisins directs ; après deux, il peut aussi recevoir des informations passées par un voisin intermédiaire, selon les orientations effectivement présentes. Cela ne revient pas à lire instantanément tous les chemins d’un grand graphe.
Le code exécuté : une moyenne par destination et par relation
Voici l’extrait du parcours r001. Lisez d’abord forward(), qui réalise le calcul ; nous reviendrons ensuite sur l’initialisation.
import torch
from torch import nn
import torch.nn.functional as F


class RelationalLayer(nn.Module):
    def __init__(self, inputs, outputs, relations, layer, seed=17):
        super().__init__()
        self.self_projection = nn.Linear(inputs, outputs, bias=False)
        self.relation_weights = nn.Parameter(torch.empty(relations, inputs, outputs))
        self.relations = relations
        nn.init.xavier_uniform_(
            self.self_projection.weight,
            generator=torch.Generator().manual_seed(seed + layer),
        )
        for r in range(relations):
            nn.init.xavier_uniform_(
                self.relation_weights[r],
                generator=torch.Generator().manual_seed(seed + 100 + layer * 20 + r),
            )

    def forward(self, features, edges):
        if edges.ndim != 2 or edges.shape[1] != 3 or edges.dtype != torch.long:
            raise ValueError("Edges are source,target,relation integer rows")
        if len(edges) and (
            (edges[:, :2] < 0).any()
            or (edges[:, :2] >= len(features)).any()
            or (edges[:, 2] < 0).any()
            or (edges[:, 2] >= self.relations).any()
        ):
            raise ValueError("Invalid observed edge")
        result = self.self_projection(features)
        for r in range(self.relations):
            selected = edges[edges[:, 2] == r]
            source = selected[:, 0]
            target = selected[:, 1]
            aggregate = torch.zeros_like(features)
            degree = torch.zeros(
                len(features), dtype=features.dtype, device=features.device
            )
            # Every degree and message uses only this currently observed relation.
            aggregate.index_add_(0, target, features[source])
            degree.index_add_(
                0,
                target,
                torch.ones(len(source), dtype=features.dtype, device=features.device),
            )
            aggregate = aggregate / degree.clamp_min(1)[:, None]
            result = result + aggregate @ self.relation_weights[r]
        return F.relu(result)
Le contrôle d’entrée exige un tableau d’arêtes à deux dimensions, avec trois colonnes et le type entier torch.long. Les indices de nœuds doivent correspondre à des lignes existantes de features, et les indices de relations doivent appartenir à l’intervalle prévu. Une arête vers un nœud inexistant est refusée avant de participer au calcul.
La projection propre commence avec self.self_projection(features). Chaque nœud conserve ainsi une contribution issue de ses propres caractéristiques, même s’il ne reçoit aucun message. L’option bias=False signifie que cette couche linéaire PyTorch n’ajoute pas de constante apprise à sa transformation.
Le filtrage par relation se fait avec edges[edges[:, 2] == r]. Pour le type courant, source donne les lignes à lire et target les lignes destinataires. Les autres relations ne sont pas mélangées à cette moyenne.
L’addition des messages utilise aggregate.index_add_(0, target, features[source]). Imaginez un GROUP BY destination qui additionnerait des vecteurs plutôt qu’une colonne de montants. Si plusieurs sources ont la même destination, leurs valeurs sont ajoutées dans la même ligne. Le suffixe _ indique ici que le tenseur d’accumulation est modifié sur place. La documentation de index_add_ précise cette opération.
Un second index_add_ additionne des 1 aux mêmes destinations. Il obtient les degrés pour cette relation et ce graphe observé, pas des degrés récupérés avant masquage.
La division transforme chaque somme en moyenne. degree.clamp_min(1) remplace les degrés nuls par 1 pour éviter une division par zéro. Cela ne crée pas un voisin fictif : une somme vide vaut toujours zéro, et 0 / 1 reste zéro. [:, None] met le degré sous forme de colonne pour diviser toutes les composantes d’un même nœud par le même nombre.
La transformation de relation intervient avec aggregate @ self.relation_weights[r]. Le symbole @ désigne le produit matriciel. La contribution transformée rejoint le résultat, puis F.relu(result) termine la couche.
La classe initialise ses matrices avec Xavier et des graines déterminées par seed, la couche et la relation. Une graine fixe le point de départ d’un générateur pseudo-aléatoire. Elle rend l’initialisation contrôlable ; elle ne remplace pas à elle seule tous les contrôles nécessaires à une reprise reproductible.
Un petit calcul pour vérifier ce que fait le masque
Prenons un exemple pédagogique à deux dimensions, indépendant des résultats du corpus. Deux voisins envoient [2 ; 4] et [6 ; 0] à la même destination, par la même relation.
La somme vaut [8 ; 4], le degré vaut 2 et la moyenne [4 ; 2]. Si la matrice de relation choisie pour cet exemple conserve la première composante et double la seconde, sa contribution devient [4 ; 4]. Avec une projection propre égale à [1 ; −1], la somme vaut [5 ; 3], inchangée par ReLU.
Retirons maintenant la deuxième arête. La bonne moyenne est [2 ; 4] / 1 = [2 ; 4]. Réutiliser l’ancien degré 2 donnerait [1 ; 2] : la représentation dépendrait encore du voisin retiré, par son ancien compteur.
Si nous retirons toutes les arêtes, la contribution des voisins devient nulle, mais pas nécessairement la sortie. La projection propre de cet exemple reste [1 ; −1], puis ReLU donne [1 ; 0].
Deux autres limites sont visibles dans l’extrait. Il ne connaît pas les annotations cachées : le retrait des liens cibles doit avoir eu lieu avant l’appel. Et il ne déduplique pas les arêtes : une même ligne répétée participe plusieurs fois à la somme et au degré. La validité des indices ne suffit donc pas à garantir la qualité du graphe fourni.
Passer des vecteurs aux scores, puis comparer les variantes
Après les deux couches, le programme compare la représentation de la pièce à celle de chaque dossier par un score bilinéaire. Le principe consiste à combiner deux vecteurs avec des poids appris pour produire un nombre de compatibilité. Le mot « bilinéaire » décrit le calcul ; il ne signifie pas que la relation métier a été prouvée. L’extrait ci-dessus montre la couche relationnelle, pas toute la tête de score ni toute la boucle d’apprentissage du ZIP.
Les scores neuronaux utilisés pour la décision passent par une sigmoïde, une fonction qui transforme un score brut en une valeur entre 0 et 1. Elle vaut 0,5 pour un score brut nul et augmente avec ce score. Sa définition dans PyTorch complète le mécanisme. Appliquer une sigmoïde n’établit pas que les valeurs obtenues sont des probabilités fiables de rattachement.
La comparaison distingue quatre approches. Le cosinus E5 compare directement les vecteurs textuels normalisés : c’est la référence texte seul, pas un simple moteur de mots-clés. mlp retire les arêtes et conserve un réseau qui transforme les caractéristiques des nœuds. untyped utilise les arêtes, mais rassemble tous leurs types en une seule relation. Enfin, typed applique huit transformations relationnelles distinctes.
Les variantes réutilisent les mêmes candidats, les mêmes vecteurs E5 et les mêmes masquages. Leurs nombres de paramètres ne sont pas strictement identiques. Nous comparons donc des choix sur un corpus précis, sans attribuer automatiquement toute différence au seul typage des relations.
Exécuter toutes les étapes, dans le bon ordre
Préparer l’environnement
Vous devez pouvoir lire du Python, utiliser un terminal et lancer Docker. Les opérations numériques nécessaires viennent d’être introduites : tableaux, moyennes, matrices et scores. Il n’est pas nécessaire d’avoir déjà développé un réseau de graphes.
Décompressez le ZIP dans un nouveau répertoire et ouvrez le terminal à sa racine. Toutes les commandes suivantes partent de ce dossier. Utilisez le profil GPU prévu par le projet. Avant le lancement, consultez son README pour les ressources requises et les conditions d’installation.
Le préflight contrôle Docker, Compose, le GPU, la mémoire et l’espace disponible. setup.sh prépare le projet ; Compose vérifie ensuite sa configuration et construit les services.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference calibration
Vérifiez les diagnostics avant de poursuivre. Une erreur d’environnement ne se résout pas en modifiant le modèle ou en changeant ses seuils.
Acquérir E5, puis vérifier un vrai calcul dans Docker
Le service acquisition télécharge neuf fichiers E5 verrouillés, contrôlés par taille et par empreinte SHA-256. Une empreinte permet de vérifier l’identité des fichiers acquis, pas leur qualité prédictive.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
check_environment.py exécute E5 dans Docker. Voir le GPU avec nvidia-smi sur l’hôte ne prouve pas que ce calcul conteneurisé fonctionne. pytest -q lance ensuite les tests du projet. Vérifiez leur réussite avant de poursuivre : un test du programme et une mesure de qualité des propositions ne contrôlent pas la même chose.
Les services de calcul ne téléchargent aucun pilote et n’exposent aucun port hôte. Le montage d’un environnement de calcul et l’exécution d’une API publique sont deux sujets différents.
Construire les données et observer les entrées
docker compose run --rm tutorial python -m ged_rattachement_graphe.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rattachement_graphe.cli encode --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rattachement_graphe.cli baseline --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rattachement_graphe.cli inspect-mechanism --config configs/minimum.yaml
prepare construit le corpus. C’est le moment de contrôler les îlots, les partitions et les comptes, notamment la distinction entre pièces et ensemble des nœuds. encode calcule les vecteurs E5. La référence baseline sert de point de comparaison textuel, puis inspect-mechanism permet d’examiner la mécanique avant l’apprentissage des variantes.
Pour une pièce comme O-035, posez-vous trois questions en inspectant les entrées : quels sont les quatre candidats ? Quelles relations sont visibles ? Le lien à prédire, son inverse ou un degré calculé avant son retrait subsistent-ils ? Un exemple inspecté apporte souvent plus qu’un score agrégé affiché trop tôt.
Apprendre les variantes et fixer la décision
sh scripts/train_variants.sh
docker compose run --rm calibration python -m ged_rattachement_graphe.cli calibrate --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_rattachement_graphe.cli evaluate --config configs/minimum.yaml
train_variants.sh lance typed, untyped et mlp. calibrate choisit les seuils sur la validation, puis evaluate mesure les résultats avec cette règle fixée.
À chaque époque, c’est-à-dire à chaque passage d’apprentissage sur les exemples prévus, trois des six liens visibles de chaque dossier d’entraînement sont temporairement masqués, avec leurs inverses. Le réseau doit apprendre sans disposer dans son contexte immédiat du lien ainsi retiré. Les liens définitivement cachés, eux, ne sont jamais réinsérés.
Distinguez bien ces deux mécanismes : un masquage temporaire crée une situation d’apprentissage à partir du contexte autorisé ; le masquage permanent maintient la séparation du protocole. Aucun des deux ne doit être annulé pour obtenir artificiellement une meilleure prédiction.
Le projet entraîne pendant trente époques, avec quatre îlots par batch. Un batch est le groupe d’exemples traité pour une étape d’apprentissage. L’optimiseur AdamW utilise un taux d’apprentissage de 0,003, un weight decay de 0,001 et un clipping de norme 1.
Un optimiseur ajuste les poids à partir des gradients, les variations de l’erreur par rapport à ces poids. Le taux d’apprentissage règle l’amplitude des mises à jour ; le weight decay réduit les poids selon la règle d’AdamW ; le clipping limite la norme des gradients trop grands. La documentation d’AdamW approfondit le rôle de l’optimiseur. Ces réglages identifient l’expérience, ils ne promettent pas sa réussite.
Reprendre un apprentissage n’est pas seulement recharger les poids
Le parcours prévoit une interruption après douze époques, puis une reprise qui doit retrouver exactement le chemin continu. Le checkpoint, ou point de sauvegarde, conserve les poids, l’optimiseur, le sampler qui détermine l’ordre des exemples et les états des générateurs aléatoires.
Recharger uniquement les poids peut donner un modèle ressemblant à celui interrompu sans reproduire ses prochaines mises à jour. C’est pourquoi le contrôle compare les états nécessaires à la poursuite, pas seulement une métrique finale proche.
Cette exigence reste liée à l’environnement. La documentation PyTorch sur la reproductibilité avertit que l’identité des résultats n’est pas garantie entre versions et plateformes ; index_add_ comporte aussi une réserve concernant CUDA. Une graine fixe ne suffit donc pas à annoncer une reproductibilité universelle. Conservez les versions du ZIP et vérifiez le résultat des contrôles de reprise.
Lire les métriques avant les chiffres
D’abord : le bon dossier est-il bien classé ?
Top-1 mesure la part des pièces rattachables pour lesquelles le dossier correct arrive premier. MRR, pour Mean Reciprocal Rank, est la moyenne des inverses des rangs du bon dossier. Ce n’est ni le rang moyen ni l’inverse de ce rang moyen.
Si deux pièces ont leur dossier correct aux rangs 1 et 2, Top-1 vaut 1 / 2 = 0,50. MRR vaut (1/1 + 1/2) / 2 = 0,75. L’inverse du rang moyen donnerait 1 / 1,5, soit environ 0,667 : c’est un autre calcul.
Dans ce tutoriel, ces deux mesures portent sur les 288 pièces ayant un bon candidat, même si le seuil conduit ensuite à s’abstenir sur certaines. Elles mesurent le classement, pas le nombre de propositions envoyées à un utilisateur.
Ensuite : quelles propositions sont émises, et lesquelles sont justes ?
La précision acceptée compte les propositions correctes parmi celles réellement émises. La couverture compte les propositions émises parmi les 336 cibles, qu’elles soient correctes ou non. Le rappel de rejet compte les cas hors périmètre rejetés parmi les 48 cas hors périmètre.
Enfin, le taux global de décisions correctes additionne les propositions correctes et les rejets corrects, puis divise par 336. S’abstenir sur une pièce qui possède un bon candidat ne compte pas comme une bonne décision dans ce calcul.
Retenons un exemple fictif de dix pièces : huit ont un dossier correct, deux n’en ont pas. Le programme émet six propositions, dont cinq justes, et rejette quatre pièces, parmi lesquelles les deux cas hors périmètre.
Sa précision acceptée vaut 5/6 ≈ 0,8333, sa couverture 6/10 = 0,60, son rappel de rejet 2/2 = 1, et son taux global (5 + 2)/10 = 0,70. Il rejette parfaitement les cas hors périmètre, mais refuse aussi deux pièces qu’il aurait pu rattacher. Une bonne mesure de rejet ne suffit donc pas à décrire tout le comportement.
Sans aucune proposition, la précision acceptée est indéfinie : il n’y a pas de dénominateur. Elle ne devient pas 1 par convention. De même, une couverture élevée ne signifie pas que les dossiers proposés sont justes.
Choisir un seuil sans régler le test après coup
Le parcours explore les seuils sur la validation uniquement. Pour le cosinus, la grille va de −1 à 1 par pas de 0,01. Pour les scores sigmoïdes, elle va de 0 à 1 par pas de 0,05.
En cas d’égalité, la règle retient la valeur proche de 0 pour le cosinus ou de 0,5 pour la sigmoïde, puis le seuil inférieur. Ce départage est fixé avant la lecture du test. L’article ne reproduit pas le critère complet d’optimisation de calibrate : consultez son implémentation dans le ZIP plutôt que d’en déduire un objectif non précisé.
Le mot calibration désigne ici ce choix de seuil. Il ne suffit pas à établir une calibration probabiliste, qui demanderait de vérifier si les niveaux de confiance annoncés correspondent aux fréquences de succès observées. La documentation de scikit-learn sur la calibration des probabilités explique cette distinction ; elle n’est pas une étape supplémentaire exécutée par ce projet.
Une fois le seuil choisi, le test décrit cette règle préexistante. Le modifier parce qu’un chiffre de test déplaît ferait perdre cette séparation.
Résultats observés et leur portée
Le classement reste identique
Sur les 336 cibles de test, toutes les variantes principales obtiennent Top-1 = 0,50 et MRR = 0,75 sur les 288 cas rattachables. Le graphe typé ne fait donc pas mieux que les autres méthodes pour placer le bon dossier en première position dans cette reproduction.
Ne confondons pas ce constat avec une absence totale de différence. La règle de proposition et de rejet peut changer, même si le classement ne s’améliore pas.
Reconstituer les décisions du graphe typé
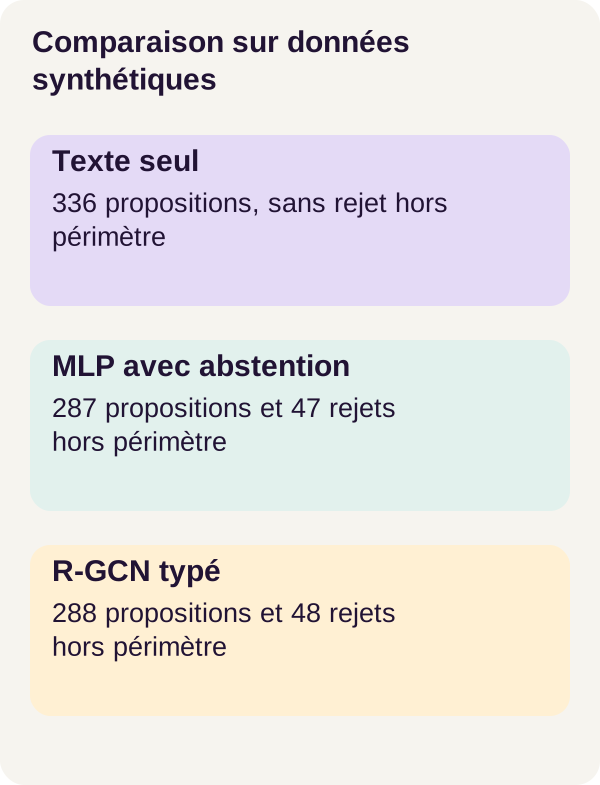
Avec le seuil de validation 0,40, typed accepte 288 cibles, en propose 144 correctement et rejette les 48 cas hors périmètre.
Les comptes permettent de lire ses mesures sans jargon : la précision acceptée est 144/288 = 0,50, la couverture est 288/336 = 0,857143, et le taux global vaut (144 + 48)/336 = 0,571429. Le rappel de rejet vaut 48/48 = 1.
Le programme ne propose donc pas de mauvais dossier aux 48 pièces hors périmètre, mais la moitié des 288 propositions émises reste incorrecte. Un rejet parfait sur cette population ne rend pas le classement fiable.
Comparer sans attribuer au graphe un gain qu’il ne démontre pas
Le cosinus utilise un seuil de 0. untyped utilise 0,30 et obtient les mêmes comptes que typed. Les résultats publiés ne précisent pas le seuil du MLP ; le tableau compare les décisions rapportées, sans lui attribuer un seuil supplémentaire.
Sur mobile, faites défiler le tableau horizontalement.
| Méthode | Propositions émises | Propositions correctes | Hors périmètre rejetés, sur 48 | Précision acceptée | Taux global correct |
|---|---|---|---|---|---|
| Cosinus E5, texte seul | 336 | 144 | 0 | 0,428571 | 0,428571 |
mlp, sans arêtes |
287 | 143 | 47 | 0,498258 | 0,565476 |
untyped, relation unique |
288 | 144 | 48 | 0,50 | 0,571429 |
typed, relations distinguées |
288 | 144 | 48 | 0,50 | 0,571429 |
Pour le cosinus, accepter les 336 cibles signifie aussi proposer un dossier aux 48 pièces qui n’en ont aucun de correct dans la liste. Sa précision vaut donc 144/336 = 0,428571. Le graphe typé améliore ici le rejet par rapport à cette référence, pas Top-1 ou MRR.
Les résultats du MLP sont également instructifs. Avec 287 propositions, il rejette 336 − 287 = 49 pièces. Parmi elles, 47 sont hors périmètre : les deux autres possèdent donc un bon candidat. Ce détail est une déduction arithmétique des comptes publiés, pas une nouvelle analyse des prédictions individuelles.
Son taux global s’explique par (143 + 47)/336 = 0,565476. Il est proche de celui des graphes. On ne peut donc pas attribuer au seul contexte relationnel tout l’écart avec le cosinus, ni annoncer que distinguer les types de relations améliore nécessairement le résultat.
Le résultat à retenir est limité mais clair : les graphes étudiés rejettent mieux les cas hors périmètre que le texte seul dans ce protocole, sans mieux classer les bons dossiers. Ces mesures sur données synthétiques ne valident ni un rattachement métier ni l’apport causal d’une relation donnée.
Exercice : tester l'hypothèse avant sa correction
Prédire l’effet avant de le mesurer
Revenons à O-035. Nous disposons de son texte et d’une relation avec BX-07. Si ce canal relationnel apporte une information utile, que devrait-il se passer lorsqu’on le retire ? Le classement va-t-il changer ? Les propositions seront-elles moins nombreuses ? Les rejets seront-ils meilleurs ou moins bons ?
Écrivez votre hypothèse avant l’exécution. L’effet peut être positif, nul ou négatif. Un lien qui paraît intuitivement utile n’améliore pas nécessairement le comportement mesuré.
Retirer un canal de contexte pour observer son rôle constitue une ablation. Ici, l’expérience ne se contente pas de supprimer l’arête dans un modèle déjà entraîné : elle entraîne la variante no-equipment pendant trente époques, avec les mêmes candidats et les mêmes vecteurs E5. Son seuil est choisi à nouveau sur la validation.
C’est une comparaison de variantes réentraînées, pas une simple perturbation de dernière minute des entrées d’un modèle fixe. Comme le texte reste conservé, retirer le lien pièce–équipement ne supprime pas nécessairement la mention textuelle de l’équipement.
Exécuter la variante et son évaluation
docker compose run --rm learning python -m ged_rattachement_graphe.cli exercise --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rattachement_graphe.cli predict --config configs/minimum.yaml --variant no-equipment --mode continuous
docker compose run --rm calibration python -m ged_rattachement_graphe.cli calibrate-exercise --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_rattachement_graphe.cli evaluate-exercise --config configs/minimum.yaml
exercise réalise l’expérience prévue, predict produit les sorties de no-equipment, puis calibrate-exercise et evaluate-exercise appliquent la même séparation validation/test. Les sorties initiales restent protégées par hash : l’exercice ne doit pas écraser discrètement le point de comparaison.
Comparer avec les observations fournies
Dans les résultats r001, no-equipment émet 287 propositions, dont 143 correctes, et rejette 47 des 48 cas hors périmètre. Ces comptes sont proches du graphe initial et identiques aux comptes du MLP rapportés plus haut. Des comptes égaux ne prouvent pas que les erreurs concernent les mêmes pièces : cette question demande une comparaison des sorties document par document.
Vous ne pouvez donc pas conclure « la relation équipement garantit le bon dossier ». Vous ne pouvez pas non plus conclure qu’elle est inutile dans toute GED. Le résultat décrit ce corpus, cette architecture, cet entraînement et cette règle de décision.
La correction consiste à confronter votre hypothèse aux propositions et aux rejets, puis à examiner des exemples. Pour prolonger le raisonnement à la main, reprenez les deux vecteurs de la section précédente : si vous retirez une arête, le numérateur et le degré doivent changer. Cette vérification locale permet de comprendre une cause de fuite avant de regarder un score final.
Produire les figures et contrôler les sauvegardes
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Les figures complètent l’évaluation ; les contrôles de checkpoints vérifient les états attendus du parcours. Conservez les sorties à étudier avant le nettoyage présenté ci-dessous. Une courbe ne remplace pas l’inspection de la pièce, de ses candidats et de son contexte visible.
Dépanner, nettoyer et passer à un produit
Distinguer une panne d’environnement d’une erreur de modèle
Le GPU n’est pas accessible dans Docker ? Suivez le diagnostic du préflight, corrigez l’environnement de l’hôte, puis recommencez dans un nouveau dossier extrait. Un état nvidia-smi sur l’hôte ne remplace pas le calcul E5 dans le conteneur.
L’acquisition échoue ? Vérifiez les fichiers verrouillés, leur taille et leur SHA-256. Ne substituez pas un autre modèle ou une autre révision pour faire disparaître l’erreur : vous changeriez les conditions de l’expérience.
Un contrôle de checkpoint échoue ? Conservez les éléments utiles au diagnostic. Le nettoyage fourni ne supprime que outputs ; il ne répare ni ne remplace les checkpoints conservés. Pour un nouveau parcours complet, une extraction neuve évite de mélanger les états de plusieurs essais.
Avant de nettoyer, copiez les résultats et figures à garder. Les commandes suivantes arrêtent le projet, affichent puis effacent uniquement outputs, et terminent le parcours. Les données, modèles et checkpoints restent présents. Aucun nettoyage Docker global n’est nécessaire.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Comprendre ce que l’isolation fournit
Les services utilisent l’UID et le GID de l’utilisateur, c’est-à-dire ses identifiants système. Leur système racine est en lecture seule ; seules les zones nécessaires au rôle de chaque service sont montées en écriture. Le projet retire les capacités Linux supplémentaires, utilise no-new-privileges, fixe des limites de CPU, de mémoire et de processus, et prévoit un espace temporaire en tmpfs.
L’acquisition peut joindre les fichiers publics verrouillés. Les services de calcul fonctionnent avec le réseau désactivé. Cette séparation aide à maintenir le parcours dans son périmètre prévu ; elle n’est pas une certification de sécurité contre un administrateur Docker.
Passer d’un score à une interface de revue
Dans une application réelle, commencez par définir avec les équipes métier ce qu’est un rattachement correct, quels documents sont concernés et d’où viennent les dossiers candidats. Constituez des annotations et une évaluation représentatives avant de remplacer le corpus fictif.
Les droits doivent intervenir avant le score : la bonne première place dans un classement n’autorise pas à montrer un dossier confidentiel. Il faut aussi décider quoi faire lorsqu’aucun dossier autorisé n’est disponible, alors que le tutoriel en fournit toujours quatre.
Les égalités du parcours sont départagées par identifiant pour stabiliser le calcul. Ce choix ne porte aucun sens métier. Si deux candidats sont à égalité, un identifiant plus petit ne rend pas l’un plus pertinent que l’autre.
Une interface de revue peut présenter la pièce, les candidats, les relations consultées et la proposition, puis laisser une personne confirmer, refuser ou corriger. C’est une piste produit à développer, pas une interface déjà fournie par l’extrait. Le sous-graphe montre le contexte disponible ; il ne constitue pas une explication causale de la validité du rattachement.
Il reste à prévoir authentification, API, stockage persistant, journalisation des propositions, supervision, sauvegardes, tests de charge et évaluation métier. Versionnez ensemble le graphe, les données, les règles de décision et le modèle. Une proposition doit pouvoir être retrouvée et contestée, pas seulement affichée puis oubliée.
Le parcours de ce tutoriel ne modifie aucun dossier ni aucun droit. Automatiser une action administrative constituerait un autre périmètre à définir et à valider.
Synthèse
Nous sommes partis d’une question de back-office : proposer un dossier à partir d’une note et de relations déjà connues. E5 transforme le texte en vecteurs gelés ; le réseau relationnel combine ces vecteurs avec les voisins autorisés ; le score classe quatre candidats ; une règle distincte décide de proposer ou de s’abstenir.
Le contrôle essentiel se trouve dans les entrées : retirer le lien cible et son inverse, recalculer les degrés et séparer les îlots. Sans cela, une belle métrique peut simplement mesurer la présence de la réponse dans le contexte.
Les chiffres montrent ensuite pourquoi il faut séparer les objectifs. Dans cette reproduction, le graphe améliore le rejet des cas hors périmètre par rapport au cosinus, mais pas le classement des dossiers. Le modèle sans arêtes reste proche, et le typage des relations ne démontre pas de gain sur les mesures publiées.
Vous disposez ainsi d’un parcours pour apprendre à représenter un contexte, vérifier une agrégation et interpréter une décision. L’étape suivante n’est pas de transformer le score en certitude : c’est d’évaluer ce qui reste faux sur les documents et les usages réellement visés.
Sources primaires et compléments de lecture
Les références initiales du parcours sont l’article R-GCN, la documentation E5 de la révision acquise et la documentation PyTorch 2.8 de index_add_.
Les liens complémentaires intégrés au texte approfondissent les projections linéaires, la sigmoïde, AdamW, la reproductibilité et la calibration probabiliste. Ils expliquent les notions ; ils n’ajoutent pas de nouveaux entraînements ni de nouvelles mesures au parcours r001. Pour reproduire celui-ci, conservez les versions et les commandes du ZIP plutôt que de les remplacer par celles des documentations courantes.