





Immaginate una schermata di back-office in cui arrivano note di sopralluogo da classificare in fascicoli. La nota O-035 menziona l’attrezzatura BX-07 e il sito Cedro, ma non riporta alcun numero di fascicolo. L’applicazione propone quattro fascicoli. Quale suggerire alla persona incaricata della classificazione? E soprattutto: quando è meglio non proporne nessuno?
Se sviluppate applicazioni web, forse avete già risolto una parte di questo problema con ricerche testuali e join. Ma due fascicoli possono avere una formulazione identica e una relazione nota con un’attrezzatura non fornisce necessariamente una corrispondenza certa.
Confronteremo quindi diversi approcci: il solo testo, una rete neurale senza relazioni, poi una rete che sfrutta un grafo, cioè oggetti collegati tra loro. Seguiremos il percorso testo e relazioni disponibili → rappresentazioni numeriche → punteggi dei quattro candidati → proposta o astensione.
L’obiettivo è capire che cosa apporta davvero il contesto, senza fornirgli di nascosto la risposta da ritrovare. Un modello che vede ancora il collegamento documento–fascicolo nascosto nei propri input non risolve il problema: rilegge la soluzione.
Questo tutorial produce una proposta di associazione, mai un’associazione amministrativa. I dati sono sintetici. I risultati descrivono il protocollo r001, non una convalida su documenti aziendali.
Scaricare il progetto completo, revisione r001
Partire da ciò che è realmente disponibile
Un grafo non è necessariamente un nuovo database
Una GED, ovvero gestione elettronica dei documenti, organizza i documenti, i loro metadati e i loro collegamenti. Nel nostro esempio, un documento è una nota di sopralluogo; un fascicolo riunisce informazioni relative a una pratica o a un intervento.
Per rappresentare questo piccolo mondo, ogni oggetto diventa un nodo: un documento, un’attrezzatura, un sito o un fascicolo. Un arco è una relazione orientata tra due nodi. Il suo tipo indica che cosa significa questa relazione.
Sappiamo ad esempio che O-035 — concerne → BX-07 e che BX-07 — situé à → Cèdre. In termini di database relazionale, ciò somiglia ad associazioni tra record, con un verso e una natura precisi. Usare un grafo nel calcolo non significa che l’esempio Python installi o richieda un database a grafo: qui manipola tabelle di nodi e relazioni.
Il collegamento che cerchiamo di proporre è diverso: a quale fascicolo dovrebbe essere associato il documento O-035? Non deve essere già presente tra gli input utilizzati per rispondere.
Il testo e le relazioni osservate sono forniti al programma. Il tutorial non dimostra l’estrazione automatica di queste relazioni da un PDF o da una nota libera.
Classificare quattro candidati, poi decidere se rispondere
Anche i quattro fascicoli candidati sono forniti in input. Il programma non li seleziona dopo aver consultato il fascicolo atteso. È una distinzione importante: ritrovare la risposta giusta fra quattro candidati già noti non equivale a cercare liberamente in un’intera GED.
Il calcolo produce quattro punteggi. Il fascicolo meglio classificato diventa una proposta solo se il suo punteggio supera la soglia prevista; altrimenti, il programma si astiene.
Prendiamo un esempio fittizio di punteggi, solo per comprendere questa regola: 0,64 ; 0,62 ; 0,21 ; 0,08. Con una soglia di 0,60, viene proposto il primo fascicolo. Tuttavia, il suo punteggio è vicino a quello del secondo. La regola qui descritta esamina il miglior punteggio, non lo scarto fra i primi due. Per costruzione, quindi, non rileva ogni forma di ambiguità.
Questi quattro valori non sono necessariamente probabilità che sommano a 1. Un punteggio di 0,64 non significa «64 % di probabilità che questa associazione sia amministrativamente corretta». Torneremo sulla differenza fra punteggio e probabilità calibrata.
Una relazione assente non è automaticamente falsa
In una GED reale, un collegamento mancante può voler dire «non ancora compilato». Non significa necessariamente «questo documento non appartiene a questo fascicolo».
Il corpus sintetico offre qui un vantaggio sperimentale: il suo generatore conosce i documenti per i quali nessuno dei quattro candidati è corretto. Questi casi sono detti fuori ambito. Permettono di verificare se il programma sa respingere una richiesta senza risposta giusta nell’elenco proposto.
La portata del rifiuto resta quindi locale: «nessun buon candidato tra questi quattro fascicoli» non significa «non esiste alcun buon fascicolo nell’azienda».
Separare intere isole, non solo righe di dati
Il corpus comprende 80 isole indipendenti. Un’isola è un piccolo gruppo di nodi e relazioni che non condivide il proprio contesto con gli altri. La suddivisione conserva 56 isole per l’addestramento, 12 per la convalida e 12 per il test.
L’addestramento regola i parametri della rete. La convalida serve in particolare a scegliere le soglie. Il test misura poi il comportamento della regola scelta, senza modificarla dopo l’osservazione.
Le partizioni non condividono né nodi, né archi, né attrezzature, né siti. Parole, tipi di documenti e frammenti di frasi possono invece restare comuni. Testiamo quindi nuovi identificativi e nuovi contesti di grafo, non necessariamente un vocabolario interamente nuovo.
Ogni isola contiene quattro fascicoli. Per ciascuno, sei collegamenti con documenti restano visibili come contesto e altri sei vengono mascherati definitivamente. Quattro documenti aggiuntivi non hanno alcun buon fascicolo candidato. Il dettaglio dei documenti è il seguente:
| Documenti di un’isola | Calcolo dal protocollo | Numero |
|---|---|---|
| Documenti con associazione visibile | 4 fascicoli × 6 documenti | 24 |
| Documenti con associazione nascosta | 4 fascicoli × 6 documenti | 24 |
| Documenti senza buon candidato | Aggiunti dal generatore | 4 |
| Totale documenti | 24 + 24 + 4 | 52 |
Punto di attenzione sul conteggio r001. La descrizione originale indica «80 isole indipendenti di 52 nodi», pur annunciando 5 600 nodi di cui 4 160 documenti. Queste formulazioni non coincidono: 80 × 52 = 4 160, non 5 600. Il dettaglio precedente permette di ritrovare 52 documenti per isola, ossia 4 160 documenti. Il totale annunciato di 5 600 nodi è conservato, ma la formulazione «52 nodi per isola» deve essere verificata nel corpus generato. Questo calcolo non costituisce un nuovo conteggio dei file del progetto.
Per la convalida come per il test, gli obiettivi sono i 24 documenti con collegamento nascosto e i quattro documenti fuori ambito di ciascuna delle 12 isole. Si ottengono 12 × 24 = 288 casi associabili e 12 × 4 = 48 casi fuori ambito, cioè 336 obiettivi per partizione. I 24 documenti con collegamento visibile di ogni isola restano contesto: non diventano risposte da valutare.
Nascondere la risposta in entrambi i sensi
Supponiamo che l’associazione nota sia rappresentata sia da pièce → dossier sia dalla relazione inversa dossier → pièce. Rimuovere solo il primo arco lascerebbe disponibile la stessa informazione nell’altro verso.
Il percorso rimuove quindi entrambi gli orientamenti di ogni collegamento nascosto prima dell’inferenza. L’inferenza è semplicemente l’uso del modello per calcolare una previsione dopo l’apprendimento.
Occorre inoltre ricalcolare i gradi, cioè il numero di relazioni utilizzate per normalizzare i messaggi. Mantenere un vecchio contatore conserverebbe una traccia del grafo non mascherato anche dopo la rimozione degli archi. Vicinati e gradi devono entrambi provenire dal grafo realmente autorizzato.
Questa precauzione non elimina gli indizi legittimi: attrezzature e siti restano disponibili secondo il protocollo. Evita che la relazione obiettivo sia ancora fornita, direttamente o attraverso un calcolo effettuato prima della sua rimozione.
Trasformare il testo in vettori con E5
Il modello multilingual-e5-small, al commit 614241f622f53c4eeff9890bdc4f31cfecc418b3, trasforma i testi in embedding. Un embedding è una lista di numeri che rappresenta il testo per i calcoli di somiglianza. Qui ogni lista contiene 384 valori float32, numeri in virgola mobile memorizzati su 32 bit.
Queste 384 posizioni non sono 384 campi aziendali che avremmo chiamato «sito», «attrezzatura» e così via. Sono caratteristiche apprese dall’encoder. L’encoder produce una rappresentazione numerica; non redige una risposta conversazionale.
I vettori sono normalizzati in L2: ogni vettore viene diviso per la sua lunghezza. In un esempio didattico a due dimensioni, [3 ; 4] ha lunghezza 5 e diventa [0,6 ; 0,8]. I testi vengono così confrontati tramite la direzione della loro rappresentazione anziché la sola ampiezza.
Tutti ricevono il prefisso letterale query: , inclusi i testi dei fascicoli, per questa rappresentazione simmetrica. La documentazione E5 della revisione usata descrive questa scelta per i compiti simmetrici e l’uso degli embedding come caratteristiche.
Il percorso rifiuta una media vuota, non finita o nulla, e fallisce oltre 512 token. Un token è un’unità di testo manipolata dal modello, non necessariamente una parola intera. A differenza di un trattamento che troncherebbe silenziosamente la fine, questo limite diventa un errore esplicito.
E5 resta congelato durante l’addestramento: i suoi parametri non vengono modificati. Impariamo le trasformazioni che usano i suoi vettori, non un nuovo encoder testuale. Gli identificativi dei fascicoli non diventano mai embedding appresi singolarmente; gli indici del grafo servono a ritrovare righe di tabelle, non a memorizzare un vettore addestrabile per fascicolo.
Far circolare il contesto giusto
Uno strato di grafo: leggere i vicini senza dimenticare il proprio testo
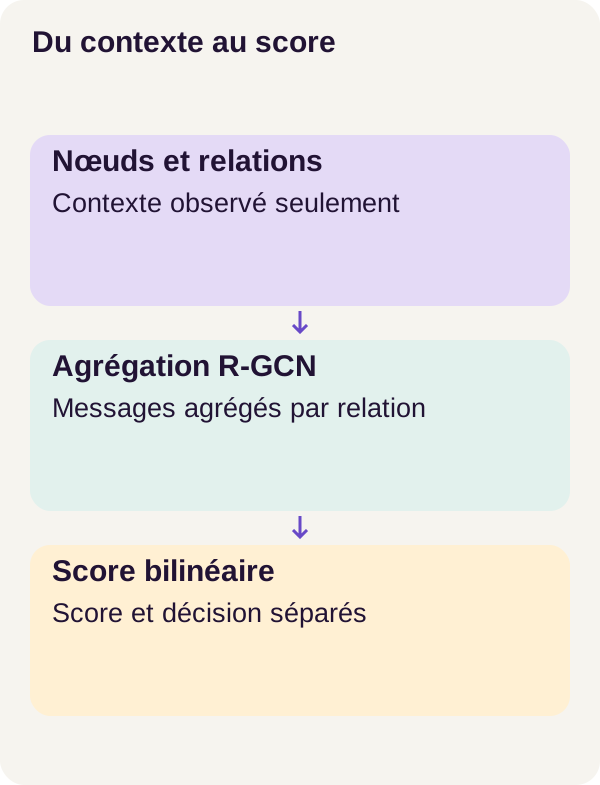
Un R-GCN, per Relational Graph Convolutional Network, è una rete neurale che combina le rappresentazioni dei nodi con quelle dei loro vicini, distinguendo i tipi di relazioni. L’articolo fondativo sugli R-GCN presenta questo principio per grafi multirelazionali.
L’intuizione è vicina a una join seguita da un raggruppamento: per un nodo destinatario, ritroviamo i suoi vicini, raggruppiamo i loro vettori per tipo di relazione e calcoliamo una media. Una trasformazione appresa elabora poi ogni media.
Perché mantenere i tipi? Perché «riguarda un’attrezzatura» e «si trova su un sito» non descrivono la stessa associazione. La variante tipizzata può apprendere trattamenti diversi. Le offre una possibilità in più, non la garanzia di fare proposte migliori.
Per ogni destinazione e ogni relazione, lo strato segue quattro operazioni: somma i vettori sorgente, divide questa somma per il numero di archi visibili corrispondenti, applica la matrice di quella relazione, poi aggiunge tutto a una proiezione del nodo stesso. Un’attivazione ReLU completa il calcolo: sostituisce con zero i valori negativi.
Possiamo riassumere la meccanica così: nuova rappresentazione = ReLU(testo del nodo trasformato + contributi trasformati dei vicini).
Leggere le dimensioni prima delle operazioni
Un tensore è qui una tabella di numeri. Con N nodi e E archi osservati, il primo strato manipola le dimensioni seguenti:
| Oggetto del codice | Forma e significato |
|---|---|
features |
N × 384 : un vettore per nodo |
edges |
E × 3 : sorgente, destinazione, tipo di relazione |
relation_weights |
8 × 384 × 64 nel primo strato tipizzato |
| Output dello strato | N × 64 : gli stessi nodi, con nuovi vettori |
Una matrice è una tabella a due dimensioni. Una proiezione lineare combina i valori di input con pesi appresi per ottenere un vettore della dimensione desiderata. Passare da 384 a 64 dimensioni non elimina nodi: modifica la lunghezza della rappresentazione di ciascuno.
Il progetto impila due strati: 384 → 64, poi 64 → 64. Dopo uno strato, un nodo può usare le informazioni dei suoi vicini diretti; dopo due, può anche ricevere informazioni passate da un vicino intermedio, secondo gli orientamenti effettivamente presenti. Questo non equivale a leggere istantaneamente tutti i percorsi di un grande grafo.
Il codice eseguito: una media per destinazione e per relazione
Ecco l’estratto del percorso r001. Leggete prima forward(), che esegue il calcolo; torneremo poi sull’inizializzazione.
import torch
from torch import nn
import torch.nn.functional as F


class RelationalLayer(nn.Module):
    def __init__(self, inputs, outputs, relations, layer, seed=17):
        super().__init__()
        self.self_projection = nn.Linear(inputs, outputs, bias=False)
        self.relation_weights = nn.Parameter(torch.empty(relations, inputs, outputs))
        self.relations = relations
        nn.init.xavier_uniform_(
            self.self_projection.weight,
            generator=torch.Generator().manual_seed(seed + layer),
        )
        for r in range(relations):
            nn.init.xavier_uniform_(
                self.relation_weights[r],
                generator=torch.Generator().manual_seed(seed + 100 + layer * 20 + r),
            )

    def forward(self, features, edges):
        if edges.ndim != 2 or edges.shape[1] != 3 or edges.dtype != torch.long:
            raise ValueError("Edges are source,target,relation integer rows")
        if len(edges) and (
            (edges[:, :2] < 0).any()
            or (edges[:, :2] >= len(features)).any()
            or (edges[:, 2] < 0).any()
            or (edges[:, 2] >= self.relations).any()
        ):
            raise ValueError("Invalid observed edge")
        result = self.self_projection(features)
        for r in range(self.relations):
            selected = edges[edges[:, 2] == r]
            source = selected[:, 0]
            target = selected[:, 1]
            aggregate = torch.zeros_like(features)
            degree = torch.zeros(
                len(features), dtype=features.dtype, device=features.device
            )
            # Every degree and message uses only this currently observed relation.
            aggregate.index_add_(0, target, features[source])
            degree.index_add_(
                0,
                target,
                torch.ones(len(source), dtype=features.dtype, device=features.device),
            )
            aggregate = aggregate / degree.clamp_min(1)[:, None]
            result = result + aggregate @ self.relation_weights[r]
        return F.relu(result)
Il controllo dell’input richiede una tabella di archi bidimensionale, con tre colonne e il tipo intero torch.long. Gli indici dei nodi devono corrispondere a righe esistenti di features, e gli indici delle relazioni devono appartenere all’intervallo previsto. Un arco verso un nodo inesistente viene rifiutato prima di partecipare al calcolo.
La proiezione propria inizia con self.self_projection(features). Ogni nodo conserva così un contributo derivato dalle proprie caratteristiche, anche se non riceve alcun messaggio. L’opzione bias=False significa che questo strato lineare PyTorch non aggiunge una costante appresa alla sua trasformazione.
Il filtraggio per relazione avviene con edges[edges[:, 2] == r]. Per il tipo corrente, source fornisce le righe da leggere e target le righe destinatarie. Le altre relazioni non vengono mescolate in questa media.
La somma dei messaggi usa aggregate.index_add_(0, target, features[source]). Immaginate un GROUP BY destination che sommerebbe vettori anziché una colonna di importi. Se più sorgenti hanno la stessa destinazione, i loro valori vengono aggiunti nella stessa riga. Il suffisso _ indica qui che il tensore di accumulo viene modificato sul posto. La documentazione di index_add_ precisa questa operazione.
Un secondo index_add_ somma degli 1 alle stesse destinazioni. Ottiene i gradi per questa relazione e questo grafo osservato, non gradi recuperati prima del mascheramento.
La divisione trasforma ogni somma in media. degree.clamp_min(1) sostituisce i gradi nulli con 1 per evitare una divisione per zero. Questo non crea un vicino fittizio: una somma vuota vale sempre zero, e 0 / 1 resta zero. [:, None] mette il grado in forma di colonna per dividere tutte le componenti di uno stesso nodo per lo stesso numero.
La trasformazione della relazione interviene con aggregate @ self.relation_weights[r]. Il simbolo @ indica il prodotto matriciale. Il contributo trasformato si aggiunge al risultato, poi F.relu(result) conclude lo strato.
La classe inizializza le sue matrici con Xavier e semi determinati da seed, dallo strato e dalla relazione. Un seme fissa il punto di partenza di un generatore pseudo-casuale. Rende l’inizializzazione controllabile; da solo non sostituisce tutti i controlli necessari a una ripresa riproducibile.
Un piccolo calcolo per verificare che cosa fa la maschera
Prendiamo un esempio didattico a due dimensioni, indipendente dai risultati del corpus. Due vicini inviano [2 ; 4] e [6 ; 0] alla stessa destinazione, tramite la stessa relazione.
La somma vale [8 ; 4], il grado vale 2 e la media [4 ; 2]. Se la matrice di relazione scelta per questo esempio conserva la prima componente e raddoppia la seconda, il suo contributo diventa [4 ; 4]. Con una proiezione propria pari a [1 ; −1], la somma vale [5 ; 3], invariata dalla ReLU.
Rimuoviamo ora il secondo arco. La media corretta è [2 ; 4] / 1 = [2 ; 4]. Riutilizzare il vecchio grado 2 darebbe [1 ; 2]: la rappresentazione dipenderebbe ancora dal vicino rimosso, attraverso il suo vecchio contatore.
Se rimuoviamo tutti gli archi, il contributo dei vicini diventa nullo, ma non necessariamente l’output. La proiezione propria di questo esempio resta [1 ; −1], poi ReLU restituisce [1 ; 0].
Nell’estratto sono visibili altri due limiti. Non conosce le annotazioni nascoste: la rimozione dei collegamenti obiettivo deve essere avvenuta prima della chiamata. E non deduplica gli archi: una stessa riga ripetuta partecipa più volte alla somma e al grado. La validità degli indici non basta quindi a garantire la qualità del grafo fornito.
Passare dai vettori ai punteggi, poi confrontare le varianti
Dopo i due strati, il programma confronta la rappresentazione del documento con quella di ciascun fascicolo tramite un punteggio bilineare. Il principio consiste nel combinare due vettori con pesi appresi per produrre un numero di compatibilità. La parola «bilineare» descrive il calcolo; non significa che la relazione aziendale sia stata dimostrata. L’estratto precedente mostra lo strato relazionale, non l’intera testa di punteggio né l’intero ciclo di addestramento dello ZIP.
I punteggi neurali usati per la decisione passano attraverso una sigmoide, una funzione che trasforma un punteggio grezzo in un valore compreso fra 0 e 1. Vale 0,5 per un punteggio grezzo nullo e aumenta con tale punteggio. La sua definizione in PyTorch completa il meccanismo. Applicare una sigmoide non stabilisce che i valori ottenuti siano probabilità affidabili di associazione.
Il confronto distingue quattro approcci. Il coseno E5 confronta direttamente i vettori testuali normalizzati: è il riferimento solo testo, non un semplice motore di parole chiave. mlp rimuove gli archi e conserva una rete che trasforma le caratteristiche dei nodi. untyped usa gli archi, ma riunisce tutti i loro tipi in una sola relazione. Infine, typed applica otto trasformazioni relazionali distinte.
Le varianti riutilizzano gli stessi candidati, gli stessi vettori E5 e gli stessi mascheramenti. Il loro numero di parametri non è strettamente identico. Confrontiamo quindi scelte su un corpus preciso, senza attribuire automaticamente ogni differenza al solo tipaggio delle relazioni.
Eseguire tutte le fasi, nell’ordine giusto
Preparare l’ambiente
Dovete saper leggere Python, usare un terminale e avviare Docker. Le operazioni numeriche necessarie sono state appena introdotte: tabelle, medie, matrici e punteggi. Non è necessario aver già sviluppato una rete di grafi.
Decomprimete lo ZIP in una nuova directory e aprite il terminale alla sua radice. Tutti i comandi seguenti partono da questa cartella. Usate il profilo GPU previsto dal progetto. Prima dell’avvio, consultate il suo README per le risorse richieste e le condizioni d’installazione.
Il preflight controlla Docker, Compose, la GPU, la memoria e lo spazio disponibile. setup.sh prepara il progetto; Compose ne verifica poi la configurazione e costruisce i servizi.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference calibration
Verificate le diagnosi prima di proseguire. Un errore d’ambiente non si risolve modificando il modello o cambiandone le soglie.
Acquisire E5, poi verificare un vero calcolo in Docker
Il servizio acquisition scarica nove file E5 bloccati, controllati per dimensione e impronta SHA-256. Un’impronta permette di verificare l’identità dei file acquisiti, non la loro qualità predittiva.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
check_environment.py esegue E5 in Docker. Vedere la GPU con nvidia-smi sull’host non prova che questo calcolo containerizzato funzioni. pytest -q avvia poi i test del progetto. Verificatene il successo prima di proseguire: un test del programma e una misura della qualità delle proposte non controllano la stessa cosa.
I servizi di calcolo non scaricano driver né espongono porte host. La predisposizione di un ambiente di calcolo e l’esecuzione di un’API pubblica sono due questioni diverse.
Costruire i dati e osservare gli input
docker compose run --rm tutorial python -m ged_rattachement_graphe.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rattachement_graphe.cli encode --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rattachement_graphe.cli baseline --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rattachement_graphe.cli inspect-mechanism --config configs/minimum.yaml
prepare costruisce il corpus. È il momento di controllare le isole, le partizioni e i conteggi, in particolare la distinzione fra documenti e insieme dei nodi. encode calcola i vettori E5. Il riferimento baseline serve da punto di confronto testuale, poi inspect-mechanism permette di esaminare la meccanica prima dell’apprendimento delle varianti.
Per un documento come O-035, ponetevi tre domande mentre ispezionate gli input: quali sono i quattro candidati? Quali relazioni sono visibili? Il collegamento da prevedere, la sua inversa o un grado calcolato prima della sua rimozione sono ancora presenti? Un esempio ispezionato apporta spesso più di un punteggio aggregato mostrato troppo presto.
Addestrare le varianti e fissare la decisione
sh scripts/train_variants.sh
docker compose run --rm calibration python -m ged_rattachement_graphe.cli calibrate --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_rattachement_graphe.cli evaluate --config configs/minimum.yaml
train_variants.sh avvia typed, untyped e mlp. calibrate sceglie le soglie sulla convalida, poi evaluate misura i risultati con questa regola fissata.
A ogni epoca, cioè a ogni passaggio di apprendimento sugli esempi previsti, tre dei sei collegamenti visibili di ogni fascicolo di addestramento vengono temporaneamente mascherati, con le loro inverse. La rete deve imparare senza disporre nel proprio contesto immediato del collegamento così rimosso. I collegamenti definitivamente nascosti, invece, non vengono mai reinseriti.
Distinguete bene questi due meccanismi: un mascheramento temporaneo crea una situazione di apprendimento a partire dal contesto autorizzato; il mascheramento permanente mantiene la separazione del protocollo. Nessuno dei due deve essere annullato per ottenere artificialmente una previsione migliore.
Il progetto addestra per trenta epoche, con quattro isole per batch. Un batch è il gruppo di esempi elaborato per una fase di apprendimento. L’ottimizzatore AdamW usa un tasso di apprendimento di 0,003, un weight decay di 0,001 e un clipping di norma 1.
Un ottimizzatore regola i pesi a partire dai gradienti, le variazioni dell’errore rispetto a tali pesi. Il tasso di apprendimento regola l’ampiezza degli aggiornamenti; il weight decay riduce i pesi secondo la regola AdamW; il clipping limita la norma dei gradienti troppo grandi. La documentazione di AdamW approfondisce il ruolo dell’ottimizzatore. Queste impostazioni identificano l’esperimento, non ne promettono la riuscita.
Riprendere un addestramento non significa solo ricaricare i pesi
Il percorso prevede un’interruzione dopo dodici epoche, poi una ripresa che deve ritrovare esattamente il percorso continuo. Il checkpoint, o punto di salvataggio, conserva i pesi, l’ottimizzatore, il sampler che determina l’ordine degli esempi e gli stati dei generatori casuali.
Ricaricare solo i pesi può produrre un modello simile a quello interrotto senza riprodurne i prossimi aggiornamenti. Per questo il controllo confronta gli stati necessari alla prosecuzione, non solo una metrica finale vicina.
Questa esigenza resta legata all’ambiente. La documentazione PyTorch sulla riproducibilità avverte che l’identità dei risultati non è garantita tra versioni e piattaforme; anche index_add_ contiene una riserva relativa a CUDA. Un seme fisso non basta dunque per annunciare una riproducibilità universale. Conservate le versioni dello ZIP e verificate il risultato dei controlli di ripresa.
Leggere le metriche prima dei numeri
Prima: il fascicolo corretto è davvero ben classificato?
Top-1 misura la quota di documenti associabili per i quali il fascicolo corretto arriva primo. MRR, per Mean Reciprocal Rank, è la media degli inversi delle posizioni del fascicolo corretto. Non è né la posizione media né l’inverso di tale posizione media.
Se due documenti hanno il fascicolo corretto alle posizioni 1 e 2, Top-1 vale 1 / 2 = 0,50. MRR vale (1/1 + 1/2) / 2 = 0,75. L’inverso della posizione media darebbe 1 / 1,5, cioè circa 0,667: è un altro calcolo.
In questo tutorial, queste due misure riguardano i 288 documenti che hanno un buon candidato, anche se la soglia porta poi ad astenersi per alcuni. Misurano la classificazione, non il numero di proposte inviate a un utente.
Poi: quali proposte vengono emesse e quali sono corrette?
La precisione delle proposte accettate conta le proposte corrette tra quelle effettivamente emesse. La copertura conta le proposte emesse tra i 336 obiettivi, corrette o meno. Il richiamo del rifiuto conta i casi fuori ambito rifiutati fra i 48 casi fuori ambito.
Infine, il tasso complessivo di decisioni corrette somma le proposte corrette e i rifiuti corretti, quindi divide per 336. Astenersi su un documento che possiede un buon candidato non conta come buona decisione in questo calcolo.
Consideriamo un esempio fittizio di dieci documenti: otto hanno un fascicolo corretto, due non ne hanno. Il programma emette sei proposte, di cui cinque giuste, e rifiuta quattro documenti, fra i quali i due casi fuori ambito.
La precisione delle proposte accettate vale 5/6 ≈ 0,8333, la copertura 6/10 = 0,60, il richiamo del rifiuto 2/2 = 1 e il tasso complessivo (5 + 2)/10 = 0,70. Rifiuta perfettamente i casi fuori ambito, ma respinge anche due documenti che avrebbe potuto associare. Una buona misura di rifiuto non basta quindi a descrivere l’intero comportamento.
Senza alcuna proposta, la precisione delle proposte accettate è indefinita: non vi è denominatore. Non diventa 1 per convenzione. Allo stesso modo, una copertura elevata non significa che i fascicoli proposti siano corretti.
Scegliere una soglia senza regolare il test a posteriori
Il percorso esplora le soglie solo sulla convalida. Per il coseno, la griglia va da −1 a 1 con passo 0,01. Per i punteggi sigmoidi, va da 0 a 1 con passo 0,05.
In caso di parità, la regola conserva il valore vicino a 0 per il coseno o a 0,5 per la sigmoide, poi la soglia inferiore. Questo spareggio è fissato prima della lettura del test. L’articolo non riproduce il criterio completo di ottimizzazione di calibrate: consultatene l’implementazione nello ZIP invece di dedurne un obiettivo non precisato.
La parola calibrazione indica qui questa scelta di soglia. Non basta a stabilire una calibrazione probabilistica, che richiederebbe di verificare se i livelli di confidenza annunciati corrispondono alle frequenze di successo osservate. La documentazione scikit-learn sulla calibrazione delle probabilità spiega questa distinzione; non è una fase aggiuntiva eseguita dal progetto.
Una volta scelta la soglia, il test descrive questa regola preesistente. Modificarla perché un numero del test non piace farebbe perdere questa separazione.
Risultati osservati e loro portata
La classificazione resta identica
Sui 336 obiettivi di test, tutte le principali varianti ottengono Top-1 = 0,50 e MRR = 0,75 sui 288 casi associabili. Il grafo tipizzato non fa quindi meglio degli altri metodi nel porre il fascicolo corretto in prima posizione in questa riproduzione.
Non confondiamo questa constatazione con un’assenza totale di differenza. La regola di proposta e rifiuto può cambiare, anche se la classificazione non migliora.
Ricostruire le decisioni del grafo tipizzato
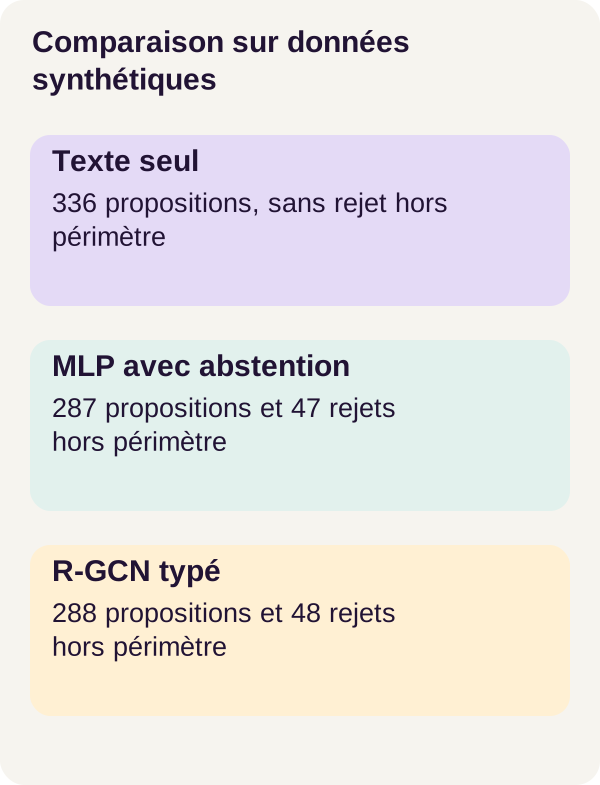
Con la soglia di convalida 0,40, typed accetta 288 obiettivi, ne propone 144 correttamente e rifiuta i 48 casi fuori ambito.
I conteggi permettono di leggere le sue misure senza gergo: la precisione delle proposte accettate è 144/288 = 0,50, la copertura è 288/336 = 0,857143 e il tasso complessivo vale (144 + 48)/336 = 0,571429. Il richiamo del rifiuto vale 48/48 = 1.
Il programma non propone quindi un fascicolo sbagliato ai 48 documenti fuori ambito, ma la metà delle 288 proposte emesse resta errata. Un rifiuto perfetto su questa popolazione non rende affidabile la classificazione.
Confrontare senza attribuire al grafo un vantaggio che non dimostra
Il coseno usa una soglia di 0. untyped usa 0,30 e ottiene gli stessi conteggi di typed. I risultati pubblicati non precisano la soglia dell’MLP; la tabella confronta le decisioni riportate, senza attribuirgli una soglia aggiuntiva.
Su mobile, scorrete orizzontalmente la tabella.
| Metodo | Proposte emesse | Proposte corrette | Fuori ambito rifiutati, su 48 | Precisione delle proposte accettate | Tasso complessivo corretto |
|---|---|---|---|---|---|
| Coseno E5, solo testo | 336 | 144 | 0 | 0,428571 | 0,428571 |
mlp, senza archi |
287 | 143 | 47 | 0,498258 | 0,565476 |
untyped, relazione unica |
288 | 144 | 48 | 0,50 | 0,571429 |
typed, relazioni distinte |
288 | 144 | 48 | 0,50 | 0,571429 |
Per il coseno, accettare i 336 obiettivi significa anche proporre un fascicolo ai 48 documenti che non ne hanno alcuno di corretto nella lista. La sua precisione vale quindi 144/336 = 0,428571. Il grafo tipizzato migliora qui il rifiuto rispetto a questo riferimento, non Top-1 o MRR.
Anche i risultati dell’MLP sono istruttivi. Con 287 proposte, rifiuta 336 − 287 = 49 documenti. Fra essi, 47 sono fuori ambito: gli altri due possiedono dunque un buon candidato. Questo dettaglio è una deduzione aritmetica dai conteggi pubblicati, non una nuova analisi delle previsioni individuali.
Il suo tasso complessivo si spiega con (143 + 47)/336 = 0,565476. È vicino a quello dei grafi. Non possiamo quindi attribuire al solo contesto relazionale tutto lo scarto rispetto al coseno, né annunciare che distinguere i tipi di relazioni migliori necessariamente il risultato.
Il risultato da ricordare è limitato ma chiaro: i grafi studiati rifiutano meglio i casi fuori ambito rispetto al solo testo in questo protocollo, senza classificare meglio i fascicoli corretti. Queste misure su dati sintetici non convalidano né un’associazione aziendale né l’apporto causale di una data relazione.
Esercizio: testare l’ipotesi prima della sua correzione
Prevedere l’effetto prima di misurarlo
Torniamo a O-035. Disponiamo del suo testo e di una relazione con BX-07. Se questo canale relazionale apporta un’informazione utile, cosa dovrebbe accadere quando lo rimuoviamo? La classificazione cambierà? Le proposte saranno meno numerose? I rifiuti saranno migliori o peggiori?
Scrivete la vostra ipotesi prima dell’esecuzione. L’effetto può essere positivo, nullo o negativo. Un collegamento che sembra intuitivamente utile non migliora necessariamente il comportamento misurato.
Rimuovere un canale di contesto per osservarne il ruolo costituisce un’ablazione. Qui l’esperimento non si limita a cancellare l’arco in un modello già addestrato: addestra la variante no-equipment per trenta epoche, con gli stessi candidati e gli stessi vettori E5. La sua soglia viene nuovamente scelta sulla convalida.
È un confronto di varianti riaddestrate, non una semplice perturbazione dell’ultimo momento degli input di un modello fisso. Poiché il testo resta conservato, rimuovere il collegamento documento–attrezzatura non elimina necessariamente la menzione testuale dell’attrezzatura.
Eseguire la variante e la sua valutazione
docker compose run --rm learning python -m ged_rattachement_graphe.cli exercise --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rattachement_graphe.cli predict --config configs/minimum.yaml --variant no-equipment --mode continuous
docker compose run --rm calibration python -m ged_rattachement_graphe.cli calibrate-exercise --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_rattachement_graphe.cli evaluate-exercise --config configs/minimum.yaml
exercise esegue l’esperimento previsto, predict produce gli output di no-equipment, poi calibrate-exercise e evaluate-exercise applicano la stessa separazione convalida/test. Gli output iniziali restano protetti da hash: l’esercizio non deve sovrascrivere di nascosto il punto di confronto.
Confrontare con le osservazioni fornite
Nei risultati r001, no-equipment emette 287 proposte, di cui 143 corrette, e rifiuta 47 dei 48 casi fuori ambito. Questi conteggi sono vicini al grafo iniziale e identici a quelli dell’MLP riportati sopra. Conteggi uguali non provano che gli errori riguardino gli stessi documenti: questa domanda richiede un confronto degli output documento per documento.
Non potete quindi concludere «la relazione con l’attrezzatura garantisce il fascicolo corretto». Non potete neppure concludere che sia inutile in ogni GED. Il risultato descrive questo corpus, questa architettura, questo addestramento e questa regola decisionale.
La correzione consiste nel confrontare la vostra ipotesi con le proposte e i rifiuti, poi nell’esaminare esempi. Per prolungare manualmente il ragionamento, riprendete i due vettori della sezione precedente: se rimuovete un arco, devono cambiare sia il numeratore sia il grado. Questa verifica locale permette di comprendere una causa di fuga prima di guardare un punteggio finale.
Produrre le figure e controllare i salvataggi
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Le figure completano la valutazione; i controlli dei checkpoint verificano gli stati attesi del percorso. Conservate gli output da studiare prima della pulizia illustrata sotto. Una curva non sostituisce l’ispezione del documento, dei suoi candidati e del suo contesto visibile.
Risolvere problemi, pulire e passare a un prodotto
Distinguere un problema d’ambiente da un errore del modello
La GPU non è accessibile in Docker? Seguite la diagnosi del preflight, correggete l’ambiente dell’host, poi ricominciate in una nuova cartella estratta. Uno stato nvidia-smi sull’host non sostituisce il calcolo E5 nel contenitore.
L’acquisizione fallisce? Verificate i file bloccati, la loro dimensione e il loro SHA-256. Non sostituite un altro modello o un’altra revisione per far sparire l’errore: cambiereste le condizioni dell’esperimento.
Un controllo del checkpoint fallisce? Conservate gli elementi utili alla diagnosi. La pulizia fornita elimina solo outputs; non ripara né sostituisce i checkpoint conservati. Per un nuovo percorso completo, una nuova estrazione evita di mescolare gli stati di più tentativi.
Prima di pulire, copiate risultati e figure da conservare. I comandi seguenti arrestano il progetto, mostrano poi eliminano solo outputs, e terminano il percorso. Dati, modelli e checkpoint restano presenti. Non è necessaria alcuna pulizia Docker globale.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Comprendere ciò che fornisce l’isolamento
I servizi usano l’UID e il GID dell’utente, cioè i suoi identificativi di sistema. Il loro filesystem radice è in sola lettura; solo le zone necessarie al ruolo di ciascun servizio sono montate in scrittura. Il progetto rimuove le capacità Linux aggiuntive, usa no-new-privileges, fissa limiti di CPU, memoria e processi, e prevede uno spazio temporaneo in tmpfs.
L’acquisizione può collegarsi ai file pubblici bloccati. I servizi di calcolo funzionano con la rete disattivata. Questa separazione aiuta a mantenere il percorso nel perimetro previsto; non è una certificazione di sicurezza contro un amministratore Docker.
Passare da un punteggio a un’interfaccia di revisione
In un’applicazione reale, iniziate definendo con i team aziendali che cosa sia un’associazione corretta, quali documenti siano interessati e da dove provengano i fascicoli candidati. Costituite annotazioni e una valutazione rappresentative prima di sostituire il corpus fittizio.
I diritti devono intervenire prima del punteggio: il primo posto giusto in una classificazione non autorizza a mostrare un fascicolo riservato. Occorre anche decidere cosa fare quando nessun fascicolo autorizzato è disponibile, mentre il tutorial ne fornisce sempre quattro.
Le parità del percorso vengono risolte per identificativo per stabilizzare il calcolo. Questa scelta non ha alcun significato aziendale. Se due candidati sono a pari merito, un identificativo più piccolo non rende uno dei due più pertinente.
Un’interfaccia di revisione può presentare il documento, i candidati, le relazioni consultate e la proposta, poi lasciare a una persona la possibilità di confermare, rifiutare o correggere. È una pista di prodotto da sviluppare, non un’interfaccia già fornita dall’estratto. Il sottografo mostra il contesto disponibile; non costituisce una spiegazione causale della validità dell’associazione.
Restano da prevedere autenticazione, API, archiviazione persistente, registrazione delle proposte, supervisione, backup, test di carico e valutazione aziendale. Versionate insieme il grafo, i dati, le regole decisionali e il modello. Una proposta deve poter essere ritrovata e contestata, non solo mostrata e poi dimenticata.
Il percorso di questo tutorial non modifica alcun fascicolo né alcun diritto. Automatizzare un’azione amministrativa costituirebbe un altro perimetro da definire e convalidare.
Sintesi
Siamo partiti da una domanda di back-office: proporre un fascicolo a partire da una nota e da relazioni già note. E5 trasforma il testo in vettori congelati; la rete relazionale combina questi vettori con i vicini autorizzati; il punteggio classifica quattro candidati; una regola distinta decide se proporre o astenersi.
Il controllo essenziale si trova negli input: rimuovere il collegamento obiettivo e la sua inversa, ricalcolare i gradi e separare le isole. Senza questo, una bella metrica può semplicemente misurare la presenza della risposta nel contesto.
I numeri mostrano poi perché occorre separare gli obiettivi. In questa riproduzione, il grafo migliora il rifiuto dei casi fuori ambito rispetto al coseno, ma non la classificazione dei fascicoli. Il modello senza archi resta vicino, e la tipizzazione delle relazioni non dimostra un guadagno sulle misure pubblicate.
Avete così un percorso per imparare a rappresentare un contesto, verificare un’aggregazione e interpretare una decisione. Il passo successivo non è trasformare il punteggio in certezza: è valutare ciò che resta errato sui documenti e sugli usi realmente previsti.
Fonti primarie e letture di approfondimento
I riferimenti iniziali del percorso sono l’articolo R-GCN, la documentazione E5 della revisione acquisita e la documentazione PyTorch 2.8 di index_add_.
I collegamenti aggiuntivi integrati nel testo approfondiscono proiezioni lineari, sigmoide, AdamW, riproducibilità e calibrazione probabilistica. Spiegano le nozioni; non aggiungono nuovi addestramenti né nuove misure al percorso r001. Per riprodurlo, conservate le versioni e i comandi dello ZIP invece di sostituirli con quelli delle documentazioni correnti.