





Imagine una pantalla de back-office a la que llegan notas de visita que deben archivarse en expedientes. La nota O-035 menciona el equipo BX-07 y el sitio Cèdre, pero ningún número de expediente. La aplicación recibe cuatro expedientes candidatos. ¿Cuál sugerir a la persona encargada de clasificar? Y, sobre todo, ¿cuándo es preferible no sugerir nada?
Si desarrolla aplicaciones web, quizá ya haya resuelto parte de este problema con búsquedas textuales y uniones. Pero dos expedientes pueden tener una redacción idéntica, y una relación conocida con un equipo no proporciona necesariamente una correspondencia segura.
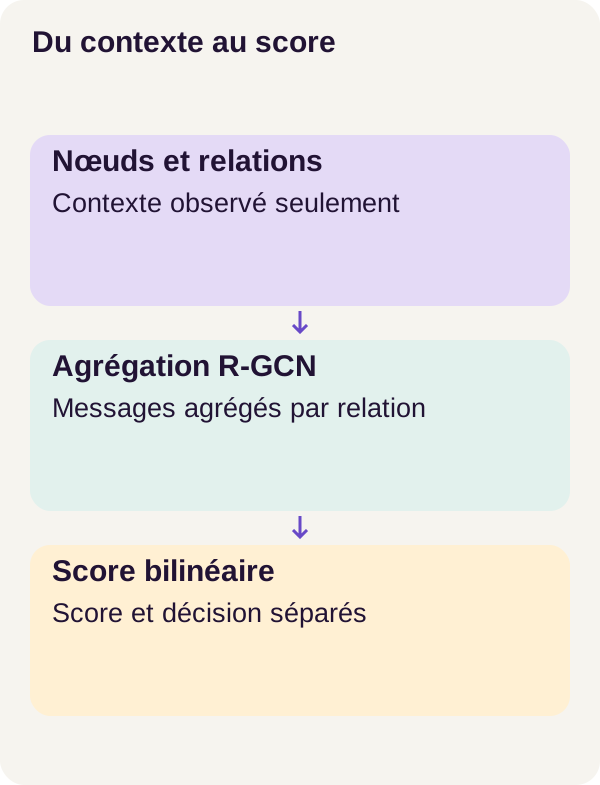
Compararemos varios enfoques: solo texto, una red neuronal sin relaciones y después una red que aprovecha un grafo, es decir, objetos conectados entre sí. Seguiremos el recorrido texto y relaciones disponibles → representaciones numéricas → puntuaciones de los cuatro candidatos → propuesta o abstención.
El objetivo es entender qué aporta realmente el contexto, sin darle discretamente la respuesta que debe encontrar. Un modelo que todavía ve en sus entradas el enlace oculto documento–expediente no resuelve el problema: vuelve a leer la solución.
Este tutorial produce una propuesta de vinculación, nunca una vinculación administrativa. Los datos son sintéticos. Los resultados describen el protocolo r001, no una validación sobre documentos de una empresa.
Descargar el proyecto completo, revisión r001
Partir de lo que realmente está disponible
Un grafo no es necesariamente una nueva base de datos
Una GED, o gestión electrónica de documentos, organiza documentos, sus metadatos y sus enlaces. En nuestro ejemplo, un documento es una nota de visita; un expediente reúne información relativa a un asunto o una intervención.
Para representar este pequeño mundo, cada objeto se convierte en un nodo: un documento, un equipo, un sitio o un expediente. Una arista es una relación orientada entre dos nodos. Su tipo indica qué significa esa relación.
Sabemos, por ejemplo, que O-035 — concerne → BX-07 y que BX-07 — situé à → Cèdre. En términos de una base relacional, se parece a asociaciones entre registros, con un sentido y una naturaleza precisos. Usar un grafo en el cálculo no significa que el fragmento Python instale o requiera una base de datos de grafos: aquí manipula tablas de nodos y relaciones.
El enlace que buscamos proponer es distinto: ¿a qué expediente debería vincularse el documento O-035? No debe estar ya presente entre las entradas utilizadas para responder.
El texto y las relaciones observadas se proporcionan al programa. El tutorial no demuestra una extracción automática de esas relaciones a partir de un PDF o de una nota libre.
Clasificar cuatro candidatos y decidir después si responder
Los cuatro expedientes candidatos también se proporcionan como entrada. El programa no los selecciona después de consultar el expediente esperado. Es una distinción importante: encontrar la respuesta correcta entre cuatro candidatos ya conocidos no equivale a buscar libremente en toda una GED.
El cálculo produce cuatro puntuaciones. El expediente mejor clasificado solo se convierte en una propuesta si su puntuación supera el umbral previsto; de lo contrario, el programa se abstiene.
Tomemos un ejemplo ficticio de puntuaciones, únicamente para entender esta regla: 0,64 ; 0,62 ; 0,21 ; 0,08. Con un umbral de 0,60, se propone el primer expediente. Sin embargo, su puntuación está cerca de la del segundo. La regla descrita examina la mejor puntuación, no la diferencia entre las dos primeras. Por construcción, no detecta toda forma de ambigüedad.
Estos cuatro valores no son necesariamente probabilidades que sumen 1. Una puntuación de 0,64 no significa «un 64 % de posibilidades de que esta vinculación sea administrativamente correcta». Volveremos a la diferencia entre puntuación y probabilidad calibrada.
Una relación ausente no es automáticamente falsa
En una GED real, un enlace que falta puede querer decir «todavía no informado». No significa necesariamente «este documento no pertenece a este expediente».
El corpus sintético ofrece aquí una ventaja experimental: su generador conoce los documentos para los que ninguno de los cuatro candidatos es correcto. Estos casos se denominan fuera de alcance. Permiten comprobar si el programa sabe rechazar una solicitud sin respuesta correcta en la lista propuesta.
El alcance del rechazo sigue siendo local: «ningún buen candidato entre estos cuatro expedientes» no significa «no existe ningún buen expediente en la empresa».
Separar islas enteras, no solo filas de datos
El corpus contiene 80 islas independientes. Una isla es un pequeño grupo de nodos y relaciones que no comparte contexto con los demás. La partición conserva 56 islas para entrenamiento, 12 para validación y 12 para prueba.
El entrenamiento ajusta los parámetros de la red. La validación sirve, en particular, para elegir los umbrales. La prueba mide después el comportamiento de la regla elegida, sin modificarla tras observarla.
Las particiones no comparten nodos, aristas, equipos ni sitios. Sin embargo, pueden seguir compartiendo palabras, tipos de documento y fragmentos de frases. Por tanto, probamos nuevos identificadores y nuevos contextos de grafo, no necesariamente un vocabulario totalmente nuevo.
Cada isla contiene cuatro expedientes. Para cada uno, seis enlaces con documentos permanecen visibles como contexto y otros seis quedan ocultos definitivamente. Cuatro documentos adicionales no tienen ningún expediente candidato correcto. El detalle de los documentos es el siguiente:
| Documentos de una isla | Cálculo según el protocolo | Número |
|---|---|---|
| Documentos con vinculación visible | 4 expedientes × 6 documentos | 24 |
| Documentos con vinculación oculta | 4 expedientes × 6 documentos | 24 |
| Documentos sin candidato correcto | Añadidos por el generador | 4 |
| Total de documentos | 24 + 24 + 4 | 52 |
Atención al recuento r001. La descripción original indica «80 islas independientes de 52 nodos», al tiempo que anuncia 5 600 nodos, de los cuales 4 160 documentos. Estas formulaciones no coinciden: 80 × 52 = 4 160, no 5 600. El detalle anterior permite recuperar 52 documentos por isla, es decir, 4 160 documentos. Se conserva el total anunciado de 5 600 nodos, pero la formulación «52 nodos por isla» debe verificarse en el corpus generado. Este cálculo no constituye un nuevo recuento de los archivos del proyecto.
Tanto para validación como para prueba, los objetivos son los 24 documentos con enlace oculto y los cuatro documentos fuera de alcance de cada una de las 12 islas. Eso da 12 × 24 = 288 casos vinculables y 12 × 4 = 48 casos fuera de alcance, es decir, 336 objetivos por partición. Los 24 documentos con enlace visible de cada isla siguen siendo contexto: no se convierten en respuestas que evaluar.
Ocultar la respuesta en ambos sentidos
Supongamos que la vinculación conocida se representa tanto por pièce → dossier como por su relación inversa dossier → pièce. Eliminar solo la primera arista dejaría disponible la misma información en el otro sentido.
Por eso, el recorrido elimina las dos orientaciones de cada enlace oculto antes de la inferencia. La inferencia es simplemente el uso del modelo para calcular una predicción, después del aprendizaje.
También hay que recalcular los grados, es decir, el número de relaciones utilizado para normalizar los mensajes. Conservar un contador antiguo mantendría una huella del grafo no enmascarado, incluso después de eliminar las aristas. Tanto las vecindades como los grados deben provenir del grafo realmente autorizado.
Esta precaución no elimina las pistas legítimas: los equipos y los sitios siguen disponibles según el protocolo. Evita que la relación objetivo se siga proporcionando, directamente o mediante un cálculo realizado antes de retirarla.
Transformar texto en vectores con E5
El modelo multilingual-e5-small, en el commit 614241f622f53c4eeff9890bdc4f31cfecc418b3, transforma los textos en embeddings. Un embedding es una lista de números que representa el texto para cálculos de similitud. Aquí, cada lista contiene 384 valores float32, números de coma flotante almacenados en 32 bits.
Estas 384 posiciones no son 384 campos de negocio a los que hayamos llamado «sitio», «equipo», etc. Son características aprendidas por el codificador. El codificador produce una representación numérica; no redacta una respuesta conversacional.
Los vectores se normalizan en L2: se divide cada vector por su longitud. En un ejemplo didáctico de dos dimensiones, [3 ; 4] tiene longitud 5 y pasa a ser [0,6 ; 0,8]. Así, los textos se comparan por la dirección de su representación y no solo por su amplitud.
Todos reciben el prefijo literal query: , incluidos los textos de los expedientes, para esta representación simétrica. La documentación E5 de la revisión utilizada describe esta elección para tareas simétricas y el uso de embeddings como características.
El recorrido rechaza una media vacía, no finita o nula, y falla por encima de 512 tokens. Un token es una unidad de texto manipulada por el modelo, no necesariamente una palabra completa. A diferencia de un proceso que recortaría silenciosamente el final, este límite se convierte en un error explícito.
E5 permanece congelado durante el aprendizaje: sus parámetros no se modifican. Aprendemos las transformaciones que usan sus vectores, no un nuevo codificador textual. Los identificadores de expedientes nunca se convierten en embeddings aprendidos individualmente; los índices del grafo sirven para encontrar filas de tablas, no para memorizar un vector entrenable por expediente.
Hacer circular el contexto adecuado
Una capa de grafo: leer vecinos sin olvidar el propio texto
Un R-GCN, por Relational Graph Convolutional Network, es una red neuronal que combina las representaciones de los nodos con las de sus vecinos, distinguiendo los tipos de relación. El artículo fundacional sobre R-GCN presenta este principio para grafos multirrelacionales.
La intuición se parece a una unión seguida de una agrupación: para un nodo destino, recuperamos sus vecinos, agrupamos sus vectores por tipo de relación y calculamos una media. Una transformación aprendida trata después cada media.
¿Por qué conservar los tipos? Porque «se refiere a un equipo» y «está situado en un sitio» no describen la misma asociación. La variante tipada puede aprender tratamientos distintos. Eso le da una posibilidad adicional, no la garantía de hacer mejores propuestas.
Para cada destino y cada relación, la capa sigue cuatro operaciones: suma los vectores de origen, divide esa suma por el número de aristas visibles correspondientes, aplica la matriz de esa relación y añade todo a una proyección del propio nodo. Una activación ReLU termina el cálculo: sustituye por cero los valores negativos.
La mecánica puede resumirse así: nueva representación = ReLU(texto transformado del nodo + contribuciones transformadas de los vecinos).
Leer las dimensiones antes de las operaciones
Un tensor es aquí una tabla de números. Con N nodos y E aristas observadas, la primera capa maneja las dimensiones siguientes:
| Objeto del código | Forma y significado |
|---|---|
features |
N × 384: un vector por nodo |
edges |
E × 3: origen, destino, tipo de relación |
relation_weights |
8 × 384 × 64 en la primera capa tipada |
| Salida de la capa | N × 64: los mismos nodos, con vectores nuevos |
Una matriz es una tabla bidimensional. Una proyección lineal combina los valores de entrada con pesos aprendidos para obtener un vector del tamaño deseado. Pasar de 384 a 64 dimensiones no elimina nodos: cambia la longitud de la representación de cada uno.
El proyecto apila dos capas: 384 → 64, y después 64 → 64. Tras una capa, un nodo puede usar la información de sus vecinos directos; tras dos, también puede recibir información que pasa por un vecino intermedio, según las orientaciones realmente presentes. No equivale a leer instantáneamente todos los caminos de un gran grafo.
El código ejecutado: una media por destino y por relación
Este es el fragmento del recorrido r001. Lea primero forward(), que realiza el cálculo; después volveremos a la inicialización.
import torch
from torch import nn
import torch.nn.functional as F


class RelationalLayer(nn.Module):
    def __init__(self, inputs, outputs, relations, layer, seed=17):
        super().__init__()
        self.self_projection = nn.Linear(inputs, outputs, bias=False)
        self.relation_weights = nn.Parameter(torch.empty(relations, inputs, outputs))
        self.relations = relations
        nn.init.xavier_uniform_(
            self.self_projection.weight,
            generator=torch.Generator().manual_seed(seed + layer),
        )
        for r in range(relations):
            nn.init.xavier_uniform_(
                self.relation_weights[r],
                generator=torch.Generator().manual_seed(seed + 100 + layer * 20 + r),
            )

    def forward(self, features, edges):
        if edges.ndim != 2 or edges.shape[1] != 3 or edges.dtype != torch.long:
            raise ValueError("Edges are source,target,relation integer rows")
        if len(edges) and (
            (edges[:, :2] < 0).any()
            or (edges[:, :2] >= len(features)).any()
            or (edges[:, 2] < 0).any()
            or (edges[:, 2] >= self.relations).any()
        ):
            raise ValueError("Invalid observed edge")
        result = self.self_projection(features)
        for r in range(self.relations):
            selected = edges[edges[:, 2] == r]
            source = selected[:, 0]
            target = selected[:, 1]
            aggregate = torch.zeros_like(features)
            degree = torch.zeros(
                len(features), dtype=features.dtype, device=features.device
            )
            # Every degree and message uses only this currently observed relation.
            aggregate.index_add_(0, target, features[source])
            degree.index_add_(
                0,
                target,
                torch.ones(len(source), dtype=features.dtype, device=features.device),
            )
            aggregate = aggregate / degree.clamp_min(1)[:, None]
            result = result + aggregate @ self.relation_weights[r]
        return F.relu(result)
El control de entrada exige una tabla de aristas bidimensional, con tres columnas y el tipo entero torch.long. Los índices de nodos deben corresponder a filas existentes de features, y los índices de relaciones deben pertenecer al intervalo previsto. Una arista hacia un nodo inexistente se rechaza antes de participar en el cálculo.
La proyección propia comienza con self.self_projection(features). Así, cada nodo conserva una contribución procedente de sus propias características, incluso si no recibe ningún mensaje. La opción bias=False significa que esta capa lineal de PyTorch no añade una constante aprendida a su transformación.
El filtrado por relación se realiza con edges[edges[:, 2] == r]. Para el tipo actual, source indica las filas que leer y target las filas de destino. Las demás relaciones no se mezclan en esta media.
La suma de mensajes utiliza aggregate.index_add_(0, target, features[source]). Imagine un GROUP BY destination que sumara vectores en vez de una columna de importes. Si varias fuentes tienen el mismo destino, sus valores se añaden en la misma fila. El sufijo _ indica aquí que el tensor de acumulación se modifica en el sitio. La documentación de index_add_ precisa esta operación.
Un segundo index_add_ suma 1 a los mismos destinos. Obtiene los grados para esta relación y este grafo observado, no grados recuperados antes del enmascaramiento.
La división transforma cada suma en una media. degree.clamp_min(1) sustituye los grados nulos por 1 para evitar una división por cero. No crea un vecino ficticio: una suma vacía sigue valiendo cero, y 0 / 1 sigue siendo cero. [:, None] coloca el grado en forma de columna para dividir todos los componentes de un mismo nodo por el mismo número.
La transformación de relación interviene con aggregate @ self.relation_weights[r]. El símbolo @ designa el producto matricial. La contribución transformada se añade al resultado, y F.relu(result) termina la capa.
La clase inicializa sus matrices con Xavier y semillas determinadas por seed, la capa y la relación. Una semilla fija el punto de partida de un generador seudoaleatorio. Hace controlable la inicialización; por sí sola no sustituye todos los controles necesarios para una reanudación reproducible.
Un cálculo pequeño para comprobar qué hace la máscara
Tomemos un ejemplo didáctico de dos dimensiones, independiente de los resultados del corpus. Dos vecinos envían [2 ; 4] y [6 ; 0] al mismo destino, mediante la misma relación.
La suma vale [8 ; 4], el grado vale 2 y la media [4 ; 2]. Si la matriz de relación elegida para este ejemplo conserva el primer componente y duplica el segundo, su contribución pasa a ser [4 ; 4]. Con una proyección propia igual a [1 ; −1], la suma vale [5 ; 3], sin cambios por ReLU.
Ahora eliminemos la segunda arista. La media correcta es [2 ; 4] / 1 = [2 ; 4]. Reutilizar el antiguo grado 2 daría [1 ; 2]: la representación seguiría dependiendo del vecino eliminado por su contador anterior.
Si eliminamos todas las aristas, la contribución de los vecinos se vuelve nula, pero no necesariamente la salida. La proyección propia de este ejemplo sigue siendo [1 ; −1] y ReLU da [1 ; 0].
En el fragmento se ven otros dos límites. No conoce las anotaciones ocultas: los enlaces objetivo deben haberse retirado antes de la llamada. Y no deduplica las aristas: una misma fila repetida participa varias veces en la suma y el grado. Por tanto, la validez de los índices no basta para garantizar la calidad del grafo proporcionado.
Pasar de vectores a puntuaciones y comparar las variantes
Tras las dos capas, el programa compara la representación del documento con la de cada expediente mediante una puntuación bilineal. El principio consiste en combinar dos vectores con pesos aprendidos para producir un número de compatibilidad. La palabra «bilineal» describe el cálculo; no significa que se haya probado la relación de negocio. El fragmento anterior muestra la capa relacional, no toda la cabeza de puntuación ni todo el bucle de aprendizaje del ZIP.
Las puntuaciones neuronales utilizadas para decidir pasan por una sigmoide, una función que transforma una puntuación bruta en un valor entre 0 y 1. Vale 0,5 para una puntuación bruta nula y aumenta con ella. Su definición en PyTorch completa el mecanismo. Aplicar una sigmoide no demuestra que los valores obtenidos sean probabilidades fiables de vinculación.
La comparación distingue cuatro enfoques. El coseno E5 compara directamente los vectores textuales normalizados: es la referencia de solo texto, no un simple motor de palabras clave. mlp elimina las aristas y conserva una red que transforma las características de los nodos. untyped usa las aristas, pero reúne todos sus tipos en una sola relación. Por último, typed aplica ocho transformaciones relacionales distintas.
Las variantes reutilizan los mismos candidatos, los mismos vectores E5 y los mismos enmascaramientos. Sus números de parámetros no son estrictamente idénticos. Por tanto, comparamos decisiones en un corpus preciso, sin atribuir automáticamente toda diferencia al mero tipado de las relaciones.
Ejecutar todas las etapas, en el orden correcto
Preparar el entorno
Debe poder leer Python, utilizar un terminal y ejecutar Docker. Ya se han introducido las operaciones numéricas necesarias: tablas, medias, matrices y puntuaciones. No es necesario haber desarrollado antes una red de grafos.
Descomprima el ZIP en un directorio nuevo y abra el terminal en su raíz. Todos los comandos siguientes parten de esta carpeta. Use el perfil GPU previsto por el proyecto. Antes de iniciarlo, consulte su README para conocer los recursos necesarios y las condiciones de instalación.
El preflight controla Docker, Compose, la GPU, la memoria y el espacio disponible. setup.sh prepara el proyecto; después Compose verifica su configuración y construye los servicios.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference calibration
Compruebe los diagnósticos antes de continuar. Un error de entorno no se resuelve modificando el modelo ni cambiando sus umbrales.
Adquirir E5 y verificar después un cálculo real en Docker
El servicio acquisition descarga nueve archivos E5 bloqueados, controlados por tamaño y huella SHA-256. Una huella permite comprobar la identidad de los archivos adquiridos, no su calidad predictiva.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
check_environment.py ejecuta E5 en Docker. Ver la GPU con nvidia-smi en el host no demuestra que funcione este cálculo en contenedor. Después, pytest -q ejecuta las pruebas del proyecto. Compruebe que pasan antes de continuar: una prueba del programa y una medida de calidad de las propuestas no controlan lo mismo.
Los servicios de cálculo no descargan ningún controlador ni exponen puertos del host. Montar un entorno de cálculo y ejecutar una API pública son dos temas distintos.
Construir los datos y observar las entradas
docker compose run --rm tutorial python -m ged_rattachement_graphe.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rattachement_graphe.cli encode --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rattachement_graphe.cli baseline --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rattachement_graphe.cli inspect-mechanism --config configs/minimum.yaml
prepare construye el corpus. Es el momento de controlar las islas, las particiones y los recuentos, en particular la distinción entre documentos y el conjunto de nodos. encode calcula los vectores E5. La referencia baseline sirve como punto de comparación textual; después, inspect-mechanism permite examinar el mecanismo antes de aprender las variantes.
Para un documento como O-035, hágase tres preguntas al inspeccionar las entradas: ¿cuáles son los cuatro candidatos? ¿Qué relaciones son visibles? ¿Siguen presentes el enlace que se debe predecir, su inverso o un grado calculado antes de retirarlo? Un ejemplo inspeccionado suele aportar más que una puntuación agregada mostrada demasiado pronto.
Aprender las variantes y fijar la decisión
sh scripts/train_variants.sh
docker compose run --rm calibration python -m ged_rattachement_graphe.cli calibrate --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_rattachement_graphe.cli evaluate --config configs/minimum.yaml
train_variants.sh ejecuta typed, untyped y mlp. calibrate elige los umbrales en validación y después evaluate mide los resultados con esa regla fijada.
En cada época, es decir, en cada pasada de aprendizaje sobre los ejemplos previstos, se enmascaran temporalmente tres de los seis enlaces visibles de cada expediente de entrenamiento, junto con sus inversos. La red debe aprender sin disponer en su contexto inmediato del enlace retirado. Los enlaces ocultos definitivamente, en cambio, nunca se reintroducen.
Distinga bien ambos mecanismos: un enmascaramiento temporal crea una situación de aprendizaje a partir del contexto autorizado; el enmascaramiento permanente mantiene la separación del protocolo. Ninguno debe anularse para obtener artificialmente una predicción mejor.
El proyecto entrena durante treinta épocas, con cuatro islas por batch. Un batch es el grupo de ejemplos tratado en una etapa de aprendizaje. El optimizador AdamW usa una tasa de aprendizaje de 0,003, un weight decay de 0,001 y un clipping de norma 1.
Un optimizador ajusta los pesos a partir de los gradientes, las variaciones del error respecto a esos pesos. La tasa de aprendizaje regula la amplitud de las actualizaciones; el weight decay reduce los pesos según la regla de AdamW; el clipping limita la norma de gradientes demasiado grandes. La documentación de AdamW profundiza en el papel del optimizador. Estos ajustes identifican el experimento; no prometen su éxito.
Reanudar un aprendizaje no consiste solo en recargar los pesos
El recorrido prevé una interrupción tras doce épocas y una reanudación que debe recuperar exactamente el recorrido continuo. El checkpoint, o punto de guardado, conserva los pesos, el optimizador, el sampler que determina el orden de los ejemplos y los estados de los generadores aleatorios.
Recargar únicamente los pesos puede dar un modelo que se parece al interrumpido sin reproducir sus siguientes actualizaciones. Por eso, el control compara los estados necesarios para continuar, no solo una métrica final parecida.
Este requisito sigue ligado al entorno. La documentación de PyTorch sobre reproducibilidad advierte que la identidad de los resultados no está garantizada entre versiones y plataformas; index_add_ también contiene una reserva acerca de CUDA. Por tanto, una semilla fija no basta para anunciar una reproducibilidad universal. Conserve las versiones del ZIP y compruebe los resultados de los controles de reanudación.
Leer las métricas antes que las cifras
Primero: ¿el expediente correcto está bien clasificado?
Top-1 mide la proporción de documentos vinculables para los que el expediente correcto llega primero. MRR, por Mean Reciprocal Rank, es la media de los inversos de los rangos del expediente correcto. No es ni el rango medio ni el inverso de ese rango medio.
Si dos documentos tienen su expediente correcto en los rangos 1 y 2, Top-1 vale 1 / 2 = 0,50. MRR vale (1/1 + 1/2) / 2 = 0,75. El inverso del rango medio daría 1 / 1,5, aproximadamente 0,667: es otro cálculo.
En este tutorial, estas dos medidas se aplican a los 288 documentos con un buen candidato, incluso si el umbral lleva después a abstenerse en algunos. Miden la clasificación, no el número de propuestas enviadas a un usuario.
Después: ¿qué propuestas se emiten y cuáles son correctas?
La precisión aceptada cuenta las propuestas correctas entre las realmente emitidas. La cobertura cuenta las propuestas emitidas entre los 336 objetivos, sean correctas o no. El recall de rechazo cuenta los casos fuera de alcance rechazados entre los 48 casos fuera de alcance.
Por último, la tasa global de decisiones correctas suma las propuestas correctas y los rechazos correctos, y divide por 336. Abstenerse para un documento que tiene un buen candidato no cuenta como una buena decisión en este cálculo.
Tomemos un ejemplo ficticio de diez documentos: ocho tienen un expediente correcto y dos no. El programa emite seis propuestas, cinco correctas, y rechaza cuatro documentos, entre ellos los dos casos fuera de alcance.
Su precisión aceptada vale 5/6 ≈ 0,8333, su cobertura 6/10 = 0,60, su recall de rechazo 2/2 = 1 y su tasa global (5 + 2)/10 = 0,70. Rechaza perfectamente los casos fuera de alcance, pero también rechaza dos documentos que podría haber vinculado. Una buena medida de rechazo no basta, por tanto, para describir todo el comportamiento.
Sin ninguna propuesta, la precisión aceptada es indefinida: no hay denominador. No pasa a valer 1 por convención. Del mismo modo, una cobertura alta no significa que los expedientes propuestos sean correctos.
Elegir un umbral sin ajustar la prueba a posteriori
El recorrido explora los umbrales solo en validación. Para el coseno, la cuadrícula va de −1 a 1 en pasos de 0,01. Para las puntuaciones sigmoides, va de 0 a 1 en pasos de 0,05.
En caso de empate, la regla retiene el valor cercano a 0 para el coseno o a 0,5 para la sigmoide y después el umbral inferior. Este desempate se fija antes de leer la prueba. El artículo no reproduce el criterio completo de optimización de calibrate: consulte su implementación en el ZIP en lugar de deducir un objetivo no especificado.
La palabra calibración designa aquí esta elección de umbral. No basta para establecer una calibración probabilística, que exigiría comprobar si los niveles de confianza anunciados corresponden a las frecuencias de éxito observadas. La documentación de scikit-learn sobre calibración de probabilidades explica esta distinción; no es una etapa adicional ejecutada por este proyecto.
Una vez elegido el umbral, la prueba describe esta regla preexistente. Modificarla porque una cifra de prueba no gusta haría perder esta separación.
Resultados observados y su alcance
La clasificación sigue siendo idéntica
En los 336 objetivos de prueba, todas las variantes principales obtienen Top-1 = 0,50 y MRR = 0,75 en los 288 casos vinculables. Por tanto, el grafo tipado no lo hace mejor que los otros métodos al colocar el expediente correcto en primera posición en esta reproducción.
No confundamos esta constatación con una ausencia total de diferencia. La regla de propuesta y rechazo puede cambiar, aunque la clasificación no mejore.
Reconstruir las decisiones del grafo tipado
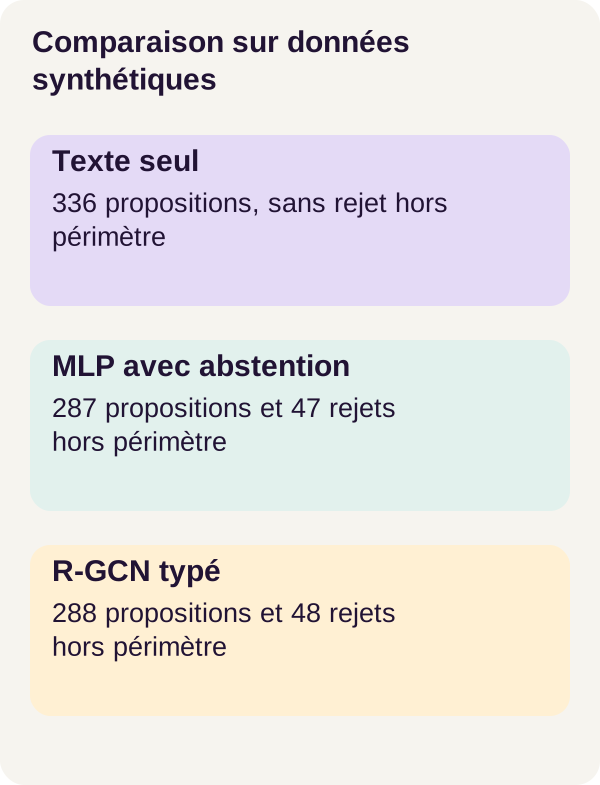
Con el umbral de validación 0,40, typed acepta 288 objetivos, propone 144 correctamente y rechaza los 48 casos fuera de alcance.
Los recuentos permiten leer sus medidas sin jerga: la precisión aceptada es 144/288 = 0,50, la cobertura es 288/336 = 0,857143 y la tasa global vale (144 + 48)/336 = 0,571429. El recall de rechazo vale 48/48 = 1.
Por tanto, el programa no propone un expediente incorrecto a los 48 documentos fuera de alcance, pero la mitad de las 288 propuestas emitidas sigue siendo incorrecta. Un rechazo perfecto en esta población no hace fiable la clasificación.
Comparar sin atribuir al grafo una ganancia que no demuestra
El coseno usa un umbral de 0. untyped usa 0,30 y obtiene los mismos recuentos que typed. Los resultados publicados no precisan el umbral del MLP; la tabla compara las decisiones comunicadas, sin atribuirle un umbral adicional.
En móvil, desplácese horizontalmente por la tabla.
| Método | Propuestas emitidas | Propuestas correctas | Fuera de alcance rechazados, de 48 | Precisión aceptada | Tasa global correcta |
|---|---|---|---|---|---|
| Coseno E5, solo texto | 336 | 144 | 0 | 0,428571 | 0,428571 |
mlp, sin aristas |
287 | 143 | 47 | 0,498258 | 0,565476 |
untyped, relación única |
288 | 144 | 48 | 0,50 | 0,571429 |
typed, relaciones diferenciadas |
288 | 144 | 48 | 0,50 | 0,571429 |
Para el coseno, aceptar los 336 objetivos también significa proponer un expediente a los 48 documentos que no tienen ninguno correcto en la lista. Por ello, su precisión vale 144/336 = 0,428571. Aquí, el grafo tipado mejora el rechazo respecto a esta referencia, no Top-1 ni MRR.
Los resultados del MLP también son instructivos. Con 287 propuestas, rechaza 336 − 287 = 49 documentos. Entre ellos, 47 están fuera de alcance: los otros dos tienen, por tanto, un buen candidato. Este detalle es una deducción aritmética de los recuentos publicados, no un nuevo análisis de las predicciones individuales.
Su tasa global se explica por (143 + 47)/336 = 0,565476. Está cerca de la de los grafos. Por tanto, no se puede atribuir al solo contexto relacional toda la diferencia respecto al coseno, ni anunciar que distinguir los tipos de relación mejora necesariamente el resultado.
El resultado que debe retenerse es limitado pero claro: los grafos estudiados rechazan mejor los casos fuera de alcance que el solo texto en este protocolo, sin clasificar mejor los buenos expedientes. Estas medidas sobre datos sintéticos no validan ni una vinculación de negocio ni el aporte causal de una relación concreta.
Ejercicio: probar la hipótesis antes de corregirla
Predecir el efecto antes de medirlo
Volvamos a O-035. Disponemos de su texto y de una relación con BX-07. Si este canal relacional aporta información útil, ¿qué debería ocurrir al retirarlo? ¿Cambiará la clasificación? ¿Habrá menos propuestas? ¿Serán mejores o peores los rechazos?
Escriba su hipótesis antes de la ejecución. El efecto puede ser positivo, nulo o negativo. Un enlace que parece intuitivamente útil no mejora necesariamente el comportamiento medido.
Retirar un canal de contexto para observar su papel constituye una ablación. Aquí el experimento no se limita a eliminar la arista en un modelo ya entrenado: entrena la variante no-equipment durante treinta épocas, con los mismos candidatos y los mismos vectores E5. Su umbral se elige de nuevo en validación.
Es una comparación de variantes reentrenadas, no una simple perturbación de última hora de las entradas de un modelo fijo. Como el texto se conserva, retirar el enlace documento–equipo no elimina necesariamente la mención textual del equipo.
Ejecutar la variante y su evaluación
docker compose run --rm learning python -m ged_rattachement_graphe.cli exercise --config configs/minimum.yaml
docker compose run --rm inference python -m ged_rattachement_graphe.cli predict --config configs/minimum.yaml --variant no-equipment --mode continuous
docker compose run --rm calibration python -m ged_rattachement_graphe.cli calibrate-exercise --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_rattachement_graphe.cli evaluate-exercise --config configs/minimum.yaml
exercise realiza el experimento previsto, predict produce las salidas de no-equipment y luego calibrate-exercise y evaluate-exercise aplican la misma separación validación/prueba. Las salidas iniciales siguen protegidas por hash: el ejercicio no debe sobrescribir discretamente el punto de comparación.
Comparar con las observaciones proporcionadas
En los resultados r001, no-equipment emite 287 propuestas, de las que 143 son correctas, y rechaza 47 de los 48 casos fuera de alcance. Estos recuentos están cerca del grafo inicial e idénticos a los recuentos del MLP comunicados antes. Recuentos iguales no prueban que los errores afecten a los mismos documentos: esta cuestión exige comparar las salidas documento por documento.
Por tanto, no puede concluir «la relación con el equipo garantiza el expediente correcto». Tampoco puede concluir que sea inútil en toda GED. El resultado describe este corpus, esta arquitectura, este entrenamiento y esta regla de decisión.
La corrección consiste en confrontar su hipótesis con las propuestas y los rechazos, y después examinar ejemplos. Para prolongar el razonamiento a mano, retome los dos vectores de la sección anterior: si elimina una arista, deben cambiar el numerador y el grado. Esta comprobación local permite comprender una causa de fuga antes de mirar una puntuación final.
Producir las figuras y controlar los guardados
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Las figuras completan la evaluación; los controles de checkpoints verifican los estados esperados del recorrido. Conserve las salidas que deba estudiar antes de la limpieza presentada a continuación. Una curva no sustituye la inspección del documento, de sus candidatos y de su contexto visible.
Depurar, limpiar y pasar a un producto
Distinguir un fallo de entorno de un error de modelo
¿La GPU no es accesible en Docker? Siga el diagnóstico del preflight, corrija el entorno del host y vuelva a empezar en una carpeta recién extraída. Un estado nvidia-smi en el host no sustituye el cálculo E5 en el contenedor.
¿Falla la adquisición? Compruebe los archivos bloqueados, su tamaño y su SHA-256. No sustituya otro modelo u otra revisión para hacer desaparecer el error: cambiaría las condiciones del experimento.
¿Falla un control de checkpoint? Conserve los elementos útiles para el diagnóstico. La limpieza suministrada solo elimina outputs; no repara ni sustituye los checkpoints conservados. Para un nuevo recorrido completo, una extracción nueva evita mezclar estados de varios intentos.
Antes de limpiar, copie los resultados y las figuras que quiera conservar. Los comandos siguientes detienen el proyecto, muestran y después eliminan únicamente outputs, y terminan el recorrido. Los datos, modelos y checkpoints permanecen presentes. No se necesita ninguna limpieza global de Docker.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Comprender qué aporta el aislamiento
Los servicios utilizan el UID y el GID del usuario, es decir, sus identificadores de sistema. Su sistema raíz es de solo lectura; solo las zonas necesarias para el papel de cada servicio se montan con escritura. El proyecto elimina capacidades adicionales de Linux, usa no-new-privileges, fija límites de CPU, memoria y procesos, y prevé un espacio temporal en tmpfs.
La adquisición puede acceder a los archivos públicos bloqueados. Los servicios de cálculo funcionan con la red desactivada. Esta separación ayuda a mantener el recorrido dentro de su alcance previsto; no es una certificación de seguridad frente a un administrador de Docker.
Pasar de una puntuación a una interfaz de revisión
En una aplicación real, comience por definir con los equipos de negocio qué es una vinculación correcta, qué documentos están afectados y de dónde proceden los expedientes candidatos. Constituya anotaciones y una evaluación representativas antes de sustituir el corpus ficticio.
Los permisos deben intervenir antes de la puntuación: el primer puesto correcto en una clasificación no autoriza a mostrar un expediente confidencial. También hay que decidir qué hacer cuando no hay ningún expediente autorizado disponible, mientras que el tutorial siempre proporciona cuatro.
Los empates del recorrido se resuelven por identificador para estabilizar el cálculo. Esta elección no tiene ningún sentido de negocio. Si dos candidatos empatan, un identificador más pequeño no hace a uno más pertinente que el otro.
Una interfaz de revisión puede presentar el documento, los candidatos, las relaciones consultadas y la propuesta, y después dejar que una persona confirme, rechace o corrija. Es una vía de producto por desarrollar, no una interfaz ya proporcionada por el fragmento. El subgrafo muestra el contexto disponible; no constituye una explicación causal de la validez de la vinculación.
Aún hay que prever autenticación, API, almacenamiento persistente, registro de las propuestas, supervisión, copias de seguridad, pruebas de carga y evaluación de negocio. Versione juntos el grafo, los datos, las reglas de decisión y el modelo. Una propuesta debe poder encontrarse y cuestionarse, no solo mostrarse y luego olvidarse.
El recorrido de este tutorial no modifica ningún expediente ni ningún permiso. Automatizar una acción administrativa constituiría otro alcance que habría que definir y validar.
Síntesis
Partimos de una pregunta de back-office: proponer un expediente a partir de una nota y de relaciones ya conocidas. E5 transforma el texto en vectores congelados; la red relacional combina esos vectores con los vecinos autorizados; la puntuación clasifica cuatro candidatos; una regla distinta decide proponer o abstenerse.
El control esencial está en las entradas: retirar el enlace objetivo y su inverso, recalcular los grados y separar las islas. Sin ello, una buena métrica puede limitarse a medir la presencia de la respuesta en el contexto.
Las cifras muestran después por qué hay que separar los objetivos. En esta reproducción, el grafo mejora el rechazo de casos fuera de alcance respecto al coseno, pero no la clasificación de expedientes. El modelo sin aristas sigue estando cerca, y el tipado de las relaciones no demuestra una ganancia en las medidas publicadas.
Dispone así de un recorrido para aprender a representar un contexto, verificar una agregación e interpretar una decisión. El siguiente paso no es transformar la puntuación en certeza: es evaluar lo que sigue siendo incorrecto en los documentos y usos realmente previstos.
Fuentes primarias y lecturas complementarias
Las referencias iniciales del recorrido son el artículo R-GCN, la documentación E5 de la revisión adquirida y la documentación PyTorch 2.8 de index_add_.
Los enlaces complementarios integrados en el texto profundizan en proyecciones lineales, la sigmoide, AdamW, la reproducibilidad y la calibración probabilística. Explican las nociones; no añaden nuevos entrenamientos ni nuevas medidas al recorrido r001. Para reproducirlo, conserve las versiones y los comandos del ZIP en lugar de sustituirlos por los de las documentaciones actuales.