





Vous avez peut-être déjà copié le texte d’un PDF dans un éditeur : tous les mots sont là, mais les phrases ne se suivent plus. Une ligne de la colonne gauche s’intercale dans celle de droite. Un encadré arrive au milieu d’un paragraphe. Le pied de page se retrouve avant la fin du texte.
Le problème n’est pas forcément la reconnaissance des caractères. Retrouver les mots et retrouver leur ordre de lecture sont deux tâches différentes.
Dans ce tutoriel, nous allons entraîner un petit réseau de neurones à répondre à une question très précise : « Entre ces deux lignes, laquelle devrait être lue en premier ? » Nous utiliserons ensuite ces comparaisons pour reconstruire l’ordre d’une page entière.
Pas de grand modèle de langage à interroger, ni de texte à lui faire résumer. Notre modèle ne reçoit que des positions et des tailles de police. L’occasion de comprendre, avec du Python et un cas visuel, comment on passe de données observables à un apprentissage, puis à un résultat que l’on peut contrôler.
Télécharger le projet complet du tutoriel
Les commandes et les mesures présentées suivent le parcours de référence r004 du projet. Les petits exemples ajoutés pour expliquer les calculs sont des illustrations pédagogiques, pas des résultats supplémentaires de ce parcours.
Le résultat que nous visons
Notre fil rouge est un bulletin fictif, « Boreal Maintenance Bulletin ». Il contient un titre sur toute la largeur, deux colonnes de lignes « Check valve …: stable », un encadré de notices et deux lignes de pied de page.
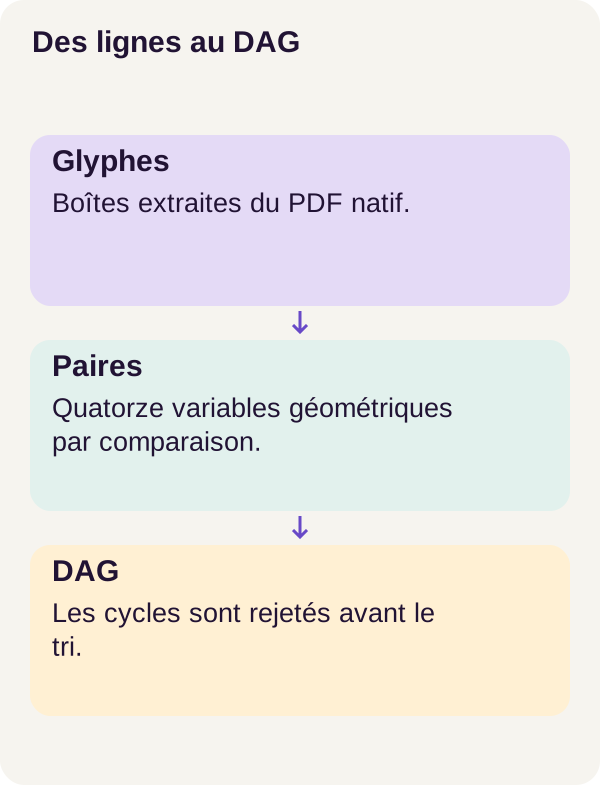
À l’œil, vous repérez des blocs. Un programme doit, lui, reconstruire ce chemin de lecture à partir de ce qu’il extrait. Il commence par retrouver les glyphes, les formes des caractères, puis les regroupe en lignes. Il attribue ensuite un rang à chaque ligne et produit deux sorties complémentaires : un Markdown pour lire le texte dans l’ordre proposé, et une surimpression SVG qui numérote les lignes sur la page.
Le SVG sert donc à comprendre une décision, pas seulement à illustrer le tutoriel. Si une notice est insérée trop tôt, vous pouvez retrouver sa position et son numéro dans la page.
Un détail rend l’expérience intéressante : le générateur mélange volontairement l’ordre de dessin des objets dans le PDF. Le programme ne peut pas simplement suivre ce flux pour retrouver la réponse. Pour un développeur web, imaginez des blocs dont l’ordre visuel ne correspond pas à leur ordre dans le DOM : parcourir les éléments ne suffit plus à déduire le parcours souhaité.
Le modèle ne reçoit ni le texte, ni les identifiants des lignes, ni leur ordre de référence. Le texte reste disponible pour les exports, mais n’entre pas dans son calcul. Les annotations, c’est-à-dire les réponses attendues, servent séparément à l’entraînement et à l’évaluation. Le service de prédiction fonctionne sans elles.
Le périmètre reste précis : des PDF natifs, dont les caractères peuvent être extraits. Le projet ne réalise pas d’OCR, la reconnaissance de texte dans une image, et ne valide aucun document métier réel.
Les repères nécessaires avant le code
Retrouver les lignes dans le même repère
Commençons par une notion familière en développement d’interface : une boîte qui entoure un élément. Ici, chaque caractère extrait possède une boîte, notée x0, y0, x1, y1. Dans le repère final utilisé par le projet, ces valeurs désignent les bords gauche, haut, droit et bas.
Il faut toutefois préparer ce repère. Dans le repère classique du PDF, l’origine se situe en bas à gauche. Le projet applique le recadrage CropBox et la rotation, puis transforme chaque boîte une seule fois vers un repère commun dont l’origine est en haut à gauche. La CropBox définit la zone de page conservée pour l’affichage ; les rotations à 90° et 270° échangent largeur et hauteur.
Pourquoi s’en préoccuper avant le modèle ? Parce qu’une erreur de coordonnées peut faire passer une colonne droite pour une colonne gauche. Le réseau apprendrait alors sur des positions qui ne décrivent pas correctement ce que vous voyez.
Les caractères proches sur une même rangée sont ensuite regroupés. Les glyphes de « Check valve 0020: stable » deviennent une ligne avec son texte, sa boîte et une taille de police moyenne. Un très grand espace entre deux groupes de caractères les sépare : on ne veut pas souder deux colonnes en une seule ligne.
Cette extraction peut déjà se tromper. Le classement ne fera pas réapparaître une ligne perdue. Nous mesurerons donc séparément la présence des lignes et la qualité de leur ordre.
Transformer deux lignes en 14 nombres
Le réseau ne manipule pas directement des boîtes ou des paragraphes. Nous lui transmettons un vecteur de caractéristiques : une liste de nombres décrivant ce qui nous intéresse.
Pour chaque ligne, nous prenons les quatre coordonnées de sa boîte et sa taille de police. Les coordonnées horizontales sont divisées par la largeur de la page ; les coordonnées verticales et la taille de police, par sa hauteur. C’est la normalisation.
Un petit exemple suffit : une position horizontale de 60 sur une page large de 600 devient 60 / 600 = 0,10. Une position de 120 sur une page large de 1 200 donne aussi 0,10. Dans les deux cas, la ligne commence à 10 % de la largeur. Nous comparons ainsi des positions relatives plutôt que des distances brutes.
Une paire reçoit les cinq valeurs de la première ligne, puis les cinq de la seconde. Nous ajoutons l’écart horizontal, l’écart vertical et les recouvrements sur les deux axes. Cela fait 5 + 5 + 4 = 14 caractéristiques.
Un recouvrement horizontal signifie que les boîtes occupent en partie les mêmes positions de gauche à droite ; il n’implique pas que leurs rectangles se touchent. Deux lignes superposées dans une colonne peuvent se recouvrir horizontalement sans se recouvrir verticalement.
Apprendre une préférence, pas encore un classement
Pour chaque paire, le modèle produit un logit, un score brut qui peut être négatif ou positif. Une fonction appelée sigmoïde le transforme en une valeur entre 0 et 1, interprétée ici comme la probabilité que la première ligne précède la seconde.
Avec un score converti en 0,90, le modèle privilégie la première ligne ; avec 0,10, il privilégie la seconde. À 0,50, il ne privilégie aucune des deux. Ces valeurs expriment sa prédiction, pas une certitude sur la page.
Pendant l’entraînement, nous disposons de la bonne réponse, appelée cible ou label. Elle vaut 1 si la première ligne doit précéder la seconde, 0 sinon. Une fonction de perte mesure l’erreur : ici, la BCE, ou entropie croisée binaire. Si la cible vaut 1, annoncer 0,01 est davantage pénalisé qu’annoncer 0,90.
Le calcul de la perte utilise directement les logits. Le complément documentaire utile est BCEWithLogitsLoss de PyTorch : réunir la sigmoïde et la BCE permet un calcul plus stable que de les appliquer séparément. Il ne faut donc pas confondre la probabilité que nous utilisons pour expliquer le résultat avec la valeur brute transmise à la fonction de perte.
Passer des préférences à une page lisible
Supposons maintenant que le modèle préfère A avant B, B avant C, mais C avant A. Impossible de respecter les trois décisions à la fois : nous revenons au point de départ. C’est un cycle.
Le décodeur est le morceau de code qui transforme ces préférences en une liste. Celui du projet examine les relations les plus affirmées d’abord et ne conserve une flèche que si elle ne crée pas de cycle. L’ensemble obtenu est un DAG, un graphe orienté sans cycle. Chaque ligne est un sommet ; chaque flèche signifie « doit précéder ».
Un tri topologique peut alors produire un ordre qui respecte les flèches conservées. Pensez à des tâches de déploiement : une tâche devient disponible lorsque ses prérequis ont été traités. La documentation Python sur les graphes explique ce principe ; le tutoriel utilise son propre décodeur, présenté plus bas.
Retenez la séparation : le réseau estime les préférences ; le décodeur construit l’ordre final. Éliminer les cycles rend cet ordre cohérent avec les relations conservées, mais ne garantit ni l’ordre global optimal, ni le bon ordre de lecture.
Des données contrôlées pour apprendre le mécanisme
Le corpus est synthétique : le programme génère les pages et connaît leur ordre de référence. Il contient 60 familles de géométrie, avec 10 pages par famille, soit 600 pages. Une famille regroupe des pages partageant une géométrie de mise en page.
La séparation se fait par famille, avant tout entraînement. 42 familles, soit 420 pages, servent à apprendre ; 9 familles, soit 90 pages, servent à la validation ; les 9 familles restantes, soit 90 pages, sont réservées au test.
L’entraînement ajuste les paramètres. La validation permet de suivre la qualité du modèle sans apprendre directement sur ces pages. Le test sert à mesurer le résultat final. Répartir les familles, plutôt que mélanger leurs pages au hasard, évite qu’une même famille se retrouve à la fois dans l’entraînement et dans le test. Cela ne transforme pas pour autant un corpus synthétique en échantillon représentatif de tous les PDF.
Revenons à Boreal. Sur une première page, « Check valve 0000: stable » se trouve dans la colonne gauche, « Check valve 0020: stable » dans celle de droite et « Notice 00-00-0 » dans l’encadré. Vous pouvez lire ces textes pour suivre l’exemple ; le modèle, lui, doit décider où placer les lignes sans lire ces chaînes.
Le parcours observé compte 232 570 paires de lignes. Le contrôle des entrées confirme des vecteurs de 14 dimensions, sans texte ni identifiant. Les labels servent à fabriquer les cibles d’entraînement et à comparer les prédictions aux réponses attendues, mais ne sont pas ajoutés à ces vecteurs.
Lors de l’inférence, c’est-à-dire l’utilisation du modèle entraîné pour prédire, le dossier des labels est absent du conteneur. Le code échoue explicitement s’il est monté. C’est une séparation concrète entre « disposer du corrigé pour apprendre » et « accéder au corrigé pendant que l’on prétend prédire ».
Le code central : construire les entrées du modèle
Nous allons lire trois morceaux : la préparation des paires, le réseau et le décodeur. Les extraits sont ceux des modules du ZIP ; ils se lisent dans leur environnement de projet, pas comme un script autonome à copier dans un fichier vide.
pair_features() : préparer ce que le réseau peut voir
Voici les fonctions de src/pdforder/features.py. first et second décrivent deux lignes. Pour chaque paire, nous préparons les deux orientations : la première suivie de la seconde, puis l’inverse.
def pair_features(first, second, width, height):
    a = [
        first["bbox"][0] / width,
        first["bbox"][1] / height,
        first["bbox"][2] / width,
        first["bbox"][3] / height,
        first["font_size"] / height,
    ]
    b = [
        second["bbox"][0] / width,
        second["bbox"][1] / height,
        second["bbox"][2] / width,
        second["bbox"][3] / height,
        second["font_size"] / height,
    ]
    overlap_x = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    overlap_y = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    return a + b + [b[0] - a[0], b[1] - a[1], overlap_x, overlap_y]


def page_pairs(page, device="cpu"):
    lines = page["lines"]
    pairs = [(i, j) for i in range(len(lines)) for j in range(i + 1, len(lines))]
    forward = torch.tensor(
        [
            pair_features(lines[i], lines[j], page["width"], page["height"])
            for i, j in pairs
        ],
        dtype=torch.float32,
        device=device,
    ).reshape(-1, 14)
    reverse = torch.tensor(
        [
            pair_features(lines[j], lines[i], page["width"], page["height"])
            for i, j in pairs
        ],
        dtype=torch.float32,
        device=device,
    ).reshape(-1, 14)
    return pairs, forward, reverse
Dans pair_features(), a et b sont deux listes de cinq nombres. Le + les concatène : il ne fait pas une addition terme à terme. La valeur renvoyée contient bien 14 nombres, dans un ordre fixe.
overlap_x et overlap_y mesurent la longueur commune des intervalles sur chaque axe, dans les coordonnées normalisées. Si les intervalles ne se recouvrent pas, max(0, ...) renvoie zéro. Ce ne sont pas des pourcentages de surface commune.
La dernière partie ajoute les écarts entre les coins supérieurs gauches. Deux lignes à la même hauteur ont un écart vertical proche de zéro ; deux colonnes éloignées produisent un écart horizontal important. Le réseau pourra combiner ces indices avec les dimensions des boîtes et les tailles de police.
page_pairs() énumère ensuite les couples d’indices avec i < j. Il n’associe pas une ligne à elle-même et ne liste qu’une fois chaque paire, tout en construisant ses deux orientations. Avec quatre lignes, par exemple, on obtient six paires : (0, 1), (0, 2), (0, 3), (1, 2), (1, 3) et (2, 3).
forward et reverse deviennent des tenseurs, ici des tableaux numériques à deux dimensions. Chaque rangée décrit une paire avec 14 colonnes. Dans reshape(-1, 14), le -1 laisse PyTorch déduire le nombre de rangées. float32 indique le format numérique ; device détermine où les données sont placées pour le calcul. La valeur par défaut "cpu" dans cette fonction ne constitue pas une validation du parcours complet sur CPU.
En observant ces entrées, on comprend ce que le modèle peut apprendre : des relations entre largeur, hauteur, position et police. Il ne peut pas s’appuyer sur le sens de « Notice » ou sur le numéro écrit dans une ligne, puisqu’ils ne lui sont pas transmis.
PairOrderNet : comparer les deux orientations
Le modèle de src/pdforder/model.py est un MLP, ou perceptron multicouche. Il s’agit d’un petit réseau dont les transformations numériques s’enchaînent. Ses paramètres sont initialisés localement, puis ajustés pendant l’entraînement : nous ne téléchargeons aucun modèle préentraîné pour cette tâche.
import torch
from torch import nn


class PairOrderNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(14, hidden),
            nn.ReLU(),
            nn.Linear(hidden, hidden),
            nn.ReLU(),
            nn.Linear(hidden, 1),
        )

    def forward(self, forward_features, reverse_features):
        return (
            self.network(forward_features) - self.network(reverse_features)
        ).squeeze(-1)
Avec hidden=64, le chemin est 14 valeurs → 64 → 64 → 1 score. Les deux groupes de 64 valeurs sont les couches cachées : des calculs intermédiaires, ni les entrées ni la réponse finale.
Une couche nn.Linear combine les valeurs reçues avec des poids et un biais appris. nn.ReLU conserve les valeurs positives et remplace les négatives par zéro. Ces activations permettent d’intercaler une transformation non linéaire entre les couches. nn.Sequential les exécute dans l’ordre où elles sont déclarées.
La méthode forward() applique le même réseau, avec les mêmes paramètres, aux deux orientations, puis soustrait les scores. Il ne s’agit pas de deux modèles entraînés séparément.
Pour voir l’intérêt, imaginons un score direct de 2,4 et un score inverse de 0,9. Le logit vaut 2,4 − 0,9 = 1,5. Échangeons les lignes : il devient 0,9 − 2,4 = −1,5. La préférence change bien de sens. .squeeze(-1) retire simplement la dernière dimension de taille 1 pour conserver un score par paire.
Cette propriété ne suffit pas à éviter les cycles entre trois lignes. Elle garantit une cohérence lorsqu’on inverse la même paire, pas entre toutes les paires d’une page.
Mais où se fait l’apprentissage ? Dans la boucle d’entraînement, pas dans la seule déclaration de la classe. Le modèle calcule ses scores ; la perte les compare aux cibles ; PyTorch calcule comment les paramètres influencent l’erreur, puis l’optimiseur les ajuste. Ces indications de variation sont les gradients. Le tutoriel officiel sur l’optimisation détaille ce mécanisme général.
Dans ce projet, la perte moyenne d’abord les paires de chaque page, puis les pages. Une page dense ne prend donc pas davantage de poids dans la moyenne simplement parce qu’elle fournit plus de paires.
decode_dag() : empêcher les contradictions de bloquer le classement
Le réseau fournit maintenant des préférences. Il reste à les assembler. Voici le décodeur de src/pdforder/decode.py :
def has_path(adjacency, start, target):
    pending = [start]
    visited = set()
    while pending:
        current = pending.pop()
        if current == target:
            return True
        if current not in visited:
            visited.add(current)
            pending.extend(adjacency[current])
    return False


def decode_dag(lines, pairs, probabilities):
    adjacency = [set() for _ in lines]
    candidates = []
    for (first, second), probability in zip(pairs, probabilities):
        source, target = (first, second) if probability >= 0.5 else (second, first)
        candidates.append((abs(probability - 0.5), source, target))
    candidates.sort(
        key=lambda edge: (
            -edge[0],
            stable_key(lines[edge[1]]),
            stable_key(lines[edge[2]]),
        )
    )
    rejected = []
    for confidence, source, target in candidates:
        if has_path(adjacency, target, source):
            rejected.append([source, target, confidence])
        else:
            adjacency[source].add(target)
    degree = [0] * len(lines)
    for targets in adjacency:
        for target in targets:
            degree[target] += 1
    available = [i for i, d in enumerate(degree) if d == 0]
    order = []
    while available:
        current = min(available, key=lambda i: stable_key(lines[i]))
        available.remove(current)
        order.append(current)
        for target in adjacency[current]:
            degree[target] -= 1
            if degree[target] == 0:
                available.append(target)
    if len(order) != len(lines):
        raise ValueError("Internal cycle escaped detection")
    return order, rejected
D’abord, orienter les flèches. Si la probabilité est supérieure ou égale à 0.5, la première ligne devient la source et la seconde la destination. Sinon, l’orientation s’inverse. adjacency conserve, pour chaque ligne, les lignes vers lesquelles elle pointe.
Ensuite, traiter les préférences les plus affirmées. abs(probability - 0.5) mesure la distance au point d’hésitation. Une probabilité de 0,95 donne 0,45 ; une probabilité de 0,10 donne 0,40, mais dans l’autre sens. Plus cette distance est grande, plus la relation passe tôt. Ce n’est pas une garantie que cette relation soit vraie.
Avant chaque ajout, vérifier le retour possible. has_path(adjacency, target, source) cherche un chemin de la destination vers la source. S’il existe déjà, ajouter la flèche dans l’autre sens fermerait un cycle. Elle est alors rangée dans rejected plutôt qu’ajoutée au graphe.
Enfin, produire la liste. degree compte les prédécesseurs encore présents pour chaque ligne. available contient celles qui n’en ont plus. Le programme en choisit une, l’ajoute à order, puis libère progressivement ses successeurs. stable_key, la fonction auxiliaire du projet, départage les égalités de façon reproductible.
La vérification finale exige que toutes les lignes figurent dans l’ordre obtenu. Elle signale une incohérence interne si ce n’est pas le cas. Le résultat comprend la liste ordonnée et les relations rejetées : on peut donc examiner les arbitrages, au lieu de n’obtenir qu’un texte final.
Prérequis et contrôles avant d'entraîner
Vous devez pouvoir lire des fonctions Python, manipuler des listes et utiliser un terminal. Les notions d’apprentissage nécessaires ont été introduites plus haut ; aucune expérience préalable des grands modèles de langage n’est requise.
Le parcours validé utilise Linux, Docker Engine, Compose, un pilote NVIDIA et NVIDIA Container Toolkit. Le profil observé est une RTX 3090 avec PyTorch en float32. Le profil CPU reste NOT_TESTED : nous ne le présentons pas comme une solution de remplacement validée.
Le README prévoit 16 Gio de mémoire disponible et environ 12 Gio de disque pour l’image et les données. Ce sont des estimations de préparation, pas une garantie de consommation sur votre machine. Aucun modèle préentraîné externe n’est nécessaire : le MLP est initialisé localement.
Décompressez le ZIP et ouvrez un terminal à la racine du projet. Toutes les commandes suivantes se lancent depuis ce répertoire, dans l’ordre.
Le service tutorial sert à préparer, entraîner et évaluer ; inference effectue la prédiction sans les labels. Leurs calculs se font sans réseau. Le service acquisition, séparé, vérifie les actifs externes nécessaires au projet ; il ne télécharge ici aucun modèle.
Étape 1 — préparer et vérifier l'environnement
Le préflight est le contrôle préalable : il vérifie Docker et la visibilité du GPU sous Linux. Le contrôle d’environnement lance ensuite réellement un calcul CUDA dans Docker. Voir la carte avec nvidia-smi sur l’hôte ne prouve pas qu’un conteneur peut l’utiliser.
Docker Compose permet de configurer cet accès GPU avec l’intégration fournie par NVIDIA Container Toolkit. Les commandes du projet vérifient le parcours dont nous avons besoin.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm tutorial python -m pytest -q
Chaque commande doit se terminer avec un code retour nul, c’est-à-dire sans erreur signalée. La reproduction de référence a validé 27 tests publics, portant sur les coordonnées, le regroupement des caractères, les cycles, les entrées PDF rejetées et les garde-fous.
Ces tests contrôlent des comportements du programme. Ils ne démontrent pas que le modèle lira correctement vos futurs documents.
Étape 2 — générer, inspecter et comparer une baseline
Avant d’entraîner quoi que ce soit, nous préparons les pages et regardons ce qu’une méthode simple sait déjà faire. C’est une baseline, un résultat de référence auquel comparer l’apprentissage.
docker compose run --rm tutorial python -m pdforder.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdforder.cli inspect-pairs --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdforder.cli baseline --config configs/minimum.yaml
prepare doit produire 600 pages, réparties en 420/90/90 pour l’entraînement, la validation et le test.
inspect-pairs rend visibles le nombre de paires, les 14 caractéristiques et l’absence de texte ou d’identifiants dans les entrées du réseau. C’est le moment de vérifier que le modèle ne reçoit que les informations prévues.
baseline calcule deux ordres sans apprentissage. Le tri vertical suit la hauteur des lignes : il est volontairement fragile lorsque plusieurs colonnes occupent les mêmes rangées. La méthode colonnes applique une règle géométrique explicite.
Gardez ces sorties. La question n’est pas seulement « le modèle fonctionne-t-il ? », mais aussi « fait-il mieux qu’une règle plus simple sur les mêmes données ? ».
Étape 3 — entraîner et contrôler une reprise
Une époque correspond à un passage sur les données d’entraînement. Le parcours compare ici un entraînement continu à un entraînement interrompu puis repris.
docker compose run --rm tutorial python -m pdforder.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdforder.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm tutorial python -m pdforder.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm tutorial python -m pdforder.cli verify-resume --config configs/minimum.yaml
La première commande s’arrête après l’époque 6. La deuxième lance le témoin continu : il repart du même état initial et atteint 12 époques. La troisième reprend l’état interrompu et effectue les six époques restantes. La dernière compare les deux chemins.
La sauvegarde utilisée pour reprendre s’appelle un checkpoint. Pour reprendre fidèlement un entraînement, conserver les poids du modèle ne suffit pas : il faut aussi restaurer l’état qui gouverne la suite des mises à jour. La documentation PyTorch sur les sauvegardes d’entraînement explique notamment le rôle de l’état de l’optimiseur.
Dans ce projet, verify-resume compare les paramètres, l’optimiseur, l’ordre d’échantillonnage, les générateurs aléatoires et le meilleur checkpoint. Dans la reproduction de référence, l’écart maximal entre le parcours continu et la reprise vaut 0,0 après 12 époques.
Ce contrôle répond à une question de reproductibilité : la reprise suit-elle le même chemin dans les conditions testées ? Il ne mesure pas encore la qualité de l’ordre de lecture.
Étape 4 — prédire et mesurer
Le modèle est prêt. Passons maintenant à la prédiction, puis à sa comparaison avec les références.
docker compose run --rm inference python -m pdforder.predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdforder.cli evaluate --config configs/minimum.yaml
La prédiction produit quatre ordres sur les mêmes lignes : vertical, colonnes, DAG et Borda. Borda est une autre façon de combiner les préférences : elle les additionne pour obtenir un score de classement par ligne, au lieu de construire un graphe en refusant les cycles.
L’évaluation rejoint les annotations de référence uniquement sur le test. Elle écrit notamment les exports d’exemple, les métriques de chaque page et les métriques agrégées, c’est-à-dire les mesures qui résument l’ensemble évalué.
Ouvrez les Markdown et les SVG générés. Suivez le titre, la colonne gauche, la colonne droite, l’encadré et le pied de page. Où passe chaque méthode ? Une moyenne aide à comparer, mais une page annotée permet de comprendre ce qui a effectivement été réordonné.
Lire les mesures avant les chiffres
Le piège serait de demander un unique « score de lecture ». Nous avons plusieurs étapes, donc plusieurs types d’erreurs à distinguer.
La couverture : avons-nous retrouvé les lignes ?
La couverture mesure la part des lignes de référence retrouvées à l’extraction. Une valeur de 1,0 signifie qu’elles sont toutes présentes. Elle ne dit rien, à elle seule, de leur ordre.
Imaginez cinq lignes attendues, A, B, C, D et E. Si l’extraction ne retrouve que A, B, D et E, la couverture est de quatre sur cinq, soit 80 %. Cet exemple illustre la mesure ; ce n’est pas une page supplémentaire du corpus.
Les inversions conditionnelles : les lignes retrouvées sont-elles dans le bon sens ?
Le taux d’inversion conditionnel regarde les paires de lignes extraites qui ont pu être associées aux lignes de référence. Une paire est inversée si la prédiction place B avant A alors que la référence demande A avant B. Ici, plus la valeur est basse, mieux c’est.
Pourquoi « conditionnel » ? Parce que la mesure porte sur les lignes appariées. Dans notre exemple, A, B, D et E peuvent être parfaitement ordonnées : le taux vaut alors zéro, bien que C manque toujours. Une bonne valeur ne suffit donc pas à certifier l’extraction.
Le succès paire bout-en-bout : les pertes restent-elles visibles ?
Le succès paire bout-en-bout conserve les pertes d’extraction dans son dénominateur. Autrement dit, il ne fait pas disparaître du calcul les paires que l’on ne peut plus reconstruire parce qu’une ligne manque.
Il complète ainsi le taux conditionnel. Une méthode ne doit pas paraître parfaite uniquement parce qu’elle ordonne bien le sous-ensemble qu’elle a réussi à extraire. Pour cette mesure, une valeur proche de 1 est souhaitable.
L’Adjacency F1 : les bons voisins se suivent-ils encore ?
L’Adjacency F1 compare les relations entre lignes immédiatement successives. Si la référence est A, B, C, D, ses voisinages sont A→B, B→C et C→D. Dans A, C, B, D, aucun de ces trois voisinages n’est conservé, alors que toutes les lignes sont présentes.
Le score F1 combine la précision, la part des voisinages prédits qui sont corrects, et le rappel, la part des voisinages attendus qui sont retrouvés. La documentation du score F1 précise cette définition générale ; ce lien est un complément de lecture, pas l’ajout d’une dépendance au projet.
Nous pouvons maintenant lire les résultats sans confondre lignes présentes, paires correctement orientées et voisins conservés.
Les résultats du parcours de référence
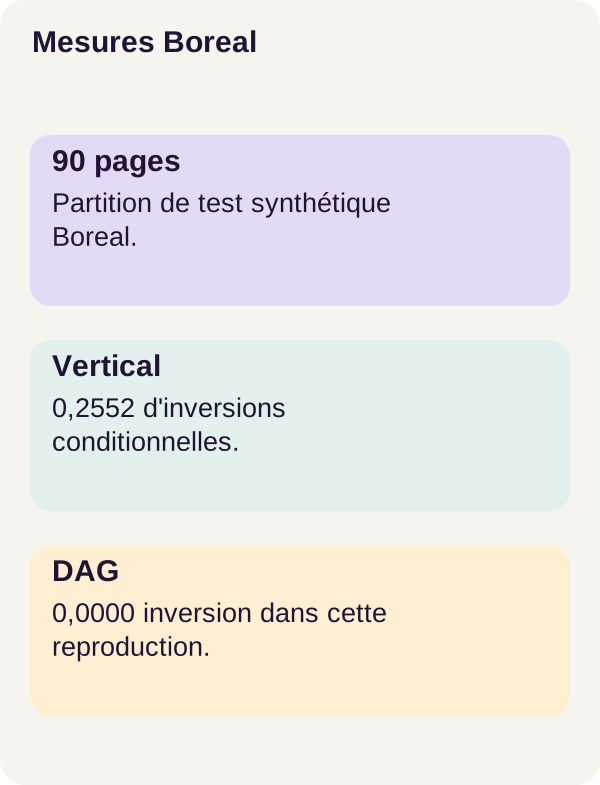
Le tableau porte sur les 90 pages de test et arrondit les valeurs à quatre décimales. La meilleure valeur est 0 pour les inversions, 1 pour les trois autres mesures.
Sur mobile, faites défiler le tableau horizontalement.
| Méthode | Couverture | Inversions conditionnelles | Succès bout-en-bout | Adjacency F1 |
|---|---|---|---|---|
| Tri vertical | 1,0000 | 0,2552 | 0,7448 | 0,1039 |
| Colonnes | 1,0000 | 0,0000 | 1,0000 | 1,0000 |
| DAG appris | 1,0000 | 0,0000 | 1,0000 | 1,0000 |
| Borda | 1,0000 | 0,0000 | 1,0000 | 1,0000 |
Le tri vertical conserve toutes les lignes, mais son taux d’inversion vaut 0,2552, soit environ 25,52 %. Son Adjacency F1 reste faible, à 0,1039. C’est exactement le problème de départ : les mots et les lignes sont là, mais le chemin de lecture est perturbé.
Les méthodes colonnes, DAG appris et Borda atteignent les mêmes résultats parfaits sur ce test. L’apprentissage ne démontre donc aucun gain sur la règle géométrique par colonnes dans cette expérience.
Ce n’est pas un résultat à masquer. Sur cette distribution, une règle explicite suffit déjà. L’intérêt du tutoriel est de comprendre et de comparer les mécanismes, pas d’attribuer un avantage à l’IA par principe.
Le corpus reste synthétique, anglais et construit avec des géométries connues. Ces chiffres ne prouvent aucune supériorité générale du MLP sur des factures, contrats, scans, tableaux ou PDF clients. Ils décrivent ce que le protocole a mesuré sur ses propres pages de test.
Exercice : prédire, puis observer la correction
Prenez une feuille et dessinez trois lignes, A, B et C. Ajoutez les préférences A→B à 0,95, C→A à 0,90 et B→C à 0,85.
Avant de lancer la commande, cherchez le cycle. Quelle flèche le DAG examinera-t-il en premier ? Laquelle devra-t-il refuser ? Quel ordre restera possible ? Pour Borda, essayez d’additionner les probabilités en faveur de chaque ligne et repérez une éventuelle égalité.
docker compose run --rm tutorial python -m pdforder.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
L’exercice n’entraîne pas de nouveau modèle. Sa sortie donne C, A, B pour le DAG et A, C, B pour Borda. Prenons le temps d’expliquer ces résultats.
Pour le DAG, les distances à 0,5 sont respectivement 0,45, 0,40 et 0,35. Le décodeur conserve d’abord A→B, puis C→A. Nous avons donc un chemin C→A→B. Ajouter B→C nous ramènerait à C : B→C est rejetée, et l’ordre obtenu est C, A, B.
Borda cherche un autre compromis par addition des préférences. Avec les probabilités décimales de l’énoncé, le calcul à la main donne 0,95 + 0,10 = 1,05 pour A, 0,05 + 0,85 = 0,90 pour B et 0,90 + 0,15 = 1,05 pour C. Les valeurs inverses viennent de 1 − p.
Un détail mérite votre attention : A et C ont ici le même total théorique. Ces sommes seules ne permettent pas de les départager. A, C, B est l’ordre rapporté par l’exercice fourni ; il ne faut pas en déduire qu’A possède un total strictement supérieur à C. Consultez la sortie pour le classement effectivement produit.
L’exercice écrit aussi l’empreinte, ou hash, du checkpoint utilisé pour les vraies comparaisons. Les figures sont produites après cette observation. Comparez votre prédiction au fichier de sortie : l’intérêt est de suivre les décisions du décodeur, pas de deviner un classement sans examiner son calcul.
Ce que nous avons appris
Le bon ordre de lecture n’est pas nécessairement l’ordre dans lequel les objets ont été dessinés dans le PDF. Nous avons séparé la récupération des caractères, leur regroupement en lignes, l’estimation des préférences entre paires et la construction d’un classement.
Le modèle apprend à partir de la géométrie, sans lire le texte. Le DAG transforme ses préférences en relations sans cycle ; Borda les additionne et peut aboutir à un autre compromis. Le choix du décodeur fait donc partie du système, autant que le réseau lui-même.
Enfin, nous avons distingué les lignes perdues, les paires inversées et les voisinages conservés. Les résultats ne montrent aucun gain sur la baseline géométrique par colonnes : ils fournissent une expérience reproductible pour comprendre les données, les entrées, le modèle, le décodeur et les mesures.
Un résultat égal à celui d’une règle simple reste une information utile : il indique ce que l’apprentissage n’a pas encore démontré.
Adapter, dépanner et nettoyer
Passer à d’autres documents sans perdre les repères
Pour étendre le projet, commencez par des PDF que vous êtes autorisé à traiter et par des annotations adaptées à leurs encadrés, notes, tableaux, images et pages mixtes. Définir l’ordre attendu fait partie du travail : on ne peut pas évaluer correctement un encadré sans avoir décidé où sa lecture doit s’insérer.
Séparez entraînement, validation et test par source documentaire. Ajoutez une évaluation humaine de la lisibilité et inspectez les erreurs par famille. Un résultat moyen satisfaisant peut masquer une catégorie de pages mal traitée.
Les limites du parcours restent présentes : l’extraction peut perdre des lignes ; le graphe peut conserver une préférence erronée ; les tests de rotation ne démontrent pas un apprentissage de la lecture du texte vertical.
Pour un service de production, il faut aussi prévoir les droits d’accès, la validation des fichiers, une isolation renforcée du parseur PDF, la supervision, des mesures de latence et d’erreurs, des tests de charge, des sauvegardes et une politique de rétention. Les chaînes extraites restent des données : ne les exécutez jamais comme des commandes. Les contrôles pédagogiques du projet ne constituent pas une protection universelle contre les vulnérabilités des bibliothèques PDF.
Diagnostiquer l’étape qui se trompe
CUDA échoue ? Reprenez le contrôle d’environnement dans Docker et vérifiez l’intégration NVIDIA avant de toucher au réseau de neurones.
Les colonnes semblent inversées ? Vérifiez la CropBox, la rotation et les repères. Si les coordonnées sont incorrectes, modifier l’entraînement ne corrige pas la cause.
Les lignes sont déjà mélangées avant le classement ? Inspectez le regroupement par rangée et la séparation des grands espaces. Ne remplacez pas les observations par les labels pour obtenir une meilleure sortie : vous contourneriez précisément le problème à mesurer.
Conserver les résultats utiles, puis nettoyer
Copiez les figures et les métriques que vous souhaitez garder avant le nettoyage. Le script ci-dessous cible seulement outputs/ ; les checkpoints restent dans assets/checkpoints/ et les données générées dans data/generated/.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
La première commande arrête l’environnement Compose. La deuxième lance le nettoyage prévu par le projet ; la dernière ferme de nouveau l’environnement. Vous conservez ainsi les données et les sauvegardes d’entraînement, sans confondre leur suppression avec celle des seuls résultats exportés.
Sources officielles consultées
Références du parcours
- Docker Compose : accès GPU : configuration de l’accès au GPU pour les services.
- NVIDIA Container Toolkit : installation et configuration Docker : intégration du pilote NVIDIA à l’environnement de conteneurs.
- PyTorch : BCEWithLogitsLoss : calcul stable de la perte binaire à partir des logits.
Compléments pour approfondir
Les références liées au fil du texte expliquent les couches Linear et ReLU, l’optimisation, les checkpoints, le tri topologique et le score F1. Elles éclairent les concepts ; elles ne constituent pas de nouvelles validations du projet.
Pour reproduire les mesures, conservez les fichiers, les dépendances et les configurations du ZIP r004. Les documentations courantes peuvent évoluer indépendamment de cette version.