





Forse avete già copiato il testo di un PDF in un editor: tutte le parole ci sono, ma le frasi non seguono più il loro ordine. Una riga della colonna sinistra si inserisce in quella destra. Un riquadro compare nel mezzo di un paragrafo. Il piè di pagina finisce prima della fine del testo.
Il problema non è necessariamente il riconoscimento dei caratteri. Ritrovare le parole e ritrovare il loro ordine di lettura sono due compiti diversi.
In questo tutorial addestreremo una piccola rete neurale a rispondere a una domanda molto precisa: «Tra queste due righe, quale dovrebbe essere letta per prima?» Useremo poi questi confronti per ricostruire l'ordine di un'intera pagina.
Nessun grande modello linguistico da interrogare né testo da fargli riassumere. Il nostro modello riceve soltanto posizioni e dimensioni dei caratteri. È l'occasione per capire, con Python e un caso visivo, come si passa da dati osservabili all'apprendimento, poi a un risultato che si può controllare.
Scaricare il progetto completo del tutorial
I comandi e le misure presentati seguono il percorso di riferimento r004 del progetto. I piccoli esempi aggiunti per spiegare i calcoli sono illustrazioni didattiche, non risultati supplementari di questo percorso.
Il risultato a cui puntiamo
Il nostro filo conduttore è un bollettino fittizio, «Boreal Maintenance Bulletin». Contiene un titolo a tutta larghezza, due colonne di righe «Check valve …: stable», un riquadro di avvisi e due righe di piè di pagina.
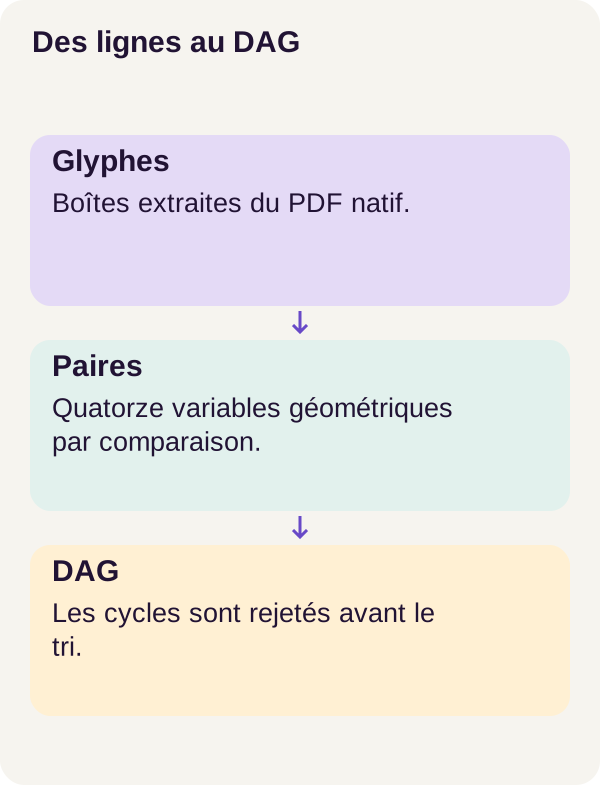
A occhio riconoscete dei blocchi. Un programma, invece, deve ricostruire questo percorso di lettura da ciò che estrae. Inizia ritrovando i glifi, le forme dei caratteri, poi li raggruppa in righe. Assegna quindi una posizione a ogni riga e produce due risultati complementari: un Markdown per leggere il testo nell'ordine proposto e una sovrapposizione SVG che numera le righe sulla pagina.
L'SVG serve quindi a comprendere una decisione, non soltanto a illustrare il tutorial. Se un avviso viene inserito troppo presto, potete ritrovarne la posizione e il numero nella pagina.
Un dettaglio rende interessante l'esperimento: il generatore mescola volutamente l'ordine di disegno degli oggetti nel PDF. Il programma non può limitarsi a seguire quel flusso per ritrovare la risposta. Per chi sviluppa per il web, immaginate blocchi il cui ordine visivo non corrisponde a quello nel DOM: scorrere gli elementi non basta più per dedurre il percorso desiderato.
Il modello non riceve né il testo, né gli identificatori delle righe, né il loro ordine di riferimento. Il testo resta disponibile per gli export, ma non entra nel calcolo. Le annotazioni, cioè le risposte attese, servono separatamente per l'addestramento e la valutazione. Il servizio di predizione funziona senza di esse.
Il perimetro resta preciso: PDF nativi, dai quali si possono estrarre i caratteri. Il progetto non esegue OCR, il riconoscimento di testo in un'immagine, e non convalida alcun documento aziendale reale.
I riferimenti necessari prima del codice
Ritrovare le righe nello stesso sistema di riferimento
Cominciamo da una nozione familiare nello sviluppo di interfacce: una scatola che circonda un elemento. Qui ogni carattere estratto possiede una scatola, indicata con x0, y0, x1, y1. Nel sistema finale usato dal progetto, questi valori designano i bordi sinistro, superiore, destro e inferiore.
Tuttavia occorre preparare questo sistema di riferimento. Nel sistema classico del PDF, l'origine è in basso a sinistra. Il progetto applica il ritaglio CropBox e la rotazione, poi trasforma ogni scatola una sola volta in un sistema comune con origine in alto a sinistra. La CropBox definisce l'area della pagina mantenuta per la visualizzazione; le rotazioni di 90° e 270° scambiano larghezza e altezza.
Perché occuparsene prima del modello? Perché un errore nelle coordinate può far passare una colonna destra per una colonna sinistra. La rete imparerebbe allora da posizioni che non descrivono correttamente ciò che vedete.
I caratteri vicini sulla stessa riga vengono poi raggruppati. I glifi di «Check valve 0020: stable» diventano una riga con il testo, la scatola e una dimensione media del carattere. Uno spazio molto grande tra due gruppi di caratteri li separa: non vogliamo saldare due colonne in un'unica riga.
Questa estrazione può già sbagliare. Il riordino non farà ricomparire una riga perduta. Misureremo quindi separatamente la presenza delle righe e la qualità del loro ordine.
Trasformare due righe in 14 numeri
La rete non manipola direttamente scatole o paragrafi. Le forniamo un vettore di caratteristiche: un elenco di numeri che descrive ciò che ci interessa.
Per ogni riga prendiamo le quattro coordinate della sua scatola e la dimensione del carattere. Le coordinate orizzontali sono divise per la larghezza della pagina; quelle verticali e la dimensione del carattere per l'altezza. È la normalizzazione.
Basta un piccolo esempio: una posizione orizzontale di 60 su una pagina larga 600 diventa 60 / 600 = 0,10. Una posizione di 120 su una pagina larga 1 200 dà anch'essa 0,10. In entrambi i casi la riga inizia al 10% della larghezza. Confrontiamo così posizioni relative invece di distanze assolute.
Una coppia riceve i cinque valori della prima riga, poi i cinque della seconda. Aggiungiamo lo scarto orizzontale, lo scarto verticale e le sovrapposizioni sui due assi. Questo fa 5 + 5 + 4 = 14 caratteristiche.
Una sovrapposizione orizzontale significa che le scatole occupano in parte le stesse posizioni da sinistra a destra; non implica che i loro rettangoli si tocchino. Due righe sovrapposte in una colonna possono sovrapporsi orizzontalmente senza sovrapporsi verticalmente.
Imparare una preferenza, non ancora una classifica
Per ogni coppia il modello produce un logit, un punteggio grezzo che può essere negativo o positivo. Una funzione chiamata sigmoide lo trasforma in un valore compreso tra 0 e 1, interpretato qui come la probabilità che la prima riga preceda la seconda.
Con un punteggio convertito in 0,90, il modello preferisce la prima riga; con 0,10, preferisce la seconda. A 0,50, non preferisce nessuna delle due. Questi valori esprimono la sua predizione, non una certezza sulla pagina.
Durante l'addestramento disponiamo della risposta corretta, chiamata bersaglio o label. Vale 1 se la prima riga deve precedere la seconda, 0 altrimenti. Una funzione di perdita misura l'errore: qui la BCE, o entropia incrociata binaria. Se il bersaglio vale 1, annunciare 0,01 è penalizzato più che annunciare 0,90.
Il calcolo della perdita usa direttamente i logit. Il complemento documentario utile è BCEWithLogitsLoss di PyTorch: unire sigmoide e BCE consente un calcolo più stabile che applicarle separatamente. Non bisogna quindi confondere la probabilità usata per spiegare il risultato con il valore grezzo trasmesso alla funzione di perdita.
Passare dalle preferenze a una pagina leggibile
Supponiamo ora che il modello preferisca A prima di B, B prima di C, ma C prima di A. È impossibile rispettare tutte e tre le decisioni contemporaneamente: torniamo al punto di partenza. È un ciclo.
Il decodificatore è la parte di codice che trasforma queste preferenze in un elenco. Quello del progetto esamina prima le relazioni più sicure e conserva una freccia solo se non crea un ciclo. L'insieme ottenuto è un DAG, un grafo orientato aciclico. Ogni riga è un vertice; ogni freccia significa «deve precedere».
Un ordinamento topologico può allora produrre un ordine che rispetta le frecce conservate. Pensate a compiti di distribuzione: un compito diventa disponibile quando i suoi prerequisiti sono stati trattati. La documentazione Python sui grafi spiega questo principio; il tutorial usa il proprio decodificatore, presentato più avanti.
Ricordate la separazione: la rete stima le preferenze; il decodificatore costruisce l'ordine finale. Eliminare i cicli rende l'ordine coerente con le relazioni conservate, ma non garantisce né l'ordine globale ottimale né il corretto ordine di lettura.
Dati controllati per imparare il meccanismo
Il corpus è sintetico: il programma genera le pagine e conosce il loro ordine di riferimento. Contiene 60 famiglie di geometrie, con 10 pagine per famiglia, cioè 600 pagine. Una famiglia riunisce pagine che condividono una geometria di impaginazione.
La separazione avviene per famiglia, prima di ogni addestramento. 42 famiglie, cioè 420 pagine, servono ad apprendere; 9 famiglie, cioè 90 pagine, servono alla validazione; le 9 famiglie rimanenti, cioè 90 pagine, sono riservate al test.
L'addestramento regola i parametri. La validazione permette di seguire la qualità del modello senza imparare direttamente da queste pagine. Il test serve a misurare il risultato finale. Distribuire le famiglie, invece di mescolare casualmente le loro pagine, evita che una stessa famiglia si ritrovi sia nell'addestramento sia nel test. Questo non trasforma però un corpus sintetico in un campione rappresentativo di tutti i PDF.
Torniamo a Boreal. Su una prima pagina, «Check valve 0000: stable» è nella colonna sinistra, «Check valve 0020: stable» in quella destra e «Notice 00-00-0» nel riquadro. Potete leggere questi testi per seguire l'esempio; il modello deve invece decidere dove collocare le righe senza leggere queste stringhe.
Il percorso osservato conta 232 570 coppie di righe. Il controllo degli input conferma vettori di 14 dimensioni, senza testo né identificatore. Le label servono a costruire i bersagli di addestramento e a confrontare le predizioni con le risposte attese, ma non vengono aggiunte a questi vettori.
Durante l'inferenza, cioè l'uso del modello addestrato per predire, la cartella delle label è assente dal contenitore. Il codice fallisce esplicitamente se viene montata. È una separazione concreta tra «disporre della correzione per imparare» e «accedere alla correzione mentre si pretende di predire».
Il codice centrale: costruire gli input del modello
Leggeremo tre parti: la preparazione delle coppie, la rete e il decodificatore. Gli estratti provengono dai moduli dello ZIP; si leggono nel loro ambiente di progetto, non come uno script autonomo da copiare in un file vuoto.
pair_features() : preparare ciò che la rete può vedere
Ecco le funzioni di src/pdforder/features.py. first e second descrivono due righe. Per ogni coppia prepariamo i due orientamenti: la prima seguita dalla seconda, poi l'inverso.
def pair_features(first, second, width, height):
    a = [
        first["bbox"][0] / width,
        first["bbox"][1] / height,
        first["bbox"][2] / width,
        first["bbox"][3] / height,
        first["font_size"] / height,
    ]
    b = [
        second["bbox"][0] / width,
        second["bbox"][1] / height,
        second["bbox"][2] / width,
        second["bbox"][3] / height,
        second["font_size"] / height,
    ]
    overlap_x = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    overlap_y = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    return a + b + [b[0] - a[0], b[1] - a[1], overlap_x, overlap_y]


def page_pairs(page, device="cpu"):
    lines = page["lines"]
    pairs = [(i, j) for i in range(len(lines)) for j in range(i + 1, len(lines))]
    forward = torch.tensor(
        [
            pair_features(lines[i], lines[j], page["width"], page["height"])
            for i, j in pairs
        ],
        dtype=torch.float32,
        device=device,
    ).reshape(-1, 14)
    reverse = torch.tensor(
        [
            pair_features(lines[j], lines[i], page["width"], page["height"])
            for i, j in pairs
        ],
        dtype=torch.float32,
        device=device,
    ).reshape(-1, 14)
    return pairs, forward, reverse
In pair_features(), a e b sono due elenchi di cinque numeri. Il + li concatena: non esegue un'addizione elemento per elemento. Il valore restituito contiene effettivamente 14 numeri, in un ordine fisso.
overlap_x e overlap_y misurano la lunghezza comune degli intervalli su ogni asse, nelle coordinate normalizzate. Se gli intervalli non si sovrappongono, max(0, ...) restituisce zero. Non sono percentuali della superficie comune.
L'ultima parte aggiunge gli scarti tra gli angoli superiori sinistri. Due righe alla stessa altezza hanno uno scarto verticale vicino a zero; due colonne distanti producono uno scarto orizzontale importante. La rete potrà combinare questi indizi con le dimensioni delle scatole e dei caratteri.
page_pairs() enumera poi le coppie di indici con i < j. Non associa una riga a sé stessa e elenca una sola volta ogni coppia, costruendone entrambi gli orientamenti. Con quattro righe, per esempio, si ottengono sei coppie: (0, 1), (0, 2), (0, 3), (1, 2), (1, 3) e (2, 3).
forward e reverse diventano tensori, qui tabelle numeriche a due dimensioni. Ogni riga descrive una coppia con 14 colonne. In reshape(-1, 14), il -1 lascia che PyTorch deduca il numero di righe. float32 indica il formato numerico; device determina dove sono collocati i dati per il calcolo. Il valore predefinito "cpu" in questa funzione non costituisce una convalida del percorso completo su CPU.
Osservando questi input, si capisce ciò che il modello può imparare: relazioni tra larghezza, altezza, posizione e carattere. Non può basarsi sul significato di «Notice» o sul numero scritto in una riga, poiché non gli vengono trasmessi.
PairOrderNet : confrontare i due orientamenti
Il modello di src/pdforder/model.py è un MLP, o percettrone multistrato. È una piccola rete in cui si susseguono trasformazioni numeriche. I suoi parametri sono inizializzati localmente e poi regolati durante l'addestramento: non scarichiamo alcun modello preaddestrato per questo compito.
import torch
from torch import nn


class PairOrderNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(14, hidden),
            nn.ReLU(),
            nn.Linear(hidden, hidden),
            nn.ReLU(),
            nn.Linear(hidden, 1),
        )

    def forward(self, forward_features, reverse_features):
        return (
            self.network(forward_features) - self.network(reverse_features)
        ).squeeze(-1)
Con hidden=64, il percorso è 14 valori → 64 → 64 → 1 punteggio. I due gruppi da 64 valori sono gli strati nascosti: calcoli intermedi, né gli input né la risposta finale.
Uno strato nn.Linear combina i valori ricevuti con pesi e un bias appresi. nn.ReLU conserva i valori positivi e sostituisce quelli negativi con zero. Queste attivazioni permettono di inserire una trasformazione non lineare tra gli strati. nn.Sequential li esegue nell'ordine in cui sono dichiarati.
Il metodo forward() applica la stessa rete, con gli stessi parametri, ai due orientamenti, poi sottrae i punteggi. Non si tratta di due modelli addestrati separatamente.
Per capirne l'interesse, immaginiamo un punteggio diretto di 2,4 e uno inverso di 0,9. Il logit vale 2,4 − 0,9 = 1,5. Scambiamo le righe: diventa 0,9 − 2,4 = −1,5. La preferenza cambia davvero verso. .squeeze(-1) rimuove semplicemente l'ultima dimensione di dimensione 1 per mantenere un punteggio per coppia.
Questa proprietà non basta a evitare i cicli tra tre righe. Garantisce coerenza quando si inverte la stessa coppia, non tra tutte le coppie di una pagina.
Ma dove avviene l'apprendimento? Nel ciclo di addestramento, non nella sola dichiarazione della classe. Il modello calcola i punteggi; la perdita li confronta con i bersagli; PyTorch calcola come i parametri influenzano l'errore, poi l'ottimizzatore li regola. Queste indicazioni di variazione sono i gradienti. Il tutorial ufficiale sull'ottimizzazione illustra questo meccanismo generale.
In questo progetto, la perdita media prima le coppie di ogni pagina e poi le pagine. Una pagina densa non pesa quindi di più nella media solo perché fornisce più coppie.
decode_dag() : impedire che le contraddizioni blocchino l'ordinamento
La rete fornisce ora delle preferenze. Resta da assemblarle. Ecco il decodificatore di src/pdforder/decode.py:
def has_path(adjacency, start, target):
    pending = [start]
    visited = set()
    while pending:
        current = pending.pop()
        if current == target:
            return True
        if current not in visited:
            visited.add(current)
            pending.extend(adjacency[current])
    return False


def decode_dag(lines, pairs, probabilities):
    adjacency = [set() for _ in lines]
    candidates = []
    for (first, second), probability in zip(pairs, probabilities):
        source, target = (first, second) if probability >= 0.5 else (second, first)
        candidates.append((abs(probability - 0.5), source, target))
    candidates.sort(
        key=lambda edge: (
            -edge[0],
            stable_key(lines[edge[1]]),
            stable_key(lines[edge[2]]),
        )
    )
    rejected = []
    for confidence, source, target in candidates:
        if has_path(adjacency, target, source):
            rejected.append([source, target, confidence])
        else:
            adjacency[source].add(target)
    degree = [0] * len(lines)
    for targets in adjacency:
        for target in targets:
            degree[target] += 1
    available = [i for i, d in enumerate(degree) if d == 0]
    order = []
    while available:
        current = min(available, key=lambda i: stable_key(lines[i]))
        available.remove(current)
        order.append(current)
        for target in adjacency[current]:
            degree[target] -= 1
            if degree[target] == 0:
                available.append(target)
    if len(order) != len(lines):
        raise ValueError("Internal cycle escaped detection")
    return order, rejected
Prima, orientare le frecce. Se la probabilità è maggiore o uguale a 0.5, la prima riga diventa l'origine e la seconda la destinazione. Altrimenti l'orientamento si inverte. adjacency conserva, per ogni riga, le righe verso cui punta.
Poi, trattare le preferenze più sicure. abs(probability - 0.5) misura la distanza dal punto di esitazione. Una probabilità di 0,95 dà 0,45; una probabilità di 0,10 dà 0,40, ma nel verso opposto. Più questa distanza è grande, prima passa la relazione. Non è una garanzia che la relazione sia vera.
Prima di ogni aggiunta, verificare il ritorno possibile. has_path(adjacency, target, source) cerca un percorso dalla destinazione all'origine. Se esiste già, aggiungere la freccia nell'altro verso chiuderebbe un ciclo. Viene allora messa in rejected invece di essere aggiunta al grafo.
Infine, produrre l'elenco. degree conta i predecessori ancora presenti per ogni riga. available contiene quelle che non ne hanno più. Il programma ne sceglie una, la aggiunge a order, quindi libera progressivamente le sue successive. stable_key, la funzione ausiliaria del progetto, risolve le parità in modo riproducibile.
La verifica finale richiede che tutte le righe figurino nell'ordine ottenuto. Segnala un'incoerenza interna in caso contrario. Il risultato comprende l'elenco ordinato e le relazioni rifiutate: possiamo quindi esaminare gli arbitrati, invece di ottenere soltanto un testo finale.
Prerequisiti e controlli prima di addestrare
Dovete saper leggere funzioni Python, manipolare elenchi e usare un terminale. Le nozioni di apprendimento necessarie sono state introdotte sopra; non è richiesta alcuna esperienza precedente con i grandi modelli linguistici.
Il percorso convalidato usa Linux, Docker Engine, Compose, un driver NVIDIA e NVIDIA Container Toolkit. Il profilo osservato è una RTX 3090 con PyTorch in float32. Il profilo CPU resta NOT_TESTED: non lo presentiamo come soluzione alternativa convalidata.
Il README prevede 16 GiB di memoria disponibile e circa 12 GiB di disco per l'immagine e i dati. Sono stime di preparazione, non una garanzia di consumo sulla vostra macchina. Non è necessario alcun modello preaddestrato esterno: l'MLP è inizializzato localmente.
Decomprimete lo ZIP e aprite un terminale alla radice del progetto. Tutti i comandi seguenti si eseguono da questa cartella, nell'ordine.
Il servizio tutorial serve a preparare, addestrare e valutare; inference esegue la predizione senza le label. I loro calcoli avvengono senza rete. Il servizio separato acquisition verifica gli asset esterni necessari al progetto; qui non scarica alcun modello.
Passo 1 — preparare e verificare l'ambiente
Il preflight è il controllo preliminare: verifica Docker e la visibilità della GPU in Linux. Il controllo dell'ambiente avvia poi realmente un calcolo CUDA in Docker. Vedere la scheda con nvidia-smi sull'host non dimostra che un contenitore possa usarla.
Docker Compose permette di configurare questo accesso alla GPU con l'integrazione fornita da NVIDIA Container Toolkit. I comandi del progetto verificano il percorso di cui abbiamo bisogno.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm tutorial python -m pytest -q
Ogni comando deve terminare con un codice di ritorno nullo, cioè senza errore segnalato. La riproduzione di riferimento ha convalidato 27 test pubblici, relativi alle coordinate, al raggruppamento dei caratteri, ai cicli, agli input PDF rifiutati e alle protezioni.
Questi test controllano comportamenti del programma. Non dimostrano che il modello leggerà correttamente i vostri documenti futuri.
Passo 2 — generare, ispezionare e confrontare una baseline
Prima di addestrare qualunque cosa, prepariamo le pagine e osserviamo ciò che un metodo semplice sa già fare. È una baseline, un risultato di riferimento con cui confrontare l'apprendimento.
docker compose run --rm tutorial python -m pdforder.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdforder.cli inspect-pairs --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdforder.cli baseline --config configs/minimum.yaml
prepare deve produrre 600 pagine, ripartite in 420/90/90 per addestramento, validazione e test.
inspect-pairs rende visibili il numero di coppie, le 14 caratteristiche e l'assenza di testo o identificatori negli input della rete. È il momento di verificare che il modello riceva solo le informazioni previste.
baseline calcola due ordini senza apprendimento. L'ordinamento verticale segue l'altezza delle righe: è volutamente fragile quando più colonne occupano le stesse fasce. Il metodo colonne applica una regola geometrica esplicita.
Conservate questi output. La domanda non è soltanto «il modello funziona?», ma anche «fa meglio di una regola più semplice sugli stessi dati?».
Passo 3 — addestrare e controllare una ripresa
Un'epoca corrisponde a un passaggio sui dati di addestramento. Il percorso confronta qui un addestramento continuo con uno interrotto e poi ripreso.
docker compose run --rm tutorial python -m pdforder.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdforder.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm tutorial python -m pdforder.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm tutorial python -m pdforder.cli verify-resume --config configs/minimum.yaml
Il primo comando si ferma dopo l'epoca 6. Il secondo avvia il riferimento continuo: riparte dallo stesso stato iniziale e raggiunge 12 epoche. Il terzo riprende lo stato interrotto ed esegue le sei epoche rimanenti. L'ultimo confronta i due percorsi.
Il salvataggio usato per riprendere si chiama checkpoint. Per riprendere fedelmente un addestramento, conservare i pesi del modello non basta: occorre anche ripristinare lo stato che governa gli aggiornamenti successivi. La documentazione PyTorch sui salvataggi di addestramento spiega in particolare il ruolo dello stato dell'ottimizzatore.
In questo progetto, verify-resume confronta parametri, ottimizzatore, ordine di campionamento, generatori casuali e miglior checkpoint. Nella riproduzione di riferimento, lo scarto massimo tra percorso continuo e ripresa vale 0,0 dopo 12 epoche.
Questo controllo risponde a una domanda di riproducibilità: la ripresa segue lo stesso percorso nelle condizioni testate? Non misura ancora la qualità dell'ordine di lettura.
Passo 4 — predire e misurare
Il modello è pronto. Passiamo ora alla predizione, poi al confronto con i riferimenti.
docker compose run --rm inference python -m pdforder.predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdforder.cli evaluate --config configs/minimum.yaml
La predizione produce quattro ordini sulle stesse righe: verticale, colonne, DAG e Borda. Borda è un altro modo di combinare le preferenze: le somma per ottenere un punteggio di classificazione per riga, invece di costruire un grafo rifiutando i cicli.
La valutazione unisce le annotazioni di riferimento solo nel test. Scrive in particolare gli export d'esempio, le metriche di ogni pagina e le metriche aggregate, cioè le misure che riassumono l'insieme valutato.
Aprite i Markdown e gli SVG generati. Seguite il titolo, la colonna sinistra, quella destra, il riquadro e il piè di pagina. Dove passa ogni metodo? Una media aiuta a confrontare, ma una pagina annotata permette di comprendere ciò che è stato effettivamente riordinato.
Leggere le misure prima delle cifre
La trappola sarebbe chiedere un unico «punteggio di lettura». Abbiamo più fasi, quindi più tipi di errori da distinguere.
Copertura: abbiamo ritrovato le righe?
La copertura misura la parte delle righe di riferimento ritrovate durante l'estrazione. Un valore di 1,0 significa che sono tutte presenti. Da solo non dice nulla sul loro ordine.
Immaginate cinque righe attese, A, B, C, D ed E. Se l'estrazione ritrova solo A, B, D ed E, la copertura è quattro su cinque, cioè 80%. Questo esempio illustra la misura; non è una pagina supplementare del corpus.
Inversioni condizionali: le righe ritrovate sono nel verso giusto?
Il tasso di inversione condizionale considera le coppie di righe estratte che hanno potuto essere associate alle righe di riferimento. Una coppia è invertita se la predizione pone B prima di A mentre il riferimento richiede A prima di B. Qui più il valore è basso, meglio è.
Perché «condizionale»? Perché la misura riguarda le righe abbinate. Nel nostro esempio A, B, D ed E possono essere perfettamente ordinate: il tasso vale allora zero, sebbene C manchi sempre. Un buon valore non basta quindi a certificare l'estrazione.
Successo di coppia end-to-end: le perdite restano visibili?
Il successo di coppia end-to-end mantiene le perdite di estrazione nel suo denominatore. In altre parole, non fa sparire dal calcolo le coppie che non si possono più ricostruire perché manca una riga.
Completa così il tasso condizionale. Un metodo non deve sembrare perfetto solo perché ordina bene il sottoinsieme che è riuscito a estrarre. Per questa misura è desiderabile un valore vicino a 1.
Adjacency F1: i vicini corretti sono ancora uno dopo l'altro?
L'Adjacency F1 confronta le relazioni tra righe immediatamente successive. Se il riferimento è A, B, C, D, le sue adiacenze sono A→B, B→C e C→D. In A, C, B, D nessuna di queste tre adiacenze è conservata, anche se tutte le righe sono presenti.
Il punteggio F1 combina la precisione, la parte delle adiacenze previste che è corretta, e il richiamo, la parte delle adiacenze attese ritrovata. La documentazione del punteggio F1 precisa questa definizione generale; il collegamento è un approfondimento, non l'aggiunta di una dipendenza al progetto.
Ora possiamo leggere i risultati senza confondere righe presenti, coppie orientate correttamente e vicini conservati.
I risultati del percorso di riferimento
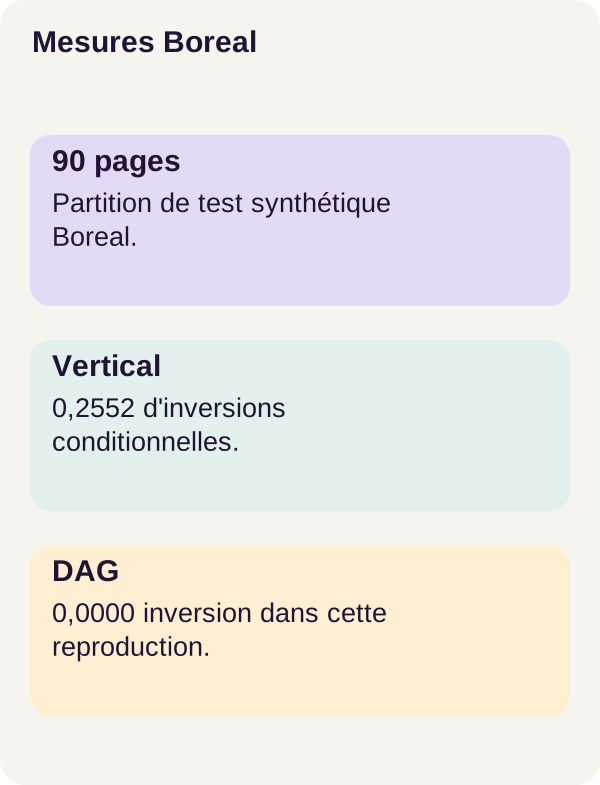
La tabella riguarda le 90 pagine di test e arrotonda i valori a quattro decimali. Il valore migliore è 0 per le inversioni, 1 per le altre tre misure.
Su mobile, scorrete la tabella orizzontalmente.
| Metodo | Copertura | Inversioni condizionali | Successo end-to-end | Adjacency F1 |
|---|---|---|---|---|
| Ordinamento verticale | 1,0000 | 0,2552 | 0,7448 | 0,1039 |
| Colonne | 1,0000 | 0,0000 | 1,0000 | 1,0000 |
| DAG appreso | 1,0000 | 0,0000 | 1,0000 | 1,0000 |
| Borda | 1,0000 | 0,0000 | 1,0000 | 1,0000 |
L'ordinamento verticale conserva tutte le righe, ma il suo tasso di inversione vale 0,2552, cioè circa 25,52%. Il suo Adjacency F1 resta basso, a 0,1039. È esattamente il problema iniziale: parole e righe sono presenti, ma il percorso di lettura è perturbato.
I metodi colonne, DAG appreso e Borda ottengono gli stessi risultati perfetti su questo test. L'apprendimento non dimostra quindi alcun guadagno rispetto alla regola geometrica per colonne in questo esperimento.
Non è un risultato da nascondere. Su questa distribuzione è già sufficiente una regola esplicita. L'interesse del tutorial è comprendere e confrontare i meccanismi, non attribuire un vantaggio all'IA per principio.
Il corpus resta sintetico, inglese e costruito con geometrie note. Queste cifre non provano alcuna superiorità generale dell'MLP su fatture, contratti, scansioni, tabelle o PDF di clienti. Descrivono ciò che il protocollo ha misurato sulle proprie pagine di test.
Esercizio: predire, poi osservare la correzione
Prendete un foglio e disegnate tre righe, A, B e C. Aggiungete le preferenze A→B a 0,95, C→A a 0,90 e B→C a 0,85.
Prima di lanciare il comando, cercate il ciclo. Quale freccia esaminerà per prima il DAG? Quale dovrà rifiutare? Quale ordine resterà possibile? Per Borda, provate a sommare le probabilità a favore di ogni riga e individuate un'eventuale parità.
docker compose run --rm tutorial python -m pdforder.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
L'esercizio non addestra un nuovo modello. Il suo output dà C, A, B per il DAG e A, C, B per Borda. Prendiamoci il tempo per spiegare questi risultati.
Per il DAG, le distanze da 0,5 sono rispettivamente 0,45, 0,40 e 0,35. Il decodificatore conserva prima A→B, poi C→A. Abbiamo quindi un percorso C→A→B. Aggiungere B→C ci riporterebbe a C: B→C viene rifiutata, e l'ordine ottenuto è C, A, B.
Borda cerca un altro compromesso sommando le preferenze. Con le probabilità decimali dell'enunciato, il calcolo a mano dà 0,95 + 0,10 = 1,05 per A, 0,05 + 0,85 = 0,90 per B e 0,90 + 0,15 = 1,05 per C. I valori inversi derivano da 1 − p.
Un dettaglio merita attenzione: A e C hanno qui lo stesso totale teorico. Queste somme da sole non permettono di distinguerle. A, C, B è l'ordine riportato dall'esercizio fornito; non bisogna dedurne che A abbia un totale strettamente superiore a C. Consultate l'output per la classifica effettivamente prodotta.
L'esercizio scrive anche l'impronta, o hash, del checkpoint usato per i confronti reali. Le figure sono prodotte dopo questa osservazione. Confrontate la vostra predizione con il file di output: l'interesse è seguire le decisioni del decodificatore, non indovinare una classifica senza esaminarne il calcolo.
Cosa abbiamo imparato
Il corretto ordine di lettura non è necessariamente quello in cui gli oggetti sono stati disegnati nel PDF. Abbiamo separato il recupero dei caratteri, il loro raggruppamento in righe, la stima delle preferenze tra coppie e la costruzione di una classifica.
Il modello impara dalla geometria, senza leggere il testo. Il DAG trasforma le sue preferenze in relazioni senza ciclo; Borda le somma e può arrivare a un altro compromesso. La scelta del decodificatore fa quindi parte del sistema quanto la rete stessa.
Infine abbiamo distinto righe perse, coppie invertite e adiacenze conservate. I risultati non mostrano alcun guadagno rispetto alla baseline geometrica per colonne: forniscono un'esperienza riproducibile per comprendere dati, input, modello, decodificatore e misure.
Un risultato uguale a quello di una regola semplice resta un'informazione utile: indica ciò che l'apprendimento non ha ancora dimostrato.
Adattare, risolvere problemi e pulire
Passare ad altri documenti senza perdere i riferimenti
Per estendere il progetto, cominciate da PDF che siete autorizzati a trattare e da annotazioni adatte ai loro riquadri, note, tabelle, immagini e pagine miste. Definire l'ordine atteso fa parte del lavoro: non si può valutare correttamente un riquadro senza aver deciso dove debba inserirsi la sua lettura.
Separate addestramento, validazione e test per fonte documentaria. Aggiungete una valutazione umana della leggibilità e ispezionate gli errori per famiglia. Un risultato medio soddisfacente può nascondere una categoria di pagine trattata male.
I limiti del percorso restano presenti: l'estrazione può perdere righe; il grafo può conservare una preferenza errata; i test di rotazione non dimostrano un apprendimento della lettura di testo verticale.
Per un servizio di produzione occorre prevedere anche diritti di accesso, validazione dei file, isolamento rafforzato del parser PDF, supervisione, misure di latenza e di errore, test di carico, backup e una politica di conservazione. Le stringhe estratte restano dati: non eseguitele mai come comandi. I controlli didattici del progetto non costituiscono una protezione universale contro le vulnerabilità delle librerie PDF.
Diagnosticare la fase che sbaglia
CUDA fallisce? Ripetete il controllo dell'ambiente in Docker e verificate l'integrazione NVIDIA prima di intervenire sulla rete neurale.
Le colonne sembrano invertite? Verificate CropBox, rotazione e riferimenti. Se le coordinate sono errate, modificare l'addestramento non corregge la causa.
Le righe sono già mescolate prima della classifica? Ispezionate il raggruppamento per riga e la separazione dei grandi spazi. Non sostituite le osservazioni con le label per ottenere un output migliore: aggirereste proprio il problema da misurare.
Conservare i risultati utili, poi pulire
Copiate le figure e le metriche che desiderate conservare prima della pulizia. Lo script qui sotto riguarda solo outputs/; i checkpoint restano in assets/checkpoints/ e i dati generati in data/generated/.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Il primo comando arresta l'ambiente Compose. Il secondo avvia la pulizia prevista dal progetto; l'ultimo chiude nuovamente l'ambiente. Conservate così dati e salvataggi di addestramento, senza confondere la loro eliminazione con quella dei soli risultati esportati.
Fonti ufficiali consultate
Riferimenti del percorso
- Docker Compose: accesso GPU : configurazione dell'accesso alla GPU per i servizi.
- NVIDIA Container Toolkit: installazione e configurazione Docker : integrazione del driver NVIDIA nell'ambiente di contenitori.
- PyTorch: BCEWithLogitsLoss : calcolo stabile della perdita binaria a partire dai logit.
Approfondimenti
I riferimenti collegati nel testo spiegano gli strati Linear e ReLU, l'ottimizzazione, i checkpoint, l'ordinamento topologico e il punteggio F1. Chiariscono i concetti; non costituiscono nuove convalide del progetto.
Per riprodurre le misure, conservate i file, le dipendenze e le configurazioni dello ZIP r004. Le documentazioni correnti possono evolvere indipendentemente da questa versione.