





Quizá ya haya copiado el texto de un PDF en un editor: todas las palabras están ahí, pero las frases ya no se suceden. Una línea de la columna izquierda se intercala en la derecha. Un recuadro aparece en medio de un párrafo. El pie de página queda antes del final del texto.
El problema no es necesariamente el reconocimiento de caracteres. Recuperar las palabras y recuperar su orden de lectura son dos tareas distintas.
En este tutorial entrenaremos una pequeña red neuronal para responder a una pregunta muy precisa: «¿Cuál de estas dos líneas debería leerse primero?». Después usaremos estas comparaciones para reconstruir el orden de una página completa.
No hay un gran modelo de lenguaje que consultar ni texto que resumir. Nuestro modelo solo recibe posiciones y tamaños de letra. Es una oportunidad para comprender, con Python y un caso visual, cómo se pasa de datos observables al aprendizaje y después a un resultado que podemos comprobar.
Descargar el proyecto completo del tutorial
Los comandos y las mediciones presentados siguen el recorrido de referencia r004 del proyecto. Los pequeños ejemplos añadidos para explicar los cálculos son ilustraciones didácticas, no resultados adicionales de ese recorrido.
El resultado que buscamos
Nuestro hilo conductor es un boletín ficticio, «Boreal Maintenance Bulletin». Contiene un título a todo lo ancho, dos columnas de líneas «Check valve …: stable», un recuadro de avisos y dos líneas de pie de página.
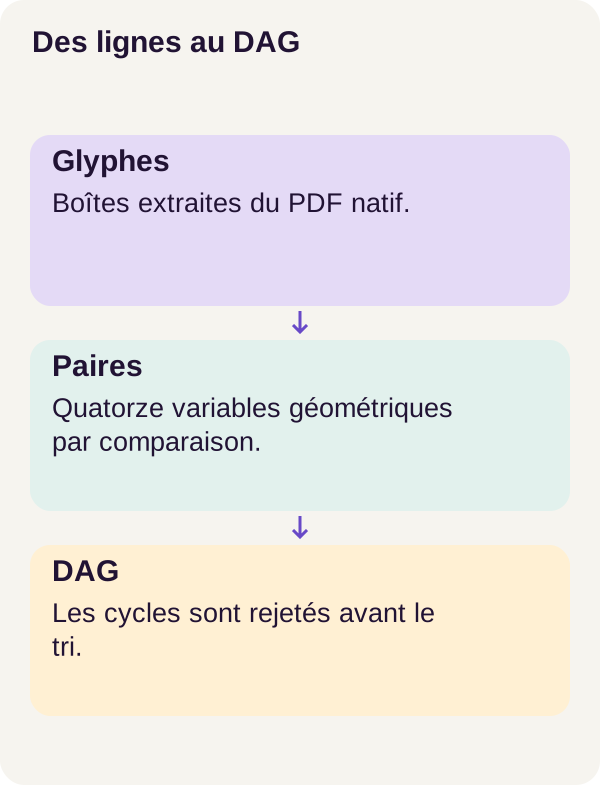
A simple vista reconoce bloques. En cambio, un programa debe reconstruir ese recorrido de lectura a partir de lo que extrae. Primero recupera los glifos, las formas de los caracteres, y los agrupa en líneas. Después asigna un rango a cada línea y produce dos salidas complementarias: un Markdown para leer el texto en el orden propuesto y una superposición SVG que numera las líneas de la página.
Por tanto, el SVG sirve para entender una decisión, no solo para ilustrar el tutorial. Si un aviso se inserta demasiado pronto, puede localizar su posición y su número en la página.
Un detalle hace interesante el experimento: el generador mezcla deliberadamente el orden de dibujo de los objetos del PDF. El programa no puede limitarse a seguir ese flujo para hallar la respuesta. Para una persona que desarrolla para la web, imagine bloques cuyo orden visual no corresponde a su orden en el DOM: recorrer los elementos ya no basta para deducir el recorrido deseado.
El modelo no recibe ni el texto, ni los identificadores de las líneas, ni su orden de referencia. El texto sigue disponible para las exportaciones, pero no entra en su cálculo. Las anotaciones, es decir, las respuestas esperadas, se usan por separado para el entrenamiento y la evaluación. El servicio de predicción funciona sin ellas.
El alcance sigue siendo preciso: PDF nativos, cuyos caracteres se pueden extraer. El proyecto no realiza OCR, el reconocimiento de texto en una imagen, ni valida documentos empresariales reales.
Conceptos necesarios antes del código
Recuperar las líneas en el mismo sistema de coordenadas
Empecemos por una noción familiar en el desarrollo de interfaces: una caja que rodea un elemento. Aquí, cada carácter extraído tiene una caja, anotada x0, y0, x1, y1. En el sistema final usado por el proyecto, estos valores indican los bordes izquierdo, superior, derecho e inferior.
Sin embargo, primero hay que preparar ese sistema. En el sistema clásico de los PDF, el origen está abajo a la izquierda. El proyecto aplica el recorte CropBox y la rotación, y después transforma cada caja una sola vez a un sistema común cuyo origen está arriba a la izquierda. La CropBox define el área de página conservada para la visualización; las rotaciones de 90° y 270° intercambian anchura y altura.
¿Por qué ocuparse de esto antes del modelo? Porque un error de coordenadas puede hacer que una columna derecha parezca una columna izquierda. La red aprendería entonces de posiciones que no describen correctamente lo que ve.
Los caracteres cercanos en una misma fila se agrupan después. Los glifos de «Check valve 0020: stable» se convierten en una línea con su texto, su caja y un tamaño de letra medio. Un espacio muy grande entre dos grupos de caracteres los separa: no queremos unir dos columnas en una sola línea.
Esta extracción ya puede equivocarse. La clasificación no hará reaparecer una línea perdida. Por eso mediremos por separado la presencia de las líneas y la calidad de su orden.
Convertir dos líneas en 14 números
La red no maneja directamente cajas ni párrafos. Le transmitimos un vector de características: una lista de números que describe lo que nos interesa.
Para cada línea tomamos las cuatro coordenadas de su caja y su tamaño de letra. Las coordenadas horizontales se dividen por la anchura de la página; las verticales y el tamaño de letra, por su altura. Esto es la normalización.
Basta un ejemplo sencillo: una posición horizontal de 60 en una página de 600 de ancho se convierte en 60 / 600 = 0,10. Una posición de 120 en una página de 1 200 de ancho también da 0,10. En ambos casos, la línea comienza en el 10 % de la anchura. Así comparamos posiciones relativas en lugar de distancias brutas.
Un par recibe los cinco valores de la primera línea y después los cinco de la segunda. Añadimos la separación horizontal, la separación vertical y los solapamientos en ambos ejes. Eso da 5 + 5 + 4 = 14 características.
Un solapamiento horizontal significa que las cajas ocupan en parte las mismas posiciones de izquierda a derecha; no implica que sus rectángulos se toquen. Dos líneas apiladas en una columna pueden solaparse horizontalmente sin solaparse verticalmente.
Aprender una preferencia, todavía no una clasificación
Para cada par, el modelo produce un logit, una puntuación bruta que puede ser negativa o positiva. Una función llamada sigmoide la transforma en un valor entre 0 y 1, interpretado aquí como la probabilidad de que la primera línea preceda a la segunda.
Con una puntuación convertida en 0,90, el modelo favorece la primera línea; con 0,10, favorece la segunda. En 0,50, no favorece a ninguna. Estos valores expresan su predicción, no una certeza sobre la página.
Durante el entrenamiento contamos con la respuesta correcta, llamada objetivo o label. Vale 1 si la primera línea debe preceder a la segunda, y 0 en caso contrario. Una función de pérdida mide el error: aquí, la BCE, o entropía cruzada binaria. Si el objetivo vale 1, predecir 0,01 se penaliza más que predecir 0,90.
El cálculo de la pérdida usa directamente los logits. Una referencia documental útil es BCEWithLogitsLoss de PyTorch: reunir la sigmoide y la BCE permite un cálculo más estable que aplicarlas por separado. No hay que confundir la probabilidad que usamos para explicar el resultado con el valor bruto que se transmite a la función de pérdida.
Pasar de preferencias a una página legible
Supongamos ahora que el modelo prefiere A antes que B, B antes que C, pero C antes que A. Es imposible respetar las tres decisiones a la vez: volvemos al punto de partida. Esto es un ciclo.
El decodificador es la parte del código que transforma estas preferencias en una lista. El del proyecto examina primero las relaciones más marcadas y solo conserva una flecha si no crea un ciclo. El conjunto obtenido es un DAG, un grafo dirigido sin ciclos. Cada línea es un vértice; cada flecha significa «debe preceder».
Un ordenamiento topológico puede producir entonces un orden que respete las flechas conservadas. Piense en tareas de despliegue: una tarea queda disponible cuando se han tratado sus requisitos previos. La documentación de Python sobre grafos explica este principio; el tutorial usa su propio decodificador, presentado más abajo.
Conserve esta separación: la red estima las preferencias; el decodificador construye el orden final. Eliminar ciclos hace que ese orden sea coherente con las relaciones conservadas, pero no garantiza ni el orden global óptimo ni el orden de lectura correcto.
Datos controlados para aprender el mecanismo
El corpus es sintético: el programa genera las páginas y conoce su orden de referencia. Contiene 60 familias de geometría, con 10 páginas por familia, es decir, 600 páginas. Una familia agrupa páginas que comparten una geometría de maquetación.
La separación se hace por familia, antes de cualquier entrenamiento. 42 familias, es decir, 420 páginas, sirven para aprender; 9 familias, es decir, 90 páginas, sirven para la validación; las 9 familias restantes, es decir, 90 páginas, se reservan para la prueba.
El entrenamiento ajusta los parámetros. La validación permite seguir la calidad del modelo sin aprender directamente de esas páginas. La prueba sirve para medir el resultado final. Repartir las familias, en vez de mezclar sus páginas al azar, evita que una misma familia aparezca tanto en el entrenamiento como en la prueba. Esto no convierte por ello un corpus sintético en una muestra representativa de todos los PDF.
Volvamos a Boreal. En una primera página, «Check valve 0000: stable» está en la columna izquierda, «Check valve 0020: stable» en la derecha y «Notice 00-00-0» en el recuadro. Puede leer estos textos para seguir el ejemplo; el modelo debe decidir dónde colocar las líneas sin leer estas cadenas.
El recorrido observado cuenta 232 570 pares de líneas. El control de las entradas confirma vectores de 14 dimensiones, sin texto ni identificador. Los labels sirven para fabricar los objetivos de entrenamiento y comparar las predicciones con las respuestas esperadas, pero no se añaden a estos vectores.
Durante la inferencia, es decir, el uso del modelo entrenado para predecir, la carpeta de labels está ausente del contenedor. El código falla explícitamente si se monta. Es una separación concreta entre «disponer de la corrección para aprender» y «acceder a la corrección mientras se pretende predecir».
El código central: construir las entradas del modelo
Leeremos tres piezas: la preparación de los pares, la red y el decodificador. Los extractos son los de los módulos del ZIP; se leen en su entorno de proyecto, no como un script autónomo que se pueda copiar en un archivo vacío.
pair_features(): preparar lo que la red puede ver
Estas son las funciones de src/pdforder/features.py. first y second describen dos líneas. Para cada par, preparamos las dos orientaciones: la primera seguida de la segunda, y después la inversa.
def pair_features(first, second, width, height):
    a = [
        first["bbox"][0] / width,
        first["bbox"][1] / height,
        first["bbox"][2] / width,
        first["bbox"][3] / height,
        first["font_size"] / height,
    ]
    b = [
        second["bbox"][0] / width,
        second["bbox"][1] / height,
        second["bbox"][2] / width,
        second["bbox"][3] / height,
        second["font_size"] / height,
    ]
    overlap_x = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    overlap_y = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    return a + b + [b[0] - a[0], b[1] - a[1], overlap_x, overlap_y]


def page_pairs(page, device="cpu"):
    lines = page["lines"]
    pairs = [(i, j) for i in range(len(lines)) for j in range(i + 1, len(lines))]
    forward = torch.tensor(
        [
            pair_features(lines[i], lines[j], page["width"], page["height"])
            for i, j in pairs
        ],
        dtype=torch.float32,
        device=device,
    ).reshape(-1, 14)
    reverse = torch.tensor(
        [
            pair_features(lines[j], lines[i], page["width"], page["height"])
            for i, j in pairs
        ],
        dtype=torch.float32,
        device=device,
    ).reshape(-1, 14)
    return pairs, forward, reverse
En pair_features(), a y b son dos listas de cinco números. El + las concatena: no hace una suma término a término. El valor devuelto contiene efectivamente 14 números, en un orden fijo.
overlap_x y overlap_y miden la longitud común de los intervalos en cada eje, en las coordenadas normalizadas. Si los intervalos no se solapan, max(0, ...) devuelve cero. No son porcentajes de superficie común.
La última parte añade las separaciones entre las esquinas superiores izquierdas. Dos líneas a la misma altura tienen una separación vertical cercana a cero; dos columnas alejadas producen una separación horizontal importante. La red podrá combinar estas pistas con las dimensiones de las cajas y los tamaños de letra.
page_pairs() enumera después los pares de índices con i < j. No asocia una línea consigo misma y lista cada par una sola vez, mientras construye sus dos orientaciones. Con cuatro líneas, por ejemplo, se obtienen seis pares: (0, 1), (0, 2), (0, 3), (1, 2), (1, 3) y (2, 3).
forward y reverse se convierten en tensores, aquí matrices numéricas bidimensionales. Cada fila describe un par con 14 columnas. En reshape(-1, 14), el -1 deja que PyTorch deduzca el número de filas. float32 indica el formato numérico; device determina dónde se colocan los datos para el cálculo. El valor predeterminado "cpu" de esta función no constituye una validación del recorrido completo en CPU.
Al observar estas entradas, entendemos qué puede aprender el modelo: relaciones entre anchura, altura, posición y letra. No puede basarse en el significado de «Notice» ni en el número escrito en una línea, porque no se le transmiten.
PairOrderNet: comparar las dos orientaciones
El modelo de src/pdforder/model.py es un MLP, o perceptrón multicapa. Es una red pequeña cuyas transformaciones numéricas se encadenan. Sus parámetros se inicializan localmente y se ajustan durante el entrenamiento: no descargamos ningún modelo preentrenado para esta tarea.
import torch
from torch import nn


class PairOrderNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(14, hidden),
            nn.ReLU(),
            nn.Linear(hidden, hidden),
            nn.ReLU(),
            nn.Linear(hidden, 1),
        )

    def forward(self, forward_features, reverse_features):
        return (
            self.network(forward_features) - self.network(reverse_features)
        ).squeeze(-1)
Con hidden=64, el recorrido es 14 valores → 64 → 64 → 1 puntuación. Los dos grupos de 64 valores son las capas ocultas: cálculos intermedios, ni las entradas ni la respuesta final.
Una capa nn.Linear combina los valores recibidos con pesos y un sesgo aprendidos. nn.ReLU conserva los valores positivos y sustituye los negativos por cero. Estas activaciones permiten intercalar una transformación no lineal entre las capas. nn.Sequential las ejecuta en el orden en que se declaran.
El método forward() aplica la misma red, con los mismos parámetros, a las dos orientaciones y luego resta las puntuaciones. No se trata de dos modelos entrenados por separado.
Para ver el interés, imaginemos una puntuación directa de 2,4 y una puntuación inversa de 0,9. El logit vale 2,4 − 0,9 = 1,5. Si intercambiamos las líneas, pasa a ser 0,9 − 2,4 = −1,5. La preferencia cambia efectivamente de sentido. .squeeze(-1) simplemente elimina la última dimensión de tamaño 1 para conservar una puntuación por par.
Esta propiedad no basta para evitar ciclos entre tres líneas. Garantiza coherencia al invertir el mismo par, no entre todos los pares de una página.
Pero ¿dónde ocurre el aprendizaje? En el bucle de entrenamiento, no en la mera declaración de la clase. El modelo calcula sus puntuaciones; la pérdida las compara con los objetivos; PyTorch calcula cómo influyen los parámetros en el error y el optimizador los ajusta. Estas indicaciones de variación son los gradientes. El tutorial oficial sobre optimización detalla este mecanismo general.
En este proyecto, la pérdida promedia primero los pares de cada página y después las páginas. Por tanto, una página densa no tiene más peso en la media solo porque aporte más pares.
decode_dag(): impedir que las contradicciones bloqueen la clasificación
La red ya proporciona preferencias. Falta ensamblarlas. Este es el decodificador de src/pdforder/decode.py:
def has_path(adjacency, start, target):
    pending = [start]
    visited = set()
    while pending:
        current = pending.pop()
        if current == target:
            return True
        if current not in visited:
            visited.add(current)
            pending.extend(adjacency[current])
    return False


def decode_dag(lines, pairs, probabilities):
    adjacency = [set() for _ in lines]
    candidates = []
    for (first, second), probability in zip(pairs, probabilities):
        source, target = (first, second) if probability >= 0.5 else (second, first)
        candidates.append((abs(probability - 0.5), source, target))
    candidates.sort(
        key=lambda edge: (
            -edge[0],
            stable_key(lines[edge[1]]),
            stable_key(lines[edge[2]]),
        )
    )
    rejected = []
    for confidence, source, target in candidates:
        if has_path(adjacency, target, source):
            rejected.append([source, target, confidence])
        else:
            adjacency[source].add(target)
    degree = [0] * len(lines)
    for targets in adjacency:
        for target in targets:
            degree[target] += 1
    available = [i for i, d in enumerate(degree) if d == 0]
    order = []
    while available:
        current = min(available, key=lambda i: stable_key(lines[i]))
        available.remove(current)
        order.append(current)
        for target in adjacency[current]:
            degree[target] -= 1
            if degree[target] == 0:
                available.append(target)
    if len(order) != len(lines):
        raise ValueError("Internal cycle escaped detection")
    return order, rejected
Primero, orientar las flechas. Si la probabilidad es mayor o igual que 0.5, la primera línea se convierte en el origen y la segunda en el destino. De lo contrario, la orientación se invierte. adjacency guarda, para cada línea, las líneas hacia las que apunta.
Después, tratar las preferencias más marcadas. abs(probability - 0.5) mide la distancia al punto de incertidumbre. Una probabilidad de 0,95 da 0,45; una de 0,10 da 0,40, pero en el otro sentido. Cuanto mayor sea esta distancia, antes se procesa la relación. No garantiza que la relación sea cierta.
Antes de cada adición, comprobar si existe un camino de vuelta. has_path(adjacency, target, source) busca un camino desde el destino hasta el origen. Si ya existe, añadir la flecha en el otro sentido cerraría un ciclo. Entonces se guarda en rejected en lugar de añadirse al grafo.
Por último, producir la lista. degree cuenta los predecesores que quedan para cada línea. available contiene las que ya no tienen ninguno. El programa elige una, la añade a order y libera gradualmente sus sucesoras. stable_key, la función auxiliar del proyecto, resuelve los empates de forma reproducible.
La comprobación final exige que todas las líneas figuren en el orden obtenido. Señala una incoherencia interna si no es así. El resultado incluye la lista ordenada y las relaciones rechazadas: podemos examinar las decisiones de compromiso, en lugar de recibir solo un texto final.
Requisitos y comprobaciones antes de entrenar
Debe poder leer funciones de Python, manipular listas y usar una terminal. Las nociones de aprendizaje necesarias se introdujeron antes; no se requiere experiencia previa con grandes modelos de lenguaje.
El recorrido validado usa Linux, Docker Engine, Compose, un controlador NVIDIA y NVIDIA Container Toolkit. El perfil observado es una RTX 3090 con PyTorch en float32. El perfil de CPU sigue siendo NOT_TESTED: no lo presentamos como una alternativa validada.
El README prevé 16 GiB de memoria disponible y alrededor de 12 GiB de disco para la imagen y los datos. Son estimaciones de preparación, no una garantía de consumo en su máquina. No se necesita ningún modelo preentrenado externo: el MLP se inicializa localmente.
Descomprima el ZIP y abra una terminal en la raíz del proyecto. Todos los comandos siguientes se ejecutan desde este directorio, en orden.
El servicio tutorial sirve para preparar, entrenar y evaluar; inference realiza la predicción sin los labels. Sus cálculos se realizan sin red. El servicio independiente acquisition verifica los activos externos necesarios para el proyecto; aquí no descarga ningún modelo.
Paso 1 — preparar y comprobar el entorno
El preflight es la comprobación previa: verifica Docker y la visibilidad de la GPU en Linux. La comprobación del entorno ejecuta después realmente un cálculo CUDA dentro de Docker. Ver la tarjeta con nvidia-smi en el host no prueba que un contenedor pueda usarla.
Docker Compose permite configurar este acceso a la GPU con la integración que proporciona NVIDIA Container Toolkit. Los comandos del proyecto comprueban el recorrido que necesitamos.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm tutorial python -m pytest -q
Cada comando debe terminar con un código de retorno cero, es decir, sin ningún error informado. La reproducción de referencia validó 27 pruebas públicas, sobre coordenadas, agrupación de caracteres, ciclos, entradas PDF rechazadas y salvaguardas.
Estas pruebas verifican comportamientos del programa. No demuestran que el modelo vaya a leer correctamente sus futuros documentos.
Paso 2 — generar, inspeccionar y comparar una línea base
Antes de entrenar nada, preparamos las páginas y observamos lo que ya puede hacer un método simple. Es una línea base, un resultado de referencia con el que comparar el aprendizaje.
docker compose run --rm tutorial python -m pdforder.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdforder.cli inspect-pairs --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdforder.cli baseline --config configs/minimum.yaml
prepare debe producir 600 páginas, repartidas en 420/90/90 para el entrenamiento, la validación y la prueba.
inspect-pairs hace visibles el número de pares, las 14 características y la ausencia de texto o identificadores en las entradas de la red. Es el momento de comprobar que el modelo solo recibe la información prevista.
baseline calcula dos órdenes sin aprendizaje. La clasificación vertical sigue la altura de las líneas: es deliberadamente frágil cuando varias columnas ocupan las mismas filas. El método columnas aplica una regla geométrica explícita.
Conserve estas salidas. La pregunta no es solo «¿funciona el modelo?», sino también «¿lo hace mejor que una regla más simple con los mismos datos?».
Paso 3 — entrenar y comprobar una reanudación
Una época corresponde a una pasada por los datos de entrenamiento. El recorrido compara aquí un entrenamiento continuo con uno interrumpido y luego reanudado.
docker compose run --rm tutorial python -m pdforder.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdforder.cli train --config configs/minimum.yaml --mode continuous
docker compose run --rm tutorial python -m pdforder.cli train --config configs/minimum.yaml --mode resume
docker compose run --rm tutorial python -m pdforder.cli verify-resume --config configs/minimum.yaml
El primer comando se detiene después de la época 6. El segundo inicia el control continuo: parte del mismo estado inicial y alcanza 12 épocas. El tercero retoma el estado interrumpido y realiza las seis épocas restantes. El último compara los dos recorridos.
La copia de seguridad usada para reanudar se llama checkpoint. Para reanudar fielmente un entrenamiento, no basta con conservar los pesos del modelo: también debe restaurar el estado que rige las actualizaciones posteriores. La documentación de PyTorch sobre guardados de entrenamiento explica, en particular, el papel del estado del optimizador.
En este proyecto, verify-resume compara los parámetros, el optimizador, el orden de muestreo, los generadores aleatorios y el mejor checkpoint. En la reproducción de referencia, la diferencia máxima entre el recorrido continuo y la reanudación es 0,0 después de 12 épocas.
Esta comprobación responde a una pregunta de reproducibilidad: ¿la reanudación sigue el mismo recorrido en las condiciones probadas? Todavía no mide la calidad del orden de lectura.
Paso 4 — predecir y medir
El modelo está listo. Pasemos ahora a la predicción y luego a compararla con las referencias.
docker compose run --rm inference python -m pdforder.predict --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdforder.cli evaluate --config configs/minimum.yaml
La predicción produce cuatro órdenes sobre las mismas líneas: vertical, columnas, DAG y Borda. Borda es otra forma de combinar las preferencias: las suma para obtener una puntuación de clasificación por línea, en vez de construir un grafo rechazando los ciclos.
La evaluación une las anotaciones de referencia únicamente en la prueba. Escribe, entre otras cosas, las exportaciones de ejemplo, las métricas de cada página y las métricas agregadas, es decir, las mediciones que resumen el conjunto evaluado.
Abra los Markdown y SVG generados. Siga el título, la columna izquierda, la columna derecha, el recuadro y el pie de página. ¿Por dónde pasa cada método? Una media ayuda a comparar, pero una página anotada permite comprender lo que realmente se ha reordenado.
Leer las mediciones antes que las cifras
La trampa sería pedir una única «puntuación de lectura». Tenemos varias etapas y, por tanto, varios tipos de errores que distinguir.
Cobertura: ¿hemos recuperado las líneas?
La cobertura mide la proporción de líneas de referencia recuperadas durante la extracción. Un valor de 1,0 significa que todas están presentes. Por sí solo, no dice nada de su orden.
Imagine cinco líneas esperadas, A, B, C, D y E. Si la extracción solo recupera A, B, D y E, la cobertura es de cuatro de cinco, es decir, el 80 %. Este ejemplo ilustra la medida; no es una página adicional del corpus.
Inversiones condicionales: ¿las líneas recuperadas están en el orden correcto?
La tasa de inversión condicional observa los pares de líneas extraídas que se han podido asociar con las líneas de referencia. Un par se invierte si la predicción coloca B antes que A cuando la referencia exige A antes que B. Aquí, cuanto menor sea el valor, mejor.
¿Por qué «condicional»? Porque la medida se refiere a las líneas emparejadas. En nuestro ejemplo, A, B, D y E pueden estar perfectamente ordenadas: la tasa vale entonces cero, aunque C siga faltando. Por tanto, un buen valor no basta para certificar la extracción.
Éxito de pares de extremo a extremo: ¿las pérdidas siguen siendo visibles?
El éxito de pares de extremo a extremo conserva las pérdidas de extracción en su denominador. En otras palabras, no elimina del cálculo los pares que ya no podemos reconstruir porque falta una línea.
Así complementa la tasa condicional. Un método no debe parecer perfecto solo porque ordena bien el subconjunto que logró extraer. Para esta medida, es deseable un valor cercano a 1.
Adjacency F1: ¿los vecinos correctos siguen juntos?
Adjacency F1 compara las relaciones entre líneas inmediatamente consecutivas. Si la referencia es A, B, C, D, sus adyacencias son A→B, B→C y C→D. En A, C, B, D no se conserva ninguna de estas tres adyacencias, aunque todas las líneas estén presentes.
La puntuación F1 combina la precisión, la proporción de adyacencias predichas que son correctas, y la recuperación, la proporción de adyacencias esperadas que se recuperan. La documentación de la puntuación F1 precisa esta definición general; este enlace amplía la lectura, no añade una dependencia al proyecto.
Ahora podemos leer los resultados sin confundir líneas presentes, pares correctamente orientados y vecinos conservados.
Resultados del recorrido de referencia
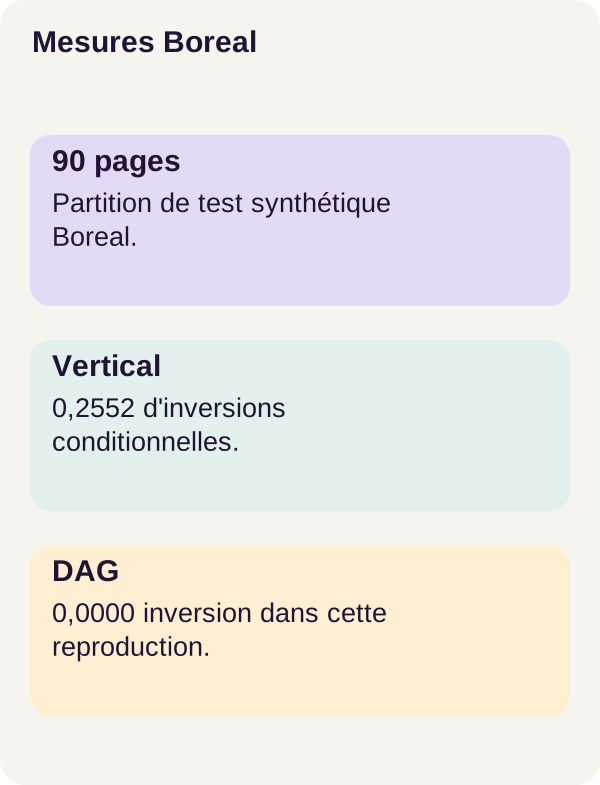
La tabla abarca las 90 páginas de prueba y redondea los valores a cuatro decimales. El mejor valor es 0 para las inversiones y 1 para las otras tres medidas.
En móvil, desplácese horizontalmente por la tabla.
| Método | Cobertura | Inversiones condicionales | Éxito de extremo a extremo | Adjacency F1 |
|---|---|---|---|---|
| Clasificación vertical | 1,0000 | 0,2552 | 0,7448 | 0,1039 |
| Columnas | 1,0000 | 0,0000 | 1,0000 | 1,0000 |
| DAG aprendido | 1,0000 | 0,0000 | 1,0000 | 1,0000 |
| Borda | 1,0000 | 0,0000 | 1,0000 | 1,0000 |
La clasificación vertical conserva todas las líneas, pero su tasa de inversión vale 0,2552, aproximadamente el 25,52 %. Su Adjacency F1 sigue siendo baja, con 0,1039. Es exactamente el problema inicial: las palabras y las líneas están ahí, pero el recorrido de lectura se altera.
Los métodos de columnas, DAG aprendido y Borda alcanzan los mismos resultados perfectos en esta prueba. Por tanto, el aprendizaje no demuestra ninguna mejora respecto a la regla geométrica por columnas en este experimento.
No es un resultado que ocultar. En esta distribución, una regla explícita ya basta. El interés del tutorial es comprender y comparar los mecanismos, no atribuir una ventaja a la IA por principio.
El corpus sigue siendo sintético, en inglés y construido con geometrías conocidas. Estas cifras no prueban ninguna superioridad general del MLP sobre facturas, contratos, escaneos, tablas o PDF de clientes. Describen lo que el protocolo midió en sus propias páginas de prueba.
Ejercicio: predecir y después observar la corrección
Tome una hoja de papel y dibuje tres líneas, A, B y C. Añada las preferencias A→B en 0,95, C→A en 0,90 y B→C en 0,85.
Antes de ejecutar el comando, busque el ciclo. ¿Qué flecha examinará primero el DAG? ¿Cuál tendrá que rechazar? ¿Qué orden seguirá siendo posible? Para Borda, pruebe a sumar las probabilidades a favor de cada línea y localice un posible empate.
docker compose run --rm tutorial python -m pdforder.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
El ejercicio no entrena un modelo nuevo. Su salida da C, A, B para el DAG y A, C, B para Borda. Dediquemos un momento a explicar estos resultados.
Para el DAG, las distancias a 0,5 son respectivamente 0,45, 0,40 y 0,35. El decodificador conserva primero A→B y después C→A. Tenemos por tanto un camino C→A→B. Añadir B→C nos devolvería a C: B→C se rechaza, y el orden obtenido es C, A, B.
Borda busca otro compromiso sumando las preferencias. Con las probabilidades decimales del enunciado, el cálculo manual da 0,95 + 0,10 = 1,05 para A, 0,05 + 0,85 = 0,90 para B y 0,90 + 0,15 = 1,05 para C. Los valores inversos proceden de 1 − p.
Un detalle merece atención: A y C tienen aquí el mismo total teórico. Estas sumas por sí solas no permiten desempatarlas. A, C, B es el orden informado por el ejercicio proporcionado; no hay que deducir que A tenga un total estrictamente mayor que C. Consulte la salida para conocer la clasificación realmente producida.
El ejercicio también escribe la huella, o hash, del checkpoint usado para las comparaciones reales. Las figuras se producen después de esta observación. Compare su predicción con el archivo de salida: el objetivo es seguir las decisiones del decodificador, no adivinar una clasificación sin examinar su cálculo.
Lo que hemos aprendido
El orden de lectura correcto no es necesariamente el orden en que se dibujaron los objetos en el PDF. Hemos separado la recuperación de caracteres, su agrupación en líneas, la estimación de preferencias entre pares y la construcción de una clasificación.
El modelo aprende a partir de la geometría, sin leer el texto. El DAG transforma sus preferencias en relaciones sin ciclos; Borda las suma y puede llegar a otro compromiso. Por tanto, la elección del decodificador forma parte del sistema tanto como la propia red.
Por último, distinguimos líneas perdidas, pares invertidos y adyacencias conservadas. Los resultados no muestran ninguna mejora respecto a la línea base geométrica por columnas: proporcionan un experimento reproducible para comprender los datos, las entradas, el modelo, el decodificador y las mediciones.
Un resultado igual al de una regla simple sigue siendo información útil: indica lo que el aprendizaje todavía no ha demostrado.
Adaptar, solucionar problemas y limpiar
Pasar a otros documentos sin perder la orientación
Para ampliar el proyecto, comience por PDF que esté autorizado a procesar y por anotaciones adecuadas para sus recuadros, notas, tablas, imágenes y páginas mixtas. Definir el orden esperado forma parte del trabajo: no se puede evaluar correctamente un recuadro sin decidir dónde debe insertarse su lectura.
Separe entrenamiento, validación y prueba por fuente documental. Añada una evaluación humana de la legibilidad e inspeccione los errores por familia. Un resultado medio satisfactorio puede ocultar una categoría de páginas mal tratada.
Los límites del recorrido siguen presentes: la extracción puede perder líneas; el grafo puede conservar una preferencia errónea; las pruebas de rotación no demuestran un aprendizaje de lectura de texto vertical.
Para un servicio de producción también hay que prever derechos de acceso, validación de archivos, un aislamiento reforzado del analizador PDF, supervisión, mediciones de latencia y errores, pruebas de carga, copias de seguridad y una política de retención. Las cadenas extraídas siguen siendo datos: nunca las ejecute como comandos. Los controles didácticos del proyecto no constituyen una protección universal frente a las vulnerabilidades de las bibliotecas PDF.
Diagnosticar la etapa que falla
¿CUDA falla? Repita la comprobación del entorno en Docker y verifique la integración de NVIDIA antes de modificar la red neuronal.
¿Las columnas parecen invertidas? Compruebe la CropBox, la rotación y los sistemas de coordenadas. Si las coordenadas son incorrectas, modificar el entrenamiento no corrige la causa.
¿Las líneas ya están mezcladas antes de la clasificación? Inspeccione la agrupación por fila y la separación de los grandes espacios. No sustituya las observaciones por los labels para obtener una salida mejor: eludiría precisamente el problema que se mide.
Conservar los resultados útiles y después limpiar
Copie las figuras y las métricas que quiera conservar antes de limpiar. El script siguiente solo afecta a outputs/; los checkpoints permanecen en assets/checkpoints/ y los datos generados en data/generated/.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
El primer comando detiene el entorno Compose. El segundo ejecuta la limpieza prevista por el proyecto; el último vuelve a cerrar el entorno. Así conserva los datos y las copias de seguridad de entrenamiento, sin confundir su eliminación con la de los únicos resultados exportados.
Fuentes oficiales consultadas
Referencias del recorrido
- Docker Compose: acceso a la GPU: configuración del acceso a la GPU para los servicios.
- NVIDIA Container Toolkit: instalación y configuración de Docker: integración del controlador NVIDIA en el entorno de contenedores.
- PyTorch: BCEWithLogitsLoss: cálculo estable de la pérdida binaria a partir de logits.
Lecturas complementarias
Las referencias enlazadas a lo largo del texto explican las capas Linear y ReLU, la optimización, los checkpoints, el ordenamiento topológico y la puntuación F1. Aclaran los conceptos; no constituyen nuevas validaciones del proyecto.
Para reproducir las mediciones, conserve los archivos, las dependencias y las configuraciones del ZIP r004. La documentación actual puede evolucionar independientemente de esta versión.