





Un scan n'est pas du texte
Vous développez un import de documents. Un utilisateur dépose un bordereau « Cedar Parts » en PDF : à l'écran, vous lisez sans difficulté BOLT AA11 12.50 et SEAL B00 7.20. Vous lancez l'extraction de texte… et vous ne récupérez rien.
Pourquoi ? Parce que ce PDF contient une image de la page, pas les caractères que vous voyez. C'est un peu comme recevoir la capture d'écran d'un formulaire plutôt que ses champs : l'information est visible, mais elle n'est plus disponible sous forme de chaînes de caractères.
C'est le point de départ de l'OCR, pour Optical Character Recognition, ou reconnaissance optique de caractères. Il faut passer des pixels à du texte. Et nous allons construire ce passage, plutôt que simplement appeler un service qui nous cache son fonctionnement.
Notre terrain de jeu sera volontairement limité : des lignes imprimées d'un corpus fictif, avec un alphabet restreint. Nous n'allons pas apprendre à lire toutes les factures du monde, les écritures manuscrites ou les pages aux mises en forme complexes. En revanche, nous allons comprendre comment un réseau apprend à transcrire une ligne sans qu'on lui indique la position de chaque caractère.
Les résultats feront aussi partie de l'apprentissage : ce petit modèle progresse, mais sa qualité finale reste insuffisante pour automatiser une extraction métier. Nous regarderons précisément ce qui fonctionne et ce qui ne fonctionne pas.
Télécharger le projet complet du tutoriel
Ce que vous allez construire et apprendre
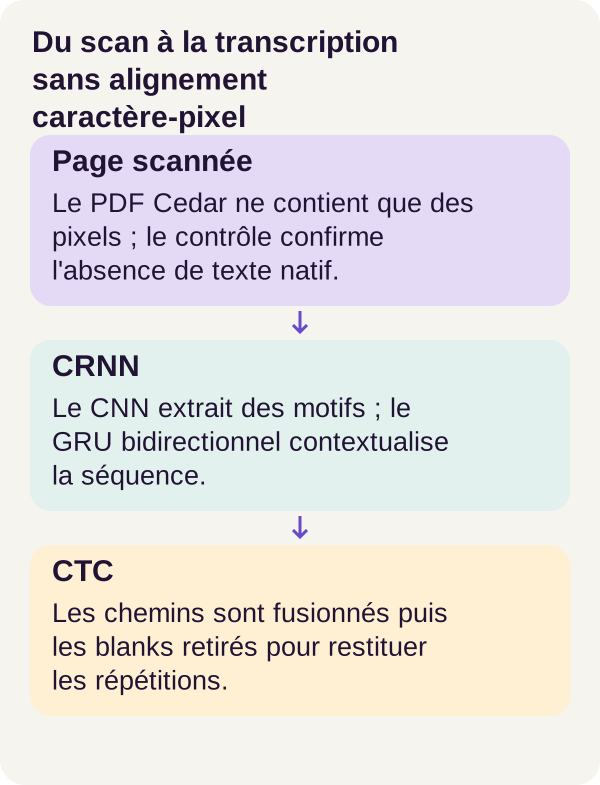
La chaîne suit le document : PDF scanné → image → lignes détectées → réseau CNN-GRU → scores de caractères → décodage CTC → texte.
Ne cherchez pas encore à retenir tous les sigles. Pour commencer, représentons-nous trois responsabilités.
Trouver les lignes. Nous repérons les zones de la page qui contiennent du texte et découpons une petite image par ligne. Cette étape s'appelle la segmentation.
Analyser chaque image de ligne. Le CNN transforme les pixels en motifs visuels. Le GRU relie ces informations en parcourant la ligne dans les deux sens. Leur association produit une succession de scores pour les caractères possibles.
Apprendre et décoder sans découper chaque lettre. CTC permet d'entraîner le réseau avec la transcription entière de la ligne, puis d'interpréter une séquence qui peut contenir des répétitions et des symboles techniques.
Nous entraînerons ce réseau depuis son initialisation, vérifierons qu'il sait reprendre après une interruption, puis mesurerons séparément la découpe et la reconnaissance. Nous terminerons par une expérience : rendre les scans plus flous sans réentraîner le modèle, prédire ce qui va se passer, puis comparer notre intuition aux résultats.
Le fil rouge sera AA11. Ce petit identifiant est particulièrement intéressant : comment distinguer deux vrais A d'un même A que le réseau aurait proposé plusieurs fois ? C'est justement l'un des problèmes que CTC permet de traiter.
Préparer le projet et vérifier le GPU
Vous devez savoir programmer en Python, utiliser un terminal et lancer Docker. Vous n'avez pas besoin d'avoir déjà entraîné un modèle. Nous expliquerons les notions au moment de les utiliser.
Un premier mot mérite toutefois une définition : un tenseur est ici un tableau numérique à une ou plusieurs dimensions. Une image, un lot d'images ou des scores de caractères seront représentés par de tels tableaux. Le réseau contient lui aussi des nombres, ses paramètres, que l'entraînement ajuste pour réduire l'erreur sur des transcriptions connues.
Reprendre l'environnement du parcours validé
Le parcours a été exécuté avec une RTX 3090, Python 3.11.16, PyTorch 2.8.0+cu126 et CUDA 12.6. PyTorch est la bibliothèque utilisée pour construire et entraîner le réseau ; CUDA permet d'exécuter les calculs prévus sur le GPU NVIDIA.
Ces versions décrivent l'environnement validé. Le Dockerfile du ZIP fixe les dépendances : ne les remplacez pas par les dernières versions pour une première reproduction. Consultez le README pour le dimensionnement, et prévoyez la place nécessaire aux images Docker, aux scans générés et aux checkpoints, c'est-à-dire aux sauvegardes de l'entraînement.
Décompressez le ZIP et placez votre terminal dans son dossier racine, celui de README.md. Toutes les commandes suivantes se lancent depuis ce dossier, dans l'ordre indiqué. Les extraits de code expliqués plus loin appartiennent au projet complet ; ils ne remplacent pas ses autres fichiers.
Commençons par le contrôle de l'hôte, appelé preflight :
sh scripts/preflight.sh
Un GPU visible sous Linux ne garantit pas que Docker puisse l'utiliser. NVIDIA Container Toolkit fournit l'intégration entre Docker et les pilotes de l'hôte ; sa documentation officielle détaille l'installation selon le système. Nous vérifierons l'accès CUDA du conteneur après sa construction.
Construire les services et comprendre leur rôle
Préparons les répertoires, vérifions la configuration Compose, puis construisons les services :
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
acquisition vérifie les actifs du projet. tutorial prépare les données et entraîne le réseau. inference transcrit les scans avec les poids enregistrés. Les fichiers sont répartis entre data/generated/ pour les scans, assets/checkpoints/ pour les états du modèle et outputs/ pour les résultats.
Aucun poids OCR préentraîné n'est à télécharger. Ici, le réseau apprend à partir de son initialisation ; nous ne spécialisons pas un moteur déjà entraîné. L'étape d'acquisition est conservée dans le parcours et rapporte donc zéro octet de poids externes. Cela ne signifie pas que la construction des images Docker ne nécessite aucun téléchargement.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
Vérifions maintenant CUDA depuis le conteneur, puis les tests du projet :
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Le contrôle d'environnement doit confirmer l'accès au GPU. Les 26 tests réussis dans le parcours de référence couvrent notamment la segmentation, les longueurs et le décodage.
Pensez à vos tests applicatifs : vérifier qu'une fonction respecte son contrat n'est pas la même chose que vérifier la pertinence de toutes les données qu'elle produira. Ici aussi, les tests réussis ne signifient pas que toutes les transcriptions seront correctes.
Les services d'entraînement et d'inférence n'ont ensuite pas de réseau. Le fichier Compose complet décrit les volumes en lecture seule, l'utilisateur non privilégié, les capacités retirées et les limites de ressources. Ces restrictions réduisent les accès du programme ; elles ne constituent pas une protection complète contre toute vulnérabilité des bibliothèques natives.
Un bordereau réellement rasterisé
Fabriquer des scans dont nous connaissons la réponse
Pour entraîner un OCR, il nous faut des images et leur transcription attendue. Le projet fabrique lui-même ces exemples : nous pouvons ainsi connaître la réponse sans demander à quelqu'un de recopier chaque ligne.
Le générateur prepare, dans src/pdfctc/corpus.py, compose 600 pages de dix lignes. Il les rend en image, réinsère cette image dans un PDF, puis transforme de nouveau ce PDF en image. Cette transformation en pixels s'appelle la rastérisation.
Pourquoi ces étapes ? Pour que le document transmis à notre chaîne soit bien un PDF scanné, et non un PDF dont le programme pourrait simplement relire les caractères cachés derrière l'affichage. Le générateur vérifie que le texte natif est vide.
Chaque page existe en trois vues : propre, dégradée ou fortement floue. Ce sont différentes versions d'une même page, pas trois familles documentaires indépendantes. Le corpus est fictif, imprimé avec des caractères ASCII et une police PDF standard. Il ne représente pas la diversité des factures, langues ou manuscrits d'une entreprise.
Séparer les documents avant d'apprendre
Les 60 familles de documents sont réparties en 42 pour l'entraînement, 9 pour la validation et 9 pour le test. Cela représente respectivement 4 200, 900 et 900 lignes.
L'entraînement sert à ajuster les paramètres. La validation sert à observer le comportement pendant la mise au point, sans être le jeu sur lequel on apprend ces paramètres. Le test sert à mesurer le résultat sur les exemples réservés à l'évaluation finale.
La séparation se fait par famille de mise en page, pas simplement en distribuant au hasard toutes les lignes. Une même famille ne se retrouve donc pas des deux côtés de la frontière entre apprentissage et évaluation. Cela limite une comparaison trop facile entre des documents apparentés, sans pour autant couvrir toute la diversité des documents réels.
Une annotation contient ici la transcription attendue et la boîte qui entoure la ligne. Nous connaissons donc le texte d'une ligne et sa position globale, mais nous ne fournissons pas une boîte pour chaque lettre. CTC nous évitera cette annotation caractère par caractère ; elle ne supprime pas le besoin de transcriptions pour entraîner le modèle.
Trouver les lignes avant de les reconnaître
La fonction line_boxes, dans src/pdfctc/segment.py, cherche les rangées de pixels sombres, regroupe les rangées voisines et construit une boîte par ligne. Pour vous la représenter, imaginez que vous parcouriez la page de haut en bas en mesurant où se trouve l'encre.
Cette méthode est explicite, et non un deuxième réseau à entraîner. Elle localise des lignes ; elle ne sait pas encore ce qu'elles contiennent. Le morceau d'image extrait d'une boîte s'appelle un crop, ou recadrage.
Générons les scans, puis inspectons ces découpes :
docker compose run --rm tutorial python -m pdfctc.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfctc.cli inspect-lines --config configs/minimum.yaml
Vous devez retrouver les 600 pages et leurs trois vues. Dans les fichiers d'inspection, regardez les boîtes autour des lignes et les largeurs après redimensionnement. Le PDF généré doit rester sans couche de texte natif : sinon nous ne testerions plus une reconnaissance à partir des pixels.
Prenez une ligne et posez-vous deux questions distinctes : « ai-je récupéré toute la ligne ? » et « est-ce que le réseau saura la lire ? ». La première concerne la segmentation, la seconde la reconnaissance.
Mettre les images dans un format commun
normalize, également dans src/pdfctc/segment.py, ramène chaque crop à 32 pixels de hauteur, en conservant ses proportions. Une largeur supérieure à 512 pixels provoque une erreur : on ne coupe jamais silencieusement la fin du texte pour faire entrer l'image.
Voici la fonction du projet :
def normalize(image, height=32, max_width=512):
    width = max(4, round(image.width * height / image.height))
    if width > max_width:
        raise ValueError(
            f"Line width {width} exceeds {max_width}; no text truncation allowed"
        )
    array = (
        1.0
        - np.asarray(
            image.convert("L").resize((width, height), Image.Resampling.BILINEAR),
            dtype=np.float32,
        )
        / 255.0
    )
    return array
La première instruction calcule la nouvelle largeur à partir du rapport entre les hauteurs, avec un minimum de 4 pixels. À titre d'exemple de calcul, une image de 400 pixels de large et de 64 pixels de haut devient une image de 200 × 32 pixels. Ces dimensions illustrent le code ; elles ne décrivent pas une mesure supplémentaire du corpus.
image.convert("L") transforme l'image en niveaux de gris. resize effectue le redimensionnement avec l'interpolation bilinéaire indiquée dans le code. Ces opérations sont documentées dans le module Image de Pillow.
np.asarray(..., dtype=np.float32) transforme ensuite l'image en tableau de nombres. La division par 255 ramène les intensités entre 0 et 1 ; 1.0 - ... inverse cette échelle. Un pixel noir, initialement à 0, devient 1. Un pixel blanc, initialement à 255, devient 0. L'encre sombre correspond donc aux valeurs élevées.
Nous avons maintenant une image numérique de hauteur connue, sans avoir imposé que toutes les lignes contiennent le même nombre de caractères.
CNN puis GRU : construire la séquence
Le CNN : apprendre des motifs, pas une règle par lettre
Un CNN, pour Convolutional Neural Network, est un réseau convolutif. Il applique des filtres sur différentes zones de l'image. Les valeurs de ces filtres sont apprises pendant l'entraînement : nous n'écrivons pas une succession de conditions du type « si cette forme ressemble à un A… ».
Ces filtres peuvent représenter des bords, des fragments de lettres ou des espaces. C'est une façon de comprendre leur rôle, pas une inspection des filtres effectivement appris dans cette expérience.
Dans notre réseau, trois convolutions construisent ces représentations visuelles. Deux opérations de max-pooling réduisent la résolution en conservant le maximum de petites zones. Le code utilise des zones de 2 × 2, ce qui réduit progressivement la hauteur et la largeur. Les contrats de ces opérations figurent dans les documentations de Conv2d et de MaxPool2d.
Le GRU : replacer chaque position dans son voisinage
Un GRU, pour Gated Recurrent Unit, est un réseau récurrent : il conserve un état au fur et à mesure qu'il parcourt une séquence. Ici, cette séquence correspond à la largeur de la ligne après son passage dans le CNN.
La version bidirectionnelle parcourt cette représentation de gauche à droite et de droite à gauche. Une position peut ainsi être interprétée avec du contexte des deux côtés. Ce voisinage peut aider à distinguer un 0 d'un O, sans garantir que la distinction sera correcte. La documentation du GRU de PyTorch décrit cette combinaison des deux directions.
L'association du réseau convolutif et du réseau récurrent s'appelle ici un CRNN. Une projection finale produit, pour chaque position, un score par caractère de l'alphabet, ainsi qu'un score pour le symbole technique CTC blank.
Suivre le trajet des nombres dans le code
Voici la classe complète, dans src/pdfctc/model.py. Observez les trois parties : cnn, gru et projection.
class CRNN(nn.Module):
    def __init__(self, classes):
        super().__init__()
        self.cnn = nn.Sequential(
            nn.Conv2d(1, 32, 3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(64, 128, 3, padding=1),
            nn.ReLU(),
        )
        self.gru = nn.GRU(128, 128, num_layers=2, bidirectional=True, batch_first=True)
        self.projection = nn.Linear(256, classes)

    def forward(self, images, lengths):
        features = self.cnn(images).mean(dim=2).transpose(1, 2)
        # The backward GRU must not read the right-hand padding as real context.
        packed = pack_padded_sequence(
            features, lengths.cpu(), batch_first=True, enforce_sorted=False
        )
        encoded, _ = self.gru(packed)
        encoded, _ = pad_packed_sequence(
            encoded, batch_first=True, total_length=features.shape[1]
        )
        return self.projection(encoded).transpose(0, 1)
__init__ définit les couches et leurs dimensions. forward décrit le trajet des données à travers ces couches : c'est cette méthode qui transforme un lot d'images en scores.
Les convolutions passent d'un canal d'entrée, les niveaux de gris, à 32, puis 64, puis 128 canaux de caractéristiques. Les ReLU introduisent des transformations non linéaires entre les convolutions. Une fois ces motifs extraits, mean(dim=2) moyenne la hauteur restante ; transpose(1, 2) place les positions horizontales dans l'ordre attendu par le GRU.
Pour rendre ces manipulations concrètes, suivons une image normalisée de 200 × 32 pixels, uniquement comme exemple de dimensions déduit du code. Ce n'est pas une sortie d'exécution publiée.
| Étape | Représentation de cette ligne |
|---|---|
| Entrée | 1 canal, hauteur 32, largeur 200. |
| Après les trois convolutions et les deux max-poolings | 128 canaux, hauteur 8, largeur 50. |
| Après la moyenne sur la hauteur et la transposition | 50 positions successives, chacune décrite par 128 valeurs. |
| Après le GRU bidirectionnel | 50 positions, chacune décrite par 256 valeurs : 128 par direction. |
| Après la projection | 50 positions, avec un score pour chaque symbole possible. |
Ces positions sont appelées pas temporels. Le terme peut surprendre : nous ne traitons pas ici une vidéo ou un signal sonore. Le « temps » désigne simplement l'avancement dans la séquence horizontale.
50 pas ne signifient pas 50 caractères. Plusieurs pas peuvent contribuer au même caractère, et certains pourront produire un blank. C'est pour cela qu'un mécanisme d'alignement et de décodage est nécessaire.
La dernière transposition renvoie les scores dans l'ordre des dimensions attendu pour CTC : pas temporels, éléments du lot, classes de symboles. Un score brut s'appelle un logit. Il n'est encore ni une probabilité ni une lettre définitivement reconnue.
Ne pas confondre le remplissage avec du contenu
Pour traiter ensemble plusieurs lignes de largeurs différentes, on les place dans un lot, ou batch, avec une largeur commune. Les lignes les plus courtes ont donc une marge artificielle à droite : le padding, ou remplissage.
lengths conserve les longueurs réelles après la réduction effectuée par le CNN. pack_padded_sequence permet au GRU de travailler sur ces longueurs, plutôt que sur toute la largeur remplie. C'est particulièrement important dans le sens droite-gauche : sinon, il commencerait par lire de la marge artificielle comme si elle faisait partie de la ligne.
pad_packed_sequence remet ensuite les résultats dans un tableau de dimensions communes. Vous trouverez le contrat de cet empaquetage dans la documentation de pack_padded_sequence.
CTC : blank, répétitions et longueurs
Le problème : une transcription, mais pas l'emplacement de chaque lettre
Nous savons que notre ligne doit contenir BOLT AA11 12.50. Mais nous n'avons pas indiqué au réseau quels pas correspondent au premier A, au second A, puis aux deux 1.
CTC, pour Connectionist Temporal Classification, traite cette absence d'alignement précis. Au lieu d'imposer un caractère attendu à chaque pas, elle additionne les probabilités des chemins compatibles avec la transcription entière. Un chemin est une succession de symboles, un par pas, avant leur réduction en texte.
Le principe est présenté dans l'article fondateur de Graves, Fernández, Gomez et Schmidhuber sur CTC (2006). Il permet d'apprendre à partir de la séquence attendue sans exiger sa segmentation caractère par caractère. Dans notre projet, la localisation des lignes reste néanmoins une étape séparée.
Le blank : un séparateur technique, pas un espace
Prenons le chemin de l'exemple fourni : A, A, blank, A, 1, 1, blank, 1.
Pour le transformer en texte, il faut fusionner les répétitions consécutives, puis retirer les blanks, dans cet ordre :
Chemin initial       : A, A, blank, A, 1, 1, blank, 1
Après fusion         : A, blank, A, 1, blank, 1
Après retrait        : A, A, 1, 1
Texte obtenu         : AA11
Les deux premiers A sont voisins : ils deviennent un seul A. Le suivant est séparé par un blank : il reste un caractère distinct. Le même mécanisme s'applique aux deux 1 que nous souhaitons conserver.
Essayons maintenant l'ordre inverse, volontairement incorrect :
Chemin initial       : A, A, blank, A, 1, 1, blank, 1
Retrait prématuré     : A, A, A, 1, 1, 1
Fusion ensuite       : A, 1
Texte obtenu         : A1
Nous avons perdu les répétitions qui faisaient partie de l'identifiant. Ce n'est pas un détail cosmétique : AA11 et A1 ne sont pas la même référence.
Le blank n'est pas le caractère espace. Dans BOLT AA11 12.50, les espaces visibles font partie de l'alphabet et doivent être reconnus. Le blank sert au mécanisme d'alignement ; il ne doit pas apparaître dans la transcription finale.
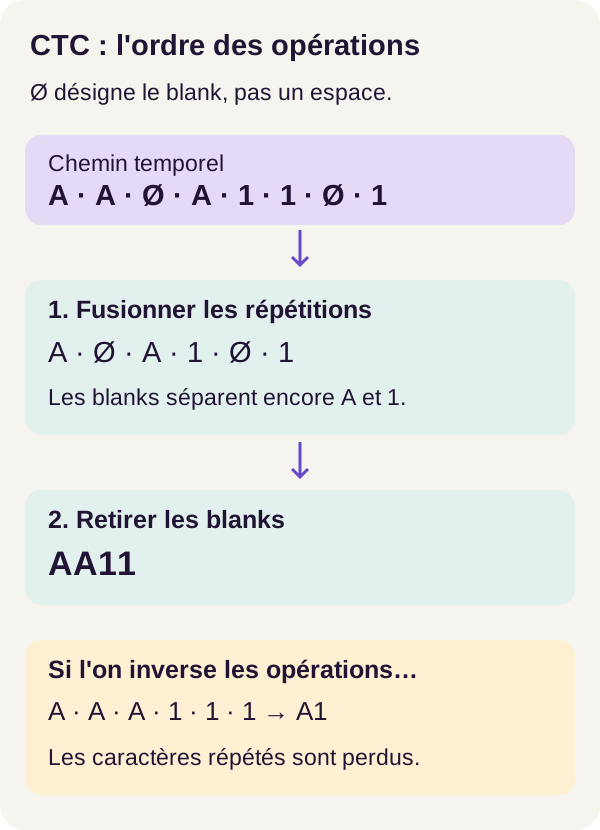
Le blank conserve la séparation entre deux caractères identiques jusqu'à la fin du décodage.
Un décodeur court, mais un ordre d'opérations essentiel
Le décodeur manipule des identifiants numériques de symboles. Dans src/pdfctc/decode.py, collapse effectue la réduction correcte, tandis que wrong_collapse rend l'erreur précédente testable.
Voici la fonction centrale. L'identifiant du blank est 0 :
def collapse(path, blank=0):
    """Merge runs first; a blank separates identical visible symbols."""
    result = []
    previous = None
    for symbol in path:
        symbol = int(symbol)
        if symbol != previous and symbol != blank:
            result.append(symbol)
        previous = symbol
    return result
previous mémorise le symbole précédent. Nous ajoutons le symbole courant seulement s'il est différent du précédent et s'il n'est pas le blank.
Le point décisif se trouve à la fin de la boucle : previous est mis à jour même pour un blank. Un A rencontré après ce blank est donc comparé au blank, et non au dernier A visible. Il peut être conservé.
Le code réalise ainsi en un parcours les deux opérations que nous avons séparées pour les expliquer. Attention également à ne pas confondre l'identifiant technique 0 avec le chiffre imprimé 0 : la classe du blank et celle d'un caractère visible ont des rôles différents.
Vérifions cette mécanique avec la commande du projet :
docker compose run --rm tutorial python -m pdfctc.cli explain-ctc --text AA11
Observez les chemins et les textes obtenus. Les exemples de décodage ci-dessus expliquent ce mécanisme ; ils ne sont pas des prédictions obtenues sur les scans.
Pourquoi quatre caractères peuvent demander six pas
Pour produire AA11, il faut au moins un pas pour chaque caractère, plus un pas de séparation entre les deux A et entre les deux 1. Un chemin minimal est donc A, blank, A, 1, blank, 1 : six pas pour quatre caractères.
Plus généralement, le minimum est le nombre de caractères, auquel on ajoute le nombre de paires de caractères identiques adjacents. C'est le type de contrainte vérifié par minimum_steps avant de calculer la perte. Si la séquence visuelle est trop courte, le problème est impossible dans ce cadre, même avec de bons paramètres.
Retenez bien les deux longueurs : celle de la sortie temporelle du réseau, et celle de la transcription attendue. Elles n'ont ni la même valeur ni la même fonction.
La perte CTC : le signal qui permet d'apprendre
Une fonction de perte, ou loss, mesure l'écart entre ce que produit le modèle et ce qu'on attend. Elle fournit le signal utilisé pour ajuster les paramètres. Ici, CTC travaille sur les probabilités des chemins compatibles, pas sur une boîte attendue pour chaque lettre.
L'appel respecte le contrat de torch.nn.CTCLoss : log-probabilités, cibles, longueurs d'entrée et longueurs de cible. La documentation correspondant à PyTorch 2.8 permet de consulter ce contrat pour la version du parcours.
La fonction du projet vérifie d'abord que les données permettent ce calcul :
def ctc_loss(logits, lengths, targets, target_lengths):
    offset = 0
    for time, size in zip(lengths.tolist(), target_lengths.tolist()):
        target = targets[offset : offset + size].tolist()
        offset += size
        if not target or 0 in target or time < minimum_steps(target):
            raise ValueError(
                f"CTC impossible: T={time}, L={size}, minimum={minimum_steps(target)}"
            )
    if offset != len(targets):
        raise ValueError("Target lengths do not sum correctly")
    # Transfer is differentiable: all network parameters and their gradients remain on CUDA.
    log_probs = logits.log_softmax(-1).cpu()
    loss = torch.nn.functional.ctc_loss(
        log_probs,
        targets.cpu(),
        lengths.cpu(),
        target_lengths.cpu(),
        blank=0,
        reduction="mean",
        zero_infinity=False,
    )
    if not torch.isfinite(loss):
        raise ValueError("Non-finite CTC loss")
    return loss
targets contient les transcriptions encodées en identifiants et concaténées. target_lengths indique combien d'identifiants appartiennent à chaque transcription. offset avance donc dans ce grand tableau pour retrouver la cible de chaque ligne.
Le premier contrôle refuse une cible vide, un blank dans la cible ou une séquence trop courte. Le second vérifie que les longueurs annoncées correspondent bien au nombre total d'identifiants. Ces refus sont des garde-fous du projet : ils rendent les erreurs explicites avant l'apprentissage.
log_softmax(-1) transforme les logits en log-probabilités, sur la dimension des symboles. C'est la représentation attendue par CTC ; la documentation de log_softmax explique le calcul combiné et sa stabilité numérique.
reduction="mean" produit une perte agrégée : PyTorch divise les pertes des exemples par leurs longueurs de cible, puis calcule leur moyenne sur le lot. zero_infinity=False évite de remplacer automatiquement les pertes infinies par zéro, et torch.isfinite(loss) refuse une perte infinie ou non numérique. Masquer une impossibilité ne la résoudrait pas.
Dernière particularité : la perte CTC est calculée sur CPU dans ce projet, tandis que les paramètres du réseau et leurs gradients restent sur CUDA. Le transfert reste différentiable : il ne coupe pas le suivi des opérations qui permet de faire remonter le signal d'apprentissage. Un gradient indique comment une petite variation d'un paramètre influence la perte ; la documentation d'Autograd présente ce suivi automatique.
C'est un choix du code démontré, pas une recommandation générale de performance. La perte CTC sert à entraîner le réseau ; le taux d'erreur caractère servira ensuite à évaluer les textes effectivement produits. Ne confondons pas ces deux mesures.
Entraîner et vérifier une reprise
Comparer deux façons d'apprendre
Une époque est un passage sur les exemples d'entraînement. Au fil de ces passages, le réseau produit des scores, la perte CTC est calculée, puis l'optimiseur ajuste les paramètres à partir des gradients.
Le projet compare un modèle entraîné avec des dégradations et un modèle entraîné uniquement sur des images propres, avec le même budget et la même initialisation. L'ajout de dégradations est une forme d'augmentation de données : nous exposons le réseau à des variations visuelles pour tenter de le rendre plus robuste.
L'idée paraît raisonnable, mais ce n'est pas une garantie. Il faudra vérifier si le modèle augmenté fait réellement mieux, sur les mêmes images de test.
Interrompre, reprendre, puis comparer
Nous allons aussi contrôler la reprise d'entraînement. Exécutez l'entraînement interrompu, la variante propre, la référence continue, puis la reprise :
docker compose run --rm tutorial python -m pdfctc.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfctc.cli train-clean --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfctc.cli train-continuous --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfctc.cli train-resume --config configs/minimum.yaml
train s'arrête après 7 époques. La référence train-continuous en réalise 15 sans cette interruption. train-resume recharge l'état interrompu et effectue les 8 époques restantes. La commande train-clean fournit, elle, le modèle de comparaison entraîné sur images propres.
Ces commandes ne prolongent donc pas toutes un même modèle dans une longue succession : elles construisent les variantes nécessaires aux comparaisons.
Un checkpoint ne se résume pas aux poids du réseau. Pour poursuivre la même expérience, il faut aussi retrouver l'état de l'optimiseur et les autres états utiles à la reprise. L'optimiseur est le mécanisme qui effectue les mises à jour des paramètres ; sa mémoire peut influencer les prochaines étapes.
Contrôlons maintenant que l'interruption n'a pas changé le résultat :
docker compose run --rm tutorial python -m pdfctc.cli verify-resume --config configs/minimum.yaml
Le parcours validé retourne une reprise exacte. La comparaison porte sur les paramètres, l'optimiseur, les états aléatoires, l'historique et les données. Nous ne nous contentons donc pas de constater que deux courbes se ressemblent.
Cette exactitude concerne l'environnement validé. Modifier les dépendances ou le matériel demande de revérifier le comportement ; le résultat ne promet pas une identité automatique entre toutes les machines.
Transcrire sans lire les réponses attendues
L'inférence est le moment où nous utilisons les paramètres appris pour produire une transcription. Il ne s'agit plus d'ajuster le réseau à partir de la réponse connue.
Le service d'inférence monte les pixels et les checkpoints en lecture seule. Les annotations ne sont pas disponibles dans ce service : il doit retrouver les lignes, calculer les scores temporels et décoder les caractères à partir des images.
docker compose run --rm inference python -m pdfctc.cli predict --config configs/minimum.yaml
Les prédictions sont écrites dans outputs/. Consultez quelques lignes avant de regarder les moyennes globales. Une chaîne peut avoir une apparence plausible tout en contenant une erreur sur un identifiant ou un montant.
L'évaluation retrouvera ensuite les annotations pour comparer les textes. Elle associe les prédictions aux références à partir des boîtes, et non en choisissant après coup le texte qui donne le meilleur score. Le programme doit comparer la bonne ligne à la bonne référence, même lorsque la reconnaissance s'est trompée.
Lire les métriques avant les valeurs
Compter les erreurs de caractères
Le CER, pour Character Error Rate, est le taux d'erreur caractère. Il vaut (S + I + D) / N.
S compte les substitutions, lorsqu'un caractère remplace un autre. I compte les insertions, lorsqu'un caractère apparaît en trop. D compte les suppressions, lorsqu'un caractère attendu manque. N est le nombre de caractères dans la référence.
Par exemple, une substitution et une suppression sur dix caractères attendus donnent (1 + 0 + 1) / 10 = 0,2. C'est un exemple de calcul, pas une mesure supplémentaire du modèle.
Un CER de 0,34 ne signifie pas que 34 % des lignes sont fausses. Il rapporte des erreurs de caractères au nombre de caractères attendus. Il peut même dépasser 1 si les erreurs, notamment les insertions, sont suffisamment nombreuses. Ce n'est donc pas une simple proportion de lignes réussies ou ratées.
Vérifier aussi ce que l'application doit vraiment utiliser
L'exactitude de ligne exige que toute la ligne soit correcte. Une seule lettre incorrecte suffit à faire échouer cette vérification, même si le reste est lisible.
L'exactitude d'identifiant vérifie séparément le deuxième champ. Dans notre exemple BOLT AA11 12.50, ce champ est AA11. C'est une mesure utile pour ne pas perdre de vue ce qui compte dans un import : une bonne partie du texte reconnue ne compense pas une mauvaise référence produit.
Enfin, la couverture de segmentation est le nombre de lignes appariées par la géométrie, divisé par le nombre de lignes de référence. Une couverture de 1 signifie que toutes les lignes ont été appariées. Elle ne dit pas que le texte est correct, ni que chaque recadrage est identique à celui de l'annotation.
Distinguer la chaîne complète du diagnostic « gold crop »
Les mesures portent sur 900 lignes et 19 358 caractères de test.
La mesure de bout en bout utilise toute la chaîne, y compris la segmentation par projection, qui cherche les lignes à partir des rangées de pixels sombres. C'est ce qui se rapproche du trajet réel du document dans ce projet.
Le diagnostic gold crop fournit directement les recadrages de référence à la reconnaissance. On retire ainsi le choix des boîtes effectué par la segmentation pour examiner la lecture sur les zones annotées.
Le terme gold désigne la référence, pas une promesse de meilleur score. Ce diagnostic ne remplace pas la mesure de la chaîne complète et ne représente pas une prédiction autonome à partir de toute la page.
Calculons les mesures sur les prédictions :
docker compose run --rm tutorial python -m pdfctc.cli evaluate --config configs/minimum.yaml
Ce que montrent les résultats du parcours r001
Le modèle initial, avant entraînement, obtient un CER de 0,9950, sur les vues propres comme dégradées. Les résultats suivants permettent de comparer l'effet de l'entraînement et celui des images utilisées pour l'évaluation. Un CER plus faible est meilleur.
| Modèle | Vue évaluée | CER |
|---|---|---|
| Initial, non entraîné | Propre et dégradée | 0,9950 |
| Entraîné sur images propres, chaîne complète | Propre | 0,3387 |
| Entraîné sur images propres, chaîne complète | Dégradée | 0,3694 |
| Entraîné avec dégradations, chaîne complète | Propre | 0,4103 |
| Entraîné avec dégradations, chaîne complète | Dégradée | 0,4131 |
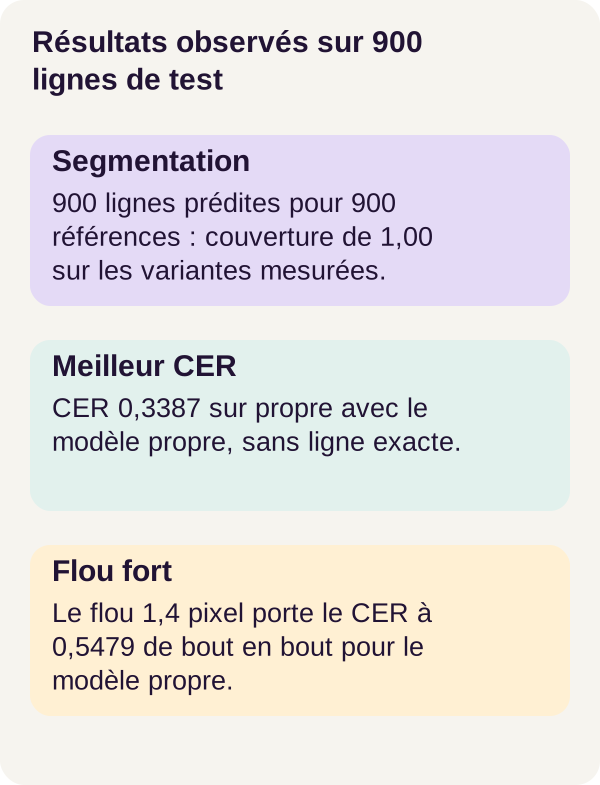
Le meilleur résultat est donc le modèle entraîné sur scans propres, évalué de bout en bout sur la vue propre : CER 0,3387, avec 900 lignes prédites pour 900 références et une couverture de 1,00.
Mais il obtient aussi 0 ligne exacte et 0 identifiant exact sur 900. La chaîne retrouve les lignes, et le modèle a progressé par rapport à son initialisation, mais le résultat n'est pas un extracteur de données métier utilisable.
Sur la vue dégradée, ce même modèle obtient 0,3694 dans la chaîne complète et 0,3803 avec les crops gold. Ici, le diagnostic sur recadrages de référence ne donne donc pas un CER inférieur. Ces deux moyennes ne suffisent pas, à elles seules, à identifier la cause de cet écart : il faut inspecter les exemples avant d'avancer une explication.
Enfin, le modèle entraîné avec dégradations reste à 0,4103 sur la vue propre, puis 0,4131 de bout en bout sur la vue dégradée. L'augmentation choisie ne gagne pas contre l'entraînement propre sur ce corpus et avec ce budget. C'est un résultat négatif à conserver, pas une anomalie à retirer du récit.
Cela ne démontre pas que toute augmentation de données serait inutile. Cela montre que cette augmentation, dans cette expérience, n'a pas apporté le gain espéré. Changer les transformations ou le budget demanderait de nouvelles mesures.
Ce que nous avons appris
L'OCR rassemble plusieurs problèmes : localiser le texte, représenter ses pixels, contextualiser une séquence, puis la décoder. Une bonne réponse à l'un de ces problèmes ne résout pas automatiquement les suivants.
Le CNN apprend des motifs locaux ; le GRU relie les positions horizontales ; CTC permet d'apprendre à partir des transcriptions sans imposer une boîte à chaque caractère. Son blank gère l'alignement et les répétitions : il ne représente pas un espace.
Les mesures nous donnent deux leçons concrètes. Retrouver toutes les lignes ne signifie pas savoir les lire. Et ajouter des dégradations ne garantit pas un modèle plus robuste. La question utile reste : quelles erreurs subsistent, sur quels documents et avec quelles conséquences ?
Exercice : prévoir avant de mesurer
Écrire une hypothèse avant de lancer la commande
Nous allons changer une seule variable : la force du flou, sans réentraîner le réseau.
Avant de lancer l'expérience, notez ce que vous attendez. Le CER va-t-il augmenter ? La segmentation perdra-t-elle nécessairement des lignes ? Le modèle entraîné avec dégradations doit-il forcément mieux résister que celui entraîné sur images propres ? Distinguez une hypothèse raisonnable d'un résultat déjà connu.
Pour vérifier votre compréhension du blank, calculez aussi à la main le décodage du chemin A, blank, A, A, 1, blank, 1, 1. Essayez l'ordre correct des opérations, puis l'ordre inversé. Écrivez les deux textes obtenus avant de lire la correction.
Exécuter la variante fournie
configs/exercise.yaml fixe un flou de 1,4 pixel et conserve les checkpoints. Nous utilisons donc les mêmes modèles pour observer l'effet d'images plus difficiles, pas pour leur apprendre à s'y adapter.
docker compose run --rm tutorial python -m pdfctc.cli exercise --config configs/exercise.yaml
Ouvrez les résultats d'exercice et comparez-les à votre prédiction. Pour le chemin proposé, le bon décodage donne AA11 ; retirer d'abord les blanks conduit à A1. Les fichiers produits et lesson/SOLUTIONS.md permettent d'étudier la correction du parcours fourni.
La variante fortement floue, sans réentraînement, confirme le décalage. Le modèle entraîné sur images propres atteint un CER de 0,5479 de bout en bout et de 0,5660 avec les crops gold. Le modèle augmenté atteint respectivement 0,5617 et 0,5918.
La couverture demeure 1,00, tandis que l'exactitude de ligne et d'identifiant reste nulle. Le programme continue à retrouver les lignes, mais leur contenu est plus difficile à transcrire. La segmentation et la reconnaissance ne se dégradent donc pas nécessairement de la même manière.
Prolonger l'expérience sans tout changer à la fois
Vous pouvez ensuite faire varier uniquement l'intensité d'une dégradation du générateur. Conservez le modèle, les pages et les annotations, puis prédisez et mesurez de nouveau.
Cette modification personnelle est distincte de la variante fournie : son résultat n'est pas connu à l'avance. Ne changez pas simultanément les données et l'entraînement, sinon vous ne saurez plus à quoi attribuer l'écart observé.
La progression n'est pas nécessairement monotone pour chaque page : augmenter la dégradation ne garantit pas que chaque transcription individuelle empirera à chaque essai. Inspectez aussi les exemples qui contredisent votre intuition et expliquez-les sans les écarter.
Générer les figures et contrôler les fichiers
Produisez les figures à partir de vos résultats, puis vérifiez les checkpoints :
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Les six checkpoints du parcours de référence passent leur contrôle de structure et d'identité. Ce contrôle porte sur les fichiers attendus ; il ne transforme pas un modèle peu précis en modèle fiable.
Regardez ensuite les courbes et les exemples de lignes dans outputs/. Un CER agrégé indique l'ampleur globale des erreurs, mais les exemples permettent de voir ce qui se passe : des caractères sont-ils confondus, ajoutés ou perdus ? Comparez la transcription à l'image plutôt que de vous contenter de sa plausibilité.
Tester les erreurs et se dépanner
Un cas négatif vérifie que le programme refuse une situation incohérente. Réussir ce test signifie donc obtenir le refus attendu, et non parvenir malgré tout à produire une sortie.
Les tests couvrent notamment une cible CTC vide, un blank interdit dans la transcription cible, un nombre insuffisant de pas temporels et une ligne trop large. Ne contournez pas ces erreurs en coupant silencieusement le texte ou en masquant une perte impossible : vous modifieriez le problème au lieu de le résoudre.
Sur mobile, faites défiler le tableau horizontalement.
| Symptôme | Vérification et correction |
|---|---|
| Le GPU apparaît sur l'hôte mais CUDA échoue dans Docker | Comparez preflight et check_environment.py, puis corrigez l'intégration NVIDIA avant l'entraînement. |
| Une ligne dépasse la largeur prévue | Inspectez sa boîte et son redimensionnement. Le corpus personnel peut exiger une autre segmentation, à évaluer comme une modification du projet. |
| CTC refuse une cible | Vérifiez les longueurs, les répétitions et l'absence du blank dans les caractères attendus. |
| Un checkpoint manque | Retrouvez l'étape d'entraînement correspondante et son erreur ; un fichier absent ne doit pas être remplacé par des poids arbitraires. |
| Le disque est plein | Vérifiez l'espace des scans, checkpoints et résultats. Conservez les fichiers utiles avant le nettoyage ciblé ci-dessous. |
Arrêter et nettoyer
Copiez d'abord les résultats et figures que vous souhaitez conserver. La première commande arrête le projet. Le script affiche puis efface uniquement outputs/. Le dernier arrêt termine le parcours après l'exécution du nettoyage.
Le contenu de outputs/ sera supprimé. Les scans restent dans data/generated/ et les checkpoints dans assets/checkpoints/.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Aucun volume Docker global n'est supprimé. Pour refaire le parcours, utilisez les mêmes instructions et les dépendances verrouillées du ZIP. Un nettoyage ciblé permet de savoir ce qui est supprimé sans toucher à vos autres projets.
Du tutoriel à une application réelle
Le premier travail ne serait pas d'ajouter une route HTTP, mais de disposer de documents représentatifs et d'une qualité mesurée sur ces documents.
Remplacez le corpus fictif par des documents autorisés, accompagnés de leurs annotations. Séparez les données de façon à éviter les fuites entre apprentissage et test par fournisseur, gabarit ou lot. Mesurez le CER et les critères réellement utiles à votre application sur des sources distinctes. Les langues, rotations, tableaux, pages complexes et écritures manuscrites demandent des données et des évaluations supplémentaires.
L'intégration web vient avec d'autres responsabilités : authentification, droits documentaires, limites de fichiers, traitement asynchrone, supervision et tests de charge, selon le contexte. Une API asynchrone permettrait, par exemple, de séparer le dépôt du document de la récupération de son résultat ; ce n'est pas une fonctionnalité fournie par ce tutoriel.
Protégez les données, versionnez les modèles et prévoyez un contrôle humain des identifiants et montants critiques. L'isolation du parseur PDF, c'est-à-dire de la bibliothèque qui ouvre et interprète le fichier, ainsi que la maintenance des bibliothèques natives font partie de l'exploitation.
Le réseau de ce tutoriel n'offre pas une qualité suffisante pour automatiser une extraction métier sans contrôle. Son intérêt est de rendre le mécanisme et ses limites observables, pour savoir ce qu'il faudra améliorer et vérifier ensuite.
Pour aller plus loin
Commencez par construire un corpus annoté représentatif de vos propres scans. Étudiez séparément les erreurs de segmentation et celles de reconnaissance : une image de ligne mal découpée et une lettre mal reconnue n'appellent pas la même investigation.
Vous pouvez ensuite comparer un autre budget d'entraînement en gardant un jeu de test fixe, ou tester un décodage qui explore plusieurs chemins. Dans les deux cas, mesurez l'apport réel plutôt que de le déduire du seul choix de la technique. Ce sont des prolongements à expérimenter, pas des améliorations déjà validées dans le parcours r001.
Les liens documentaires intégrés au fil du texte approfondissent les mécanismes : opérations d'image dans Pillow, couches et longueurs de séquence dans PyTorch, puis principe de CTC dans l'article fondateur. Les références PyTorch 2.8 correspondent à la version utilisée ici ; les autres documentations peuvent évoluer. Pour reproduire l'expérience, les configurations et dépendances verrouillées du ZIP restent votre point de départ.