





Un escaneo no es texto
Está desarrollando una importación de documentos. Un usuario carga un albarán de «Cedar Parts» en PDF: en pantalla, lee sin dificultad BOLT AA11 12.50 y SEAL B00 7.20. Inicia la extracción de texto… y no obtiene nada.
¿Por qué? Porque ese PDF contiene una imagen de la página, no los caracteres que ve. Es un poco como recibir la captura de pantalla de un formulario en lugar de sus campos: la información es visible, pero ya no está disponible como cadenas de caracteres.
Ese es el punto de partida del OCR, por Optical Character Recognition o reconocimiento óptico de caracteres. Hay que pasar de los píxeles al texto. Y vamos a construir ese paso, en lugar de limitarnos a llamar a un servicio que oculte su funcionamiento.
Nuestro campo de pruebas será deliberadamente limitado: líneas impresas de un corpus ficticio, con un alfabeto restringido. No aprenderemos a leer todas las facturas del mundo, la escritura manuscrita o páginas con maquetaciones complejas. En cambio, entenderemos cómo una red aprende a transcribir una línea sin indicarle la posición de cada carácter.
Los resultados también formarán parte del aprendizaje: este pequeño modelo progresa, pero su calidad final sigue siendo insuficiente para automatizar una extracción de negocio. Veremos con precisión qué funciona y qué no.
Descargar el proyecto completo del tutorial
Lo que va a construir y aprender
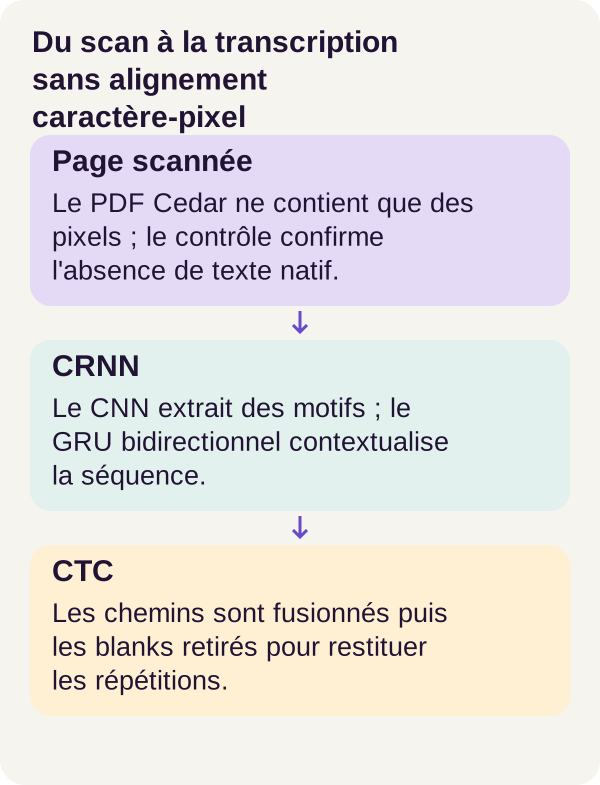
La cadena sigue el documento: PDF escaneado → imagen → líneas detectadas → red CNN-GRU → puntuaciones de caracteres → decodificación CTC → texto.
No intente memorizar aún todas las siglas. Para empezar, representemos tres responsabilidades.
Encontrar las líneas. Localizamos las zonas de la página que contienen texto y recortamos una pequeña imagen por línea. Esta etapa se llama segmentación.
Analizar cada imagen de línea. La CNN transforma los píxeles en patrones visuales. La GRU relaciona esta información recorriendo la línea en ambos sentidos. Su asociación produce una sucesión de puntuaciones para los caracteres posibles.
Aprender y decodificar sin recortar cada letra. CTC permite entrenar la red con la transcripción completa de la línea e interpretar después una secuencia que puede contener repeticiones y símbolos técnicos.
Entrenaremos esta red desde su inicialización, comprobaremos que sabe reanudarse después de una interrupción y mediremos por separado el recorte y el reconocimiento. Terminaremos con un experimento: hacer los escaneos más borrosos sin reentrenar el modelo, predecir qué ocurrirá y comparar después nuestra intuición con los resultados.
El hilo conductor será AA11. Este pequeño identificador es especialmente interesante: ¿cómo distinguir dos A reales de una misma A que la red habría propuesto varias veces? Ese es precisamente uno de los problemas que CTC permite tratar.
Preparar el proyecto y comprobar la GPU
Debe saber programar en Python, usar un terminal e iniciar Docker. No necesita haber entrenado ya un modelo. Explicaremos los conceptos cuando los usemos.
No obstante, una primera palabra merece una definición: un tensor es aquí una tabla numérica de una o varias dimensiones. Una imagen, un lote de imágenes o puntuaciones de caracteres se representarán mediante tales tablas. La red también contiene números, sus parámetros, que el entrenamiento ajusta para reducir el error sobre transcripciones conocidas.
Retomar el entorno del recorrido validado
El recorrido se ejecutó con una RTX 3090, Python 3.11.16, PyTorch 2.8.0+cu126 y CUDA 12.6. PyTorch es la biblioteca utilizada para construir y entrenar la red; CUDA permite ejecutar en la GPU NVIDIA los cálculos previstos.
Estas versiones describen el entorno validado. El Dockerfile del ZIP fija las dependencias: no las sustituya por las últimas versiones en una primera reproducción. Consulte el README para el dimensionamiento y prevea el espacio necesario para las imágenes Docker, los escaneos generados y los checkpoints, es decir, las copias de seguridad del entrenamiento.
Descomprima el ZIP y sitúe el terminal en su carpeta raíz, la que contiene README.md. Todos los comandos siguientes se ejecutan desde esta carpeta, en el orden indicado. Los extractos de código explicados más adelante pertenecen al proyecto completo; no sustituyen sus otros archivos.
Empecemos por la comprobación del host, llamada preflight:
sh scripts/preflight.sh
Una GPU visible en Linux no garantiza que Docker pueda utilizarla. NVIDIA Container Toolkit proporciona la integración entre Docker y los controladores del host; su documentación oficial detalla la instalación según el sistema. Comprobaremos el acceso a CUDA del contenedor después de construirlo.
Construir los servicios y comprender su función
Preparemos los directorios, comprobemos la configuración de Compose y construyamos los servicios:
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
acquisition comprueba los recursos del proyecto. tutorial prepara los datos y entrena la red. inference transcribe los escaneos con los pesos guardados. Los archivos se distribuyen entre data/generated/ para los escaneos, assets/checkpoints/ para los estados del modelo y outputs/ para los resultados.
No hay pesos OCR preentrenados que descargar. Aquí la red aprende desde su inicialización; no especializamos un motor ya entrenado. La etapa de adquisición se conserva en el recorrido y por ello informa cero bytes de pesos externos. Esto no significa que la construcción de las imágenes Docker no requiera descargas.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
Comprobemos ahora CUDA desde el contenedor y después las pruebas del proyecto:
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
La comprobación de entorno debe confirmar el acceso a la GPU. Las 26 pruebas correctas del recorrido de referencia cubren, entre otros elementos, la segmentación, las longitudes y la decodificación.
Piense en las pruebas de su aplicación: verificar que una función cumple su contrato no equivale a verificar la pertinencia de todos los datos que producirá. Aquí también, que las pruebas sean correctas no significa que todas las transcripciones sean correctas.
Los servicios de entrenamiento e inferencia no tienen red después. El archivo Compose completo describe los volúmenes de solo lectura, el usuario sin privilegios, las capacidades retiradas y los límites de recursos. Estas restricciones reducen los accesos del programa; no constituyen una protección completa frente a toda vulnerabilidad de las bibliotecas nativas.
Un albarán realmente rasterizado
Fabricar escaneos cuya respuesta conocemos
Para entrenar un OCR necesitamos imágenes y su transcripción esperada. El proyecto fabrica por sí mismo estos ejemplos: así podemos conocer la respuesta sin pedir a alguien que copie cada línea.
El generador prepare, en src/pdfctc/corpus.py, compone 600 páginas de diez líneas. Las renderiza como imagen, reinserta esa imagen en un PDF y luego transforma de nuevo ese PDF en imagen. Esta transformación a píxeles se llama rasterización.
¿Por qué estos pasos? Para que el documento enviado a nuestra cadena sea realmente un PDF escaneado, y no un PDF cuyos caracteres ocultos detrás de la visualización el programa podría simplemente releer. El generador verifica que el texto nativo esté vacío.
Cada página existe en tres vistas: limpia, degradada o muy borrosa. Son versiones diferentes de una misma página, no tres familias documentales independientes. El corpus es ficticio, se imprime con caracteres ASCII y una fuente PDF estándar. No representa la diversidad de facturas, idiomas o manuscritos de una empresa.
Separar los documentos antes de aprender
Las 60 familias de documentos se distribuyen en 42 para el entrenamiento, 9 para la validación y 9 para la prueba. Esto representa respectivamente 4.200, 900 y 900 líneas.
El entrenamiento sirve para ajustar los parámetros. La validación sirve para observar el comportamiento durante el ajuste, sin ser el conjunto con el que se aprenden esos parámetros. La prueba sirve para medir el resultado sobre los ejemplos reservados para la evaluación final.
La separación se hace por familia de maquetación, no simplemente distribuyendo al azar todas las líneas. Así, una misma familia no aparece a ambos lados de la frontera entre aprendizaje y evaluación. Esto limita una comparación demasiado fácil entre documentos emparentados, sin cubrir por ello toda la diversidad de los documentos reales.
Una anotación contiene aquí la transcripción esperada y la caja que rodea la línea. Por tanto, conocemos el texto de una línea y su posición global, pero no proporcionamos una caja para cada letra. CTC nos evitará esta anotación carácter por carácter; no elimina la necesidad de transcripciones para entrenar el modelo.
Encontrar las líneas antes de reconocerlas
La función line_boxes, en src/pdfctc/segment.py, busca filas de píxeles oscuros, agrupa las filas vecinas y construye una caja por línea. Para representárselo, imagine que recorre la página de arriba abajo midiendo dónde está la tinta.
Este método es explícito y no una segunda red que entrenar. Localiza líneas; todavía no sabe qué contienen. El fragmento de imagen extraído de una caja se llama crop, o recorte.
Generemos los escaneos e inspeccionemos después estos recortes:
docker compose run --rm tutorial python -m pdfctc.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfctc.cli inspect-lines --config configs/minimum.yaml
Debe encontrar las 600 páginas y sus tres vistas. En los archivos de inspección, observe las cajas alrededor de las líneas y las anchuras después del redimensionado. El PDF generado debe seguir sin una capa de texto nativo: de lo contrario ya no probaríamos un reconocimiento a partir de píxeles.
Tome una línea y hágase dos preguntas distintas: «¿he recuperado toda la línea?» y «¿sabrá leerla la red?». La primera trata de la segmentación; la segunda, del reconocimiento.
Llevar las imágenes a un formato común
normalize, también en src/pdfctc/segment.py, lleva cada crop a 32 píxeles de altura, manteniendo sus proporciones. Una anchura superior a 512 píxeles provoca un error: nunca se corta en silencio el final del texto para hacer que la imagen quepa.
Esta es la función del proyecto:
def normalize(image, height=32, max_width=512):
    width = max(4, round(image.width * height / image.height))
    if width > max_width:
        raise ValueError(
            f"Line width {width} exceeds {max_width}; no text truncation allowed"
        )
    array = (
        1.0
        - np.asarray(
            image.convert("L").resize((width, height), Image.Resampling.BILINEAR),
            dtype=np.float32,
        )
        / 255.0
    )
    return array
La primera instrucción calcula la nueva anchura a partir de la relación entre las alturas, con un mínimo de 4 píxeles. Como ejemplo de cálculo, una imagen de 400 píxeles de ancho y 64 de alto se convierte en una imagen de 200 × 32 píxeles. Estas dimensiones ilustran el código; no describen una medida adicional del corpus.
image.convert("L") transforma la imagen en escala de grises. resize realiza el redimensionado con la interpolación bilineal indicada en el código. Estas operaciones están documentadas en el módulo Image de Pillow.
np.asarray(..., dtype=np.float32) transforma después la imagen en una tabla de números. La división entre 255 lleva las intensidades entre 0 y 1; 1.0 - ... invierte esa escala. Un píxel negro, inicialmente en 0, pasa a ser 1. Un píxel blanco, inicialmente en 255, pasa a ser 0. Por tanto, la tinta oscura corresponde a valores altos.
Ahora tenemos una imagen numérica de altura conocida, sin haber impuesto que todas las líneas contengan el mismo número de caracteres.
CNN y después GRU: construir la secuencia
La CNN: aprender patrones, no una regla por letra
Una CNN, por Convolutional Neural Network, es una red convolucional. Aplica filtros sobre distintas zonas de la imagen. Los valores de estos filtros se aprenden durante el entrenamiento: no escribimos una sucesión de condiciones del tipo «si esta forma se parece a una A…».
Estos filtros pueden representar bordes, fragmentos de letras o espacios. Es una forma de entender su función, no una inspección de los filtros realmente aprendidos en este experimento.
En nuestra red, tres convoluciones construyen estas representaciones visuales. Dos operaciones de max-pooling reducen la resolución conservando el máximo de zonas pequeñas. El código utiliza zonas de 2 × 2, lo que reduce progresivamente la altura y la anchura. Los contratos de estas operaciones figuran en las documentaciones de Conv2d y MaxPool2d.
La GRU: situar cada posición en su entorno
Una GRU, por Gated Recurrent Unit, es una red recurrente: conserva un estado a medida que recorre una secuencia. Aquí, esta secuencia corresponde a la anchura de la línea tras pasar por la CNN.
La versión bidireccional recorre esta representación de izquierda a derecha y de derecha a izquierda. Así, una posición puede interpretarse con contexto en ambos lados. Este entorno puede ayudar a distinguir un 0 de una O, sin garantizar que la distinción sea correcta. La documentación de la GRU de PyTorch describe esta combinación de las dos direcciones.
La asociación de la red convolucional y la red recurrente se llama aquí un CRNN. Una proyección final produce, para cada posición, una puntuación por carácter del alfabeto, además de una puntuación para el símbolo técnico CTC blank.
Seguir el recorrido de los números en el código
Esta es la clase completa, en src/pdfctc/model.py. Observe las tres partes: cnn, gru y projection.
class CRNN(nn.Module):
    def __init__(self, classes):
        super().__init__()
        self.cnn = nn.Sequential(
            nn.Conv2d(1, 32, 3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(64, 128, 3, padding=1),
            nn.ReLU(),
        )
        self.gru = nn.GRU(128, 128, num_layers=2, bidirectional=True, batch_first=True)
        self.projection = nn.Linear(256, classes)

    def forward(self, images, lengths):
        features = self.cnn(images).mean(dim=2).transpose(1, 2)
        # The backward GRU must not read the right-hand padding as real context.
        packed = pack_padded_sequence(
            features, lengths.cpu(), batch_first=True, enforce_sorted=False
        )
        encoded, _ = self.gru(packed)
        encoded, _ = pad_packed_sequence(
            encoded, batch_first=True, total_length=features.shape[1]
        )
        return self.projection(encoded).transpose(0, 1)
__init__ define las capas y sus dimensiones. forward describe el recorrido de los datos a través de estas capas: este método es el que transforma un lote de imágenes en puntuaciones.
Las convoluciones pasan de un canal de entrada, la escala de grises, a 32, luego 64 y finalmente 128 canales de características. Las ReLU introducen transformaciones no lineales entre las convoluciones. Una vez extraídos estos patrones, mean(dim=2) calcula el promedio de la altura restante; transpose(1, 2) coloca las posiciones horizontales en el orden esperado por la GRU.
Para hacer concretas estas manipulaciones, sigamos una imagen normalizada de 200 × 32 píxeles, únicamente como ejemplo de dimensiones deducido del código. No es una salida de ejecución publicada.
| Etapa | Representación de esta línea |
|---|---|
| Entrada | 1 canal, altura 32, anchura 200. |
| Después de las tres convoluciones y los dos max-poolings | 128 canales, altura 8, anchura 50. |
| Después del promedio sobre la altura y la transposición | 50 posiciones sucesivas, cada una descrita por 128 valores. |
| Después de la GRU bidireccional | 50 posiciones, cada una descrita por 256 valores: 128 por dirección. |
| Después de la proyección | 50 posiciones, con una puntuación para cada símbolo posible. |
Estas posiciones se llaman pasos temporales. El término puede sorprender: aquí no tratamos un vídeo ni una señal sonora. El «tiempo» designa simplemente el avance en la secuencia horizontal.
50 pasos no significan 50 caracteres. Varios pasos pueden contribuir al mismo carácter y algunos pueden producir un blank. Por eso se necesita un mecanismo de alineación y decodificación.
La última transposición devuelve las puntuaciones en el orden de dimensiones esperado para CTC: pasos temporales, elementos del lote y clases de símbolos. Una puntuación bruta se llama logit. Todavía no es ni una probabilidad ni una letra reconocida definitivamente.
No confundir el relleno con contenido
Para tratar juntas varias líneas de anchuras distintas, se colocan en un lote, o batch, con una anchura común. Por tanto, las líneas más cortas tienen un margen artificial a la derecha: el padding, o relleno.
lengths conserva las longitudes reales después de la reducción realizada por la CNN. pack_padded_sequence permite a la GRU trabajar con estas longitudes, en lugar de con toda la anchura rellenada. Esto es especialmente importante en el sentido derecha-izquierda: de otro modo, empezaría a leer un margen artificial como si fuera parte de la línea.
pad_packed_sequence vuelve a colocar después los resultados en una tabla de dimensiones comunes. Encontrará el contrato de este empaquetado en la documentación de pack_padded_sequence.
CTC: blank, repeticiones y longitudes
El problema: una transcripción, pero no la ubicación de cada letra
Sabemos que nuestra línea debe contener BOLT AA11 12.50. Pero no hemos indicado a la red qué pasos corresponden a la primera A, la segunda A y los dos 1.
CTC, por Connectionist Temporal Classification, trata esta ausencia de alineación precisa. En lugar de imponer un carácter esperado en cada paso, suma las probabilidades de los caminos compatibles con toda la transcripción. Un camino es una sucesión de símbolos, uno por paso, antes de su reducción a texto.
El principio se presenta en el artículo fundacional de Graves, Fernández, Gomez y Schmidhuber sobre CTC (2006). Permite aprender a partir de la secuencia esperada sin exigir su segmentación carácter por carácter. Sin embargo, en nuestro proyecto la localización de líneas sigue siendo una etapa separada.
El blank: un separador técnico, no un espacio
Tomemos el camino del ejemplo proporcionado: A, A, blank, A, 1, 1, blank, 1.
Para transformarlo en texto, hay que fusionar las repeticiones consecutivas y después retirar los blanks, en este orden:
Chemin initial       : A, A, blank, A, 1, 1, blank, 1
Après fusion         : A, blank, A, 1, blank, 1
Après retrait        : A, A, 1, 1
Texte obtenu         : AA11
Las dos primeras A son vecinas: se convierten en una sola A. La siguiente está separada por un blank: sigue siendo un carácter distinto. El mismo mecanismo se aplica a los dos 1 que queremos conservar.
Probemos ahora el orden inverso, deliberadamente incorrecto:
Chemin initial       : A, A, blank, A, 1, 1, blank, 1
Retrait prématuré     : A, A, A, 1, 1, 1
Fusion ensuite       : A, 1
Texte obtenu         : A1
Hemos perdido las repeticiones que formaban parte del identificador. No es un detalle cosmético: AA11 y A1 no son la misma referencia.
El blank no es el carácter de espacio. En BOLT AA11 12.50, los espacios visibles forman parte del alfabeto y deben reconocerse. El blank sirve al mecanismo de alineación; no debe aparecer en la transcripción final.
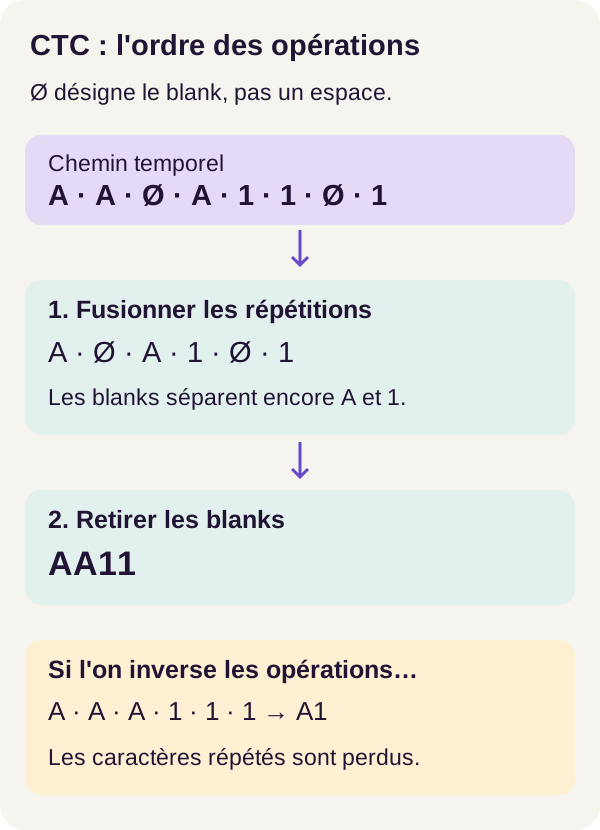
El blank conserva la separación entre dos caracteres idénticos hasta el final de la decodificación.
Un decodificador corto, pero un orden de operaciones esencial
El decodificador manipula identificadores numéricos de símbolos. En src/pdfctc/decode.py, collapse realiza la reducción correcta, mientras que wrong_collapse hace comprobable el error anterior.
Esta es la función central. El identificador del blank es 0:
def collapse(path, blank=0):
    """Merge runs first; a blank separates identical visible symbols."""
    result = []
    previous = None
    for symbol in path:
        symbol = int(symbol)
        if symbol != previous and symbol != blank:
            result.append(symbol)
        previous = symbol
    return result
previous memoriza el símbolo anterior. Añadimos el símbolo actual solo si es diferente del anterior y no es el blank.
El punto decisivo está al final del bucle: previous se actualiza incluso para un blank. Por tanto, una A encontrada después de ese blank se compara con el blank, y no con la última A visible. Puede conservarse.
El código realiza así en un recorrido las dos operaciones que hemos separado para explicarlas. Atención también a no confundir el identificador técnico 0 con el dígito impreso 0: la clase del blank y la de un carácter visible tienen funciones diferentes.
Comprobemos este mecanismo con el comando del proyecto:
docker compose run --rm tutorial python -m pdfctc.cli explain-ctc --text AA11
Observe los caminos y los textos obtenidos. Los ejemplos de decodificación anteriores explican este mecanismo; no son predicciones obtenidas sobre los escaneos.
Por qué cuatro caracteres pueden requerir seis pasos
Para producir AA11, hace falta al menos un paso por cada carácter, más un paso de separación entre las dos A y entre los dos 1. Por tanto, un camino mínimo es A, blank, A, 1, blank, 1: seis pasos para cuatro caracteres.
De forma más general, el mínimo es el número de caracteres al que se añade el número de pares de caracteres idénticos adyacentes. Es el tipo de restricción que verifica minimum_steps antes de calcular la pérdida. Si la secuencia visual es demasiado corta, el problema es imposible en este marco, incluso con buenos parámetros.
Retenga bien las dos longitudes: la de la salida temporal de la red y la de la transcripción esperada. No tienen ni el mismo valor ni la misma función.
La pérdida CTC: la señal que permite aprender
Una función de pérdida, o loss, mide la diferencia entre lo que produce el modelo y lo que se espera. Proporciona la señal utilizada para ajustar los parámetros. Aquí, CTC trabaja sobre las probabilidades de los caminos compatibles, no sobre una caja esperada para cada letra.
La llamada respeta el contrato de torch.nn.CTCLoss: log-probabilidades, objetivos, longitudes de entrada y longitudes de objetivo. La documentación correspondiente a PyTorch 2.8 permite consultar este contrato para la versión del recorrido.
La función del proyecto comprueba primero que los datos permiten este cálculo:
def ctc_loss(logits, lengths, targets, target_lengths):
    offset = 0
    for time, size in zip(lengths.tolist(), target_lengths.tolist()):
        target = targets[offset : offset + size].tolist()
        offset += size
        if not target or 0 in target or time < minimum_steps(target):
            raise ValueError(
                f"CTC impossible: T={time}, L={size}, minimum={minimum_steps(target)}"
            )
    if offset != len(targets):
        raise ValueError("Target lengths do not sum correctly")
    # Transfer is differentiable: all network parameters and their gradients remain on CUDA.
    log_probs = logits.log_softmax(-1).cpu()
    loss = torch.nn.functional.ctc_loss(
        log_probs,
        targets.cpu(),
        lengths.cpu(),
        target_lengths.cpu(),
        blank=0,
        reduction="mean",
        zero_infinity=False,
    )
    if not torch.isfinite(loss):
        raise ValueError("Non-finite CTC loss")
    return loss
targets contiene las transcripciones codificadas como identificadores y concatenadas. target_lengths indica cuántos identificadores pertenecen a cada transcripción. Por tanto, offset avanza por esta gran tabla para recuperar el objetivo de cada línea.
La primera comprobación rechaza un objetivo vacío, un blank en el objetivo o una secuencia demasiado corta. La segunda verifica que las longitudes anunciadas correspondan al número total de identificadores. Estos rechazos son salvaguardas del proyecto: hacen explícitos los errores antes del aprendizaje.
log_softmax(-1) transforma los logits en log-probabilidades, en la dimensión de los símbolos. Es la representación esperada por CTC; la documentación de log_softmax explica el cálculo combinado y su estabilidad numérica.
reduction="mean" produce una pérdida agregada: PyTorch divide las pérdidas de los ejemplos por sus longitudes de objetivo y después calcula su promedio sobre el lote. zero_infinity=False evita sustituir automáticamente por cero las pérdidas infinitas, y torch.isfinite(loss) rechaza una pérdida infinita o no numérica. Ocultar una imposibilidad no la resolvería.
Última particularidad: la pérdida CTC se calcula en CPU en este proyecto, mientras que los parámetros de la red y sus gradientes permanecen en CUDA. La transferencia sigue siendo diferenciable: no corta el seguimiento de operaciones que permite remontar la señal de aprendizaje. Un gradiente indica cómo una pequeña variación de un parámetro influye en la pérdida; la documentación de Autograd presenta este seguimiento automático.
Es una elección de código demostrada, no una recomendación general de rendimiento. La pérdida CTC sirve para entrenar la red; la tasa de error de caracteres servirá después para evaluar los textos realmente producidos. No confundamos estas dos medidas.
Entrenar y comprobar una reanudación
Comparar dos formas de aprender
Una época es un paso por los ejemplos de entrenamiento. A lo largo de estos pasos, la red produce puntuaciones, se calcula la pérdida CTC y el optimizador ajusta los parámetros a partir de los gradientes.
El proyecto compara un modelo entrenado con degradaciones y un modelo entrenado solo con imágenes limpias, con el mismo presupuesto y la misma inicialización. Añadir degradaciones es una forma de aumento de datos: exponemos la red a variaciones visuales para intentar hacerla más robusta.
La idea parece razonable, pero no es una garantía. Habrá que comprobar si el modelo aumentado realmente lo hace mejor con las mismas imágenes de prueba.
Interrumpir, reanudar y después comparar
También vamos a comprobar la reanudación del entrenamiento. Ejecute el entrenamiento interrumpido, la variante limpia, la referencia continua y después la reanudación:
docker compose run --rm tutorial python -m pdfctc.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfctc.cli train-clean --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfctc.cli train-continuous --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfctc.cli train-resume --config configs/minimum.yaml
train se detiene tras 7 épocas. La referencia train-continuous realiza 15 sin esa interrupción. train-resume recarga el estado interrumpido y ejecuta las 8 épocas restantes. El comando train-clean proporciona el modelo de comparación entrenado con imágenes limpias.
Por tanto, estos comandos no prolongan todos un mismo modelo en una larga sucesión: construyen las variantes necesarias para las comparaciones.
Un checkpoint no se resume a los pesos de la red. Para continuar el mismo experimento, también hay que recuperar el estado del optimizador y los demás estados útiles para la reanudación. El optimizador es el mecanismo que realiza las actualizaciones de parámetros; su memoria puede influir en los siguientes pasos.
Comprobemos ahora que la interrupción no cambió el resultado:
docker compose run --rm tutorial python -m pdfctc.cli verify-resume --config configs/minimum.yaml
El recorrido validado devuelve una reanudación exacta. La comparación se refiere a los parámetros, el optimizador, los estados aleatorios, el historial y los datos. Por tanto, no nos limitamos a comprobar que dos curvas se parezcan.
Esta exactitud se refiere al entorno validado. Modificar las dependencias o el material exige comprobar de nuevo el comportamiento; el resultado no promete una identidad automática entre todas las máquinas.
Transcribir sin leer las respuestas esperadas
La inferencia es el momento en que usamos los parámetros aprendidos para producir una transcripción. Ya no se trata de ajustar la red a partir de la respuesta conocida.
El servicio de inferencia monta los píxeles y los checkpoints en solo lectura. Las anotaciones no están disponibles en este servicio: debe encontrar las líneas, calcular las puntuaciones temporales y decodificar los caracteres a partir de las imágenes.
docker compose run --rm inference python -m pdfctc.cli predict --config configs/minimum.yaml
Las predicciones se escriben en outputs/. Consulte algunas líneas antes de observar los promedios globales. Una cadena puede tener un aspecto plausible y, sin embargo, contener un error en un identificador o un importe.
La evaluación recuperará después las anotaciones para comparar los textos. Asocia las predicciones con las referencias a partir de las cajas, y no eligiendo después el texto que da la mejor puntuación. El programa debe comparar la línea correcta con la referencia correcta, incluso cuando el reconocimiento se ha equivocado.
Leer las métricas antes que los valores
Contar los errores de caracteres
El CER, por Character Error Rate, es la tasa de error de caracteres. Vale (S + I + D) / N.
S cuenta las sustituciones, cuando un carácter reemplaza a otro. I cuenta las inserciones, cuando aparece un carácter de más. D cuenta las eliminaciones, cuando falta un carácter esperado. N es el número de caracteres de la referencia.
Por ejemplo, una sustitución y una eliminación sobre diez caracteres esperados dan (1 + 0 + 1) / 10 = 0,2. Es un ejemplo de cálculo, no una medida adicional del modelo.
Un CER de 0,34 no significa que el 34 % de las líneas sean incorrectas. Relaciona los errores de caracteres con el número de caracteres esperados. Incluso puede superar 1 si los errores, en especial las inserciones, son suficientemente numerosos. Por tanto, no es una simple proporción de líneas correctas o incorrectas.
Comprobar también lo que la aplicación debe utilizar realmente
La exactitud de línea exige que toda la línea sea correcta. Basta una letra incorrecta para que esta comprobación falle, aunque el resto sea legible.
La exactitud del identificador comprueba por separado el segundo campo. En nuestro ejemplo BOLT AA11 12.50, este campo es AA11. Es una medida útil para no perder de vista lo que importa en una importación: una buena parte del texto reconocido no compensa una mala referencia de producto.
Por último, la cobertura de segmentación es el número de líneas emparejadas por la geometría, dividido por el número de líneas de referencia. Una cobertura de 1 significa que todas las líneas se han emparejado. No dice que el texto sea correcto ni que cada recorte sea idéntico al de la anotación.
Distinguir la cadena completa del diagnóstico «gold crop»
Las medidas se realizan sobre 900 líneas y 19 358 caracteres de prueba.
La medida de extremo a extremo utiliza toda la cadena, incluida la segmentación por proyección, que busca las líneas a partir de filas de píxeles oscuros. Es lo que más se aproxima al recorrido real del documento en este proyecto.
El diagnóstico gold crop proporciona directamente al reconocimiento los recortes de referencia. Así se elimina la elección de las cajas realizada por la segmentación para examinar la lectura sobre las zonas anotadas.
El término gold designa la referencia, no una promesa de mejor puntuación. Este diagnóstico no sustituye la medida de la cadena completa ni representa una predicción autónoma a partir de toda la página.
Calculemos las medidas sobre las predicciones:
docker compose run --rm tutorial python -m pdfctc.cli evaluate --config configs/minimum.yaml
Lo que muestran los resultados del recorrido r001
El modelo inicial, antes del entrenamiento, obtiene un CER de 0,9950, tanto en las vistas limpias como en las degradadas. Los resultados siguientes permiten comparar el efecto del entrenamiento y el de las imágenes utilizadas para la evaluación. Un CER más bajo es mejor.
| Modelo | Vista evaluada | CER |
|---|---|---|
| Inicial, sin entrenar | Limpia y degradada | 0,9950 |
| Entrenado con imágenes limpias, cadena completa | Limpia | 0,3387 |
| Entrenado con imágenes limpias, cadena completa | Degradada | 0,3694 |
| Entrenado con degradaciones, cadena completa | Limpia | 0,4103 |
| Entrenado con degradaciones, cadena completa | Degradada | 0,4131 |
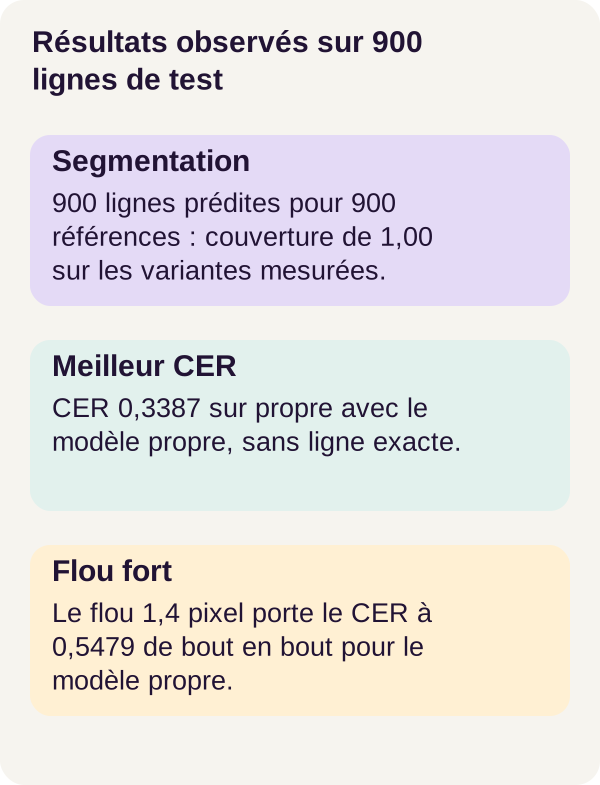
El mejor resultado es, por tanto, el modelo entrenado con escaneos limpios, evaluado de extremo a extremo en la vista limpia: CER 0,3387, con 900 líneas predichas para 900 referencias y una cobertura de 1,00.
Pero también obtiene 0 líneas exactas y 0 identificadores exactos sobre 900. La cadena recupera las líneas y el modelo ha progresado respecto a su inicialización, pero el resultado no es un extractor de datos de negocio utilizable.
En la vista degradada, este mismo modelo obtiene 0,3694 en la cadena completa y 0,3803 con los crops gold. Por tanto, aquí el diagnóstico sobre recortes de referencia no da un CER inferior. Estos dos promedios no bastan por sí solos para identificar la causa de esta diferencia: hay que inspeccionar los ejemplos antes de proponer una explicación.
Por último, el modelo entrenado con degradaciones se mantiene en 0,4103 en la vista limpia y después en 0,4131 de extremo a extremo en la vista degradada. El aumento elegido no supera al entrenamiento limpio en este corpus y con este presupuesto. Es un resultado negativo que hay que conservar, no una anomalía que deba retirarse del relato.
Esto no demuestra que todo aumento de datos sea inútil. Muestra que este aumento, en este experimento, no aportó la ganancia esperada. Cambiar las transformaciones o el presupuesto requeriría nuevas medidas.
Lo que hemos aprendido
El OCR reúne varios problemas: localizar el texto, representar sus píxeles, contextualizar una secuencia y después decodificarla. Una buena respuesta a uno de estos problemas no resuelve automáticamente los siguientes.
La CNN aprende patrones locales; la GRU relaciona las posiciones horizontales; CTC permite aprender a partir de transcripciones sin imponer una caja a cada carácter. Su blank gestiona la alineación y las repeticiones: no representa un espacio.
Las medidas nos dan dos lecciones concretas. Encontrar todas las líneas no significa saber leerlas. Y añadir degradaciones no garantiza un modelo más robusto. La pregunta útil sigue siendo: ¿qué errores persisten, en qué documentos y con qué consecuencias?
Ejercicio: predecir antes de medir
Escribir una hipótesis antes de ejecutar el comando
Vamos a cambiar una sola variable: la intensidad del desenfoque, sin reentrenar la red.
Antes de ejecutar el experimento, anote lo que espera. ¿Aumentará el CER? ¿La segmentación perderá necesariamente líneas? ¿El modelo entrenado con degradaciones debe resistir forzosamente mejor que el entrenado con imágenes limpias? Distinga una hipótesis razonable de un resultado ya conocido.
Para comprobar su comprensión del blank, calcule también a mano la decodificación del camino A, blank, A, A, 1, blank, 1, 1. Pruebe el orden correcto de las operaciones y después el orden inverso. Escriba los dos textos obtenidos antes de leer la corrección.
Ejecutar la variante proporcionada
configs/exercise.yaml fija un desenfoque de 1,4 píxeles y conserva los checkpoints. Por tanto, usamos los mismos modelos para observar el efecto de imágenes más difíciles, no para enseñarles a adaptarse.
docker compose run --rm tutorial python -m pdfctc.cli exercise --config configs/exercise.yaml
Abra los resultados del ejercicio y compárelos con su predicción. Para el camino propuesto, la decodificación correcta da AA11; retirar primero los blanks conduce a A1. Los archivos producidos y lesson/SOLUTIONS.md permiten estudiar la corrección del recorrido proporcionado.
La variante muy borrosa, sin reentrenamiento, confirma la diferencia. El modelo entrenado con imágenes limpias alcanza un CER de 0,5479 de extremo a extremo y de 0,5660 con los crops gold. El modelo aumentado alcanza respectivamente 0,5617 y 0,5918.
La cobertura sigue siendo 1,00, mientras que la exactitud de línea y de identificador permanece nula. El programa sigue encontrando las líneas, pero su contenido es más difícil de transcribir. Por tanto, la segmentación y el reconocimiento no se degradan necesariamente de la misma manera.
Prolongar el experimento sin cambiarlo todo a la vez
Después puede variar únicamente la intensidad de una degradación del generador. Conserve el modelo, las páginas y las anotaciones, y vuelva a predecir y medir.
Esta modificación personal es distinta de la variante proporcionada: su resultado no se conoce de antemano. No cambie simultáneamente los datos y el entrenamiento, o ya no sabrá a qué atribuir la diferencia observada.
La progresión no es necesariamente monótona para cada página: aumentar la degradación no garantiza que cada transcripción individual empeore en cada ensayo. Inspeccione también los ejemplos que contradicen su intuición y explíquelos sin descartarlos.
Generar las figuras y controlar los archivos
Produzca las figuras a partir de sus resultados y después compruebe los checkpoints:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Los seis checkpoints del recorrido de referencia superan su comprobación de estructura e identidad. Esta comprobación se refiere a los archivos esperados; no transforma un modelo poco preciso en un modelo fiable.
Observe después las curvas y los ejemplos de líneas en outputs/. Un CER agregado indica la magnitud global de los errores, pero los ejemplos permiten ver lo que sucede: ¿se confunden, añaden o pierden caracteres? Compare la transcripción con la imagen en lugar de conformarse con su plausibilidad.
Probar los errores y resolver problemas
Un caso negativo comprueba que el programa rechaza una situación incoherente. Por tanto, superar esta prueba significa obtener el rechazo esperado, y no lograr producir una salida a pesar de todo.
Las pruebas cubren, entre otros casos, un objetivo CTC vacío, un blank prohibido en la transcripción objetivo, un número insuficiente de pasos temporales y una línea demasiado ancha. No sortee estos errores cortando en silencio el texto ni ocultando una pérdida imposible: modificaría el problema en lugar de resolverlo.
En móvil, desplace la tabla horizontalmente.
| Síntoma | Comprobación y corrección |
|---|---|
| La GPU aparece en el host, pero CUDA falla en Docker | Compare preflight y check_environment.py, y después corrija la integración NVIDIA antes del entrenamiento. |
| Una línea supera la anchura prevista | Inspeccione su caja y su redimensionado. El corpus personal puede requerir otra segmentación, que debe evaluarse como una modificación del proyecto. |
| CTC rechaza un objetivo | Compruebe las longitudes, las repeticiones y la ausencia del blank entre los caracteres esperados. |
| Falta un checkpoint | Encuentre la etapa de entrenamiento correspondiente y su error; un archivo ausente no debe reemplazarse por pesos arbitrarios. |
| El disco está lleno | Compruebe el espacio de los escaneos, checkpoints y resultados. Conserve los archivos útiles antes de la limpieza específica indicada más abajo. |
Detener y limpiar
Copie primero los resultados y figuras que quiera conservar. El primer comando detiene el proyecto. El script muestra y después borra únicamente outputs/. La última detención finaliza el recorrido tras ejecutar la limpieza.
Se eliminará el contenido de outputs/. Los escaneos permanecen en data/generated/ y los checkpoints en assets/checkpoints/.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
No se elimina ningún volumen Docker global. Para repetir el recorrido, use las mismas instrucciones y las dependencias bloqueadas del ZIP. Una limpieza específica permite saber qué se elimina sin tocar sus otros proyectos.
Del tutorial a una aplicación real
El primer trabajo no sería añadir una ruta HTTP, sino disponer de documentos representativos y de una calidad medida sobre esos documentos.
Sustituya el corpus ficticio por documentos autorizados, acompañados de sus anotaciones. Separe los datos de forma que se eviten fugas entre aprendizaje y prueba por proveedor, plantilla o lote. Mida el CER y los criterios realmente útiles para su aplicación en fuentes distintas. Los idiomas, rotaciones, tablas, páginas complejas y escritura manuscrita requieren datos y evaluaciones adicionales.
La integración web conlleva otras responsabilidades: autenticación, derechos sobre documentos, límites de archivos, tratamiento asíncrono, supervisión y pruebas de carga, según el contexto. Una API asíncrona permitiría, por ejemplo, separar la carga del documento de la recuperación de su resultado; no es una funcionalidad proporcionada por este tutorial.
Proteja los datos, versione los modelos y prevea una comprobación humana de los identificadores e importes críticos. El aislamiento del analizador de PDF, es decir, de la biblioteca que abre e interpreta el archivo, así como el mantenimiento de las bibliotecas nativas, forman parte de la explotación.
La red de este tutorial no ofrece calidad suficiente para automatizar una extracción de negocio sin control. Su interés es hacer observables el mecanismo y sus límites, para saber qué habrá que mejorar y comprobar después.
Para ir más lejos
Empiece por construir un corpus anotado representativo de sus propios escaneos. Estudie por separado los errores de segmentación y los de reconocimiento: una imagen de línea mal recortada y una letra mal reconocida no requieren la misma investigación.
Después puede comparar otro presupuesto de entrenamiento manteniendo un conjunto de prueba fijo, o probar una decodificación que explore varios caminos. En ambos casos, mida la aportación real en lugar de deducirla solo de la elección de la técnica. Son extensiones que se deben experimentar, no mejoras ya validadas en el recorrido r001.
Los enlaces documentales integrados a lo largo del texto profundizan en los mecanismos: operaciones de imagen en Pillow, capas y longitudes de secuencia en PyTorch, y después el principio de CTC en el artículo fundacional. Las referencias de PyTorch 2.8 corresponden a la versión utilizada aquí; las demás documentaciones pueden evolucionar. Para reproducir el experimento, las configuraciones y dependencias bloqueadas del ZIP siguen siendo su punto de partida.