





Una scansione non è testo
State sviluppando un'importazione di documenti. Un utente carica un documento «Cedar Parts» in PDF: sullo schermo leggete senza difficoltà BOLT AA11 12.50 e SEAL B00 7.20. Avviate l'estrazione del testo… e non recuperate nulla.
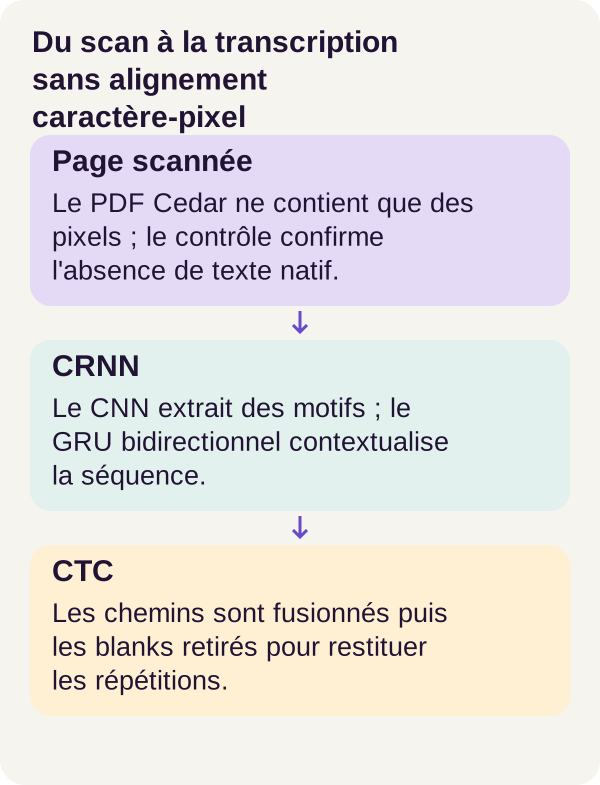
Perché? Perché questo PDF contiene un'immagine della pagina, non i caratteri che vedete. È un po' come ricevere la schermata di un modulo invece dei suoi campi: l'informazione è visibile, ma non è più disponibile come stringa di caratteri.
È il punto di partenza dell'OCR, Optical Character Recognition, ovvero riconoscimento ottico dei caratteri. Occorre passare dai pixel al testo. E costruiremo questo passaggio, invece di chiamare semplicemente un servizio che ne nasconde il funzionamento.
Il nostro terreno di prova sarà volutamente limitato: righe stampate di un corpus fittizio, con un alfabeto ristretto. Non impareremo a leggere tutte le fatture del mondo, la scrittura a mano o pagine dalla formattazione complessa. Capiremo però come una rete impari a trascrivere una riga senza che le venga indicata la posizione di ogni carattere.
Anche i risultati faranno parte dell'apprendimento: questo piccolo modello migliora, ma la sua qualità finale rimane insufficiente per automatizzare un'estrazione aziendale. Vedremo con precisione cosa funziona e cosa non funziona.
Scaricare il progetto completo del tutorial
Cosa costruirete e imparerete
La catena segue il documento: PDF scansionato → immagine → righe rilevate → rete CNN-GRU → punteggi dei caratteri → decodifica CTC → testo.
Non cercate ancora di ricordare tutte le sigle. Per iniziare, immaginiamo tre responsabilità.
Trovare le righe. Individuiamo le aree della pagina che contengono testo e ritagliamo una piccola immagine per riga. Questa fase si chiama segmentazione.
Analizzare ogni immagine di riga. La CNN trasforma i pixel in motivi visivi. Il GRU collega queste informazioni percorrendo la riga nei due sensi. La loro associazione produce una successione di punteggi per i caratteri possibili.
Apprendere e decodificare senza ritagliare ogni lettera. CTC consente di addestrare la rete con la trascrizione completa della riga, poi di interpretare una sequenza che può contenere ripetizioni e simboli tecnici.
Addestreremo questa rete dalla sua inizializzazione, verificheremo che sappia riprendere dopo un'interruzione, quindi misureremo separatamente il ritaglio e il riconoscimento. Concluderemo con un esperimento: rendere le scansioni più sfocate senza riaddestrare il modello, prevedere che cosa accadrà e confrontare la nostra intuizione con i risultati.
Il filo conduttore sarà AA11. Questo piccolo identificativo è particolarmente interessante: come distinguere due veri A da uno stesso A che la rete avrebbe proposto più volte? È proprio uno dei problemi che CTC consente di affrontare.
Preparare il progetto e verificare la GPU
Dovete saper programmare in Python, usare un terminale e avviare Docker. Non avete bisogno di aver già addestrato un modello. Spiegheremo i concetti nel momento in cui li useremo.
Una prima parola merita comunque una definizione: qui un tensore è un array numerico a una o più dimensioni. Un'immagine, un gruppo di immagini o i punteggi dei caratteri saranno rappresentati da tali array. La rete contiene anch'essa numeri, i suoi parametri, che l'addestramento modifica per ridurre l'errore su trascrizioni note.
Riprendere l'ambiente del percorso validato
Il percorso è stato eseguito con una RTX 3090, Python 3.11.16, PyTorch 2.8.0+cu126 e CUDA 12.6. PyTorch è la libreria usata per costruire e addestrare la rete; CUDA permette di eseguire sulla GPU NVIDIA i calcoli previsti.
Queste versioni descrivono l'ambiente validato. Il Dockerfile dello ZIP fissa le dipendenze: non sostituitele con le versioni più recenti per una prima riproduzione. Consultate il README per il dimensionamento e prevedete lo spazio necessario per le immagini Docker, le scansioni generate e i checkpoint, cioè i salvataggi dell'addestramento.
Scompattate lo ZIP e posizionate il terminale nella sua cartella radice, quella che contiene README.md. Tutti i comandi seguenti vanno eseguiti da questa cartella, nell'ordine indicato. Gli estratti di codice spiegati più avanti appartengono al progetto completo; non sostituiscono gli altri file.
Iniziamo dal controllo dell'host, chiamato preflight:
sh scripts/preflight.sh
Una GPU visibile in Linux non garantisce che Docker possa usarla. NVIDIA Container Toolkit fornisce l'integrazione tra Docker e i driver dell'host; la sua documentazione ufficiale illustra l'installazione in base al sistema. Verificheremo l'accesso CUDA del contenitore dopo la sua costruzione.
Costruire i servizi e comprenderne il ruolo
Prepariamo le directory, verifichiamo la configurazione Compose, poi costruiamo i servizi:
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
acquisition verifica gli asset del progetto. tutorial prepara i dati e addestra la rete. inference trascrive le scansioni con i pesi salvati. I file sono distribuiti tra data/generated/ per le scansioni, assets/checkpoints/ per gli stati del modello e outputs/ per i risultati.
Non ci sono pesi OCR preaddestrati da scaricare. Qui la rete apprende dalla propria inizializzazione; non specializziamo un motore già addestrato. La fase di acquisizione resta nel percorso e riporta quindi zero byte di pesi esterni. Questo non significa che la costruzione delle immagini Docker non richieda alcun download.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
Verifichiamo ora CUDA dal contenitore, quindi i test del progetto:
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Il controllo dell'ambiente deve confermare l'accesso alla GPU. I 26 test superati nel percorso di riferimento coprono in particolare la segmentazione, le lunghezze e la decodifica.
Pensate ai vostri test applicativi: verificare che una funzione rispetti il proprio contratto non equivale a verificare la pertinenza di tutti i dati che produrrà. Anche qui, test superati non significano che tutte le trascrizioni saranno corrette.
I servizi di addestramento e inferenza non hanno poi accesso alla rete. Il file Compose completo descrive i volumi in sola lettura, l'utente senza privilegi, le capacità rimosse e i limiti di risorse. Queste restrizioni riducono gli accessi del programma; non costituiscono una protezione completa contro ogni vulnerabilità delle librerie native.
Un documento davvero rasterizzato
Creare scansioni di cui conosciamo la risposta
Per addestrare un OCR ci servono immagini e la loro trascrizione attesa. Il progetto crea autonomamente questi esempi: possiamo così conoscere la risposta senza chiedere a qualcuno di ricopiare ogni riga.
Il generatore prepare, in src/pdfctc/corpus.py, compone 600 pagine di dieci righe. Le renderizza come immagine, reinserisce quell'immagine in un PDF, poi trasforma di nuovo quel PDF in immagine. Questa trasformazione in pixel si chiama rasterizzazione.
Perché questi passaggi? Perché il documento inviato alla nostra catena sia davvero un PDF scansionato e non un PDF di cui il programma potrebbe semplicemente rileggere i caratteri nascosti dietro la visualizzazione. Il generatore verifica che il testo nativo sia vuoto.
Ogni pagina esiste in tre versioni: pulita, degradata o molto sfocata. Sono versioni diverse della stessa pagina, non tre famiglie documentali indipendenti. Il corpus è fittizio, stampato con caratteri ASCII e un font PDF standard. Non rappresenta la diversità di fatture, lingue o manoscritti di un'azienda.
Separare i documenti prima di apprendere
Le 60 famiglie di documenti sono suddivise in 42 per l'addestramento, 9 per la validazione e 9 per il test. Ciò rappresenta rispettivamente 4.200, 900 e 900 righe.
L'addestramento serve a modificare i parametri. La validazione serve a osservare il comportamento durante la messa a punto, senza essere l'insieme su cui tali parametri vengono appresi. Il test serve a misurare il risultato sugli esempi riservati alla valutazione finale.
La separazione avviene per famiglia di impaginazione, non semplicemente distribuendo a caso tutte le righe. Una stessa famiglia non si ritrova quindi su entrambi i lati del confine tra apprendimento e valutazione. Questo limita un confronto troppo facile tra documenti correlati, senza però coprire tutta la diversità dei documenti reali.
Qui un'annotazione contiene la trascrizione attesa e il riquadro che circonda la riga. Conosciamo quindi il testo di una riga e la sua posizione globale, ma non forniamo un riquadro per ogni lettera. CTC ci eviterà questa annotazione carattere per carattere; non elimina il bisogno di trascrizioni per addestrare il modello.
Trovare le righe prima di riconoscerle
La funzione line_boxes, in src/pdfctc/segment.py, cerca le righe di pixel scuri, raggruppa le righe vicine e costruisce un riquadro per riga. Per rappresentarvela, immaginate di percorrere la pagina dall'alto in basso misurando dove si trova l'inchiostro.
Questo metodo è esplicito, non una seconda rete da addestrare. Localizza le righe; non sa ancora cosa contengano. La porzione d'immagine estratta da un riquadro si chiama crop, o ritaglio.
Generiamo le scansioni, poi ispezioniamo questi ritagli:
docker compose run --rm tutorial python -m pdfctc.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfctc.cli inspect-lines --config configs/minimum.yaml
Dovete ritrovare le 600 pagine e le loro tre versioni. Nei file di ispezione, osservate i riquadri intorno alle righe e le larghezze dopo il ridimensionamento. Il PDF generato deve rimanere privo di livello di testo nativo: altrimenti non testeremmo più un riconoscimento a partire dai pixel.
Prendete una riga e ponetevi due domande distinte: «ho recuperato l'intera riga?» e «la rete saprà leggerla?». La prima riguarda la segmentazione, la seconda il riconoscimento.
Portare le immagini a un formato comune
normalize, anch'essa in src/pdfctc/segment.py, porta ogni crop a 32 pixel di altezza, mantenendone le proporzioni. Una larghezza superiore a 512 pixel genera un errore: non si taglia mai silenziosamente la fine del testo per far entrare l'immagine.
Ecco la funzione del progetto:
def normalize(image, height=32, max_width=512):
    width = max(4, round(image.width * height / image.height))
    if width > max_width:
        raise ValueError(
            f"Line width {width} exceeds {max_width}; no text truncation allowed"
        )
    array = (
        1.0
        - np.asarray(
            image.convert("L").resize((width, height), Image.Resampling.BILINEAR),
            dtype=np.float32,
        )
        / 255.0
    )
    return array
La prima istruzione calcola la nuova larghezza dal rapporto tra le altezze, con un minimo di 4 pixel. Come esempio di calcolo, un'immagine larga 400 pixel e alta 64 pixel diventa un'immagine di 200 × 32 pixel. Queste dimensioni illustrano il codice; non descrivono una misura aggiuntiva del corpus.
image.convert("L") trasforma l'immagine in livelli di grigio. resize esegue il ridimensionamento con l'interpolazione bilineare indicata nel codice. Queste operazioni sono documentate nel modulo Image di Pillow.
np.asarray(..., dtype=np.float32) trasforma poi l'immagine in un array di numeri. La divisione per 255 riporta le intensità tra 0 e 1; 1.0 - ... inverte questa scala. Un pixel nero, inizialmente a 0, diventa 1. Un pixel bianco, inizialmente a 255, diventa 0. L'inchiostro scuro corrisponde quindi ai valori elevati.
Ora abbiamo un'immagine numerica di altezza nota, senza aver imposto che tutte le righe contengano lo stesso numero di caratteri.
CNN poi GRU: costruire la sequenza
La CNN: apprendere motivi, non una regola per lettera
Una CNN, Convolutional Neural Network, è una rete convoluzionale. Applica filtri a zone diverse dell'immagine. I valori di questi filtri vengono appresi durante l'addestramento: non scriviamo una successione di condizioni del tipo «se questa forma assomiglia a una A…».
Questi filtri possono rappresentare bordi, frammenti di lettere o spazi. È un modo per comprenderne il ruolo, non un'ispezione dei filtri effettivamente appresi in questo esperimento.
Nella nostra rete, tre convoluzioni costruiscono queste rappresentazioni visive. Due operazioni di max-pooling riducono la risoluzione mantenendo il massimo di piccole aree. Il codice usa aree di 2 × 2, riducendo progressivamente altezza e larghezza. I contratti di queste operazioni sono riportati nelle documentazioni di Conv2d e MaxPool2d.
Il GRU: collocare ogni posizione nel suo contesto
Un GRU, Gated Recurrent Unit, è una rete ricorrente: conserva uno stato mentre percorre una sequenza. Qui questa sequenza corrisponde alla larghezza della riga dopo il passaggio nella CNN.
La versione bidirezionale percorre questa rappresentazione da sinistra a destra e da destra a sinistra. Una posizione può così essere interpretata con il contesto su entrambi i lati. Questo vicinato può aiutare a distinguere uno 0 da una O, senza garantire che la distinzione sia corretta. La documentazione del GRU di PyTorch descrive questa combinazione delle due direzioni.
L'associazione della rete convoluzionale e della rete ricorrente qui si chiama CRNN. Una proiezione finale produce, per ogni posizione, un punteggio per carattere dell'alfabeto, oltre a un punteggio per il simbolo tecnico CTC blank.
Seguire il percorso dei numeri nel codice
Ecco la classe completa, in src/pdfctc/model.py. Osservate le tre parti: cnn, gru e projection.
class CRNN(nn.Module):
    def __init__(self, classes):
        super().__init__()
        self.cnn = nn.Sequential(
            nn.Conv2d(1, 32, 3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(64, 128, 3, padding=1),
            nn.ReLU(),
        )
        self.gru = nn.GRU(128, 128, num_layers=2, bidirectional=True, batch_first=True)
        self.projection = nn.Linear(256, classes)

    def forward(self, images, lengths):
        features = self.cnn(images).mean(dim=2).transpose(1, 2)
        # The backward GRU must not read the right-hand padding as real context.
        packed = pack_padded_sequence(
            features, lengths.cpu(), batch_first=True, enforce_sorted=False
        )
        encoded, _ = self.gru(packed)
        encoded, _ = pad_packed_sequence(
            encoded, batch_first=True, total_length=features.shape[1]
        )
        return self.projection(encoded).transpose(0, 1)
__init__ definisce i layer e le loro dimensioni. forward descrive il percorso dei dati attraverso questi layer: è questo metodo a trasformare un gruppo di immagini in punteggi.
Le convoluzioni passano da un canale di ingresso, i livelli di grigio, a 32, poi 64, poi 128 canali di caratteristiche. Le ReLU introducono trasformazioni non lineari tra le convoluzioni. Una volta estratti questi motivi, mean(dim=2) calcola la media dell'altezza rimanente; transpose(1, 2) dispone le posizioni orizzontali nell'ordine atteso dal GRU.
Per rendere concrete queste manipolazioni, seguiamo un'immagine normalizzata di 200 × 32 pixel, soltanto come esempio di dimensioni dedotto dal codice. Non è un risultato di esecuzione pubblicato.
| Fase | Rappresentazione di questa riga |
|---|---|
| Ingresso | 1 canale, altezza 32, larghezza 200. |
| Dopo le tre convoluzioni e i due max-pooling | 128 canali, altezza 8, larghezza 50. |
| Dopo la media sull'altezza e la trasposizione | 50 posizioni successive, ciascuna descritta da 128 valori. |
| Dopo il GRU bidirezionale | 50 posizioni, ciascuna descritta da 256 valori: 128 per direzione. |
| Dopo la proiezione | 50 posizioni, con un punteggio per ogni simbolo possibile. |
Queste posizioni sono chiamate passi temporali. Il termine può sorprendere: qui non elaboriamo un video o un segnale sonoro. Il «tempo» indica semplicemente l'avanzamento nella sequenza orizzontale.
50 passi non significano 50 caratteri. Più passi possono contribuire allo stesso carattere e alcuni possono produrre un blank. Per questo è necessario un meccanismo di allineamento e decodifica.
L'ultima trasposizione restituisce i punteggi nell'ordine delle dimensioni atteso da CTC: passi temporali, elementi del gruppo, classi di simboli. Un punteggio grezzo si chiama logit. Non è ancora né una probabilità né una lettera riconosciuta definitivamente.
Non confondere il riempimento con il contenuto
Per elaborare insieme più righe di larghezze diverse, le inseriamo in un lotto, o batch, con una larghezza comune. Le righe più corte hanno quindi un margine artificiale a destra: il padding, o riempimento.
lengths conserva le lunghezze reali dopo la riduzione effettuata dalla CNN. pack_padded_sequence permette al GRU di lavorare su queste lunghezze, invece che sull'intera larghezza riempita. È particolarmente importante nel senso da destra a sinistra: altrimenti inizierebbe a leggere un margine artificiale come se facesse parte della riga.
pad_packed_sequence rimette poi i risultati in un array dalle dimensioni comuni. Troverete il contratto di questo impacchettamento nella documentazione di pack_padded_sequence.
CTC: blank, ripetizioni e lunghezze
Il problema: una trascrizione, ma non la posizione di ogni lettera
Sappiamo che la nostra riga deve contenere BOLT AA11 12.50. Ma non abbiamo indicato alla rete quali passi corrispondono alla prima A, alla seconda A, poi ai due 1.
CTC, Connectionist Temporal Classification, gestisce questa assenza di allineamento preciso. Invece di imporre un carattere atteso a ogni passo, somma le probabilità dei percorsi compatibili con l'intera trascrizione. Un percorso è una successione di simboli, uno per passo, prima della loro riduzione in testo.
Il principio è presentato nell'articolo fondativo di Graves, Fernández, Gomez e Schmidhuber su CTC (2006). Permette di apprendere dalla sequenza attesa senza esigerne la segmentazione carattere per carattere. Nel nostro progetto, la localizzazione delle righe resta comunque una fase distinta.
Il blank: un separatore tecnico, non uno spazio
Prendiamo il percorso dell'esempio fornito: A, A, blank, A, 1, 1, blank, 1.
Per trasformarlo in testo, bisogna unire le ripetizioni consecutive, poi rimuovere i blank, in quest'ordine:
Chemin initial       : A, A, blank, A, 1, 1, blank, 1
Après fusion         : A, blank, A, 1, blank, 1
Après retrait        : A, A, 1, 1
Texte obtenu         : AA11
Le prime due A sono vicine: diventano una sola A. La successiva è separata da un blank: resta un carattere distinto. Lo stesso meccanismo si applica ai due 1 che desideriamo conservare.
Proviamo ora l'ordine inverso, volutamente errato:
Chemin initial       : A, A, blank, A, 1, 1, blank, 1
Retrait prématuré     : A, A, A, 1, 1, 1
Fusion ensuite       : A, 1
Texte obtenu         : A1
Abbiamo perso le ripetizioni che facevano parte dell'identificativo. Non è un dettaglio estetico: AA11 e A1 non sono lo stesso riferimento.
Il blank non è il carattere spazio. In BOLT AA11 12.50, gli spazi visibili fanno parte dell'alfabeto e devono essere riconosciuti. Il blank serve al meccanismo di allineamento; non deve comparire nella trascrizione finale.
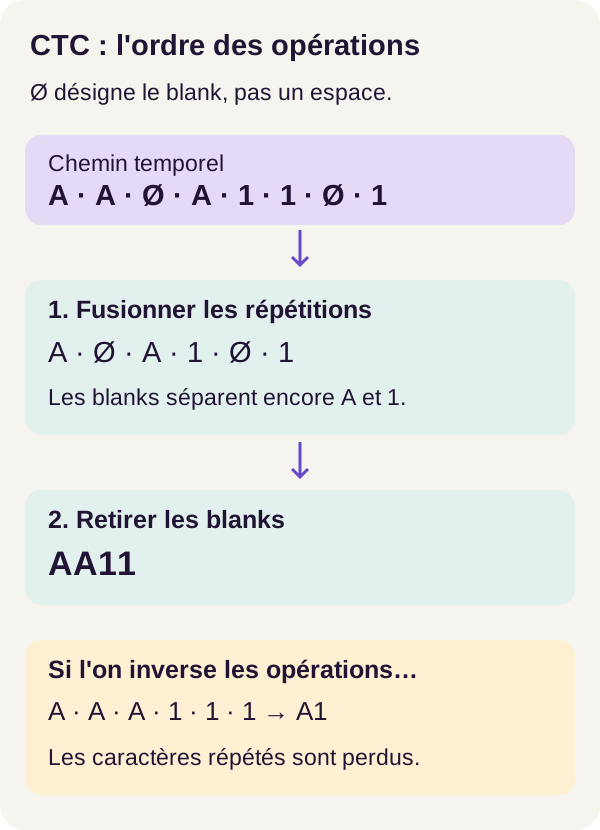
Il blank mantiene la separazione tra due caratteri identici fino alla fine della decodifica.
Un decoder breve, ma un ordine di operazioni essenziale
Il decoder manipola identificativi numerici di simboli. In src/pdfctc/decode.py, collapse esegue la riduzione corretta, mentre wrong_collapse rende testabile l'errore precedente.
Ecco la funzione centrale. L'identificativo del blank è 0:
def collapse(path, blank=0):
    """Merge runs first; a blank separates identical visible symbols."""
    result = []
    previous = None
    for symbol in path:
        symbol = int(symbol)
        if symbol != previous and symbol != blank:
            result.append(symbol)
        previous = symbol
    return result
previous memorizza il simbolo precedente. Aggiungiamo il simbolo corrente soltanto se è diverso dal precedente e se non è il blank.
Il punto decisivo si trova alla fine del ciclo: previous viene aggiornato anche per un blank. Una A incontrata dopo questo blank viene quindi confrontata con il blank, non con l'ultima A visibile. Può essere conservata.
Il codice realizza così in un solo passaggio le due operazioni che abbiamo separato per spiegarle. Attenzione anche a non confondere l'identificativo tecnico 0 con la cifra stampata 0: la classe del blank e quella di un carattere visibile hanno ruoli diversi.
Verifichiamo questo meccanismo con il comando del progetto:
docker compose run --rm tutorial python -m pdfctc.cli explain-ctc --text AA11
Osservate i percorsi e i testi ottenuti. Gli esempi di decodifica qui sopra spiegano il meccanismo; non sono predizioni ottenute sulle scansioni.
Perché quattro caratteri possono richiedere sei passi
Per produrre AA11, serve almeno un passo per ogni carattere, più un passo di separazione tra le due A e tra i due 1. Un percorso minimo è quindi A, blank, A, 1, blank, 1: sei passi per quattro caratteri.
Più in generale, il minimo è il numero di caratteri a cui si aggiunge il numero di coppie di caratteri identici adiacenti. È il tipo di vincolo verificato da minimum_steps prima di calcolare la perdita. Se la sequenza visiva è troppo breve, il problema è impossibile in questo quadro, anche con buoni parametri.
Ricordate bene le due lunghezze: quella dell'uscita temporale della rete e quella della trascrizione attesa. Non hanno né lo stesso valore né la stessa funzione.
La perdita CTC: il segnale che permette di apprendere
Una funzione di perdita, o loss, misura la differenza tra ciò che il modello produce e ciò che ci si aspetta. Fornisce il segnale usato per modificare i parametri. Qui CTC lavora sulle probabilità dei percorsi compatibili, non su un riquadro atteso per ogni lettera.
La chiamata rispetta il contratto di torch.nn.CTCLoss: log-probabilità, obiettivi, lunghezze di ingresso e lunghezze degli obiettivi. La documentazione corrispondente a PyTorch 2.8 permette di consultare questo contratto per la versione del percorso.
La funzione del progetto verifica anzitutto che i dati consentano questo calcolo:
def ctc_loss(logits, lengths, targets, target_lengths):
    offset = 0
    for time, size in zip(lengths.tolist(), target_lengths.tolist()):
        target = targets[offset : offset + size].tolist()
        offset += size
        if not target or 0 in target or time < minimum_steps(target):
            raise ValueError(
                f"CTC impossible: T={time}, L={size}, minimum={minimum_steps(target)}"
            )
    if offset != len(targets):
        raise ValueError("Target lengths do not sum correctly")
    # Transfer is differentiable: all network parameters and their gradients remain on CUDA.
    log_probs = logits.log_softmax(-1).cpu()
    loss = torch.nn.functional.ctc_loss(
        log_probs,
        targets.cpu(),
        lengths.cpu(),
        target_lengths.cpu(),
        blank=0,
        reduction="mean",
        zero_infinity=False,
    )
    if not torch.isfinite(loss):
        raise ValueError("Non-finite CTC loss")
    return loss
targets contiene le trascrizioni codificate come identificativi e concatenate. target_lengths indica quanti identificativi appartengono a ogni trascrizione. offset avanza quindi in questo grande array per ritrovare l'obiettivo di ogni riga.
Il primo controllo rifiuta un obiettivo vuoto, un blank nell'obiettivo o una sequenza troppo corta. Il secondo verifica che le lunghezze dichiarate corrispondano al numero totale di identificativi. Questi rifiuti sono protezioni del progetto: rendono gli errori espliciti prima dell'apprendimento.
log_softmax(-1) trasforma i logit in log-probabilità, sulla dimensione dei simboli. È la rappresentazione attesa da CTC; la documentazione di log_softmax spiega il calcolo combinato e la sua stabilità numerica.
reduction="mean" produce una perdita aggregata: PyTorch divide le perdite degli esempi per le loro lunghezze di obiettivo, poi ne calcola la media sul lotto. zero_infinity=False evita di sostituire automaticamente con zero le perdite infinite e torch.isfinite(loss) rifiuta una perdita infinita o non numerica. Nascondere un'impossibilità non la risolverebbe.
Ultima particolarità: la perdita CTC è calcolata su CPU in questo progetto, mentre i parametri della rete e i loro gradienti restano su CUDA. Il trasferimento rimane differenziabile: non interrompe il tracciamento delle operazioni che permette al segnale di apprendimento di risalire. Un gradiente indica come una piccola variazione di un parametro influenzi la perdita; la documentazione di Autograd presenta questo tracciamento automatico.
È una scelta del codice dimostrata, non una raccomandazione generale sulle prestazioni. La perdita CTC serve ad addestrare la rete; il tasso di errore dei caratteri servirà poi a valutare i testi effettivamente prodotti. Non confondiamo queste due misure.
Addestrare e verificare una ripresa
Confrontare due modi di apprendere
Un'epoca è un passaggio sugli esempi di addestramento. Nel corso di questi passaggi, la rete produce punteggi, viene calcolata la perdita CTC, poi l'ottimizzatore modifica i parametri a partire dai gradienti.
Il progetto confronta un modello addestrato con degradazioni e un modello addestrato solo con immagini pulite, con lo stesso budget e la stessa inizializzazione. L'aggiunta di degradazioni è una forma di aumento dei dati: esponiamo la rete a variazioni visive per cercare di renderla più robusta.
L'idea sembra ragionevole, ma non è una garanzia. Bisognerà verificare se il modello aumentato fa davvero meglio sulle stesse immagini di test.
Interrompere, riprendere, poi confrontare
Controlleremo anche la ripresa dell'addestramento. Eseguite l'addestramento interrotto, la variante pulita, il riferimento continuo, quindi la ripresa:
docker compose run --rm tutorial python -m pdfctc.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfctc.cli train-clean --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfctc.cli train-continuous --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfctc.cli train-resume --config configs/minimum.yaml
train si ferma dopo 7 epoche. Il riferimento train-continuous ne esegue 15 senza questa interruzione. train-resume ricarica lo stato interrotto ed esegue le 8 epoche rimanenti. Il comando train-clean fornisce invece il modello di confronto addestrato su immagini pulite.
Questi comandi non prolungano quindi tutti lo stesso modello in una lunga successione: costruiscono le varianti necessarie ai confronti.
Un checkpoint non si riduce ai pesi della rete. Per proseguire lo stesso esperimento, occorre ritrovare anche lo stato dell'ottimizzatore e gli altri stati utili alla ripresa. L'ottimizzatore è il meccanismo che esegue gli aggiornamenti dei parametri; la sua memoria può influenzare i passaggi successivi.
Controlliamo ora che l'interruzione non abbia cambiato il risultato:
docker compose run --rm tutorial python -m pdfctc.cli verify-resume --config configs/minimum.yaml
Il percorso validato restituisce una ripresa esatta. Il confronto riguarda i parametri, l'ottimizzatore, gli stati casuali, la cronologia e i dati. Non ci limitiamo quindi a constatare che due curve si assomigliano.
Questa esattezza riguarda l'ambiente validato. Modificare dipendenze o materiale richiede di verificare nuovamente il comportamento; il risultato non promette un'identità automatica tra tutte le macchine.
Trascrivere senza leggere le risposte attese
L'inferenza è il momento in cui usiamo i parametri appresi per produrre una trascrizione. Non si tratta più di modificare la rete a partire dalla risposta nota.
Il servizio di inferenza monta i pixel e i checkpoint in sola lettura. Le annotazioni non sono disponibili in questo servizio: deve ritrovare le righe, calcolare i punteggi temporali e decodificare i caratteri a partire dalle immagini.
docker compose run --rm inference python -m pdfctc.cli predict --config configs/minimum.yaml
Le predizioni vengono scritte in outputs/. Consultate alcune righe prima di guardare le medie globali. Una stringa può sembrare plausibile pur contenendo un errore in un identificativo o in un importo.
La valutazione ritroverà poi le annotazioni per confrontare i testi. Associa le predizioni ai riferimenti a partire dai riquadri, non scegliendo a posteriori il testo che ottiene il punteggio migliore. Il programma deve confrontare la riga giusta con il riferimento giusto, anche quando il riconoscimento ha sbagliato.
Leggere le metriche prima dei valori
Contare gli errori dei caratteri
Il CER, Character Error Rate, è il tasso di errore dei caratteri. Vale (S + I + D) / N.
S conta le sostituzioni, quando un carattere ne sostituisce un altro. I conta gli inserimenti, quando compare un carattere in più. D conta le eliminazioni, quando manca un carattere atteso. N è il numero di caratteri nel riferimento.
Per esempio, una sostituzione e un'eliminazione su dieci caratteri attesi danno (1 + 0 + 1) / 10 = 0,2. È un esempio di calcolo, non una misura aggiuntiva del modello.
Un CER di 0,34 non significa che il 34% delle righe sia errato. Rapporta gli errori dei caratteri al numero di caratteri attesi. Può perfino superare 1 se gli errori, soprattutto gli inserimenti, sono abbastanza numerosi. Non è dunque una semplice proporzione di righe riuscite o fallite.
Verificare anche ciò che l'applicazione deve usare davvero
L'esattezza della riga richiede che l'intera riga sia corretta. Basta una lettera errata per far fallire questa verifica, anche se il resto è leggibile.
L'esattezza dell'identificativo verifica separatamente il secondo campo. Nel nostro esempio BOLT AA11 12.50, questo campo è AA11. È una misura utile per non perdere di vista ciò che conta in un'importazione: una buona parte del testo riconosciuto non compensa un riferimento prodotto errato.
Infine, la copertura della segmentazione è il numero di righe abbinate dalla geometria diviso per il numero di righe di riferimento. Una copertura pari a 1 significa che tutte le righe sono state abbinate. Non dice che il testo sia corretto né che ogni ritaglio sia identico a quello dell'annotazione.
Distinguere la catena completa dalla diagnosi «gold crop»
Le misure riguardano 900 righe e 19.358 caratteri di test.
La misura end-to-end usa l'intera catena, inclusa la segmentazione per proiezione, che cerca le righe dalle file di pixel scuri. È ciò che si avvicina al percorso reale del documento in questo progetto.
La diagnosi gold crop fornisce direttamente al riconoscimento i ritagli di riferimento. Rimuoviamo così la scelta dei riquadri effettuata dalla segmentazione per esaminare la lettura sulle aree annotate.
Il termine gold indica il riferimento, non una promessa di punteggio migliore. Questa diagnosi non sostituisce la misura dell'intera catena e non rappresenta una predizione autonoma a partire dall'intera pagina.
Calcoliamo le misure sulle predizioni:
docker compose run --rm tutorial python -m pdfctc.cli evaluate --config configs/minimum.yaml
Cosa mostrano i risultati del percorso r001
Il modello iniziale, prima dell'addestramento, ottiene un CER di 0,9950, sia sulle versioni pulite sia su quelle degradate. I risultati seguenti permettono di confrontare l'effetto dell'addestramento e quello delle immagini usate per la valutazione. Un CER più basso è migliore.
| Modello | Versione valutata | CER |
|---|---|---|
| Iniziale, non addestrato | Pulita e degradata | 0,9950 |
| Addestrato su immagini pulite, catena completa | Pulita | 0,3387 |
| Addestrato su immagini pulite, catena completa | Degradata | 0,3694 |
| Addestrato con degradazioni, catena completa | Pulita | 0,4103 |
| Addestrato con degradazioni, catena completa | Degradata | 0,4131 |
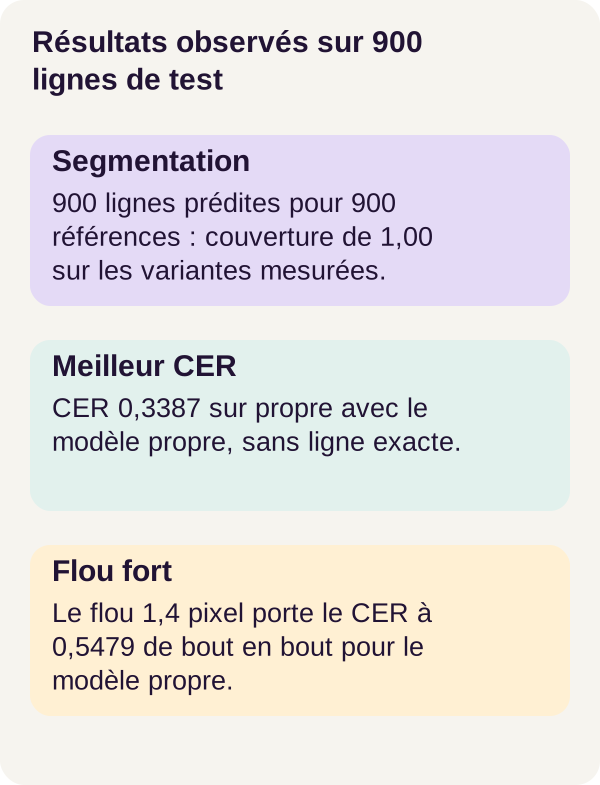
Il risultato migliore è quindi il modello addestrato su scansioni pulite, valutato end-to-end sulla versione pulita: CER 0,3387, con 900 righe predette per 900 riferimenti e una copertura di 1,00.
Ma ottiene anche 0 righe esatte e 0 identificativi esatti su 900. La catena ritrova le righe e il modello è migliorato rispetto alla sua inizializzazione, ma il risultato non è un estrattore di dati aziendali utilizzabile.
Sulla versione degradata, questo stesso modello ottiene 0,3694 nella catena completa e 0,3803 con i crop gold. Qui la diagnosi sui ritagli di riferimento non dà quindi un CER inferiore. Queste due medie non sono sufficienti da sole a identificare la causa di questo divario: occorre ispezionare gli esempi prima di proporre una spiegazione.
Infine, il modello addestrato con degradazioni resta a 0,4103 sulla versione pulita, poi a 0,4131 end-to-end sulla versione degradata. L'aumento scelto non supera l'addestramento pulito su questo corpus e con questo budget. È un risultato negativo da conservare, non un'anomalia da rimuovere dal racconto.
Questo non dimostra che ogni aumento dei dati sarebbe inutile. Mostra che questo aumento, in questo esperimento, non ha portato il guadagno sperato. Modificare le trasformazioni o il budget richiederebbe nuove misure.
Cosa abbiamo imparato
L'OCR riunisce diversi problemi: localizzare il testo, rappresentarne i pixel, contestualizzare una sequenza, poi decodificarla. Una buona risposta a uno di questi problemi non risolve automaticamente i successivi.
La CNN apprende motivi locali; il GRU collega le posizioni orizzontali; CTC permette di apprendere dalle trascrizioni senza imporre un riquadro a ogni carattere. Il suo blank gestisce l'allineamento e le ripetizioni: non rappresenta uno spazio.
Le misure ci offrono due lezioni concrete. Ritrovare tutte le righe non significa saperle leggere. E aggiungere degradazioni non garantisce un modello più robusto. La domanda utile resta: quali errori persistono, su quali documenti e con quali conseguenze?
Esercizio: prevedere prima di misurare
Scrivere un'ipotesi prima di lanciare il comando
Cambieremo una sola variabile: l'intensità della sfocatura, senza riaddestrare la rete.
Prima di lanciare l'esperimento, annotate cosa vi aspettate. Il CER aumenterà? La segmentazione perderà necessariamente delle righe? Il modello addestrato con degradazioni dovrà per forza resistere meglio di quello addestrato su immagini pulite? Distinguete un'ipotesi ragionevole da un risultato già noto.
Per verificare la vostra comprensione del blank, calcolate anche a mano la decodifica del percorso A, blank, A, A, 1, blank, 1, 1. Provate l'ordine corretto delle operazioni, poi quello inverso. Scrivete i due testi ottenuti prima di leggere la correzione.
Eseguire la variante fornita
configs/exercise.yaml fissa una sfocatura di 1,4 pixel e conserva i checkpoint. Usiamo quindi gli stessi modelli per osservare l'effetto di immagini più difficili, non per insegnare loro ad adattarsi.
docker compose run --rm tutorial python -m pdfctc.cli exercise --config configs/exercise.yaml
Aprite i risultati dell'esercizio e confrontateli con la vostra previsione. Per il percorso proposto, la decodifica corretta dà AA11; rimuovere prima i blank porta a A1. I file prodotti e lesson/SOLUTIONS.md permettono di studiare la correzione del percorso fornito.
La variante molto sfocata, senza riaddestramento, conferma il divario. Il modello addestrato su immagini pulite raggiunge un CER di 0,5479 end-to-end e di 0,5660 con i crop gold. Il modello aumentato raggiunge rispettivamente 0,5617 e 0,5918.
La copertura rimane 1,00, mentre l'esattezza della riga e dell'identificativo resta nulla. Il programma continua a ritrovare le righe, ma il loro contenuto è più difficile da trascrivere. Segmentazione e riconoscimento non si degradano quindi necessariamente nello stesso modo.
Proseguire l'esperimento senza cambiare tutto insieme
Potete poi variare soltanto l'intensità di una degradazione del generatore. Conservate il modello, le pagine e le annotazioni, quindi predite e misurate di nuovo.
Questa modifica personale è distinta dalla variante fornita: il suo risultato non è noto in anticipo. Non cambiate contemporaneamente dati e addestramento, altrimenti non saprete più a cosa attribuire lo scarto osservato.
La progressione non è necessariamente monotona per ogni pagina: aumentare la degradazione non garantisce che ogni singola trascrizione peggiori a ogni prova. Ispezionate anche gli esempi che contraddicono la vostra intuizione e spiegateli senza scartarli.
Generare le figure e controllare i file
Produrre le figure dai vostri risultati, quindi verificare i checkpoint:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
I sei checkpoint del percorso di riferimento superano il loro controllo di struttura e identità. Questo controllo riguarda i file attesi; non trasforma un modello poco preciso in un modello affidabile.
Guardate poi le curve e gli esempi di righe in outputs/. Un CER aggregato indica l'ampiezza globale degli errori, ma gli esempi permettono di vedere cosa accade: i caratteri sono confusi, aggiunti o persi? Confrontate la trascrizione con l'immagine invece di limitarvi alla sua plausibilità.
Testare gli errori e risolvere i problemi
Un caso negativo verifica che il programma rifiuti una situazione incoerente. Superare questo test significa quindi ottenere il rifiuto previsto, non riuscire comunque a produrre un output.
I test coprono in particolare un obiettivo CTC vuoto, un blank vietato nella trascrizione di destinazione, un numero insufficiente di passi temporali e una riga troppo larga. Non aggirate questi errori tagliando silenziosamente il testo o mascherando una perdita impossibile: modifichereste il problema anziché risolverlo.
Su mobile, fate scorrere la tabella orizzontalmente.
| Sintomo | Verifica e correzione |
|---|---|
| La GPU appare sull'host ma CUDA fallisce in Docker | Confrontate preflight e check_environment.py, quindi correggete l'integrazione NVIDIA prima dell'addestramento. |
| Una riga supera la larghezza prevista | Ispezionate il suo riquadro e il suo ridimensionamento. Il corpus personale può richiedere un'altra segmentazione, da valutare come modifica del progetto. |
| CTC rifiuta un obiettivo | Verificate le lunghezze, le ripetizioni e l'assenza del blank nei caratteri attesi. |
| Manca un checkpoint | Ritrovate la fase di addestramento corrispondente e il suo errore; un file assente non deve essere sostituito da pesi arbitrari. |
| Il disco è pieno | Verificate lo spazio per scansioni, checkpoint e risultati. Conservate i file utili prima della pulizia mirata qui sotto. |
Arrestare e pulire
Copiate anzitutto i risultati e le figure che desiderate conservare. Il primo comando arresta il progetto. Lo script mostra e poi cancella soltanto outputs/. L'ultimo arresto termina il percorso dopo l'esecuzione della pulizia.
Il contenuto di outputs/ verrà eliminato. Le scansioni restano in data/generated/ e i checkpoint in assets/checkpoints/.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Nessun volume Docker globale viene eliminato. Per rifare il percorso, usate le stesse istruzioni e le dipendenze bloccate dello ZIP. Una pulizia mirata permette di sapere che cosa viene eliminato senza toccare gli altri progetti.
Dal tutorial a un'applicazione reale
Il primo lavoro non sarebbe aggiungere una route HTTP, bensì disporre di documenti rappresentativi e di una qualità misurata su tali documenti.
Sostituite il corpus fittizio con documenti autorizzati, accompagnati dalle loro annotazioni. Separate i dati in modo da evitare fughe tra apprendimento e test per fornitore, modello o lotto. Misurate il CER e i criteri davvero utili alla vostra applicazione su fonti distinte. Lingue, rotazioni, tabelle, pagine complesse e scrittura a mano richiedono dati e valutazioni aggiuntivi.
L'integrazione web comporta altre responsabilità: autenticazione, diritti sui documenti, limiti dei file, elaborazione asincrona, supervisione e test di carico, secondo il contesto. Un'API asincrona consentirebbe, per esempio, di separare il deposito del documento dal recupero del suo risultato; non è una funzionalità fornita da questo tutorial.
Proteggete i dati, versionate i modelli e prevedete un controllo umano sugli identificativi e sugli importi critici. L'isolamento del parser PDF, cioè della libreria che apre e interpreta il file, così come la manutenzione delle librerie native, fanno parte dell'esercizio.
La rete di questo tutorial non offre una qualità sufficiente per automatizzare un'estrazione aziendale senza controllo. Il suo interesse è rendere osservabili il meccanismo e i suoi limiti, per sapere che cosa migliorare e verificare in seguito.
Per approfondire
Iniziate costruendo un corpus annotato rappresentativo delle vostre scansioni. Studiate separatamente gli errori di segmentazione e quelli di riconoscimento: un'immagine di riga ritagliata male e una lettera riconosciuta male non richiedono la stessa indagine.
Potete poi confrontare un altro budget di addestramento mantenendo fisso un insieme di test, oppure provare una decodifica che esplori più percorsi. In entrambi i casi, misurate il contributo reale invece di dedurlo dalla sola scelta della tecnica. Sono estensioni da sperimentare, non miglioramenti già validati nel percorso r001.
I collegamenti documentari integrati nel testo approfondiscono i meccanismi: operazioni sulle immagini in Pillow, layer e lunghezze di sequenza in PyTorch, poi il principio di CTC nell'articolo fondativo. I riferimenti a PyTorch 2.8 corrispondono alla versione qui usata; le altre documentazioni possono evolvere. Per riprodurre l'esperimento, configurazioni e dipendenze bloccate dello ZIP restano il vostro punto di partenza.