





Vous développez un back-office qui permet de partager des courriers après avoir caché leurs informations sensibles. Dans l’aperçu, les noms et les adresses sont recouverts de noir. Le fichier paraît prêt à être envoyé. Mais que se passe-t-il si son destinataire sélectionne le texte et le copie dans un éditeur ?
Pour un développeur web, le piège rappelle un élément masqué à l’écran alors que sa valeur reste dans le HTML. Un PDF n’est pas une page web, mais la distinction est la même : ne plus voir une information ne signifie pas qu’elle a disparu du fichier. Une barre noire ajoutée à un PDF peut laisser le texte et les objets d’origine en dessous.
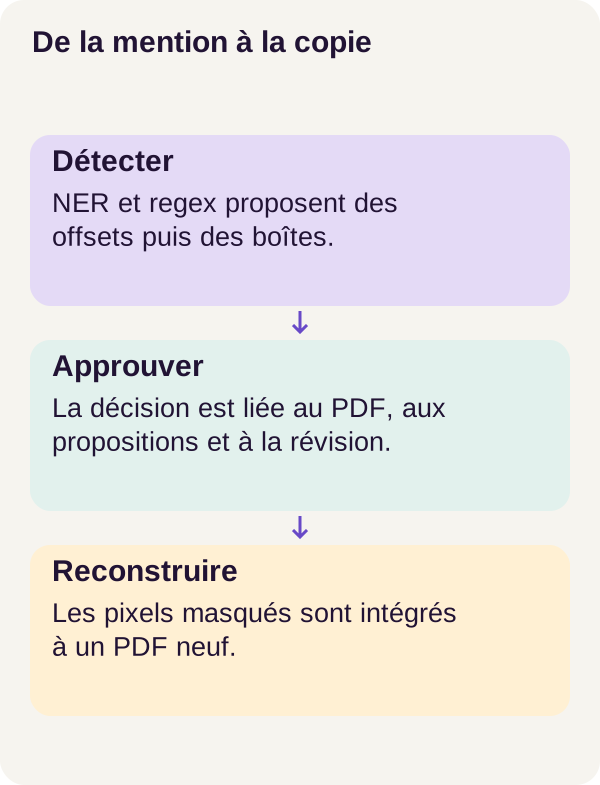
Nous allons construire une chaîne qui traite séparément ces problèmes : proposer des zones sensibles, sélectionner celles à approuver, modifier les pixels concernés, puis fabriquer un nouveau PDF à partir de l’image obtenue. Nous vérifierons ensuite ce qui a réellement été masqué, plutôt que de nous fier à son apparence.
Télécharger le ZIP du tutoriel r001
Notre fil rouge est une lettre fictive « Solstice Support ». Elle contient un nom, une adresse @example.org et une référence de ticket. Le programme doit retrouver les mentions candidates sans lire les réponses attendues, ne masquer que les zones approuvées et ne pas transporter la structure PDF source dans la copie reconstruite.
Ce tutoriel est une démonstration, pas un dispositif d’anonymisation prêt à l’emploi. Il ne délivre ni avis juridique ni garantie sur des documents réels. Son résultat le plus important est justement un échec observable : sur le test, certaines mentions ne seront pas entièrement masquées.
Ce que mesure réellement l'exemple
Du texte, des pixels et un fichier : trois choses différentes
Nous allons manipuler plusieurs représentations de la même lettre. Le texte extrait permet de rechercher une adresse ou un nom. Les pixels donnent l’apparence de la page rendue. La structure du PDF contient les éléments utilisés pour représenter le document : ce n’est pas simplement une capture d’écran.
Cette dernière distinction ne concerne pas uniquement le texte visible. La documentation Adobe sur les informations cachées dans les PDF mentionne notamment les métadonnées, les commentaires et les calques. Nous n’allons pas supposer que ces éléments ont disparu parce qu’une zone paraît noire : le projet inspecte la copie qu’il produit.
Rastériser une page, c’est en calculer une image composée de pixels. Cela ne veut pas dire reconnaître son texte. L’OCR, au contraire, cherche à retrouver des caractères à partir d’une image. Ici, la détection reçoit du texte ; la rastérisation nous sert à fabriquer et à contrôler la copie visuelle. Ce parcours ne démontre pas une reconnaissance de noms directement sur des scans.
Ce que l’IA apporte, et ce que les règles font déjà
Une entité nommée est une portion de texte à laquelle nous attribuons un type. Dans ce projet, les types recherchés sont des personnes (PERSON), des e-mails (EMAIL) et des références (REFERENCE). Le mot mention désigne une occurrence dans le document : retrouver un nom à un endroit ne dispense pas de chercher ses autres occurrences.
Le NER, pour Named Entity Recognition, est la reconnaissance d’entités nommées. spaCy propose des mentions de personnes à partir d’un modèle déjà entraîné. Deux expressions régulières, ou regex, recherchent de leur côté les formats d’e-mails et de références prévus dans le cours.
Pourquoi associer les deux ? Parce que nous n’avons pas le même problème pour une adresse au format reconnaissable et pour un nom situé dans une phrase. Les regex expriment des motifs écrits par le développeur ; le NER utilise un modèle statistique. Aucun des deux ne découvre automatiquement toute information sensible possible. La documentation de spaCy présente ce fonctionnement et rappelle que ses prédictions peuvent être erronées.
Le programme forme ensuite leur union : il rassemble les candidats des deux mécanismes. Il ne demande pas que les deux soient d’accord pour proposer une zone. Nous verrons dans le code ce qui est réellement fusionné, et ce qui reste distinct.
Le parcours utilise spaCy 3.7.2 avec en_core_web_sm 3.7.1, chargé localement. Il ne réentraîne pas ce modèle sur les lettres : nous faisons de l’inférence, c’est-à-dire une utilisation du modèle existant pour obtenir des prédictions. La fiche de cette version précise de en_core_web_sm décrit un pipeline anglais optimisé pour le CPU. Le fait que ce tutoriel soit rédigé en français ne transforme donc pas le modèle en détecteur français.
Garder les réponses attendues hors du détecteur
Le jeu contient 120 lettres synthétiques : 30 pour le développement et 90 pour le test. La partition de test comporte 360 mentions attendues.
Ces mentions sont décrites par des annotations de référence, souvent appelées gold. Elles jouent le rôle du corrigé d’un exercice. Elles servent à mesurer ce que le programme a trouvé, pas à lui indiquer où chercher.
Le conteneur d’inférence ne monte pas leur répertoire. Pour un développeur habitué à Docker, cette frontière est concrète : le processus n’a pas simplement pour consigne de ne pas ouvrir les réponses, il ne doit pas disposer du dossier qui les contient. La séparation permet d’évaluer une proposition, plutôt qu’un programme qui recopie discrètement son corrigé.
Les 30 lettres de développement servent à préparer le parcours ; les 90 de test servent à mesurer le résultat final. Ces nombres ne décrivent pas un nouvel entraînement de spaCy. Ils ne représentent pas non plus la diversité des noms, langues et mises en page que contiendrait une collection réelle.
Poser les bonnes questions avant de calculer un score
Pour la détection, nous comptons les vrais positifs, c’est-à-dire les mentions correctement proposées, et toutes les prédictions émises. La précision répond à « parmi mes propositions, combien sont justes ? » ; le rappel répond à « parmi les mentions attendues, combien ai-je retrouvées ? ».
Les calculs sont précision = vrais positifs / prédictions et rappel = vrais positifs / mentions gold. À titre d’exemple pédagogique, trouver correctement 8 mentions parmi 10 attendues, avec 2 propositions inutiles en plus, donne une précision de 8/10 et un rappel de 8/10. Les valeurs sont égales, mais les questions restent différentes.
Le masquage ajoute une autre mesure : couverture = pixels gold couverts / pixels gold. Une mention n’est entièrement masquée que si tous ses pixels de référence sont couverts. Une bonne détection ne garantit pas que le rectangle appliqué soit bien positionné ; une bonne couverture moyenne ne garantit pas que chaque mention soit complète.
Nous suivrons donc la détection, les pixels, les mentions complètes et la structure du fichier. Zéro caractère extractible n’est pas un score de disparition des informations visibles. L’exercice final permettra de le constater très directement.
Préparer une exécution CPU reproductible
Vous devez savoir lire du Python, utiliser un terminal et lancer Docker Compose. Nous expliquerons les coordonnées et les opérations sur les images au fil du code. Aucune expérience préalable d’OCR ou de calcul GPU n’est nécessaire.
Le parcours r001 a été validé sur CPU : aucun GPU NVIDIA n’est requis. Prévoyez environ 16 Gio de RAM et 15 Gio de disque libre pour les images, les conteneurs et les sorties. Il s’agit des indications de préparation du cours, pas de mesures garanties pour toutes les machines.
Décompressez le ZIP et placez le terminal à sa racine. Toutes les commandes de l’article se lancent depuis ce même répertoire. Nous conservons leurs configurations et leur ordre pour retrouver les conditions de référence.
Vérifier l’environnement et construire les services
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
Le préflight est le contrôle préalable : il vérifie notamment Docker, la mémoire et l’espace disque. setup.sh prépare le parcours. Compose vérifie ensuite sa configuration, puis construit les services acquisition, tutorial et inference.
Ne soyez pas surpris si docker compose config --quiet ne produit aucun texte lorsqu’il réussit : l’option --quiet valide sans afficher la configuration. Ce qui compte est l’absence d’erreur et un code de retour nul.
Contrôler les ressources puis les tests
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Dans cette révision, l’acquisition contrôle les versions et les empreintes des ressources verrouillées ; le cours annonce qu’aucune ressource n’est téléchargée à l’exécution du tutoriel. Ce n’est pas une invitation à laisser l’inférence récupérer automatiquement un autre modèle. La construction des images Docker reste une étape distincte de cette exécution.
check_environment.py confirme la présence des ressources. Les tests vérifient ensuite les fonctions du cours avant la production des PDF. Un test réussi signifie que le comportement testé est respecté ; il ne signifie pas que toutes les mentions d’une lettre seront reconnues.
Si un contrôle de mémoire ou de disque échoue, libérez les ressources nécessaires et reprenez au préflight. Supprimer le contrôle ne réduit pas les besoins du programme.
Préparer les lettres et proposer des zones
Créer les entrées de l’expérience
docker compose run --rm tutorial python -m pdfredactai.cli prepare --config configs/minimum.yaml
prepare crée les lettres synthétiques, leur rendu et les annotations de mesure. Ces annotations restent hors du volume utilisé par l’inférence. Le garde-fou du projet rend cette contrainte explicite : le détecteur ne doit pas voir data/generated/labels.
À ce stade, nous avons les documents à traiter et, séparément, leur corrigé. Nous pouvons maintenant demander au programme de proposer des zones à partir des seules entrées observables.
Relier une portion de texte à un emplacement sur la page
docker compose run --rm inference python -m pdfredactai.cli propose --config configs/minimum.yaml
propose charge le modèle local et écrit les candidats dans outputs/proposals.json. Une proposition doit conserver davantage qu’un mot : nous avons besoin de son type, de son emplacement dans le texte et de ses rectangles dans le document.
Ces emplacements textuels sont des offsets de caractères. Ils indiquent où commence et où finit une portion de chaîne. Dans la documentation de Span, spaCy les expose avec start_char et end_char. Ne les confondez pas avec les positions de tokens, les unités de texte découpées par son pipeline.
Prenons une chaîne inventée uniquement pour comprendre l’indexation : Contact: Alice Rowan.. La portion Alice Rowan commence à l’indice 9 et finit juste avant l’indice 20. L’expression Python text[9:20] contient donc les 11 caractères du nom. La borne de fin est exclue. Cet exemple n’est ni une sortie du modèle ni une lettre supplémentaire du corpus.
Ces indices ne sont pas des coordonnées d’image. Le caractère numéro 9 ne se situe pas nécessairement au pixel horizontal 9. Il faut retrouver les rectangles associés à cette portion dans le document, puis les convertir dans le repère du rendu. C’est le lien que le projet conserve avec span_boxes, puis avec le traitement géométrique du masque.
Lire la fusion NER + regex
Voici le cœur exact de propose :
regex = regex_candidates(text)
ner = [
    {
        "start": e.start_char,
        "end": e.end_char,
        "kind": e.label_,
        "source": "ner",
    }
    for e in result.ents
    if e.label_ in config["entity_labels"]
]
candidates = {}
for candidate in regex + ner:
    key = (candidate["start"], candidate["end"])
    row = candidates.setdefault(key, {**candidate, "sources": []})
    row["sources"].append(candidate["source"])
union = []
for index, ((a, b), candidate) in enumerate(sorted(candidates.items())):
    union.append(
        {
            **candidate,
            "id": f"z{index:03d}",
            "text": text[a:b],
            "boxes": span_boxes(document, a, b),
        }
    )
La première partie fabrique les candidats NER. Pour chaque entité de result.ents, le code conserve ses bornes de caractères, son type label_ et son origine ner. Le filtre config["entity_labels"] sélectionne les types autorisés par la configuration. Les candidats regex ont été calculés séparément par regex_candidates(text).
La deuxième partie rassemble les occurrences au même emplacement. regex + ner concatène les deux listes. La clé du dictionnaire est le couple (start, end), pas le texte reconnu. Deux occurrences identiques à des endroits différents ne sont donc pas confondues simplement parce qu’elles portent le même nom.
setdefault insère une ligne si la clé n’existe pas ; sinon, il retourne celle qui était déjà présente. C’est le comportement décrit dans la documentation Python des dictionnaires. La notation **candidate recopie les champs du candidat, auxquels le programme ajoute une liste sources.
Si regex et NER proposent exactement les mêmes bornes, une seule ligne est conservée et les deux origines sont enregistrées. Ce ne sont pas deux votes indépendants et cela ne donne pas une probabilité de justesse. L’extrait conserve des provenances ; il ne calcule pas un score de confiance combiné.
Il y a aussi une limite à lire dans ces quelques lignes. Si deux candidats partagent les mêmes bornes mais pas le même kind, les champs du premier restent conservés : setdefault ne les arbitre pas. Puisque la liste regex vient avant la liste NER, son candidat est rencontré d’abord. Inversement, deux candidats qui se chevauchent sans avoir exactement les mêmes bornes restent distincts. Cette union n’est pas une fusion générale des rectangles.
La dernière partie prépare la sortie. Les couples sont triés par début, puis par fin. enumerate leur donne des identifiants comme z000, z001 et z002. text[a:b] récupère le texte de chaque occurrence, et span_boxes(document, a, b) retrouve les boîtes correspondantes.
Un identifiant comme z003 est ainsi une position dans la liste de propositions de cette version, pas une identité universelle du nom détecté. Si les propositions changent, ce numéro peut désigner une autre zone. C’est une bonne raison de lier l’approbation à la version exacte du document et de la proposition.
Une approbation traçable, mais pas encore humaine
docker compose run --rm inference python -m pdfredactai.cli review --config configs/minimum.yaml
Le mot review peut faire penser à un opérateur qui a lu la lettre. Ce n’est pas ce que cette commande démontre. Dans le POC, ou preuve de concept, la revue applique la politique configurée aux propositions du corpus synthétique.
La décision est liée au SHA-256 du PDF, au digest de la proposition et à la révision. Un digest est une empreinte calculée à partir d’un contenu. La documentation Python de hashlib décrit notamment SHA-256. Ici, ces empreintes servent à vérifier que l’on travaille sur les fichiers auxquels la décision se rapporte.
Pensez à une validation de formulaire qui doit rester attachée à la bonne version d’un enregistrement. Une approbation de la lettre A ne doit pas être réutilisée silencieusement après son remplacement par une lettre B. Pour autant, le hachage ne prouve ni qu’une personne a lu la lettre ni qu’elle a choisi les bonnes zones.
Une interface de revue, l’identité de l’opérateur, ses droits et une politique d’escalade des cas incertains restent à concevoir pour un produit. Pour l’instant, inspectez les propositions et les décisions comme des sorties de l’expérience, pas comme une validation humaine acquise.
Masquer les pixels et reconstruire la copie
Remplacer les pixels, plutôt qu’ajouter un objet par-dessus
Nous avons maintenant des zones approuvées. Le programme ne les transforme pas en rectangles ajoutés au PDF initial. Il travaille sur une copie de l’image de la page, remplace les pixels concernés par du noir, puis le module rebuild crée un nouveau PDF à partir de cette image modifiée.
La fonction suivante produit trois objets : l’image noircie, un masque de contrôle et la liste des rectangles appliqués. Elle ne crée pas elle-même le PDF ; cette étape vient ensuite.
def mask_pixels(image, boxes, scale, margin):
    image = image.convert("RGB").copy()
    mask = Image.new("L", image.size, 0)
    paint = ImageDraw.Draw(image)
    mark = ImageDraw.Draw(mask)
    rectangles = []
    for box in boxes:
        x0, y0, x1, y1 = pixel_box(box, scale, image.size, margin)
        rectangle = (x0, y0, x1 - 1, y1 - 1)
        paint.rectangle(rectangle, fill=(0, 0, 0))
        mark.rectangle(rectangle, fill=255)
        rectangles.append([x0, y0, x1, y1])
    return image, mask, rectangles
Pourquoi deux images ?
image.convert("RGB").copy() prépare une copie en trois canaux : rouge, vert et bleu. Le noir est représenté par (0, 0, 0). Le second objet, créé avec Image.new("L", image.size, 0), contient un seul canal de niveaux de gris, initialement rempli de zéros. Ces modes sont décrits dans les concepts de Pillow.
Les deux images n’ont pas le même rôle. L’image RGB est le document visuel modifié. Le masque indique où le programme est intervenu. Dans ce masque, la valeur 255, blanche, marque les zones traitées ; le zéro, noir, signifie qu’aucun rectangle n’y a été appliqué. Le blanc du masque ne veut donc pas dire que la page publiée sera blanche à cet endroit : elle y est noircie.
paint dessine dans la copie du document ; mark dessine dans le masque. Chaque rectangle reçoit le même emplacement dans les deux. Cette correspondance permet ensuite de comparer les zones effectivement traitées aux zones de référence.
La copie laisse l’image d’entrée intacte. C’est pratique pour vérifier la transformation, mais cela rappelle aussi que fabriquer une copie occultée ne supprime pas l’original. La fonction n’efface ni le PDF source ni les autres fichiers intermédiaires.
Passer des coordonnées du document à celles du rendu
pixel_box reçoit la boîte source, l’échelle scale, la taille de l’image et la marge margin. Le calcul des arrondis et des limites de page est dans cette fonction du projet, pas dans l’extrait ci-dessus. Il faut conserver ses conventions plutôt que deviner celles d’une autre bibliothèque.
Pour comprendre seulement l’échelle, prenons un exemple géométrique indépendant du corpus. Avec des origines déjà alignées et sans marge, une boîte (10, 20, 30, 25) agrandie d’un facteur deux devient (20, 40, 60, 50). Ses dimensions passent de 20 × 5 à 40 × 10 ; son aire est multipliée par quatre. Cet exemple ne décrit pas les arrondis ou la marge configurés dans r001.
Une marge peut couvrir le bord d’un caractère qui dépasse légèrement la boîte retenue, mais elle noircit aussi davantage de voisinage. Elle ne remplace pas la recherche d’une mention oubliée ailleurs sur la page. Il faudra lire la couverture des zones sensibles et le masquage des zones non sensibles.
À quoi servent les deux « moins un » ?
La ligne rectangle = (x0, y0, x1 - 1, y1 - 1) mérite un arrêt. La fonction Pillow rectangle inclut ses deux bornes. Le code traduit donc une boîte dont la borne droite et la borne basse sont exclues vers ce dessin inclusif.
Supposons que pixel_box retourne (10, 20, 30, 25). Nous voulons couvrir les colonnes 10 à 29 et les lignes 20 à 24 : 20 × 5 = 100 pixels. Le rectangle passé à Pillow finit alors à (29, 24).
Sans soustraire un, le dessin irait jusqu’à la colonne 30 et à la ligne 25, soit 21 × 6 = 126 pixels. Le rectangle paraîtrait presque identique à l’écran, mais sa surface et les mesures seraient différentes. Ce petit exemple explique une convention de coordonnées ; ce n’est pas un nouveau résultat du corpus.
Enfin, rectangles.append([x0, y0, x1, y1]) conserve les bornes originales pour la trace. La liste mémorisée et le rectangle dessiné utilisent ainsi deux écritures cohérentes de la même zone.
Exécuter la transformation et l’évaluation
docker compose run --rm inference python -m pdfredactai.cli redact --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfredactai.cli evaluate --config configs/minimum.yaml
redact vérifie l’approbation et l’empreinte SHA de la source avant et après la reconstruction. Il refuse, lui aussi, la présence des annotations gold. evaluate peut ensuite accéder au corrigé pour mesurer ce qui a été couvert.
Chaque ligne de outputs/transformation.json porte le statut FIXTURE_COPY_NOT_A_SAFETY_CERTIFICATE. Une fixture est un cas de test connu, préparé pour vérifier un comportement. Vous pouvez lire ce statut comme « copie du cas de test, pas certificat de sécurité ».
L’évaluation examine les pixels, l’absence du marqueur synthétique recherché et la structure de la copie : une page, une image /Im0, pas de texte ni d’objets source attendus. /Im0 est le nom de la ressource image dans ce fichier. Sa présence ne signifie pas que l’image ne contient plus d’information sensible : ce sont justement les pixels qu’il reste à contrôler.
Ces vérifications répondent donc à deux questions distinctes : avons-nous reconstruit le type de fichier prévu, et avons-nous effectivement masqué toutes les zones attendues ? La première peut réussir alors que la seconde échoue.
Lire les résultats avant de les généraliser
La figure sépare la détection des mentions et l’application du masquage. Gardons cette séparation lorsque nous lisons les chiffres du parcours de référence.
Les regex sont précises, mais elles ne cherchent pas tout
Sur les 360 mentions de test, les regex seules trouvent 180 mentions correctes : les 90 e-mails et les 90 références. Elles ne trouvent aucune des 180 mentions de personnes. Leur précision vaut donc 1,00, mais leur rappel seulement 0,50.
Une précision parfaite ne signifie pas que la tâche est terminée. Ici, elle signifie que les propositions émises sont justes ; la moitié des mentions attendues manque encore.
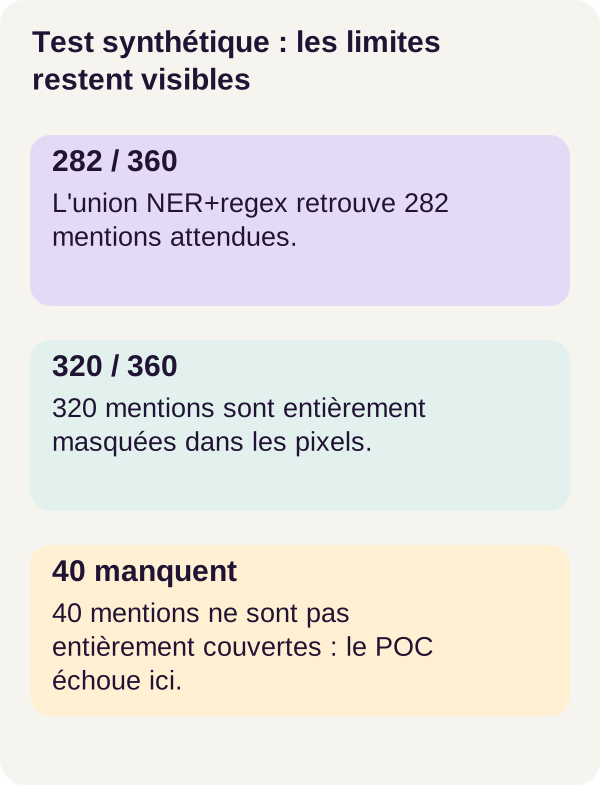
L’union NER + regex retrouve 282 vrais positifs sur 411 propositions, soit une précision de 0,686 et un rappel de 0,783. Voici les comptes qui permettent de comprendre la différence :
| Méthode | Mentions correctes | Propositions | Précision | Rappel |
|---|---|---|---|---|
| Regex seules | 180 | 180 | 1,00 | 0,50 |
| Union NER + regex | 282 | 411 | 0,686 | 0,783 |
L’ajout du NER retrouve donc davantage de mentions, mais ajoute aussi des zones non attendues. Par différence, l’union compte 129 propositions non reconnues comme correctes (411 - 282) et 78 mentions attendues non retrouvées comme vrais positifs (360 - 282). Ces deux nombres sont calculés à partir des comptes publiés, pas issus d’un nouvel essai.
La catégorie PERSON explique l’essentiel de cette difficulté : elle compte 102 vrais positifs pour 231 propositions et 180 mentions gold. Nous avons donc un détecteur qui aide à trouver des personnes, pas un détecteur qui les retrouve toutes ni qui propose toujours les bonnes zones.
Une couverture de pixels n’est pas une proportion de mentions complètes
La transformation couvre 1 717 175 des 1 881 925 pixels gold, soit 0,91246, environ 91,25 %. Elle masque complètement 320 mentions sur 360.
Il reste donc 40 mentions incomplètement masquées. Cela ne veut pas dire que les 40 sont intégralement visibles, ni qu’elles sont nécessairement illisibles : le contrôle dit que leur couverture n’est pas complète. On ne transforme pas ce constat en succès parce que le rectangle « semble assez grand ».
Pourquoi les pourcentages de pixels et de mentions peuvent-ils différer ? Dans un exemple fictif, supposons deux mentions dont les zones de référence occupent 100 et 10 pixels. Si la première est entièrement couverte et la seconde pas du tout, la couverture globale vaut 100/110, soit environ 90,91 %, mais seule une mention sur deux est entièrement masquée. Les grandes surfaces pèsent davantage dans le premier calcul ; chaque mention pèse une unité dans le second.
Le même raisonnement explique pourquoi nous ne devons pas confondre 282 détections correctes et 320 mentions complètement masquées. Les métriques ne comptent pas les mêmes objets. Par exemple, une zone trop large peut couvrir des pixels sensibles sans être reconnue comme une bonne proposition de détection ; plusieurs masques peuvent aussi se recouvrir.
Ce sont des explications possibles du mécanisme, pas un diagnostic des mentions de ce test. Les totaux publiés ne suffisent pas à expliquer chaque différence : il faudrait examiner les propositions, les rectangles et les correspondances de l’évaluation, mention par mention. Nous conservons les deux résultats sans les remplacer l’un par l’autre.
Un marqueur absent ne prouve pas que tout a disparu
Dans les 12 documents qui contenaient le marqueur synthétique, le rapport compte zéro chaîne marqueur restante. Ce contrôle ciblé est utile : le signal recherché n’a pas été retrouvé par ce test. Mais il ne compense pas les 40 échecs de couverture.
À l’échelle des documents, les sorties indiquent 55 statuts PASS_FIXTURE et 35 échecs de contenu fixture, sur les 90 lettres de test. Une lettre peut donc échouer même si plusieurs de ses zones ont été correctement traitées.
Gardez les noms des statuts dans vos sorties. PASS_FIXTURE signifie que le cas satisfait les contrôles de cette expérience ; cela ne transforme pas le statut général FIXTURE_COPY_NOT_A_SAFETY_CERTIFICATE en autorisation de diffusion d’un document réel.
Le parcours rapporte également un temps moyen d’environ 0,096 seconde par document et une taille moyenne de 54 116 octets par PDF. Ces valeurs décrivent ce corpus et cette machine CPU. Elles ne mesurent pas le temps d’un opérateur humain et ne promettent pas la même performance sur une autre collection.
Le coût du masquage en trop
La fraction de pixels non sensibles masqués est 0,00871, soit environ 0,87 % de la zone non sensible. C’est le coût visuel de la marge et des faux positifs : une partie du contenu que l’on souhaitait conserver est noircie.
Ce taux n’est pas la proportion de fausses propositions. Son dénominateur est une surface de pixels, pas un nombre d’entités. Un seul grand rectangle inutile peut peser beaucoup dans cette mesure ; plusieurs petites propositions peuvent peser peu.
Enfin, reconstruire un PDF à partir des pixels a un coût fonctionnel : le texte sélectionnable, les liens actifs, les formulaires et les signatures numériques d’origine ne sont pas transportés comme tels dans cette copie. Voir encore la forme d’un lien ou le dessin d’une signature ne signifie pas que leur fonction d’origine existe toujours. L’accessibilité demande une conception séparée, au-delà de cette démonstration.
Synthèse avant l’exercice
Nous avons relié quatre étapes qui ne se remplacent pas : détecter une mention, approuver une zone, modifier ses pixels et vérifier la copie produite.
Le modèle et les regex peuvent manquer une mention. Une politique peut approuver une zone insuffisante. Une conversion de coordonnées peut laisser un bord découvert. Enfin, une structure PDF simplifiée peut contenir une image où l’information sensible reste visible.
Le parcours nous permet de localiser ces questions plutôt que de les réduire à « le PDF est noirci ». L’exercice va maintenant isoler deux mauvaises hypothèses : qu’une couverture graphique suffit, et que l’absence de texte extractible suffit.
Exercice : prédire avant de vérifier
Avant d’exécuter la commande, formulez votre réponse à cette première hypothèse : « Une couverture noire ajoutée au PDF suffit, car le lecteur voit une zone noire. » Que renverra, selon vous, l’extraction de texte ?
Puis inversez le raisonnement. Si nous transformons la page en image et fabriquons un nouveau PDF sans masquer les pixels, l’extracteur trouvera-t-il encore du texte ? Et qu’est-ce qu’une personne verra en ouvrant le fichier ?
Notez vos prédictions, puis lancez le scénario fourni :
docker compose run --rm tutorial python -m pdfredactai.cli exercise --config configs/exercise.yaml
Comparer votre prédiction aux deux contre-exemples
La commande fabrique deux cas fictifs. Les résultats ci-dessous sont ceux rapportés pour le parcours de référence :
| Cas | Extraction de texte | Ce que l’expérience montre |
|---|---|---|
| Couverture noire ajoutée au PDF | cover_text_characters: 361 |
Le texte source reste extractible malgré la couverture visible. |
| Reconstruction raster sans masque | Zéro caractère extractible | Les pixels sensibles d’origine sont conservés exactement. |
Dans le premier cas, l’affichage ne suffit pas : la couche noire n’a pas supprimé le texte sous-jacent. Dans le second, l’extraction ne suffit pas : elle renvoie zéro parce qu’elle ne retrouve pas de texte natif, pas parce que les informations ont disparu de l’image.
Les deux tests négatifs réfutent deux garanties imaginaires. Ils ne se corrigent pas mutuellement. Il faut vérifier les zones pixel par pixel et la structure du nouveau PDF, puis traiter toute omission de détection comme un échec à revoir.
Revenez ensuite aux 40 mentions incomplètement masquées du parcours principal. Le second contre-exemple explique pourquoi une extraction vide ne peut pas les faire passer au vert. C’est cette association entre observation et mesure qui rend le tutoriel utile.
Générer les figures, contrôler les jalons et nettoyer
Produire les dernières sorties avant de les supprimer
Les figures doivent être construites à partir des mesures existantes. Exécutez ces deux commandes depuis la racine du projet :
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
plot.py utilise l’évaluation déjà produite. check_checkpoints.py contrôle les jalons et signale une incohérence entre le cours et le code. La présence du mot checkpoint dans son nom ne signifie pas que nous venons d’entraîner spaCy : ce parcours utilise toujours le modèle local prévu.
Avant le nettoyage, conservez les résultats que vous souhaitez étudier. Pour suivre un cas, rapprochez outputs/proposals.json, la décision de revue, les rectangles appliqués, l’image masquée et outputs/transformation.json. Une moyenne globale ne dit pas pourquoi une lettre précise échoue.
Dépanner au bon endroit
Une ressource manque ou son empreinte diffère ? Reprenez l’acquisition et le contrôle d’environnement, avec les fichiers verrouillés du cours. Substituer un autre modèle changerait l’expérience avant même la première proposition.
Un nom reste visible ? Regardez d’abord s’il existe une proposition pour cette occurrence, puis si sa zone est approuvée. Si elle l’est, inspectez la projection du texte vers les boîtes, l’échelle et les rectangles effectivement appliqués. Agrandir toutes les zones sans diagnostic peut masquer plus de contenu utile sans résoudre l’origine du problème.
Une approbation ne correspond plus au fichier ? Comparez la source, la proposition et leur révision. Ne contournez pas le contrôle d’empreinte pour réutiliser une décision devenue incohérente.
L’extraction est vide, mais la lettre reste lisible ? C’est compatible avec un PDF image. Revenez au contrôle des pixels : vous venez précisément de rencontrer la distinction étudiée dans l’exercice.
Nettoyer seulement les sorties prévues
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Le premier down arrête le projet. Le script de nettoyage s’exécute ensuite dans un conteneur temporaire ; le second down laisse l’environnement arrêté. L’option --outputs-only conserve les sources et configurations, mais retire les artefacts générés concernés. Ne lancez pas cette séquence avant d’avoir lu ou archivé les sorties utiles.
Ce nettoyage n’est pas présenté comme un effacement sécurisé de toutes les copies d’un document. Il ne faut pas le confondre avec une politique de conservation, de suppression des sauvegardes ou de gestion des droits.
Ce qu’il faudrait concevoir avant un usage réel
Ne branchez pas directement cette chaîne sur des PDF réels à diffuser. Les 40 mentions incomplètement masquées sur le test sont une limite mesurée, pas une précaution purement théorique.
Pour une adaptation, commencez par une évaluation distincte, autorisée et annotée, représentative des documents concernés. Définissez les catégories à occulter et les cas à escalader. Gardez les labels hors du service de proposition, versionnez la politique de zones et rendez les décisions révisables. Ces travaux constituent une nouvelle validation ; ils ne prolongent pas automatiquement celle du corpus Solstice.
Une vraie revue doit permettre de chercher aussi les faux négatifs, les informations manquées. Montrer uniquement les zones proposées ne permet pas de vérifier que le reste de la page ne contient rien à masquer. Prévoyez un examen du document, un échantillonnage humain des omissions et des contrôles de rendu indépendants.
La traçabilité doit également rester protégée. L’extrait de propose conserve explicitement "text": text[a:b] : le fichier de propositions peut donc contenir les chaînes que vous cherchez à cacher dans la copie finale. Ne distribuez pas automatiquement tout le dossier de sorties avec le PDF reconstruit. Une copie correctement transformée ne rend pas ses journaux ni ses aperçus intermédiaires partageables.
Enfin, définissez une stratégie d’accessibilité et contrôlez toute représentation supplémentaire du document. L’image seule ne remplace pas un contenu textuel accessible, mais remettre sans contrôle le texte original dans la copie annulerait l’objectif de l’occultation.
L’enseignement à retenir n’est pas « la rastérisation rend un PDF sûr ». C’est plutôt : une transformation doit être examinée à chaque niveau où une information peut subsister, avec des mesures qui rendent aussi les échecs visibles.
Références pour approfondir
Les liens intégrés au fil de l’article renvoient aux documentations officielles : spaCy pour les entités et leurs positions, Python pour les dictionnaires et les empreintes, Pillow pour les modes d’image et les rectangles, Docker pour le contrôle de configuration, et Adobe pour la distinction entre informations visibles et cachées.
Ces compléments expliquent les mécanismes ; ils ne sont pas de nouveaux essais du projet. Pour reproduire r001, conservez les versions, les ressources verrouillées et les commandes de son archive plutôt que de remplacer une dépendance par celle d’une documentation courante.
Téléchargez l'archive complète du cours : ZIP r001.