





State sviluppando un back office che consente di condividere lettere dopo averne nascosto le informazioni sensibili. Nell'anteprima, nomi e indirizzi sono coperti di nero. Il file sembra pronto per l'invio. Ma cosa accade se il destinatario seleziona il testo e lo copia in un editor?
Per uno sviluppatore web, la trappola ricorda un elemento nascosto sullo schermo mentre il suo valore resta nell'HTML. Un PDF non è una pagina web, ma la distinzione è la stessa: non vedere più un'informazione non significa che sia scomparsa dal file. Una barra nera aggiunta a un PDF può lasciare sotto di sé il testo e gli oggetti originali.
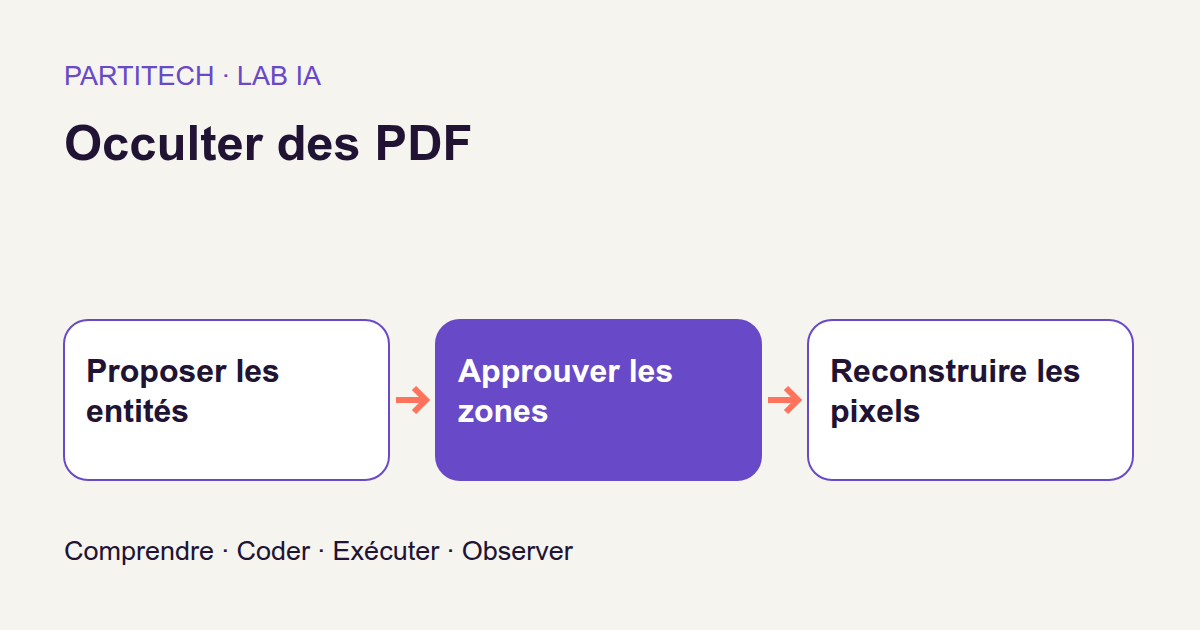
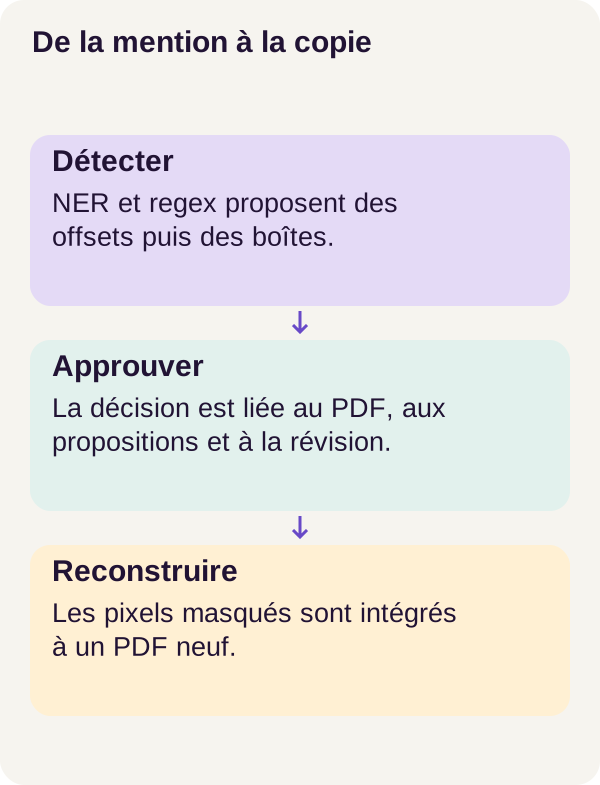
Costruiremo una catena che affronta separatamente questi problemi: proporre zone sensibili, selezionare quelle da approvare, modificare i pixel interessati, quindi creare un nuovo PDF dall'immagine ottenuta. Verificheremo poi cosa è stato davvero nascosto, invece di fidarci del suo aspetto.
Scaricare lo ZIP del tutorial r001
Il nostro filo conduttore è una lettera fittizia «Solstice Support». Contiene un nome, un indirizzo @example.org e un riferimento del ticket. Il programma deve ritrovare le menzioni candidate senza leggere le risposte attese, oscurare solo le zone approvate e non trasferire la struttura del PDF sorgente nella copia ricostruita.
Questo tutorial è una dimostrazione, non un sistema di anonimizzazione pronto all'uso. Non fornisce né un parere legale né una garanzia su documenti reali. Il suo risultato più importante è proprio un fallimento osservabile: nel test, alcune menzioni non saranno oscurate interamente.
Che cosa misura realmente l'esempio
Testo, pixel e file: tre cose diverse
Manipoleremo diverse rappresentazioni della stessa lettera. Il testo estratto consente di cercare un indirizzo o un nome. I pixel determinano l'aspetto della pagina renderizzata. La struttura del PDF contiene gli elementi usati per rappresentare il documento: non è semplicemente una schermata.
Quest'ultima distinzione non riguarda solo il testo visibile. La documentazione Adobe sulle informazioni nascoste nei PDF cita in particolare metadati, commenti e livelli. Non supporremo che questi elementi siano scomparsi perché un'area sembra nera: il progetto ispeziona la copia che produce.
Rasterizzare una pagina significa calcolarne un'immagine composta da pixel. Non significa riconoscerne il testo. L'OCR, invece, cerca di ricostruire caratteri a partire da un'immagine. Qui il rilevamento riceve del testo; la rasterizzazione serve a creare e controllare la copia visiva. Questo percorso non dimostra il riconoscimento di nomi direttamente nelle scansioni.
Cosa porta l'IA, e cosa fanno già le regole
Un'entità denominata è una porzione di testo alla quale attribuiamo un tipo. In questo progetto, i tipi cercati sono persone (PERSON), e-mail (EMAIL) e riferimenti (REFERENCE). La parola menzione indica un'occorrenza nel documento: trovare un nome in un punto non esonera dal cercarne le altre occorrenze.
Il NER, da Named Entity Recognition, è il riconoscimento delle entità denominate. spaCy propone menzioni di persone tramite un modello già addestrato. Due espressioni regolari, o regex, cercano invece i formati di e-mail e riferimenti previsti dal corso.
Perché associare entrambi? Perché un indirizzo con un formato riconoscibile e un nome in una frase non pongono lo stesso problema. Le regex esprimono schemi scritti dallo sviluppatore; il NER usa un modello statistico. Nessuno dei due scopre automaticamente ogni possibile informazione sensibile. La documentazione di spaCy presenta questo funzionamento e ricorda che le sue previsioni possono essere errate.
Il programma ne forma poi l'unione: riunisce i candidati dei due meccanismi. Non richiede che entrambi concordino per proporre una zona. Nel codice vedremo cosa viene effettivamente unito e cosa resta distinto.
Il percorso usa spaCy 3.7.2 con en_core_web_sm 3.7.1, caricato localmente. Non riaddestra questo modello sulle lettere: facciamo inferenza, cioè usiamo un modello esistente per ottenere previsioni. La scheda di questa versione precisa di en_core_web_sm descrive una pipeline inglese ottimizzata per la CPU. Il fatto che questo tutorial sia scritto in francese non trasforma quindi il modello in un rilevatore francese.
Tenere le risposte attese fuori dal rilevatore
Il set contiene 120 lettere sintetiche: 30 per lo sviluppo e 90 per il test. La suddivisione di test comprende 360 menzioni attese.
Queste menzioni sono descritte da annotazioni di riferimento, spesso chiamate gold. Svolgono il ruolo della soluzione di un esercizio. Servono a misurare ciò che il programma ha trovato, non a indicargli dove cercare.
Il contenitore di inferenza non monta la loro directory. Per uno sviluppatore abituato a Docker, questo confine è concreto: al processo non viene semplicemente chiesto di non aprire le risposte, non deve avere a disposizione la cartella che le contiene. La separazione permette di valutare una proposta, anziché un programma che ricopia di nascosto la propria soluzione.
Le 30 lettere di sviluppo servono a preparare il percorso; le 90 di test servono a misurare il risultato finale. Questi numeri non descrivono un nuovo addestramento di spaCy. Non rappresentano nemmeno la varietà di nomi, lingue e impaginazioni che conterrebbe una raccolta reale.
Porre le domande giuste prima di calcolare un punteggio
Per il rilevamento contiamo i veri positivi, cioè le menzioni proposte correttamente, e tutte le previsioni emesse. La precisione risponde a «tra le mie proposte, quante sono corrette?»; il richiamo risponde a «tra le menzioni attese, quante ne ho ritrovate?».
I calcoli sono precisione = veri positivi / previsioni e richiamo = veri positivi / menzioni gold. Come esempio didattico, trovare correttamente 8 menzioni su 10 attese, con 2 proposte inutili in più, dà una precisione di 8/10 e un richiamo di 8/10. I valori sono uguali, ma le domande restano diverse.
Il mascheramento aggiunge un'altra misura: copertura = pixel gold coperti / pixel gold. Una menzione è completamente nascosta solo se tutti i suoi pixel di riferimento sono coperti. Un buon rilevamento non garantisce che il rettangolo applicato sia posizionato correttamente; una buona copertura media non garantisce che ogni menzione sia completa.
Seguiremo quindi il rilevamento, i pixel, le menzioni complete e la struttura del file. Zero caratteri estraibili non è un punteggio di scomparsa delle informazioni visibili. L'esercizio finale lo mostrerà in modo molto diretto.
Preparare un'esecuzione CPU riproducibile
Dovete saper leggere Python, usare un terminale e avviare Docker Compose. Spiegheremo coordinate e operazioni sulle immagini seguendo il codice. Non serve esperienza precedente di OCR o calcolo GPU.
Il percorso r001 è stato validato su CPU: non è necessaria alcuna GPU NVIDIA. Prevedete circa 16 GiB di RAM e 15 GiB di spazio libero su disco per immagini, contenitori e output. Sono indicazioni di preparazione del corso, non misure garantite per tutte le macchine.
Estraete lo ZIP e posizionate il terminale nella sua radice. Tutti i comandi dell'articolo vengono eseguiti dalla stessa directory. Manteniamo configurazioni e ordine per ritrovare le condizioni di riferimento.
Verificare l'ambiente e costruire i servizi
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
Il preflight è il controllo preliminare: verifica in particolare Docker, memoria e spazio su disco. setup.sh prepara il percorso. Compose verifica poi la sua configurazione, quindi costruisce i servizi acquisition, tutorial e inference.
Non sorprendetevi se docker compose config --quiet non produce alcun testo quando riesce: l'opzione --quiet convalida senza mostrare la configurazione. Ciò che conta è l'assenza di errori e un codice di ritorno nullo.
Controllare le risorse, poi i test
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
In questa revisione, l'acquisizione controlla le versioni e le impronte delle risorse bloccate; il corso annuncia che nessuna risorsa viene scaricata durante l'esecuzione del tutorial. Non è un invito a lasciare che l'inferenza recuperi automaticamente un altro modello. La costruzione delle immagini Docker resta una fase distinta da questa esecuzione.
check_environment.py conferma la presenza delle risorse. I test verificano poi le funzioni del corso prima della produzione dei PDF. Un test riuscito significa che il comportamento testato è rispettato; non significa che tutte le menzioni di una lettera saranno riconosciute.
Se un controllo di memoria o di disco fallisce, liberate le risorse necessarie e ripartite dal preflight. Eliminare il controllo non riduce le esigenze del programma.
Preparare le lettere e proporre le zone
Creare gli input dell'esperimento
docker compose run --rm tutorial python -m pdfredactai.cli prepare --config configs/minimum.yaml
prepare crea le lettere sintetiche, il loro rendering e le annotazioni di misura. Queste annotazioni restano fuori dal volume usato dall'inferenza. La protezione del progetto rende esplicito questo vincolo: il rilevatore non deve vedere data/generated/labels.
A questo punto abbiamo i documenti da trattare e, separatamente, la loro soluzione. Possiamo ora chiedere al programma di proporre zone a partire dai soli input osservabili.
Collegare una porzione di testo a una posizione sulla pagina
docker compose run --rm inference python -m pdfredactai.cli propose --config configs/minimum.yaml
propose carica il modello locale e scrive i candidati in outputs/proposals.json. Una proposta deve conservare più di una parola: servono il suo tipo, la sua posizione nel testo e i suoi rettangoli nel documento.
Queste posizioni testuali sono offset di caratteri. Indicano dove inizia e finisce una porzione di stringa. Nella documentazione di Span, spaCy li espone con start_char e end_char. Non confondeteli con le posizioni dei token, le unità di testo segmentate dalla sua pipeline.
Prendiamo una stringa inventata solo per capire l'indicizzazione: Contact: Alice Rowan.. La porzione Alice Rowan inizia all'indice 9 e termina appena prima dell'indice 20. L'espressione Python text[9:20] contiene quindi gli 11 caratteri del nome. Il limite finale è escluso. Questo esempio non è né un output del modello né una lettera aggiuntiva del corpus.
Questi indici non sono coordinate dell'immagine. Il carattere numero 9 non si trova necessariamente al pixel orizzontale 9. Occorre ritrovare i rettangoli associati a questa porzione nel documento, poi convertirli nel riferimento del rendering. È il collegamento che il progetto conserva con span_boxes, poi con il trattamento geometrico della maschera.
Leggere l'unione NER + regex
Ecco il nucleo esatto di propose:
regex = regex_candidates(text)
ner = [
    {
        "start": e.start_char,
        "end": e.end_char,
        "kind": e.label_,
        "source": "ner",
    }
    for e in result.ents
    if e.label_ in config["entity_labels"]
]
candidates = {}
for candidate in regex + ner:
    key = (candidate["start"], candidate["end"])
    row = candidates.setdefault(key, {**candidate, "sources": []})
    row["sources"].append(candidate["source"])
union = []
for index, ((a, b), candidate) in enumerate(sorted(candidates.items())):
    union.append(
        {
            **candidate,
            "id": f"z{index:03d}",
            "text": text[a:b],
            "boxes": span_boxes(document, a, b),
        }
    )
La prima parte crea i candidati NER. Per ogni entità di result.ents, il codice conserva i limiti di caratteri, il tipo label_ e l'origine ner. Il filtro config["entity_labels"] seleziona i tipi autorizzati dalla configurazione. I candidati regex sono stati calcolati separatamente da regex_candidates(text).
La seconda parte riunisce le occorrenze nella stessa posizione. regex + ner concatena le due liste. La chiave del dizionario è la coppia (start, end), non il testo riconosciuto. Due occorrenze identiche in punti diversi non vengono quindi confuse solo perché portano lo stesso nome.
setdefault inserisce una riga se la chiave non esiste; altrimenti restituisce quella già presente. È il comportamento descritto nella documentazione Python dei dizionari. La notazione **candidate copia i campi del candidato, ai quali il programma aggiunge una lista sources.
Se regex e NER propongono esattamente gli stessi limiti, viene conservata una sola riga e vengono registrate entrambe le origini. Non sono due voti indipendenti e ciò non fornisce una probabilità di correttezza. L'estratto conserva le provenienze; non calcola un punteggio di confidenza combinato.
C'è anche un limite da leggere in queste poche righe. Se due candidati condividono gli stessi limiti ma non lo stesso kind, vengono conservati i campi del primo: setdefault non li arbitra. Poiché la lista regex viene prima della lista NER, il suo candidato è incontrato per primo. Al contrario, due candidati che si sovrappongono senza avere esattamente gli stessi limiti restano distinti. Questa unione non è una fusione generale dei rettangoli.
L'ultima parte prepara l'output. Le coppie sono ordinate per inizio, poi per fine. enumerate assegna loro identificativi come z000, z001 e z002. text[a:b] recupera il testo di ogni occorrenza e span_boxes(document, a, b) ritrova le caselle corrispondenti.
Un identificativo come z003 è dunque una posizione nella lista delle proposte di questa versione, non un'identità universale del nome rilevato. Se le proposte cambiano, questo numero può designare un'altra zona. È una buona ragione per collegare l'approvazione alla versione esatta del documento e della proposta.
Un'approvazione tracciabile, ma non ancora umana
docker compose run --rm inference python -m pdfredactai.cli review --config configs/minimum.yaml
La parola review può far pensare a un operatore che ha letto la lettera. Non è ciò che questo comando dimostra. Nel POC, o prova di concetto, la revisione applica alle proposte del corpus sintetico la politica configurata.
La decisione è collegata al SHA-256 del PDF, al digest della proposta e alla revisione. Un digest è un'impronta calcolata a partire da un contenuto. La documentazione Python di hashlib descrive in particolare SHA-256. Qui queste impronte servono a verificare che si lavori sui file a cui la decisione si riferisce.
Pensate a una convalida di modulo che deve restare collegata alla versione corretta di un record. Un'approvazione della lettera A non deve essere riutilizzata silenziosamente dopo la sua sostituzione con una lettera B. Tuttavia, l'hash non prova né che una persona abbia letto la lettera né che abbia scelto le zone giuste.
Un'interfaccia di revisione, l'identità dell'operatore, i suoi diritti e una politica di escalation per i casi incerti restano da progettare per un prodotto. Per ora, ispezionate proposte e decisioni come output dell'esperimento, non come una convalida umana acquisita.
Mascherare i pixel e ricostruire la copia
Sostituire i pixel anziché aggiungere un oggetto sopra
Ora abbiamo zone approvate. Il programma non le trasforma in rettangoli aggiunti al PDF iniziale. Lavora su una copia dell'immagine della pagina, sostituisce con nero i pixel interessati, quindi il modulo rebuild crea un nuovo PDF a partire da questa immagine modificata.
La funzione seguente produce tre oggetti: l'immagine annerita, una maschera di controllo e l'elenco dei rettangoli applicati. Non crea essa stessa il PDF; questa fase viene dopo.
def mask_pixels(image, boxes, scale, margin):
    image = image.convert("RGB").copy()
    mask = Image.new("L", image.size, 0)
    paint = ImageDraw.Draw(image)
    mark = ImageDraw.Draw(mask)
    rectangles = []
    for box in boxes:
        x0, y0, x1, y1 = pixel_box(box, scale, image.size, margin)
        rectangle = (x0, y0, x1 - 1, y1 - 1)
        paint.rectangle(rectangle, fill=(0, 0, 0))
        mark.rectangle(rectangle, fill=255)
        rectangles.append([x0, y0, x1, y1])
    return image, mask, rectangles
Perché due immagini?
image.convert("RGB").copy() prepara una copia a tre canali: rosso, verde e blu. Il nero è rappresentato da (0, 0, 0). Il secondo oggetto, creato con Image.new("L", image.size, 0), contiene un solo canale di livelli di grigio, inizialmente riempito di zeri. Queste modalità sono descritte nei concetti di Pillow.
Le due immagini non hanno lo stesso ruolo. L'immagine RGB è il documento visivo modificato. La maschera indica dove il programma è intervenuto. In questa maschera, il valore 255, bianco, segna le zone trattate; lo zero, nero, significa che non è stato applicato alcun rettangolo. Il bianco della maschera non significa quindi che la pagina pubblicata sarà bianca in quel punto: lì è annerita.
paint disegna nella copia del documento; mark disegna nella maschera. Ogni rettangolo riceve la stessa posizione in entrambe. Questa corrispondenza permette poi di confrontare le zone realmente trattate con le zone di riferimento.
La copia lascia intatta l'immagine in ingresso. È utile per verificare la trasformazione, ma ricorda anche che creare una copia oscurata non elimina l'originale. La funzione non cancella né il PDF sorgente né gli altri file intermedi.
Passare dalle coordinate del documento a quelle del rendering
pixel_box riceve la casella sorgente, la scala scale, la dimensione dell'immagine e il margine margin. Il calcolo degli arrotondamenti e dei limiti della pagina è in questa funzione del progetto, non nell'estratto precedente. Occorre rispettarne le convenzioni anziché indovinare quelle di un'altra libreria.
Per comprendere solo la scala, prendiamo un esempio geometrico indipendente dal corpus. Con origini già allineate e senza margine, una casella (10, 20, 30, 25) ingrandita di un fattore due diventa (20, 40, 60, 50). Le dimensioni passano da 20 × 5 a 40 × 10; la sua area viene moltiplicata per quattro. Questo esempio non descrive gli arrotondamenti o il margine configurati in r001.
Un margine può coprire il bordo di un carattere che sporge leggermente dalla casella selezionata, ma annerisce anche una porzione maggiore dell'area vicina. Non sostituisce la ricerca di una menzione dimenticata altrove nella pagina. Bisognerà leggere la copertura delle zone sensibili e il mascheramento delle zone non sensibili.
A cosa servono i due «meno uno»?
La riga rectangle = (x0, y0, x1 - 1, y1 - 1) merita una pausa. La funzione Pillow rectangle include entrambi i limiti. Il codice traduce quindi una casella il cui limite destro e quello inferiore sono esclusi in questo disegno inclusivo.
Supponiamo che pixel_box restituisca (10, 20, 30, 25). Vogliamo coprire le colonne da 10 a 29 e le righe da 20 a 24: 20 × 5 = 100 pixel. Il rettangolo passato a Pillow termina quindi in (29, 24).
Senza sottrarre uno, il disegno arriverebbe alla colonna 30 e alla riga 25, cioè 21 × 6 = 126 pixel. Il rettangolo apparirebbe quasi identico sullo schermo, ma la sua superficie e le misure sarebbero diverse. Questo piccolo esempio spiega una convenzione di coordinate; non è un nuovo risultato del corpus.
Infine, rectangles.append([x0, y0, x1, y1]) conserva i limiti originali per la traccia. L'elenco memorizzato e il rettangolo disegnato usano così due notazioni coerenti della stessa zona.
Eseguire la trasformazione e la valutazione
docker compose run --rm inference python -m pdfredactai.cli redact --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfredactai.cli evaluate --config configs/minimum.yaml
redact verifica l'approvazione e l'impronta SHA della sorgente prima e dopo la ricostruzione. Anch'esso rifiuta la presenza delle annotazioni gold. evaluate può poi accedere alla soluzione per misurare ciò che è stato coperto.
Ogni riga di outputs/transformation.json riporta lo stato FIXTURE_COPY_NOT_A_SAFETY_CERTIFICATE. Una fixture è un caso di test noto, preparato per verificare un comportamento. Potete leggere questo stato come «copia del caso di test, non certificato di sicurezza».
La valutazione esamina i pixel, l'assenza del marcatore sintetico cercato e la struttura della copia: una pagina, un'immagine /Im0, nessun testo né oggetti sorgente attesi. /Im0 è il nome della risorsa immagine in questo file. La sua presenza non significa che l'immagine non contenga più informazioni sensibili: sono proprio i pixel che restano da controllare.
Queste verifiche rispondono dunque a due domande distinte: abbiamo ricostruito il tipo di file previsto e abbiamo davvero mascherato tutte le zone attese? La prima può riuscire mentre la seconda fallisce.
Leggere i risultati prima di generalizzarli
La figura separa il rilevamento delle menzioni dall'applicazione del mascheramento. Manteniamo questa separazione quando leggiamo i numeri del percorso di riferimento.
Le regex sono precise, ma non cercano tutto
Sulle 360 menzioni di test, le sole regex trovano 180 menzioni corrette: le 90 e-mail e i 90 riferimenti. Non trovano nessuna delle 180 menzioni di persone. La loro precisione vale quindi 1,00, ma il richiamo soltanto 0,50.
Una precisione perfetta non significa che il compito sia terminato. Qui significa che le proposte emesse sono corrette; manca ancora metà delle menzioni attese.
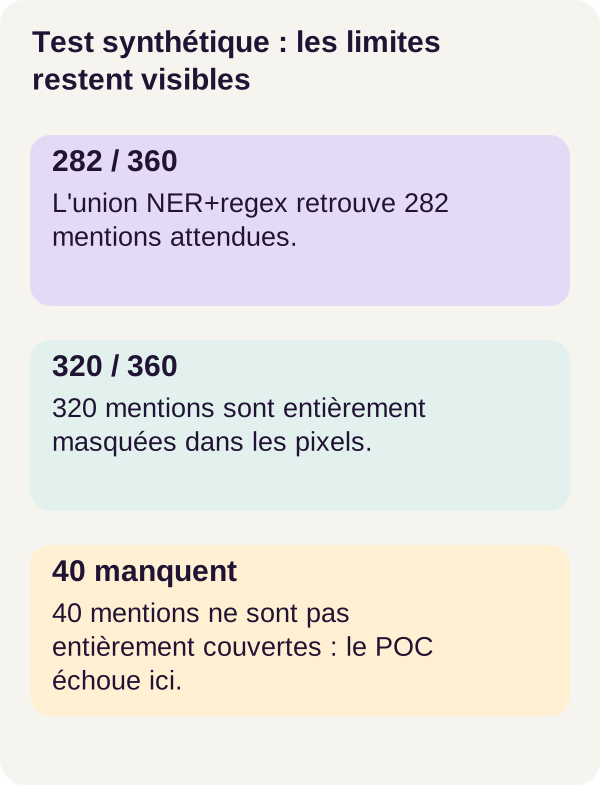
L'unione NER + regex ritrova 282 veri positivi su 411 proposte, cioè una precisione di 0,686 e un richiamo di 0,783. Ecco i conteggi che permettono di comprendere la differenza:
| Metodo | Menzioni corrette | Proposte | Precisione | Richiamo |
|---|---|---|---|---|
| Solo regex | 180 | 180 | 1,00 | 0,50 |
| Unione NER + regex | 282 | 411 | 0,686 | 0,783 |
L'aggiunta del NER ritrova dunque più menzioni, ma aggiunge anche zone non attese. Per differenza, l'unione conta 129 proposte non riconosciute come corrette (411 - 282) e 78 menzioni attese non ritrovate come veri positivi (360 - 282). Questi due numeri sono calcolati dai conteggi pubblicati, non derivano da una nuova prova.
La categoria PERSON spiega la parte principale di questa difficoltà: conta 102 veri positivi per 231 proposte e 180 menzioni gold. Abbiamo quindi un rilevatore che aiuta a trovare persone, non un rilevatore che le ritrova tutte né che propone sempre le zone corrette.
Una copertura dei pixel non è una proporzione di menzioni complete
La trasformazione copre 1 717 175 dei 1 881 925 pixel gold, cioè 0,91246, circa 91,25 %. Maschera completamente 320 menzioni su 360.
Restano quindi 40 menzioni mascherate in modo incompleto. Ciò non significa che le 40 siano integralmente visibili, né che siano necessariamente leggibili: il controllo dice che la loro copertura non è completa. Non trasformiamo questa constatazione in successo perché il rettangolo «sembra abbastanza grande».
Perché le percentuali di pixel e menzioni possono differire? In un esempio fittizio, supponiamo due menzioni le cui zone di riferimento occupano 100 e 10 pixel. Se la prima è interamente coperta e la seconda per nulla, la copertura globale vale 100/110, cioè circa 90,91 %, ma solo una menzione su due è completamente nascosta. Le grandi superfici pesano di più nel primo calcolo; ogni menzione pesa un'unità nel secondo.
Lo stesso ragionamento spiega perché non dobbiamo confondere 282 rilevamenti corretti e 320 menzioni completamente mascherate. Le metriche non contano gli stessi oggetti. Per esempio, una zona troppo ampia può coprire pixel sensibili senza essere riconosciuta come una buona proposta di rilevamento; più maschere possono anche sovrapporsi.
Sono spiegazioni possibili del meccanismo, non una diagnosi delle menzioni di questo test. I totali pubblicati non bastano a spiegare ogni differenza: bisognerebbe esaminare proposte, rettangoli e corrispondenze della valutazione, menzione per menzione. Conserviamo i due risultati senza sostituire l'uno con l'altro.
Un marcatore assente non prova che tutto sia scomparso
Nei 12 documenti che contenevano il marcatore sintetico, il rapporto conta zero stringhe marcatore rimanenti. Questo controllo mirato è utile: il segnale cercato non è stato ritrovato da questo test. Ma non compensa i 40 fallimenti di copertura.
A livello di documenti, gli output indicano 55 stati PASS_FIXTURE e 35 fallimenti di contenuto fixture, sulle 90 lettere di test. Una lettera può quindi fallire anche se diverse sue zone sono state trattate correttamente.
Conservate i nomi degli stati nei vostri output. PASS_FIXTURE significa che il caso soddisfa i controlli di questo esperimento; non trasforma lo stato generale FIXTURE_COPY_NOT_A_SAFETY_CERTIFICATE nell'autorizzazione a diffondere un documento reale.
Il percorso riporta anche un tempo medio di circa 0,096 secondi per documento e una dimensione media di 54 116 byte per PDF. Questi valori descrivono questo corpus e questa macchina CPU. Non misurano il tempo di un operatore umano e non promettono la stessa prestazione su un'altra raccolta.
Il costo dell'oscuramento eccessivo
La frazione di pixel non sensibili mascherati è 0,00871, ossia circa 0,87 % della zona non sensibile. È il costo visivo del margine e dei falsi positivi: una parte del contenuto che si voleva conservare viene annerita.
Questo tasso non è la proporzione di proposte false. Il suo denominatore è una superficie di pixel, non un numero di entità. Un unico grande rettangolo inutile può pesare molto in questa misura; diverse piccole proposte possono pesare poco.
Infine, ricostruire un PDF a partire dai pixel comporta un costo funzionale: testo selezionabile, collegamenti attivi, moduli e firme digitali originali non vengono trasferiti come tali in questa copia. Vedere ancora la forma di un collegamento o il disegno di una firma non significa che la loro funzione originaria esista ancora. L'accessibilità richiede una progettazione separata, oltre questa dimostrazione.
Sintesi prima dell'esercizio
Abbiamo collegato quattro fasi che non si sostituiscono l'una all'altra: rilevare una menzione, approvare una zona, modificarne i pixel e verificare la copia prodotta.
Il modello e le regex possono non rilevare una menzione. Una politica può approvare una zona insufficiente. Una conversione di coordinate può lasciare scoperto un bordo. Infine, una struttura PDF semplificata può contenere un'immagine nella quale l'informazione sensibile resta visibile.
Il percorso consente di localizzare queste questioni anziché ridurle a «il PDF è annerito». L'esercizio isolerà ora due ipotesi errate: che una copertura grafica sia sufficiente e che l'assenza di testo estraibile sia sufficiente.
Esercizio: prevedere prima di verificare
Prima di eseguire il comando, formulate la risposta a questa prima ipotesi: «Una copertura nera aggiunta al PDF è sufficiente, perché il lettore vede una zona nera.» Secondo voi, cosa restituirà l'estrazione del testo?
Poi invertite il ragionamento. Se trasformiamo la pagina in immagine e creiamo un nuovo PDF senza mascherare i pixel, l'estrattore troverà ancora del testo? E cosa vedrà una persona aprendo il file?
Annotate le vostre previsioni, quindi avviate lo scenario fornito:
docker compose run --rm tutorial python -m pdfredactai.cli exercise --config configs/exercise.yaml
Confrontare la previsione con i due controesempi
Il comando crea due casi fittizi. I risultati seguenti sono quelli riportati per il percorso di riferimento:
| Caso | Estrazione del testo | Cosa mostra l'esperimento |
|---|---|---|
| Copertura nera aggiunta al PDF | cover_text_characters: 361 |
Il testo sorgente resta estraibile nonostante la copertura visibile. |
| Ricostruzione raster senza maschera | Zero caratteri estraibili | I pixel sensibili originali sono conservati esattamente. |
Nel primo caso, la visualizzazione non basta: il livello nero non ha eliminato il testo sottostante. Nel secondo, l'estrazione non basta: restituisce zero perché non ritrova testo nativo, non perché le informazioni siano scomparse dall'immagine.
I due test negativi confutano due garanzie immaginarie. Non si correggono a vicenda. Occorre verificare le zone pixel per pixel e la struttura del nuovo PDF, quindi trattare ogni omissione di rilevamento come un fallimento da rivedere.
Tornate poi alle 40 menzioni mascherate in modo incompleto del percorso principale. Il secondo controesempio spiega perché un'estrazione vuota non può farle passare al verde. È questa associazione tra osservazione e misura a rendere utile il tutorial.
Generare le figure, controllare le tappe e pulire
Produrre gli ultimi output prima di eliminarli
Le figure devono essere costruite a partire dalle misure esistenti. Eseguite questi due comandi dalla radice del progetto:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
plot.py usa la valutazione già prodotta. check_checkpoints.py controlla le tappe e segnala un'incoerenza tra il corso e il codice. La presenza della parola checkpoint nel suo nome non significa che abbiamo appena addestrato spaCy: questo percorso usa sempre il modello locale previsto.
Prima della pulizia, conservate i risultati che desiderate studiare. Per seguire un caso, accostate outputs/proposals.json, la decisione di revisione, i rettangoli applicati, l'immagine mascherata e outputs/transformation.json. Una media globale non spiega perché una lettera precisa fallisca.
Risolvere i problemi nel punto giusto
Manca una risorsa o la sua impronta differisce? Riprendete l'acquisizione e il controllo dell'ambiente, con i file bloccati del corso. Sostituire un altro modello cambierebbe l'esperimento prima ancora della prima proposta.
Un nome resta visibile? Guardate prima se esiste una proposta per questa occorrenza, poi se la sua zona è approvata. Se lo è, ispezionate la proiezione dal testo alle caselle, la scala e i rettangoli effettivamente applicati. Ingrandire tutte le zone senza una diagnosi può mascherare più contenuto utile senza risolvere l'origine del problema.
Un'approvazione non corrisponde più al file? Confrontate la sorgente, la proposta e la loro revisione. Non aggirate il controllo dell'impronta per riutilizzare una decisione diventata incoerente.
L'estrazione è vuota, ma la lettera resta leggibile? È compatibile con un PDF immagine. Tornate al controllo dei pixel: avete appena incontrato la distinzione studiata nell'esercizio.
Pulire soltanto gli output previsti
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Il primo down arresta il progetto. Lo script di pulizia viene poi eseguito in un contenitore temporaneo; il secondo down lascia l'ambiente arrestato. L'opzione --outputs-only conserva sorgenti e configurazioni, ma rimuove gli artefatti generati interessati. Non avviate questa sequenza prima di aver letto o archiviato gli output utili.
Questa pulizia non è presentata come una cancellazione sicura di tutte le copie di un documento. Non va confusa con una politica di conservazione, eliminazione dei backup o gestione dei diritti.
Cosa bisognerebbe progettare prima di un uso reale
Non collegate direttamente questa catena a PDF reali da diffondere. Le 40 menzioni mascherate in modo incompleto nel test sono un limite misurato, non una precauzione puramente teorica.
Per un adattamento, iniziate da una valutazione distinta, autorizzata e annotata, rappresentativa dei documenti interessati. Definite le categorie da oscurare e i casi da escalare. Tenete le etichette fuori dal servizio di proposta, versionate la politica delle zone e rendete le decisioni rivedibili. Questi lavori costituiscono una nuova convalida; non estendono automaticamente quella del corpus Solstice.
Una vera revisione deve consentire di cercare anche i falsi negativi, le informazioni mancate. Mostrare soltanto le zone proposte non permette di verificare che il resto della pagina non contenga nulla da mascherare. Prevedete un esame del documento, un campionamento umano delle omissioni e controlli di rendering indipendenti.
Anche la tracciabilità deve restare protetta. L'estratto di propose conserva esplicitamente "text": text[a:b]: il file delle proposte può quindi contenere le stringhe che cercate di nascondere nella copia finale. Non distribuite automaticamente l'intera cartella di output con il PDF ricostruito. Una copia correttamente trasformata non rende condivisibili i suoi log né le anteprime intermedie.
Infine, definite una strategia di accessibilità e controllate ogni rappresentazione aggiuntiva del documento. La sola immagine non sostituisce un contenuto testuale accessibile, ma reinserire senza controllo il testo originale nella copia annullerebbe l'obiettivo dell'occultamento.
L'insegnamento da ricordare non è «la rasterizzazione rende sicuro un PDF». È piuttosto: una trasformazione deve essere esaminata a ogni livello in cui un'informazione può persistere, con misure che rendano visibili anche i fallimenti.
Riferimenti per approfondire
I collegamenti integrati nel corso dell'articolo rimandano alla documentazione ufficiale: spaCy per le entità e le loro posizioni, Python per dizionari e impronte, Pillow per modalità immagine e rettangoli, Docker per il controllo della configurazione e Adobe per la distinzione tra informazioni visibili e nascoste.
Questi approfondimenti spiegano i meccanismi; non sono nuove prove del progetto. Per riprodurre r001, conservate versioni, risorse bloccate e comandi della sua archivio invece di sostituire una dipendenza con quella di una documentazione corrente.
Scaricate l'archivio completo del corso: ZIP r001.