





Está desarrollando un back office que permite compartir cartas después de ocultar su información sensible. En la vista previa, los nombres y las direcciones aparecen cubiertos de negro. El archivo parece listo para enviarse. Pero ¿qué sucede si la persona destinataria selecciona el texto y lo copia en un editor?
Para un desarrollador web, la trampa recuerda a un elemento oculto en pantalla cuyo valor sigue en el HTML. Un PDF no es una página web, pero la distinción es la misma: dejar de ver una información no significa que haya desaparecido del archivo. Una barra negra añadida a un PDF puede dejar debajo el texto y los objetos originales.
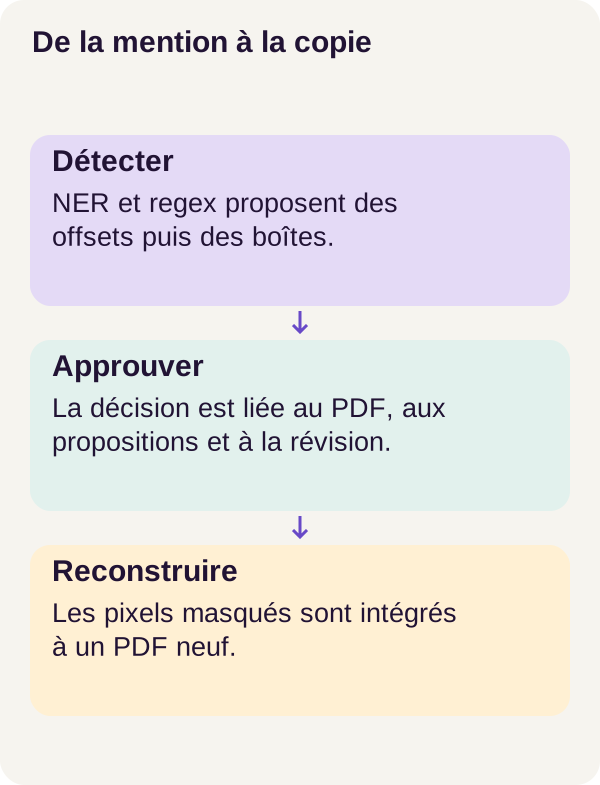
Vamos a construir una cadena que trate estos problemas por separado: proponer zonas sensibles, seleccionar las que se aprobarán, modificar los píxeles implicados y, después, fabricar un PDF nuevo a partir de la imagen obtenida. A continuación comprobaremos qué se ha ocultado realmente, en vez de confiar en su apariencia.
Descargar el ZIP del tutorial r001
Nuestro hilo conductor es una carta ficticia de «Solstice Support». Contiene un nombre, una dirección @example.org y una referencia de ticket. El programa debe encontrar las menciones candidatas sin leer las respuestas esperadas, ocultar solo las zonas aprobadas y no trasladar la estructura del PDF de origen a la copia reconstruida.
Este tutorial es una demostración, no un sistema de anonimización listo para usar. No proporciona asesoramiento jurídico ni garantías sobre documentos reales. Su resultado más importante es precisamente un fallo observable: en la prueba, algunas menciones no quedarán completamente ocultas.
Lo que mide realmente el ejemplo
Texto, píxeles y archivo: tres cosas diferentes
Vamos a manipular varias representaciones de la misma carta. El texto extraído permite buscar una dirección o un nombre. Los píxeles dan la apariencia de la página renderizada. La estructura del PDF contiene los elementos usados para representar el documento: no es simplemente una captura de pantalla.
Esta última distinción no se refiere únicamente al texto visible. La documentación de Adobe sobre información oculta en PDF menciona, entre otros elementos, los metadatos, los comentarios y las capas. No supondremos que han desaparecido porque una zona parezca negra: el proyecto inspecciona la copia que produce.
Rasterizar una página es calcular una imagen compuesta por píxeles. Eso no significa reconocer su texto. El OCR, por el contrario, intenta recuperar caracteres a partir de una imagen. Aquí, la detección recibe texto; la rasterización sirve para fabricar y controlar la copia visual. Este recorrido no demuestra un reconocimiento de nombres directamente en escaneos.
Lo que aporta la IA y lo que ya hacen las reglas
Una entidad nombrada es una porción de texto a la que atribuimos un tipo. En este proyecto, los tipos buscados son personas (PERSON), correos electrónicos (EMAIL) y referencias (REFERENCE). La palabra mención designa una ocurrencia en el documento: encontrar un nombre en un lugar no exime de buscar sus demás ocurrencias.
El NER, por Named Entity Recognition, es el reconocimiento de entidades nombradas. spaCy propone menciones de personas a partir de un modelo ya entrenado. Dos expresiones regulares, o regex, buscan por su parte los formatos de correos y referencias previstos en el curso.
¿Por qué asociar ambos? Porque una dirección con un formato reconocible y un nombre situado en una frase no plantean el mismo problema. Las regex expresan patrones escritos por el desarrollador; el NER usa un modelo estadístico. Ninguno descubre automáticamente toda posible información sensible. La documentación de spaCy presenta este funcionamiento y recuerda que sus predicciones pueden ser erróneas.
El programa forma después su unión: reúne los candidatos de ambos mecanismos. No exige que los dos coincidan para proponer una zona. Veremos en el código qué se fusiona realmente y qué permanece separado.
El recorrido utiliza spaCy 3.7.2 con en_core_web_sm 3.7.1, cargado localmente. No vuelve a entrenar este modelo con las cartas: realizamos inferencia, es decir, usamos el modelo existente para obtener predicciones. La ficha de esta versión concreta de en_core_web_sm describe un pipeline inglés optimizado para CPU. Que este tutorial esté redactado en francés no convierte por ello el modelo en un detector de francés.
Mantener las respuestas esperadas fuera del detector
El conjunto contiene 120 cartas sintéticas: 30 para desarrollo y 90 para prueba. La partición de prueba cuenta con 360 menciones esperadas.
Estas menciones se describen mediante anotaciones de referencia, a menudo llamadas gold. Cumplen el papel de la solución de un ejercicio. Sirven para medir lo que ha encontrado el programa, no para indicarle dónde buscar.
El contenedor de inferencia no monta su directorio. Para quien desarrolla con Docker, esta frontera es concreta: el proceso no recibe simplemente la instrucción de no abrir las respuestas, sino que no debe disponer de la carpeta que las contiene. La separación permite evaluar una propuesta, en vez de un programa que copia discretamente su solución.
Las 30 cartas de desarrollo sirven para preparar el recorrido; las 90 de prueba sirven para medir el resultado final. Estas cifras no describen un nuevo entrenamiento de spaCy. Tampoco representan la diversidad de nombres, idiomas y maquetaciones que contendría una colección real.
Plantear las preguntas correctas antes de calcular una puntuación
Para la detección contamos los verdaderos positivos, es decir, las menciones propuestas correctamente, y todas las predicciones emitidas. La precisión responde a «entre mis propuestas, ¿cuántas son correctas?»; la recuperación responde a «entre las menciones esperadas, ¿cuántas he encontrado?».
Los cálculos son precisión = verdaderos positivos / predicciones y recuperación = verdaderos positivos / menciones gold. Como ejemplo pedagógico, encontrar correctamente 8 menciones entre 10 esperadas, con 2 propuestas inútiles adicionales, da una precisión de 8/10 y una recuperación de 8/10. Los valores son iguales, pero las preguntas siguen siendo distintas.
La ocultación añade otra medida: cobertura = píxeles gold cubiertos / píxeles gold. Una mención solo queda completamente ocultada si se cubren todos sus píxeles de referencia. Una buena detección no garantiza que el rectángulo aplicado esté bien posicionado; una buena cobertura media no garantiza que cada mención esté completa.
Por tanto, seguiremos la detección, los píxeles, las menciones completas y la estructura del archivo. Cero caracteres extraíbles no es una puntuación de desaparición de la información visible. El ejercicio final permitirá comprobarlo de forma muy directa.
Preparar una ejecución reproducible en CPU
Debe saber leer Python, usar una terminal y ejecutar Docker Compose. Explicaremos las coordenadas y las operaciones sobre imágenes a lo largo del código. No es necesaria experiencia previa con OCR ni con cálculo GPU.
El recorrido r001 se validó en CPU: no se requiere ninguna GPU NVIDIA. Prevea aproximadamente 16 GiB de RAM y 15 GiB de espacio libre en disco para las imágenes, los contenedores y las salidas. Son indicaciones de preparación del curso, no medidas garantizadas para todas las máquinas.
Descomprima el ZIP y sitúe la terminal en su raíz. Todos los comandos del artículo se ejecutan desde ese mismo directorio. Conservamos sus configuraciones y su orden para recuperar las condiciones de referencia.
Comprobar el entorno y construir los servicios
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
El preflight es la comprobación previa: verifica, entre otros elementos, Docker, la memoria y el espacio en disco. setup.sh prepara el recorrido. A continuación Compose comprueba su configuración y construye los servicios acquisition, tutorial e inference.
No se sorprenda si docker compose config --quiet no muestra ningún texto cuando tiene éxito: la opción --quiet valida sin mostrar la configuración. Lo importante es que no haya error y el código de retorno sea cero.
Controlar los recursos y después las pruebas
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
En esta revisión, la adquisición controla las versiones y las huellas de los recursos bloqueados; el curso indica que no se descarga ningún recurso durante la ejecución del tutorial. No es una invitación a dejar que la inferencia recupere automáticamente otro modelo. La construcción de las imágenes Docker sigue siendo una etapa distinta de esta ejecución.
check_environment.py confirma la presencia de los recursos. Las pruebas comprueban después las funciones del curso antes de producir los PDF. Una prueba correcta significa que se respeta el comportamiento probado; no significa que se reconocerán todas las menciones de una carta.
Si falla una comprobación de memoria o de disco, libere los recursos necesarios y vuelva al preflight. Eliminar el control no reduce las necesidades del programa.
Preparar las cartas y proponer zonas
Crear las entradas del experimento
docker compose run --rm tutorial python -m pdfredactai.cli prepare --config configs/minimum.yaml
prepare crea las cartas sintéticas, su renderizado y las anotaciones de medida. Estas anotaciones permanecen fuera del volumen usado por la inferencia. La protección del proyecto hace explícita esta restricción: el detector no debe ver data/generated/labels.
En este punto tenemos los documentos que procesar y, por separado, su solución. Ya podemos pedir al programa que proponga zonas a partir de las únicas entradas observables.
Vincular una porción de texto a una ubicación en la página
docker compose run --rm inference python -m pdfredactai.cli propose --config configs/minimum.yaml
propose carga el modelo local y escribe los candidatos en outputs/proposals.json. Una propuesta debe conservar más que una palabra: necesitamos su tipo, su ubicación en el texto y sus rectángulos en el documento.
Estas ubicaciones textuales son desplazamientos de caracteres. Indican dónde empieza y termina una porción de cadena. En la documentación de Span, spaCy los expone mediante start_char y end_char. No los confunda con las posiciones de tokens, las unidades de texto segmentadas por su pipeline.
Tomemos una cadena inventada únicamente para entender la indexación: Contact: Alice Rowan.. La porción Alice Rowan empieza en el índice 9 y termina justo antes del índice 20. Por tanto, la expresión Python text[9:20] contiene los 11 caracteres del nombre. El límite final está excluido. Este ejemplo no es una salida del modelo ni una carta adicional del corpus.
Estos índices no son coordenadas de imagen. El carácter número 9 no está necesariamente en el píxel horizontal 9. Hay que recuperar los rectángulos asociados a esa porción en el documento y convertirlos al sistema de referencia del renderizado. Es el vínculo que el proyecto conserva con span_boxes, y después con el tratamiento geométrico de la máscara.
Leer la unión NER + regex
Este es el núcleo exacto de propose:
regex = regex_candidates(text)
ner = [
    {
        "start": e.start_char,
        "end": e.end_char,
        "kind": e.label_,
        "source": "ner",
    }
    for e in result.ents
    if e.label_ in config["entity_labels"]
]
candidates = {}
for candidate in regex + ner:
    key = (candidate["start"], candidate["end"])
    row = candidates.setdefault(key, {**candidate, "sources": []})
    row["sources"].append(candidate["source"])
union = []
for index, ((a, b), candidate) in enumerate(sorted(candidates.items())):
    union.append(
        {
            **candidate,
            "id": f"z{index:03d}",
            "text": text[a:b],
            "boxes": span_boxes(document, a, b),
        }
    )
La primera parte fabrica los candidatos NER. Para cada entidad de result.ents, el código conserva sus límites de caracteres, su tipo label_ y su origen ner. El filtro config["entity_labels"] selecciona los tipos autorizados por la configuración. Los candidatos regex se calcularon por separado mediante regex_candidates(text).
La segunda parte reúne las ocurrencias en la misma ubicación. regex + ner concatena las dos listas. La clave del diccionario es el par (start, end), no el texto reconocido. Por tanto, dos ocurrencias idénticas en lugares diferentes no se confunden solo por llevar el mismo nombre.
setdefault inserta una fila si la clave no existe; si no, devuelve la que ya estaba presente. Es el comportamiento descrito en la documentación de diccionarios de Python. La notación **candidate copia los campos del candidato, a los que el programa añade una lista sources.
Si regex y NER proponen exactamente los mismos límites, se conserva una sola fila y se registran ambos orígenes. No son dos votos independientes y eso no proporciona una probabilidad de acierto. El fragmento conserva procedencias; no calcula una puntuación de confianza combinada.
También hay un límite que se aprecia en estas líneas. Si dos candidatos comparten los mismos límites pero no el mismo kind, se conservan los campos del primero: setdefault no arbitra entre ellos. Como la lista regex aparece antes de la lista NER, su candidato se encuentra primero. En cambio, dos candidatos que se solapan sin tener exactamente los mismos límites permanecen separados. Esta unión no es una fusión general de rectángulos.
La última parte prepara la salida. Los pares se ordenan por inicio y después por final. enumerate les asigna identificadores como z000, z001 y z002. text[a:b] recupera el texto de cada ocurrencia y span_boxes(document, a, b) encuentra las cajas correspondientes.
Así, un identificador como z003 es una posición en la lista de propuestas de esta versión, no una identidad universal del nombre detectado. Si cambian las propuestas, ese número puede designar otra zona. Es una buena razón para vincular la aprobación a la versión exacta del documento y de la propuesta.
Una aprobación trazable, pero todavía no humana
docker compose run --rm inference python -m pdfredactai.cli review --config configs/minimum.yaml
La palabra review puede hacer pensar en una persona operadora que ha leído la carta. No es lo que demuestra este comando. En el POC, o prueba de concepto, la revisión aplica la política configurada a las propuestas del corpus sintético.
La decisión está vinculada al SHA-256 del PDF, al digest de la propuesta y a la revisión. Un digest es una huella calculada a partir de un contenido. La documentación de Python sobre hashlib describe en particular SHA-256. Aquí, estas huellas sirven para comprobar que se trabaja con los archivos a los que se refiere la decisión.
Piense en una validación de formulario que debe permanecer asociada a la versión correcta de un registro. Una aprobación de la carta A no debe reutilizarse silenciosamente tras sustituirla por una carta B. Sin embargo, el hash no demuestra ni que una persona haya leído la carta ni que haya elegido las zonas correctas.
Para un producto quedan por diseñar una interfaz de revisión, la identidad de la persona operadora, sus permisos y una política de escalado de casos inciertos. Por ahora, inspeccione las propuestas y las decisiones como salidas del experimento, no como una validación humana ya adquirida.
Ocultar los píxeles y reconstruir la copia
Sustituir píxeles, en vez de añadir un objeto encima
Ahora tenemos zonas aprobadas. El programa no las transforma en rectángulos añadidos al PDF inicial. Trabaja sobre una copia de la imagen de la página, sustituye por negro los píxeles implicados y después el módulo rebuild crea un PDF nuevo a partir de esta imagen modificada.
La función siguiente produce tres objetos: la imagen ennegrecida, una máscara de control y la lista de rectángulos aplicados. No crea por sí misma el PDF; esa etapa llega después.
def mask_pixels(image, boxes, scale, margin):
    image = image.convert("RGB").copy()
    mask = Image.new("L", image.size, 0)
    paint = ImageDraw.Draw(image)
    mark = ImageDraw.Draw(mask)
    rectangles = []
    for box in boxes:
        x0, y0, x1, y1 = pixel_box(box, scale, image.size, margin)
        rectangle = (x0, y0, x1 - 1, y1 - 1)
        paint.rectangle(rectangle, fill=(0, 0, 0))
        mark.rectangle(rectangle, fill=255)
        rectangles.append([x0, y0, x1, y1])
    return image, mask, rectangles
¿Por qué dos imágenes?
image.convert("RGB").copy() prepara una copia de tres canales: rojo, verde y azul. El negro se representa mediante (0, 0, 0). El segundo objeto, creado con Image.new("L", image.size, 0), contiene un solo canal de niveles de gris, inicialmente relleno de ceros. Estos modos se describen en los conceptos de Pillow.
Las dos imágenes no tienen el mismo papel. La imagen RGB es el documento visual modificado. La máscara indica dónde ha intervenido el programa. En esta máscara, el valor 255, blanco, marca las zonas procesadas; el cero, negro, significa que no se ha aplicado ningún rectángulo allí. Por tanto, el blanco de la máscara no quiere decir que la página publicada sea blanca en ese lugar: queda ennegrecida.
paint dibuja en la copia del documento; mark dibuja en la máscara. Cada rectángulo recibe la misma ubicación en ambas. Esta correspondencia permite comparar después las zonas realmente tratadas con las zonas de referencia.
La copia deja intacta la imagen de entrada. Es práctico para comprobar la transformación, pero también recuerda que fabricar una copia ocultada no elimina el original. La función no borra ni el PDF de origen ni los demás archivos intermedios.
Pasar de las coordenadas del documento a las del renderizado
pixel_box recibe la caja de origen, la escala scale, el tamaño de la imagen y el margen margin. El cálculo de los redondeos y de los límites de página está en esta función del proyecto, no en el fragmento anterior. Hay que conservar sus convenciones en vez de adivinar las de otra biblioteca.
Para entender solo la escala, tomemos un ejemplo geométrico independiente del corpus. Con orígenes ya alineados y sin margen, una caja (10, 20, 30, 25) ampliada por un factor dos se convierte en (20, 40, 60, 50). Sus dimensiones pasan de 20 × 5 a 40 × 10; su área se multiplica por cuatro. Este ejemplo no describe los redondeos ni el margen configurados en r001.
Un margen puede cubrir el borde de un carácter que sobresale ligeramente de la caja seleccionada, pero también ennegrece más entorno. No reemplaza la búsqueda de una mención olvidada en otra parte de la página. Habrá que leer la cobertura de las zonas sensibles y la ocultación de las zonas no sensibles.
¿Para qué sirven los dos «menos uno»?
La línea rectangle = (x0, y0, x1 - 1, y1 - 1) merece detenerse. La función Pillow rectangle incluye ambos límites. Por eso el código traduce una caja cuyo límite derecho e inferior están excluidos a este dibujo inclusivo.
Supongamos que pixel_box devuelve (10, 20, 30, 25). Queremos cubrir las columnas 10 a 29 y las filas 20 a 24: 20 × 5 = 100 píxeles. El rectángulo que se pasa a Pillow termina entonces en (29, 24).
Sin restar uno, el dibujo llegaría hasta la columna 30 y la fila 25, es decir, 21 × 6 = 126 píxeles. El rectángulo parecería casi idéntico en pantalla, pero su superficie y las medidas serían diferentes. Este pequeño ejemplo explica una convención de coordenadas; no es un nuevo resultado del corpus.
Por último, rectangles.append([x0, y0, x1, y1]) conserva los límites originales para la trazabilidad. La lista memorizada y el rectángulo dibujado usan así dos escrituras coherentes de la misma zona.
Ejecutar la transformación y la evaluación
docker compose run --rm inference python -m pdfredactai.cli redact --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfredactai.cli evaluate --config configs/minimum.yaml
redact verifica la aprobación y la huella SHA de la fuente antes y después de la reconstrucción. También rechaza la presencia de las anotaciones gold. A continuación, evaluate puede acceder a la solución para medir lo que se ha cubierto.
Cada línea de outputs/transformation.json lleva el estado FIXTURE_COPY_NOT_A_SAFETY_CERTIFICATE. Una fixture es un caso de prueba conocido, preparado para comprobar un comportamiento. Puede leer este estado como «copia del caso de prueba, no certificado de seguridad».
La evaluación examina los píxeles, la ausencia del marcador sintético buscado y la estructura de la copia: una página, una imagen /Im0, sin texto ni objetos de origen esperados. /Im0 es el nombre del recurso de imagen en este archivo. Su presencia no significa que la imagen ya no contenga información sensible: son precisamente los píxeles que queda por controlar.
Estas comprobaciones responden, por tanto, a dos preguntas distintas: ¿hemos reconstruido el tipo de archivo previsto y hemos ocultado realmente todas las zonas esperadas? La primera puede tener éxito mientras la segunda falla.
Leer los resultados antes de generalizarlos
La figura separa la detección de menciones y la aplicación de la ocultación. Mantengamos esa separación al leer las cifras del recorrido de referencia.
Las regex son precisas, pero no lo buscan todo
De las 360 menciones de prueba, las regex por sí solas encuentran 180 menciones correctas: los 90 correos electrónicos y las 90 referencias. No encuentran ninguna de las 180 menciones de personas. Por tanto, su precisión es 1,00, pero su recuperación es solo 0,50.
Una precisión perfecta no significa que la tarea esté terminada. Aquí significa que las propuestas emitidas son correctas; todavía falta la mitad de las menciones esperadas.
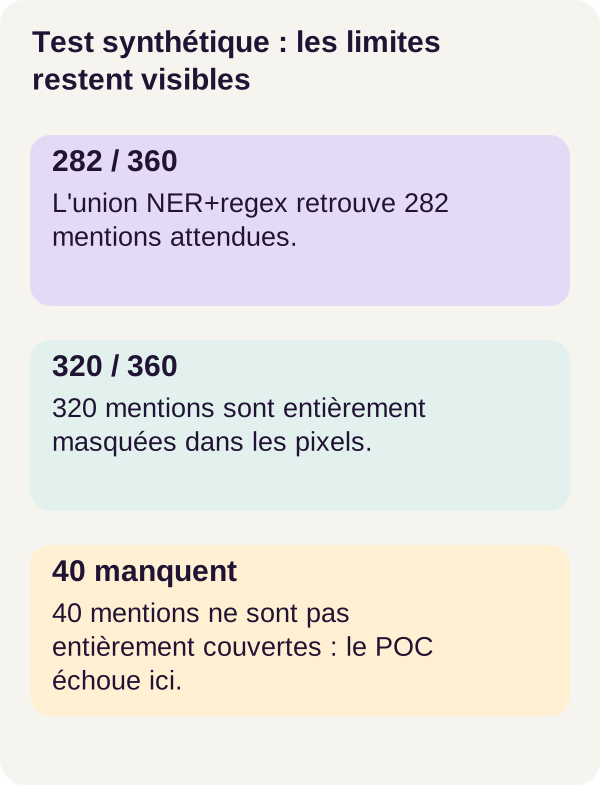
La unión NER + regex recupera 282 verdaderos positivos de 411 propuestas, es decir, una precisión de 0,686 y una recuperación de 0,783. Estos son los recuentos que permiten entender la diferencia:
| Método | Menciones correctas | Propuestas | Precisión | Recuperación |
|---|---|---|---|---|
| Solo regex | 180 | 180 | 1,00 | 0,50 |
| Unión NER + regex | 282 | 411 | 0,686 | 0,783 |
La incorporación de NER encuentra así más menciones, pero también añade zonas no esperadas. Por diferencia, la unión cuenta 129 propuestas no reconocidas como correctas (411 - 282) y 78 menciones esperadas no recuperadas como verdaderos positivos (360 - 282). Estas dos cifras se calculan a partir de los recuentos publicados, no proceden de una prueba nueva.
La categoría PERSON explica la mayor parte de esta dificultad: cuenta 102 verdaderos positivos para 231 propuestas y 180 menciones gold. Tenemos, por tanto, un detector que ayuda a encontrar personas, no uno que las encuentre todas ni que proponga siempre las zonas correctas.
Una cobertura de píxeles no es una proporción de menciones completas
La transformación cubre 1 717 175 de los 1 881 925 píxeles gold, es decir, 0,91246, aproximadamente 91,25 %. Oculta completamente 320 menciones de 360.
Por tanto, quedan 40 menciones ocultadas de forma incompleta. Eso no significa que las 40 sean íntegramente visibles ni que sean necesariamente legibles: el control dice que su cobertura no es completa. No convertimos esta constatación en éxito porque el rectángulo «parezca suficientemente grande».
¿Por qué pueden diferir los porcentajes de píxeles y menciones? En un ejemplo ficticio, supongamos dos menciones cuyas zonas de referencia ocupan 100 y 10 píxeles. Si la primera queda totalmente cubierta y la segunda no se cubre en absoluto, la cobertura global vale 100/110, aproximadamente 90,91 %, pero solo una mención de dos queda completamente ocultada. Las superficies grandes pesan más en el primer cálculo; cada mención pesa una unidad en el segundo.
El mismo razonamiento explica por qué no debemos confundir 282 detecciones correctas y 320 menciones completamente ocultadas. Las métricas no cuentan los mismos objetos. Por ejemplo, una zona demasiado grande puede cubrir píxeles sensibles sin reconocerse como una buena propuesta de detección; también pueden solaparse varias máscaras.
Son explicaciones posibles del mecanismo, no un diagnóstico de las menciones de esta prueba. Los totales publicados no bastan para explicar cada diferencia: habría que examinar las propuestas, los rectángulos y las correspondencias de la evaluación, mención por mención. Conservamos los dos resultados sin sustituir uno por otro.
Un marcador ausente no demuestra que todo haya desaparecido
En los 12 documentos que contenían el marcador sintético, el informe cuenta cero cadenas de marcador restantes. Este control específico es útil: la señal buscada no se volvió a encontrar en esta prueba. Pero no compensa los 40 fallos de cobertura.
A escala de documento, las salidas indican 55 estados PASS_FIXTURE y 35 fallos de contenido fixture, en las 90 cartas de prueba. Una carta puede fallar aunque varias de sus zonas se hayan tratado correctamente.
Conserve los nombres de los estados en sus salidas. PASS_FIXTURE significa que el caso satisface los controles de este experimento; no transforma el estado general FIXTURE_COPY_NOT_A_SAFETY_CERTIFICATE en autorización para difundir un documento real.
El recorrido también informa de un tiempo medio de aproximadamente 0,096 segundos por documento y un tamaño medio de 54 116 bytes por PDF. Estos valores describen este corpus y esta máquina CPU. No miden el tiempo de una persona operadora ni prometen el mismo rendimiento en otra colección.
El coste de ocultar de más
La fracción de píxeles no sensibles ocultados es 0,00871, aproximadamente 0,87 % de la zona no sensible. Es el coste visual del margen y de los falsos positivos: se ennegrece una parte del contenido que se quería conservar.
Esta tasa no es la proporción de propuestas falsas. Su denominador es una superficie de píxeles, no un número de entidades. Un único rectángulo grande e inútil puede pesar mucho en esta medida; varias propuestas pequeñas pueden pesar poco.
Por último, reconstruir un PDF a partir de píxeles tiene un coste funcional: el texto seleccionable, los enlaces activos, los formularios y las firmas digitales originales no se trasladan como tales a esta copia. Seguir viendo la forma de un enlace o el dibujo de una firma no significa que su función original siga existiendo. La accesibilidad exige un diseño independiente, más allá de esta demostración.
Síntesis antes del ejercicio
Hemos vinculado cuatro etapas que no se sustituyen entre sí: detectar una mención, aprobar una zona, modificar sus píxeles y comprobar la copia producida.
El modelo y las regex pueden pasar por alto una mención. Una política puede aprobar una zona insuficiente. Una conversión de coordenadas puede dejar un borde sin cubrir. Por último, una estructura PDF simplificada puede contener una imagen en la que la información sensible sigue visible.
El recorrido permite localizar estas cuestiones en vez de reducirlas a «el PDF está ennegrecido». El ejercicio aislará ahora dos hipótesis equivocadas: que basta una cobertura gráfica y que basta la ausencia de texto extraíble.
Ejercicio: predecir antes de comprobar
Antes de ejecutar el comando, formule su respuesta a esta primera hipótesis: «Una cobertura negra añadida al PDF basta, porque el lector ve una zona negra». Según usted, ¿qué devolverá la extracción de texto?
Después invierta el razonamiento. Si transformamos la página en una imagen y fabricamos un PDF nuevo sin ocultar los píxeles, ¿el extractor seguirá encontrando texto? ¿Y qué verá una persona al abrir el archivo?
Anote sus predicciones y, después, ejecute el escenario proporcionado:
docker compose run --rm tutorial python -m pdfredactai.cli exercise --config configs/exercise.yaml
Comparar su predicción con los dos contraejemplos
El comando fabrica dos casos ficticios. Los resultados siguientes son los comunicados para el recorrido de referencia:
| Caso | Extracción de texto | Lo que muestra el experimento |
|---|---|---|
| Cobertura negra añadida al PDF | cover_text_characters: 361 |
El texto de origen sigue siendo extraíble a pesar de la cobertura visible. |
| Reconstrucción raster sin máscara | Cero caracteres extraíbles | Los píxeles sensibles originales se conservan exactamente. |
En el primer caso, la visualización no basta: la capa negra no ha eliminado el texto subyacente. En el segundo, la extracción no basta: devuelve cero porque no encuentra texto nativo, no porque la información haya desaparecido de la imagen.
Las dos pruebas negativas refutan dos garantías imaginarias. No se corrigen mutuamente. Hay que comprobar las zonas píxel por píxel y la estructura del nuevo PDF, y tratar cualquier omisión de detección como un fallo que debe revisarse.
Vuelva después a las 40 menciones ocultadas de forma incompleta del recorrido principal. El segundo contraejemplo explica por qué una extracción vacía no puede hacer que se aprueben. Esta asociación entre observación y medida es lo que hace útil el tutorial.
Generar las figuras, controlar los hitos y limpiar
Producir las últimas salidas antes de eliminarlas
Las figuras deben construirse a partir de las medidas existentes. Ejecute estos dos comandos desde la raíz del proyecto:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
plot.py usa la evaluación ya producida. check_checkpoints.py controla los hitos y señala una incoherencia entre el curso y el código. Que su nombre contenga la palabra checkpoint no significa que acabemos de entrenar spaCy: este recorrido sigue usando el modelo local previsto.
Antes de limpiar, conserve los resultados que quiera estudiar. Para seguir un caso, ponga en relación outputs/proposals.json, la decisión de revisión, los rectángulos aplicados, la imagen ocultada y outputs/transformation.json. Una media global no explica por qué falla una carta concreta.
Resolver problemas en el lugar adecuado
¿Falta un recurso o su huella es diferente? Repita la adquisición y el control del entorno con los archivos bloqueados del curso. Sustituir el modelo por otro cambiaría el experimento antes incluso de la primera propuesta.
¿Sigue visible un nombre? Compruebe primero si existe una propuesta para esa ocurrencia y, después, si su zona está aprobada. Si lo está, inspeccione la proyección del texto hacia las cajas, la escala y los rectángulos efectivamente aplicados. Ampliar todas las zonas sin diagnóstico puede ocultar más contenido útil sin resolver el origen del problema.
¿Una aprobación ya no corresponde al archivo? Compare la fuente, la propuesta y su revisión. No eluda el control de huella para reutilizar una decisión que se ha vuelto incoherente.
¿La extracción está vacía, pero la carta sigue siendo legible? Es compatible con un PDF de imagen. Vuelva al control de píxeles: acaba de encontrarse precisamente con la distinción estudiada en el ejercicio.
Limpiar solo las salidas previstas
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
El primer down detiene el proyecto. El script de limpieza se ejecuta después en un contenedor temporal; el segundo down deja el entorno detenido. La opción --outputs-only conserva las fuentes y las configuraciones, pero elimina los artefactos generados implicados. No ejecute esta secuencia antes de haber leído o archivado las salidas útiles.
Esta limpieza no se presenta como un borrado seguro de todas las copias de un documento. No debe confundirse con una política de conservación, eliminación de copias de seguridad o gestión de derechos.
Lo que habría que diseñar antes de un uso real
No conecte directamente esta cadena a PDF reales destinados a difundirse. Las 40 menciones ocultadas de forma incompleta en la prueba son una limitación medida, no una precaución meramente teórica.
Para una adaptación, empiece por una evaluación distinta, autorizada y anotada, representativa de los documentos implicados. Defina las categorías que se deben ocultar y los casos que deben escalarse. Mantenga las etiquetas fuera del servicio de propuesta, versione la política de zonas y haga revisables las decisiones. Estos trabajos constituyen una validación nueva; no prolongan automáticamente la del corpus Solstice.
Una revisión real también debe permitir buscar los falsos negativos, la información no detectada. Mostrar solo las zonas propuestas no permite comprobar que el resto de la página no contenga nada que ocultar. Prevea una revisión del documento, un muestreo humano de las omisiones y controles de renderizado independientes.
La trazabilidad también debe seguir protegida. El fragmento de propose conserva explícitamente "text": text[a:b]: el archivo de propuestas puede contener las cadenas que intenta ocultar en la copia final. No distribuya automáticamente toda la carpeta de salidas junto con el PDF reconstruido. Una copia transformada correctamente no vuelve compartibles sus registros ni sus vistas previas intermedias.
Por último, defina una estrategia de accesibilidad y controle cualquier representación adicional del documento. La imagen por sí sola no sustituye a un contenido textual accesible, pero reincorporar sin control el texto original a la copia anularía el objetivo de la ocultación.
La enseñanza que conviene retener no es «la rasterización hace seguro un PDF». Es más bien esta: una transformación debe examinarse en cada nivel donde pueda persistir una información, con medidas que también hagan visibles los fallos.
Referencias para profundizar
Los enlaces integrados a lo largo del artículo remiten a las documentaciones oficiales: spaCy para las entidades y sus posiciones, Python para los diccionarios y las huellas, Pillow para los modos de imagen y los rectángulos, Docker para el control de configuración y Adobe para la distinción entre información visible y oculta.
Estos complementos explican los mecanismos; no son nuevas pruebas del proyecto. Para reproducir r001, conserve las versiones, los recursos bloqueados y los comandos de su archivo, en vez de sustituir una dependencia por la de una documentación actual.
Descargue el archivo completo del curso: ZIP r001.