





Vous développez un tableau de bord. Pour l’alimenter, on vous transmet un PDF avec un graphique, mais pas le fichier de données qui a servi à le dessiner. À l’écran, deux courbes, des années et une légende sont parfaitement visibles. Dans votre application, vous avez pourtant besoin d’autre chose : des valeurs que vous pouvez stocker, comparer et utiliser dans un calcul.
Prenons la page fictive Vega Energy Summary. Elle présente deux séries et un axe « Energy (MWh) ». Comment retrouver les valeurs, puis calculer leur variation, sans confondre les séries ni transformer des MWh en kWh au mauvais moment ?
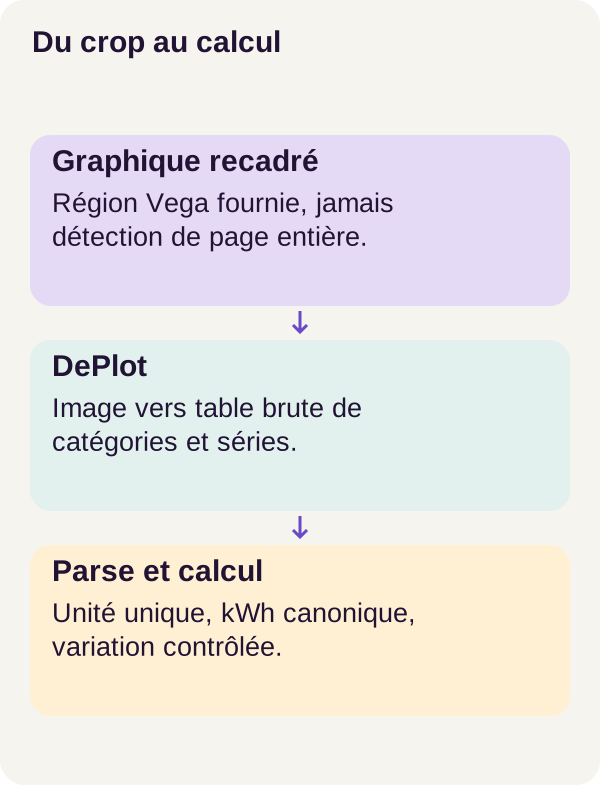
Nous allons utiliser DePlot pour proposer un tableau à partir de l’image. Ensuite, du code Python vérifiera les nombres et les unités avant d’effectuer les calculs. Le modèle extrait ; le programme contrôle et calcule. Cette séparation sera notre fil conducteur.
Le problème concret
Une réponse comme « la consommation a augmenté de 50 % » peut sembler convaincante. Elle ne dit pourtant pas si le modèle a lu les bonnes années, conservé les deux séries ou compris l’unité. Même un pourcentage juste peut accompagner des quantités fausses, comme nous le verrons avec un exemple.
Pour un développeur web, le problème ressemble à celui d’un import : recevoir du texte ne signifie pas encore disposer de données valides. Il faut reconnaître la structure, vérifier les champs et conserver les erreurs au lieu de les transformer en valeurs par défaut.
Notre parcours suit donc image de page → table proposée → validation → conversion en kWh → calcul → évaluation. Une sortie rejetée reste un résultat à examiner, pas un graphique dont les valeurs seraient toutes nulles.
Le corpus est synthétique : les pages Vega ont été fabriquées pour cette expérience. Cela permet de connaître les valeurs attendues et de comparer les prédictions à une référence. Ces réponses de référence, parfois appelées labels ou gold dans le code, servent à l’évaluation. Elles ne servent pas à réparer une extraction après coup.
Notions avant le code
Comment DePlot passe des pixels au tableau
DePlot est un modèle image-vers-texte fondé sur l’architecture Pix2Struct. Son entrée est une image ; sa sortie est une table écrite sous forme de texte. Nous ne récupérons pas ici le fichier de données original caché derrière la courbe : le modèle doit proposer une transcription à partir de ce qu’il voit.
Le processeur prépare l’entrée. Il découpe l’image en petits morceaux, appelés patches, et conserve des informations sur leur position. Un patch n’est pas forcément une lettre ou un point de courbe : c’est une zone d’image transformée en nombres.
L’encodeur transforme ces nombres en représentations utilisables par le modèle. Le décodeur produit ensuite la sortie morceau par morceau. Ces morceaux de texte sont des tokens : ils ne correspondent pas nécessairement à des mots entiers. Le prompt est la consigne qui indique la tâche à réaliser, ici la conversion du graphique en tableau. La documentation DePlot de Transformers présente cette tâche ; celle de Pix2Struct détaille l’architecture et la préparation des images.
Le modèle reste gelé pendant ce tutoriel : ses paramètres, ou poids, ne sont pas réentraînés sur Vega. Nous faisons de l’inférence, c’est-à-dire que nous utilisons un modèle déjà entraîné pour produire une sortie. Il n’y a donc ni apprentissage sur les pages du parcours ni fine-tuning dissimulé derrière la préparation.
Produire les tokens d’un nombre ne garantit pas que ce nombre soit juste. DePlot peut omettre une série ou écrire une valeur proche de celle attendue. Nous conservons sa table brute pour pouvoir retrouver l’origine d’une erreur, avant toute transformation par Python.
Du tracé à une donnée utilisable
Dans Vega, une catégorie est une année, par exemple 2020. Une série est une suite de valeurs associée à une courbe. Pour ne pas mélanger deux courbes qui passent par la même année, une valeur doit rester liée à sa série et à sa catégorie.
Le parsing, ou analyse de la sortie, consiste à passer du texte produit par DePlot à une structure que le programme sait manipuler. Pensez à la lecture d’un CSV : reconnaître les lignes et les colonnes ne dispense pas de vérifier leur contenu.
L’unité est un champ à part entière. 2 MWh et 2 kWh contiennent le même nombre, mais ne représentent pas la même quantité. Les préfixes méga et kilo correspondent respectivement à un million et à mille ; 1 MWh vaut donc 1000 kWh. La table des préfixes du NIST donne ces facteurs.
Le projet choisit le kWh comme unité canonique : toutes les quantités acceptées sont exprimées dans cette unité commune avant les opérations. « Canonique » ne veut pas dire « plus vrai » ; cela signifie simplement « représentation interne choisie pour éviter de mélanger les unités ».
Trois fonctions se partagent ce travail. recognized_unit exige une seule unité reconnue dans le texte reçu. number transforme une chaîne conforme en nombre. canonical applique le facteur de conversion. Aucune de ces étapes ne doit choisir son facteur en consultant la valeur attendue dans les annotations.
Le calcul vient après l’acceptation
Une fois la table acceptée, calculate travaille sur des valeurs numériques et des catégories annuelles. Elle trie les années, puis calcule première valeur, dernière valeur, somme, minimum, maximum et variation.
Le calcul est déterministe : pour les mêmes données acceptées et le même contexte numérique, les formules suivent les mêmes règles. Nous ne demandons pas au modèle d’improviser une addition ou d’expliquer pourquoi un résultat lui paraît plausible.
Le programme utilise Decimal, un type Python conçu pour l’arithmétique décimale. Nous regarderons son rôle dans le code. Pour le moment, retenez surtout la frontière : contrôler le calcul ne contrôle pas automatiquement la lecture du graphique.
Exemple d’unité et de variation
Reprenons un exemple simplifié, destiné à comprendre le mécanisme et non à présenter une nouvelle mesure du corpus. Une série vaut 2 MWh en 2020, puis 3 MWh en 2022.
Après conversion, nous obtenons 2000 et 3000 kWh. L’écart vaut 1000 kWh. La variation relative vaut (3000 - 2000) / 2000 = 0,5, soit 50 %. Le code renvoie le ratio 0.5 ; l’affichage en pourcentage multiplie ce ratio par 100. Ce n’est pas une croissance annuelle : la formule compare les deux extrémités de la période.
Voici le piège : calculer (3 - 2) / 2 donne aussi 0,5. Un facteur identique appliqué aux deux valeurs s’annule dans le rapport. Un bon pourcentage ne prouve donc pas que les quantités absolues aient la bonne unité.
Si la légende indique seulement « Energy », le contrat du projet refuse le calcul faute d’unité reconnue. Cela ne signifie pas qu’un rapport de nombres serait mathématiquement impossible sans unité affichée : cela signifie que notre programme n’a pas les informations requises pour accepter la table et ses conversions. Interpréter comme des kWh une quantité réellement exprimée en MWh la diviserait par mille ; faire l’inverse la multiplierait par mille.
Autre cas : la première valeur vaut zéro. La différence avec la dernière reste calculable, mais la formule du pourcentage diviserait par zéro. Le résultat devient alors None, avec le statut UNDEFINED_ZERO_BASELINE. Afficher 0 % à la place signifierait « aucune variation », ce qui serait une autre information.
Enfin, il faut décider quelle image donner au modèle. Le mode full utilise la page entière. Le mode crop utilise une région recadrée fournie au programme, pour concentrer l’entrée sur le graphique plutôt que sur les titres, logos ou tableaux voisins. Conservez ce rectangle avec les résultats : lire un graphique déjà localisé n’est pas détecter automatiquement tous les graphiques d’un rapport.
Le code central
Reconnaître l’unité, lire le nombre, convertir
L’extrait suivant provient de src/pdfcharts/units.py. Il contient quatre petites fonctions. Lisez-les comme les étapes d’un import dont le format est volontairement limité.
"""Recognize units in the extracted text; never infer a factor from gold."""

from decimal import Decimal, InvalidOperation
import re

UNIT = re.compile(r"(?<![A-Za-z])(kWh|MWh)(?![A-Za-z])", re.I)
FACTORS = {"kwh": Decimal(1), "mwh": Decimal(1000)}


def recognized_unit(raw):
    found = {m.group(1).lower() for m in UNIT.finditer(raw)}
    if len(found) != 1:
        raise ValueError("missing_unit" if not found else "conflicting_units")
    unit = next(iter(found))
    return {"unit": "kWh" if unit == "kwh" else "MWh", "factor": str(FACTORS[unit])}


def without_unit(text):
    return UNIT.sub("", text).strip().strip("()[]").strip()


def number(text):
    text = without_unit(text).replace("−", "-").strip()
    if re.fullmatch(r"[+-]?[0-9]{1,3}(,[0-9]{3})+(\.[0-9]+)?", text):
        text = text.replace(",", "")
    elif re.fullmatch(r"[+-]?[0-9]{1,3}( [0-9]{3})+(\.[0-9]+)?", text):
        text = text.replace(" ", "")
    if not re.fullmatch(
        r"[+-]?(?:[0-9]+(?:\.[0-9]*)?|\.[0-9]+)(?:[eE][+-]?[0-9]+)?", text
    ):
        raise ValueError("unsupported_numeric_format")
    try:
        value = Decimal(text)
    except InvalidOperation as exc:
        raise ValueError("invalid_number") from exc
    if not value.is_finite() or abs(value) > Decimal("1e12"):
        raise ValueError("numeric_range")
    return value


def canonical(value, unit):
    return value * Decimal(unit["factor"])
recognized_unit : une unité distincte, pas une seule occurrence
UNIT est une expression régulière qui cherche kWh ou MWh. Le drapeau re.I ignore la casse. Les tests autour du groupe évitent de le reconnaître lorsqu’il est directement accolé à une lettre couverte par [A-Za-z]. Les opérations du module re documentent ces mécanismes et les vérifications de chaîne entière.
finditer() parcourt les occurrences trouvées. La construction entre accolades crée un ensemble, qui ne conserve qu’un exemplaire de chaque unité après passage en minuscules. Le point important est donc le nombre d’unités distinctes : deux mentions de MWh ne constituent pas un conflit.
Sur des chaînes illustratives, la fonction se comporte ainsi :
| Texte reçu | Décision de recognized_unit |
|---|---|
Energy (MWh) |
Unité MWh, facteur "1000". |
MWh MWh |
Même unité répétée : acceptée. |
Energy |
Refus : missing_unit. |
Energy MWh / kWh |
Refus : conflicting_units. |
Le contrat ne couvre ici que deux unités. Par exemple, GWh n’est pas reconnu : il ne reçoit pas automatiquement un facteur parce qu’un humain connaît cette conversion.
Il reste une limite essentielle : cette fonction examine le texte qu’elle reçoit, pas directement le graphique. Si le modèle omet une unité présente dans l’image, l’expression régulière ne peut pas la retrouver. Le refus des ambiguïtés doit donc aussi être évalué sur les pages, pas seulement sur des chaînes de test.
without_unit et number : accepter un format défini
without_unit retire les mentions d’unité reconnues et nettoie les bords de la chaîne. number harmonise ensuite le signe moins typographique − avec -.
Les deux premiers tests reconnaissent certains groupements de milliers : 1,234.5 et 1 234.5, par exemple. Les séparateurs ne sont retirés que si le groupe complet respecte la forme prévue. Le dernier fullmatch vérifie toute la chaîne restante, pas seulement le premier nombre qu’on pourrait y trouver.
Voici des exemples de cette fonction, indépendants des prédictions du modèle :
Chaîne passée à number |
Valeur ou refus |
|---|---|
2 MWh |
Nombre 2, sans conversion à ce stade. |
1,234.5 kWh |
Nombre 1234.5. |
1 234.5 |
Nombre 1234.5, avec une espace ordinaire. |
1.25e3 |
Nombre équivalent à 1250 ; e3 signifie « fois mille ». |
−2.5 MWh |
Nombre -2.5. |
1,5 |
Refus : unsupported_numeric_format. |
1,234 |
Nombre 1234, pas le décimal français 1,234. |
Attention aux conventions locales. Le code prévoit un point décimal et certaines écritures des milliers. Il ne reconnaît pas automatiquement les habitudes de chaque langue. Remplacer toutes les virgules par des points ne serait pas une amélioration neutre : cela changerait notamment l’interprétation de 1,234.
La conversion en Decimal vient après la vérification de forme. NaN, qui désigne une valeur « pas un nombre », et Infinity sont déjà rejetés par le motif numérique. La vérification is_finite() complète les contrôles, et une valeur absolue supérieure à 1e12, soit mille milliards, déclenche numeric_range. Les nombres négatifs ne sont pas interdits par cette fonction : leur pertinence dépend ensuite du contrat métier.
number ne remplace surtout pas recognized_unit. Par exemple, retirer les unités de 2 MWh kWh peut laisser le nombre 2. C’est bien le contrôle séparé des unités qui doit rejeter ce texte conflictuel. Une conversion numérique réussie ne suffit pas à accepter la donnée.
Pourquoi Decimal et une conversion séparée ?
Construire Decimal à partir du texte préserve sa représentation décimale sans passer d’abord par un flottant binaire. Par exemple, Decimal("0.1") + Decimal("0.2") donne exactement Decimal("0.3"). En revanche, ce type n’offre pas une précision infinie pour toutes les opérations : une division comme un tiers dépend du contexte de précision et d’arrondi. La documentation Python de Decimal explique cette distinction.
canonical effectue ensuite une multiplication. Pour 2 MWh, number retourne 2 et le facteur vaut 1000 : nous obtenons 2000 kWh. Pour 2 kWh, le facteur vaut 1 : nous obtenons 2 kWh. La conversion utilise le facteur fourni ; elle ne redécouvre pas l’unité.
La borne de 1e12 est vérifiée avant cette multiplication. Il ne faut donc pas la présenter comme un plafond de 1e12 kWh sur toutes les valeurs converties. De même, cette petite fonction ne vérifie pas que le texte source était vrai. Les contrôles ont chacun un rôle précis, pas une garantie générale.
Calculer uniquement sur les valeurs acceptées
Passons à src/pdfcharts/calculate.py. À ce stade, les nombres sont exprimés en kWh. La fonction ne reçoit plus l’image ni la table brute DePlot : elle reçoit une structure préparée en amont.
def calculate(table):
    result = {}
    for series in table["series"]:
        values = {
            row["category"]: Decimal(row["canonical_kwh"])
            for row in table["values"]
            if row["series"] == series
        }
        if not all(re.fullmatch(r"[0-9]{4}", year) for year in values):
            raise ValueError("unsupported_category_order")
        years = sorted(values, key=int)
        first, last = values[years[0]], values[years[-1]]
        result[series] = {
            "first_category": years[0],
            "last_category": years[-1],
            "first_kwh": str(first),
            "last_kwh": str(last),
            "sum_kwh": str(sum(values.values())),
            "minimum_kwh": str(min(values.values())),
            "maximum_kwh": str(max(values.values())),
            "variation": str((last - first) / first) if first != 0 else None,
            "variation_status": "DEFINED" if first != 0 else "UNDEFINED_ZERO_BASELINE",
        }
    return result
La boucle traite chaque série séparément. Le dictionnaire values associe une catégorie à sa valeur canonique et ne conserve que les lignes de la série courante. Les chaînes numériques redeviennent des Decimal pour les opérations.
Le test [0-9]{4} impose ensuite quatre chiffres par catégorie. 2020 convient ; Q1 2020 ne convient pas. C’est un contrat de catégories annuelles, pas un tri universel de dates. Le test ne définit d’ailleurs pas une plage d’années métier : il contrôle la forme.
sorted(values, key=int) trie ces catégories numériquement. La première et la dernière valeur désignent donc les extrémités chronologiques, pas le minimum et le maximum. Une courbe qui monte puis redescend rendrait cette différence particulièrement visible.
Pour suivre le calcul, voici un objet minimal illustratif, construit avec les champs lus par la fonction. Ce n’est ni un export réel du corpus ni le schéma complet du parseur. Il ne contient qu’une série afin de rester lisible ; les deux séries Vega sont traitées séparément par la même boucle.
{
  "series": ["A"],
  "values": [
    {"category": "2022", "series": "A", "canonical_kwh": "3000"},
    {"category": "2020", "series": "A", "canonical_kwh": "2000"}
  ]
}
L’ordre d’entrée est inversé, mais le calcul commence bien en 2020. Il produit first_kwh = "2000", last_kwh = "3000", sum_kwh = "5000", minimum_kwh = "2000", maximum_kwh = "3000" et variation = "0.5", avec le statut DEFINED.
La somme porte uniquement sur les valeurs présentes. Elle n’invente pas une valeur pour 2021 et ne calcule pas l’aire sous la courbe. Pour une série qui commencerait à zéro, variation serait None, sans supprimer pour autant les autres résultats.
Les appels à str() conservent les résultats numériques sous forme de chaînes dans la sortie. Le frontend doit donc distinguer une chaîne comme "0.5", un pourcentage affiché et une absence de valeur. Le statut associé permet précisément de ne pas afficher une variation indéfinie comme un zéro.
Cet extrait n’est pas un validateur autonome de toutes les tables possibles. Il suppose notamment des séries non vides et des catégories uniques par série. Dans une entrée fabriquée avec deux lignes de même catégorie, la construction du dictionnaire garderait la dernière ; elle ne déclencherait pas ici une erreur de doublon. Ces garanties doivent être examinées dans la préparation et le parseur du projet avant de réutiliser la fonction ailleurs. Le calcul ne doit pas être appelé directement sur une structure arbitraire sortie du modèle.
Prérequis et commandes
Vous devez savoir lire du Python, manipuler des dictionnaires et utiliser un terminal avec Docker. Il n’est pas nécessaire de savoir entraîner un réseau pour suivre cette expérience : DePlot reste gelé.
Le profil de référence utilise Linux, Docker Engine, Compose, un pilote NVIDIA et NVIDIA Container Toolkit, sur une RTX 3090 de 24 Gio. Les recommandations sont de 32 Gio de RAM et 25 Gio de disque. La RAM est la mémoire de la machine ; les 24 Gio de la carte correspondent à sa mémoire vidéo, ou VRAM. Ces indications préparent l’environnement, elles ne constituent pas des minima garantis pour toute configuration. Le profil CPU n’est pas validé.
Le pilote rend le GPU utilisable par Linux. NVIDIA Container Toolkit fournit l’intégration qui permet aux conteneurs d’y accéder ; il ne remplace pas l’installation du pilote de l’hôte. C’est pourquoi voir la carte avec nvidia-smi ne suffit pas : check_environment.py exécute le modèle dans Docker pour vérifier ce second niveau.
Décompressez le ZIP et ouvrez un terminal à sa racine. Toutes les commandes qui suivent se lancent depuis ce répertoire, dans l’ordre. Le service acquisition récupère les actifs prévus ; inference réalise les prédictions et les traitements associés ; tutorial prépare le corpus et les évaluations. L’acquisition est séparée, et les services d’inférence ne consultent pas les labels de référence.
Étape 1 — préparer
Commençons par les contrôles préalables, la préparation, la construction des services et l’acquisition du modèle. Nous terminerons par un calcul dans l’environnement conteneurisé et par les tests du projet.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Chaque commande doit terminer avec un code retour nul, c’est-à-dire un code de succès. Les vérifications sont complémentaires : une configuration Compose valide ne prouve pas que le modèle a été acquis ; une acquisition réussie ne prouve pas que le GPU est utilisable ; des tests réussis ne prouvent pas que toutes les valeurs extraites seront justes.
Conservez les versions et les fichiers de l’acquisition verrouillée du ZIP. Les documentations liées dans cet article expliquent les mécanismes, mais leurs exemples d’installation ne remplacent pas les dépendances du parcours r001.
Étape 2 — construire la prédiction
Nous allons maintenant fabriquer les pages Vega, demander les tables à DePlot, puis analyser les sorties.
docker compose run --rm tutorial python -m pdfcharts.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m pdfcharts.cli infer --config configs/minimum.yaml
docker compose run --rm inference python -m pdfcharts.cli parse --config configs/minimum.yaml
prepare rend les 120 pages du corpus et fixe les régions. Le rendu transforme la page PDF en image. infer produit la représentation tabulaire ; parse contrôle sa structure, ses séries et ses unités.
Avant l’évaluation, ouvrez une image et sa sortie textuelle. Retrouvez les années, les noms des séries et l’unité. Examinez ensuite la table analysée ou sa raison de rejet. Vous devez pouvoir suivre le chemin d’une valeur sans consulter sa réponse attendue pour la « corriger ».
Cette inspection répond à une question utile : l’erreur était-elle déjà présente dans la sortie DePlot, ou apparaît-elle pendant son interprétation ? Changer le parseur pour masquer une mauvaise lecture du modèle empêcherait de le savoir.
Étape 3 — mesurer et contrôler
Les deux premières commandes ci-dessous calculent les statistiques sur les tables acceptées, puis évaluent les résultats. La troisième lance déjà l’exercice sur les unités, avec configs/exercise.yaml.
Avant de lancer ce bloc, notez votre prédiction pour l’exercice : que se passe-t-il si 2 MWh sont correctement réécrits en 2000 kWh ? Et si l’unité disparaît ? Nous détaillerons la correction dans la section consacrée à l’exercice, après les mesures.
docker compose run --rm inference python -m pdfcharts.cli calculate --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfcharts.cli evaluate --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfcharts.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
docker compose down
calculate n’utilise que les valeurs acceptées ; evaluate peut les comparer aux références séparées. exercise lance le scénario fourni. Les deux commandes suivantes produisent les figures et exécutent le contrôle des fichiers prévu par le projet. Le nom check_checkpoints.py ne signifie pas qu’un entraînement a eu lieu : le modèle de ce parcours reste gelé.
Le dernier docker compose down arrête les services du projet. Ce n’est pas la commande de nettoyage des exports : conservez les sorties pour les lire, puis utilisez le nettoyage ciblé à la fin de l’article.
Mesures avant les chiffres
Mesurer l’extraction sans confondre les populations
Une métrique est une mesure du comportement du programme. Avant de comparer deux nombres, il faut savoir ce qui a été compté et sur quels exemples.
Le taux d’acceptation est la proportion de graphiques pour lesquels les contrôles autorisent une table et un calcul. Accepter davantage n’est pas toujours mieux : accepter une unité ambiguë serait une erreur, alors qu’un rejet explicite est le comportement recherché dans ce cas.
La MAE, pour Mean Absolute Error, est l’erreur absolue moyenne. Sur un exemple fictif, des valeurs attendues de 1000 et 2000 kWh, prédites à 990 et 2030 kWh, donnent des erreurs de 10 et 30 kWh. La MAE vaut donc (10 + 30) / 2 = 20 kWh. Les signes disparaissent : une sous-estimation ne compense pas une surestimation.
Ici, cette MAE est conditionnelle : elle ne concerne que les valeurs acceptées et comparables. Elle ne pénalise pas directement celles qui ne sont pas disponibles pour la comparaison. Une méthode qui rejette les cas difficiles pourrait donc afficher une faible MAE tout en fournissant peu de valeurs. Lisez l’erreur avec l’acceptation et la couverture, jamais seule. La couverture désigne ici les éléments effectivement disponibles pour être comparés ; ne la supposez pas parfaite parce qu’une table a été acceptée.
Le rappel de séries indique si les séries attendues ont été retrouvées. Dans un exemple fictif de quatre séries attendues dont trois retrouvées, ce rappel vaut 3/4 = 0,75. Des valeurs exactes sur une seule courbe ne compensent pas automatiquement l’oubli de l’autre.
La précision d’unité mesure la justesse de l’unité reconnue parmi les sorties non ambiguës. Un score parfait sur cet indicateur ne signifie ni que toutes les pages ont été acceptées ni que tous les nombres sont corrects.
Enfin, le contrôle arithmétique compare les sommes, extrema et variations aux valeurs acceptées après conversion. Il vérifie le travail du calculateur, pas la fidélité de ces valeurs à l’image. Dans l’exemple précédent, additionner 990 et 2030 donne correctement 3020, alors que la somme des valeurs attendues est 3000. Le calcul peut être exact sur des entrées inexactes.
Voir ce que les commandes produisent
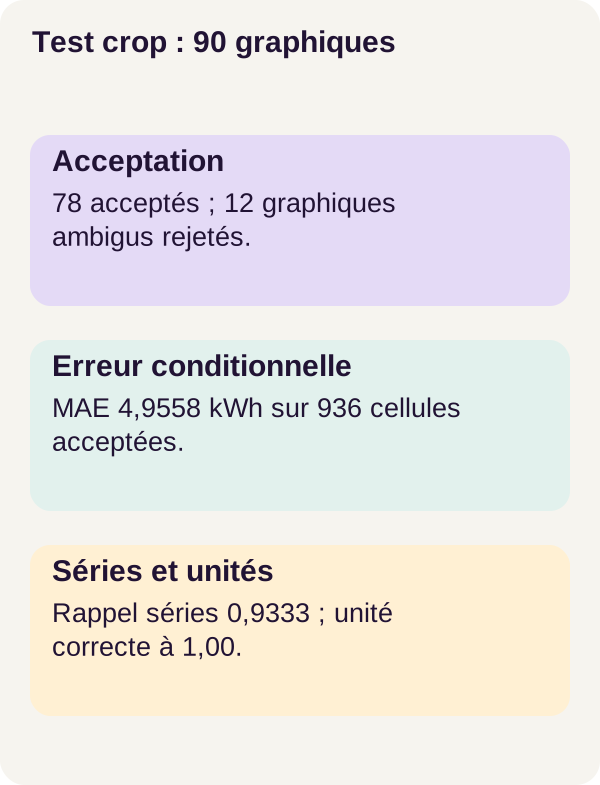
Le parcours principal comporte 90 pages de test, dont 12 graphiques ambigus. Le tableau suivant reprend les résultats r001 rapportés pour ce jeu, sans les mélanger avec les trois pages de l’exercice.
| Mesure sur le test | Région fournie : mode crop | Page entière : mode full |
|---|---|---|
| Graphiques acceptés | 78/90 | 45/90 |
| MAE conditionnelle, en kWh | 4,9558 | 26,4075 |
| Rappel de séries | 0,9333 | Non chiffré ici |
| Précision d’unité | 1,0000 | Non chiffrée ici |
Une mesure non chiffrée dans ce tableau n’est pas un zéro. Les populations comparées pour la MAE dépendent des sorties acceptées par chaque mode.
Le mode crop accepte les 78 graphiques non ambigus et rejette les 12 ambigus, sans acceptation dangereuse observée parmi ces cas. Son taux d’acceptation est donc d’environ 86,7 %, contre 50 % pour la page entière. Ces pourcentages sont simplement calculés à partir des fractions affichées.
L’erreur conditionnelle plus faible du crop est un résultat utile, mais il faut garder deux limites en tête. D’abord, les deux modes n’acceptent pas exactement la même population : comparer les MAE ne remplace pas une comparaison valeur par valeur sur un ensemble commun. Ensuite, le crop apporte déjà la région pertinente au modèle ; ce score ne mesure pas sa capacité à trouver seul un graphique dans une page.
Le rappel de séries de 0,9333 rappelle une autre limite. Une table exploitable pour les séries qu’elle contient n’est pas nécessairement une reconstruction exhaustive des séries attendues. Une série entière omise peut ne devenir visible qu’à la comparaison avec la référence, puisque l’inférence n’a pas accès aux réponses.
Le résultat à retenir n’est donc pas « les graphiques sont tous bien lus ». Sur ce corpus synthétique, le recadrage fourni permet davantage de tables acceptées et une erreur conditionnelle moindre. Des séries restent manquantes et les chiffres n’établissent aucune performance sur vos propres PDF.
Dépanner et produire
Une valeur est rejetée ? Revenez d’abord à l’export textuel : l’unité est-elle présente ? Le format respecte-t-il la convention numérique ? Les séries et catégories sont-elles utilisables ? Ne commencez pas par ajouter un facteur 1000 « parce que cela ressemble à des MWh ».
Si le crop coupe la légende, le modèle ne reçoit plus toute l’information nécessaire. Une région corrigée constitue une nouvelle entrée à évaluer : conservez l’ancienne et la nouvelle, plutôt que de réécrire rétrospectivement le résultat du parcours de référence.
En service, versionnez le modèle, le rendu PDF, la région fournie, la table brute, les conversions et les raisons de rejet. Cette traçabilité permet de remonter d’un nombre affiché à ce qui a réellement été traité. Les données utilisées dans une décision énergétique ou une facture doivent également passer par une revue humaine adaptée à l’enjeu.
Ce que nous avons appris
DePlot propose une table à partir d’une image, sans réentraînement dans ce parcours. Le parseur lui donne une forme exploitable, puis des contrôles explicites autorisent ou refusent les nombres et l’unité. La conversion canonique permet enfin d’utiliser les mêmes formules sur les valeurs acceptées.
Ces étapes répondent à des questions différentes : ai-je extrait la bonne donnée ? Est-elle interprétable sans ambiguïté ? Ai-je correctement calculé à partir d’elle ? Une seule métrique ne répond pas aux trois.
Nous avons aussi vu qu’une variation relative peut rester correcte malgré une erreur d’échelle, qu’une série absente peut échapper à une erreur moyenne conditionnelle et qu’une unité correctement reconnue ne garantit pas un nombre correctement lu. Ce sont des distinctions concrètes à conserver jusque dans l’interface.
Exercice — changer l’unité ou la rendre ambiguë
Reprenez les hypothèses notées avant l’étape 3. L’expérience est lancée par la sous-commande exercise avec configs/exercise.yaml, déjà présente dans cette séquence. Elle ne nécessite pas de modifier le code validé. Les commandes de nettoyage se trouvent plus loin, après l’inspection des résultats.
La question est simple : changer l’écriture d’une quantité change-t-il nécessairement la quantité elle-même ? Dans notre exemple simplifié, 2 MWh deviennent 2000 kWh. La représentation change, mais la valeur canonique doit rester 2000 kWh. Pour la seconde année, 3 MWh deviennent 3000 kWh : la variation reste 0.5.
Comparez cela à une autre opération, purement illustrative : remplacer seulement le texte MWh par kWh tout en gardant le nombre 2. Ce n’est pas une conversion de la même quantité. Vous avez décrit une quantité mille fois plus petite. Le programme ne doit pas deviner que vous souhaitiez conserver l’ancienne valeur.
Le scénario fourni comprend trois pages, dont une ambiguë. Dans les résultats de référence, le mode crop accepte deux tables et rejette la page ambiguë. Comparez l’unité source, les valeurs canoniques et les raisons de rejet avec votre prédiction. Une conversion explicite conserve la grandeur ; une unité manquante ne doit pas être déduite de ce qui rendrait le résultat satisfaisant.
Cette petite expérience vérifie des cas précis. Elle ne démontre pas que le modèle saura gérer tous les formats d’axes, toutes les légendes ou toutes les unités d’un corpus réel.
Décider quoi afficher à un utilisateur
Dans une interface, une table acceptée devrait montrer la série, les catégories, l’unité source, l’unité canonique et les résultats de calcul. Le PDF et la région traitée doivent rester consultables pour que l’utilisateur puisse contrôler la lecture. Il s’agit d’une exigence pour une intégration, pas de l’annonce d’un back-office déjà fourni par ce tutoriel.
Pour une sortie rejetée, affichez la raison : unité manquante, unités conflictuelles, format numérique non pris en charge ou structure de série inutilisable. Masquer ces cas donnerait l’impression que les graphiques ignorés contiennent des zéros ou n’existent pas.
Enfin, distinguez valeur nulle, valeur absente et variation indéfinie. Une série qui commence à zéro conserve une première valeur connue ; c’est seulement sa variation relative depuis cette base qui est indéfinie. Le statut UNDEFINED_ZERO_BASELINE permet d’expliquer cette situation sans supprimer toute la série.
Sorties et pannes fréquentes
Après infer, gardez la table brute DePlot. Après parse, regardez les unités et les catégories reconnues, ainsi que les séries ou tables rejetées. Après calculate, contrôlez les catégories initiale et finale et le statut de variation.
Si plusieurs unités sont présentes, le parcours ne fournit pas une gestion générale des graphiques à axes multiples. Rejetez le cas selon le contrat ; le scinder en sous-tables serait une adaptation à concevoir et à évaluer séparément, pas un comportement à lui attribuer implicitement.
Si l’image est mal rendue ou la légende illisible, inspectez le PDF, le crop et sa résolution avant de mettre en cause le parseur. Celui-ci ne peut pas récupérer un détail qui n’a pas été transmis ou correctement extrait.
Production, limites et nettoyage
Passer de cette expérience à une application demande de mesurer l’extraction sur des documents autorisés et représentatifs de votre usage. Les pages Vega fournissent un environnement contrôlé, pas la diversité des rapports clients, des scans dégradés ou des graphiques réels.
Conservez pour chaque résultat la version du document, la page, la région d’entrée, la version du modèle, les unités, les transformations et la décision d’acceptation ou de rejet. Cette provenance facilite la vérification ; elle ne prouve pas à elle seule que chaque valeur est correcte. Le rectangle du crop localise l’entrée, il ne constitue pas automatiquement une preuve précise pour chacun des nombres produits.
Ajoutez les droits d’accès aux documents, la surveillance du service, des tests sur vos propres formats et une revue humaine pour les décisions à enjeu. Une absence, une unité ambiguë ou une région invalide ne doit jamais être transformée silencieusement en certitude.
Nettoyer après avoir conservé les résultats
Copiez les exports et les figures utiles avant de lancer les deux commandes suivantes. La première supprime les sorties ; elle ne lance pas l’exercice. Le nettoyage vise seulement outputs/, puis le dernier arrêt termine le parcours Docker.
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Références pour approfondir
Le dépôt primaire de DePlot documente la conversion d’une figure en tableau sous-jacent. La documentation officielle de NVIDIA Container Toolkit explique l’intégration GPU avec les conteneurs.
Les liens complémentaires vers Transformers, Python et les préfixes d’unités éclairent les mécanismes présentés. Les exemples numériques de l’article sont pédagogiques ; les mesures du corpus et de l’exercice restent celles du parcours r001. Pour reproduire celui-ci, utilisez les fichiers et configurations du ZIP plutôt que de remplacer ses versions par celles d’un exemple documentaire récent.
Une valeur devient exploitable lorsqu’on peut retrouver d’où elle vient, comment elle a été interprétée et pourquoi son calcul a été autorisé. C’est ce chemin que nous avons construit, sans confondre une prédiction lisible avec une preuve.