





Está desarrollando un cuadro de mando. Para alimentarlo, le entregan un PDF con un gráfico, pero no el archivo de datos que se utilizó para dibujarlo. En pantalla se ven perfectamente dos curvas, años y una leyenda. Sin embargo, en su aplicación necesita otra cosa: valores que pueda almacenar, comparar y utilizar en un cálculo.
Tomemos la página ficticia Vega Energy Summary. Presenta dos series y un eje «Energy (MWh)». ¿Cómo recuperar los valores y calcular después su variación sin confundir las series ni convertir MWh en kWh en el momento equivocado?
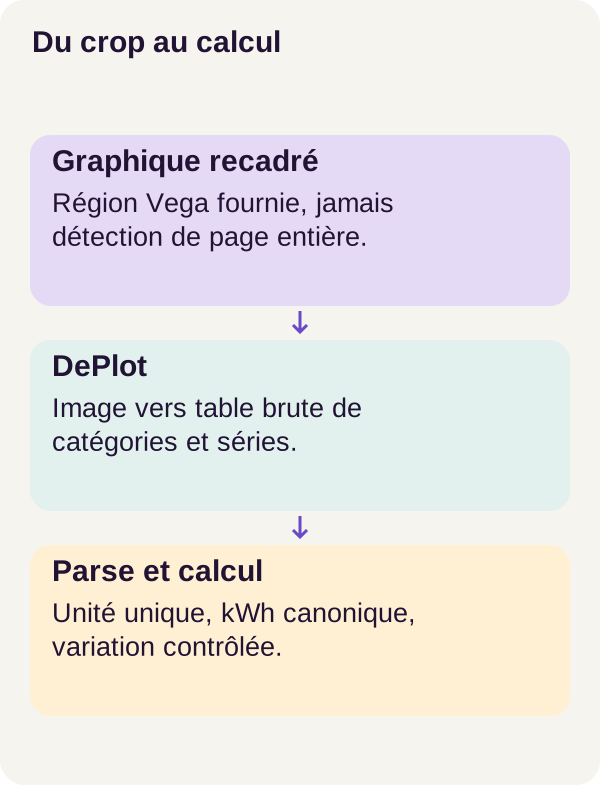
Usaremos DePlot para proponer una tabla a partir de la imagen. Después, código Python verificará los números y las unidades antes de efectuar los cálculos. El modelo extrae; el programa controla y calcula. Esta separación será nuestro hilo conductor.
El problema concreto
Una respuesta como «el consumo aumentó un 50 %» puede parecer convincente. Sin embargo, no dice si el modelo leyó los años correctos, conservó las dos series o entendió la unidad. Incluso un porcentaje correcto puede acompañar cantidades erróneas, como veremos con un ejemplo.
Para un desarrollador web, el problema se parece al de una importación: recibir texto todavía no significa disponer de datos válidos. Hay que reconocer la estructura, verificar los campos y conservar los errores en lugar de convertirlos en valores predeterminados.
Por tanto, nuestro recorrido sigue imagen de página → tabla propuesta → validación → conversión a kWh → cálculo → evaluación. Una salida rechazada sigue siendo un resultado que examinar, no un gráfico cuyos valores sean todos nulos.
El corpus es sintético: las páginas Vega se fabricaron para este experimento. Esto permite conocer los valores esperados y comparar las predicciones con una referencia. Estas respuestas de referencia, llamadas a veces labels o gold en el código, sirven para la evaluación. No sirven para reparar una extracción a posteriori.
Conceptos antes del código
Cómo pasa DePlot de los píxeles a la tabla
DePlot es un modelo de imagen a texto basado en la arquitectura Pix2Struct. Su entrada es una imagen; su salida es una tabla escrita como texto. Aquí no recuperamos el archivo de datos original oculto tras la curva: el modelo debe proponer una transcripción a partir de lo que ve.
El procesador prepara la entrada. Divide la imagen en pequeñas partes, llamadas patches, y conserva información sobre su posición. Un patch no es necesariamente una letra ni un punto de la curva: es una zona de imagen transformada en números.
El codificador transforma estos números en representaciones que el modelo puede utilizar. A continuación, el decodificador produce la salida fragmento a fragmento. Estos fragmentos de texto son tokens: no corresponden necesariamente a palabras completas. El prompt es la instrucción que indica la tarea que debe realizarse, aquí convertir el gráfico en tabla. La documentación de DePlot en Transformers presenta esta tarea; la de Pix2Struct detalla la arquitectura y la preparación de imágenes.
El modelo permanece congelado durante este tutorial: sus parámetros, o pesos, no se vuelven a entrenar con Vega. Hacemos inferencia, es decir, usamos un modelo ya entrenado para producir una salida. Por tanto, no hay aprendizaje con las páginas del recorrido ni ajuste fino oculto tras la preparación.
Producir los tokens de un número no garantiza que ese número sea correcto. DePlot puede omitir una serie o escribir un valor cercano al esperado. Conservamos su tabla sin procesar para poder rastrear el origen de un error antes de cualquier transformación en Python.
Del trazado a un dato utilizable
En Vega, una categoría es un año, por ejemplo 2020. Una serie es una sucesión de valores asociada a una curva. Para no mezclar dos curvas que pasan por el mismo año, un valor debe permanecer vinculado a su serie y a su categoría.
El parsing, o análisis de la salida, consiste en pasar del texto producido por DePlot a una estructura que el programa sabe manipular. Piense en leer un CSV: reconocer filas y columnas no exime de comprobar su contenido.
La unidad es un campo por derecho propio. 2 MWh y 2 kWh contienen el mismo número, pero no representan la misma cantidad. Los prefijos mega y kilo corresponden respectivamente a un millón y a mil; por tanto, 1 MWh equivale a 1000 kWh. La tabla de prefijos del NIST ofrece estos factores.
El proyecto elige el kWh como unidad canónica: todas las cantidades aceptadas se expresan en esta unidad común antes de las operaciones. «Canónica» no quiere decir «más verdadera»; simplemente significa «representación interna elegida para no mezclar unidades».
Tres funciones se reparten este trabajo. recognized_unit exige una sola unidad reconocida en el texto recibido. number transforma una cadena conforme en número. canonical aplica el factor de conversión. Ninguna de estas etapas debe elegir su factor consultando el valor esperado en las anotaciones.
El cálculo llega después de la aceptación
Una vez aceptada la tabla, calculate trabaja con valores numéricos y categorías anuales. Ordena los años y calcula el primer valor, el último, la suma, el mínimo, el máximo y la variación.
El cálculo es determinista: con los mismos datos aceptados y el mismo contexto numérico, las fórmulas siguen las mismas reglas. No pedimos al modelo que improvise una suma ni que explique por qué un resultado le parece plausible.
El programa usa Decimal, un tipo de Python diseñado para la aritmética decimal. Veremos su función en el código. Por ahora, retenga sobre todo la frontera: controlar el cálculo no controla automáticamente la lectura del gráfico.
Ejemplo de unidad y variación
Retomemos un ejemplo simplificado, pensado para entender el mecanismo y no para presentar una nueva medida del corpus. Una serie vale 2 MWh en 2020 y después 3 MWh en 2022.
Tras la conversión obtenemos 2000 y 3000 kWh. La diferencia es 1000 kWh. La variación relativa es (3000 - 2000) / 2000 = 0,5, es decir, 50 %. El código devuelve la proporción 0.5; la visualización en porcentaje multiplica esta proporción por 100. No es un crecimiento anual: la fórmula compara los dos extremos del período.
He aquí la trampa: calcular (3 - 2) / 2 también da 0,5. Un factor idéntico aplicado a ambos valores se cancela en la relación. Por tanto, un buen porcentaje no demuestra que las cantidades absolutas tengan la unidad correcta.
Si la leyenda solo indica «Energy», el contrato del proyecto rechaza el cálculo por falta de una unidad reconocida. Esto no significa que una relación entre números sea matemáticamente imposible sin una unidad visible: significa que nuestro programa no tiene la información necesaria para aceptar la tabla y sus conversiones. Interpretar como kWh una cantidad realmente expresada en MWh la dividiría entre mil; hacer lo contrario la multiplicaría por mil.
Otro caso: el primer valor es cero. La diferencia con el último sigue siendo calculable, pero la fórmula del porcentaje dividiría por cero. El resultado pasa entonces a ser None, con el estado UNDEFINED_ZERO_BASELINE. Mostrar 0 % en su lugar significaría «ninguna variación», que es otra información.
Por último, hay que decidir qué imagen dar al modelo. El modo full utiliza la página completa. El modo crop utiliza una región recortada proporcionada al programa para concentrar la entrada en el gráfico y no en títulos, logotipos o tablas cercanas. Conserve este rectángulo con los resultados: leer un gráfico ya localizado no es detectar automáticamente todos los gráficos de un informe.
El código central
Reconocer la unidad, leer el número, convertir
El siguiente extracto procede de src/pdfcharts/units.py. Contiene cuatro pequeñas funciones. Léalas como las etapas de una importación cuyo formato se ha limitado deliberadamente.
"""Recognize units in the extracted text; never infer a factor from gold."""

from decimal import Decimal, InvalidOperation
import re

UNIT = re.compile(r"(?<![A-Za-z])(kWh|MWh)(?![A-Za-z])", re.I)
FACTORS = {"kwh": Decimal(1), "mwh": Decimal(1000)}


def recognized_unit(raw):
    found = {m.group(1).lower() for m in UNIT.finditer(raw)}
    if len(found) != 1:
        raise ValueError("missing_unit" if not found else "conflicting_units")
    unit = next(iter(found))
    return {"unit": "kWh" if unit == "kwh" else "MWh", "factor": str(FACTORS[unit])}


def without_unit(text):
    return UNIT.sub("", text).strip().strip("()[]").strip()


def number(text):
    text = without_unit(text).replace("−", "-").strip()
    if re.fullmatch(r"[+-]?[0-9]{1,3}(,[0-9]{3})+(\.[0-9]+)?", text):
        text = text.replace(",", "")
    elif re.fullmatch(r"[+-]?[0-9]{1,3}( [0-9]{3})+(\.[0-9]+)?", text):
        text = text.replace(" ", "")
    if not re.fullmatch(
        r"[+-]?(?:[0-9]+(?:\.[0-9]*)?|\.[0-9]+)(?:[eE][+-]?[0-9]+)?", text
    ):
        raise ValueError("unsupported_numeric_format")
    try:
        value = Decimal(text)
    except InvalidOperation as exc:
        raise ValueError("invalid_number") from exc
    if not value.is_finite() or abs(value) > Decimal("1e12"):
        raise ValueError("numeric_range")
    return value


def canonical(value, unit):
    return value * Decimal(unit["factor"])
recognized_unit: una unidad distinta, no una única aparición
UNIT es una expresión regular que busca kWh o MWh. La bandera re.I ignora las mayúsculas y minúsculas. Las pruebas alrededor del grupo evitan reconocerla cuando está pegada directamente a una letra cubierta por [A-Za-z]. Las operaciones del módulo re documentan estos mecanismos y las comprobaciones de cadena completa.
finditer() recorre las apariciones encontradas. La construcción entre llaves crea un conjunto, que conserva un solo ejemplar de cada unidad tras pasarla a minúsculas. Por tanto, el punto importante es el número de unidades distintas: dos menciones de MWh no constituyen un conflicto.
En cadenas ilustrativas, la función se comporta así:
| Texto recibido | Decisión de recognized_unit |
|---|---|
Energy (MWh) |
Unidad MWh, factor "1000". |
MWh MWh |
Misma unidad repetida: aceptada. |
Energy |
Rechazo: missing_unit. |
Energy MWh / kWh |
Rechazo: conflicting_units. |
El contrato solo cubre aquí dos unidades. Por ejemplo, GWh no se reconoce: no recibe automáticamente un factor porque un ser humano conozca esa conversión.
Sigue existiendo un límite esencial: esta función examina el texto que recibe, no el gráfico directamente. Si el modelo omite una unidad presente en la imagen, la expresión regular no puede recuperarla. Por tanto, el rechazo de ambigüedades también debe evaluarse en las páginas, no solo en cadenas de prueba.
without_unit y number: aceptar un formato definido
without_unit elimina las menciones de unidades reconocidas y limpia los bordes de la cadena. A continuación, number armoniza el signo menos tipográfico − con -.
Las dos primeras pruebas reconocen ciertos agrupamientos de miles: 1,234.5 y 1 234.5, por ejemplo. Los separadores solo se eliminan si el grupo completo respeta la forma prevista. El último fullmatch verifica toda la cadena restante, no solo el primer número que pudiera encontrar.
Estos son ejemplos de esta función, independientes de las predicciones del modelo:
Cadena pasada a number |
Valor o rechazo |
|---|---|
2 MWh |
Número 2, sin conversión en esta etapa. |
1,234.5 kWh |
Número 1234.5. |
1 234.5 |
Número 1234.5, con un espacio ordinario. |
1.25e3 |
Número equivalente a 1250; e3 significa «por mil». |
−2.5 MWh |
Número -2.5. |
1,5 |
Rechazo: unsupported_numeric_format. |
1,234 |
Número 1234, no el decimal francés 1,234. |
Atención a las convenciones locales. El código prevé un punto decimal y ciertas escrituras de miles. No reconoce automáticamente los usos de cada idioma. Sustituir todas las comas por puntos no sería una mejora neutra: cambiaría en particular la interpretación de 1,234.
La conversión a Decimal llega después de comprobar la forma. NaN, que designa un valor «no numérico», e Infinity ya quedan rechazados por el patrón numérico. La comprobación is_finite() completa los controles, y un valor absoluto superior a 1e12, es decir, un billón, activa numeric_range. Esta función no prohíbe los números negativos: su pertinencia depende después del contrato de negocio.
Sobre todo, number no reemplaza a recognized_unit. Por ejemplo, eliminar las unidades de 2 MWh kWh puede dejar el número 2. Es precisamente el control separado de las unidades el que debe rechazar este texto conflictivo. Una conversión numérica correcta no basta para aceptar el dato.
¿Por qué Decimal y una conversión separada?
Construir Decimal a partir del texto conserva su representación decimal sin pasar primero por un flotante binario. Por ejemplo, Decimal("0.1") + Decimal("0.2") da exactamente Decimal("0.3"). En cambio, este tipo no ofrece precisión infinita para todas las operaciones: una división como un tercio depende del contexto de precisión y redondeo. La documentación Python de Decimal explica esta diferencia.
canonical realiza después una multiplicación. Para 2 MWh, number devuelve 2 y el factor vale 1000: obtenemos 2000 kWh. Para 2 kWh, el factor vale 1: obtenemos 2 kWh. La conversión utiliza el factor proporcionado; no redescubre la unidad.
El límite de 1e12 se comprueba antes de esta multiplicación. Por tanto, no debe presentarse como un techo de 1e12 kWh para todos los valores convertidos. Del mismo modo, esta pequeña función no verifica que el texto de origen fuera verdadero. Cada control tiene una función precisa, no una garantía general.
Calcular únicamente con los valores aceptados
Pasemos a src/pdfcharts/calculate.py. En este punto, los números están expresados en kWh. La función ya no recibe la imagen ni la tabla sin procesar de DePlot: recibe una estructura preparada previamente.
def calculate(table):
    result = {}
    for series in table["series"]:
        values = {
            row["category"]: Decimal(row["canonical_kwh"])
            for row in table["values"]
            if row["series"] == series
        }
        if not all(re.fullmatch(r"[0-9]{4}", year) for year in values):
            raise ValueError("unsupported_category_order")
        years = sorted(values, key=int)
        first, last = values[years[0]], values[years[-1]]
        result[series] = {
            "first_category": years[0],
            "last_category": years[-1],
            "first_kwh": str(first),
            "last_kwh": str(last),
            "sum_kwh": str(sum(values.values())),
            "minimum_kwh": str(min(values.values())),
            "maximum_kwh": str(max(values.values())),
            "variation": str((last - first) / first) if first != 0 else None,
            "variation_status": "DEFINED" if first != 0 else "UNDEFINED_ZERO_BASELINE",
        }
    return result
El bucle trata cada serie por separado. El diccionario values asocia una categoría a su valor canónico y solo conserva las filas de la serie actual. Las cadenas numéricas vuelven a ser Decimal para las operaciones.
La prueba [0-9]{4} exige después cuatro cifras por categoría. 2020 es válido; Q1 2020 no lo es. Es un contrato de categorías anuales, no una ordenación universal de fechas. Además, la prueba no define un rango de años de negocio: controla la forma.
sorted(values, key=int) ordena numéricamente estas categorías. Por tanto, el primer y el último valor designan los extremos cronológicos, no el mínimo y el máximo. Una curva que subiera y luego bajara haría esta diferencia especialmente visible.
Para seguir el cálculo, aquí tiene un objeto mínimo ilustrativo, construido con los campos que lee la función. No es ni una exportación real del corpus ni el esquema completo del analizador. Solo contiene una serie para seguir siendo legible; las dos series Vega se tratan por separado mediante el mismo bucle.
{
  "series": ["A"],
  "values": [
    {"category": "2022", "series": "A", "canonical_kwh": "3000"},
    {"category": "2020", "series": "A", "canonical_kwh": "2000"}
  ]
}
El orden de entrada está invertido, pero el cálculo comienza efectivamente en 2020. Produce first_kwh = "2000", last_kwh = "3000", sum_kwh = "5000", minimum_kwh = "2000", maximum_kwh = "3000" y variation = "0.5", con el estado DEFINED.
La suma solo abarca los valores presentes. No inventa un valor para 2021 ni calcula el área bajo la curva. Para una serie que empezara en cero, variation sería None, sin eliminar por ello los demás resultados.
Las llamadas a str() conservan los resultados numéricos como cadenas en la salida. Por tanto, el frontend debe distinguir entre una cadena como "0.5", un porcentaje mostrado y la ausencia de un valor. El estado asociado permite precisamente no mostrar una variación indefinida como un cero.
Este extracto no es un validador autónomo de todas las tablas posibles. Supone en particular series no vacías y categorías únicas por serie. En una entrada fabricada con dos filas de la misma categoría, la construcción del diccionario conservaría la última; aquí no provocaría un error de duplicado. Estas garantías deben examinarse en la preparación y el analizador del proyecto antes de reutilizar la función en otro lugar. El cálculo no debe llamarse directamente sobre una estructura arbitraria salida del modelo.
Requisitos y comandos
Debe saber leer Python, manipular diccionarios y utilizar un terminal con Docker. No es necesario saber entrenar una red para seguir este experimento: DePlot permanece congelado.
El perfil de referencia utiliza Linux, Docker Engine, Compose, un controlador NVIDIA y NVIDIA Container Toolkit, con una RTX 3090 de 24 GiB. Las recomendaciones son 32 GiB de RAM y 25 GiB de disco. La RAM es la memoria de la máquina; los 24 GiB de la tarjeta corresponden a su memoria de vídeo, o VRAM. Estas indicaciones preparan el entorno, pero no constituyen mínimos garantizados para cualquier configuración. El perfil de CPU no está validado.
El controlador permite que Linux utilice la GPU. NVIDIA Container Toolkit proporciona la integración que permite a los contenedores acceder a ella; no sustituye la instalación del controlador en el host. Por eso, ver la tarjeta con nvidia-smi no basta: check_environment.py ejecuta el modelo en Docker para verificar este segundo nivel.
Descomprima el ZIP y abra un terminal en su raíz. Todos los comandos siguientes se ejecutan desde este directorio, en orden. El servicio acquisition recupera los recursos previstos; inference realiza las predicciones y los tratamientos asociados; tutorial prepara el corpus y las evaluaciones. La adquisición está separada, y los servicios de inferencia no consultan las etiquetas de referencia.
Paso 1 — preparar
Comencemos con las comprobaciones previas, la preparación, la construcción de los servicios y la adquisición del modelo. Terminaremos con un cálculo en el entorno de contenedores y con las pruebas del proyecto.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Cada comando debe terminar con un código de salida nulo, es decir, un código de éxito. Las comprobaciones son complementarias: una configuración Compose válida no prueba que el modelo se haya adquirido; una adquisición correcta no prueba que la GPU sea utilizable; unas pruebas correctas no prueban que todos los valores extraídos sean correctos.
Conserve las versiones y los archivos de la adquisición bloqueada del ZIP. Las documentaciones enlazadas en este artículo explican los mecanismos, pero sus ejemplos de instalación no sustituyen las dependencias del recorrido r001.
Paso 2 — construir la predicción
Ahora vamos a fabricar las páginas Vega, pedir las tablas a DePlot y analizar las salidas.
docker compose run --rm tutorial python -m pdfcharts.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m pdfcharts.cli infer --config configs/minimum.yaml
docker compose run --rm inference python -m pdfcharts.cli parse --config configs/minimum.yaml
prepare renderiza las 120 páginas del corpus y fija las regiones. El renderizado transforma la página PDF en imagen. infer produce la representación tabular; parse controla su estructura, sus series y sus unidades.
Antes de la evaluación, abra una imagen y su salida textual. Localice los años, los nombres de las series y la unidad. Examine después la tabla analizada o su motivo de rechazo. Debe poder seguir el recorrido de un valor sin consultar su respuesta esperada para «corregirlo».
Esta inspección responde a una pregunta útil: ¿el error ya estaba presente en la salida de DePlot o aparece durante su interpretación? Cambiar el analizador para ocultar una lectura incorrecta del modelo impediría saberlo.
Paso 3 — medir y controlar
Los dos primeros comandos siguientes calculan las estadísticas sobre las tablas aceptadas y luego evalúan los resultados. El tercero ya inicia el ejercicio sobre unidades, con configs/exercise.yaml.
Antes de ejecutar este bloque, anote su predicción para el ejercicio: ¿qué ocurre si 2 MWh se reescriben correctamente como 2000 kWh? ¿Y si desaparece la unidad? Detallaremos la solución en la sección dedicada al ejercicio, después de las medidas.
docker compose run --rm inference python -m pdfcharts.cli calculate --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfcharts.cli evaluate --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfcharts.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
docker compose down
calculate utiliza solo los valores aceptados; evaluate puede compararlos con las referencias separadas. exercise ejecuta el escenario proporcionado. Los dos comandos siguientes producen las figuras y ejecutan el control de archivos previsto por el proyecto. El nombre check_checkpoints.py no significa que haya habido entrenamiento: el modelo de este recorrido permanece congelado.
El último docker compose down detiene los servicios del proyecto. No es el comando de limpieza de las exportaciones: conserve las salidas para leerlas y utilice después la limpieza específica al final del artículo.
Medidas antes de las cifras
Medir la extracción sin confundir las poblaciones
Una métrica es una medida del comportamiento del programa. Antes de comparar dos números, hay que saber qué se ha contado y sobre qué ejemplos.
La tasa de aceptación es la proporción de gráficos para los que los controles autorizan una tabla y un cálculo. Aceptar más no siempre es mejor: aceptar una unidad ambigua sería un error, mientras que un rechazo explícito es el comportamiento buscado en ese caso.
La MAE, por Mean Absolute Error o error absoluto medio, es el promedio de los errores absolutos. En un ejemplo ficticio, valores esperados de 1000 y 2000 kWh, predichos como 990 y 2030 kWh, dan errores de 10 y 30 kWh. Por tanto, la MAE es (10 + 30) / 2 = 20 kWh. Los signos desaparecen: una subestimación no compensa una sobreestimación.
Aquí, esta MAE es condicional: solo se refiere a valores aceptados y comparables. No penaliza directamente los que no están disponibles para la comparación. Por tanto, un método que rechace los casos difíciles podría mostrar una MAE baja y proporcionar pocos valores. Lea el error junto con la aceptación y la cobertura, nunca por separado. La cobertura designa aquí los elementos realmente disponibles para compararse; no la suponga perfecta porque una tabla haya sido aceptada.
El recall de series indica si se recuperaron las series esperadas. En un ejemplo ficticio de cuatro series esperadas de las que se recuperan tres, este recall es 3/4 = 0,75. Valores exactos en una sola curva no compensan automáticamente olvidar la otra.
La precisión de unidad mide la corrección de la unidad reconocida entre las salidas no ambiguas. Una puntuación perfecta en este indicador no significa ni que todas las páginas hayan sido aceptadas ni que todos los números sean correctos.
Por último, el control aritmético compara las sumas, los extremos y las variaciones con los valores aceptados tras la conversión. Verifica el trabajo de la calculadora, no la fidelidad de esos valores a la imagen. En el ejemplo anterior, sumar correctamente 990 y 2030 da 3020, aunque la suma de los valores esperados sea 3000. El cálculo puede ser exacto con entradas inexactas.
Ver lo que producen los comandos
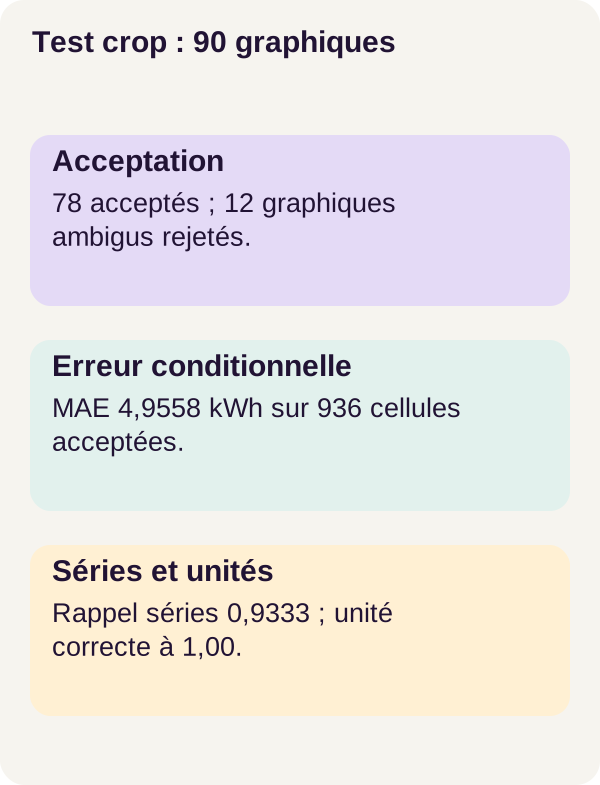
El recorrido principal incluye 90 páginas de prueba, de las cuales 12 gráficos ambiguos. La siguiente tabla recoge los resultados r001 informados para este conjunto, sin mezclarlos con las tres páginas del ejercicio.
| Medida en la prueba | Región proporcionada: modo crop | Página completa: modo full |
|---|---|---|
| Gráficos aceptados | 78/90 | 45/90 |
| MAE condicional, en kWh | 4,9558 | 26,4075 |
| Recall de series | 0,9333 | No cuantificado aquí |
| Precisión de unidad | 1,0000 | No cuantificada aquí |
Una medida no cuantificada en esta tabla no es un cero. Las poblaciones comparadas para la MAE dependen de las salidas aceptadas por cada modo.
El modo crop acepta los 78 gráficos no ambiguos y rechaza los 12 ambiguos, sin que se haya observado una aceptación peligrosa entre estos casos. Por tanto, su tasa de aceptación es de aproximadamente 86,7 %, frente al 50 % de la página completa. Estos porcentajes se calculan simplemente a partir de las fracciones mostradas.
El menor error condicional del crop es un resultado útil, pero conviene tener presentes dos límites. En primer lugar, los dos modos no aceptan exactamente la misma población: comparar las MAE no sustituye una comparación valor a valor sobre un conjunto común. En segundo lugar, el crop ya aporta al modelo la región pertinente; esta puntuación no mide su capacidad para encontrar por sí solo un gráfico en una página.
El recall de series de 0,9333 recuerda otro límite. Una tabla utilizable para las series que contiene no es necesariamente una reconstrucción exhaustiva de las series esperadas. Una serie completa omitida puede hacerse visible solo al compararla con la referencia, ya que la inferencia no tiene acceso a las respuestas.
Por tanto, la conclusión no es «todos los gráficos se leen bien». En este corpus sintético, el recorte proporcionado permite más tablas aceptadas y un menor error condicional. Siguen faltando series y las cifras no establecen ningún rendimiento sobre sus propios PDF.
Depurar y poner en producción
¿Se rechaza un valor? Vuelva primero a la exportación textual: ¿está presente la unidad? ¿El formato respeta la convención numérica? ¿Se pueden utilizar las series y categorías? No empiece añadiendo un factor 1000 «porque parece MWh».
Si el crop corta la leyenda, el modelo ya no recibe toda la información necesaria. Una región corregida constituye una nueva entrada que evaluar: conserve la antigua y la nueva, en lugar de reescribir retrospectivamente el resultado del recorrido de referencia.
En producción, versione el modelo, el renderizado del PDF, la región proporcionada, la tabla sin procesar, las conversiones y los motivos de rechazo. Esta trazabilidad permite remontarse desde un número mostrado hasta lo que realmente se procesó. Los datos utilizados en una decisión energética o en una factura también deben pasar por una revisión humana adecuada a lo que está en juego.
Lo que hemos aprendido
DePlot propone una tabla a partir de una imagen, sin reentrenamiento en este recorrido. El analizador le da una forma utilizable y después controles explícitos autorizan o rechazan los números y la unidad. La conversión canónica permite finalmente usar las mismas fórmulas con los valores aceptados.
Estas etapas responden a preguntas distintas: ¿he extraído el dato correcto? ¿Se puede interpretar sin ambigüedad? ¿He calculado correctamente a partir de él? Una sola métrica no responde a las tres.
También hemos visto que una variación relativa puede seguir siendo correcta pese a un error de escala, que una serie ausente puede escapar a un error medio condicional y que una unidad correctamente reconocida no garantiza que un número se haya leído correctamente. Son distinciones concretas que hay que conservar incluso en la interfaz.
Ejercicio — cambiar la unidad o hacerla ambigua
Retome las hipótesis anotadas antes del paso 3. El experimento se inicia mediante el subcomando exercise con configs/exercise.yaml, ya presente en esta secuencia. No requiere modificar el código validado. Los comandos de limpieza se encuentran más adelante, tras inspeccionar los resultados.
La pregunta es sencilla: ¿cambiar la escritura de una cantidad cambia necesariamente la cantidad misma? En nuestro ejemplo simplificado, 2 MWh pasan a ser 2000 kWh. La representación cambia, pero el valor canónico debe seguir siendo 2000 kWh. Para el segundo año, 3 MWh pasan a ser 3000 kWh: la variación permanece en 0.5.
Compárelo con otra operación, puramente ilustrativa: sustituir solo el texto MWh por kWh manteniendo el número 2. Esto no es una conversión de la misma cantidad. Ha descrito una cantidad mil veces menor. El programa no debe adivinar que quería conservar el valor anterior.
El escenario proporcionado incluye tres páginas, una de ellas ambigua. En los resultados de referencia, el modo crop acepta dos tablas y rechaza la página ambigua. Compare la unidad de origen, los valores canónicos y los motivos de rechazo con su predicción. Una conversión explícita conserva la magnitud; una unidad ausente no debe deducirse de lo que haría satisfactorio el resultado.
Este pequeño experimento verifica casos concretos. No demuestra que el modelo vaya a gestionar todos los formatos de ejes, todas las leyendas ni todas las unidades de un corpus real.
Decidir qué mostrar a un usuario
En una interfaz, una tabla aceptada debería mostrar la serie, las categorías, la unidad de origen, la unidad canónica y los resultados del cálculo. El PDF y la región procesada deben seguir siendo consultables para que el usuario pueda controlar la lectura. Se trata de un requisito para una integración, no del anuncio de un back-office ya proporcionado por este tutorial.
Para una salida rechazada, muestre el motivo: unidad ausente, unidades conflictivas, formato numérico no compatible o estructura de serie inutilizable. Ocultar estos casos daría la impresión de que los gráficos ignorados contienen ceros o no existen.
Por último, distinga valor nulo, valor ausente y variación indefinida. Una serie que comienza en cero conserva un primer valor conocido; solo su variación relativa desde esa base es indefinida. El estado UNDEFINED_ZERO_BASELINE permite explicar esta situación sin eliminar toda la serie.
Salidas y fallos frecuentes
Después de infer, conserve la tabla sin procesar de DePlot. Después de parse, observe las unidades y categorías reconocidas, así como las series o tablas rechazadas. Después de calculate, controle las categorías inicial y final y el estado de variación.
Si hay varias unidades, el recorrido no proporciona una gestión general de gráficos con ejes múltiples. Rechace el caso según el contrato; dividirlo en subtables sería una adaptación que habría que diseñar y evaluar por separado, no un comportamiento que pueda atribuírsele implícitamente.
Si la imagen se renderiza mal o la leyenda es ilegible, inspeccione el PDF, el crop y su resolución antes de culpar al analizador. Este no puede recuperar un detalle que no se haya transmitido o extraído correctamente.
Producción, límites y limpieza
Pasar de este experimento a una aplicación exige medir la extracción en documentos autorizados y representativos de su uso. Las páginas Vega proporcionan un entorno controlado, no la diversidad de informes de clientes, escaneos degradados o gráficos reales.
Conserve para cada resultado la versión del documento, la página, la región de entrada, la versión del modelo, las unidades, las transformaciones y la decisión de aceptación o rechazo. Esta procedencia facilita la verificación; por sí sola no demuestra que cada valor sea correcto. El rectángulo del crop localiza la entrada, no constituye automáticamente una prueba precisa de cada número producido.
Añada derechos de acceso a los documentos, supervisión del servicio, pruebas con sus propios formatos y una revisión humana para las decisiones importantes. Una ausencia, una unidad ambigua o una región no válida nunca deben transformarse silenciosamente en una certeza.
Limpiar después de conservar los resultados
Copie las exportaciones y figuras útiles antes de ejecutar los dos comandos siguientes. El primero elimina las salidas; no inicia el ejercicio. La limpieza solo afecta a outputs/ y la última detención termina el recorrido Docker.
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Referencias para profundizar
El repositorio principal de DePlot documenta la conversión de una figura en su tabla subyacente. La documentación oficial de NVIDIA Container Toolkit explica la integración de GPU con contenedores.
Los enlaces complementarios a Transformers, Python y los prefijos de unidades aclaran los mecanismos presentados. Los ejemplos numéricos del artículo son pedagógicos; las medidas del corpus y del ejercicio siguen siendo las del recorrido r001. Para reproducirlo, utilice los archivos y configuraciones del ZIP en vez de sustituir sus versiones por las de un ejemplo documental reciente.
Un valor se vuelve utilizable cuando se puede recuperar de dónde procede, cómo se ha interpretado y por qué se ha autorizado su cálculo. Ese es el recorrido que hemos construido, sin confundir una predicción legible con una prueba.