





State sviluppando una dashboard. Per alimentarla, ricevete un PDF con un grafico, ma non il file di dati usato per disegnarlo. Sullo schermo sono ben visibili due curve, gli anni e una legenda. Nella vostra applicazione, però, vi serve altro: valori che potete archiviare, confrontare e usare in un calcolo.
Prendiamo la pagina fittizia Vega Energy Summary. Presenta due serie e un asse «Energy (MWh)». Come ritrovare i valori e calcolarne la variazione, senza confondere le serie né trasformare MWh in kWh nel momento sbagliato?
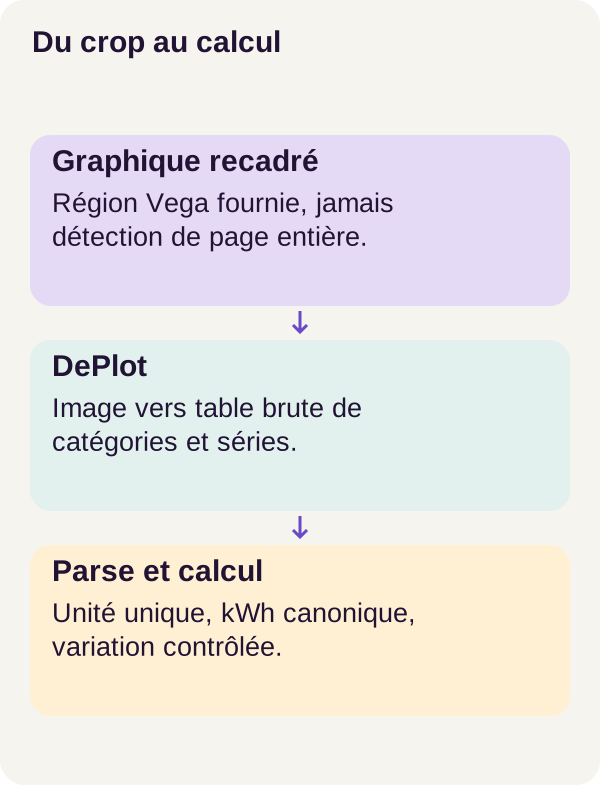
Useremo DePlot per proporre una tabella a partire dall'immagine. Poi il codice Python verificherà i numeri e le unità prima di eseguire i calcoli. Il modello estrae; il programma controlla e calcola. Questa separazione sarà il nostro filo conduttore.
Il problema concreto
Una risposta come «il consumo è aumentato del 50 %» può sembrare convincente. Tuttavia non dice se il modello ha letto gli anni corretti, conservato entrambe le serie o compreso l'unità. Anche una percentuale corretta può accompagnare quantità errate, come vedremo con un esempio.
Per uno sviluppatore web, il problema assomiglia a quello di un'importazione: ricevere testo non significa ancora disporre di dati validi. Occorre riconoscere la struttura, verificare i campi e conservare gli errori invece di trasformarli in valori predefiniti.
Il nostro percorso segue quindi immagine della pagina → tabella proposta → validazione → conversione in kWh → calcolo → valutazione. Un output rifiutato resta un risultato da esaminare, non un grafico i cui valori siano tutti zero.
Il corpus è sintetico: le pagine Vega sono state create per questo esperimento. Ciò permette di conoscere i valori attesi e confrontare le previsioni con un riferimento. Queste risposte di riferimento, talvolta chiamate labels o gold nel codice, servono alla valutazione. Non servono a correggere un'estrazione a posteriori.
Concetti prima del codice
Come DePlot passa dai pixel alla tabella
DePlot è un modello da immagine a testo basato sull'architettura Pix2Struct. Il suo input è un'immagine; il suo output è una tabella scritta come testo. Qui non recuperiamo il file di dati originale nascosto dietro la curva: il modello deve proporre una trascrizione da ciò che vede.
Il processore prepara l'input. Divide l'immagine in piccole parti, chiamate patch, e conserva informazioni sulla loro posizione. Una patch non è necessariamente una lettera o un punto della curva: è una zona dell'immagine trasformata in numeri.
L'encoder trasforma questi numeri in rappresentazioni utilizzabili dal modello. Il decoder produce poi l'output pezzo per pezzo. Questi pezzi di testo sono token: non corrispondono necessariamente a parole intere. Il prompt è l'istruzione che indica il compito da svolgere, qui la conversione del grafico in tabella. La documentazione DePlot di Transformers presenta questo compito; quella di Pix2Struct descrive l'architettura e la preparazione delle immagini.
Il modello resta congelato durante questo tutorial: i suoi parametri, o pesi, non vengono riaddestrati su Vega. Facciamo inferenza, cioè usiamo un modello già addestrato per produrre un output. Non c'è quindi né apprendimento sulle pagine del percorso né fine-tuning nascosto dietro la preparazione.
Produrre i token di un numero non garantisce che quel numero sia corretto. DePlot può omettere una serie o scrivere un valore vicino a quello atteso. Conserviamo la sua tabella grezza per poter risalire all'origine di un errore, prima di ogni trasformazione Python.
Dal tracciato a un dato utilizzabile
In Vega, una categoria è un anno, per esempio 2020. Una serie è una sequenza di valori associata a una curva. Per non mescolare due curve che passano per lo stesso anno, un valore deve restare collegato alla propria serie e categoria.
Il parsing, ossia l'analisi dell'output, consiste nel passare dal testo prodotto da DePlot a una struttura che il programma sa manipolare. Pensate alla lettura di un CSV: riconoscere righe e colonne non esime dal verificarne il contenuto.
L'unità è un campo a sé stante. 2 MWh e 2 kWh contengono lo stesso numero, ma non rappresentano la stessa quantità. I prefissi mega e kilo corrispondono rispettivamente a un milione e a mille; 1 MWh vale quindi 1000 kWh. La tabella dei prefissi del NIST riporta questi fattori.
Il progetto sceglie il kWh come unità canonica: tutte le quantità accettate sono espresse in questa unità comune prima delle operazioni. «Canonica» non significa «più vera»; significa semplicemente «rappresentazione interna scelta per evitare di mescolare le unità».
Tre funzioni si dividono questo lavoro. recognized_unit richiede una sola unità riconosciuta nel testo ricevuto. number trasforma una stringa conforme in un numero. canonical applica il fattore di conversione. Nessuna di queste fasi deve scegliere il fattore consultando il valore atteso nelle annotazioni.
Il calcolo arriva dopo l'accettazione
Una volta accettata la tabella, calculate lavora su valori numerici e categorie annuali. Ordina gli anni, poi calcola primo valore, ultimo valore, somma, minimo, massimo e variazione.
Il calcolo è deterministico: con gli stessi dati accettati e lo stesso contesto numerico, le formule seguono le stesse regole. Non chiediamo al modello di improvvisare un'addizione o di spiegare perché un risultato gli sembri plausibile.
Il programma usa Decimal, un tipo Python progettato per l'aritmetica decimale. Vedremo il suo ruolo nel codice. Per ora, ricordate soprattutto il confine: controllare il calcolo non controlla automaticamente la lettura del grafico.
Esempio di unità e variazione
Riprendiamo un esempio semplificato, pensato per capire il meccanismo e non per presentare una nuova misura del corpus. Una serie vale 2 MWh nel 2020, poi 3 MWh nel 2022.
Dopo la conversione otteniamo 2000 e 3000 kWh. Lo scarto è di 1000 kWh. La variazione relativa è (3000 - 2000) / 2000 = 0,5, cioè 50 %. Il codice restituisce il rapporto 0.5; la visualizzazione percentuale moltiplica questo rapporto per 100. Non è una crescita annuale: la formula confronta le due estremità del periodo.
Ecco la trappola: anche calcolare (3 - 2) / 2 dà 0,5. Un fattore identico applicato ai due valori si annulla nel rapporto. Una buona percentuale non prova quindi che le quantità assolute abbiano l'unità corretta.
Se la legenda indica solo «Energy», il contratto del progetto rifiuta il calcolo per mancanza di un'unità riconosciuta. Ciò non significa che un rapporto tra numeri sia matematicamente impossibile senza un'unità visualizzata: significa che il nostro programma non dispone delle informazioni richieste per accettare la tabella e le sue conversioni. Interpretare come kWh una quantità realmente espressa in MWh la dividerebbe per mille; fare il contrario la moltiplicherebbe per mille.
Altro caso: il primo valore è zero. La differenza con l'ultimo resta calcolabile, ma la formula della percentuale dividerebbe per zero. Il risultato diventa allora None, con lo stato UNDEFINED_ZERO_BASELINE. Visualizzare invece 0 % significherebbe «nessuna variazione», che è un'altra informazione.
Infine, bisogna decidere quale immagine fornire al modello. La modalità full usa l'intera pagina. La modalità crop usa una regione ritagliata fornita al programma, per concentrare l'input sul grafico anziché su titoli, loghi o tabelle vicine. Conservate questo rettangolo con i risultati: leggere un grafico già localizzato non significa rilevare automaticamente tutti i grafici di un rapporto.
Il codice centrale
Riconoscere l'unità, leggere il numero, convertire
L'estratto seguente proviene da src/pdfcharts/units.py. Contiene quattro piccole funzioni. Leggetele come le fasi di un'importazione dal formato volutamente limitato.
"""Recognize units in the extracted text; never infer a factor from gold."""

from decimal import Decimal, InvalidOperation
import re

UNIT = re.compile(r"(?<![A-Za-z])(kWh|MWh)(?![A-Za-z])", re.I)
FACTORS = {"kwh": Decimal(1), "mwh": Decimal(1000)}


def recognized_unit(raw):
    found = {m.group(1).lower() for m in UNIT.finditer(raw)}
    if len(found) != 1:
        raise ValueError("missing_unit" if not found else "conflicting_units")
    unit = next(iter(found))
    return {"unit": "kWh" if unit == "kwh" else "MWh", "factor": str(FACTORS[unit])}


def without_unit(text):
    return UNIT.sub("", text).strip().strip("()[]").strip()


def number(text):
    text = without_unit(text).replace("−", "-").strip()
    if re.fullmatch(r"[+-]?[0-9]{1,3}(,[0-9]{3})+(\.[0-9]+)?", text):
        text = text.replace(",", "")
    elif re.fullmatch(r"[+-]?[0-9]{1,3}( [0-9]{3})+(\.[0-9]+)?", text):
        text = text.replace(" ", "")
    if not re.fullmatch(
        r"[+-]?(?:[0-9]+(?:\.[0-9]*)?|\.[0-9]+)(?:[eE][+-]?[0-9]+)?", text
    ):
        raise ValueError("unsupported_numeric_format")
    try:
        value = Decimal(text)
    except InvalidOperation as exc:
        raise ValueError("invalid_number") from exc
    if not value.is_finite() or abs(value) > Decimal("1e12"):
        raise ValueError("numeric_range")
    return value


def canonical(value, unit):
    return value * Decimal(unit["factor"])
recognized_unit: un'unità distinta, non una sola occorrenza
UNIT è un'espressione regolare che cerca kWh o MWh. Il flag re.I ignora maiuscole e minuscole. I test attorno al gruppo evitano di riconoscerli quando sono direttamente attaccati a una lettera coperta da [A-Za-z]. Le operazioni del modulo re documentano questi meccanismi e le verifiche sull'intera stringa.
finditer() percorre le occorrenze trovate. La costruzione tra parentesi graffe crea un insieme, che conserva un solo esemplare di ogni unità dopo il passaggio in minuscolo. Il punto importante è quindi il numero di unità distinte: due menzioni di MWh non costituiscono un conflitto.
Su stringhe illustrative, la funzione si comporta così:
| Testo ricevuto | Decisione di recognized_unit |
|---|---|
Energy (MWh) |
Unità MWh, fattore "1000". |
MWh MWh |
Stessa unità ripetuta: accettata. |
Energy |
Rifiuto: missing_unit. |
Energy MWh / kWh |
Rifiuto: conflicting_units. |
Il contratto copre qui solo due unità. Per esempio, GWh non è riconosciuto: non riceve automaticamente un fattore perché un essere umano conosce questa conversione.
Resta un limite essenziale: questa funzione esamina il testo che riceve, non direttamente il grafico. Se il modello omette un'unità presente nell'immagine, l'espressione regolare non può ritrovarla. Il rifiuto delle ambiguità va quindi valutato anche sulle pagine, non solo sulle stringhe di test.
without_unit e number: accettare un formato definito
without_unit rimuove le menzioni di unità riconosciute e pulisce i bordi della stringa. number uniforma poi il segno meno tipografico − a -.
I primi due test riconoscono alcuni raggruppamenti delle migliaia: 1,234.5 e 1 234.5, per esempio. I separatori vengono rimossi solo se l'intero gruppo rispetta la forma prevista. L'ultimo fullmatch verifica tutta la stringa restante, non solo il primo numero che vi si potrebbe trovare.
Ecco esempi di questa funzione, indipendenti dalle previsioni del modello:
Stringa passata a number |
Valore o rifiuto |
|---|---|
2 MWh |
Numero 2, senza conversione in questa fase. |
1,234.5 kWh |
Numero 1234.5. |
1 234.5 |
Numero 1234.5, con uno spazio normale. |
1.25e3 |
Numero equivalente a 1250; e3 significa «per mille». |
−2.5 MWh |
Numero -2.5. |
1,5 |
Rifiuto: unsupported_numeric_format. |
1,234 |
Numero 1234, non il decimale francese 1,234. |
Attenzione alle convenzioni locali. Il codice prevede un punto decimale e alcune scritture delle migliaia. Non riconosce automaticamente le abitudini di ogni lingua. Sostituire tutte le virgole con punti non sarebbe un miglioramento neutro: cambierebbe in particolare l'interpretazione di 1,234.
La conversione in Decimal avviene dopo la verifica della forma. NaN, che indica un valore «non numerico», e Infinity sono già rifiutati dal modello numerico. Il controllo is_finite() completa le verifiche, e un valore assoluto superiore a 1e12, cioè mille miliardi, attiva numeric_range. I numeri negativi non sono vietati da questa funzione: la loro pertinenza dipende poi dal contratto di business.
Soprattutto, number non sostituisce recognized_unit. Per esempio, rimuovere le unità da 2 MWh kWh può lasciare il numero 2. È proprio il controllo separato delle unità che deve rifiutare questo testo conflittuale. Una conversione numerica riuscita non basta ad accettare il dato.
Perché Decimal e una conversione separata?
Costruire Decimal dal testo conserva la sua rappresentazione decimale senza passare prima da un float binario. Per esempio, Decimal("0.1") + Decimal("0.2") dà esattamente Decimal("0.3"). Tuttavia, questo tipo non offre precisione infinita per tutte le operazioni: una divisione come un terzo dipende dal contesto di precisione e arrotondamento. La documentazione Python di Decimal spiega questa distinzione.
canonical esegue poi una moltiplicazione. Per 2 MWh, number restituisce 2 e il fattore vale 1000: otteniamo 2000 kWh. Per 2 kWh, il fattore vale 1: otteniamo 2 kWh. La conversione usa il fattore fornito; non riscopre l'unità.
Il limite di 1e12 viene verificato prima di questa moltiplicazione. Non va quindi presentato come un tetto di 1e12 kWh su tutti i valori convertiti. Allo stesso modo, questa piccola funzione non verifica che il testo sorgente fosse vero. Ogni controllo ha un ruolo preciso, non una garanzia generale.
Calcolare solo sui valori accettati
Passiamo a src/pdfcharts/calculate.py. A questo punto, i numeri sono espressi in kWh. La funzione non riceve più l'immagine né la tabella grezza DePlot: riceve una struttura preparata a monte.
def calculate(table):
    result = {}
    for series in table["series"]:
        values = {
            row["category"]: Decimal(row["canonical_kwh"])
            for row in table["values"]
            if row["series"] == series
        }
        if not all(re.fullmatch(r"[0-9]{4}", year) for year in values):
            raise ValueError("unsupported_category_order")
        years = sorted(values, key=int)
        first, last = values[years[0]], values[years[-1]]
        result[series] = {
            "first_category": years[0],
            "last_category": years[-1],
            "first_kwh": str(first),
            "last_kwh": str(last),
            "sum_kwh": str(sum(values.values())),
            "minimum_kwh": str(min(values.values())),
            "maximum_kwh": str(max(values.values())),
            "variation": str((last - first) / first) if first != 0 else None,
            "variation_status": "DEFINED" if first != 0 else "UNDEFINED_ZERO_BASELINE",
        }
    return result
Il ciclo tratta ogni serie separatamente. Il dizionario values associa una categoria al suo valore canonico e conserva solo le righe della serie corrente. Le stringhe numeriche tornano a essere Decimal per le operazioni.
Il test [0-9]{4} impone poi quattro cifre per categoria. 2020 va bene; Q1 2020 no. È un contratto di categorie annuali, non un ordinamento universale delle date. Il test non definisce peraltro un intervallo di anni di business: controlla la forma.
sorted(values, key=int) ordina queste categorie numericamente. Il primo e l'ultimo valore designano quindi le estremità cronologiche, non il minimo e il massimo. Una curva che sale e poi scende renderebbe questa differenza particolarmente evidente.
Per seguire il calcolo, ecco un oggetto minimo illustrativo, costruito con i campi letti dalla funzione. Non è né un export reale del corpus né lo schema completo del parser. Contiene una sola serie per restare leggibile; le due serie Vega sono trattate separatamente dallo stesso ciclo.
{
  "series": ["A"],
  "values": [
    {"category": "2022", "series": "A", "canonical_kwh": "3000"},
    {"category": "2020", "series": "A", "canonical_kwh": "2000"}
  ]
}
L'ordine di input è invertito, ma il calcolo inizia davvero nel 2020. Produce first_kwh = "2000", last_kwh = "3000", sum_kwh = "5000", minimum_kwh = "2000", maximum_kwh = "3000" e variation = "0.5", con lo stato DEFINED.
La somma riguarda solo i valori presenti. Non inventa un valore per il 2021 e non calcola l'area sotto la curva. Per una serie che iniziasse da zero, variation sarebbe None, senza eliminare per questo gli altri risultati.
Le chiamate a str() conservano i risultati numerici come stringhe nell'output. Il frontend deve quindi distinguere una stringa come "0.5", una percentuale visualizzata e un'assenza di valore. Lo stato associato permette proprio di non mostrare una variazione indefinita come uno zero.
Questo estratto non è un validatore autonomo di tutte le tabelle possibili. Presuppone in particolare serie non vuote e categorie uniche per serie. In un input costruito con due righe della stessa categoria, la costruzione del dizionario conserverebbe l'ultima; qui non attiverebbe un errore di duplicato. Queste garanzie vanno esaminate nella preparazione e nel parser del progetto prima di riutilizzare la funzione altrove. Il calcolo non deve essere chiamato direttamente su una struttura arbitraria uscita dal modello.
Prerequisiti e comandi
Dovete saper leggere Python, manipolare dizionari e usare un terminale con Docker. Non è necessario saper addestrare una rete per seguire questo esperimento: DePlot resta congelato.
Il profilo di riferimento usa Linux, Docker Engine, Compose, un driver NVIDIA e NVIDIA Container Toolkit, su una RTX 3090 da 24 Gio. Le raccomandazioni sono 32 Gio di RAM e 25 Gio di disco. La RAM è la memoria della macchina; i 24 Gio della scheda corrispondono alla sua memoria video, o VRAM. Queste indicazioni preparano l'ambiente, non costituiscono minimi garantiti per ogni configurazione. Il profilo CPU non è validato.
Il driver rende la GPU utilizzabile da Linux. NVIDIA Container Toolkit fornisce l'integrazione che consente ai container di accedervi; non sostituisce l'installazione del driver sull'host. Per questo vedere la scheda con nvidia-smi non basta: check_environment.py esegue il modello in Docker per verificare questo secondo livello.
Decomprimete lo ZIP e aprite un terminale nella sua radice. Tutti i comandi seguenti vanno lanciati da questa directory, nell'ordine. Il servizio acquisition recupera gli asset previsti; inference esegue le previsioni e i trattamenti associati; tutorial prepara il corpus e le valutazioni. L'acquisizione è separata e i servizi di inferenza non consultano le label di riferimento.
Passaggio 1 — preparare
Cominciamo con i controlli preliminari, la preparazione, la costruzione dei servizi e l'acquisizione del modello. Concluderemo con un calcolo nell'ambiente containerizzato e con i test del progetto.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Ogni comando deve terminare con un codice di ritorno nullo, cioè un codice di successo. Le verifiche sono complementari: una configurazione Compose valida non prova che il modello sia stato acquisito; un'acquisizione riuscita non prova che la GPU sia utilizzabile; test riusciti non provano che tutti i valori estratti saranno corretti.
Conservate le versioni e i file dell'acquisizione bloccata nello ZIP. Le documentazioni collegate in questo articolo spiegano i meccanismi, ma i loro esempi di installazione non sostituiscono le dipendenze del percorso r001.
Passaggio 2 — costruire la previsione
Ora creeremo le pagine Vega, chiederemo le tabelle a DePlot, quindi analizzeremo gli output.
docker compose run --rm tutorial python -m pdfcharts.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m pdfcharts.cli infer --config configs/minimum.yaml
docker compose run --rm inference python -m pdfcharts.cli parse --config configs/minimum.yaml
prepare renderizza le 120 pagine del corpus e fissa le regioni. Il rendering trasforma la pagina PDF in immagine. infer produce la rappresentazione tabellare; parse controlla la struttura, le serie e le unità.
Prima della valutazione, aprite un'immagine e il suo output testuale. Ritrovate gli anni, i nomi delle serie e l'unità. Esaminate poi la tabella analizzata o il motivo del rifiuto. Dovete poter seguire il percorso di un valore senza consultare la risposta attesa per «correggerlo».
Questa ispezione risponde a una domanda utile: l'errore era già presente nell'output DePlot oppure compare durante la sua interpretazione? Modificare il parser per mascherare una lettura errata del modello impedirebbe di saperlo.
Passaggio 3 — misurare e controllare
I primi due comandi qui sotto calcolano le statistiche sulle tabelle accettate, poi valutano i risultati. Il terzo avvia già l'esercizio sulle unità, con configs/exercise.yaml.
Prima di lanciare questo blocco, annotate la vostra previsione per l'esercizio: cosa succede se 2 MWh vengono correttamente riscritti come 2000 kWh? E se l'unità scompare? Spiegheremo la soluzione nella sezione dedicata all'esercizio, dopo le misure.
docker compose run --rm inference python -m pdfcharts.cli calculate --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfcharts.cli evaluate --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfcharts.cli exercise --config configs/exercise.yaml
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
docker compose down
calculate usa solo valori accettati; evaluate può confrontarli con i riferimenti separati. exercise avvia lo scenario fornito. I due comandi seguenti producono le figure ed eseguono il controllo dei file previsto dal progetto. Il nome check_checkpoints.py non significa che sia avvenuto un addestramento: il modello di questo percorso resta congelato.
L'ultimo docker compose down arresta i servizi del progetto. Non è il comando di pulizia degli export: conservate gli output per leggerli, poi usate la pulizia mirata alla fine dell'articolo.
Misure prima dei numeri
Misurare l'estrazione senza confondere le popolazioni
Una metrica è una misura del comportamento del programma. Prima di confrontare due numeri, bisogna sapere cosa è stato contato e su quali esempi.
Il tasso di accettazione è la proporzione di grafici per i quali i controlli autorizzano una tabella e un calcolo. Accettarne di più non è sempre meglio: accettare un'unità ambigua sarebbe un errore, mentre in questo caso un rifiuto esplicito è il comportamento desiderato.
La MAE, per Mean Absolute Error, è l'errore assoluto medio. In un esempio fittizio, valori attesi di 1000 e 2000 kWh, previsti a 990 e 2030 kWh, danno errori di 10 e 30 kWh. La MAE vale quindi (10 + 30) / 2 = 20 kWh. I segni scompaiono: una sottostima non compensa una sovrastima.
Qui questa MAE è condizionale: riguarda solo valori accettati e confrontabili. Non penalizza direttamente quelli non disponibili per il confronto. Un metodo che rifiutasse i casi difficili potrebbe quindi mostrare una MAE bassa fornendo però pochi valori. Leggete l'errore insieme all'accettazione e alla copertura, mai da solo. Qui la copertura indica gli elementi effettivamente disponibili per il confronto; non supponetela perfetta perché una tabella è stata accettata.
Il richiamo delle serie indica se le serie attese sono state ritrovate. In un esempio fittizio di quattro serie attese, di cui tre ritrovate, questo richiamo vale 3/4 = 0,75. Valori esatti su una sola curva non compensano automaticamente l'omissione dell'altra.
La precisione dell'unità misura la correttezza dell'unità riconosciuta tra gli output non ambigui. Un punteggio perfetto su questo indicatore non significa né che tutte le pagine siano state accettate né che tutti i numeri siano corretti.
Infine, il controllo aritmetico confronta somme, estremi e variazioni con i valori accettati dopo conversione. Verifica il lavoro del calcolatore, non la fedeltà di quei valori all'immagine. Nell'esempio precedente, sommare 990 e 2030 dà correttamente 3020, mentre la somma dei valori attesi è 3000. Il calcolo può essere esatto su input inesatti.
Vedere cosa producono i comandi
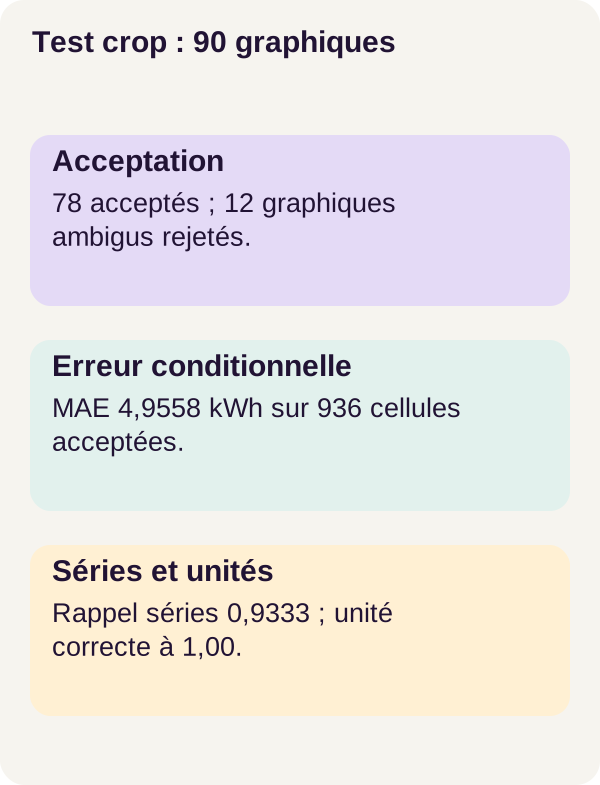
Il percorso principale comprende 90 pagine di test, di cui 12 grafici ambigui. La tabella seguente riprende i risultati r001 riportati per questo insieme, senza mescolarli con le tre pagine dell'esercizio.
| Misura sul test | Regione fornita: modalità crop | Pagina intera: modalità full |
|---|---|---|
| Grafici accettati | 78/90 | 45/90 |
| MAE condizionale, in kWh | 4,9558 | 26,4075 |
| Richiamo delle serie | 0,9333 | Non quantificato qui |
| Precisione dell'unità | 1,0000 | Non quantificata qui |
Una misura non quantificata in questa tabella non è zero. Le popolazioni confrontate per la MAE dipendono dagli output accettati da ciascuna modalità.
La modalità crop accetta i 78 grafici non ambigui e rifiuta i 12 ambigui, senza accettazione rischiosa osservata tra questi casi. Il suo tasso di accettazione è quindi circa 86,7 %, contro il 50 % per l'intera pagina. Queste percentuali sono semplicemente calcolate dalle frazioni visualizzate.
L'errore condizionale più basso del crop è un risultato utile, ma bisogna tenere presenti due limiti. Prima, le due modalità non accettano esattamente la stessa popolazione: confrontare le MAE non sostituisce un confronto valore per valore su un insieme comune. Poi, il crop fornisce già al modello la regione pertinente; questo punteggio non misura la sua capacità di trovare da solo un grafico in una pagina.
Il richiamo delle serie di 0,9333 ricorda un altro limite. Una tabella utilizzabile per le serie che contiene non è necessariamente una ricostruzione esaustiva delle serie attese. L'omissione di un'intera serie può diventare visibile solo nel confronto con il riferimento, poiché l'inferenza non accede alle risposte.
Il risultato da ricordare non è quindi «i grafici sono tutti letti bene». Su questo corpus sintetico, il ritaglio fornito consente più tabelle accettate e un errore condizionale minore. Mancano ancora serie e i numeri non stabiliscono alcuna prestazione sui vostri PDF.
Risolvere problemi e mettere in produzione
Un valore viene rifiutato? Tornate prima all'export testuale: l'unità è presente? Il formato rispetta la convenzione numerica? Serie e categorie sono utilizzabili? Non iniziate aggiungendo un fattore 1000 «perché assomiglia a dei MWh».
Se il crop taglia la legenda, il modello non riceve più tutte le informazioni necessarie. Una regione corretta costituisce un nuovo input da valutare: conservate quella vecchia e quella nuova, invece di riscrivere retrospettivamente il risultato del percorso di riferimento.
In produzione, versionate il modello, il rendering PDF, la regione fornita, la tabella grezza, le conversioni e i motivi di rifiuto. Questa tracciabilità permette di risalire da un numero visualizzato a ciò che è stato realmente elaborato. I dati usati in una decisione energetica o in una fattura devono inoltre passare per una revisione umana adeguata alla posta in gioco.
Cosa abbiamo imparato
DePlot propone una tabella a partire da un'immagine, senza riaddestramento in questo percorso. Il parser le dà una forma utilizzabile, poi controlli espliciti autorizzano o rifiutano numeri e unità. La conversione canonica permette infine di usare le stesse formule sui valori accettati.
Queste fasi rispondono a domande diverse: ho estratto il dato corretto? È interpretabile senza ambiguità? Ho calcolato correttamente a partire da esso? Una sola metrica non risponde a tutte e tre.
Abbiamo anche visto che una variazione relativa può restare corretta nonostante un errore di scala, che una serie assente può sfuggire a un errore medio condizionale e che un'unità riconosciuta correttamente non garantisce un numero letto correttamente. Sono distinzioni concrete da mantenere anche nell'interfaccia.
Esercizio — cambiare l'unità o renderla ambigua
Riprendete le ipotesi annotate prima del passaggio 3. L'esperimento viene avviato dal sottocomando exercise con configs/exercise.yaml, già presente in questa sequenza. Non richiede di modificare il codice validato. I comandi di pulizia si trovano più avanti, dopo l'ispezione dei risultati.
La domanda è semplice: cambiare la scrittura di una quantità cambia necessariamente la quantità stessa? Nel nostro esempio semplificato, 2 MWh diventano 2000 kWh. La rappresentazione cambia, ma il valore canonico deve restare 2000 kWh. Per il secondo anno, 3 MWh diventano 3000 kWh: la variazione resta 0.5.
Confrontate questo con un'altra operazione, puramente illustrativa: sostituire solo il testo MWh con kWh mantenendo il numero 2. Questa non è una conversione della stessa quantità. Avete descritto una quantità mille volte più piccola. Il programma non deve indovinare che volevate conservare il valore precedente.
Lo scenario fornito comprende tre pagine, di cui una ambigua. Nei risultati di riferimento, la modalità crop accetta due tabelle e rifiuta la pagina ambigua. Confrontate l'unità sorgente, i valori canonici e i motivi del rifiuto con la vostra previsione. Una conversione esplicita conserva la grandezza; un'unità mancante non va dedotta da ciò che renderebbe il risultato soddisfacente.
Questo piccolo esperimento verifica casi precisi. Non dimostra che il modello saprà gestire tutti i formati di assi, tutte le legende o tutte le unità di un corpus reale.
Decidere cosa mostrare a un utente
In un'interfaccia, una tabella accettata dovrebbe mostrare la serie, le categorie, l'unità sorgente, l'unità canonica e i risultati del calcolo. Il PDF e la regione elaborata devono restare consultabili affinché l'utente possa controllare la lettura. Si tratta di un requisito per un'integrazione, non dell'annuncio di un back-office già fornito da questo tutorial.
Per un output rifiutato, visualizzate il motivo: unità mancante, unità conflittuali, formato numerico non supportato o struttura di serie inutilizzabile. Nascondere questi casi darebbe l'impressione che i grafici ignorati contengano zeri o non esistano.
Infine, distinguete valore nullo, valore assente e variazione indefinita. Una serie che inizia da zero conserva un primo valore noto; solo la sua variazione relativa da questa base è indefinita. Lo stato UNDEFINED_ZERO_BASELINE permette di spiegare questa situazione senza eliminare l'intera serie.
Output e guasti frequenti
Dopo infer, conservate la tabella grezza DePlot. Dopo parse, osservate le unità e le categorie riconosciute, così come le serie o tabelle rifiutate. Dopo calculate, controllate le categorie iniziale e finale e lo stato della variazione.
Se sono presenti più unità, il percorso non fornisce una gestione generale dei grafici ad assi multipli. Rifiutate il caso secondo il contratto; dividerlo in sotto-tabelle sarebbe un adattamento da progettare e valutare separatamente, non un comportamento da attribuirgli implicitamente.
Se l'immagine è renderizzata male o la legenda è illeggibile, ispezionate il PDF, il crop e la sua risoluzione prima di accusare il parser. Quest'ultimo non può recuperare un dettaglio che non gli è stato trasmesso o estratto correttamente.
Produzione, limiti e pulizia
Passare da questo esperimento a un'applicazione richiede di misurare l'estrazione su documenti autorizzati e rappresentativi del vostro utilizzo. Le pagine Vega offrono un ambiente controllato, non la varietà di rapporti clienti, scansioni degradate o grafici reali.
Conservate per ogni risultato la versione del documento, la pagina, la regione di input, la versione del modello, le unità, le trasformazioni e la decisione di accettazione o rifiuto. Questa provenienza facilita la verifica; da sola non prova che ogni valore sia corretto. Il rettangolo del crop localizza l'input, non costituisce automaticamente una prova precisa per ciascuno dei numeri prodotti.
Aggiungete diritti di accesso ai documenti, monitoraggio del servizio, test sui vostri formati e una revisione umana per le decisioni a rischio. Un'assenza, un'unità ambigua o una regione non valida non devono mai essere trasformate silenziosamente in certezza.
Pulire dopo aver conservato i risultati
Copiate gli export e le figure utili prima di lanciare i due comandi seguenti. Il primo elimina gli output; non avvia l'esercizio. La pulizia riguarda solo outputs/, poi l'ultimo arresto termina il percorso Docker.
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Riferimenti per approfondire
Il repository principale di DePlot documenta la conversione di una figura nella tabella sottostante. La documentazione ufficiale di NVIDIA Container Toolkit spiega l'integrazione della GPU con i container.
I link complementari a Transformers, Python e ai prefissi delle unità chiariscono i meccanismi presentati. Gli esempi numerici dell'articolo sono didattici; le misure del corpus e dell'esercizio restano quelle del percorso r001. Per riprodurlo, usate i file e le configurazioni dello ZIP invece di sostituire le sue versioni con quelle di un esempio documentale recente.
Un valore diventa utilizzabile quando si può ritrovare da dove proviene, come è stato interpretato e perché il suo calcolo è stato autorizzato. È questo il percorso che abbiamo costruito, senza confondere una previsione leggibile con una prova.