





Imaginez le centre d’aide de votre application web. Un utilisateur signale que des messages restent bloqués dans une file après l’arrêt d’un worker. Votre moteur de recherche retrouve une fiche expliquant comment redémarrer ce worker. C’est utile, mais une seconde fiche décrit comment rejouer les messages restés sans confirmation de traitement. Elle aussi répond au problème.
Comment apprendre au moteur à retrouver ces deux procédures, sans les confondre avec d’autres fiches qui emploient les mêmes mots mais décrivent un incident différent ?
Nous allons adapter un modèle d’embeddings : le programme qui transforme les textes en vecteurs pour les comparer. Le point délicat ne sera pas seulement de rapprocher une question d’une bonne réponse. Il faudra aussi éviter qu’une deuxième bonne réponse devienne, par erreur, un exemple à repousser pendant l’entraînement.
Télécharger le projet complet du tutoriel
Ce que nous construisons
Le projet construit un petit moteur de recherche sur un corpus de support synthétique. Il encode les requêtes et les procédures avec un même encodeur, sélectionne des documents trompeusement proches, puis entraîne cet encodeur avec une perte contrastive multi-positifs. Enfin, il conserve les classements et calcule deux métriques : Recall@5 et MRR@10.
Dit autrement, nous voulons modifier ce que le modèle considère comme « proche ». Deux procédures différentes peuvent être pertinentes pour la même demande ; leur différence ne doit pas suffire à en faire des concurrentes incompatibles.
Le parcours sépare trois responsabilités : les annotations définissent les procédures pertinentes ; l’entraînement utilise ces annotations pour adapter le modèle ; l’évaluation vérifie ensuite où les procédures apparaissent dans les résultats. Le modèle ne définit pas lui-même les bonnes réponses à partir de ses préférences.
Ce programme retrouve et classe des documents. Il ne construit ni RAG complet — une recherche documentaire suivie d’une génération de réponse — ni règle métier qui déciderait comment résoudre automatiquement un incident.
Concepts expliqués avant le code
Un embedding : des coordonnées pour comparer des textes
Un embedding est une liste de nombres calculée à partir d’un texte. Vous pouvez l’imaginer comme les coordonnées d’un point : deux textes dont les vecteurs sont proches sont considérés comme similaires par le modèle.
Nous ne choisissons pas à la main un axe « panne » et un axe « redémarrage ». Les paramètres du réseau, aussi appelés poids, déterminent comment les textes deviennent des coordonnées. Adapter ces paramètres change donc la représentation produite, sans modifier le texte des procédures.
Le modèle utilisé est sentence-transformers/all-MiniLM-L6-v2, verrouillé à la révision 1110a243fdf4706b3f48f1d95db1a4f5529b4d41 dans locks/models.lock.json. Sa fiche officielle à cette révision décrit des vecteurs de 384 coordonnées. Un identifiant de document permet de retrouver une fiche ; son embedding sert à la comparer à une requête. Les deux ne sont pas interchangeables.
Du texte à un seul vecteur
Le calcul comporte plusieurs transformations. Le tokenizer découpe le texte en unités, les tokens, puis les remplace par des identifiants numériques. Un token peut être un mot ou un morceau de mot : il ne correspond pas forcément à un mot séparé par des espaces.
Le Transformer calcule ensuite un vecteur par position en tenant compte du contexte. Nous avons donc plusieurs vecteurs pour un texte, alors que la recherche en attend un seul. Le pooling moyen les rassemble en calculant une moyenne, coordonnée par coordonnée.
Il faut cependant ignorer le padding : les positions de remplissage ajoutées pour que plusieurs textes tiennent dans un tableau de même largeur. Le masque d’attention indique les positions utilisées, avec 1 pour celles à conserver et 0 pour le remplissage.
Prenons un exemple pédagogique à deux coordonnées, sans rapport avec les vecteurs réellement produits par MiniLM. Deux positions utiles valent [1, 2] et [5, 6]. Une troisième position est du remplissage. Avec un masque [1, 1, 0], la moyenne vaut [(1 + 5) / 2, (2 + 6) / 2], soit [3, 4]. La troisième position ne participe ni à la somme ni au dénominateur.
Normaliser : comparer les directions plutôt que la taille
Le parcours applique ensuite F.normalize(..., dim=-1). Cette opération divise chaque vecteur par sa norme, avec une protection pour les valeurs très petites. La norme est ici sa longueur géométrique : pour [3, 4], elle vaut sqrt(3² + 4²) = 5. Le vecteur normalisé devient donc [0.6, 0.8], dont la norme vaut 1.
Le produit scalaire multiplie les coordonnées correspondantes, puis additionne les résultats. Pour deux vecteurs de norme 1, il correspond à leur similarité cosinus, c’est-à-dire une comparaison de leurs directions. Par exemple, [0.6, 0.8] comparé à lui-même donne 0.6² + 0.8² = 1.
Sans cette normalisation, un vecteur plus long pourrait obtenir un produit scalaire supérieur simplement à cause de sa taille. Nous cherchons ici une proximité de représentation, pas un concours de longueur. La documentation de normalize précise aussi le traitement des normes très petites.
Un score de similarité n’est pas une preuve de pertinence métier. Deux fiches peuvent parler du même composant sans recommander la bonne action pour le même incident.
Positifs, négatifs et exemples trompeurs
Un positif est un document annoté comme pertinent pour une requête. Un négatif est utilisé comme contre-exemple pour cette requête. Ces rôles dépendent de la demande : une procédure peut être pertinente pour une question et pas pour une autre.
Un négatif difficile, ou hard negative, est un contre-exemple auquel le modèle donne pourtant un score élevé. Il permet de travailler précisément une confusion. Une fiche qui parle de la même file de messages mais traite un autre problème peut être plus instructive qu’une fiche sans rapport avec les files.
Le mining désigne la sélection de ces contre-exemples. Il utilise le classement du modèle pour trouver les candidats proches, mais s’appuie sur les annotations pour exclure les bonnes réponses. La documentation Sentence Transformers sur les négatifs difficiles présente ce principe général ; le tutoriel conserve son propre code de sélection.
Le danger est le faux négatif : une procédure réellement pertinente que l’entraînement traite comme incorrecte. Avec deux positifs, une convention qui n’en reconnaîtrait qu’un créerait précisément cette erreur.
Une perte contrastive : apprendre par comparaison
Une perte, ou loss, est le nombre que l’entraînement cherche à réduire. Une perte contrastive compare des candidats : elle encourage ici le modèle à donner davantage de poids aux documents pertinents qu’aux autres.
La rétropropagation calcule les gradients, qui indiquent comment une variation des paramètres ferait varier cette perte. L’optimiseur utilise ces informations pour mettre à jour les poids. Les tutoriels PyTorch sur les gradients et l’optimisation détaillent ce cycle. Calculer des embeddings avec un modèle déjà chargé, sans modifier ses poids, relève au contraire de l’inférence.
Notre adaptation part d’un modèle existant : nous n’apprenons pas à lire les textes depuis zéro. Nous lui fournissons une supervision plus précise sur les rapprochements attendus dans ce corpus.
Température et softmax : régler le poids des écarts
Le softmax transforme une ligne de scores en nombres positifs dont la somme vaut 1. Il utilise exp, la fonction exponentielle : une fonction croissante qui donne une valeur positive, y compris pour un score négatif. Pour le candidat j, il calcule exp(score_j) / somme(exp(scores)). Ces valeurs expriment une répartition entre les candidats considérés, pas une probabilité métier calibrée. La définition PyTorch du softmax formalise cette opération.
Pendant l’entraînement, les similarités sont divisées par une température positive avant ce calcul. Une petite température accentue les écarts ; une température plus élevée les atténue.
Par exemple, les similarités fictives [0.4, 0.2, 0, -0.2] deviennent les scores [2, 1, 0, -1] après division par 0.2. Le premier candidat reçoit alors environ 64,39 % de la masse du softmax, contre 32,92 % avec une température de 1. Ce sont des valeurs d’illustration, pas les réglages ni les mesures r1. Le classement ne change pas sous cette division positive ; l’importance accordée aux écarts change.
Enfin, log désigne ici le logarithme naturel, la fonction inverse de l’exponentielle. logsumexp calcule le logarithme d’une somme d’exponentielles de manière numériquement stable. Nous l’utiliserons pour réunir les contributions de plusieurs positifs sans calculer naïvement de très grandes exponentielles. La documentation de torch.logsumexp décrit cette opération.
Prérequis Docker et GPU
Vous devez pouvoir lire une fonction Python, manipuler des listes et des identifiants, et lancer des commandes dans un terminal. Le parcours r1 utilise Linux x86_64, Docker Compose, NVIDIA Container Toolkit et une RTX 3090 de 24 Gio.
Prévoyez également 16 Gio de RAM et 16 Gio de disque, hors couches Docker partagées. La RAM est la mémoire de l’hôte ; la mémoire de la carte graphique est la VRAM. Ces provisions décrivent le cadre du projet, pas des minima démontrés sur toutes les machines. Aucun profil CPU n’est présenté comme une reproduction validée du parcours GPU.
locks/models.lock.json fixe les actifs du modèle et locks/environment.lock.json l’environnement attendu. Gardez ces verrous pour reproduire l’expérience : remplacer une révision par la branche courante changerait les éléments que nous comparons.
Le service acquire est le seul qui télécharge les actifs du modèle. Le service gpu réalise ensuite les calculs locaux. Construire une image Docker et acquérir les poids sont deux opérations différentes : les poids sont les paramètres du modèle, pas le code Python qui les utilise.
Le contrôle d’environnement initialise CUDA et exécute un calcul dans le conteneur. Voir la carte depuis Linux ne suffit pas. Les documentations Docker Compose pour les GPU et NVIDIA Container Toolkit expliquent cette intégration.
Données et fonctions centrales
Connaître les bonnes réponses avant d’entraîner
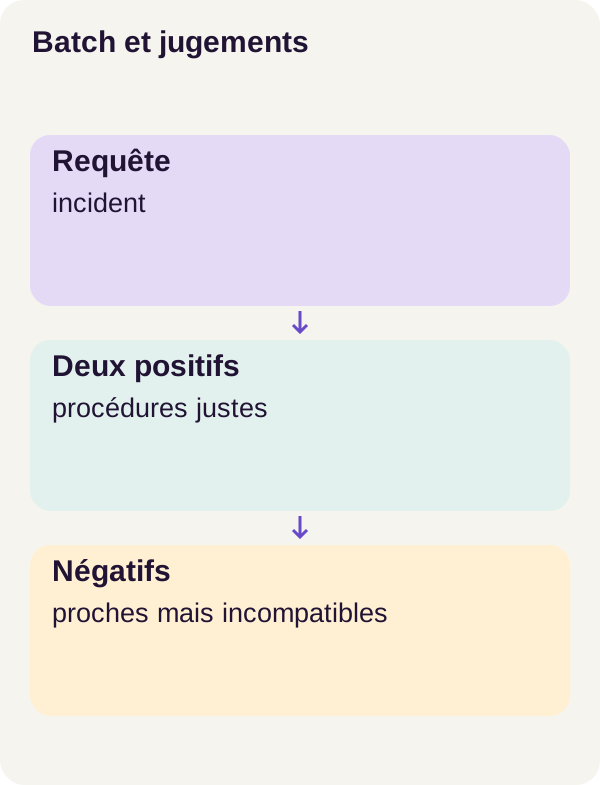
Le corpus synthétique comporte 240 documents et 72 requêtes de test. Chaque requête possède exactement deux positive_ids. Ces identifiants constituent la référence utilisée pour dire quelles procédures sont pertinentes.
Les familles sont séparées entre train, validation et test avant l’entraînement. Train fournit les exemples qui influencent les poids ; validation sert à observer les choix d’entraînement ; test reste réservé au classement final. Séparer les familles évite qu’une simple reformulation d’un même ensemble de cas se retrouve des deux côtés de l’évaluation.
Une requête d’entraînement ne mine que des documents d’entraînement. Le mining les classe avec le modèle courant, retire explicitement les deux IDs positifs, puis garde les négatifs. Il ne devine donc pas leur pertinence. Cette frontière empêche qu’une procédure de test soit déjà vue par l’optimiseur comme contre-exemple.
Ne confondez pas les 240 documents annoncés pour le corpus avec la population autorisée au mining d’entraînement : cette dernière est limitée au split train. Les effectifs détaillés et les appartenances se lisent dans les données préparées.
Notre fil rouge : deux procédures, pas deux copies
L’exemple r1 atlas-queue-q0 contient cette question :
The Atlas messages remain pending after the queue worker crashes. What should the operator do?
Pour la comprendre en français : « Les messages Atlas restent en attente après le plantage du worker de la file. Que doit faire l’opérateur ? » Cette traduction accompagne la lecture ; elle ne remplace pas le texte de l’expérience.
Un worker est le processus qui prend en charge les travaux d’une file. Un message non acquitté n’a pas reçu la confirmation attendue de son traitement. Rejouer un tel message demande de maîtriser les répétitions : une clé d’idempotence sert à identifier une opération afin d’éviter que son rejeu ne reproduise indûment ses effets.
Les deux procédures annotées répondent à des aspects distincts de cet incident :
| Identifiant positif | Rôle de la procédure dans cet exemple |
|---|---|
atlas-queue-procedure-a |
Inspecter et redémarrer le worker. |
atlas-queue-procedure-b |
Rejouer les messages non acquittés avec des clés d’idempotence. |
Nous ne cherchons pas à fusionner ces textes, ni à considérer que l’un remplace toujours l’autre. Les deux doivent rester positifs pour cette requête. Retrouver ces fiches ne constitue pas, à lui seul, une validation opérationnelle de leur exécution.
Construire le masque à partir des identifiants
Un batch, ou lot, rassemble plusieurs exemples traités ensemble. La matrice scores contient une ligne par requête et une colonne par document candidat. Sa forme est donc B × D, avec B requêtes et D documents.
positive_mask a exactement la même forme. Il contient True quand le document de la colonne est pertinent pour la requête de la ligne. Une même ligne peut donc contenir plusieurs True.
La fonction make_batch, dans src/contrastive_search/mining.py, construit ce masque à partir des identifiants, puis vérifie la présence de deux positifs par requête. C’est l’équivalent d’une jointure par clé dans une application : changer l’ordre des lignes ne doit pas changer leur sens.
Une diagonale ne marque que les positions où le numéro de ligne égale le numéro de colonne. Elle ne peut pas, à elle seule, représenter deux positifs sur une ligne. Une convention de position dans le lot ne doit donc pas remplacer nos annotations.
Lire le cœur de la perte
Voici l’extrait continu central de src/contrastive_search/losses.py. Il reçoit des scores déjà calculés, un masque de pertinence et, éventuellement, un masque des candidats inclus dans le calcul.
def multi_positive_nce(scores, positive_mask, allowed=None):
    if scores.ndim != 2 or positive_mask.shape != scores.shape:
        raise ValueError("B x D scores and positive mask required")
    allowed = (
        torch.ones_like(positive_mask, dtype=torch.bool) if allowed is None else allowed
    )
    if not torch.isfinite(scores).all():
        raise ValueError("Non-finite scores")
    if ((positive_mask & allowed).sum(1) == 0).any():
        raise ValueError("Each query needs an allowed positive")
    denominator = torch.logsumexp(scores.masked_fill(~allowed, -torch.inf), dim=1)
    numerator = torch.logsumexp(
        scores.masked_fill(~(positive_mask & allowed), -torch.inf), dim=1
    )
    return (denominator - numerator).mean()
Commençons par les entrées. scores est un tableau de nombres PyTorch, aussi appelé tenseur. positive_mask est le tableau de booléens qui lui correspond. Lorsque allowed n’est pas fourni, tous les candidats sont inclus.
Le nom allowed signifie ici « pris en compte dans la formule ». Ce masque n’est ni une authentification ni une règle de droits documentaires. Sur ces tableaux de booléens, ~ inverse True et False, tandis que & applique un « et » case par case.
Le dénominateur considère tous les candidats inclus. masked_fill(~allowed, -torch.inf) remplace les scores exclus par moins l’infini. Comme leur exponentielle vaut zéro, ils ne contribuent plus à la somme. dim=1 demande de faire ce calcul sur les colonnes, séparément pour chaque requête.
Le numérateur considère tous les positifs inclus. L’expression positive_mask & allowed conserve l’intersection des deux masques. Les deux bonnes procédures participent donc ensemble au numérateur, au lieu de n’en retenir qu’une.
Pour une requête, nous calculons ainsi :
L = log(somme des exp(scores) des candidats inclus) − log(somme des exp(scores) des positifs inclus).
Les noms denominator et numerator désignent, dans le code, les logarithmes de ces deux sommes. Leur différence équivaut à −log(numérateur / dénominateur). Le .mean() final moyenne cette perte sur les requêtes du lot, pas sur les documents positifs pris séparément.
Refaire un calcul à la main
Reprenons la ligne de démonstration [2, 1, 0, -1], avec les deux premiers documents positifs et tous les candidats inclus. Les quatre scores sont pédagogiques ; ils ne sont pas des sorties capturées du modèle.
| Colonne | Score | Document positif ? | Contribution exp(score), arrondie |
|---|---|---|---|
| 0 | 2 | Oui | 7,389056 |
| 1 | 1 | Oui | 2,718282 |
| 2 | 0 | Non | 1,000000 |
| 3 | −1 | Non | 0,367879 |
La somme de toutes les contributions vaut environ 11,475217. Celle des deux positifs vaut environ 10,107338. Le rapport vaut donc environ 0,880797, puis la perte −log(0,880797) vaut environ 0,126928.
Le modèle attribue ici environ 88,08 % de la masse du softmax à l’ensemble des bonnes réponses. La perte diminue lorsque cette masse se rapproche de 1. Les calculs numériques ci-dessus sont effectués avant arrondi des valeurs affichées.
Avec un masque ne déclarant que la colonne 0 positive, le numérateur ne garderait que 7,389056. La perte deviendrait environ 0,440190. Surtout, la colonne 1 resterait au dénominateur sans participer au numérateur : augmenter son score augmenterait la perte, alors que sa procédure est pertinente. Nous vérifierons le signe de son gradient dans l’exercice.
Ce que cette formule garantit, et ce qu’elle ne garantit pas
La fonction évite de traiter le second positif comme un négatif. Elle favorise cependant l’ensemble des positifs, sans exiger qu’ils reçoivent le même score. Ce n’est pas une moyenne de deux pertes indépendantes, chacune exigeant que son document gagne à elle seule.
Une bonne procédure peut donc recevoir l’essentiel de la masse du softmax, et l’autre beaucoup moins. Si tous les candidats inclus sont positifs, numérateur et dénominateur deviennent même identiques : la perte vaut zéro, quel que soit leur ordre.
Cela explique pourquoi nous mesurons ensuite la présence des deux procédures dans le top 5. Une perte faible ne suffit pas à démontrer que chacune est bien classée.
Les garde-fous ont également un périmètre précis. La fonction vérifie la forme de scores et de positive_mask, la finitude des scores et l’existence d’au moins un positif inclus par requête. Elle ne vérifie pas elle-même qu’il y en a exactement deux : ce contrôle appartient à make_batch. Les masques doivent être des booléens compatibles fournis par l’appelant.
Le contrôle des valeurs finies intervient avant le masquage. Un NaN ou un infini déjà présent dans scores est donc refusé même si sa colonne devait ensuite être exclue. Les moins l’infini introduits volontairement par masked_fill servent, eux, à retirer les contributions du calcul.
Enfin, cet extrait n’encode pas les textes, ne choisit pas les négatifs et ne divise pas les similarités par la température. Il ne contient pas non plus de backward() ni de mise à jour des poids. Il calcule une perte différentiable que la boucle d’entraînement utilise ensuite.
Installer, vérifier, puis préparer les données
Extrayez le ZIP et placez-vous dans son dossier racine. Toutes les commandes suivantes se lancent depuis cette racine, dans l’ordre indiqué.
Nous préparons d’abord les répertoires, vérifions la configuration Compose, construisons les images, acquérons les actifs verrouillés, contrôlons CUDA et exécutons les tests. Les six commandes suivantes sont les six premières commandes du parcours r1.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
docker compose config --quiet contrôle la configuration sans afficher tout le fichier résolu. Le build prépare les images. L’acquisition valide les fichiers définis par les verrous ; le contrôle d’environnement vérifie le calcul CUDA ; pytest exécute les tests du projet. La documentation de Docker Compose détaille la commande de validation.
Ne poursuivez pas si une étape échoue. Une suite de tests réussie vérifie des comportements du programme ; elle ne dit pas encore si l’encodeur adapté classera mieux les procédures.
Préparons maintenant le corpus, inspectons les vecteurs et extrayons les négatifs. Nous n’entraînons pas encore le modèle.
docker compose run --rm gpu python -m contrastive_search.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m contrastive_search.cli inspect-embeddings --config configs/minimum.yaml
docker compose run --rm gpu python -m contrastive_search.cli mine --config configs/minimum.yaml
docker compose run --rm gpu python -m contrastive_search.cli check-loss --config configs/minimum.yaml
Après prepare, inspectez les splits et les identifiants. Après inspect-embeddings, reliez les vecteurs aux textes dont ils proviennent : un tableau de coordonnées n’est pas un classement complet à lui seul.
Après mine, ouvrez outputs/mining-audit.json. Vérifiez que les négatifs sont issus de train et qu’aucun des positive_ids n’a été sélectionné comme négatif. La fraction de faux négatifs attendue est nulle par rapport aux annotations connues. Cette vérification ne pourrait pas découvrir une troisième procédure pertinente que personne n’aurait annotée.
Enfin, check-loss contrôle la formule sur des tenseurs connus. Il sert à détecter une erreur de mécanisme avant de la chercher dans des milliers de calculs d’entraînement.
Entraîner et vérifier la reprise
Nous allons comparer trois entraînements. La référence hard, lancée sans option de variante, utilise les négatifs difficiles. random fait varier leur sélection ; temperature fait varier la température. Chaque variante change une décision expérimentale, afin que les différences restent interprétables.
Attention au vocabulaire : la baseline désignera plus loin le modèle avant cette adaptation. La référence hard est, elle, un entraînement. Ce ne sont pas deux noms pour le même état.
Les valeurs exactes des températures et les autres réglages d’entraînement restent ceux de la configuration du projet. Les nombres employés dans nos exemples de calcul ne les remplacent pas.
Les dernières commandes provoquent une interruption, reprennent le checkpoint créé et comparent la reprise. Gardez cet ordre : le fichier artifacts/checkpoints/interrupted/state.pt doit exister avant la commande qui le charge.
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml --variant random
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml --variant temperature
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml --stop-after 10 --run-name interrupted
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m contrastive_search.cli compare-resume --config configs/minimum.yaml
Un checkpoint est une sauvegarde d’un état de calcul. Retrouver des poids pour faire une recherche et retrouver l’état nécessaire pour continuer l’apprentissage sont deux besoins différents. Selon la boucle, la reprise peut aussi dépendre de l’optimiseur, de la progression dans les données et des générateurs aléatoires. La documentation PyTorch sur les sauvegardes de reprise explique pourquoi conserver les seuls poids ne suffit pas toujours. Le contenu exact de la sauvegarde de ce projet se consulte dans l’archive.
compare-resume sert justement à vérifier que l’état nécessaire a été reconstitué, plutôt qu’à juger la ressemblance de deux courbes. Lisez ses contrôles : un chargement sans erreur n’est pas, à lui seul, une preuve de reprise équivalente.
Mesurer avant l'exercice
Calculons maintenant les classements de référence, avant toute modification guidée de l’exercice.
docker compose run --rm gpu python -m contrastive_search.cli evaluate --config configs/minimum.yaml
La commande écrit les métriques et les rangs dans outputs/. Ces deux types de sorties sont complémentaires : une métrique résume le lot, tandis qu’un classement permet de comprendre ce qui s’est passé pour une requête précise.
Pour une première lecture, retrouvez l’ID d’une question, ses deux positive_ids, puis leurs positions dans chaque classement. Passez ensuite aux moyennes sur le jeu de test. Une recherche réussie ne suffit pas à établir la qualité de tout le système.
Métriques avant les mesures
Recall@5 : avons-nous retrouvé les deux procédures ?
Recall@5, ou rappel à cinq résultats, est la fraction des documents pertinents présents parmi les cinq premiers :
Recall@5 = nombre de positifs dans le top 5 / nombre total de positifs attendus.
Avec deux procédures pertinentes, une seule dans le top 5 donne 1 / 2 = 0,5. Les deux donnent 2 / 2 = 1. La moyenne finale rassemble les contributions des requêtes.
Le dénominateur vaut ici 2, pas 5. Le rappel demande « quelle part des bonnes procédures ai-je retrouvée ? ». Il ne demande pas « quelle part des cinq résultats est pertinente ? », qui serait une autre métrique, la précision. Deux bonnes procédures parmi cinq résultats peuvent donc donner 100 % de rappel sans que les cinq résultats soient tous pertinents.
MRR@10 : où apparaît la première bonne procédure ?
Pour une requête, le rang réciproque vaut l’inverse du rang du premier positif dans les dix premières positions. Un positif au rang 1 donne 1 ; au rang 2, 1 / 2 = 0,5 ; au rang 4, 1 / 4 = 0,25. S’il n’y en a aucun dans les dix premiers, la contribution vaut 0.
MRR signifie Mean Reciprocal Rank : nous prenons ensuite la moyenne de ces contributions sur les requêtes. Par exemple, trois contributions 1, 0,5 et 0 donnent un MRR de (1 + 0,5 + 0) / 3 = 0,5. Ce petit calcul illustre la métrique, pas le lot r1.
Le MRR ignore la position du second positif dès qu’il a trouvé le premier. Il faut donc le lire avec Recall@5, et non à sa place. La documentation d’évaluation de recherche de Sentence Transformers replace ces métriques dans un dispositif fondé sur requêtes, corpus et annotations.
Six classements pour distinguer les deux questions
Voici des exemples pédagogiques avec exactement deux positifs. Les nombres indiquent leurs rangs, en commençant à 1 ; les autres documents ne sont pas pertinents.
| Rangs des deux positifs | Recall@5 de la requête | Rang réciproque à 10 | Ce que nous observons |
|---|---|---|---|
| 1 et 2 | 1 | 1 | Les deux procédures sont en tête. |
| 1 et 5 | 1 | 1 | Mêmes métriques, mais le second positif est plus bas. |
| 2 et 4 | 1 | 0,5 | Les deux sont retrouvés ; aucun n’arrive premier. |
| 1 et 8 | 0,5 | 1 | Le premier est idéalement placé, le second manque au top 5. |
| 6 et 9 | 0 | Environ 0,1667 | Les positifs sont dans le top 10, pas dans le top 5. |
| 11 et 12 | 0 | 0 | Aucun positif dans les périmètres mesurés. |
Deux conséquences deviennent visibles. Un Recall@5 parfait peut coexister avec un MRR encore améliorable. Et même lorsque les deux métriques valent 1, elles ne prouvent pas que les deux procédures occupent les deux premières places.
Résultats réels et ce que nous avons appris
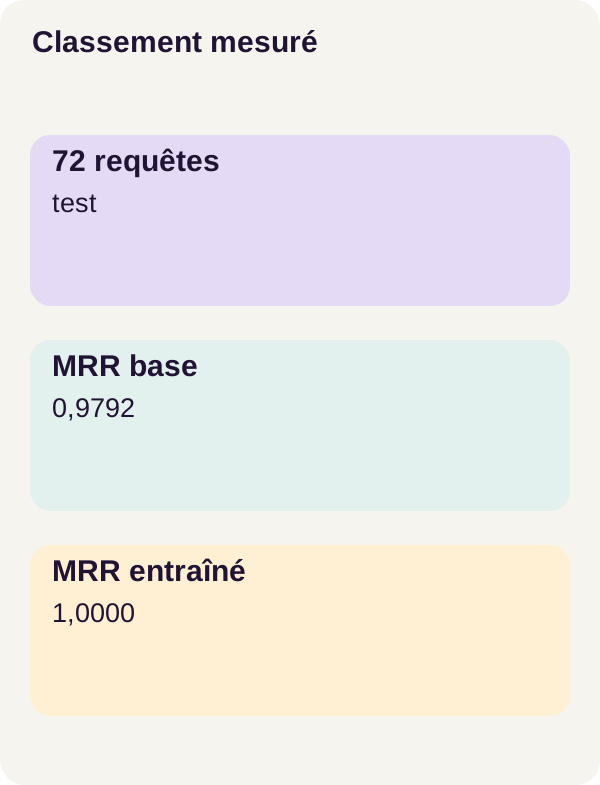
Les valeurs suivantes sont les mesures r1 rapportées sur 72 requêtes de test et 240 documents. Elles sont distinctes des exemples de calcul précédents.
| État évalué | Recall@5 | MRR@10 |
|---|---|---|
| Baseline, avant adaptation | 1,0 | 0,9791666666666666 |
Entraînement random |
1,0 | 1,0 |
Entraînement hard |
1,0 | 1,0 |
Entraînement temperature |
1,0 | 1,0 |
La première observation est que le rappel ne progresse pas : il est déjà parfait avant l’entraînement. La baseline retrouve les deux procédures pertinentes dans les cinq premiers résultats pour chaque requête évaluée.
Le MRR, lui, passe de 0,9791666666666666 à 1,0. Après chacun des trois entraînements, la première procédure pertinente arrive donc au premier rang de chaque requête du lot. Cela n’implique pas que la seconde occupe systématiquement le rang 2 : le tableau pédagogique précédent montre pourquoi.
Les trois variantes entraînées obtiennent les mêmes métriques. Nous ne pouvons donc pas attribuer aux négatifs difficiles une supériorité que ce tableau ne montre pas. Le corpus synthétique est petit et déjà facile ; il expose le fonctionnement de ce protocole, pas un classement universel des stratégies d’entraînement.
L’agrégat ne donne pas non plus la distribution détaillée des rangs de la baseline. Pour savoir quelles requêtes ont changé, relisez les classements sauvegardés plutôt que de reconstruire une histoire à partir de la moyenne seule.
La leçon principale est structurelle : les labels de pertinence doivent survivre à la fabrication du batch. Une deuxième bonne procédure reste une bonne procédure, quelle que soit sa colonne dans la matrice. Et une perte bien calculée ne dispense jamais de mesurer le classement final.
Exercice : prédire, puis exécuter
Reprenons la ligne [2, 1, 0, -1]. Les colonnes 0 et 1 correspondent aux deux procédures pertinentes. Imaginez maintenant qu’un masque fondé sur la diagonale n’en conserve qu’une : seule la colonne 0 reste marquée positive.
Avant de lancer la commande, notez votre prédiction : le gradient du score de la colonne 1 encouragera-t-il ce score à monter ou à descendre ?
Pour lire le signe, gardez en tête une mise à jour élémentaire : nouveau_score = score − pas × gradient, avec un pas positif. Un gradient négatif pousse donc le score vers le haut ; un gradient positif le pousse vers le bas. Nous parlons ici de la dérivée par rapport au score, afin d’isoler le mécanisme.
docker compose run --rm gpu python -m contrastive_search.cli exercise --config configs/exercise.yaml
La sortie de l’exercice conserve les deux gradients et confirme la répulsion injustifiée lorsque le second positif n’est plus marqué. Comparez-la à votre prédiction.
Pour accompagner cette lecture, voici les dérivées calculées sur notre ligne pédagogique, avec tous les candidats inclus et une seule requête. Elles ne sont pas présentées comme une capture de l’entraînement r1.
| Colonne | Gradient avec deux positifs | Gradient avec seul le premier positif | Effet de la seconde convention |
|---|---|---|---|
| 0, positif | −0,087144 | −0,356086 | Le premier positif reste encouragé. |
| 1, positif | −0,032059 | +0,236883 | Le second positif est désormais repoussé. |
| 2, négatif | +0,087144 | +0,087144 | Le négatif reste repoussé. |
| 3, négatif | +0,032059 | +0,032059 | Le négatif reste repoussé. |
Le changement de signe en colonne 1 est le défaut à retenir. Le modèle n’a pas découvert que la procédure était incorrecte : nous lui avons donné une supervision incorrecte.
Dans le réseau réel, les scores partagent les mêmes paramètres. Ces dérivées décrivent la pression exercée par la perte sur chaque score ; elles ne garantissent pas que chaque score évoluera isolément dans ce sens après une mise à jour de tous les poids.
Terminez ensuite les artefacts et l’arrêt du parcours, dans cet ordre :
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
La première commande génère les figures ; la deuxième contrôle les checkpoints, notamment ceux créés pendant l’entraînement. clean.py --dry-run ne fait qu’une prévisualisation du nettoyage et ne supprime aucun fichier. La dernière commande arrête les ressources Compose du projet. Ne confondez pas cette prévisualisation avec l’arrêt effectif des conteneurs.
Adaptation, production, dépannage et nettoyage
Passer du corpus synthétique à vos documents
Pour adapter le mécanisme, commencez par des jugements de pertinence versionnés et relus. Une demande peut posséder deux bonnes procédures, mais aussi une seule, davantage, ou aucune. Le contrat « exactement deux positifs » est celui de ce tutoriel ; il ne doit pas devenir une hypothèse implicite sur vos données réelles.
Conservez une séparation claire entre entraînement, validation et test. Analysez les faux positifs par famille : ce sont les procédures classées comme utiles alors qu’elles ne répondent pas à la demande. Distinguez-les des faux négatifs du mining, qui sont de bonnes procédures utilisées à tort comme contre-exemples d’entraînement.
Un négatif difficile peut être une pertinence non annotée. L’absence de son ID dans la liste des positifs ne prouve pas son inutilité. Gardez donc l’audit de mining et un mécanisme de revue. Corriger les annotations est une décision sur les données, pas un effet automatique du modèle.
Si vous adaptez le modèle, recalculez aussi les représentations documentaires avec l’encodeur correspondant avant de comparer les nouvelles requêtes : mélanger deux états d’encodeur ne reproduit plus la recherche avec un même modèle décrite ici. Cette cohérence découle du fonctionnement du parcours, elle ne constitue pas une fonction de migration d’index déjà fournie.
La question Atlas montrée plus haut est en anglais et la fiche du modèle indique language: en. Un corpus français constitue donc une expérience à évaluer séparément ; la traduction pédagogique de l’article ne valide pas sa qualité en français.
Ne pas transformer une moyenne locale en promesse de service
Mesurez la latence sous votre charge cible. Une mesure chaude par requête — lorsque le modèle est déjà chargé — ne décrit ni le trafic concurrent ni l’attente dans une file de requêtes. Elle ne valide pas non plus un index ANN, c’est-à-dire une recherche de voisins approximative utilisée pour éviter de comparer exhaustivement tous les vecteurs.
Le projet ne devient pas une API de production parce que Recall@5 vaut 1. L’ingestion documentaire, les droits d’accès, la mise à jour de l’index, les sauvegardes, les limites d’entrée et l’observabilité demandent une conception et des tests propres à l’application. Ces extensions sont distinctes de l’expérience mesurée.
Diagnostiquer sans modifier silencieusement l’expérience
CUDA échoue. Relancez d’abord check_environment.py et consultez le guide NVIDIA Container Toolkit. Une erreur d’accès au GPU n’est pas une raison de changer la formule de perte.
L’acquisition échoue. Vérifiez le réseau du service acquire, puis relancez la même commande. Ne modifiez pas les fichiers verrouillés pour faire accepter un actif différent.
La perte refuse une requête sans positif inclus. Inspectez les IDs, le split et l’intersection positive_mask & allowed. Retirer le contrôle ferait disparaître le symptôme, pas l’absence de supervision.
Les scores surprennent. Examinez les rangs des deux positifs, pas seulement le premier résultat ou la perte. Un MRR parfait peut masquer un second positif trop bas ; un Recall@5 déjà parfait ne peut pas augmenter davantage.
Enfin, docker compose down --remove-orphans arrête les services du projet et conserve les fichiers locaux décrits par le parcours. clean.py --dry-run affiche seulement ce qu’il viserait. Conservez les sorties de référence avant toute expérience séparée ou suppression effective.
Sources officielles
Modèle et apprentissage. La fiche all-MiniLM-L6-v2 présente le modèle ; sa version verrouillée est liée plus haut. Les documentations Sentence Transformers sur les losses, le mining de négatifs difficiles et l’évaluation de recherche approfondissent ces sujets. Elles ne remplacent pas la formule multi-positifs propre au code de cette archive.
Calcul numérique. Les références PyTorch pour normalize, softmax et logsumexp précisent les opérations utilisées dans les explications. La page des versions PyTorch sert de référence d’installation ; pour reproduire r1, gardez l’environnement fixé dans les verrous du projet.
Environnement. Consultez Docker Compose et l’accès GPU ainsi que le guide NVIDIA Container Toolkit pour comprendre l’intégration entre hôte, conteneur et carte graphique.