





Immaginate il centro assistenza della vostra applicazione web. Un utente segnala che alcuni messaggi restano bloccati in una coda dopo l'arresto di un worker. Il motore di ricerca trova una scheda che spiega come riavviare quel worker. È utile, ma una seconda scheda descrive come riprodurre i messaggi rimasti senza conferma di elaborazione. Anche questa risponde al problema.
Come insegnare al motore a ritrovare queste due procedure, senza confonderle con altre schede che usano le stesse parole ma descrivono un incidente diverso?
Adatteremo un modello di embedding: il programma che trasforma i testi in vettori per confrontarli. Il punto delicato non sarà soltanto avvicinare una domanda a una risposta corretta. Dovremo anche evitare che una seconda risposta corretta diventi per errore un esempio da allontanare durante l'addestramento.
Scaricare il progetto completo del tutorial
Cosa costruiamo
Il progetto realizza un piccolo motore di ricerca su un corpus di assistenza sintetico. Codifica le query e le procedure con lo stesso encoder, seleziona documenti ingannevolmente vicini, quindi addestra questo encoder con una loss contrastiva multi-positivi. Infine conserva le classifiche e calcola due metriche: Recall@5 e MRR@10.
In altre parole, vogliamo modificare ciò che il modello considera «vicino». Due procedure diverse possono essere pertinenti per la stessa richiesta; la loro differenza non deve bastare a renderle concorrenti incompatibili.
Il percorso separa tre responsabilità: le annotazioni definiscono le procedure pertinenti; l'addestramento usa tali annotazioni per adattare il modello; la valutazione verifica poi dove compaiono le procedure nei risultati. Il modello non definisce da sé le risposte corrette secondo le proprie preferenze.
Questo programma trova e classifica documenti. Non costruisce né un RAG completo — una ricerca documentale seguita dalla generazione di una risposta — né una regola aziendale che decida come risolvere automaticamente un incidente.
Concetti spiegati prima del codice
Un embedding: coordinate per confrontare testi
Un embedding è una lista di numeri calcolata a partire da un testo. Potete immaginarlo come le coordinate di un punto: due testi i cui vettori sono vicini sono considerati simili dal modello.
Non scegliamo a mano un asse «guasto» e un asse «riavvio». I parametri della rete, chiamati anche pesi, determinano come i testi diventano coordinate. Adattare tali parametri cambia quindi la rappresentazione prodotta, senza modificare il testo delle procedure.
Il modello usato è sentence-transformers/all-MiniLM-L6-v2, bloccato alla revisione 1110a243fdf4706b3f48f1d95db1a4f5529b4d41 in locks/models.lock.json. La sua scheda ufficiale a questa revisione descrive vettori di 384 coordinate. Un identificativo di documento permette di ritrovare una scheda; il suo embedding serve a confrontarla con una query. I due non sono intercambiabili.
Dal testo a un solo vettore
Il calcolo comprende varie trasformazioni. Il tokenizer suddivide il testo in unità, i token, poi le sostituisce con identificativi numerici. Un token può essere una parola o una parte di parola: non corrisponde necessariamente a una parola separata da spazi.
Il Transformer calcola poi un vettore per posizione tenendo conto del contesto. Abbiamo quindi più vettori per un testo, mentre la ricerca ne richiede uno solo. Il pooling medio li riunisce calcolando una media, coordinata per coordinata.
Bisogna però ignorare il padding: le posizioni di riempimento aggiunte affinché più testi entrino in una tabella della stessa larghezza. La maschera di attenzione indica le posizioni usate, con 1 per quelle da conservare e 0 per il riempimento.
Prendiamo un esempio didattico a due coordinate, senza rapporto con i vettori realmente prodotti da MiniLM. Due posizioni utili valgono [1, 2] e [5, 6]. Una terza posizione è riempimento. Con una maschera [1, 1, 0], la media vale [(1 + 5) / 2, (2 + 6) / 2], cioè [3, 4]. La terza posizione non partecipa né alla somma né al denominatore.
Normalizzare: confrontare le direzioni invece della dimensione
Il percorso applica poi F.normalize(..., dim=-1). Questa operazione divide ogni vettore per la sua norma, proteggendo i valori molto piccoli. La norma è qui la sua lunghezza geometrica: per [3, 4], vale sqrt(3² + 4²) = 5. Il vettore normalizzato diventa quindi [0.6, 0.8], la cui norma vale 1.
Il prodotto scalare moltiplica le coordinate corrispondenti e poi somma i risultati. Per due vettori di norma 1, corrisponde alla loro similarità coseno, cioè a un confronto delle loro direzioni. Per esempio, [0.6, 0.8] confrontato con sé stesso dà 0.6² + 0.8² = 1.
Senza questa normalizzazione, un vettore più lungo potrebbe ottenere un prodotto scalare maggiore soltanto per la sua dimensione. Qui cerchiamo una vicinanza di rappresentazione, non una gara di lunghezza. La documentazione di normalize precisa anche il trattamento delle norme molto piccole.
Un punteggio di similarità non è una prova di pertinenza aziendale. Due schede possono parlare dello stesso componente senza consigliare l'azione corretta per lo stesso incidente.
Positivi, negativi ed esempi ingannevoli
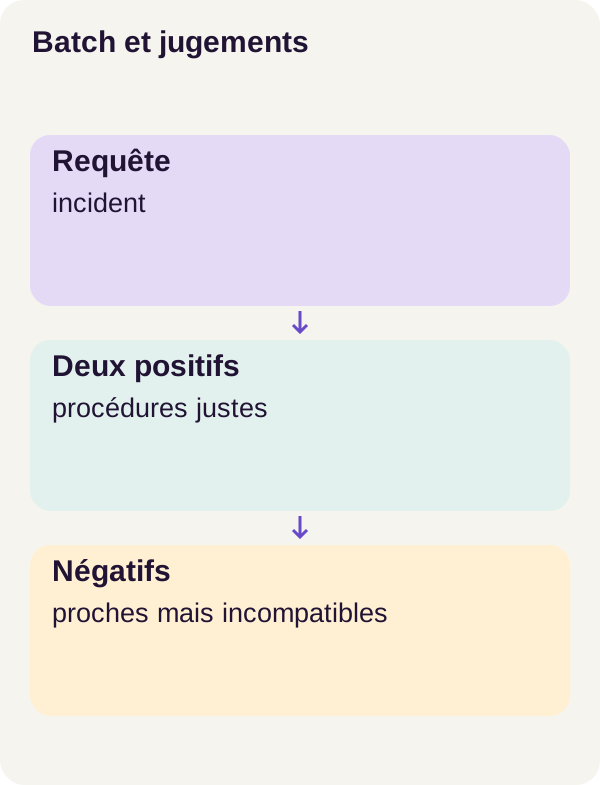
Un positivo è un documento annotato come pertinente per una query. Un negativo viene usato come controesempio per tale query. Questi ruoli dipendono dalla richiesta: una procedura può essere pertinente per una domanda e non per un'altra.
Un negativo difficile, o hard negative, è un controesempio al quale il modello assegna comunque un punteggio elevato. Permette di lavorare proprio su una confusione. Una scheda che parla della stessa coda di messaggi ma tratta un altro problema può essere più istruttiva di una scheda senza alcun rapporto con le code.
Il mining indica la selezione di questi controesempi. Usa la classifica del modello per trovare candidati vicini, ma si basa sulle annotazioni per escludere le risposte corrette. La documentazione Sentence Transformers sui negativi difficili presenta questo principio generale; il tutorial conserva il proprio codice di selezione.
Il pericolo è il falso negativo: una procedura realmente pertinente che l'addestramento tratta come errata. Con due positivi, una convenzione che ne riconoscesse uno solo creerebbe proprio questo errore.
Una loss contrastiva: imparare per confronto
Una loss è il numero che l'addestramento cerca di ridurre. Una loss contrastiva confronta candidati: qui incoraggia il modello a dare più peso ai documenti pertinenti che agli altri.
La retropropagazione calcola i gradienti, che indicano come una variazione dei parametri farebbe variare questa loss. L'ottimizzatore usa queste informazioni per aggiornare i pesi. I tutorial PyTorch sui gradienti e sull'ottimizzazione descrivono questo ciclo. Calcolare embedding con un modello già caricato, senza modificarne i pesi, è invece inferenza.
Il nostro adattamento parte da un modello esistente: non impariamo a leggere i testi da zero. Gli forniamo una supervisione più precisa sugli avvicinamenti attesi in questo corpus.
Temperatura e softmax: regolare il peso degli scarti
Il softmax trasforma una riga di punteggi in numeri positivi la cui somma vale 1. Usa exp, la funzione esponenziale: una funzione crescente che restituisce un valore positivo, anche per un punteggio negativo. Per il candidato j, calcola exp(score_j) / somma(exp(scores)). Questi valori esprimono una ripartizione tra i candidati considerati, non una probabilità aziendale calibrata. La definizione PyTorch di softmax formalizza questa operazione.
Durante l'addestramento, le similarità vengono divise per una temperatura positiva prima di questo calcolo. Una temperatura piccola accentua gli scarti; una temperatura più elevata li attenua.
Per esempio, le similarità fittizie [0.4, 0.2, 0, -0.2] diventano i punteggi [2, 1, 0, -1] dopo la divisione per 0.2. Il primo candidato riceve allora circa il 64,39 % della massa del softmax, contro il 32,92 % con una temperatura di 1. Sono valori illustrativi, non le impostazioni né le misure r1. La classifica non cambia con questa divisione positiva; cambia l'importanza attribuita agli scarti.
Infine, log indica qui il logaritmo naturale, la funzione inversa dell'esponenziale. logsumexp calcola il logaritmo di una somma di esponenziali in modo numericamente stabile. Lo useremo per riunire i contributi di più positivi senza calcolare ingenuamente esponenziali molto grandi. La documentazione di torch.logsumexp descrive questa operazione.
Prerequisiti Docker e GPU
Dovete saper leggere una funzione Python, manipolare liste e identificativi, ed eseguire comandi in un terminale. Il percorso r1 usa Linux x86_64, Docker Compose, NVIDIA Container Toolkit e una RTX 3090 da 24 Gio.
Prevedete anche 16 Gio di RAM e 16 Gio di disco, esclusi gli strati Docker condivisi. La RAM è la memoria dell'host; la memoria della scheda grafica è la VRAM. Queste dotazioni descrivono il quadro del progetto, non minimi dimostrati su tutte le macchine. Nessun profilo CPU è presentato come riproduzione convalidata del percorso GPU.
locks/models.lock.json fissa gli asset del modello e locks/environment.lock.json l'ambiente previsto. Conservate questi blocchi per riprodurre l'esperimento: sostituire una revisione con il ramo corrente cambierebbe gli elementi che confrontiamo.
Il servizio acquire è l'unico a scaricare gli asset del modello. Il servizio gpu esegue poi i calcoli locali. Costruire un'immagine Docker e acquisire i pesi sono due operazioni diverse: i pesi sono i parametri del modello, non il codice Python che li usa.
Il controllo dell'ambiente inizializza CUDA ed esegue un calcolo nel contenitore. Vedere la scheda da Linux non basta. Le documentazioni Docker Compose per le GPU e NVIDIA Container Toolkit spiegano questa integrazione.
Dati e funzioni centrali
Conoscere le risposte corrette prima di addestrare
Il corpus sintetico comprende 240 documenti e 72 query di test. Ogni query possiede esattamente due positive_ids. Questi identificativi costituiscono il riferimento per stabilire quali procedure sono pertinenti.
Le famiglie sono separate in train, validation e test prima dell'addestramento. Train fornisce gli esempi che influenzano i pesi; validation serve a osservare le scelte di addestramento; test resta riservato alla classifica finale. Separare le famiglie evita che una semplice riformulazione dello stesso insieme di casi si trovi da entrambi i lati della valutazione.
Una query di addestramento estrae candidati solo tra documenti di addestramento. Il mining li classifica con il modello corrente, rimuove esplicitamente i due ID positivi, poi conserva i negativi. Non ne indovina dunque la pertinenza. Questa frontiera impedisce che una procedura di test sia già vista dall'ottimizzatore come controesempio.
Non confondete i 240 documenti annunciati per il corpus con la popolazione autorizzata al mining di addestramento: quest'ultima è limitata allo split train. I conteggi dettagliati e le appartenenze si leggono nei dati preparati.
Il nostro filo conduttore: due procedure, non due copie
L'esempio r1 atlas-queue-q0 contiene questa domanda:
The Atlas messages remain pending after the queue worker crashes. What should the operator do?
Per capirla in italiano: «I messaggi Atlas restano in attesa dopo l'arresto anomalo del worker della coda. Che cosa deve fare l'operatore?». Questa traduzione accompagna la lettura; non sostituisce il testo dell'esperimento.
Un worker è il processo che prende in carico i lavori di una coda. Un messaggio non confermato non ha ricevuto la conferma prevista della sua elaborazione. Riprodurre un simile messaggio richiede di gestire le ripetizioni: una chiave di idempotenza identifica un'operazione per evitare che la sua riesecuzione ne riproduca indebitamente gli effetti.
Le due procedure annotate rispondono ad aspetti distinti di questo incidente:
| Identificativo positivo | Ruolo della procedura in questo esempio |
|---|---|
atlas-queue-procedure-a |
Ispezionare e riavviare il worker. |
atlas-queue-procedure-b |
Riprodurre i messaggi non confermati con chiavi di idempotenza. |
Non cerchiamo di fondere questi testi, né di considerare che uno sostituisca sempre l'altro. Entrambi devono restare positivi per questa query. Ritrovare queste schede non costituisce, da solo, una convalida operativa della loro esecuzione.
Costruire la maschera a partire dagli identificativi
Un batch, o lotto, riunisce più esempi trattati insieme. La matrice scores contiene una riga per query e una colonna per documento candidato. La sua forma è quindi B × D, con B query e D documenti.
positive_mask ha esattamente la stessa forma. Contiene True quando il documento della colonna è pertinente per la query della riga. Una stessa riga può quindi contenere più True.
La funzione make_batch, in src/contrastive_search/mining.py, costruisce questa maschera a partire dagli identificativi, poi verifica la presenza di due positivi per query. È l'equivalente di un join per chiave in un'applicazione: cambiare l'ordine delle righe non deve cambiarne il significato.
Una diagonale marca solo le posizioni in cui il numero di riga è uguale al numero di colonna. Da sola non può rappresentare due positivi su una riga. Una convenzione di posizione nel lotto non deve quindi sostituire le nostre annotazioni.
Leggere il cuore della loss
Ecco l'estratto centrale continuo di src/contrastive_search/losses.py. Riceve punteggi già calcolati, una maschera di pertinenza e, facoltativamente, una maschera dei candidati inclusi nel calcolo.
def multi_positive_nce(scores, positive_mask, allowed=None):
    if scores.ndim != 2 or positive_mask.shape != scores.shape:
        raise ValueError("B x D scores and positive mask required")
    allowed = (
        torch.ones_like(positive_mask, dtype=torch.bool) if allowed is None else allowed
    )
    if not torch.isfinite(scores).all():
        raise ValueError("Non-finite scores")
    if ((positive_mask & allowed).sum(1) == 0).any():
        raise ValueError("Each query needs an allowed positive")
    denominator = torch.logsumexp(scores.masked_fill(~allowed, -torch.inf), dim=1)
    numerator = torch.logsumexp(
        scores.masked_fill(~(positive_mask & allowed), -torch.inf), dim=1
    )
    return (denominator - numerator).mean()
Cominciamo dagli input. scores è una tabella di numeri PyTorch, chiamata anche tensore. positive_mask è la tabella booleana corrispondente. Quando allowed non è fornito, tutti i candidati sono inclusi.
Il nome allowed significa qui «preso in considerazione nella formula». Questa maschera non è né un'autenticazione né una regola di diritti documentali. Su queste tabelle booleane, ~ inverte True e False, mentre & applica un «e» cella per cella.
Il denominatore considera tutti i candidati inclusi. masked_fill(~allowed, -torch.inf) sostituisce i punteggi esclusi con meno infinito. Poiché la loro esponenziale vale zero, non contribuiscono più alla somma. dim=1 chiede di effettuare questo calcolo sulle colonne, separatamente per ciascuna query.
Il numeratore considera tutti i positivi inclusi. L'espressione positive_mask & allowed conserva l'intersezione delle due maschere. Le due procedure corrette partecipano quindi insieme al numeratore, invece di trattenerne una sola.
Per una query, calcoliamo quindi:
L = log(somma delle exp(scores) dei candidati inclusi) − log(somma delle exp(scores) dei positivi inclusi).
I nomi denominator e numerator indicano, nel codice, i logaritmi di queste due somme. La loro differenza equivale a −log(numeratore / denominatore). Il .mean() finale calcola la media di questa loss sulle query del lotto, non sui documenti positivi presi separatamente.
Rifare un calcolo a mano
Riprendiamo la riga dimostrativa [2, 1, 0, -1], con i primi due documenti positivi e tutti i candidati inclusi. I quattro punteggi sono didattici; non sono output catturati dal modello.
| Colonna | Punteggio | Documento positivo? | Contributo exp(score), arrotondato |
|---|---|---|---|
| 0 | 2 | Sì | 7,389056 |
| 1 | 1 | Sì | 2,718282 |
| 2 | 0 | No | 1,000000 |
| 3 | −1 | No | 0,367879 |
La somma di tutti i contributi vale circa 11,475217. Quella dei due positivi vale circa 10,107338. Il rapporto vale dunque circa 0,880797, poi la loss −log(0,880797) vale circa 0,126928.
Il modello attribuisce qui circa l'88,08 % della massa del softmax all'insieme delle risposte corrette. La loss diminuisce quando questa massa si avvicina a 1. I calcoli numerici sopra riportati sono effettuati prima dell'arrotondamento dei valori visualizzati.
Con una maschera che dichiara positiva soltanto la colonna 0, il numeratore conserverebbe solo 7,389056. La loss diventerebbe circa 0,440190. Soprattutto, la colonna 1 resterebbe al denominatore senza partecipare al numeratore: aumentare il suo punteggio aumenterebbe la loss, mentre la sua procedura è pertinente. Verificheremo il segno del suo gradiente nell'esercizio.
Ciò che questa formula garantisce, e ciò che non garantisce
La funzione evita di trattare il secondo positivo come un negativo. Favorisce però l'insieme dei positivi, senza richiedere che ricevano lo stesso punteggio. Non è una media di due loss indipendenti, ciascuna delle quali richiede che il proprio documento vinca da solo.
Una buona procedura può quindi ricevere la maggior parte della massa softmax e l'altra molto meno. Se tutti i candidati inclusi sono positivi, numeratore e denominatore diventano persino identici: la loss vale zero, qualunque sia il loro ordine.
Questo spiega perché misuriamo poi la presenza di entrambe le procedure nella top 5. Una loss bassa non basta a dimostrare che ciascuna sia ben classificata.
Anche le protezioni hanno un perimetro preciso. La funzione verifica la forma di scores e positive_mask, la finitezza dei punteggi e l'esistenza di almeno un positivo incluso per query. Non verifica da sé che ce ne siano esattamente due: questo controllo spetta a make_batch. Le maschere devono essere booleane compatibili fornite dal chiamante.
Il controllo dei valori finiti interviene prima del mascheramento. Un NaN o un infinito già presente in scores viene quindi rifiutato anche se la sua colonna dovesse essere esclusa in seguito. I meno infiniti introdotti volontariamente da masked_fill servono invece a rimuovere contributi dal calcolo.
Infine, questo estratto non codifica i testi, non sceglie i negativi e non divide le similarità per la temperatura. Non contiene neppure backward() né un aggiornamento dei pesi. Calcola una loss differenziabile che il ciclo di addestramento usa in seguito.
Installare, verificare, poi preparare i dati
Estraete lo ZIP e posizionatevi nella sua cartella radice. Tutti i comandi seguenti vengono avviati da questa radice, nell'ordine indicato.
Prepariamo dapprima le cartelle, verifichiamo la configurazione Compose, costruiamo le immagini, acquisiamo gli asset bloccati, controlliamo CUDA ed eseguiamo i test. I sei comandi seguenti sono i primi sei comandi del percorso r1.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
docker compose config --quiet controlla la configurazione senza visualizzare l'intero file risolto. Il build prepara le immagini. L'acquisizione convalida i file definiti dai blocchi; il controllo dell'ambiente verifica il calcolo CUDA; pytest esegue i test del progetto. La documentazione di Docker Compose dettaglia il comando di convalida.
Non proseguite se una fase fallisce. Una suite di test riuscita verifica comportamenti del programma; non dice ancora se l'encoder adattato classificherà meglio le procedure.
Prepariamo ora il corpus, ispezioniamo i vettori ed estraiamo i negativi. Non addestriamo ancora il modello.
docker compose run --rm gpu python -m contrastive_search.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m contrastive_search.cli inspect-embeddings --config configs/minimum.yaml
docker compose run --rm gpu python -m contrastive_search.cli mine --config configs/minimum.yaml
docker compose run --rm gpu python -m contrastive_search.cli check-loss --config configs/minimum.yaml
Dopo prepare, ispezionate gli split e gli identificativi. Dopo inspect-embeddings, collegate i vettori ai testi da cui provengono: una tabella di coordinate non è da sola una classifica completa.
Dopo mine, aprite outputs/mining-audit.json. Verificate che i negativi provengano da train e che nessuno dei positive_ids sia stato selezionato come negativo. La frazione attesa di falsi negativi è nulla rispetto alle annotazioni note. Questa verifica non potrebbe scoprire una terza procedura pertinente che nessuno abbia annotato.
Infine, check-loss controlla la formula su tensori noti. Serve a rilevare un errore di meccanismo prima di cercarlo in migliaia di calcoli di addestramento.
Addestrare e verificare la ripresa
Confronteremo tre addestramenti. Il riferimento hard, avviato senza opzione di variante, usa negativi difficili. random ne varia la selezione; temperature varia la temperatura. Ogni variante cambia una decisione sperimentale, affinché le differenze restino interpretabili.
Attenzione al vocabolario: più avanti la baseline indicherà il modello prima di questo adattamento. Il riferimento hard è invece un addestramento. Non sono due nomi per lo stesso stato.
I valori esatti delle temperature e le altre impostazioni di addestramento restano quelli della configurazione del progetto. I numeri usati nei nostri esempi di calcolo non li sostituiscono.
Gli ultimi comandi provocano un'interruzione, riprendono il checkpoint creato e confrontano la ripresa. Rispettate questo ordine: il file artifacts/checkpoints/interrupted/state.pt deve esistere prima del comando che lo carica.
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml --variant random
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml --variant temperature
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml --stop-after 10 --run-name interrupted
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m contrastive_search.cli compare-resume --config configs/minimum.yaml
Un checkpoint è un salvataggio di uno stato di calcolo. Ritrovare pesi per eseguire una ricerca e ritrovare lo stato necessario per proseguire l'apprendimento sono due necessità diverse. A seconda del ciclo, la ripresa può dipendere anche dall'ottimizzatore, dall'avanzamento nei dati e dai generatori casuali. La documentazione PyTorch sui salvataggi di ripresa spiega perché conservare i soli pesi non basta sempre. Il contenuto esatto del salvataggio di questo progetto può essere consultato nell'archivio.
compare-resume serve proprio a verificare che lo stato necessario sia stato ricostituito, invece di giudicare la somiglianza di due curve. Leggete i suoi controlli: un caricamento senza errore non è da solo una prova di ripresa equivalente.
Misurare prima dell'esercizio
Calcoliamo ora le classifiche di riferimento, prima di qualsiasi modifica guidata dall'esercizio.
docker compose run --rm gpu python -m contrastive_search.cli evaluate --config configs/minimum.yaml
Il comando scrive metriche e ranghi in outputs/. Questi due tipi di output sono complementari: una metrica riassume il lotto, mentre una classifica permette di capire che cosa è accaduto per una query precisa.
Per una prima lettura, ritrovate l'ID di una domanda, i suoi due positive_ids, poi le loro posizioni in ogni classifica. Passate quindi alle medie sul set di test. Una ricerca riuscita non basta a stabilire la qualità dell'intero sistema.
Metriche prima delle misure
Recall@5: abbiamo ritrovato le due procedure?
Recall@5, o richiamo sui primi cinque risultati, è la frazione di documenti pertinenti presenti tra i primi cinque:
Recall@5 = numero di positivi nella top 5 / numero totale di positivi attesi.
Con due procedure pertinenti, una sola nella top 5 dà 1 / 2 = 0,5. Entrambe danno 2 / 2 = 1. La media finale riunisce i contributi delle query.
Il denominatore vale qui 2, non 5. Il richiamo chiede «quale parte delle procedure corrette ho ritrovato?». Non chiede «quale parte dei cinque risultati è pertinente?», che sarebbe un'altra metrica, la precisione. Due buone procedure tra cinque risultati possono dunque dare un richiamo del 100 % senza che tutti e cinque i risultati siano pertinenti.
MRR@10: dove appare la prima buona procedura?
Per una query, il rango reciproco è l'inverso del rango del primo positivo nelle prime dieci posizioni. Un positivo al rango 1 dà 1; al rango 2, 1 / 2 = 0,5; al rango 4, 1 / 4 = 0,25. Se non ce n'è alcuno tra i primi dieci, il contributo vale 0.
MRR significa Mean Reciprocal Rank: prendiamo poi la media di questi contributi sulle query. Per esempio, tre contributi 1, 0,5 e 0 danno un MRR di (1 + 0,5 + 0) / 3 = 0,5. Questo piccolo calcolo illustra la metrica, non il lotto r1.
L'MRR ignora la posizione del secondo positivo dopo avere trovato il primo. Occorre quindi leggerlo insieme a Recall@5, non al suo posto. La documentazione di valutazione della ricerca di Sentence Transformers colloca queste metriche in un dispositivo basato su query, corpus e annotazioni.
Sei classifiche per distinguere le due questioni
Ecco esempi didattici con esattamente due positivi. I numeri indicano i loro ranghi, a partire da 1; gli altri documenti non sono pertinenti.
| Ranghi dei due positivi | Recall@5 della query | Rango reciproco a 10 | Ciò che osserviamo |
|---|---|---|---|
| 1 e 2 | 1 | 1 | Le due procedure sono in testa. |
| 1 e 5 | 1 | 1 | Stesse metriche, ma il secondo positivo è più in basso. |
| 2 e 4 | 1 | 0,5 | Entrambi sono ritrovati; nessuno arriva primo. |
| 1 e 8 | 0,5 | 1 | Il primo è posizionato idealmente, il secondo manca dalla top 5. |
| 6 e 9 | 0 | Circa 0,1667 | I positivi sono nella top 10, non nella top 5. |
| 11 e 12 | 0 | 0 | Nessun positivo nei perimetri misurati. |
Due conseguenze diventano visibili. Un Recall@5 perfetto può coesistere con un MRR ancora migliorabile. E anche quando entrambe le metriche valgono 1, non provano che le due procedure occupino i primi due posti.
Risultati reali e ciò che abbiamo appreso
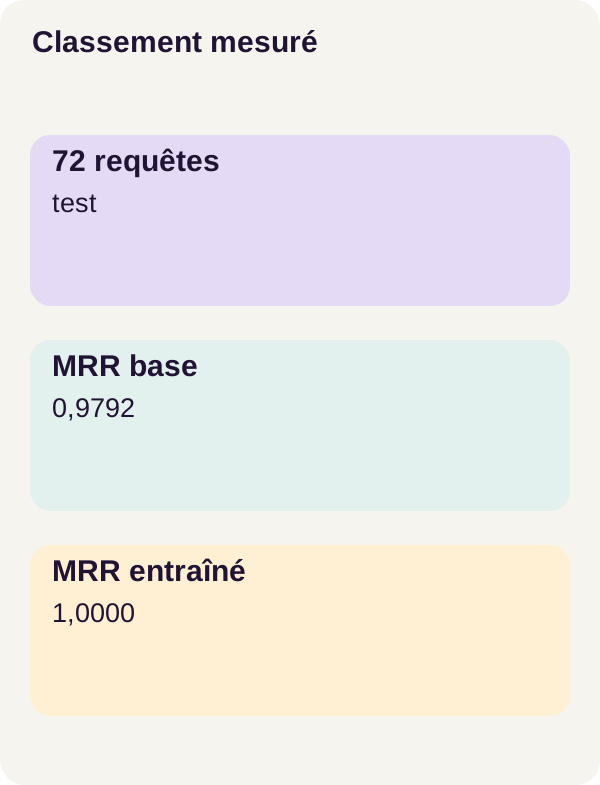
I valori seguenti sono le misure r1 riportate su 72 query di test e 240 documenti. Sono distinti dagli esempi di calcolo precedenti.
| Stato valutato | Recall@5 | MRR@10 |
|---|---|---|
| Baseline, prima dell'adattamento | 1,0 | 0,9791666666666666 |
Addestramento random |
1,0 | 1,0 |
Addestramento hard |
1,0 | 1,0 |
Addestramento temperature |
1,0 | 1,0 |
La prima osservazione è che il richiamo non migliora: è già perfetto prima dell'addestramento. La baseline ritrova le due procedure pertinenti nei primi cinque risultati per ogni query valutata.
L'MRR, invece, passa da 0,9791666666666666 a 1,0. Dopo ciascuno dei tre addestramenti, la prima procedura pertinente arriva dunque al primo rango di ogni query del lotto. Questo non implica che la seconda occupi sistematicamente il rango 2: la tabella didattica precedente mostra perché.
Le tre varianti addestrate ottengono le stesse metriche. Non possiamo quindi attribuire ai negativi difficili una superiorità che questa tabella non mostra. Il corpus sintetico è piccolo e già facile; espone il funzionamento di questo protocollo, non una classifica universale delle strategie di addestramento.
L'aggregato non fornisce neppure la distribuzione dettagliata dei ranghi della baseline. Per sapere quali query sono cambiate, rileggete le classifiche salvate invece di ricostruire una storia dalla sola media.
La lezione principale è strutturale: le etichette di pertinenza devono sopravvivere alla creazione del batch. Una seconda buona procedura resta una buona procedura, qualunque sia la sua colonna nella matrice. E una loss ben calcolata non dispensa mai dal misurare la classifica finale.
Esercizio: prevedere, poi eseguire
Riprendiamo la riga [2, 1, 0, -1]. Le colonne 0 e 1 corrispondono alle due procedure pertinenti. Immaginate ora che una maschera basata sulla diagonale ne conservi solo una: soltanto la colonna 0 resta marcata positiva.
Prima di avviare il comando, annotate la vostra previsione: il gradiente del punteggio della colonna 1 incoraggerà questo punteggio a salire o a scendere?
Per leggere il segno, tenete presente un aggiornamento elementare: nuovo_punteggio = punteggio − passo × gradiente, con un passo positivo. Un gradiente negativo spinge quindi il punteggio verso l'alto; un gradiente positivo lo spinge verso il basso. Parliamo qui della derivata rispetto al punteggio, per isolare il meccanismo.
docker compose run --rm gpu python -m contrastive_search.cli exercise --config configs/exercise.yaml
L'output dell'esercizio conserva i due gradienti e conferma la repulsione ingiustificata quando il secondo positivo non è più marcato. Confrontatelo con la vostra previsione.
Per accompagnare questa lettura, ecco le derivate calcolate sulla nostra riga didattica, con tutti i candidati inclusi e una sola query. Non sono presentate come una cattura dell'addestramento r1.
| Colonna | Gradiente con due positivi | Gradiente con solo il primo positivo | Effetto della seconda convenzione |
|---|---|---|---|
| 0, positivo | −0,087144 | −0,356086 | Il primo positivo resta incoraggiato. |
| 1, positivo | −0,032059 | +0,236883 | Il secondo positivo viene ora respinto. |
| 2, negativo | +0,087144 | +0,087144 | Il negativo resta respinto. |
| 3, negativo | +0,032059 | +0,032059 | Il negativo resta respinto. |
Il cambiamento di segno nella colonna 1 è il difetto da ricordare. Il modello non ha scoperto che la procedura era errata: gli abbiamo fornito una supervisione errata.
Nella rete reale, i punteggi condividono gli stessi parametri. Queste derivate descrivono la pressione esercitata dalla loss su ogni punteggio; non garantiscono che ogni punteggio evolva isolatamente in questo senso dopo un aggiornamento di tutti i pesi.
Completate quindi gli artefatti e l'arresto del percorso, in quest'ordine:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
Il primo comando genera le figure; il secondo controlla i checkpoint, in particolare quelli creati durante l'addestramento. clean.py --dry-run fa soltanto un'anteprima della pulizia e non elimina alcun file. L'ultimo comando arresta le risorse Compose del progetto. Non confuse questa anteprima con l'arresto effettivo dei contenitori.
Adattamento, produzione, diagnosi e pulizia
Passare dal corpus sintetico ai vostri documenti
Per adattare il meccanismo, iniziate con giudizi di pertinenza versionati e riletti. Una richiesta può avere due buone procedure, ma anche una sola, più di due o nessuna. Il contratto «esattamente due positivi» è quello di questo tutorial; non deve diventare un'ipotesi implicita sui vostri dati reali.
Mantenete una separazione chiara tra addestramento, validazione e test. Analizzate i falsi positivi per famiglia: sono le procedure classificate come utili pur non rispondendo alla richiesta. Distinguiteli dai falsi negativi del mining, che sono buone procedure usate erroneamente come controesempi di addestramento.
Un negativo difficile può essere una pertinenza non annotata. L'assenza del suo ID nella lista dei positivi non prova la sua inutilità. Conservate quindi l'audit del mining e un meccanismo di revisione. Correggere le annotazioni è una decisione sui dati, non un effetto automatico del modello.
Se adattate il modello, ricalcolate anche le rappresentazioni documentali con l'encoder corrispondente prima di confrontare le nuove query: mescolare due stati dell'encoder non riproduce più la ricerca con un unico modello descritta qui. Questa coerenza deriva dal funzionamento del percorso, non costituisce una funzione di migrazione dell'indice già fornita.
La domanda Atlas mostrata sopra è in inglese e la scheda del modello indica language: en. Un corpus francese costituisce quindi un esperimento da valutare separatamente; la traduzione didattica dell'articolo non ne convalida la qualità in francese.
Non trasformare una media locale in una promessa di servizio
Misurate la latenza con il vostro carico target. Una misura a caldo per query — quando il modello è già caricato — non descrive né il traffico concorrente né l'attesa in una coda di richieste. Non convalida neppure un indice ANN, cioè una ricerca approssimata dei vicini usata per evitare di confrontare in modo esaustivo tutti i vettori.
Il progetto non diventa un'API di produzione perché Recall@5 vale 1. L'ingestione documentale, i diritti di accesso, l'aggiornamento dell'indice, i salvataggi, i limiti di input e l'osservabilità richiedono una progettazione e test propri dell'applicazione. Queste estensioni sono distinte dall'esperimento misurato.
Diagnosticare senza modificare silenziosamente l'esperimento
CUDA fallisce. Rieseguite dapprima check_environment.py e consultate la guida NVIDIA Container Toolkit. Un errore di accesso alla GPU non è un motivo per cambiare la formula della loss.
L'acquisizione fallisce. Verificate la rete del servizio acquire, poi rieseguite lo stesso comando. Non modificate i file bloccati per accettare un asset diverso.
La loss rifiuta una query senza positivo incluso. Ispezionate gli ID, lo split e l'intersezione positive_mask & allowed. Rimuovere il controllo farebbe sparire il sintomo, non l'assenza di supervisione.
I punteggi sorprendono. Esaminate i ranghi dei due positivi, non soltanto il primo risultato o la loss. Un MRR perfetto può nascondere un secondo positivo troppo in basso; un Recall@5 già perfetto non può aumentare ulteriormente.
Infine, docker compose down --remove-orphans arresta i servizi del progetto e conserva i file locali descritti dal percorso. clean.py --dry-run visualizza soltanto ciò che avrebbe come obiettivo. Conservate gli output di riferimento prima di qualsiasi esperimento separato o eliminazione effettiva.
Fonti ufficiali
Modello e apprendimento. La scheda all-MiniLM-L6-v2 presenta il modello; la sua versione bloccata è collegata più sopra. Le documentazioni Sentence Transformers sulle loss, sul mining dei negativi difficili e sulla valutazione della ricerca approfondiscono questi argomenti. Non sostituiscono la formula multi-positivi propria del codice di questo archivio.
Calcolo numerico. I riferimenti PyTorch per normalize, softmax e logsumexp precisano le operazioni usate nelle spiegazioni. La pagina delle versioni PyTorch serve da riferimento di installazione; per riprodurre r1, conservate l'ambiente fissato nei blocchi.
Ambiente. Consultate Docker Compose e l'accesso alla GPU e la guida NVIDIA Container Toolkit per comprendere l'integrazione tra host, contenitore e scheda grafica.