





Imagine el centro de ayuda de su aplicación web. Un usuario indica que unos mensajes quedan bloqueados en una cola tras detenerse un worker. Su motor de búsqueda encuentra una ficha que explica cómo reiniciar ese worker. Es útil, pero una segunda ficha describe cómo volver a procesar los mensajes que quedaron sin confirmación de procesamiento. También responde al problema.
¿Cómo enseñar al motor a encontrar estos dos procedimientos, sin confundirlos con otras fichas que emplean las mismas palabras pero describen un incidente diferente?
Vamos a adaptar un modelo de embeddings: el programa que transforma textos en vectores para compararlos. La dificultad no consistirá solo en acercar una pregunta a una respuesta correcta. También habrá que impedir que una segunda respuesta correcta se convierta, por error, en un ejemplo que se debe alejar durante el entrenamiento.
Descargar el proyecto completo del tutorial
Lo que vamos a construir
El proyecto construye un pequeño motor de búsqueda sobre un corpus sintético de soporte. Codifica las consultas y los procedimientos con un mismo codificador, selecciona documentos engañosamente cercanos y, después, entrena ese codificador con una pérdida contrastiva de múltiples positivos. Por último, conserva las clasificaciones y calcula dos métricas: Recall@5 y MRR@10.
Dicho de otro modo, queremos modificar lo que el modelo considera «cercano». Dos procedimientos distintos pueden ser pertinentes para la misma solicitud; su diferencia no debe bastar para convertirlos en competidores incompatibles.
El recorrido separa tres responsabilidades: las anotaciones definen los procedimientos pertinentes; el entrenamiento utiliza esas anotaciones para adaptar el modelo; la evaluación comprueba después dónde aparecen los procedimientos en los resultados. El modelo no define por sí mismo las respuestas correctas según sus preferencias.
Este programa recupera y clasifica documentos. No construye ni un RAG completo —una búsqueda documental seguida de la generación de una respuesta— ni una regla de negocio que decida cómo resolver automáticamente un incidente.
Conceptos explicados antes del código
Un embedding: coordenadas para comparar textos
Un embedding es una lista de números calculada a partir de un texto. Puede imaginarlo como las coordenadas de un punto: el modelo considera similares dos textos cuyos vectores están cerca.
No elegimos manualmente un eje «avería» y un eje «reinicio». Los parámetros de la red, también llamados pesos, determinan cómo los textos se convierten en coordenadas. Por tanto, adaptar esos parámetros cambia la representación producida sin modificar el texto de los procedimientos.
El modelo utilizado es sentence-transformers/all-MiniLM-L6-v2, fijado en la revisión 1110a243fdf4706b3f48f1d95db1a4f5529b4d41 en locks/models.lock.json. Su ficha oficial en esta revisión describe vectores de 384 coordenadas. Un identificador de documento permite encontrar una ficha; su embedding sirve para compararla con una consulta. No son intercambiables.
Del texto a un único vector
El cálculo comprende varias transformaciones. El tokenizer divide el texto en unidades, los tokens, y después las reemplaza por identificadores numéricos. Un token puede ser una palabra o una parte de una palabra: no corresponde necesariamente a una palabra separada por espacios.
A continuación, el Transformer calcula un vector por posición teniendo en cuenta el contexto. Por ello tenemos varios vectores para un texto, mientras que la búsqueda espera uno solo. El pooling medio los reúne calculando una media, coordenada a coordenada.
Sin embargo, hay que ignorar el padding: las posiciones de relleno añadidas para que varios textos quepan en una tabla de la misma anchura. La máscara de atención indica las posiciones utilizadas, con 1 para las que se conservan y 0 para el relleno.
Tomemos un ejemplo didáctico con dos coordenadas, sin relación con los vectores producidos realmente por MiniLM. Dos posiciones útiles valen [1, 2] y [5, 6]. Una tercera posición es relleno. Con una máscara [1, 1, 0], la media vale [(1 + 5) / 2, (2 + 6) / 2], es decir, [3, 4]. La tercera posición no participa ni en la suma ni en el denominador.
Normalizar: comparar direcciones en lugar de tamaño
El recorrido aplica después F.normalize(..., dim=-1). Esta operación divide cada vector por su norma, con una protección para valores muy pequeños. La norma es aquí su longitud geométrica: para [3, 4], vale sqrt(3² + 4²) = 5. El vector normalizado pasa a ser [0.6, 0.8], cuya norma vale 1.
El producto escalar multiplica las coordenadas correspondientes y después suma los resultados. Para dos vectores de norma 1, corresponde a su similitud coseno, es decir, a una comparación de sus direcciones. Por ejemplo, [0.6, 0.8] comparado consigo mismo da 0.6² + 0.8² = 1.
Sin esta normalización, un vector más largo podría obtener un producto escalar superior simplemente por su tamaño. Aquí buscamos cercanía de representación, no un concurso de longitud. La documentación de normalize también precisa el tratamiento de normas muy pequeñas.
Una puntuación de similitud no demuestra pertinencia para el negocio. Dos fichas pueden hablar del mismo componente sin recomendar la acción correcta para el mismo incidente.
Positivos, negativos y ejemplos engañosos
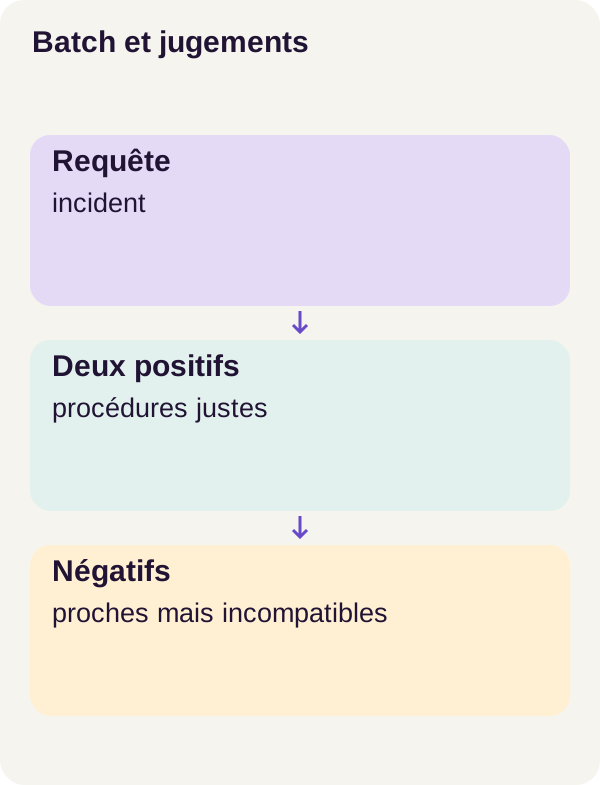
Un positivo es un documento anotado como pertinente para una consulta. Un negativo se utiliza como contraejemplo para esa consulta. Estas funciones dependen de la solicitud: un procedimiento puede ser pertinente para una pregunta y no serlo para otra.
Un negativo difícil, o hard negative, es un contraejemplo al que el modelo da, sin embargo, una puntuación alta. Permite trabajar una confusión concreta. Una ficha que habla de la misma cola de mensajes pero trata otro problema puede ser más instructiva que una ficha sin relación con las colas.
El mining designa la selección de estos contraejemplos. Utiliza la clasificación del modelo para encontrar candidatos cercanos, pero se apoya en las anotaciones para excluir las respuestas correctas. La documentación de Sentence Transformers sobre negativos difíciles presenta este principio general; el tutorial conserva su propio código de selección.
El peligro es el falso negativo: un procedimiento realmente pertinente que el entrenamiento trata como incorrecto. Con dos positivos, una convención que solo reconociera uno crearía precisamente este error.
Una pérdida contrastiva: aprender por comparación
Una pérdida, o loss, es el número que el entrenamiento intenta reducir. Una pérdida contrastiva compara candidatos: aquí anima al modelo a dar más peso a los documentos pertinentes que a los demás.
La retropropagación calcula los gradientes, que indican cómo una variación de los parámetros haría variar esta pérdida. El optimizador usa esta información para actualizar los pesos. Los tutoriales de PyTorch sobre gradientes y optimización detallan este ciclo. En cambio, calcular embeddings con un modelo ya cargado, sin modificar sus pesos, es inferencia.
Nuestra adaptación parte de un modelo existente: no aprendemos a leer textos desde cero. Le proporcionamos una supervisión más precisa sobre las asociaciones esperadas en este corpus.
Temperatura y softmax: ajustar el peso de las diferencias
El softmax transforma una fila de puntuaciones en números positivos cuya suma vale 1. Utiliza exp, la función exponencial: una función creciente que da un valor positivo, incluso para una puntuación negativa. Para el candidato j, calcula exp(score_j) / suma(exp(scores)). Estos valores expresan una distribución entre los candidatos considerados, no una probabilidad de negocio calibrada. La definición de softmax de PyTorch formaliza esta operación.
Durante el entrenamiento, las similitudes se dividen por una temperatura positiva antes de este cálculo. Una temperatura pequeña acentúa las diferencias; una temperatura más alta las atenúa.
Por ejemplo, las similitudes ficticias [0.4, 0.2, 0, -0.2] se convierten en las puntuaciones [2, 1, 0, -1] tras dividirlas por 0.2. El primer candidato recibe entonces aproximadamente el 64,39 % de la masa del softmax, frente al 32,92 % con una temperatura de 1. Son valores ilustrativos, no los parámetros ni las mediciones r1. La clasificación no cambia con esta división positiva; cambia la importancia otorgada a las diferencias.
Por último, log designa aquí el logaritmo natural, la función inversa de la exponencial. logsumexp calcula el logaritmo de una suma de exponenciales de forma numéricamente estable. Lo utilizaremos para reunir las contribuciones de varios positivos sin calcular ingenuamente exponenciales muy grandes. La documentación de torch.logsumexp describe esta operación.
Requisitos de Docker y GPU
Debe poder leer una función de Python, manejar listas e identificadores y ejecutar comandos en una terminal. El recorrido r1 utiliza Linux x86_64, Docker Compose, NVIDIA Container Toolkit y una RTX 3090 de 24 Gio.
Prevea también 16 Gio de RAM y 16 Gio de disco, sin contar las capas Docker compartidas. La RAM es la memoria del host; la memoria de la tarjeta gráfica es la VRAM. Estas previsiones describen el marco del proyecto, no mínimos demostrados en todas las máquinas. No se presenta ningún perfil de CPU como reproducción validada del recorrido de GPU.
locks/models.lock.json fija los activos del modelo y locks/environment.lock.json el entorno esperado. Mantenga estos bloqueos para reproducir la experiencia: sustituir una revisión por la rama actual cambiaría los elementos que comparamos.
El servicio acquire es el único que descarga los activos del modelo. El servicio gpu realiza después los cálculos locales. Construir una imagen Docker y adquirir los pesos son dos operaciones distintas: los pesos son los parámetros del modelo, no el código Python que los utiliza.
La comprobación del entorno inicializa CUDA y ejecuta un cálculo dentro del contenedor. Ver la tarjeta desde Linux no basta. Las documentaciones de Docker Compose para GPU y NVIDIA Container Toolkit explican esta integración.
Datos y funciones centrales
Conocer las respuestas correctas antes de entrenar
El corpus sintético contiene 240 documentos y 72 consultas de prueba. Cada consulta posee exactamente dos positive_ids. Estos identificadores constituyen la referencia utilizada para determinar qué procedimientos son pertinentes.
Las familias se separan en train, validation y test antes del entrenamiento. Train proporciona los ejemplos que influyen en los pesos; validation permite observar las decisiones de entrenamiento; test queda reservado para la clasificación final. Separar las familias evita que una simple reformulación del mismo conjunto de casos aparezca a ambos lados de la evaluación.
Una consulta de entrenamiento solo extrae documentos de entrenamiento. El mining los clasifica con el modelo actual, elimina explícitamente los dos IDs positivos y conserva los negativos. Por tanto, no adivina su pertinencia. Esta frontera impide que el optimizador ya haya visto un procedimiento de prueba como contraejemplo.
No confunda los 240 documentos anunciados para el corpus con la población autorizada para el mining de entrenamiento: esta última está limitada al split train. Los efectivos detallados y las pertenencias se consultan en los datos preparados.
Nuestro hilo conductor: dos procedimientos, no dos copias
El ejemplo r1 atlas-queue-q0 contiene esta pregunta:
The Atlas messages remain pending after the queue worker crashes. What should the operator do?
Para entenderla en español: «Los mensajes Atlas permanecen pendientes después de que falle el worker de la cola. ¿Qué debe hacer el operador?». Esta traducción acompaña la lectura; no sustituye el texto del experimento.
Un worker es el proceso que se encarga de los trabajos de una cola. Un mensaje no confirmado no ha recibido la confirmación esperada de su procesamiento. Volver a procesar un mensaje de este tipo exige controlar las repeticiones: una clave de idempotencia sirve para identificar una operación y evitar que repetirla reproduzca indebidamente sus efectos.
Los dos procedimientos anotados responden a aspectos distintos de este incidente:
| Identificador positivo | Función del procedimiento en este ejemplo |
|---|---|
atlas-queue-procedure-a |
Inspeccionar y reiniciar el worker. |
atlas-queue-procedure-b |
Volver a procesar los mensajes no confirmados con claves de idempotencia. |
No buscamos fusionar estos textos ni considerar que uno siempre reemplaza al otro. Los dos deben seguir siendo positivos para esta consulta. Encontrar estas fichas no constituye, por sí solo, una validación operativa de su ejecución.
Construir la máscara a partir de los identificadores
Un batch, o lote, reúne varios ejemplos tratados conjuntamente. La matriz scores contiene una fila por consulta y una columna por documento candidato. Por tanto, su forma es B × D, con B consultas y D documentos.
positive_mask tiene exactamente la misma forma. Contiene True cuando el documento de la columna es pertinente para la consulta de la fila. Por lo tanto, una misma fila puede contener varios True.
La función make_batch, en src/contrastive_search/mining.py, construye esta máscara a partir de los identificadores y después comprueba la presencia de dos positivos por consulta. Es el equivalente a una unión por clave en una aplicación: cambiar el orden de las filas no debe cambiar su significado.
Una diagonal solo marca las posiciones en que el número de fila coincide con el de columna. Por sí sola, no puede representar dos positivos en una fila. Por tanto, una convención de posición dentro del lote no debe reemplazar nuestras anotaciones.
Leer el núcleo de la pérdida
Aquí está el extracto central continuo de src/contrastive_search/losses.py. Recibe puntuaciones ya calculadas, una máscara de pertinencia y, opcionalmente, una máscara de candidatos incluidos en el cálculo.
def multi_positive_nce(scores, positive_mask, allowed=None):
    if scores.ndim != 2 or positive_mask.shape != scores.shape:
        raise ValueError("B x D scores and positive mask required")
    allowed = (
        torch.ones_like(positive_mask, dtype=torch.bool) if allowed is None else allowed
    )
    if not torch.isfinite(scores).all():
        raise ValueError("Non-finite scores")
    if ((positive_mask & allowed).sum(1) == 0).any():
        raise ValueError("Each query needs an allowed positive")
    denominator = torch.logsumexp(scores.masked_fill(~allowed, -torch.inf), dim=1)
    numerator = torch.logsumexp(
        scores.masked_fill(~(positive_mask & allowed), -torch.inf), dim=1
    )
    return (denominator - numerator).mean()
Comencemos por las entradas. scores es una tabla de números de PyTorch, también llamada tensor. positive_mask es la tabla de booleanos que le corresponde. Cuando no se proporciona allowed, se incluyen todos los candidatos.
El nombre allowed significa aquí «tenido en cuenta en la fórmula». Esta máscara no es ni una autenticación ni una regla de derechos documentales. En estas tablas de booleanos, ~ invierte True y False, mientras que & aplica un «y» celda por celda.
El denominador considera todos los candidatos incluidos. masked_fill(~allowed, -torch.inf) reemplaza las puntuaciones excluidas por menos infinito. Como su exponencial vale cero, dejan de contribuir a la suma. dim=1 pide realizar este cálculo sobre las columnas, por separado para cada consulta.
El numerador considera todos los positivos incluidos. La expresión positive_mask & allowed conserva la intersección de las dos máscaras. Así, los dos procedimientos correctos participan juntos en el numerador, en vez de conservar solo uno.
Para una consulta, calculamos así:
L = log(suma de exp(scores) de los candidatos incluidos) − log(suma de exp(scores) de los positivos incluidos).
Los nombres denominator y numerator designan, en el código, los logaritmos de estas dos sumas. Su diferencia equivale a −log(numerador / denominador). El .mean() final promedia esta pérdida entre las consultas del lote, no entre los documentos positivos por separado.
Rehacer un cálculo a mano
Retomemos la fila de demostración [2, 1, 0, -1], con los dos primeros documentos positivos y todos los candidatos incluidos. Las cuatro puntuaciones son didácticas; no son salidas capturadas del modelo.
| Columna | Puntuación | ¿Documento positivo? | Contribución exp(score), redondeada |
|---|---|---|---|
| 0 | 2 | Sí | 7,389056 |
| 1 | 1 | Sí | 2,718282 |
| 2 | 0 | No | 1,000000 |
| 3 | −1 | No | 0,367879 |
La suma de todas las contribuciones vale aproximadamente 11,475217. La de los dos positivos vale aproximadamente 10,107338. Por tanto, la relación vale aproximadamente 0,880797, y la pérdida −log(0,880797) vale aproximadamente 0,126928.
Aquí el modelo asigna aproximadamente el 88,08 % de la masa del softmax al conjunto de respuestas correctas. La pérdida disminuye cuando esta masa se acerca a 1. Los cálculos numéricos anteriores se realizan antes de redondear los valores mostrados.
Con una máscara que declarara positiva solo la columna 0, el numerador conservaría únicamente 7,389056. La pérdida pasaría a ser aproximadamente 0,440190. Sobre todo, la columna 1 seguiría en el denominador sin participar en el numerador: aumentar su puntuación incrementaría la pérdida, aunque la segunda ficha sea pertinente.
Lo que esta fórmula garantiza y lo que no garantiza
La función evita tratar el segundo positivo como un negativo. Sin embargo, favorece el conjunto de positivos, sin exigir que reciban la misma puntuación. No es una media de dos pérdidas independientes, cada una de las cuales exigiría que su documento ganase por sí solo.
Por tanto, un procedimiento correcto puede recibir la mayor parte de la masa del softmax, y el otro mucho menos. Si todos los candidatos incluidos son positivos, el numerador y el denominador incluso se vuelven idénticos: la pérdida vale cero, sea cual sea su orden.
Esto explica por qué medimos después la presencia de los dos procedimientos en el top 5. Una pérdida baja no basta para demostrar que cada uno está bien clasificado.
Las salvaguardas también tienen un alcance preciso. La función comprueba la forma de scores y positive_mask, la finitud de las puntuaciones y la existencia de al menos un positivo incluido por consulta. No comprueba por sí misma que haya exactamente dos: ese control corresponde a make_batch. Quien llama a la función debe proporcionar máscaras booleanas compatibles.
La comprobación de valores finitos se realiza antes del enmascaramiento. Por tanto, un NaN o un infinito ya presente en scores se rechaza incluso si su columna debía excluirse después. Los menos infinitos introducidos deliberadamente por masked_fill, por su parte, sirven para retirar contribuciones del cálculo.
Por último, este extracto no codifica los textos, no elige los negativos ni divide las similitudes por la temperatura. Tampoco contiene backward() ni actualización de pesos. Calcula una pérdida diferenciable que el bucle de entrenamiento utiliza después.
Instalar, comprobar y preparar los datos
Extraiga el ZIP y sitúese en su carpeta raíz. Todos los comandos siguientes se ejecutan desde esta raíz, en el orden indicado.
Primero preparamos los directorios, comprobamos la configuración de Compose, construimos las imágenes, adquirimos los activos bloqueados, comprobamos CUDA y ejecutamos las pruebas. Los seis comandos siguientes son los seis primeros comandos del recorrido r1.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
docker compose config --quiet comprueba la configuración sin mostrar todo el archivo resuelto. La compilación prepara las imágenes. La adquisición valida los archivos definidos por los bloqueos; la comprobación del entorno verifica el cálculo CUDA; pytest ejecuta las pruebas del proyecto. La documentación de Docker Compose detalla el comando de validación.
No continúe si falla una etapa. Una suite de pruebas satisfactoria verifica comportamientos del programa; todavía no dice si el codificador adaptado clasificará mejor los procedimientos.
Ahora preparemos el corpus, inspeccionemos los vectores y extraigamos los negativos. Todavía no entrenamos el modelo.
docker compose run --rm gpu python -m contrastive_search.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m contrastive_search.cli inspect-embeddings --config configs/minimum.yaml
docker compose run --rm gpu python -m contrastive_search.cli mine --config configs/minimum.yaml
docker compose run --rm gpu python -m contrastive_search.cli check-loss --config configs/minimum.yaml
Después de prepare, inspeccione los splits y los identificadores. Después de inspect-embeddings, relacione los vectores con los textos de los que proceden: una tabla de coordenadas no es por sí sola una clasificación completa.
Después de mine, abra outputs/mining-audit.json. Compruebe que los negativos proceden de train y que ninguno de los positive_ids se ha seleccionado como negativo. La fracción esperada de falsos negativos es nula con respecto a las anotaciones conocidas. Esta comprobación no podría descubrir un tercer procedimiento pertinente que nadie hubiera anotado.
Por último, check-loss comprueba la fórmula con tensores conocidos. Sirve para detectar un error de mecanismo antes de buscarlo entre miles de cálculos de entrenamiento.
Entrenar y comprobar la reanudación
Vamos a comparar tres entrenamientos. La referencia hard, lanzada sin opción de variante, utiliza negativos difíciles. random cambia su selección; temperature cambia la temperatura. Cada variante modifica una decisión experimental para que las diferencias sigan siendo interpretables.
Atención al vocabulario: más adelante, baseline designará el modelo anterior a esta adaptación. La referencia hard, en cambio, es un entrenamiento. No son dos nombres para el mismo estado.
Los valores exactos de las temperaturas y los demás parámetros de entrenamiento siguen siendo los de la configuración del proyecto. Los números empleados en nuestros ejemplos de cálculo no los sustituyen.
Los últimos comandos provocan una interrupción, reanudan desde el checkpoint creado y comparan la reanudación. Respete este orden: el archivo artifacts/checkpoints/interrupted/state.pt debe existir antes del comando que lo carga.
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml --variant random
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml --variant temperature
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml --stop-after 10 --run-name interrupted
docker compose run --rm gpu python -m contrastive_search.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m contrastive_search.cli compare-resume --config configs/minimum.yaml
Un checkpoint es una copia de un estado de cálculo. Recuperar pesos para hacer una búsqueda y recuperar el estado necesario para continuar el aprendizaje son dos necesidades distintas. Según el bucle, la reanudación también puede depender del optimizador, del avance en los datos y de los generadores aleatorios. La documentación de PyTorch sobre copias para reanudar explica por qué conservar solo los pesos no siempre basta. El contenido exacto de la copia de este proyecto puede consultarse en el archivo.
compare-resume sirve precisamente para comprobar que se ha reconstruido el estado necesario, en lugar de juzgar el parecido de dos curvas. Lea sus comprobaciones: una carga sin errores no demuestra, por sí sola, una reanudación equivalente.
Medir antes del ejercicio
Calculemos ahora las clasificaciones de referencia, antes de cualquier modificación guiada del ejercicio.
docker compose run --rm gpu python -m contrastive_search.cli evaluate --config configs/minimum.yaml
El comando escribe las métricas y los rangos en outputs/. Estos dos tipos de salida son complementarios: una métrica resume el lote, mientras que una clasificación permite comprender lo que ocurrió para una consulta concreta.
Para una primera lectura, encuentre el ID de una pregunta, sus dos positive_ids y después sus posiciones en cada clasificación. Pase luego a las medias sobre el conjunto de prueba. Una búsqueda lograda no basta para establecer la calidad de todo el sistema.
Métricas antes de las mediciones
Recall@5: ¿hemos recuperado los dos procedimientos?
Recall@5, o recuperación entre los cinco resultados, es la fracción de documentos pertinentes presentes entre los cinco primeros:
Recall@5 = número de positivos en el top 5 / número total de positivos esperados.
Con dos procedimientos pertinentes, solo uno en el top 5 da 1 / 2 = 0,5. Los dos dan 2 / 2 = 1. La media final reúne las contribuciones de las consultas.
Aquí el denominador vale 2, no 5. La recuperación pregunta «¿qué parte de los procedimientos correctos he recuperado?». No pregunta «¿qué parte de los cinco resultados es pertinente?», que sería otra métrica, la precisión. Por tanto, dos procedimientos correctos entre cinco resultados pueden dar un 100 % de recuperación sin que los cinco resultados sean pertinentes.
MRR@10: ¿dónde aparece el primer procedimiento correcto?
Para una consulta, el rango recíproco es el inverso del rango del primer positivo dentro de las diez primeras posiciones. Un positivo en el rango 1 da 1; en el rango 2, 1 / 2 = 0,5; en el rango 4, 1 / 4 = 0,25. Si no hay ninguno entre los diez primeros, la contribución vale 0.
MRR significa Mean Reciprocal Rank: después calculamos la media de estas contribuciones entre las consultas. Por ejemplo, tres contribuciones 1, 0,5 y 0 dan un MRR de (1 + 0,5 + 0) / 3 = 0,5. Este pequeño cálculo ilustra la métrica, no el lote r1.
El MRR ignora la posición del segundo positivo en cuanto encuentra el primero. Por ello hay que leerlo junto con Recall@5, no en su lugar. La documentación de evaluación de búsqueda de Sentence Transformers sitúa estas métricas en un dispositivo basado en consultas, corpus y anotaciones.
Seis clasificaciones para distinguir las dos cuestiones
Aquí tiene ejemplos didácticos con exactamente dos positivos. Los números indican sus rangos, empezando por 1; los demás documentos no son pertinentes.
| Rangos de los dos positivos | Recall@5 de la consulta | Rango recíproco a 10 | Lo que observamos |
|---|---|---|---|
| 1 y 2 | 1 | 1 | Los dos procedimientos están en cabeza. |
| 1 y 5 | 1 | 1 | Mismas métricas, pero el segundo positivo está más abajo. |
| 2 y 4 | 1 | 0,5 | Los dos se recuperan; ninguno llega primero. |
| 1 y 8 | 0,5 | 1 | El primero está idealmente situado; el segundo falta en el top 5. |
| 6 y 9 | 0 | Aproximadamente 0,1667 | Los positivos están en el top 10, no en el top 5. |
| 11 y 12 | 0 | 0 | No hay positivos en los intervalos medidos. |
Dos consecuencias se hacen visibles. Un Recall@5 perfecto puede coexistir con un MRR aún mejorable. E incluso cuando ambas métricas valen 1, no demuestran que los dos procedimientos ocupen las dos primeras posiciones.
Resultados reales y lo que hemos aprendido
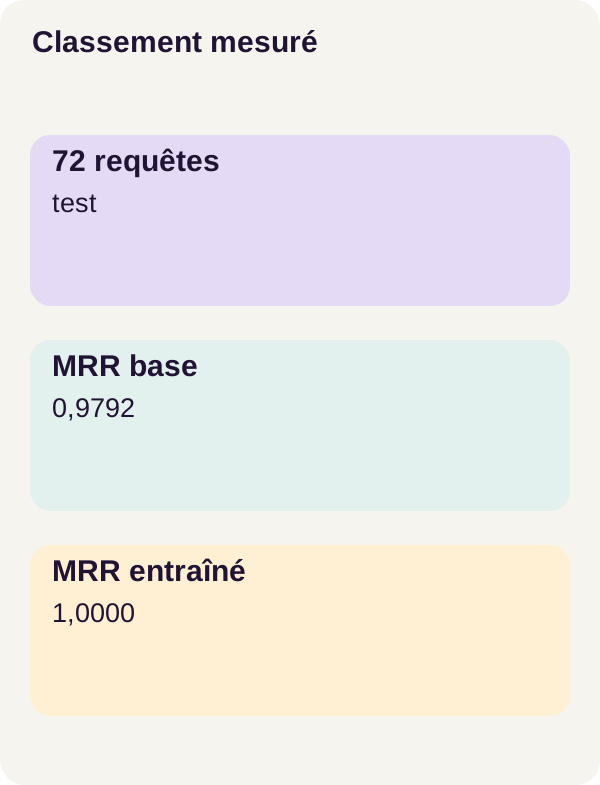
Los valores siguientes son las mediciones r1 comunicadas sobre 72 consultas de prueba y 240 documentos. Son distintos de los ejemplos de cálculo anteriores.
| Estado evaluado | Recall@5 | MRR@10 |
|---|---|---|
| Baseline, antes de la adaptación | 1,0 | 0,9791666666666666 |
Entrenamiento random |
1,0 | 1,0 |
Entrenamiento hard |
1,0 | 1,0 |
Entrenamiento temperature |
1,0 | 1,0 |
La primera observación es que la recuperación no progresa: ya es perfecta antes del entrenamiento. La baseline recupera los dos procedimientos pertinentes entre los cinco primeros resultados para cada consulta evaluada.
El MRR, por su parte, pasa de 0,9791666666666666 a 1,0. Tras cada uno de los tres entrenamientos, el primer procedimiento pertinente alcanza el primer rango de cada consulta del lote. Esto no implica que el segundo ocupe sistemáticamente el rango 2: la tabla didáctica anterior muestra por qué.
Las tres variantes entrenadas obtienen las mismas métricas. Por tanto, no podemos atribuir a los negativos difíciles una superioridad que esta tabla no muestra. El corpus sintético es pequeño y ya fácil; expone el funcionamiento de este protocolo, no una clasificación universal de estrategias de entrenamiento.
El agregado tampoco proporciona la distribución detallada de los rangos de la baseline. Para saber qué consultas cambiaron, vuelva a leer las clasificaciones guardadas en lugar de reconstruir una historia a partir de la media sola.
La lección principal es estructural: las etiquetas de pertinencia deben sobrevivir a la construcción del batch. Un segundo procedimiento correcto sigue siendo correcto, sea cual sea su columna en la matriz. Y una pérdida bien calculada nunca elimina la necesidad de medir la clasificación final.
Ejercicio: predecir y ejecutar
Retomemos la fila [2, 1, 0, -1]. Las columnas 0 y 1 corresponden a los dos procedimientos pertinentes. Imagine ahora que una máscara basada en la diagonal solo conserva uno: únicamente la columna 0 permanece marcada como positiva.
Antes de ejecutar el comando, anote su predicción: ¿el gradiente de la puntuación de la columna 1 animará esa puntuación a subir o a bajar?
Para leer el signo, tenga presente una actualización elemental: nuevo_score = score − paso × gradiente, con un paso positivo. Por tanto, un gradiente negativo empuja la puntuación hacia arriba; un gradiente positivo la empuja hacia abajo. Hablamos aquí de la derivada con respecto a la puntuación para aislar el mecanismo.
docker compose run --rm gpu python -m contrastive_search.cli exercise --config configs/exercise.yaml
La salida del ejercicio conserva los dos gradientes y confirma la repulsión injustificada cuando el segundo positivo deja de estar marcado. Compárela con su predicción.
Para acompañar esta lectura, estas son las derivadas calculadas sobre nuestra fila didáctica, con todos los candidatos incluidos y una sola consulta. No se presentan como una captura del entrenamiento r1.
| Columna | Gradiente con dos positivos | Gradiente solo con el primer positivo | Efecto de la segunda convención |
|---|---|---|---|
| 0, positivo | −0,087144 | −0,356086 | El primer positivo sigue siendo favorecido. |
| 1, positivo | −0,032059 | +0,236883 | El segundo positivo ahora se aleja. |
| 2, negativo | +0,087144 | +0,087144 | El negativo sigue alejándose. |
| 3, negativo | +0,032059 | +0,032059 | El negativo sigue alejándose. |
El cambio de signo en la columna 1 es el defecto que hay que recordar. El modelo no ha descubierto que el procedimiento sea incorrecto: le hemos dado una supervisión incorrecta.
En la red real, las puntuaciones comparten los mismos parámetros. Estas derivadas describen la presión que la pérdida ejerce sobre cada puntuación; no garantizan que cada puntuación evolucione de forma aislada en ese sentido tras actualizar todos los pesos.
Después, termine los artefactos y detenga el recorrido, en este orden:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
El primer comando genera las figuras; el segundo comprueba los checkpoints, incluidos los creados durante el entrenamiento. clean.py --dry-run solo hace una previsualización de la limpieza y no elimina ningún archivo. El último comando detiene los recursos Compose del proyecto. No confunda esta previsualización con la detención efectiva de los contenedores.
Adaptación, producción, diagnóstico y limpieza
Pasar del corpus sintético a sus documentos
Para adaptar el mecanismo, comience con juicios de pertinencia versionados y revisados. Una solicitud puede tener dos procedimientos correctos, pero también uno, más de dos o ninguno. El contrato «exactamente dos positivos» pertenece a este tutorial; no debe convertirse en una hipótesis implícita sobre sus datos reales.
Mantenga una separación clara entre entrenamiento, validación y prueba. Analice los falsos positivos por familia: son procedimientos clasificados como útiles aunque no respondan a la solicitud. Distíngalos de los falsos negativos del mining, que son procedimientos correctos usados erróneamente como contraejemplos de entrenamiento.
Un negativo difícil puede ser un documento pertinente sin anotar. Que su ID no figure en la lista de positivos no demuestra que sea inútil. Conserve por tanto la auditoría de mining y un mecanismo de revisión. Corregir las anotaciones es una decisión sobre los datos, no un efecto automático del modelo.
Si adapta el modelo, recalcule también las representaciones documentales con el codificador correspondiente antes de comparar las nuevas consultas: mezclar dos estados de codificador ya no reproduce la búsqueda con un mismo modelo descrita aquí. Esta coherencia se deriva del funcionamiento del recorrido; no constituye una función de migración de índice ya proporcionada.
La pregunta Atlas mostrada arriba está en inglés y la ficha del modelo indica language: en. Por tanto, un corpus en español constituye un experimento que debe evaluarse por separado; la traducción pedagógica del artículo no valida su calidad en español.
No convertir una media local en una promesa de servicio
Mida la latencia con su carga objetivo. Una medición en caliente por consulta —cuando el modelo ya está cargado— no describe ni el tráfico concurrente ni la espera en una cola de solicitudes. Tampoco valida un índice ANN, es decir, una búsqueda de vecinos aproximados utilizada para evitar comparar exhaustivamente todos los vectores.
El proyecto no se convierte en una API de producción porque Recall@5 valga 1. La ingestión documental, los derechos de acceso, la actualización del índice, las copias de seguridad, los límites de entrada y la observabilidad requieren un diseño y unas pruebas propios de la aplicación. Estas ampliaciones son independientes del experimento medido.
Diagnosticar sin modificar silenciosamente el experimento
CUDA falla. Vuelva a ejecutar primero check_environment.py y consulte la guía de NVIDIA Container Toolkit. Un error de acceso a la GPU no es motivo para cambiar la fórmula de pérdida.
La adquisición falla. Compruebe la red del servicio acquire y vuelva a ejecutar el mismo comando. No modifique los archivos bloqueados para aceptar un activo diferente.
La pérdida rechaza una consulta sin positivo incluido. Inspeccione los IDs, el split y la intersección positive_mask & allowed. Eliminar la comprobación haría desaparecer el síntoma, no la falta de supervisión.
Las puntuaciones sorprenden. Examine los rangos de los dos positivos, no solo el primer resultado o la pérdida. Un MRR perfecto puede ocultar un segundo positivo demasiado abajo; un Recall@5 ya perfecto no puede aumentar más.
Por último, docker compose down --remove-orphans detiene los servicios del proyecto y conserva los archivos locales descritos por el recorrido. clean.py --dry-run solo muestra lo que apuntaría. Conserve las salidas de referencia antes de cualquier experimento separado o eliminación efectiva.
Fuentes oficiales
Modelo y aprendizaje. La ficha all-MiniLM-L6-v2 presenta el modelo; su versión bloqueada está enlazada más arriba. Las documentaciones de Sentence Transformers sobre losses, mining de negativos difíciles y evaluación de búsqueda profundizan en estos temas. No sustituyen la fórmula de múltiples positivos propia del código de este archivo.
Cálculo numérico. Las referencias de PyTorch para normalize, softmax y logsumexp precisan las operaciones utilizadas en las explicaciones. La página de versiones de PyTorch sirve como referencia de instalación; para reproducir r1, mantenga el entorno fijado en los bloqueos del proyecto.
Entorno. Consulte Docker Compose y el acceso a GPU y la guía de NVIDIA Container Toolkit para comprender la integración entre host, contenedor y tarjeta gráfica.