





Imaginez le back-office d'une boutique : un utilisateur dépose une image, et vous souhaitez lui suggérer une catégorie avant qu'il enregistre sa fiche produit. Pour votre application, la question semble simple : « Est-ce un pull, une chaussure ou un sac ? » Pour le modèle, il faut apprendre à reconnaître des motifs dans les pixels.
Un premier réseau peut donner des résultats intéressants, tout en étant trop coûteux pour l'environnement où vous souhaitez l'exécuter. Vous construisez donc un réseau plus petit. Mais comment l'entraîner : uniquement avec les bonnes réponses du jeu de données, ou également avec les prédictions du grand réseau ?
C'est la question de ce tutoriel. La distillation consiste ici à entraîner un petit modèle, appelé étudiant, en utilisant les probabilités d'un modèle enseignant, en plus des labels connus. Nous allons suivre ce transfert, comprendre son calcul et vérifier s'il améliore réellement l'étudiant.
Le résultat n'est pas écrit à l'avance : un étudiant plus petit n'est pas nécessairement meilleur après distillation. Dans l'expérience présentée, il fait même moins bien que le même type d'étudiant entraîné uniquement sur les labels. Ce résultat négatif est précisément une occasion d'apprendre à comparer correctement deux méthodes.
Télécharger le projet complet du tutoriel
Ce que nous construisons
Nous construisons une expérience locale en Python et Docker autour de Fashion-MNIST, un jeu d'images de vêtements, chaussures et accessoires. Le back-office décrit plus haut donne une motivation concrète ; le projet ne fournit pas cette interface et ne valide pas la classification de photographies réelles de votre catalogue.
Nous entraînons et comparons trois modèles :
| Modèle | Ce qu'il apprend à partir des données | Pourquoi le conserver dans la comparaison |
|---|---|---|
| Enseignant CNN | Associer chaque image à son label | Mesurer la qualité du modèle qui fournit les probabilités |
| Étudiant sur labels | Retrouver le label avec une architecture plus petite | Établir ce que le petit réseau sait faire sans distillation |
| Étudiant distillé | Retrouver le label et rapprocher ses probabilités de celles de l'enseignant | Tester l'intérêt du signal supplémentaire de l'enseignant |
Les deux étudiants ont la même architecture et le même nombre de paramètres, mais leur objectif d'apprentissage diffère. Cela ne signifie pas que leurs poids appris seront identiques.
Le programme compare précision, macro-F1, nombre de paramètres, taille des poids et temps chaud. Les 10 000 images du test officiel sont conservées. Les doublons identiques sont exclus du pool train/validation avant la sélection stratifiée ; nous reviendrons sur le rôle de cette préparation.
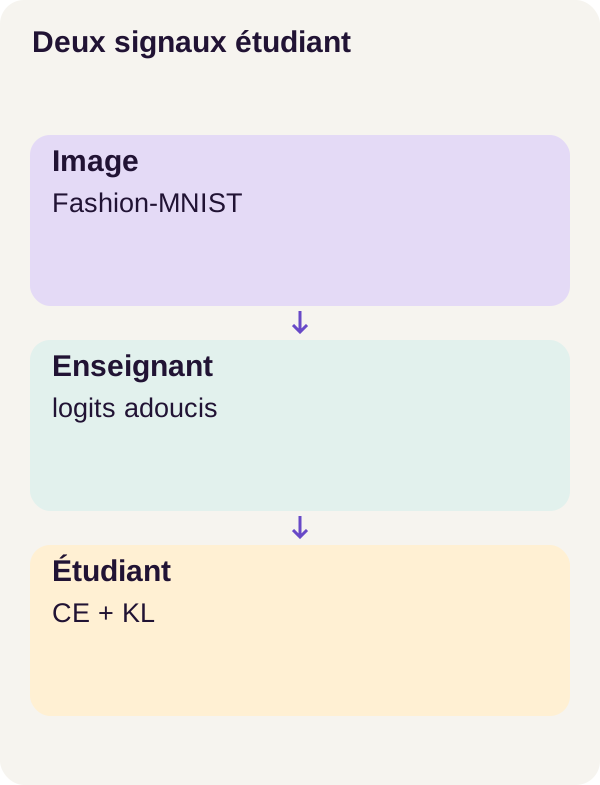
La distillation n'est donc ni une compression ZIP des poids ni une copie du grand réseau dans le petit. La petite architecture existe déjà ; nous cherchons une façon de mieux l'entraîner. Une fois entraîné, l'étudiant peut produire ses propres prédictions sans consulter l'enseignant.
Les petits exemples numériques qui suivent servent à comprendre les formules. Ils ne sont pas des sorties capturées du modèle. Les résultats expérimentaux r1 sont regroupés dans la section « Résultats réels et apprentissage ».
Concepts expliqués
D'une image à dix scores
Une image Fashion-MNIST mesure 28 × 28 pixels, en niveaux de gris. On peut la représenter comme un tableau de 784 intensités. Ces 784 valeurs sont les données d'entrée, pas les paramètres du modèle.
Une CNN, pour convolutional neural network, est un réseau de neurones convolutionnel. Elle applique de petits filtres sur différentes zones de l'image. Chaque filtre combine les pixels voisins, puis produit une carte d'activation : un nouveau tableau indiquant où il réagit. Les couches suivantes combinent ces cartes pour construire d'autres représentations.
On peut rapprocher le principe d'un filtre de traitement d'image, avec une différence essentielle : les valeurs des filtres sont apprises, plutôt que choisies à la main. Les paramètres sont ces nombres ajustables, ainsi que les autres poids et biais du réseau. Une convolution réutilise ses filtres à plusieurs positions ; elle n'attribue pas nécessairement un paramètre distinct à chaque pixel.
À la fin, le réseau produit dix logits, un par classe. Un logit est un score brut : il peut être négatif et les dix scores ne sont pas obligés de totaliser 1.
Le softmax transforme cette liste en une distribution de probabilités : chaque valeur est positive et leur somme vaut 1. La classe au score le plus élevé donne la prédiction de classification. Une telle distribution décrit la préférence du modèle ; elle ne prouve pas que sa confiance correspond à sa fréquence réelle de réussite.
Le dépôt officiel Fashion-MNIST décrit les images et les dix classes, parmi lesquelles figurent notamment pull, chemise et sac.
Pourquoi transmettre autre chose que la bonne réponse ?
Un label est la classe attendue d'une image. Il indique par exemple « pull ». C'est une information indispensable, mais elle ne décrit pas les ressemblances éventuelles avec les autres classes.
L'enseignant fournit une distribution plus détaillée. Il peut donner une forte probabilité au pull, une probabilité secondaire à la chemise et une probabilité faible au sac. L'hypothèse de distillation est que cette répartition apporte un signal utile au petit réseau : certaines confusions sont plus plausibles que d'autres.
Mais l'enseignant peut aussi se tromper. Ses probabilités ne deviennent pas une vérité simplement parce que son réseau est plus grand. Nous conservons donc les labels, puis nous mesurons le résultat sur des images de test.
La température : rendre les classes secondaires plus visibles
La température T intervient avant le softmax : nous divisons les logits par T. Pour une classe i, la formule est :
p_i(T) = exp(z_i / T) / somme_j exp(z_j / T).
z_i désigne le logit de la classe ; exp est l'exponentielle. Le dénominateur ramène la somme des probabilités à 1.
Prenons un exemple fictif à trois classes, et non les dix sorties réelles du projet. Les logits sont [3, 1, 0], associés dans cet ordre à pull, chemise et sac.
| Classe fictive | Logit initial | Probabilité avec T=1 | Probabilité avec T=3 |
|---|---|---|---|
| Pull | 3 | 84,38 % | 53,15 % |
| Chemise | 1 | 11,42 % | 27,29 % |
| Sac | 0 | 4,20 % | 19,55 % |
Les pourcentages sont arrondis. À T=3, les probabilités sont moins concentrées sur le premier choix : la distribution est adoucie. La classe pull reste première. À logits fixes, diviser par une température positive ne change pas leur ordre ; cela change la répartition utilisée pour apprendre.
Augmenter la température ne rend donc pas mécaniquement une prédiction plus juste. Cela modifie le signal transmis à l'étudiant.
Deux consignes d'apprentissage, deux termes de perte
La perte, ou loss, est un nombre que l'entraînement cherche à réduire. Dans ce projet, elle combine deux questions.
L'entropie croisée, ou CE, demande : « Quelle probabilité l'étudiant donne-t-il à la vraie classe ? » Avec un label unique, elle vaut, pour une image, le négatif du logarithme de cette probabilité. Une probabilité de 0,8 donne environ 0,2231 de perte ; une probabilité de 0,2 donne environ 1,6094. Donner moins de probabilité à la bonne réponse coûte donc davantage.
La divergence KL demande : « À quel point la distribution de l'étudiant s'écarte-t-elle de celle de l'enseignant ? » Elle prend en compte toutes les classes, pas uniquement le premier choix. Ici, le sens est KL(enseignant || étudiant) : l'enseignant fournit la distribution cible. Cette divergence n'est généralement pas symétrique.
L'entraînement combine ces deux termes. La rétropropagation, appelée backward, calcule ensuite leurs gradients : comment une petite variation des paramètres ferait varier la perte. L'optimiseur utilise ces gradients pour mettre à jour les poids. À l'inverse, l'inférence utilise un réseau déjà entraîné pour prédire, sans apprendre sur l'image soumise.
Prérequis Docker et GPU
Pour suivre le code, vous devez savoir lire des fonctions Python, manipuler des tableaux et utiliser un terminal. Les commandes supposent les bases de Docker : une image décrit l'environnement logiciel, un conteneur exécute cet environnement et Compose organise les services.
Le parcours r1 demande Linux x86_64, Docker Compose, NVIDIA Container Toolkit et une RTX 3090 de 24 Gio. Le README conseille 16 Gio de RAM et 16 Gio de disque, hors couches Docker. Ce sont les ressources indiquées pour ce parcours ; aucun profil CPU n'est validé.
La RAM appartient à la machine hôte ; la mémoire vidéo appartient au GPU. NVIDIA Container Toolkit permet d'exposer les ressources GPU à Docker. Une carte reconnue par Linux ne suffit pas : check_environment.py doit aussi vérifier CUDA dans le conteneur.
Le service acquire télécharge les archives publiques. Le service gpu exécute les calculs locaux. locks/models.lock.json verrouille les archives et locks/environment.lock.json l'environnement. Ces fichiers jouent un rôle comparable à un fichier de verrouillage des dépendances : ils fixent les actifs attendus pour que l'expérience ne change pas silencieusement.
Les références de documentation en fin d'article expliquent les mécanismes. Les versions à employer pour reproduire r1 restent celles du projet, pas celles d'un autre tutoriel ou d'une installation mise à jour au hasard.
Données et fonction centrale
Séparer les images d'apprentissage et les images d'évaluation
Le jeu officiel Fashion-MNIST fournit 60 000 images d'entraînement et 10 000 images de test. Le premier ensemble constitue le pool de départ dans lequel préparer entraînement et validation ; il ne faut pas le confondre avec la taille finalement sélectionnée par la configuration de ce tutoriel.
Le train sert à mettre à jour les poids. La validation sert à observer les choix d'entraînement. Le test sert à comparer les modèles une fois ces choix fixés. Ici, les 10 000 images du test officiel restent conservées.
Avant la sélection train/validation, le projet exclut les doublons identiques du pool concerné. La sélection est ensuite stratifiée : elle tient compte des classes pour contrôler leur représentation. Ces deux opérations répondent à des problèmes distincts. Équilibrer les classes ne suffit pas à empêcher qu'une image soit présente plusieurs fois.
Les effectifs finaux train/validation et le nombre de doublons retirés ne sont pas chiffrés dans les résultats reproduits dans cet article. Relevez-les dans les traces de prepare : ne les déduisez pas du seul effectif officiel de Fashion-MNIST.
Un grand réseau et un petit réseau, mais la même sortie
L'enseignant possède 93 962 paramètres. Il comporte trois blocs convolutionnels de largeurs 32, 64, 128. L'étudiant possède 5 130 paramètres, avec deux blocs de largeurs 16, 32. Ces largeurs désignent le nombre de canaux de représentation des blocs, pas les dimensions de l'image d'entrée.
Malgré cette différence interne, chacun doit produire dix scores correspondant aux mêmes dix classes, dans le même ordre. Sans cet alignement, comparer les distributions reviendrait à comparer la colonne « pull » de l'un avec la colonne « sac » de l'autre.
Pour un lot de B images, la représentation usuelle est B × 1 × 28 × 28 : images, canal monochrome, hauteur, largeur. Les logits ont la forme B × 10 et les labels la forme B, avec un identifiant de classe par image. Un tenseur est simplement le tableau numérique multidimensionnel qui porte ces valeurs dans PyTorch.
Le code de la perte
Voici l'extrait continu de src/vision_distill/losses.py. Malgré leurs noms, les arguments student et teacher sont ici les tenseurs de logits déjà calculés, pas les objets réseau. F désigne les fonctions de torch.nn.functional.
def distillation_loss(student, teacher, labels, alpha=0.5, temperature=3.0):
    if temperature <= 0 or not 0 <= alpha <= 1:
        raise ValueError("T>0 and 0<=alpha<=1 required")
    ce = F.cross_entropy(student, labels)
    target = F.softmax(teacher.detach() / temperature, dim=-1)
    logp = F.log_softmax(student / temperature, dim=-1)
    kl = (target * (torch.log(target.clamp_min(1e-30)) - logp)).sum(-1).mean()
    return (1 - alpha) * ce + alpha * temperature**2 * kl
Que vient-il de se passer ? La fonction a calculé un coût scalaire à partir des prédictions et des labels. Elle ne charge pas les modèles, ne calcule pas leurs prédictions et ne met pas leurs poids à jour. Les appels à backward() et à l'optimiseur appartiennent à la boucle d'entraînement, en dehors de cet extrait.
Lire le calcul ligne par ligne
Le premier contrôle porte sur les réglages. La température doit être strictement positive et alpha compris entre 0 et 1. Cette vérification explicite ne constitue pas à elle seule une validation complète des formes, appareils et valeurs numériques des tenseurs.
ce calcule l'erreur par rapport au label. Il reçoit directement les logits de l'étudiant, sans division par la température. Ne leur appliquez pas un softmax supplémentaire avant cet appel : la documentation de CrossEntropyLoss précise que l'entrée attendue contient les scores non normalisés.
target construit la réponse adoucie de l'enseignant. dim=-1 désigne la dernière dimension, donc les classes. Le softmax est appliqué séparément à chaque image du lot.
teacher.detach() coupe le chemin de gradient vers les logits de l'enseignant. La perte peut utiliser leurs valeurs, mais elle ne remonte pas par cette branche pour entraîner l'enseignant. C'est le rôle documenté de detach().
Il faut distinguer cette coupure de gradient du mode d'exécution du réseau : detach() ne met pas l'enseignant en mode évaluation. Le tutoriel officiel PyTorch sur la distillation montre séparément teacher.eval(), le calcul sans gradients de l'enseignant et l'optimisation des paramètres de l'étudiant. L'extrait de perte présenté ici ne montre pas cette boucle complète.
logp calcule les logarithmes des probabilités adoucies de l'étudiant. La même température est utilisée des deux côtés. Le calcul emploie log_softmax directement, plutôt que d'enchaîner manuellement softmax puis logarithme.
kl compare les deux distributions. En notant q les probabilités de l'enseignant et p celles de l'étudiant, une image contribue :
KL(q || p) = somme_classes q × (log(q) − log(p)).
La garde clamp_min(1e-30) borne les valeurs données au logarithme de la cible. Elle ne remplace pas toutes les probabilités par ce minimum et ne renormalise pas la distribution : le facteur multiplicatif reste target.
.sum(-1).mean() fixe le dénominateur. Nous additionnons d'abord les contributions des dix classes pour chaque image, puis nous moyennons sur les images du lot. Ce n'est pas une moyenne sur toutes les cases du tableau. La documentation de KLDivLoss distingue ce comportement, correspondant ici à batchmean, de la réduction mean. Avec dix classes, moyenner toutes les cases diviserait encore le terme par dix.
Un petit calcul de KL
Pour vérifier le sens de la formule, prenons des distributions fictives déjà adoucies : q = [0,50 ; 0,25 ; 0,25] pour l'enseignant et p = [0,25 ; 0,25 ; 0,50] pour l'étudiant.
La première classe contribue 0,50 × log(2). La deuxième contribue zéro. La troisième contribue 0,25 × log(0,5), une quantité négative. Leur somme vaut environ 0,1733.
Une contribution individuelle peut donc être négative, même si la divergence totale est non négative en arithmétique exacte. Lorsque les distributions sont identiques, la KL vaut zéro. Cela ne signifie pas que la CE vaut zéro : enseignant et étudiant peuvent être d'accord sans donner toute la probabilité au label attendu.
Alpha et T² ne jouent pas le même rôle
La dernière ligne construit :
perte = (1 − alpha) × CE + alpha × T² × KL.
alpha=0 donne un objectif fondé sur les labels ; alpha=1 donne un objectif fondé sur la distribution de l'enseignant. Dans cet extrait, les deux termes sont néanmoins calculés avant la somme : fixer alpha=0 ne supprime pas automatiquement le calcul de la branche enseignant.
Avec les valeurs par défaut alpha=0.5 et temperature=3.0, la formule devient 0,5 × CE + 4,5 × KL. Les coefficients sont égaux entre CE et T² × KL, pas entre CE et la KL brute. Cela ne garantit pas davantage des gradients de même taille.
Pourquoi T² ? Diviser les logits par la température modifie aussi les gradients du terme de distillation. Ce facteur est la compensation d'échelle conventionnelle utilisée pour garder un signal comparable ; il ne garantit pas une invariance exacte lorsque la température change. L'article fondateur de Hinton, Vinyals et Dean et le tutoriel PyTorch cité plus haut présentent cette approche. L'exercice permettra d'isoler ce qui se passe lorsque nous retirons ce facteur sans changer T.
Installer et préparer les images
Extrayez le ZIP et ouvrez un terminal dans son répertoire racine. Toutes les commandes suivantes partent de ce même dossier. Les commandes initiales respectent l'ordre de README.md et de lesson/tutorial.json.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prépare le projet. config --quiet contrôle la configuration Compose, puis build construit les images des deux services. L'acquisition récupère les archives selon les locks ; le contrôle suivant vérifie CUDA dans le conteneur. Enfin, pytest exécute la suite du projet.
À ce stade, vous cherchez une installation cohérente et des contrôles réussis, pas encore une bonne précision de classification. Corrigez une acquisition ou un accès CUDA en échec avant de poursuivre.
Créez ensuite les partitions, inspectez les réseaux, entraînez l'enseignant et contrôlez la perte avant l'apprentissage des étudiants :
docker compose run --rm gpu python -m vision_distill.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli inspect-models --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli train-teacher --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli check-loss --config configs/minimum.yaml
Après prepare, examinez les traces de splits et de doublons. Après inspect-models, reliez les formes de tenseurs aux 93 962 et 5 130 paramètres annoncés : vous devez pouvoir expliquer ce qui entre dans chaque réseau et ce qui en sort.
train-teacher entraîne le réseau qui fournira ensuite les distributions cibles. check-loss vérifie notamment, sur le cas contrôlé d'un enseignant identique, que celui-ci ne reçoit pas de gradient par la perte. Ce contrôle vérifie le mécanisme ; il ne démontre ni que l'enseignant reconnaît toutes les images ni que l'étudiant bénéficiera de son aide.
Entraîner, reprendre et mesurer
Nous disposons maintenant des données préparées et de l'enseignant. Entraînez les deux étudiants, puis contrôlez une interruption et une reprise avant l'évaluation test :
docker compose run --rm gpu python -m vision_distill.cli train-students --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli interrupt-student --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli resume-student --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli evaluate --config configs/minimum.yaml
L'étudiant sur labels constitue notre baseline, c'est-à-dire la référence simple à laquelle comparer la distillation. Il est essentiel de ne pas le supprimer : comparer uniquement l'enseignant au petit modèle distillé mélangerait deux changements, l'architecture et la méthode d'apprentissage.
L'interruption et la reprise contrôlent un état complet. Un checkpoint est une sauvegarde permettant de retrouver un état de calcul ; reprendre l'apprentissage ne se réduit pas nécessairement à recharger les poids. Il faut aussi retrouver ce qui détermine la suite des mises à jour et du parcours des données. Les détails de l'état sauvegardé sont ceux du projet, et compare-resume est le contrôle à examiner plutôt que de se satisfaire d'une exécution qui redémarre sans erreur.
Enfin, evaluate produit les mesures des trois modèles sur les mêmes 10 000 images du test officiel. Conservez ces résultats avant de passer à l'exercice.
Métriques avant les mesures
La précision globale : combien d'images sont bien classées ?
Dans cet article, précision globale désigne l'accuracy, aussi appelée exactitude :
accuracy = nombre d'images correctement classées / nombre d'images évaluées.
Dans un exemple fictif de 100 images, 80 classes prédites correctement donnent 80 %. Cela ne dit pas encore quelles classes posent problème. Deux modèles ayant la même accuracy peuvent se tromper sur des images différentes.
La macro-F1 : regarder aussi chaque classe
Attention au vocabulaire : la précision d'une classe utilisée dans F1 n'a pas le même dénominateur que l'accuracy globale.
Prenons un exemple fictif. Parmi les images que le modèle annonce comme « pull », 8 sont réellement des pulls et 2 n'en sont pas. Le jeu contient au total 12 vrais pulls : le modèle en a donc manqué 4.
Sa précision pour cette classe vaut 8 / 10 = 0,8 : parmi les prédictions « pull », quelle part est juste ? Son rappel vaut 8 / 12 ≈ 0,6667 : parmi les vrais pulls, quelle part a-t-il retrouvée ?
Le F1 combine les deux avec une moyenne harmonique :
F1 = 2 × précision × rappel / (précision + rappel).
Ici, il vaut 16 / 22 ≈ 0,7273. La macro-F1 calcule ensuite ce F1 séparément pour chacune des dix classes, puis en fait la moyenne sans pondération par leur effectif. Ce n'est pas le F1 calculé à partir d'une précision moyenne et d'un rappel moyen.
La documentation scikit-learn sur F1 détaille ces définitions. Elle sert ici de référence pour la métrique, sans présumer de la bibliothèque utilisée dans le projet. La macro-F1 donne le même poids à chaque classe, mais reste une moyenne : l'analyse des erreurs par classe demeure utile.
Trois coûts à ne pas confondre
Le nombre de paramètres décrit combien de valeurs le réseau contient. La taille des poids décrit l'espace occupé par leur représentation sauvegardée. Les deux sont liés, mais le format et la précision numérique du stockage comptent également. Une taille de fichier n'est pas une mesure complète de la mémoire nécessaire à l'exécution.
Le temps chaud mesure le traitement une fois le modèle prêt, et non son installation ou son chargement initial. Le temps chaud par image de ce parcours n'est ni une latence réseau ni un benchmark sous charge. Il ne suffit donc pas pour promettre un temps de réponse à un utilisateur de votre application.
Les résultats chiffrés reportés ci-dessous ne donnent pas les valeurs de temps chaud. Nous ne pouvons pas en déduire une accélération mesurée, même si le nombre de paramètres diminue fortement.
Résultats réels et apprentissage
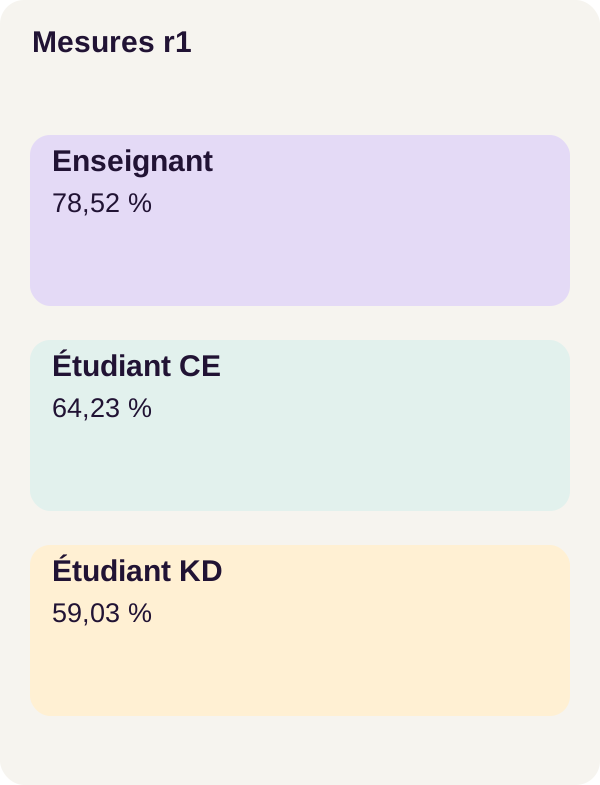
Voici les valeurs de l'exécution r1 sur les 10 000 images de test, avec les décimales reportées pour la macro-F1 :
| Modèle | Précision globale | Macro-F1 |
|---|---|---|
| Enseignant | 78,52 % | 0,7756504071911894 |
| Étudiant sur labels, CE | 64,23 % | 0,6256681401207919 |
| Étudiant distillé | 59,03 % | 0,5716481462359492 |
Les coûts de stockage et d'architecture reportés sont les suivants. Un Mio correspond à 1 048 576 octets.
| Modèle | Paramètres | Taille des poids, en Mio |
|---|---|---|
| Enseignant | 93 962 | 0,3612794876098633 |
| Étudiant sur labels, CE | 5 130 | 0,02199268341064453 |
| Étudiant distillé | 5 130 | 0,02199268341064453 |
Les deux étudiants possèdent environ 18,32 fois moins de paramètres que l'enseignant, soit une réduction d'environ 94,54 %. Le rapport des tailles de poids vaut environ 16,43. Ces rapports sont des calculs à partir des valeurs du tableau, pas des mesures de vitesse.
La comparaison décisive est celle des deux étudiants : 59,03 − 64,23 = −5,20 points de pourcentage. Sur 10 000 images, les taux correspondent respectivement à 5 903 et 6 423 classifications correctes, soit un écart net de 520. Cela ne signifie pas que nous avons identifié exactement 520 images exclusivement dégradées : il faudrait comparer les prédictions image par image pour le savoir.
La macro-F1 baisse également. Avec ces réglages et ces données, la distillation n'améliore donc pas l'étudiant. Le gain de taille existe déjà pour l'étudiant CE ; il serait erroné de l'attribuer à un gain de qualité apporté par la distillation.
Pourquoi ce résultat ? La qualité du signal enseignant, le poids relatif des deux pertes, la température, la capacité de l'étudiant ou la durée d'apprentissage sont des pistes à examiner. Le tableau ne permet pas d'isoler une cause. Il ne démontre pas non plus qu'une autre température ou davantage d'entraînement résoudrait le problème.
Pour approfondir, gardez l'enseignant, le baseline CE et un protocole de données stable. Choisissez les nouveaux réglages avec la validation, puis utilisez le même test pour la comparaison finale des variantes retenues. Ajuster continuellement les paramètres en regardant le test finirait par transformer celui-ci en outil de réglage plutôt qu'en évaluation indépendante.
Exercice : prédire, puis exécuter
Prédire le changement avant de toucher au calcul
Conservez T=3 et retirez mentalement le facteur T². Les images, logits et distributions sont figés : seule la pondération du terme KL change.
Avec alpha=0,5, nous passons de :
0,5 × CE + 4,5 × KL
à :
0,5 × CE + 0,5 × KL.
Le terme KL pondéré est donc divisé par 9. Sur ce même lot, son gradient est lui aussi divisé par 9. Mais le gradient total n'est pas nécessairement divisé par 9 : la contribution CE reste inchangée.
Pour voir pourquoi, prenez un exemple pédagogique à un seul paramètre. La contribution CE déjà pondérée vaut +1, celle de la KL déjà pondérée vaut −0,9. Leur somme vaut +0,1. Après division de la seconde par 9, la somme devient +1 − 0,1 = +0,9. Réduire une contribution a ici augmenté la norme du gradient total, parce que les deux contributions se compensaient auparavant.
Ce contre-exemple ne décrit pas les gradients du modèle r1. Il explique pourquoi il faut distinguer norme du gradient KL et norme du gradient de la perte complète.
Autre piège : la valeur totale de perte peut baisser simplement parce que vous avez diminué un coefficient. Pour des valeurs fictives CE=1,2 et KL=0,1, elle passerait de 1,05 à 0,65, sans aucune amélioration des prédictions. Ces deux nombres correspondent à deux objectifs pondérés différemment.
Exécuter et interpréter
Lancez maintenant l'exercice fourni :
docker compose run --rm gpu python -m vision_distill.cli exercise --config configs/exercise.yaml
Comparez le diagnostic de gradient à votre prédiction. Vérifiez quel terme chaque norme représente et séparez le changement d'échelle de la réaction du gradient total. Ne transformez pas ce diagnostic sur un batch figé en preuve qu'une future précision va monter : il ne remplace pas un entraînement suivi d'evaluate.
Terminez avec les figures, les checkpoints et l'arrêt du projet :
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
plot.py génère les figures. Le contrôle suivant examine les checkpoints. Le nettoyage est une prévisualisation : --dry-run ne supprime rien. L'arrêt Compose ne supprime pas les sorties du projet.
Adaptation, production, dépannage et nettoyage
Passer des petites images à votre application
Pour adapter cette expérience, commencez par le contrat métier : quelles classes souhaitez-vous distinguer, et quelles erreurs seraient inacceptables ? Dans notre exemple de back-office, une suggestion relue par un opérateur n'a pas les mêmes conséquences qu'un classement automatique sans contrôle.
Construisez un jeu de données autorisé et versionné. Documentez les transformations appliquées aux images et conservez des partitions train, validation et test distinctes. Examinez les erreurs par classe et choisissez un seuil de qualité avant de chercher à réduire les poids. Le bon étudiant est celui qui respecte ce contrat, pas simplement celui qui possède le moins de paramètres.
L'enseignant demeure une hypothèse de supervision, pas un arbitre infaillible. Gardez l'étudiant CE et ne changez qu'un facteur à la fois pour comprendre les résultats d'une nouvelle expérience. Les licences et la présence éventuelle de données personnelles doivent aussi être contrôlées avant d'utiliser vos propres images.
Mesurez ensuite le modèle exporté dans l'environnement cible, avec son prétraitement et sa charge représentative. La réduction des paramètres n'entraîne pas automatiquement une réduction proportionnelle de latence sur chaque matériel. Le parcours CUDA présenté ici ne valide pas un déploiement CPU, mobile ou navigateur.
Dépanner sans changer l'expérience en silence
En cas d'échec CUDA, relancez le contrôle du conteneur et suivez le guide NVIDIA Container Toolkit. Corrigez l'accès GPU avant de modifier le modèle ou la perte.
En cas d'échec d'acquisition, restaurez l'accès réseau du service acquire, puis relancez la commande correspondante. Ne remplacez pas les archives ou dépendances verrouillées par une autre version simplement pour contourner l'erreur.
Si les deux étudiants donnent des scores différents, commencez par relire la définition de leurs objectifs, les traces d'entraînement et les erreurs par classe. Un résultat moins bon ne prouve pas à lui seul un défaut de calcul : la distillation est une méthode à évaluer, pas une garantie de progression.
Enfin, docker compose down --remove-orphans arrête les services sans supprimer les sorties. Le script de nettoyage reste en mode dry-run. Conservez les configurations, les mesures et les checkpoints nécessaires avant toute suppression volontaire de vos fichiers d'essai.
À retenir : réduire l'architecture, transmettre une distribution et améliorer les prédictions sont trois choses différentes. Ce tutoriel permet de les mesurer séparément, y compris lorsque la méthode la plus élaborée ne donne pas le meilleur étudiant.
Sources officielles
Les mesures r1 ci-dessus sont celles du parcours du projet. Les références suivantes expliquent les données, les formules et les API ; elles ne constituent pas de nouvelles exécutions de cette expérience.
- PyTorch : cross entropy et documentation versionnée consultée : logits, labels et calcul de la CE.
- PyTorch : KL divergence et documentation versionnée consultée : sens de la divergence et différence entre
meanetbatchmean. - Fashion-MNIST : format des images, partitions officielles et labels.
- Docker Compose : prise en charge GPU : exposition des GPU aux services.
- Hinton, Vinyals et Dean — Distilling the Knowledge in a Neural Network : référence fondatrice de la distillation de distributions.
- PyTorch — Knowledge Distillation Tutorial : apprentissage enseignant-étudiant, température et combinaison des pertes.
- PyTorch — Tensor.detach : coupure du lien avec le graphe de gradients.
- Scikit-learn — F1 score : précision, rappel et moyenne macro.
- NVIDIA Container Toolkit — installation : intégration entre GPU, pilote et conteneurs.