





Immaginate il back office di un negozio: un utente carica un'immagine e volete suggerirgli una categoria prima che salvi la scheda prodotto. Per la vostra applicazione, la domanda sembra semplice: «È un maglione, una scarpa o una borsa?» Per il modello, occorre imparare a riconoscere schemi nei pixel.
Una prima rete può dare risultati interessanti, pur essendo troppo costosa per l'ambiente in cui desiderate eseguirla. Costruite quindi una rete più piccola. Ma come addestrarla: soltanto con le risposte corrette del set di dati, o anche con le previsioni della rete grande?
Questa è la domanda del tutorial. La distillazione consiste qui nell'addestrare un modello piccolo, detto studente, usando le probabilità di un modello insegnante, oltre alle etichette note. Seguiremo questo trasferimento, ne capiremo il calcolo e verificheremo se migliora davvero lo studente.
Il risultato non è scritto in anticipo: uno studente più piccolo non è necessariamente migliore dopo la distillazione. Nell'esperimento presentato, fa persino peggio dello stesso tipo di studente addestrato soltanto sulle etichette. Questo risultato negativo è proprio un'occasione per imparare a confrontare correttamente due metodi.
Scaricare il progetto completo del tutorial
Cosa costruiamo
Costruiamo un esperimento locale in Python e Docker attorno a Fashion-MNIST, un set di immagini di abbigliamento, scarpe e accessori. Il back office descritto sopra offre una motivazione concreta; il progetto non fornisce questa interfaccia e non convalida la classificazione di fotografie reali del vostro catalogo.
Addestriamo e confrontiamo tre modelli:
| Modello | Cosa apprende dai dati | Perché mantenerlo nel confronto |
|---|---|---|
| Insegnante CNN | Associare ogni immagine alla sua etichetta | Misurare la qualità del modello che fornisce le probabilità |
| Studente sulle etichette | Ritrovare l'etichetta con un'architettura più piccola | Stabilire cosa sa fare la rete piccola senza distillazione |
| Studente distillato | Ritrovare l'etichetta e avvicinare le proprie probabilità a quelle dell'insegnante | Testare l'utilità del segnale aggiuntivo dell'insegnante |
I due studenti hanno la stessa architettura e lo stesso numero di parametri, ma il loro obiettivo di apprendimento differisce. Ciò non significa che i pesi appresi saranno identici.
Il programma confronta accuracy, macro-F1, numero di parametri, dimensione dei pesi e tempo a caldo. Le 10 000 immagini del test ufficiale sono conservate. I duplicati identici vengono esclusi dal pool train/validation prima della selezione stratificata; torneremo sul ruolo di questa preparazione.
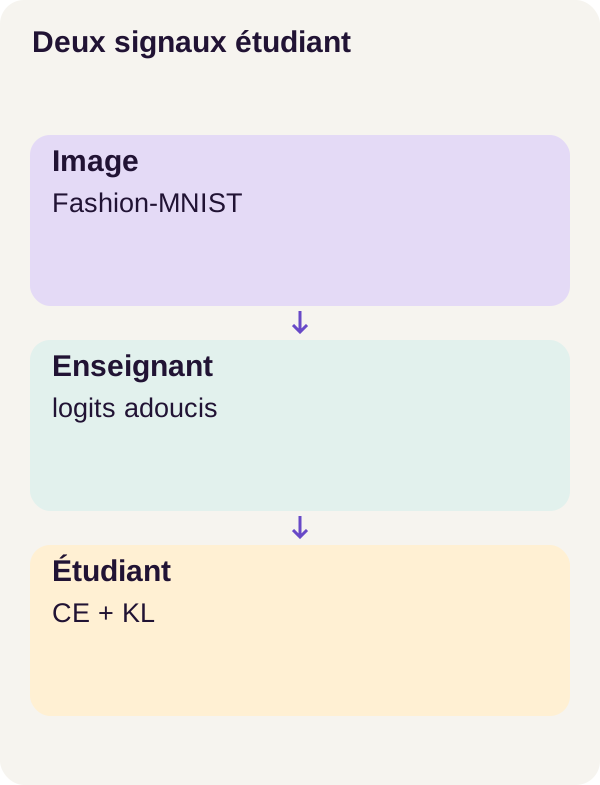
La distillazione non è quindi né una compressione ZIP dei pesi né una copia della rete grande in quella piccola. L'architettura piccola esiste già; cerchiamo un modo per addestrarla meglio. Una volta addestrato, lo studente può produrre le proprie previsioni senza consultare l'insegnante.
I piccoli esempi numerici che seguono servono a capire le formule. Non sono output catturati dal modello. I risultati sperimentali r1 sono raccolti nella sezione «Risultati reali e apprendimento».
Concetti spiegati
Da un'immagine a dieci punteggi
Un'immagine Fashion-MNIST misura 28 × 28 pixel, in scala di grigi. Possiamo rappresentarla come una tabella di 784 intensità. Questi 784 valori sono i dati di input, non i parametri del modello.
Una CNN, per convolutional neural network, è una rete neurale convoluzionale. Applica piccoli filtri a zone diverse dell'immagine. Ogni filtro combina i pixel vicini, quindi produce una mappa di attivazione: una nuova tabella che indica dove reagisce. Gli strati successivi combinano queste mappe per costruire altre rappresentazioni.
Possiamo accostare il principio a quello di un filtro di elaborazione delle immagini, con una differenza essenziale: i valori dei filtri vengono appresi, anziché scelti a mano. I parametri sono questi numeri regolabili, insieme agli altri pesi e bias della rete. Una convoluzione riutilizza i suoi filtri in più posizioni; non assegna necessariamente un parametro distinto a ogni pixel.
Alla fine, la rete produce dieci logit, uno per classe. Un logit è un punteggio grezzo: può essere negativo e i dieci punteggi non devono necessariamente sommare a 1.
Il softmax trasforma questo elenco in una distribuzione di probabilità: ogni valore è positivo e la loro somma è 1. La classe con il punteggio più alto dà la previsione di classificazione. Una tale distribuzione descrive la preferenza del modello; non dimostra che la sua confidenza corrisponda alla reale frequenza di successo.
Il repository ufficiale Fashion-MNIST descrive le immagini e le dieci classi, tra cui maglione, camicia e borsa.
Perché trasmettere altro oltre alla risposta corretta?
Un'etichetta è la classe attesa di un'immagine. Indica per esempio «maglione». È un'informazione indispensabile, ma non descrive le eventuali somiglianze con le altre classi.
L'insegnante fornisce una distribuzione più dettagliata. Può assegnare un'alta probabilità al maglione, una probabilità secondaria alla camicia e una bassa alla borsa. L'ipotesi della distillazione è che questa ripartizione apporti un segnale utile alla rete piccola: alcune confusioni sono più plausibili di altre.
Ma anche l'insegnante può sbagliarsi. Le sue probabilità non diventano una verità soltanto perché la sua rete è più grande. Conserviamo quindi le etichette, poi misuriamo il risultato su immagini di test.
La temperatura: rendere più visibili le classi secondarie
La temperatura T interviene prima del softmax: dividiamo i logit per T. Per una classe i, la formula è:
p_i(T) = exp(z_i / T) / somma_j exp(z_j / T).
z_i indica il logit della classe; exp è l'esponenziale. Il denominatore riporta la somma delle probabilità a 1.
Prendiamo un esempio fittizio a tre classi, e non i dieci output reali del progetto. I logit sono [3, 1, 0], associati in quest'ordine a maglione, camicia e borsa.
| Classe fittizia | Logit iniziale | Probabilità con T=1 | Probabilità con T=3 |
|---|---|---|---|
| Maglione | 3 | 84,38 % | 53,15 % |
| Camicia | 1 | 11,42 % | 27,29 % |
| Borsa | 0 | 4,20 % | 19,55 % |
Le percentuali sono arrotondate. A T=3, le probabilità sono meno concentrate sulla prima scelta: la distribuzione è ammorbidita. La classe maglione resta prima. A logit fissi, dividere per una temperatura positiva non ne cambia l'ordine; cambia la ripartizione usata per apprendere.
Aumentare la temperatura non rende quindi meccanicamente una previsione più corretta. Modifica il segnale trasmesso allo studente.
Due istruzioni di apprendimento, due termini di perdita
La perdita, o loss, è un numero che l'addestramento cerca di ridurre. In questo progetto combina due domande.
L'entropia incrociata, o CE, chiede: «Quale probabilità assegna lo studente alla classe vera?» Con un'unica etichetta, vale, per un'immagine, il negativo del logaritmo di questa probabilità. Una probabilità di 0,8 dà circa 0,2231 di perdita; una probabilità di 0,2 dà circa 1,6094. Assegnare meno probabilità alla risposta corretta costa quindi di più.
La divergenza KL chiede: «Quanto la distribuzione dello studente si discosta da quella dell'insegnante?» Tiene conto di tutte le classi, non soltanto della prima scelta. Qui il verso è KL(insegnante || studente): l'insegnante fornisce la distribuzione target. Questa divergenza non è generalmente simmetrica.
L'addestramento combina questi due termini. La retropropagazione, detta backward, calcola poi i loro gradienti: come una piccola variazione dei parametri farebbe variare la perdita. L'ottimizzatore usa questi gradienti per aggiornare i pesi. Al contrario, l'inferenza usa una rete già addestrata per prevedere, senza apprendere sull'immagine sottoposta.
Prerequisiti Docker e GPU
Per seguire il codice, dovete saper leggere funzioni Python, manipolare tabelle e usare un terminale. I comandi presuppongono le basi di Docker: un'immagine descrive l'ambiente software, un container esegue questo ambiente e Compose organizza i servizi.
Il percorso r1 richiede Linux x86_64, Docker Compose, NVIDIA Container Toolkit e una RTX 3090 da 24 GiB. Il README consiglia 16 GiB di RAM e 16 GiB di disco, esclusi gli strati Docker. Sono le risorse indicate per questo percorso; non è convalidato alcun profilo CPU.
La RAM appartiene alla macchina host; la memoria video appartiene alla GPU. NVIDIA Container Toolkit permette di esporre le risorse GPU a Docker. Una scheda riconosciuta da Linux non basta: check_environment.py deve verificare anche CUDA nel container.
Il servizio acquire scarica gli archivi pubblici. Il servizio gpu esegue i calcoli locali. locks/models.lock.json blocca gli archivi e locks/environment.lock.json l'ambiente. Questi file svolgono un ruolo simile a un file di blocco delle dipendenze: fissano le risorse previste affinché l'esperimento non cambi silenziosamente.
I riferimenti alla documentazione alla fine dell'articolo spiegano i meccanismi. Le versioni da usare per riprodurre r1 restano quelle del progetto, non quelle di un altro tutorial o di un'installazione aggiornata casualmente.
Dati e funzione centrale
Separare le immagini di apprendimento da quelle di valutazione
Il set ufficiale Fashion-MNIST fornisce 60 000 immagini di addestramento e 10 000 immagini di test. Il primo insieme costituisce il pool iniziale in cui preparare addestramento e validazione; non va confuso con la dimensione infine selezionata dalla configurazione di questo tutorial.
Il train serve ad aggiornare i pesi. La validation serve a osservare le scelte di addestramento. Il test serve a confrontare i modelli una volta fissate queste scelte. Qui sono conservate le 10 000 immagini del test ufficiale.
Prima della selezione train/validation, il progetto esclude dal pool interessato i duplicati identici. La selezione è poi stratificata: tiene conto delle classi per controllarne la rappresentazione. Le due operazioni rispondono a problemi distinti. Bilanciare le classi non basta a evitare che un'immagine sia presente più volte.
Le dimensioni finali di train/validation e il numero di duplicati rimossi non sono quantificati nei risultati riprodotti in questo articolo. Rilevateli nelle tracce di prepare: non deduceteli dalla sola dimensione ufficiale di Fashion-MNIST.
Una rete grande e una piccola, ma lo stesso output
L'insegnante possiede 93 962 parametri. Include tre blocchi convoluzionali di larghezze 32, 64, 128. Lo studente possiede 5 130 parametri, con due blocchi di larghezze 16, 32. Queste larghezze indicano il numero di canali di rappresentazione dei blocchi, non le dimensioni dell'immagine di input.
Nonostante questa differenza interna, ciascuno deve produrre dieci punteggi corrispondenti alle stesse dieci classi, nello stesso ordine. Senza questo allineamento, confrontare le distribuzioni equivarrebbe a confrontare la colonna «maglione» di uno con la colonna «borsa» dell'altro.
Per un batch di B immagini, la rappresentazione usuale è B × 1 × 28 × 28: immagini, canale monocromatico, altezza, larghezza. I logit hanno forma B × 10 e le etichette forma B, con un identificatore di classe per immagine. Un tensore è semplicemente la tabella numerica multidimensionale che porta questi valori in PyTorch.
Il codice della perdita
Ecco l'estratto continuo di src/vision_distill/losses.py. Nonostante i loro nomi, gli argomenti student e teacher sono qui i tensori di logit già calcolati, non gli oggetti rete. F indica le funzioni di torch.nn.functional.
def distillation_loss(student, teacher, labels, alpha=0.5, temperature=3.0):
    if temperature <= 0 or not 0 <= alpha <= 1:
        raise ValueError("T>0 and 0<=alpha<=1 required")
    ce = F.cross_entropy(student, labels)
    target = F.softmax(teacher.detach() / temperature, dim=-1)
    logp = F.log_softmax(student / temperature, dim=-1)
    kl = (target * (torch.log(target.clamp_min(1e-30)) - logp)).sum(-1).mean()
    return (1 - alpha) * ce + alpha * temperature**2 * kl
Cosa è appena successo? La funzione ha calcolato un costo scalare a partire dalle previsioni e dalle etichette. Non carica i modelli, non calcola le loro previsioni e non aggiorna i pesi. Le chiamate a backward() e all'ottimizzatore appartengono al ciclo di addestramento, fuori da questo estratto.
Leggere il calcolo riga per riga
Il primo controllo riguarda le impostazioni. La temperatura deve essere strettamente positiva e alpha compreso tra 0 e 1. Questa verifica esplicita non costituisce da sola una convalida completa delle forme, dei dispositivi e dei valori numerici dei tensori.
ce calcola l'errore rispetto all'etichetta. Riceve direttamente i logit dello studente, senza divisione per la temperatura. Non applicate loro un softmax aggiuntivo prima di questa chiamata: la documentazione di CrossEntropyLoss precisa che l'input atteso contiene punteggi non normalizzati.
target costruisce la risposta ammorbidita dell'insegnante. dim=-1 indica l'ultima dimensione, dunque le classi. Il softmax viene applicato separatamente a ogni immagine del batch.
teacher.detach() interrompe il percorso del gradiente verso i logit dell'insegnante. La perdita può usare i loro valori, ma non risale da questo ramo per addestrare l'insegnante. È il ruolo documentato di detach().
Occorre distinguere questa interruzione del gradiente dalla modalità di esecuzione della rete: detach() non mette l'insegnante in modalità valutazione. Il tutorial ufficiale PyTorch sulla distillazione mostra separatamente teacher.eval(), il calcolo senza gradienti dell'insegnante e l'ottimizzazione dei parametri dello studente. L'estratto di perdita qui presentato non mostra questo ciclo completo.
logp calcola i logaritmi delle probabilità ammorbidite dello studente. La stessa temperatura è usata da entrambi i lati. Il calcolo usa direttamente log_softmax, invece di concatenare manualmente softmax e logaritmo.
kl confronta le due distribuzioni. Indicando con q le probabilità dell'insegnante e con p quelle dello studente, un'immagine contribuisce:
KL(q || p) = somma_classi q × (log(q) − log(p)).
La protezione clamp_min(1e-30) limita i valori dati al logaritmo del target. Non sostituisce tutte le probabilità con questo minimo e non rinormalizza la distribuzione: il fattore moltiplicativo resta target.
.sum(-1).mean() fissa il denominatore. Sommiamo prima i contributi delle dieci classi per ciascuna immagine, poi facciamo la media sulle immagini del batch. Non è una media su tutte le celle della tabella. La documentazione di KLDivLoss distingue questo comportamento, che qui corrisponde a batchmean, dalla riduzione mean. Con dieci classi, fare la media di tutte le celle dividerebbe ancora il termine per dieci.
Un piccolo calcolo di KL
Per verificare il verso della formula, prendiamo distribuzioni fittizie già ammorbidite: q = [0,50 ; 0,25 ; 0,25] per l'insegnante e p = [0,25 ; 0,25 ; 0,50] per lo studente.
La prima classe contribuisce 0,50 × log(2). La seconda contribuisce zero. La terza contribuisce 0,25 × log(0,5), una quantità negativa. La loro somma vale circa 0,1733.
Un contributo individuale può quindi essere negativo, anche se la divergenza totale è non negativa nell'aritmetica esatta. Quando le distribuzioni sono identiche, la KL vale zero. Ciò non significa che la CE valga zero: insegnante e studente possono concordare senza assegnare tutta la probabilità all'etichetta attesa.
Alpha e T² non hanno lo stesso ruolo
L'ultima riga costruisce:
perdita = (1 − alpha) × CE + alpha × T² × KL.
alpha=0 dà un obiettivo fondato sulle etichette; alpha=1 dà un obiettivo fondato sulla distribuzione dell'insegnante. In questo estratto, i due termini vengono comunque calcolati prima della somma: impostare alpha=0 non elimina automaticamente il calcolo del ramo insegnante.
Con i valori predefiniti alpha=0.5 e temperature=3.0, la formula diventa 0,5 × CE + 4,5 × KL. I coefficienti sono uguali tra CE e T² × KL, non tra CE e la KL grezza. Ciò non garantisce neppure gradienti della stessa dimensione.
Perché T²? Dividere i logit per la temperatura modifica anche i gradienti del termine di distillazione. Questo fattore è la compensazione di scala convenzionale usata per mantenere un segnale comparabile; non garantisce un'invarianza esatta quando la temperatura cambia. L'articolo fondatore di Hinton, Vinyals e Dean e il tutorial PyTorch citato sopra presentano questo approccio. L'esercizio permetterà di isolare cosa accade quando rimuoviamo questo fattore senza cambiare T.
Installare e preparare le immagini
Estraete lo ZIP e aprite un terminale nella sua directory radice. Tutti i comandi seguenti partono dalla stessa cartella. I comandi iniziali rispettano l'ordine di README.md e di lesson/tutorial.json.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prepara il progetto. config --quiet controlla la configurazione Compose, poi build costruisce le immagini dei due servizi. L'acquisizione recupera gli archivi secondo i lock; il controllo successivo verifica CUDA nel container. Infine, pytest esegue la suite del progetto.
A questo punto cercate un'installazione coerente e controlli riusciti, non ancora una buona accuracy di classificazione. Correggete un'acquisizione o un accesso CUDA non riuscito prima di proseguire.
Create poi le partizioni, ispezionate le reti, addestrate l'insegnante e controllate la perdita prima dell'apprendimento degli studenti:
docker compose run --rm gpu python -m vision_distill.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli inspect-models --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli train-teacher --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli check-loss --config configs/minimum.yaml
Dopo prepare, esaminate le tracce delle divisioni e dei duplicati. Dopo inspect-models, collegate le forme dei tensori ai 93 962 e 5 130 parametri annunciati: dovete poter spiegare cosa entra in ogni rete e cosa ne esce.
train-teacher addestra la rete che fornirà poi le distribuzioni target. check-loss verifica in particolare, nel caso controllato di un insegnante identico, che questo non riceva gradiente dalla perdita. Questo controllo verifica il meccanismo; non dimostra né che l'insegnante riconosca tutte le immagini né che lo studente tragga beneficio dal suo aiuto.
Addestrare, riprendere e misurare
Disponiamo ora dei dati preparati e dell'insegnante. Addestrate i due studenti, poi controllate un'interruzione e una ripresa prima della valutazione di test:
docker compose run --rm gpu python -m vision_distill.cli train-students --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli interrupt-student --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli resume-student --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli evaluate --config configs/minimum.yaml
Lo studente sulle etichette costituisce la nostra baseline, ossia il riferimento semplice con cui confrontare la distillazione. È essenziale non eliminarlo: confrontare soltanto l'insegnante con il piccolo modello distillato mescolerebbe due cambiamenti, l'architettura e il metodo di apprendimento.
L'interruzione e la ripresa controllano uno stato completo. Un checkpoint è un salvataggio che permette di ritrovare uno stato di calcolo; riprendere l'apprendimento non si riduce necessariamente a ricaricare i pesi. Occorre ritrovare anche ciò che determina il seguito degli aggiornamenti e del percorso dei dati. I dettagli dello stato salvato sono quelli del progetto e compare-resume è il controllo da esaminare, anziché accontentarsi di un'esecuzione che riparte senza errore.
Infine, evaluate produce le misure dei tre modelli sulle stesse 10 000 immagini del test ufficiale. Conservate questi risultati prima di passare all'esercizio.
Metriche prima delle misurazioni
L'accuracy globale: quante immagini sono classificate bene?
In questo articolo, accuracy globale indica l'accuracy, detta anche esattezza:
accuracy = numero di immagini classificate correttamente / numero di immagini valutate.
In un esempio fittizio di 100 immagini, 80 classi previste correttamente danno l'80%. Questo non dice ancora quali classi pongono problemi. Due modelli con la stessa accuracy possono sbagliare su immagini diverse.
La macro-F1: osservare anche ogni classe
Attenzione al vocabolario: la precisione di una classe usata in F1 non ha lo stesso denominatore dell'accuracy globale.
Prendiamo un esempio fittizio. Tra le immagini che il modello annuncia come «maglione», 8 sono davvero maglioni e 2 non lo sono. Il set contiene in tutto 12 veri maglioni: il modello ne ha quindi mancati 4.
La sua precisione per questa classe vale 8 / 10 = 0,8: tra le previsioni «maglione», quale parte è corretta? Il suo recall vale 8 / 12 ≈ 0,6667: tra i veri maglioni, quale parte ha ritrovato?
L'F1 combina entrambe con una media armonica:
F1 = 2 × precisione × recall / (precisione + recall).
Qui vale 16 / 22 ≈ 0,7273. La macro-F1 calcola poi questo F1 separatamente per ciascuna delle dieci classi, quindi ne fa la media senza ponderazione per la loro numerosità. Non è l'F1 calcolato da una precisione media e da un recall medio.
La documentazione scikit-learn su F1 dettaglia queste definizioni. Serve qui come riferimento per la metrica, senza presumere la libreria usata nel progetto. La macro-F1 dà lo stesso peso a ogni classe, ma resta una media: l'analisi degli errori per classe rimane utile.
Tre costi da non confondere
Il numero di parametri descrive quanti valori contiene la rete. La dimensione dei pesi descrive lo spazio occupato dalla loro rappresentazione salvata. I due aspetti sono legati, ma contano anche formato e precisione numerica di archiviazione. Una dimensione di file non è una misura completa della memoria necessaria all'esecuzione.
Il tempo a caldo misura l'elaborazione quando il modello è pronto, non la sua installazione o il suo caricamento iniziale. Il tempo a caldo per immagine di questo percorso non è né una latenza di rete né un benchmark sotto carico. Non basta quindi per promettere un tempo di risposta a un utente della vostra applicazione.
I risultati numerici riportati sotto non forniscono i valori del tempo a caldo. Non possiamo dedurne un'accelerazione misurata, anche se il numero di parametri diminuisce molto.
Risultati reali e apprendimento
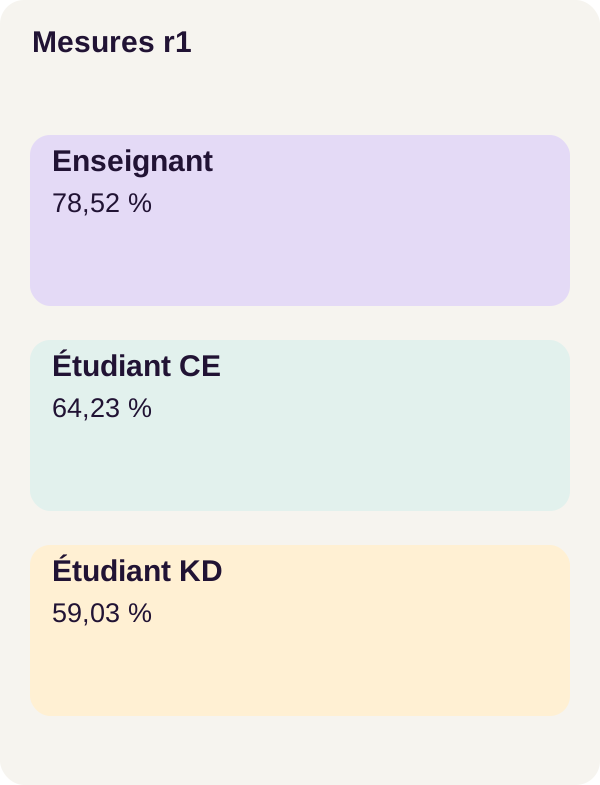
Ecco i valori dell'esecuzione r1 sulle 10 000 immagini di test, con i decimali riportati per la macro-F1:
| Modello | Accuracy globale | Macro-F1 |
|---|---|---|
| Insegnante | 78,52 % | 0,7756504071911894 |
| Studente sulle etichette, CE | 64,23 % | 0,6256681401207919 |
| Studente distillato | 59,03 % | 0,5716481462359492 |
I costi di archiviazione e di architettura riportati sono i seguenti. Un MiB corrisponde a 1 048 576 byte.
| Modello | Parametri | Dimensione dei pesi, in MiB |
|---|---|---|
| Insegnante | 93 962 | 0,3612794876098633 |
| Studente sulle etichette, CE | 5 130 | 0,02199268341064453 |
| Studente distillato | 5 130 | 0,02199268341064453 |
I due studenti hanno circa 18,32 volte meno parametri dell'insegnante, ossia una riduzione di circa 94,54%. Il rapporto delle dimensioni dei pesi vale circa 16,43. Questi rapporti sono calcoli dai valori della tabella, non misure di velocità.
Il confronto decisivo è quello dei due studenti: 59,03 − 64,23 = −5,20 punti percentuali. Su 10 000 immagini, i tassi corrispondono rispettivamente a 5 903 e 6 423 classificazioni corrette, ossia uno scarto netto di 520. Ciò non significa che abbiamo identificato esattamente 520 immagini degradate in modo esclusivo: per saperlo bisognerebbe confrontare le previsioni immagine per immagine.
Anche la macro-F1 diminuisce. Con queste impostazioni e questi dati, la distillazione non migliora quindi lo studente. Il guadagno di dimensione esiste già per lo studente CE; sarebbe errato attribuirlo a un guadagno di qualità apportato dalla distillazione.
Perché questo risultato? La qualità del segnale dell'insegnante, il peso relativo delle due perdite, la temperatura, la capacità dello studente o la durata dell'apprendimento sono piste da esaminare. La tabella non permette di isolare una causa. Non dimostra nemmeno che un'altra temperatura o più addestramento risolverebbero il problema.
Per approfondire, mantenete l'insegnante, la baseline CE e un protocollo di dati stabile. Scegliete le nuove impostazioni con la validazione, quindi usate lo stesso test per il confronto finale delle varianti selezionate. Regolare continuamente i parametri guardando il test finirebbe per trasformarlo in uno strumento di regolazione anziché in una valutazione indipendente.
Esercizio: prevedere, poi eseguire
Prevedere il cambiamento prima di intervenire sul calcolo
Mantenete T=3 e rimuovete mentalmente il fattore T². Immagini, logit e distribuzioni sono fissi: cambia soltanto la ponderazione del termine KL.
Con alpha=0,5, passiamo da:
0,5 × CE + 4,5 × KL
a:
0,5 × CE + 0,5 × KL.
Il termine KL ponderato viene quindi diviso per 9. Su questo stesso batch, anche il suo gradiente viene diviso per 9. Ma il gradiente totale non è necessariamente diviso per 9: il contributo CE resta invariato.
Per capire perché, prendete un esempio didattico con un solo parametro. Il contributo CE già ponderato vale +1, quello della KL già ponderato vale −0,9. La loro somma vale +0,1. Dopo aver diviso il secondo per 9, la somma diventa +1 − 0,1 = +0,9. Ridurre un contributo ha qui aumentato la norma del gradiente totale, perché i due contributi prima si compensavano.
Questo controesempio non descrive i gradienti del modello r1. Spiega perché bisogna distinguere norma del gradiente KL e norma del gradiente della perdita completa.
Un'altra trappola: il valore totale della perdita può calare semplicemente perché avete ridotto un coefficiente. Per valori fittizi CE=1,2 e KL=0,1, passerebbe da 1,05 a 0,65, senza alcun miglioramento delle previsioni. Questi due numeri corrispondono a due obiettivi ponderati diversamente.
Eseguire e interpretare
Lanciate ora l'esercizio fornito:
docker compose run --rm gpu python -m vision_distill.cli exercise --config configs/exercise.yaml
Confrontate la diagnosi del gradiente con la vostra previsione. Verificate quale termine rappresenti ogni norma e separate il cambiamento di scala dalla reazione del gradiente totale. Non trasformate questa diagnosi su un batch fisso in una prova che una futura accuracy aumenterà: non sostituisce un addestramento seguito da evaluate.
Concludete con le figure, i checkpoint e l'arresto del progetto:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
plot.py genera le figure. Il controllo seguente esamina i checkpoint. La pulizia è un'anteprima: --dry-run non elimina nulla. L'arresto di Compose non elimina gli output del progetto.
Adattamento, produzione, risoluzione dei problemi e pulizia
Passare dalle piccole immagini alla vostra applicazione
Per adattare questo esperimento, iniziate dal contratto aziendale: quali classi volete distinguere e quali errori sarebbero inaccettabili? Nel nostro esempio di back office, un suggerimento riletto da un operatore non ha le stesse conseguenze di una classificazione automatica senza controllo.
Costruite un set di dati autorizzato e versionato. Documentate le trasformazioni applicate alle immagini e mantenete partizioni train, validation e test distinte. Esaminate gli errori per classe e scegliete una soglia di qualità prima di cercare di ridurre i pesi. Il buon studente è quello che rispetta questo contratto, non semplicemente quello con meno parametri.
L'insegnante rimane un'ipotesi di supervisione, non un arbitro infallibile. Mantenete lo studente CE e cambiate un solo fattore alla volta per comprendere i risultati di un nuovo esperimento. Anche le licenze e l'eventuale presenza di dati personali vanno controllate prima di usare le vostre immagini.
Misurate poi il modello esportato nell'ambiente di destinazione, con il suo pretrattamento e un carico rappresentativo. La riduzione dei parametri non comporta automaticamente una riduzione proporzionale della latenza su ogni hardware. Il percorso CUDA presentato qui non convalida un deployment CPU, mobile o browser.
Risolvere i problemi senza cambiare l'esperimento in silenzio
In caso di errore CUDA, rilanciate il controllo del container e seguite la guida NVIDIA Container Toolkit. Correggete l'accesso GPU prima di modificare il modello o la perdita.
In caso di errore di acquisizione, ripristinate l'accesso di rete del servizio acquire, poi rilanciate il comando corrispondente. Non sostituite archivi o dipendenze bloccate con un'altra versione soltanto per aggirare l'errore.
Se i due studenti danno punteggi diversi, iniziate rileggendo la definizione dei loro obiettivi, le tracce di addestramento e gli errori per classe. Un risultato peggiore non dimostra da solo un difetto di calcolo: la distillazione è un metodo da valutare, non una garanzia di progresso.
Infine, docker compose down --remove-orphans arresta i servizi senza eliminare gli output. Lo script di pulizia resta in modalità dry-run. Conservate configurazioni, misure e checkpoint necessari prima di qualsiasi eliminazione volontaria dei vostri file di prova.
Da ricordare: ridurre l'architettura, trasmettere una distribuzione e migliorare le previsioni sono tre cose diverse. Questo tutorial permette di misurarle separatamente, anche quando il metodo più elaborato non dà lo studente migliore.
Fonti ufficiali
Le misure r1 qui sopra sono quelle del percorso del progetto. I riferimenti seguenti spiegano dati, formule e API; non costituiscono nuove esecuzioni di questo esperimento.
- PyTorch: cross entropy e documentazione versionata consultata: logit, etichette e calcolo della CE.
- PyTorch: divergenza KL e documentazione versionata consultata: verso della divergenza e differenza tra
meanebatchmean. - Fashion-MNIST: formato delle immagini, partizioni ufficiali ed etichette.
- Docker Compose: supporto GPU: esposizione delle GPU ai servizi.
- Hinton, Vinyals e Dean — Distilling the Knowledge in a Neural Network: riferimento fondatore della distillazione delle distribuzioni.
- PyTorch — Knowledge Distillation Tutorial: apprendimento insegnante-studente, temperatura e combinazione delle perdite.
- PyTorch — Tensor.detach: interruzione del collegamento al grafo dei gradienti.
- Scikit-learn — F1 score: precisione, recall e media macro.
- NVIDIA Container Toolkit — installazione: integrazione fra GPU, driver e container.