





Imagine el back office de una tienda: un usuario sube una imagen y desea sugerirle una categoría antes de que guarde su ficha de producto. Para su aplicación, la pregunta parece sencilla: «¿Es un jersey, un zapato o un bolso?». Para el modelo, debe aprender a reconocer patrones en los píxeles.
Una primera red puede ofrecer resultados interesantes, aunque resultar demasiado costosa para el entorno donde desea ejecutarla. Por eso construye una red más pequeña. Pero ¿cómo entrenarla: solo con las respuestas correctas del conjunto de datos, o también con las predicciones de la red grande?
Esta es la pregunta de este tutorial. La destilación consiste aquí en entrenar un modelo pequeño, llamado estudiante, usando las probabilidades de un modelo profesor, además de las etiquetas conocidas. Seguiremos esta transferencia, entenderemos su cálculo y comprobaremos si realmente mejora al estudiante.
El resultado no está escrito de antemano: un estudiante más pequeño no es necesariamente mejor después de la destilación. En el experimento presentado, incluso obtiene peores resultados que el mismo tipo de estudiante entrenado solo con las etiquetas. Este resultado negativo es precisamente una oportunidad para aprender a comparar correctamente dos métodos.
Descargar el proyecto completo del tutorial
Lo que construimos
Construimos un experimento local en Python y Docker con Fashion-MNIST, un conjunto de imágenes de ropa, zapatos y accesorios. El back office descrito antes aporta una motivación concreta; el proyecto no proporciona esta interfaz ni valida la clasificación de fotografías reales de su catálogo.
Entrenamos y comparamos tres modelos:
| Modelo | Lo que aprende de los datos | Por qué mantenerlo en la comparación |
|---|---|---|
| CNN profesor | Asociar cada imagen con su etiqueta | Medir la calidad del modelo que proporciona las probabilidades |
| Estudiante con etiquetas | Encontrar la etiqueta con una arquitectura más pequeña | Establecer qué puede hacer la red pequeña sin destilación |
| Estudiante destilado | Encontrar la etiqueta y acercar sus probabilidades a las del profesor | Probar el interés de la señal adicional del profesor |
Los dos estudiantes tienen la misma arquitectura y el mismo número de parámetros, pero su objetivo de aprendizaje difiere. Esto no significa que sus pesos aprendidos sean idénticos.
El programa compara exactitud, macro-F1, número de parámetros, tamaño de los pesos y tiempo en caliente. Se conservan las 10 000 imágenes de la prueba oficial. Los duplicados idénticos se excluyen del conjunto train/validation antes de la selección estratificada; volveremos al papel de esta preparación.
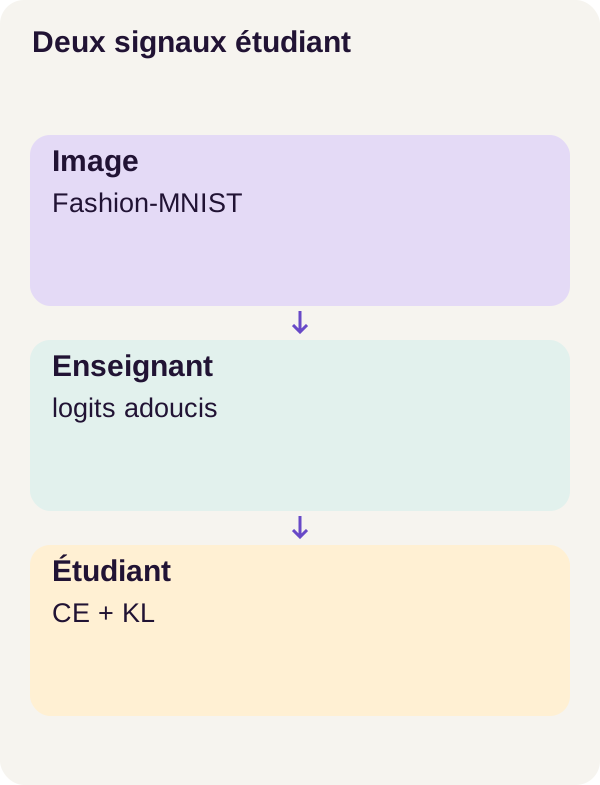
Por tanto, la destilación no es ni una compresión ZIP de los pesos ni una copia de la red grande en la pequeña. La arquitectura pequeña ya existe; buscamos una forma de entrenarla mejor. Una vez entrenado, el estudiante puede hacer sus propias predicciones sin consultar al profesor.
Los pequeños ejemplos numéricos que siguen sirven para entender las fórmulas. No son salidas capturadas del modelo. Los resultados experimentales r1 se agrupan en la sección «Resultados reales y aprendizaje».
Conceptos explicados
De una imagen a diez puntuaciones
Una imagen Fashion-MNIST mide 28 × 28 píxeles, en escala de grises. Puede representarse como una tabla de 784 intensidades. Estos 784 valores son los datos de entrada, no los parámetros del modelo.
Una CNN, por convolutional neural network, es una red neuronal convolucional. Aplica pequeños filtros a distintas zonas de la imagen. Cada filtro combina los píxeles vecinos y produce un mapa de activación: una nueva tabla que indica dónde reacciona. Las capas siguientes combinan estos mapas para construir otras representaciones.
El principio se parece al de un filtro de procesamiento de imágenes, con una diferencia esencial: los valores de los filtros se aprenden, en vez de elegirse a mano. Los parámetros son estos números ajustables, además de los otros pesos y sesgos de la red. Una convolución reutiliza sus filtros en varias posiciones; no asigna necesariamente un parámetro distinto a cada píxel.
Al final, la red produce diez logits, uno por clase. Un logit es una puntuación bruta: puede ser negativa y las diez puntuaciones no tienen por qué sumar 1.
El softmax transforma esta lista en una distribución de probabilidades: cada valor es positivo y su suma vale 1. La clase con la puntuación más alta da la predicción de clasificación. Esta distribución describe la preferencia del modelo; no prueba que su confianza corresponda a su frecuencia real de acierto.
El repositorio oficial de Fashion-MNIST describe las imágenes y las diez clases, entre las que figuran jersey, camisa y bolso.
¿Por qué transmitir algo más que la respuesta correcta?
Una etiqueta es la clase esperada de una imagen. Indica, por ejemplo, «jersey». Es información indispensable, pero no describe las posibles similitudes con las demás clases.
El profesor proporciona una distribución más detallada. Puede asignar una alta probabilidad al jersey, una probabilidad secundaria a la camisa y una baja probabilidad al bolso. La hipótesis de la destilación es que este reparto aporta una señal útil a la red pequeña: algunas confusiones son más plausibles que otras.
Pero el profesor también puede equivocarse. Sus probabilidades no se convierten en verdad simplemente porque su red sea más grande. Por eso conservamos las etiquetas y medimos el resultado en imágenes de prueba.
La temperatura: hacer más visibles las clases secundarias
La temperatura T interviene antes del softmax: dividimos los logits por T. Para una clase i, la fórmula es:
p_i(T) = exp(z_i / T) / suma_j exp(z_j / T).
z_i designa el logit de la clase; exp es la exponencial. El denominador hace que la suma de las probabilidades vuelva a ser 1.
Tomemos un ejemplo ficticio de tres clases, no las diez salidas reales del proyecto. Los logits son [3, 1, 0], asociados en ese orden a jersey, camisa y bolso.
| Clase ficticia | Logit inicial | Probabilidad con T=1 | Probabilidad con T=3 |
|---|---|---|---|
| Jersey | 3 | 84,38 % | 53,15 % |
| Camisa | 1 | 11,42 % | 27,29 % |
| Bolso | 0 | 4,20 % | 19,55 % |
Los porcentajes están redondeados. Con T=3, las probabilidades están menos concentradas en la primera opción: la distribución queda suavizada. La clase jersey sigue siendo la primera. Con logits fijos, dividir por una temperatura positiva no cambia su orden; cambia el reparto usado para aprender.
Por tanto, aumentar la temperatura no hace mecánicamente más correcta una predicción. Modifica la señal transmitida al estudiante.
Dos instrucciones de aprendizaje, dos términos de pérdida
La pérdida, o loss, es un número que el entrenamiento intenta reducir. En este proyecto combina dos preguntas.
La entropía cruzada, o CE, pregunta: «¿Qué probabilidad da el estudiante a la clase verdadera?». Con una única etiqueta, vale para una imagen el negativo del logaritmo de esta probabilidad. Una probabilidad de 0,8 da aproximadamente 0,2231 de pérdida; una de 0,2 da aproximadamente 1,6094. Por tanto, dar menos probabilidad a la respuesta correcta cuesta más.
La divergencia KL pregunta: «¿Hasta qué punto se aleja la distribución del estudiante de la del profesor?». Tiene en cuenta todas las clases, no solo la primera opción. Aquí el sentido es KL(profesor || estudiante): el profesor proporciona la distribución objetivo. Esta divergencia no suele ser simétrica.
El entrenamiento combina estos dos términos. La retropropagación, llamada backward, calcula después sus gradientes: cómo variaría la pérdida con una pequeña variación de los parámetros. El optimizador usa estos gradientes para actualizar los pesos. En cambio, la inferencia usa una red ya entrenada para predecir, sin aprender de la imagen enviada.
Requisitos de Docker y GPU
Para seguir el código, debe saber leer funciones de Python, manipular tablas y usar un terminal. Los comandos suponen nociones básicas de Docker: una imagen describe el entorno de software, un contenedor ejecuta ese entorno y Compose organiza los servicios.
El recorrido r1 requiere Linux x86_64, Docker Compose, NVIDIA Container Toolkit y una RTX 3090 de 24 GiB. El README recomienda 16 GiB de RAM y 16 GiB de disco, sin contar las capas Docker. Son los recursos indicados para este recorrido; no se valida ningún perfil de CPU.
La RAM pertenece a la máquina anfitriona; la memoria de vídeo pertenece a la GPU. NVIDIA Container Toolkit permite exponer los recursos de GPU a Docker. No basta con que Linux reconozca una tarjeta: check_environment.py también debe comprobar CUDA en el contenedor.
El servicio acquire descarga los archivos públicos. El servicio gpu ejecuta los cálculos locales. locks/models.lock.json bloquea los archivos y locks/environment.lock.json el entorno. Estos archivos cumplen una función comparable a un archivo de bloqueo de dependencias: fijan los activos esperados para que el experimento no cambie silenciosamente.
Las referencias de documentación al final del artículo explican los mecanismos. Las versiones que deben utilizarse para reproducir r1 siguen siendo las del proyecto, no las de otro tutorial o de una instalación actualizada al azar.
Datos y función central
Separar las imágenes de aprendizaje de las imágenes de evaluación
El conjunto oficial Fashion-MNIST ofrece 60 000 imágenes de entrenamiento y 10 000 imágenes de prueba. El primer conjunto forma el pool inicial en el que se preparan entrenamiento y validación; no debe confundirse con el tamaño finalmente seleccionado por la configuración de este tutorial.
El train sirve para actualizar los pesos. La validación sirve para observar las decisiones de entrenamiento. El test sirve para comparar los modelos una vez fijadas estas decisiones. Aquí se conservan las 10 000 imágenes de la prueba oficial.
Antes de la selección train/validation, el proyecto excluye del pool correspondiente los duplicados idénticos. Después, la selección es estratificada: tiene en cuenta las clases para controlar su representación. Estas dos operaciones responden a problemas distintos. Equilibrar las clases no basta para impedir que una imagen esté presente varias veces.
Los tamaños finales de train/validation y el número de duplicados retirados no se cuantifican en los resultados reproducidos en este artículo. Consúltelos en los registros de prepare: no los deduzca solo del tamaño oficial de Fashion-MNIST.
Una red grande y una pequeña, pero la misma salida
El profesor tiene 93 962 parámetros. Incluye tres bloques convolucionales de anchuras 32, 64, 128. El estudiante tiene 5 130 parámetros, con dos bloques de anchuras 16, 32. Estas anchuras designan el número de canales de representación de los bloques, no las dimensiones de la imagen de entrada.
Pese a esta diferencia interna, cada uno debe producir diez puntuaciones correspondientes a las mismas diez clases, en el mismo orden. Sin esta alineación, comparar las distribuciones equivaldría a comparar la columna «jersey» de uno con la columna «bolso» del otro.
Para un lote de B imágenes, la representación habitual es B × 1 × 28 × 28: imágenes, canal monocromo, alto, ancho. Los logits tienen forma B × 10 y las etiquetas forma B, con un identificador de clase por imagen. Un tensor es simplemente la tabla numérica multidimensional que contiene estos valores en PyTorch.
El código de la pérdida
Este es el extracto continuo de src/vision_distill/losses.py. Pese a sus nombres, los argumentos student y teacher son aquí los tensores de logits ya calculados, no los objetos de red. F designa las funciones de torch.nn.functional.
def distillation_loss(student, teacher, labels, alpha=0.5, temperature=3.0):
    if temperature <= 0 or not 0 <= alpha <= 1:
        raise ValueError("T>0 and 0<=alpha<=1 required")
    ce = F.cross_entropy(student, labels)
    target = F.softmax(teacher.detach() / temperature, dim=-1)
    logp = F.log_softmax(student / temperature, dim=-1)
    kl = (target * (torch.log(target.clamp_min(1e-30)) - logp)).sum(-1).mean()
    return (1 - alpha) * ce + alpha * temperature**2 * kl
¿Qué acaba de ocurrir? La función calculó un coste escalar a partir de las predicciones y las etiquetas. No carga los modelos, no calcula sus predicciones ni actualiza sus pesos. Las llamadas a backward() y al optimizador pertenecen al bucle de entrenamiento, fuera de este extracto.
Leer el cálculo línea por línea
El primer control se refiere a los ajustes. La temperatura debe ser estrictamente positiva y alpha estar entre 0 y 1. Esta comprobación explícita no constituye por sí sola una validación completa de las formas, dispositivos y valores numéricos de los tensores.
ce calcula el error respecto a la etiqueta. Recibe directamente los logits del estudiante, sin división por la temperatura. No les aplique un softmax adicional antes de esta llamada: la documentación de CrossEntropyLoss precisa que la entrada esperada contiene puntuaciones no normalizadas.
target construye la respuesta suavizada del profesor. dim=-1 designa la última dimensión, es decir, las clases. El softmax se aplica por separado a cada imagen del lote.
teacher.detach() corta la ruta del gradiente hacia los logits del profesor. La pérdida puede usar sus valores, pero no asciende por esta rama para entrenar al profesor. Este es el papel documentado de detach().
Hay que distinguir este corte de gradiente del modo de ejecución de la red: detach() no pone al profesor en modo de evaluación. El tutorial oficial de PyTorch sobre destilación muestra por separado teacher.eval(), el cálculo sin gradientes del profesor y la optimización de los parámetros del estudiante. El extracto de pérdida presentado aquí no muestra este bucle completo.
logp calcula los logaritmos de las probabilidades suavizadas del estudiante. Se usa la misma temperatura en ambos lados. El cálculo emplea directamente log_softmax, en vez de encadenar manualmente softmax y logaritmo.
kl compara las dos distribuciones. Si llamamos q a las probabilidades del profesor y p a las del estudiante, una imagen aporta:
KL(q || p) = suma_clases q × (log(q) − log(p)).
La guarda clamp_min(1e-30) limita los valores entregados al logaritmo del objetivo. No reemplaza todas las probabilidades por este mínimo ni renormaliza la distribución: el factor multiplicativo sigue siendo target.
.sum(-1).mean() fija el denominador. Primero sumamos las contribuciones de las diez clases para cada imagen y luego calculamos la media sobre las imágenes del lote. No es una media de todas las celdas de la tabla. La documentación de KLDivLoss distingue este comportamiento, que corresponde aquí a batchmean, de la reducción mean. Con diez clases, promediar todas las celdas dividiría de nuevo el término por diez.
Un pequeño cálculo de KL
Para comprobar el sentido de la fórmula, tomemos distribuciones ficticias ya suavizadas: q = [0,50 ; 0,25 ; 0,25] para el profesor y p = [0,25 ; 0,25 ; 0,50] para el estudiante.
La primera clase aporta 0,50 × log(2). La segunda aporta cero. La tercera aporta 0,25 × log(0,5), una cantidad negativa. Su suma vale aproximadamente 0,1733.
Una contribución individual puede ser negativa, aunque la divergencia total no sea negativa en aritmética exacta. Cuando las distribuciones son idénticas, la KL vale cero. Esto no significa que la CE valga cero: profesor y estudiante pueden estar de acuerdo sin asignar toda la probabilidad a la etiqueta esperada.
Alpha y T² no desempeñan el mismo papel
La última línea construye:
pérdida = (1 − alpha) × CE + alpha × T² × KL.
alpha=0 da un objetivo basado en las etiquetas; alpha=1 da un objetivo basado en la distribución del profesor. Sin embargo, en este extracto ambos términos se calculan antes de la suma: fijar alpha=0 no elimina automáticamente el cálculo de la rama del profesor.
Con los valores predeterminados alpha=0.5 y temperature=3.0, la fórmula se convierte en 0,5 × CE + 4,5 × KL. Los coeficientes son iguales entre CE y T² × KL, no entre CE y la KL bruta. Esto tampoco garantiza gradientes del mismo tamaño.
¿Por qué T²? Dividir los logits por la temperatura también modifica los gradientes del término de destilación. Este factor es la compensación de escala convencional para conservar una señal comparable; no garantiza una invariancia exacta cuando cambia la temperatura. El artículo fundador de Hinton, Vinyals y Dean y el tutorial de PyTorch citado antes presentan este enfoque. El ejercicio permitirá aislar qué ocurre al retirar este factor sin cambiar T.
Instalar y preparar las imágenes
Extraiga el ZIP y abra un terminal en su directorio raíz. Todos los comandos siguientes parten de esa misma carpeta. Los comandos iniciales respetan el orden de README.md y de lesson/tutorial.json.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prepara el proyecto. config --quiet comprueba la configuración de Compose y build construye las imágenes de los dos servicios. La adquisición recupera los archivos conforme a los locks; el siguiente control verifica CUDA en el contenedor. Por último, pytest ejecuta la suite del proyecto.
En esta etapa, busca una instalación coherente y controles correctos, todavía no una buena exactitud de clasificación. Corrija una adquisición o un acceso CUDA que falle antes de continuar.
A continuación, cree las particiones, inspeccione las redes, entrene al profesor y controle la pérdida antes del aprendizaje de los estudiantes:
docker compose run --rm gpu python -m vision_distill.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli inspect-models --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli train-teacher --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli check-loss --config configs/minimum.yaml
Después de prepare, examine los registros de particiones y duplicados. Después de inspect-models, relacione las formas de los tensores con los 93 962 y 5 130 parámetros anunciados: debe poder explicar qué entra en cada red y qué sale de ella.
train-teacher entrena la red que después proporcionará las distribuciones objetivo. check-loss verifica en particular, en el caso controlado de un profesor idéntico, que este no recibe gradiente mediante la pérdida. Este control verifica el mecanismo; no demuestra ni que el profesor reconozca todas las imágenes ni que el estudiante se beneficie de su ayuda.
Entrenar, reanudar y medir
Ahora disponemos de los datos preparados y del profesor. Entrene los dos estudiantes y luego controle una interrupción y una reanudación antes de la evaluación de prueba:
docker compose run --rm gpu python -m vision_distill.cli train-students --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli interrupt-student --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli resume-student --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m vision_distill.cli evaluate --config configs/minimum.yaml
El estudiante con etiquetas constituye nuestra baseline, es decir, la referencia sencilla con la que comparar la destilación. Es esencial no eliminarlo: comparar solo al profesor con el modelo pequeño destilado mezclaría dos cambios, la arquitectura y el método de aprendizaje.
La interrupción y la reanudación controlan un estado completo. Un checkpoint es una copia de seguridad que permite recuperar un estado de cálculo; reanudar el aprendizaje no se reduce necesariamente a recargar los pesos. También hay que recuperar lo que determina las actualizaciones posteriores y el recorrido de los datos. Los detalles del estado guardado son los del proyecto, y compare-resume es el control que debe examinarse en vez de conformarse con una ejecución que se reinicia sin error.
Por último, evaluate produce las mediciones de los tres modelos sobre las mismas 10 000 imágenes de la prueba oficial. Conserve estos resultados antes de pasar al ejercicio.
Métricas antes de las mediciones
La exactitud global: ¿cuántas imágenes están bien clasificadas?
En este artículo, exactitud global designa la accuracy, también llamada exactitud:
accuracy = número de imágenes clasificadas correctamente / número de imágenes evaluadas.
En un ejemplo ficticio de 100 imágenes, 80 clases predichas correctamente dan un 80 %. Esto todavía no dice qué clases plantean problemas. Dos modelos con la misma accuracy pueden equivocarse en imágenes distintas.
La macro-F1: mirar también cada clase
Atención al vocabulario: la precisión de una clase usada en F1 no tiene el mismo denominador que la accuracy global.
Tomemos un ejemplo ficticio. Entre las imágenes que el modelo anuncia como «jersey», 8 son realmente jerséis y 2 no lo son. El conjunto contiene 12 jerséis reales en total: por tanto, el modelo ha omitido 4.
Su precisión para esta clase vale 8 / 10 = 0,8: entre las predicciones «jersey», ¿qué parte es correcta? Su recall vale 8 / 12 ≈ 0,6667: entre los jerséis reales, ¿qué parte ha encontrado?
El F1 combina ambos con una media armónica:
F1 = 2 × precisión × recall / (precisión + recall).
Aquí vale 16 / 22 ≈ 0,7273. La macro-F1 calcula después este F1 por separado para cada una de las diez clases y luego obtiene la media sin ponderación por su tamaño. No es el F1 calculado a partir de una precisión media y un recall medio.
La documentación de scikit-learn sobre F1 detalla estas definiciones. Sirve aquí de referencia para la métrica, sin presuponer la biblioteca empleada en el proyecto. La macro-F1 da el mismo peso a cada clase, pero sigue siendo una media: el análisis de errores por clase continúa siendo útil.
Tres costes que no deben confundirse
El número de parámetros describe cuántos valores contiene la red. El tamaño de los pesos describe el espacio ocupado por su representación guardada. Ambos están relacionados, pero también cuentan el formato y la precisión numérica del almacenamiento. El tamaño de un archivo no es una medida completa de la memoria necesaria para la ejecución.
El tiempo en caliente mide el procesamiento una vez preparado el modelo, no su instalación ni su carga inicial. El tiempo en caliente por imagen de este recorrido no es ni latencia de red ni un benchmark bajo carga. Por tanto, no basta para prometer un tiempo de respuesta a un usuario de su aplicación.
Los resultados numéricos indicados abajo no dan valores de tiempo en caliente. No podemos deducir de ellos una aceleración medida, aunque el número de parámetros disminuya mucho.
Resultados reales y aprendizaje
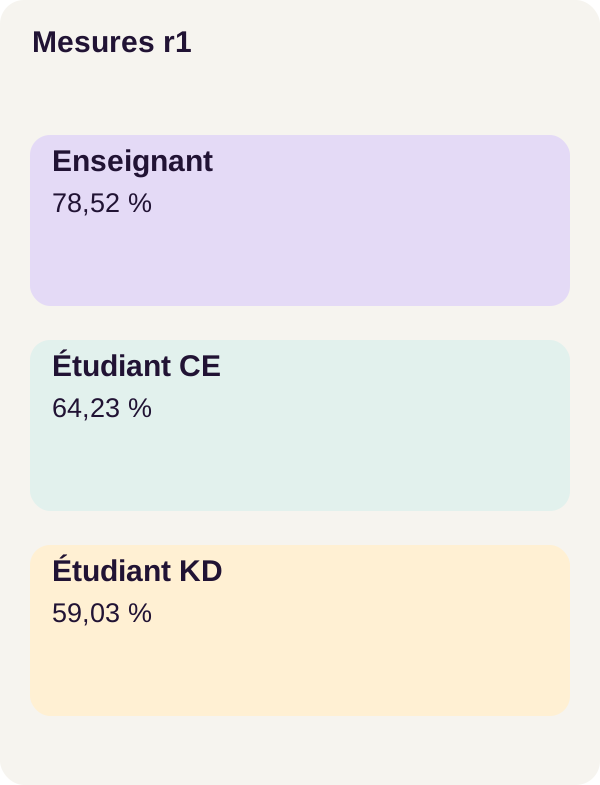
Estos son los valores de la ejecución r1 sobre las 10 000 imágenes de prueba, con los decimales indicados para la macro-F1:
| Modelo | Exactitud global | Macro-F1 |
|---|---|---|
| Profesor | 78,52 % | 0,7756504071911894 |
| Estudiante con etiquetas, CE | 64,23 % | 0,6256681401207919 |
| Estudiante destilado | 59,03 % | 0,5716481462359492 |
Los costes de almacenamiento y arquitectura indicados son los siguientes. Un MiB corresponde a 1 048 576 bytes.
| Modelo | Parámetros | Tamaño de los pesos, en MiB |
|---|---|---|
| Profesor | 93 962 | 0,3612794876098633 |
| Estudiante con etiquetas, CE | 5 130 | 0,02199268341064453 |
| Estudiante destilado | 5 130 | 0,02199268341064453 |
Los dos estudiantes tienen aproximadamente 18,32 veces menos parámetros que el profesor, una reducción de cerca del 94,54 %. La relación entre los tamaños de pesos vale aproximadamente 16,43. Estas relaciones son cálculos a partir de los valores de la tabla, no mediciones de velocidad.
La comparación decisiva es la de los dos estudiantes: 59,03 − 64,23 = −5,20 puntos porcentuales. Sobre 10 000 imágenes, las tasas corresponden respectivamente a 5 903 y 6 423 clasificaciones correctas, una diferencia neta de 520. Esto no significa que hayamos identificado exactamente 520 imágenes degradadas de forma exclusiva: habría que comparar las predicciones imagen por imagen para saberlo.
La macro-F1 también baja. Con estos ajustes y estos datos, la destilación no mejora al estudiante. La ganancia de tamaño ya existe para el estudiante CE; sería erróneo atribuirla a una ganancia de calidad aportada por la destilación.
¿Por qué este resultado? La calidad de la señal del profesor, el peso relativo de las dos pérdidas, la temperatura, la capacidad del estudiante o la duración del aprendizaje son vías que examinar. La tabla no permite aislar una causa. Tampoco demuestra que otra temperatura o más entrenamiento resolverían el problema.
Para profundizar, mantenga el profesor, la baseline CE y un protocolo de datos estable. Elija los nuevos ajustes con la validación y utilice después la misma prueba para la comparación final de las variantes seleccionadas. Ajustar continuamente los parámetros mirando la prueba acabaría convirtiéndola en una herramienta de ajuste en lugar de una evaluación independiente.
Ejercicio: predecir y ejecutar
Predecir el cambio antes de tocar el cálculo
Conserve T=3 y retire mentalmente el factor T². Las imágenes, logits y distribuciones están fijos: solo cambia la ponderación del término KL.
Con alpha=0,5, pasamos de:
0,5 × CE + 4,5 × KL
a:
0,5 × CE + 0,5 × KL.
Por tanto, el término KL ponderado se divide entre 9. En este mismo lote, su gradiente también se divide entre 9. Pero el gradiente total no se divide necesariamente entre 9: la contribución CE permanece sin cambios.
Para ver por qué, tome un ejemplo pedagógico con un solo parámetro. La contribución CE ya ponderada vale +1, la de KL ya ponderada vale −0,9. Su suma vale +0,1. Tras dividir la segunda por 9, la suma pasa a ser +1 − 0,1 = +0,9. Reducir una contribución aumentó aquí la norma del gradiente total porque antes ambas contribuciones se compensaban.
Este contraejemplo no describe los gradientes del modelo r1. Explica por qué hay que distinguir la norma del gradiente KL de la norma del gradiente de la pérdida completa.
Otra trampa: el valor total de la pérdida puede bajar simplemente porque ha disminuido un coeficiente. Para valores ficticios CE=1,2 y KL=0,1, pasaría de 1,05 a 0,65, sin ninguna mejora de las predicciones. Estos dos números corresponden a dos objetivos ponderados de manera distinta.
Ejecutar e interpretar
Ejecute ahora el ejercicio proporcionado:
docker compose run --rm gpu python -m vision_distill.cli exercise --config configs/exercise.yaml
Compare el diagnóstico de gradiente con su predicción. Compruebe qué término representa cada norma y separe el cambio de escala de la reacción del gradiente total. No convierta este diagnóstico sobre un batch fijo en prueba de que una futura exactitud aumentará: no sustituye un entrenamiento seguido de evaluate.
Termine con las figuras, los checkpoints y la detención del proyecto:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
plot.py genera las figuras. El control siguiente examina los checkpoints. La limpieza es una previsualización: --dry-run no borra nada. La detención de Compose no elimina las salidas del proyecto.
Adaptación, producción, resolución de problemas y limpieza
Pasar de imágenes pequeñas a su aplicación
Para adaptar este experimento, empiece por el contrato de negocio: ¿qué clases desea distinguir y qué errores serían inaceptables? En nuestro ejemplo de back office, una sugerencia revisada por un operador no tiene las mismas consecuencias que una clasificación automática sin control.
Construya un conjunto de datos autorizado y versionado. Documente las transformaciones aplicadas a las imágenes y conserve particiones distintas de train, validation y test. Examine los errores por clase y elija un umbral de calidad antes de intentar reducir los pesos. El buen estudiante es el que respeta este contrato, no simplemente el que tiene menos parámetros.
El profesor sigue siendo una hipótesis de supervisión, no un árbitro infalible. Conserve el estudiante CE y cambie solo un factor cada vez para entender los resultados de un nuevo experimento. Las licencias y la posible presencia de datos personales también deben comprobarse antes de usar sus propias imágenes.
Mida después el modelo exportado en el entorno objetivo, con su preprocesamiento y una carga representativa. La reducción de parámetros no conlleva automáticamente una reducción proporcional de latencia en cada material. El recorrido CUDA presentado aquí no valida un despliegue en CPU, móvil o navegador.
Resolver problemas sin cambiar silenciosamente el experimento
Si CUDA falla, vuelva a ejecutar el control del contenedor y siga la guía de NVIDIA Container Toolkit. Corrija el acceso a la GPU antes de modificar el modelo o la pérdida.
Si falla la adquisición, restaure el acceso de red del servicio acquire y ejecute de nuevo el comando correspondiente. No sustituya los archivos ni las dependencias bloqueadas por otra versión solo para sortear el error.
Si los dos estudiantes dan puntuaciones diferentes, empiece releyendo la definición de sus objetivos, los registros de entrenamiento y los errores por clase. Un resultado peor no prueba por sí solo un defecto de cálculo: la destilación es un método que evaluar, no una garantía de progreso.
Por último, docker compose down --remove-orphans detiene los servicios sin borrar las salidas. El script de limpieza sigue en modo dry-run. Conserve las configuraciones, mediciones y checkpoints necesarios antes de cualquier eliminación voluntaria de sus archivos de prueba.
Para recordar: reducir la arquitectura, transmitir una distribución y mejorar las predicciones son tres cosas distintas. Este tutorial permite medirlas por separado, incluso cuando el método más elaborado no produce el mejor estudiante.
Fuentes oficiales
Las mediciones r1 anteriores son las del recorrido del proyecto. Las referencias siguientes explican los datos, las fórmulas y las API; no constituyen nuevas ejecuciones de este experimento.
- PyTorch: entropía cruzada y documentación versionada consultada: logits, etiquetas y cálculo de CE.
- PyTorch: divergencia KL y documentación versionada consultada: sentido de la divergencia y diferencia entre
meanybatchmean. - Fashion-MNIST: formato de imágenes, particiones oficiales y etiquetas.
- Docker Compose: compatibilidad con GPU: exposición de las GPU a los servicios.
- Hinton, Vinyals y Dean — Distilling the Knowledge in a Neural Network: referencia fundadora de la destilación de distribuciones.
- PyTorch — Knowledge Distillation Tutorial: aprendizaje profesor-estudiante, temperatura y combinación de pérdidas.
- PyTorch — Tensor.detach: corte del vínculo con el grafo de gradientes.
- Scikit-learn — F1 score: precisión, recall y media macro.
- NVIDIA Container Toolkit — instalación: integración entre GPU, controlador y contenedor.