





Imaginez un petit outil graphique avec trois choix : disque, anneau et croix. Vous sélectionnez « anneau », puis demandez une nouvelle image. Pour simplement dessiner cette forme dans une application web, quelques règles géométriques ou un SVG suffiraient. Mais comment un réseau de neurones pourrait-il apprendre à la produire, en partant seulement d'une image de bruit ?
C'est la question de ce tutoriel. Nous allons fabriquer des exemples dont nous connaissons la construction, entraîner un petit modèle de diffusion, puis examiner ce qu'il a réellement appris. Le programme livré est un parcours Python en ligne de commande, pas une interface graphique : les trois formes servent de terrain d'expérience.
Le résultat mérite d'être annoncé dès le départ : le modèle apprend à mieux prédire le bruit, mais cette configuration ne produit aucun masque accepté par les critères géométriques du projet. Ce n'est pas un détail à cacher derrière une courbe qui descend. C'est précisément ce qui permet d'apprendre à distinguer un entraînement qui progresse d'un générateur qui répond au besoin.
Télécharger l'archive du tutoriel.
Ce que nous construisons
Nous construisons une diffusion conditionnelle sur des images de 32 × 32 pixels. « Conditionnelle » signifie que le réseau reçoit une information supplémentaire : la classe demandée, disque, anneau ou croix. Nous ne lui transmettons pas une description en français ; la condition est ici un identifiant de classe.
Les images sont des masques : chaque pixel estime quelle fraction de sa surface appartient à la forme. Un pixel entièrement extérieur vaut 0, un pixel entièrement intérieur vaut 1, et un pixel traversé par le bord peut prendre une valeur intermédiaire. Il n'y a qu'un canal, et non trois canaux rouge, vert et bleu.
Le parcours sépare trois opérations. Pendant l'entraînement, nous partons de masques connus, nous ajoutons un bruit connu et nous modifions les paramètres du réseau pour qu'il apprenne à prédire ce bruit. Pendant la génération, nous gardons ces paramètres fixes et partons d'un bruit pour construire progressivement une image. Pendant l'évaluation, des règles extérieures au réseau vérifient les sorties.
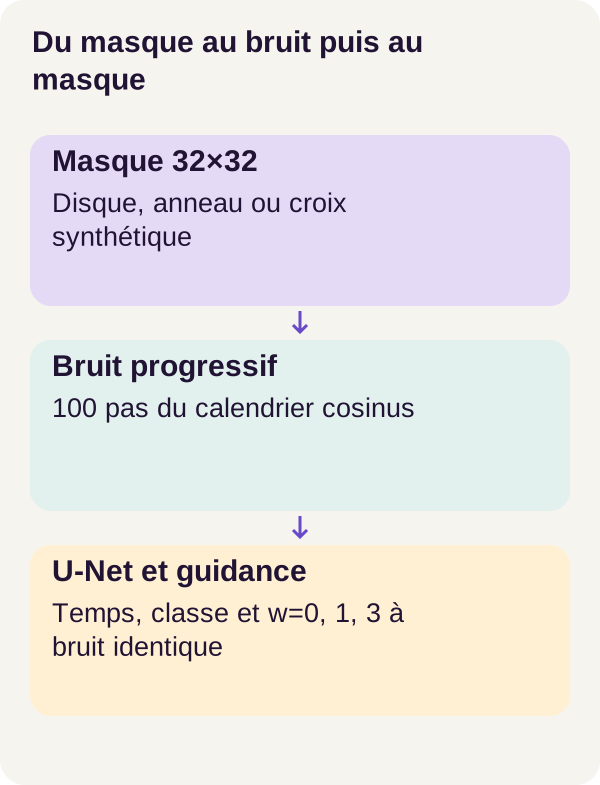
Le réseau est un U-Net, dont nous allons expliquer le rôle. Il apprend aussi à travailler sans classe précisée, grâce à une condition spéciale appelée classe nulle. Nous pourrons ainsi comparer ses prédictions avec et sans indication de forme, puis les combiner avec la guidance sans classifieur.
Le cas est volontairement synthétique : il ne produit ni photographie ni dessin industriel. Son intérêt est ailleurs. Un anneau doit notamment conserver un trou ; un disque ne doit pas se transformer en morceaux isolés. Ces propriétés donnent des questions concrètes à poser aux résultats, au-delà de « cette image semble intéressante ».
Les concepts à garder en tête
Une image bruitée reste un tableau de nombres
Un tenseur est un tableau de nombres à une ou plusieurs dimensions. Pour notre masque, 1 × 32 × 32 signifie un canal, une hauteur de 32 et une largeur de 32. Un lot d'images ajoute une dimension devant : nombre d'images, canal, hauteur, largeur.
Le bruit gaussien est lui aussi un tableau, avec une valeur aléatoire par pixel. « Gaussien » décrit la distribution de ces valeurs : elles se répartissent autour de zéro, avec davantage de petites valeurs que de valeurs extrêmes. Ce bruit n'est ni une erreur de fichier ni une image mal téléchargée. Nous l'ajoutons volontairement et conservons les valeurs tirées pour savoir ce que le réseau doit prédire.
Dans les calculs du réseau, les pixels propres passent de [0, 1] à [-1, 1] avec x * 2 - 1. Ainsi, 0 devient -1, 0.5 devient 0 et 1 reste 1. Le bruit et les états bruités, eux, ne sont pas limités à cet intervalle.
Le trajet aller : ajouter une difficulté connue
La diffusion directe transforme un masque propre, noté x0, en un masque bruité xt. L'indice t indique le niveau de diffusion choisi, pas une durée en secondes.
La formule utilisée est :
xt = √ᾱt x0 + √(1 − ᾱt) ε
On peut la lire sans commencer par une démonstration : une partie de l'image propre, plus une partie de bruit. ε, la lettre grecque « epsilon », désigne le bruit tiré. ᾱt, « alpha barre au pas t », règle la quantité de signal conservée. Les racines carrées déterminent les coefficients effectivement appliqués.
Prenons un exemple de calcul inventé, sur une seule valeur, sans rapport avec une sortie mesurée du modèle. Avec x₀ = 1, ᾱₜ = 0.64 et ε = -0.5, nous obtenons :
xₜ = 0.8 × 1 + 0.6 × (-0.5) = 0.5.
Le résultat n'est pas obtenu en effaçant 36 % des pixels. Chaque valeur est transformée par le mélange. Les coefficients ne constituent pas non plus deux opacités dont la somme devrait valoir 1.
Un calendrier de bruit, ou noise schedule, fixe l'évolution de ces coefficients. Celui du projet est un calendrier cosinus de 100 pas. Il est défini par le programme ; il ne s'apprend pas avec les poids du réseau. Le principe du calendrier cosinus est présenté dans Improved Denoising Diffusion Probabilistic Models. Cette référence explique le choix de famille de calendrier, sans remplacer les paramètres du projet.
Ce que le réseau apprend vraiment
À l'entraînement, le réseau reçoit l'image bruitée, le pas t et la classe. Il doit renvoyer le bruit estimé, pas directement un disque ou un anneau terminé. Nous connaissons la bonne réponse, puisque nous avons nous-mêmes tiré le bruit ε.
La perte, ou loss, mesure l'écart entre cette prédiction et le bruit injecté. Ici, c'est la MSE, mean squared error, ou erreur quadratique moyenne : on calcule les différences, on les met au carré, puis on en prend la moyenne.
Un deuxième exemple pédagogique, limité à deux valeurs, suffit à suivre le calcul. Le bruit réel vaut [0.2, -0.4], et le réseau prédit [0.1, -0.2]. Les écarts au carré valent 0.01 et 0.04, donc la MSE vaut (0.01 + 0.04) / 2 = 0.025. Une erreur deux fois plus grande contribue quatre fois plus à cette perte.
Les poids sont les nombres ajustables du réseau. Les gradients indiquent comment une variation de ces nombres affecte la perte ; l'optimiseur s'en sert pour les mettre à jour. Nous ne codons donc pas une règle « dessiner un anneau » dans le réseau : nous ajustons ses poids à partir d'exemples bruités et de leurs réponses attendues.
Attention aux deux sens de « pas ». Les 100 pas de diffusion décrivent les niveaux de bruit et le trajet de génération. Les 2 000 mises à jour annoncées plus loin décrivent l'entraînement des poids. Ce ne sont pas deux manières de compter la même boucle.
Pourquoi un U-Net ?
Le U-Net applique des convolutions, c'est-à-dire des filtres appris qui combinent des valeurs voisines. Son trajet descendant réduit la résolution pour agréger l'information ; son trajet remontant retrouve une résolution fine. Des connexions entre ces deux trajets réintroduisent des détails spatiaux. Le site des auteurs de U-Net présente cette architecture à deux trajets.
Dans src/mask_diffusion/unet.py, ConditionalUNet.forward() combine une représentation numérique du temps et de la classe, puis la fournit aux blocs du réseau. Le temps lui indique à quel niveau de bruit il travaille. La classe lui indique quelle famille de masques est demandée.
Sa sortie possède la même forme que l'image bruitée : une estimation de bruit pour chaque pixel. C'est ensuite le programme d'échantillonnage qui utilise cette estimation pour calculer l'état suivant. Cette distinction entre le réseau et le calcul qui l'entoure est centrale dans DDPM.
Une condition n'est pas une garantie
La classe nulle signifie « pas de classe précisée ». Ce n'est ni une quatrième forme à dessiner ni une consigne de produire une image vide. Le même réseau doit pouvoir fournir une estimation conditionnelle et une estimation non conditionnelle.
Le principe de Classifier-Free Diffusion Guidance est d'apprendre aussi sans condition, en retirant celle-ci sur une partie des exemples, puis de combiner les deux estimations à la génération. Nous n'avons pas besoin d'ajouter un classifieur séparé pour calculer cette combinaison. Cela ne supprime évidemment pas le besoin d'évaluer les images après leur production.
Dans ce projet, la combinaison est εu + w(εc − εu), où u désigne la prédiction non conditionnelle et c la prédiction conditionnelle. Nous la lirons dans le code : w=0 conserve u, w=1 conserve c. Une valeur plus grande ne constitue pas une promesse de meilleure image.
Prérequis Docker et GPU
Vous devez pouvoir lire des fonctions Python, manipuler des tableaux et lancer des commandes dans un terminal. Les bases de Docker sont nécessaires ; aucune connaissance préalable des modèles de diffusion n'est supposée.
Le parcours demande Linux x86_64, Docker Compose, le NVIDIA Container Toolkit, une RTX 3090 de 24 Gio, 16 Gio de RAM et 16 Gio de disque disponibles, hors couches Docker partagées. Ce sont les ressources indiquées pour ce tutoriel, pas une démonstration de compatibilité avec tous les matériels.
Le GPU, la carte graphique, exécute ici les calculs du réseau avec CUDA. Une carte visible par Linux peut toutefois être inaccessible à Docker. Le contrôle fourni ne se contente donc pas de lister un périphérique : il initialise CUDA dans le conteneur et exécute un calcul. La sélection éventuelle se fait avant le parcours avec export GPU_DEVICE=0, ou avec un UUID de carte, son identifiant unique.
Le calcul est isolé du réseau. Les conteneurs utilisent un système de fichiers en lecture seule, no-new-privileges, la suppression des capacités Linux et des limites CPU, RAM et nombre de processus. Ces restrictions bornent l'exécution ; elles ne prouvent pas la qualité des images. Ne confondez pas non plus calcul isolé et installation intégralement hors ligne : la construction des images Docker et l'acquisition de leurs dépendances peuvent nécessiter un accès réseau.
Un checkpoint est une sauvegarde permettant de conserver ou de reprendre un état de calcul. Les artefacts Torch produits localement doivent rester de confiance : ne chargez pas de checkpoint tiers arbitraire pour remplacer un fichier manquant. La documentation de torch.load rappelle les précautions de chargement.
Des données dont on connaît la construction
Fabriquer une référence avant de demander au modèle d'apprendre
Pour notre expérience, nous n'avons pas besoin de collecter des images sur Internet. Nous savons définir un disque, un anneau et une croix par des règles géométriques. La fonction suivante fabrique les exemples d'entraînement ; elle n'est pas le générateur neuronal que nous évaluerons ensuite.
Elle reçoit un identifiant label, un centre, un rayon, une épaisseur et un angle. Les identifiants 0, 1 et 2 désignent respectivement disque, anneau et croix.
def render_mask(label, center=(0.0, 0.0), radius=0.55, thickness=0.18, angle=0.0):
    # Four subpixels in each direction; occupation fraction is the antialiased pixel.
    axis = (np.arange(128) + 0.5) / 64 - 1
    x, y = np.meshgrid(axis - center[0], axis - center[1])
    u = x * np.cos(angle) + y * np.sin(angle)
    v = -x * np.sin(angle) + y * np.cos(angle)
    distance = np.sqrt(x * x + y * y)
    if label == 0:
        inside = distance <= radius
    elif label == 1:
        inside = (distance <= radius) & (distance >= radius - thickness)
    elif label == 2:
        inside = ((abs(u) <= radius) & (abs(v) <= thickness / 2)) | (
            (abs(v) <= radius) & (abs(u) <= thickness / 2)
        )
    else:
        raise ValueError("Unknown geometric class")
    return inside.reshape(32, 4, 32, 4).mean((1, 3)).astype("float32")[None]
Que vient de faire cette fonction ?
axis place les centres de 128 petits intervalles entre -1 et 1. meshgrid construit les coordonnées d'une grille de 128 × 128 positions. Soustraire center permet de déplacer la forme sans changer ses règles. Les coordonnées u et v appliquent la rotation utilisée pour construire la croix.
Pour le disque, chaque position est intérieure si sa distance au centre ne dépasse pas radius. Pour l'anneau, cette distance doit aussi être au moins égale à radius - thickness : le centre reste vide. Pour la croix, le programme réunit deux rectangles perpendiculaires. Un identifiant de classe inconnu provoque une erreur plutôt qu'une forme choisie par défaut.
Pourquoi une grille de 128 × 128 alors que la sortie fait 32 × 32 ? Pour l'anti-crénelage, qui réduit l'effet d'escalier aux contours. Chaque pixel final est représenté par quatre sous-pixels dans chaque direction, donc 16 sous-pixels. reshape(32, 4, 32, 4).mean((1, 3)) calcule leur occupation moyenne.
Par exemple, 12 sous-pixels intérieurs sur 16 donnent 0.75. Ce gris n'est pas une prédiction incertaine : il représente une fraction de surface dans notre méthode de rendu. L'anti-crénelage appartient donc aux données elles-mêmes, et non à une retouche appliquée après l'évaluation.
Enfin, astype("float32") choisit un stockage numérique sur 32 bits. Le [None] ajoute la dimension du canal. Nous obtenons un tableau 1 × 32 × 32, sans dimension de lot à ce stade.
Séparer les données avant l'entraînement
La préparation produit trois ensembles équilibrés. Le tableau suivant explicite les effectifs du projet ; les effectifs par classe découlent de cet équilibre.
| Ensemble | Nombre de masques | Masques par classe | Rôle |
|---|---|---|---|
| Entraînement | 3 000 | 1 000 | Fournir les exemples utilisés pour modifier les poids. |
| Validation | 600 | 200 | Mesurer la perte sur des exemples séparés de l'entraînement. |
| Test | 600 | 200 | Conserver un ensemble distinct pour l'évaluation prévue par le projet. |
Chaque partition utilise une graine différente pour ses tirages pseudo-aléatoires. Une graine initialise un générateur ; ce n'est pas une annotation d'image. Chaque image est également hachée, et tout doublon est rejeté avant de figer les ensembles.
Le hachage produit une empreinte du contenu. Il permet de repérer un contenu identique, pas de garantir que deux formes différentes ne sont jamais très proches. Sur un petit univers de disques, d'anneaux et de croix, cette nuance compte. La classe nulle n'ajoute pas une quatrième catégorie de masques à ce tableau : elle intervient dans la façon de conditionner le réseau.
Le code central : apprendre le bruit, puis guider le retour
Générer n'est pas relancer le dessin géométrique
Le sampler, ou programme d'échantillonnage, part d'un état bruité et calcule les états suivants dans l'ordre inverse de la diffusion. Ici, il appelle le modèle deux fois à chaque pas, combine les deux bruits prédits et ajoute un nouveau bruit gaussien, sauf au dernier pas.
Il ne consulte pas render_mask() pour récupérer la forme attendue. Il doit produire une image à partir de ce que le réseau a appris.
def guidance(unconditional, conditional, weight):
    return unconditional + weight * (conditional - unconditional)


def reverse_step(x, epsilon, t, schedule, noise):
    beta = schedule["beta"][t].to(x.device)
    alpha = schedule["alpha"][t].to(x.device)
    abar = schedule["abar"][t].to(x.device)
    previous = schedule["abar"][t - 1].to(x.device)
    mean = (x - beta * epsilon / (1 - abar).sqrt()) / alpha.sqrt()
    variance = beta * (1 - previous) / (1 - abar)
    return mean if t == 1 else mean + variance.sqrt() * noise


@torch.no_grad()
def ancestral_sample(
    model, initial, labels, weight, schedule, generator, start=None, stop=0
):
    x = initial.clone()
    trajectory = [x[0].cpu()]
    start = start or len(schedule["beta"]) - 1
    for t in range(start, stop, -1):
        times = torch.full((len(x),), t, device=x.device, dtype=torch.long)
        u = model(x, times, torch.full_like(labels, NULL_CLASS))
        c = model(x, times, labels)
        eps = guidance(u, c, weight)
        noise = (
            torch.randn(x.shape, device=x.device, generator=generator)
            if t > 1
            else torch.zeros_like(x)
        )
        x = reverse_step(x, eps, t, schedule, noise)
        trajectory.append(x[0].cpu())
    assert torch.isfinite(x).all()
    return x, torch.stack(trajectory)
Lire la guidance avec trois nombres
La première fonction applique exactement la formule annoncée : unconditional + weight * (conditional - unconditional).
Prenons un exemple arithmétique fictif sur une seule valeur de bruit, avec u = 0.2 et c = 0.5. Ce ne sont pas des sorties capturées du modèle.
| Poids du projet | Calcul | Résultat | Sens de l'opération |
|---|---|---|---|
w=0 |
0.2 + 0 × (0.5 - 0.2) |
0.2 |
Garder la prédiction non conditionnelle. |
w=1 |
0.2 + 1 × (0.5 - 0.2) |
0.5 |
Garder la prédiction conditionnelle. |
w=3 |
0.2 + 3 × (0.5 - 0.2) |
1.1 |
Prolonger la différence au-delà de la prédiction conditionnelle. |
w=3 est une extrapolation, pas un mélange à 75 % / 25 %. La valeur 1.1 ne signifie pas « 110 % de confiance » : nous manipulons une estimation de bruit, pas une probabilité. Si les deux branches renvoient exactement la même estimation, leur différence est nulle et changer w ne change pas cette combinaison.
Un piège de notation dans les références. L'article de Ho et Salimans écrit la combinaison sous la forme
(1 + w_article) × c - w_article × u. La convention de notre code correspond àw_projet = 1 + w_article. Gardez donc les valeurs et la formule du projet ensemble : lew=0de ce tutoriel désigne bien la branche non conditionnelle, alors que celui de cette formule de l'article désigne la branche conditionnelle.
Lire un pas de retour sans perdre le fil
reverse_step() reçoit l'état courant x, le bruit prédit epsilon et le numéro de pas. Le calendrier fournit beta, alpha et abar. Dans cette notation de diffusion, alpha correspond à 1 - beta et abar au produit des alpha jusqu'au pas considéré. previous récupère la valeur cumulée au pas précédent.
La ligne mean = ... corrige l'état à partir du bruit prédit et des coefficients du calendrier. La ligne variance = ... règle l'amplitude du bruit aléatoire utilisé pour tirer l'état suivant. Le bruit prédit epsilon et le bruit nouvellement tiré noise n'ont donc pas le même rôle. Le premier vient du réseau ; le second maintient une étape aléatoire dans ce sampler.
Le retour contient ce nouveau bruit pour t > 1. À t == 1, la fonction renvoie seulement mean. Ajouter du bruit pendant le retour peut sembler paradoxal, mais le programme ne déroule pas à l'envers l'historique exact d'une image particulière : il construit une trajectoire de génération selon la règle d'échantillonnage.
Suivre la boucle et ce qu'elle conserve
initial.clone() crée un état de travail sans écraser le tableau fourni par l'appelant. À chaque pas, times contient le même indice t pour toutes les images du lot. Les appels u = model(...) et c = model(...) utilisent le même réseau, avec une classe nulle puis avec les classes demandées.
Dans cet extrait, les deux appels ont lieu même pour w=0 ou w=1 : le code ne comporte pas de raccourci pour ces valeurs. Pour un trajet complet de 100 pas, cela représente 200 appels au réseau par lot, et non 200 mises à jour des poids.
Le décorateur @torch.no_grad() désactive le suivi des gradients pendant cette génération. Il n'y a ici ni calcul de perte d'entraînement ni mise à jour d'optimiseur. Ce décorateur ne remplace cependant pas un éventuel model.eval() : PyTorch distingue le mode d'évaluation du suivi des gradients. L'extrait ne montre pas comment l'appelant prépare le mode du réseau.
Regardez aussi trajectory.append(x[0].cpu()). La trajectoire conserve la première image du lot seulement, sur le CPU. La valeur finale x, elle, contient toutes les images du lot. Avec un départ à 100 et stop=0, la boucle traite 100, 99, …, 1, et la trajectoire contient l'état initial plus les 100 états calculés, soit 101 états.
L'assertion finale torch.isfinite(x).all() exige des valeurs numériques finies : ni NaN, ni infini. Elle ne vérifie ni les contours, ni les trous, ni même que les valeurs restent dans [0, 1]. Un tableau numériquement valide n'est pas encore une forme valide.
Même bruit initial : nécessaire, mais pas toute l'histoire
Le protocole compare w=0, w=1 et w=3 à bruit initial identique. C'est indispensable pour ne pas attribuer au poids de guidance une différence créée dès le départ.
Mais la boucle tire aussi de nouveaux bruits avec generator. Pour isoler complètement l'effet de w dans une comparaison appariée, il faut également retrouver la même suite de tirages intermédiaires. Le sampler reçoit ce générateur ; il ne le réinitialise pas lui-même. Deux appels successifs avec le même objet générateur peuvent donc consommer deux portions différentes de sa suite.
Cette précision découle du code affiché : conserver initial ne suffit pas, à lui seul, à établir le contrôle de tous les tirages. L'initialisation et la sauvegarde du générateur relèvent du code appelant dans le projet complet.
La même question apparaît à la reprise. Avec start=100 et stop=50, la boucle traite les pas 100 à 51 et rend l'état au niveau 50. Reprendre depuis cet état avec start=50 demande de retrouver aussi l'état aléatoire correspondant, ainsi que le même modèle et le même calendrier. La documentation PyTorch sur la reproductibilité explique pourquoi fixer une graine ne garantit pas, à elle seule, des résultats identiques entre tous les environnements.
Mesurer l'apprentissage avec un exercice de validation figé
Pendant l'apprentissage, le programme tire un temps, ajoute ε et minimise l'erreur de prédiction de ε. Pour comparer deux états du réseau, la validation suivante utilise au contraire des temps et des bruits fixés à l'avance. C'est l'équivalent d'utiliser les mêmes données de test après chaque modification d'une application.
def validation_mse(model, config):
    assert (
        sha("outputs/validation-noise.npz")
        == read_json("outputs/validation-lock.json")["sha256"]
    )
    data = np.load("outputs/validation.npz")
    fixed = np.load("outputs/validation-noise.npz")
    total = 0.0
    model.eval()
    with torch.no_grad():
        for i in range(0, 600, 64):
            x = torch.from_numpy(data["images"][i : i + 64]).cuda() * 2 - 1
            t = torch.from_numpy(fixed["times"][i : i + 64]).cuda()
            eps = torch.from_numpy(fixed["noise"][i : i + 64]).cuda()
            y = torch.from_numpy(data["labels"][i : i + 64]).cuda()
            noisy = sample_noisy_image(
                x, t, eps, cosine_schedule(config["diffusion_steps"])
            )
            total += float((model(noisy, t, y) - eps).square().double().sum())
    model.train()
    return total / (600 * 32 * 32)
L'assertion initiale compare l'empreinte SHA-256 de outputs/validation-noise.npz à celle enregistrée dans outputs/validation-lock.json. Elle contrôle ce fichier de bruit figé ; ce n'est pas une vérification universelle de tous les fichiers du projet.
Le programme charge ensuite les 600 images de validation, les temps, les bruits et les classes. .cuda() place les tableaux sur le GPU. La transformation * 2 - 1 applique le changement d'échelle des masques expliqué plus haut.
model.eval() active le mode d'évaluation, tandis que torch.no_grad() désactive le suivi des gradients. Puis sample_noisy_image() fabrique chaque entrée bruitée. Nous comparons model(noisy, t, y) à eps, et non à l'image propre x : le score porte toujours sur le bruit.
La boucle avance par lots de 64. Avec 600 images, cela donne neuf lots complets et un dernier lot de 24. Le code additionne les erreurs au carré, puis divise par 600 × 32 × 32 = 614 400 valeurs de pixel. Il ne fait pas une moyenne des moyennes de lots, qui donnerait trop de poids au dernier lot plus petit.
Le .double() convertit les erreurs au carré avant leur somme ; il ne transforme pas tout le réseau en un modèle calculant en double précision. Enfin, model.train() remet le réseau en mode entraînement.
Les constantes 600, 32 et 32 appartiennent au protocole. Si vous changez la taille de la validation ou des images dans une autre expérience, ce calcul devra évoluer avec les données. Dans le parcours de référence, gardez-les inchangées.
Installer et vérifier l'environnement
Extrayez l'archive, puis ouvrez un terminal à sa racine. Toutes les commandes suivantes partent de ce même répertoire. Utilisez une extraction dédiée à l'expérience pour ne pas mélanger ses fichiers avec ceux d'un autre projet.
Commencez par préparer les dossiers, vérifier Compose, construire les images et tester l'environnement :
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prépare le projet. docker compose config --quiet vérifie la configuration Compose sans l'afficher ; une absence de sortie n'est donc pas, à elle seule, une anomalie. build acquire gpu construit les deux services nommés.
acquire vérifie les verrous du projet. Aucun modèle préentraîné n'est téléchargé dans ce tutoriel : les masques seront générés par prepare, et le réseau sera entraîné dans le parcours. Ne transposez pas ici l'étape d'acquisition de poids d'un tutoriel de modèle de langage.
check_environment.py doit confirmer que le GPU est réellement utilisable depuis le conteneur. La commande pytest lance ensuite les tests du projet. Corrigez toute erreur avant l'entraînement ; les résultats de génération ne permettraient pas de réparer un contrôle d'environnement manquant.
Préparez maintenant les images, puis inspectez leur transformation par le bruit :
docker compose run --rm gpu python -m mask_diffusion.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli inspect-noise --config configs/minimum.yaml
Après prepare, les ensembles annoncés sont 3 000 masques d'entraînement, 600 de validation et 600 de test. inspect-noise permet d'observer le trajet aller. À ce stade, regardez comment une forme connue devient un état bruité ; vous n'observez pas encore la capacité du modèle à générer une forme.
Entraîner, reprendre et évaluer
Exécuter le parcours de référence
Nous vérifions d'abord les dimensions et les gradients du U-Net, puis nous entraînons le modèle. Les gradients sont utiles ici pour contrôler que le calcul permet effectivement de faire évoluer ses paramètres ; voir une image en sortie ne suffirait pas à l'établir.
La suite inclut aussi une interruption volontaire et une reprise. Un entraînement de référence complet sert de comparaison à un entraînement arrêté, puis repris. Ce n'est donc pas une consigne d'interrompre manuellement la première commande.
docker compose run --rm gpu python -m mask_diffusion.cli inspect-model --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli train --config configs/minimum.yaml --stop-after 1000 --run-name interrupted
docker compose run --rm gpu python -m mask_diffusion.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m mask_diffusion.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli sample --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli evaluate --config configs/minimum.yaml
inspect-model précède les calculs longs. Le premier train produit l'entraînement de référence. L'appel avec --stop-after 1000 --run-name interrupted crée la branche interrompue. L'appel suivant reprend son checkpoint artifacts/checkpoints/interrupted/state.pt sous le nom resumed. compare-resume confronte les états obtenus.
sample utilise ensuite les modèles pour produire les sorties, et evaluate applique les mesures. Les chiffres présentés ci-dessous sont ceux de la reproduction lecteur validée de la révision r1. Ils ne sont pas des seuils à atteindre en modifiant les réglages jusqu'à obtenir une jolie figure.
Définir ce que chaque mesure peut nous dire
La MSE de validation compare un bruit prédit à un bruit de référence figé. Elle répond à « le réseau prédit-il mieux le bruit sur cet exercice ? ». Elle ne répond pas directement à « la demande d'anneau donne-t-elle un anneau ? ».
La conformité géométrique examine les images produites avec des règles distinctes du réseau. Le projet utilise des contrôles de composantes, de trous et d'aire. Une composante est une zone reliée ; un trou est une zone de fond enfermée dans une forme ; l'aire mesure son étendue selon la règle du validateur.
Pour visualiser ces notions, pensez aux formes idéales, pas à une description exhaustive du classifieur du projet. Un disque est plein, un anneau possède un trou, et une croix comporte des branches. Le nombre de trous seul ne suffit pas à distinguer une croix d'un disque. Les décisions exactes dépendent des règles du validateur, notamment de la façon d'interpréter les pixels intermédiaires. Les seuils ne sont pas détaillés dans les extraits de cet article : il faut les lire dans le code d'évaluation de l'archive, sans en inventer de nouveaux.
La catégorie unknown signifie qu'aucune des trois classes géométriques n'a été attribuée. Elle n'est pas une quatrième réussite. Une image qui paraît vaguement circulaire à l'œil peut donc rester refusée par les critères choisis.
La distance au train, c'est-à-dire au jeu d'entraînement, est la MSE entre une sortie et son masque d'entraînement le plus proche. Ici, on compare des images entre elles ; ce n'est pas la MSE de prédiction du bruit. Une petite distance indique une forte proximité selon cette mesure, mais ne prouve pas, à elle seule, une mémorisation. Inversement, une grande distance ne prouve pas une création intéressante : du bruit sans forme peut être très éloigné des exemples.
Enfin, la diversité concerne la variété des sorties. Elle doit être lue avec la conformité et la proximité aux données d'entraînement. Trois cents sorties différentes mais toutes invalides ne constituent pas un générateur de formes variées utilisables. Le présent article ne fournit pas de valeur chiffrée de diversité ou de distance au train : nous n'en déduirons donc pas une conclusion sur la mémorisation.
Résultats observés
L'entraînement et la reprise fonctionnent dans le parcours mesuré
L'entraînement principal a réalisé 2 000 mises à jour et traité 128 000 exemples avec répétition des images du jeu d'entraînement. Il ne s'agit pas de 128 000 masques distincts : les mêmes images propres peuvent être présentées plusieurs fois, avec des temps et des bruits d'entraînement tirés.
La MSE de validation est passée de 1.1551 à 0.0211. Le réseau a donc progressé sur la tâche effectivement mesurée, la prédiction du bruit de validation.
Deux vérifications portent sur la reprise. Après l'arrêt de l'entraînement au pas 1 000, la reprise a retrouvé les mêmes paramètres, avec une erreur maximale nulle. Le sampler repris à t=50 a lui aussi donné une erreur maximale nulle. Ces égalités concernent les comparaisons réalisées dans ce parcours ; elles ne promettent pas une identité bit à bit sur tout matériel ou toute version logicielle.
Mais aucune campagne ne produit de masque conforme
Le protocole croise deux états du réseau, non entraîné et entraîné, avec trois poids de guidance. Cela donne six campagnes de 300 échantillons chacune. Le tableau développe cette répartition sans ajouter de nouvelles mesures :
| État du réseau | Guidance | Conformité géométrique | Sorties classées unknown |
|---|---|---|---|
| Non entraîné | w=0 |
0/300 |
300 |
| Non entraîné | w=1 |
0/300 |
300 |
| Non entraîné | w=3 |
0/300 |
300 |
| Entraîné | w=0 |
0/300 |
300 |
| Entraîné | w=1 |
0/300 |
300 |
| Entraîné | w=3 |
0/300 |
300 |
« Non entraîné » et « non conditionnel » ne désignent pas la même chose. Le premier décrit l'état des poids ; le second décrit l'absence de classe lors d'une prédiction. Le réseau entraîné peut donc être utilisé en branche non conditionnelle avec w=0.
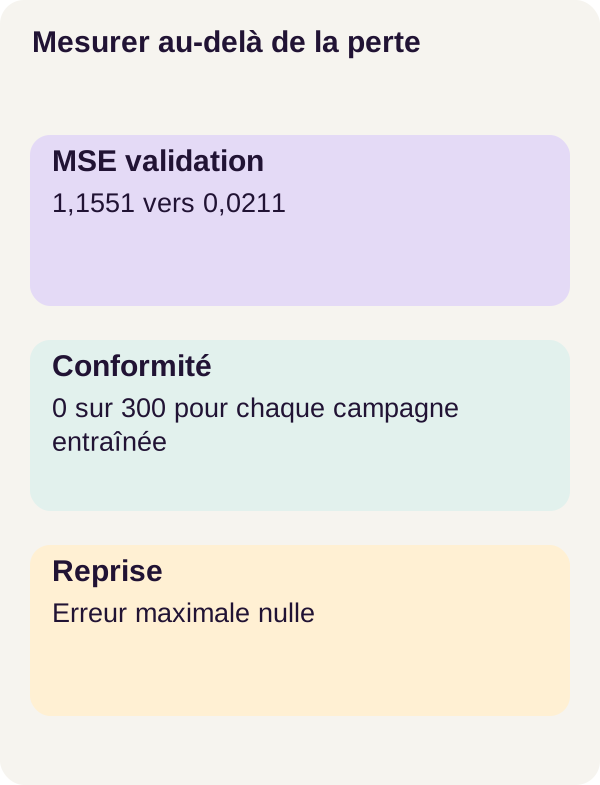
Les 300 sorties de chaque campagne ont toutes été classées unknown. La baisse de la MSE n'est donc pas une preuve que les générations respectent la forme demandée. Il serait trompeur de présenter uniquement la courbe de perte, ou de sélectionner quelques images visuellement favorables pour annoncer un générateur réussi.
Ce que nous avons appris
Une bonne réponse à une sous-tâche n'est pas encore un bon résultat final
Pour un développeur web, l'analogie est celle d'une fonction dont les tests unitaires progressent alors que le parcours utilisateur complet reste en échec. Les deux observations ne se contredisent pas : elles ne portent pas sur le même niveau du système.
Ici, la perte mesure une moyenne d'erreurs numériques sur le bruit. La génération enchaîne des pas de calcul ; l'évaluation finale exige une forme dont les propriétés sont acceptées. Ces trois objets doivent rester distincts.
À titre d'illustration, et non de diagnostic de cette expérience, une petite rupture dans le bord d'un anneau peut changer l'existence de son trou. Quelques pixels peuvent donc faire basculer un critère géométrique, alors qu'une erreur moyenne évolue peu. Cela aide à comprendre pourquoi le score d'une tâche numérique ne se convertit pas automatiquement en conformité géométrique.
Reproduire un échec reste une information utile
Le mécanisme de diffusion, les identités de guidance et la conservation de l'état de reprise sont vérifiés dans le parcours rapporté. Les règles géométriques montrent simultanément une limite nette : cette configuration ne produit pas les petits masques conformes recherchés.
Une reprise identique démontre que le calcul a pu être poursuivi de manière cohérente dans les conditions du test. Elle ne démontre pas que le résultat est bon. De même, un poids de guidance supérieur ne corrige pas automatiquement une génération inadéquate.
Les mesures agrégées ne permettent pas d'attribuer l'échec à une cause unique. Dire « il suffit d'entraîner plus longtemps » ou « le validateur est forcément trop strict » dépasserait ce qui a été établi. Ce sont éventuellement des hypothèses à examiner séparément, avec leurs propres contrôles, pas des corrections déjà validées.
Exercice : émettre l'hypothèse avant la commande
Avant d'exécuter quoi que ce soit, calculez guidance(u, c, 0) et guidance(u, c, 1) avec des valeurs de votre choix. Vérifiez aussi ce qui arrive quand u et c sont égaux : le poids peut-il encore modifier la combinaison ?
Formulez ensuite une hypothèse : passer de w=1 à w=3, à bruit initial identique, conservera-t-il, diminuera-t-il ou déplacera-t-il la diversité ? Notez ce qui relève d'une certitude algébrique, comme les identités aux poids 0 et 1, et ce qui relève d'une prévision sur les sorties du réseau.
Lancez maintenant l'exercice fourni :
docker compose run --rm gpu python -m mask_diffusion.cli exercise --config configs/exercise.yaml
La sortie contrôle les identités limites, garde le même bruit initial et rapporte les métriques de w=1 et w=3. Elle ne promet aucune amélioration.
Comparez ces observations à votre hypothèse. Pour interpréter une différence comme un effet du poids seul, pensez aussi à l'état du générateur des bruits intermédiaires, pas seulement au bruit de départ. Enfin, ne remplacez pas « plus de variations visibles » par « davantage de formes valides » : une diversité utile doit respecter les critères de la tâche.
Adapter et produire
Avant de transformer cette expérience en application, il faut d'abord traiter sa limite de génération. Ajouter une API autour du modèle ne rendrait pas les masques plus conformes.
Une expérience supplémentaire, distincte de r1, pourrait examiner une seule hypothèse à la fois : par exemple, étudier l'effet de la durée d'entraînement en conservant les données, le calendrier et le validateur. Il faudrait garder les sorties de référence, documenter le changement et mesurer de nouveau bruit, conformité et diversité. Aucun résultat de cette variante n'est annoncé ici. Modifier les règles d'acceptation après avoir vu les images définirait une autre tâche, pas une amélioration démontrée de l'ancien modèle.
Pour un usage réel, les masques synthétiques devraient être remplacés par des données autorisées et versionnées, avec des annotations et des critères métier explicites. Les défaillances devraient être mesurées par population pertinente : type d'image, classe ou condition d'acquisition, selon le besoin. Il faudrait également suivre la dérive, c'est-à-dire l'évolution des données ou des résultats après le déploiement.
La gestion des droits, l'authentification, la protection de l'API, l'observabilité, les sauvegardes, la charge et une politique de rejet restent à construire. Une perte stable ne couvre aucune de ces exigences. Le tutoriel fournit une expérience mesurable, pas un service prêt à recevoir des images métier.
Dépannage et nettoyage
Si le contrôle GPU échoue, vérifiez le pilote et l'installation du NVIDIA Container Toolkit, puis relancez check_environment.py avec la commande présentée plus haut. Une carte visible sur l'hôte mais inaccessible dans le conteneur signale d'abord un problème d'intégration Docker/GPU, pas une raison de modifier le U-Net.
Si un contrôle de fichier ou de checkpoint échoue, conservez son message et vérifiez que les fichiers appartiennent à la même exécution et à la même configuration. Ne contournez pas un échec d'intégrité avec un checkpoint externe non identifié.
Si la perte baisse alors que la conformité reste à zéro, vous n'avez pas nécessairement mal lancé le programme : c'est précisément la limite observée dans cette révision. Examinez les états et les mesures sans transformer une attente de réussite en résultat annoncé.
Pour produire les figures, vérifier les checkpoints, prévisualiser le nettoyage puis arrêter les services, utilisez les commandes du parcours :
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
plot.py produit les figures ; il ne constitue pas un nouvel entraînement. check_checkpoints.py contrôle les checkpoints. L'option --dry-run signifie que le nettoyage est seulement prévisualisé : elle n'efface pas les fichiers générés.
Enfin, docker compose down --remove-orphans arrête et retire les ressources concernées du projet Compose. Les fichiers locaux sont conservés dans ce parcours. Il n'est pas nécessaire d'effectuer une purge Docker globale, qui toucherait d'autres expériences.
Sources primaires et documentation
Les résultats de cet article sont ceux de la reproduction r1 du projet téléchargeable. Les références suivantes servent à approfondir les mécanismes et les précautions ; elles ne constituent pas une validation indépendante de ses sorties.
Diffusion et architecture. Ho, Jain et Abbeel — Denoising Diffusion Probabilistic Models décrit le cadre DDPM. Ho et Salimans — Classifier-Free Diffusion Guidance présente la combinaison des prédictions avec et sans condition ; attention à la convention de poids expliquée plus haut. Nichol et Dhariwal — Improved Denoising Diffusion Probabilistic Models présente notamment le calendrier cosinus. Le site des auteurs de U-Net explique l'architecture d'origine.
Calcul et reprise. La documentation PyTorch distingue mode d'évaluation et suivi des gradients, expose les limites de reproductibilité et documente le chargement avec torch.load. Ces pages générales ne remplacent pas les versions et les réglages conservés dans l'archive.
Environnement. La documentation Docker Compose — support GPU et le guide d'installation NVIDIA Container Toolkit détaillent l'accès à la carte depuis les conteneurs.
Télécharger l'archive et suivre le parcours complet : ouvrir le tutoriel.