





Immaginate un piccolo strumento grafico con tre scelte: disco, anello e croce. Selezionate «anello», poi richiedete una nuova immagine. Per disegnare semplicemente questa forma in un'applicazione web basterebbero alcune regole geometriche o un SVG. Ma come potrebbe una rete neurale imparare a produrla partendo soltanto da un'immagine di rumore?
È la domanda di questo tutorial. Creeremo esempi di cui conosciamo la costruzione, addestreremo un piccolo modello di diffusione, quindi osserveremo ciò che ha davvero imparato. Il programma fornito è un percorso Python da riga di comando, non un'interfaccia grafica: le tre forme sono il terreno dell'esperimento.
Il risultato va dichiarato fin dall'inizio: il modello impara a predire meglio il rumore, ma questa configurazione non produce alcuna maschera accettata dai criteri geometrici del progetto. Non è un dettaglio da nascondere dietro una curva in discesa. È proprio ciò che permette di distinguere un addestramento che avanza da un generatore che soddisfa il bisogno.
Scaricare l'archivio del tutorial.
Cosa costruiamo
Costruiamo una diffusione condizionata su immagini di 32 × 32 pixel. «Condizionata» significa che la rete riceve un'informazione aggiuntiva: la classe richiesta, disco, anello o croce. Non le trasmettiamo una descrizione in francese; qui la condizione è un identificatore di classe.
Le immagini sono maschere: ogni pixel stima quale frazione della sua superficie appartiene alla forma. Un pixel interamente esterno vale 0, uno interamente interno vale 1 e un pixel attraversato dal bordo può assumere un valore intermedio. C'è un solo canale, non tre canali rosso, verde e blu.
Il percorso separa tre operazioni. Durante l'addestramento, partiamo da maschere note, aggiungiamo rumore noto e modifichiamo i parametri della rete affinché impari a predirlo. Durante la generazione, manteniamo fissi quei parametri e partiamo dal rumore per costruire gradualmente un'immagine. Durante la valutazione, regole esterne alla rete verificano gli output.
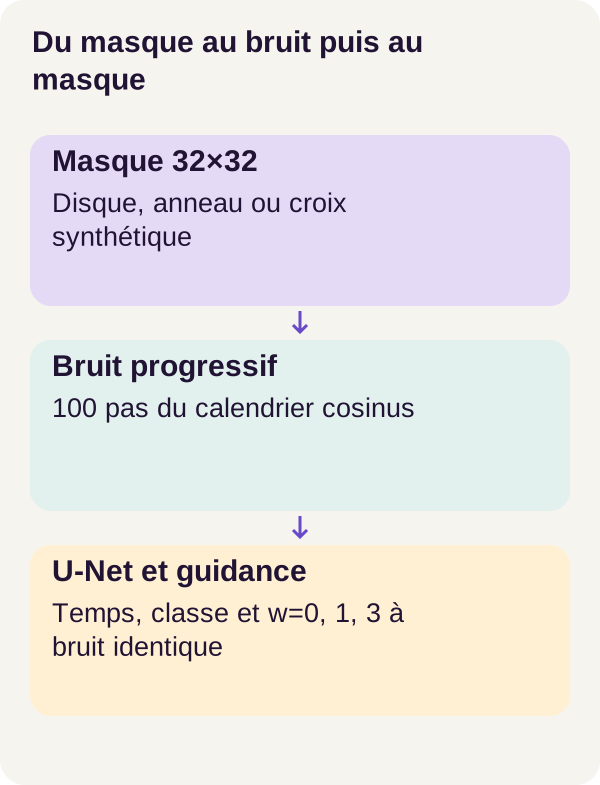
La rete è una U-Net, di cui spiegheremo il ruolo. Impara anche a lavorare senza una classe specificata grazie a una condizione speciale chiamata classe nulla. Potremo così confrontare le sue predizioni con e senza indicazione della forma e combinarle mediante la guidance senza classificatore.
Il caso è volutamente sintetico: non produce né fotografie né disegni industriali. Il suo interesse è altrove. Un anello deve in particolare conservare un foro; un disco non deve trasformarsi in pezzi isolati. Queste proprietà permettono di porre domande concrete sui risultati, oltre a «questa immagine sembra interessante».
Concetti da tenere presenti
Un'immagine rumorosa resta una matrice di numeri
Un tensore è una matrice di numeri con una o più dimensioni. Per la nostra maschera, 1 × 32 × 32 significa un canale, altezza 32 e larghezza 32. Un lotto di immagini aggiunge una dimensione iniziale: numero di immagini, canale, altezza, larghezza.
Anche il rumore gaussiano è una matrice, con un valore casuale per pixel. «Gaussiano» descrive la distribuzione di questi valori: si concentrano attorno a zero, con più valori piccoli che estremi. Questo rumore non è né un errore di file né un'immagine scaricata male. Lo aggiungiamo volontariamente e conserviamo i valori estratti per sapere cosa la rete deve predire.
Nei calcoli della rete, i pixel puliti passano da [0, 1] a [-1, 1] con x * 2 - 1. Quindi 0 diventa -1, 0.5 diventa 0 e 1 resta 1. Il rumore e gli stati rumorosi non sono invece limitati a questo intervallo.
Il percorso in avanti: aggiungere una difficoltà nota
La diffusione diretta trasforma una maschera pulita, indicata con x0, in una maschera rumorosa xt. L'indice t indica il livello di diffusione scelto, non una durata in secondi.
La formula usata è:
xt = √ᾱt x0 + √(1 − ᾱt) ε
La si può leggere senza iniziare da una dimostrazione: una parte dell'immagine pulita, più una parte di rumore. ε, la lettera greca «epsilon», indica il rumore estratto. ᾱt, «alpha barra al passo t», regola la quantità di segnale conservata. Le radici quadrate determinano i coefficienti effettivamente applicati.
Prendiamo un esempio di calcolo inventato, su un solo valore, senza rapporto con un output misurato del modello. Con x₀ = 1, ᾱₜ = 0.64 e ε = -0.5, otteniamo:
xₜ = 0.8 × 1 + 0.6 × (-0.5) = 0.5.
Il risultato non si ottiene cancellando il 36% dei pixel. Ogni valore viene trasformato dalla combinazione. I coefficienti non sono nemmeno due opacità la cui somma dovrebbe valere 1.
Un calendario del rumore, o noise schedule, stabilisce l'evoluzione di questi coefficienti. Quello del progetto è un calendario coseno di 100 passi. È definito dal programma; non viene appreso con i pesi della rete. Il principio del calendario coseno è presentato in Improved Denoising Diffusion Probabilistic Models. Questa fonte spiega la famiglia del calendario senza sostituire i parametri del progetto.
Cosa impara davvero la rete
Durante l'addestramento, la rete riceve l'immagine rumorosa, il passo t e la classe. Deve restituire il rumore stimato, non direttamente un disco o un anello finito. Conosciamo la risposta corretta perché abbiamo estratto noi stessi il rumore ε.
La perdita, o loss, misura lo scarto fra questa predizione e il rumore iniettato. Qui è la MSE, mean squared error, o errore quadratico medio: si calcolano le differenze, si elevano al quadrato e se ne fa la media.
Un secondo esempio didattico, limitato a due valori, basta per seguire il calcolo. Il rumore reale vale [0.2, -0.4] e la rete predice [0.1, -0.2]. Gli scarti al quadrato valgono 0.01 e 0.04, quindi la MSE vale (0.01 + 0.04) / 2 = 0.025. Un errore doppio contribuisce quattro volte di più alla perdita.
I pesi sono i numeri regolabili della rete. I gradienti indicano come una variazione di tali numeri influisce sulla perdita; l'ottimizzatore li usa per aggiornare i pesi. Non codifichiamo dunque nella rete una regola «disegnare un anello»: ne regoliamo i pesi a partire da esempi rumorosi e dalle loro risposte attese.
Attenzione ai due significati di «passo». I 100 passi di diffusione descrivono i livelli di rumore e il percorso di generazione. I 2 000 aggiornamenti citati più avanti descrivono l'addestramento dei pesi. Non sono due modi di contare lo stesso ciclo.
Perché una U-Net?
La U-Net applica convoluzioni, cioè filtri appresi che combinano valori vicini. Il suo percorso discendente riduce la risoluzione per aggregare l'informazione; quello ascendente ritrova una risoluzione fine. Connessioni fra i due percorsi reintroducono dettagli spaziali. Il sito degli autori di U-Net presenta questa architettura a due percorsi.
In src/mask_diffusion/unet.py, ConditionalUNet.forward() combina una rappresentazione numerica del tempo e della classe, poi la fornisce ai blocchi della rete. Il tempo indica a quale livello di rumore sta lavorando. La classe indica quale famiglia di maschere è richiesta.
Il suo output ha la stessa forma dell'immagine rumorosa: una stima del rumore per ogni pixel. È poi il programma di campionamento a usare tale stima per calcolare lo stato successivo. Questa distinzione fra rete e calcolo che la circonda è centrale in DDPM.
Una condizione non è una garanzia
La classe nulla significa «nessuna classe specificata». Non è né una quarta forma da disegnare né un'istruzione per produrre un'immagine vuota. La stessa rete deve poter fornire una stima condizionata e una non condizionata.
Il principio della Classifier-Free Diffusion Guidance è imparare anche senza condizione, rimuovendola per una parte degli esempi, quindi combinare le due stime nella generazione. Non occorre aggiungere un classificatore separato per calcolare questa combinazione. Ciò non elimina ovviamente la necessità di valutare le immagini dopo averle prodotte.
In questo progetto la combinazione è εu + w(εc − εu), dove u indica la predizione non condizionata e c quella condizionata. La leggeremo nel codice: w=0 conserva u, w=1 conserva c. Un valore maggiore non promette un'immagine migliore.
Prerequisiti Docker e GPU
Dovete saper leggere funzioni Python, manipolare matrici ed eseguire comandi in un terminale. Sono necessarie le basi di Docker; non è richiesta alcuna conoscenza preliminare dei modelli di diffusione.
Il percorso richiede Linux x86_64, Docker Compose, NVIDIA Container Toolkit, una RTX 3090 da 24 GiB, 16 GiB di RAM e 16 GiB di spazio disco disponibile, escluse le immagini Docker condivise. Sono le risorse indicate per questo tutorial, non una dimostrazione di compatibilità con ogni hardware.
Qui la GPU, la scheda grafica, esegue i calcoli della rete con CUDA. Una scheda visibile a Linux può tuttavia essere inaccessibile a Docker. Il controllo fornito non si limita quindi a elencare un dispositivo: inizializza CUDA nel contenitore ed esegue un calcolo. L'eventuale selezione avviene prima del percorso con export GPU_DEVICE=0, oppure con l'UUID della scheda, il suo identificatore univoco.
Il calcolo è isolato dalla rete. I contenitori usano un filesystem di sola lettura, no-new-privileges, la rimozione delle capacità Linux e limiti di CPU, RAM e numero di processi. Queste restrizioni delimitano l'esecuzione; non dimostrano la qualità delle immagini. Non confondete neppure calcolo isolato e installazione completamente offline: la costruzione delle immagini Docker e l'acquisizione delle dipendenze possono richiedere accesso alla rete.
Un checkpoint è un salvataggio che permette di conservare o riprendere uno stato di calcolo. Gli artefatti Torch prodotti localmente devono restare affidabili: non caricate un checkpoint di terzi arbitrario per sostituire un file mancante. La documentazione di torch.load richiama le precauzioni di caricamento.
Dati di cui conosciamo la costruzione
Creare un riferimento prima di chiedere al modello di imparare
Per il nostro esperimento non dobbiamo raccogliere immagini su Internet. Sappiamo definire disco, anello e croce tramite regole geometriche. La funzione seguente crea gli esempi di addestramento; non è il generatore neurale che valuteremo in seguito.
Riceve un identificatore label, un centro, un raggio, uno spessore e un angolo. Gli identificatori 0, 1 e 2 designano rispettivamente disco, anello e croce.
def render_mask(label, center=(0.0, 0.0), radius=0.55, thickness=0.18, angle=0.0):
    # Four subpixels in each direction; occupation fraction is the antialiased pixel.
    axis = (np.arange(128) + 0.5) / 64 - 1
    x, y = np.meshgrid(axis - center[0], axis - center[1])
    u = x * np.cos(angle) + y * np.sin(angle)
    v = -x * np.sin(angle) + y * np.cos(angle)
    distance = np.sqrt(x * x + y * y)
    if label == 0:
        inside = distance <= radius
    elif label == 1:
        inside = (distance <= radius) & (distance >= radius - thickness)
    elif label == 2:
        inside = ((abs(u) <= radius) & (abs(v) <= thickness / 2)) | (
            (abs(v) <= radius) & (abs(u) <= thickness / 2)
        )
    else:
        raise ValueError("Unknown geometric class")
    return inside.reshape(32, 4, 32, 4).mean((1, 3)).astype("float32")[None]
Cosa ha appena fatto questa funzione?
axis colloca i centri di 128 piccoli intervalli fra -1 e 1. meshgrid costruisce le coordinate di una griglia di 128 × 128 posizioni. Sottrarre center permette di spostare la forma senza cambiarne le regole. Le coordinate u e v applicano la rotazione usata per costruire la croce.
Per il disco, ogni posizione è interna se la distanza dal centro non supera radius. Per l'anello, tale distanza deve anche essere almeno radius - thickness: il centro resta vuoto. Per la croce, il programma riunisce due rettangoli perpendicolari. Un identificatore di classe sconosciuto provoca un errore invece di scegliere una forma predefinita.
Perché una griglia di 128 × 128 se l'output è 32 × 32? Per l'antialiasing, che riduce l'effetto a scalini sui contorni. Ogni pixel finale è rappresentato da quattro sottopixel in ogni direzione, dunque 16 sottopixel. reshape(32, 4, 32, 4).mean((1, 3)) calcola la loro occupazione media.
Per esempio, 12 sottopixel interni su 16 danno 0.75. Questo grigio non è una predizione incerta: rappresenta una frazione di superficie nel nostro metodo di rendering. L'antialiasing appartiene quindi ai dati stessi, non a un ritocco applicato dopo la valutazione.
Infine, astype("float32") sceglie un formato numerico a 32 bit. [None] aggiunge la dimensione del canale. Otteniamo una matrice 1 × 32 × 32, senza dimensione di lotto a questo stadio.
Separare i dati prima dell'addestramento
La preparazione produce tre insiemi equilibrati. La tabella seguente esplicita le quantità del progetto; le quantità per classe derivano da questo equilibrio.
| Insieme | Numero di maschere | Maschere per classe | Ruolo |
|---|---|---|---|
| Addestramento | 3 000 | 1 000 | Fornire gli esempi usati per modificare i pesi. |
| Validazione | 600 | 200 | Misurare la perdita su esempi separati dall'addestramento. |
| Test | 600 | 200 | Conservare un insieme distinto per la valutazione prevista dal progetto. |
Ogni partizione usa un seme diverso per le sue estrazioni pseudocasuali. Un seme inizializza un generatore; non è un'annotazione d'immagine. Ogni immagine viene inoltre sottoposta a hash e ogni duplicato è rifiutato prima di fissare gli insiemi.
L'hash produce un'impronta del contenuto. Consente di rilevare contenuti identici, non di garantire che due forme diverse non siano mai molto simili. In un piccolo universo di dischi, anelli e croci, questa sfumatura conta. La classe nulla non aggiunge una quarta categoria di maschere alla tabella: interviene nel modo di condizionare la rete.
Il codice centrale: imparare il rumore, poi guidare il ritorno
Generare non significa ridisegnare geometricamente
Il sampler, o programma di campionamento, parte da uno stato rumoroso e calcola gli stati successivi nell'ordine inverso della diffusione. Qui chiama il modello due volte a ogni passo, combina i due rumori predetti e aggiunge un nuovo rumore gaussiano, salvo all'ultimo passo.
Non consulta render_mask() per recuperare la forma attesa. Deve produrre un'immagine a partire da ciò che la rete ha appreso.
def guidance(unconditional, conditional, weight):
    return unconditional + weight * (conditional - unconditional)


def reverse_step(x, epsilon, t, schedule, noise):
    beta = schedule["beta"][t].to(x.device)
    alpha = schedule["alpha"][t].to(x.device)
    abar = schedule["abar"][t].to(x.device)
    previous = schedule["abar"][t - 1].to(x.device)
    mean = (x - beta * epsilon / (1 - abar).sqrt()) / alpha.sqrt()
    variance = beta * (1 - previous) / (1 - abar)
    return mean if t == 1 else mean + variance.sqrt() * noise


@torch.no_grad()
def ancestral_sample(
    model, initial, labels, weight, schedule, generator, start=None, stop=0
):
    x = initial.clone()
    trajectory = [x[0].cpu()]
    start = start or len(schedule["beta"]) - 1
    for t in range(start, stop, -1):
        times = torch.full((len(x),), t, device=x.device, dtype=torch.long)
        u = model(x, times, torch.full_like(labels, NULL_CLASS))
        c = model(x, times, labels)
        eps = guidance(u, c, weight)
        noise = (
            torch.randn(x.shape, device=x.device, generator=generator)
            if t > 1
            else torch.zeros_like(x)
        )
        x = reverse_step(x, eps, t, schedule, noise)
        trajectory.append(x[0].cpu())
    assert torch.isfinite(x).all()
    return x, torch.stack(trajectory)
Leggere la guidance con tre numeri
La prima funzione applica esattamente la formula annunciata: unconditional + weight * (conditional - unconditional).
Prendiamo un esempio aritmetico fittizio su un solo valore di rumore, con u = 0.2 e c = 0.5. Non sono output catturati dal modello.
| Peso del progetto | Calcolo | Risultato | Significato dell'operazione |
|---|---|---|---|
w=0 |
0.2 + 0 × (0.5 - 0.2) |
0.2 |
Conservare la predizione non condizionata. |
w=1 |
0.2 + 1 × (0.5 - 0.2) |
0.5 |
Conservare la predizione condizionata. |
w=3 |
0.2 + 3 × (0.5 - 0.2) |
1.1 |
Prolungare la differenza oltre la predizione condizionata. |
w=3 è un'estrapolazione, non una miscela al 75% / 25%. Il valore 1.1 non significa «110% di fiducia»: manipoliamo una stima di rumore, non una probabilità. Se i due rami restituiscono esattamente la stessa stima, la loro differenza è nulla e cambiare w non modifica la combinazione.
Una trappola di notazione nelle fonti. L'articolo di Ho e Salimans scrive la combinazione come
(1 + w_article) × c - w_article × u. La convenzione del nostro codice corrisponde aw_projet = 1 + w_article. Tenete dunque insieme valori e formula del progetto: ilw=0di questo tutorial designa il ramo non condizionato, mentre quello della formula dell'articolo designa il ramo condizionato.
Leggere un passo di ritorno senza perdere il filo
reverse_step() riceve lo stato corrente x, il rumore predetto epsilon e il numero del passo. Il calendario fornisce beta, alpha e abar. In questa notazione di diffusione, alpha corrisponde a 1 - beta e abar al prodotto degli alpha fino al passo considerato. previous recupera il valore cumulato al passo precedente.
La riga mean = ... corregge lo stato a partire dal rumore predetto e dai coefficienti del calendario. La riga variance = ... regola l'ampiezza del rumore casuale usato per estrarre lo stato successivo. Il rumore predetto epsilon e il rumore appena estratto noise non hanno dunque lo stesso ruolo. Il primo proviene dalla rete; il secondo mantiene una fase casuale in questo sampler.
Il ritorno include questo nuovo rumore per t > 1. A t == 1, la funzione restituisce soltanto mean. Aggiungere rumore durante il ritorno può sembrare paradossale, ma il programma non riavvolge la storia esatta di un'immagine particolare: costruisce una traiettoria di generazione secondo la regola di campionamento.
Seguire il ciclo e ciò che conserva
initial.clone() crea uno stato di lavoro senza sovrascrivere la matrice fornita dal chiamante. A ogni passo, times contiene lo stesso indice t per tutte le immagini del lotto. Le chiamate u = model(...) e c = model(...) usano la stessa rete, prima con una classe nulla poi con le classi richieste.
In questo estratto le due chiamate avvengono anche con w=0 o w=1: il codice non prevede una scorciatoia per questi valori. Per un percorso completo di 100 passi, ciò rappresenta 200 chiamate alla rete per lotto, non 200 aggiornamenti dei pesi.
Il decoratore @torch.no_grad() disabilita il tracciamento dei gradienti durante questa generazione. Non ci sono qui né calcolo della perdita di addestramento né aggiornamento dell'ottimizzatore. Questo decoratore non sostituisce tuttavia un eventuale model.eval(): PyTorch distingue la modalità di valutazione dal tracciamento dei gradienti. L'estratto non mostra come il chiamante prepari la modalità della rete.
Osservate anche trajectory.append(x[0].cpu()). La traiettoria conserva solo la prima immagine del lotto, sulla CPU. Il valore finale x, invece, contiene tutte le immagini del lotto. Con una partenza a 100 e stop=0, il ciclo tratta 100, 99, …, 1 e la traiettoria contiene lo stato iniziale più i 100 stati calcolati, cioè 101 stati.
L'asserzione finale torch.isfinite(x).all() richiede valori numerici finiti: né NaN né infinito. Non verifica né i contorni né i fori, e neppure che i valori restino in [0, 1]. Una matrice numericamente valida non è ancora una forma valida.
Stesso rumore iniziale: necessario, ma non tutta la storia
Il protocollo confronta w=0, w=1 e w=3 con rumore iniziale identico. È indispensabile per non attribuire al peso di guidance una differenza creata fin dall'inizio.
Ma il ciclo estrae anche nuovi rumori con generator. Per isolare completamente l'effetto di w in un confronto appaiato, occorre ritrovare anche la stessa sequenza di estrazioni intermedie. Il sampler riceve questo generatore; non lo reinizializza da solo. Due chiamate successive con lo stesso oggetto generatore possono quindi consumare due porzioni diverse della sua sequenza.
Questa precisazione deriva dal codice mostrato: conservare initial non basta, da solo, a stabilire il controllo di tutte le estrazioni. L'inizializzazione e il salvataggio del generatore dipendono dal codice chiamante nel progetto completo.
La stessa questione appare alla ripresa. Con start=100 e stop=50, il ciclo tratta i passi da 100 a 51 e restituisce lo stato al livello 50. Riprendere da questo stato con start=50 richiede di ritrovare anche lo stato casuale corrispondente, oltre allo stesso modello e allo stesso calendario. La documentazione PyTorch sulla riproducibilità spiega perché fissare un seme non garantisce da solo risultati identici in tutti gli ambienti.
Misurare l'apprendimento con un esercizio di validazione fissato
Durante l'apprendimento, il programma estrae un tempo, aggiunge ε e minimizza l'errore di predizione di ε. Per confrontare due stati della rete, la validazione seguente usa invece tempi e rumori fissati in anticipo. È l'equivalente di usare gli stessi dati di test dopo ogni modifica a un'applicazione.
def validation_mse(model, config):
    assert (
        sha("outputs/validation-noise.npz")
        == read_json("outputs/validation-lock.json")["sha256"]
    )
    data = np.load("outputs/validation.npz")
    fixed = np.load("outputs/validation-noise.npz")
    total = 0.0
    model.eval()
    with torch.no_grad():
        for i in range(0, 600, 64):
            x = torch.from_numpy(data["images"][i : i + 64]).cuda() * 2 - 1
            t = torch.from_numpy(fixed["times"][i : i + 64]).cuda()
            eps = torch.from_numpy(fixed["noise"][i : i + 64]).cuda()
            y = torch.from_numpy(data["labels"][i : i + 64]).cuda()
            noisy = sample_noisy_image(
                x, t, eps, cosine_schedule(config["diffusion_steps"])
            )
            total += float((model(noisy, t, y) - eps).square().double().sum())
    model.train()
    return total / (600 * 32 * 32)
L'asserzione iniziale confronta l'impronta SHA-256 di outputs/validation-noise.npz con quella registrata in outputs/validation-lock.json. Controlla questo file di rumore fissato; non è una verifica universale di tutti i file del progetto.
Il programma carica poi le 600 immagini di validazione, i tempi, i rumori e le classi. .cuda() colloca le matrici sulla GPU. La trasformazione * 2 - 1 applica il cambio di scala delle maschere spiegato sopra.
model.eval() attiva la modalità di valutazione, mentre torch.no_grad() disabilita il tracciamento dei gradienti. Quindi sample_noisy_image() crea ogni input rumoroso. Confrontiamo model(noisy, t, y) con eps, non con l'immagine pulita x: il punteggio riguarda sempre il rumore.
Il ciclo avanza per lotti di 64. Con 600 immagini, ciò dà nove lotti completi e un ultimo lotto di 24. Il codice somma gli errori al quadrato, poi divide per 600 × 32 × 32 = 614 400 valori di pixel. Non fa la media delle medie dei lotti, che darebbe troppo peso all'ultimo lotto più piccolo.
.double() converte gli errori al quadrato prima della somma; non trasforma l'intera rete in un modello che calcola in doppia precisione. Infine, model.train() riporta la rete in modalità di addestramento.
Le costanti 600, 32 e 32 appartengono al protocollo. Se in un altro esperimento cambiate la dimensione della validazione o delle immagini, questo calcolo dovrà evolvere con i dati. Nel percorso di riferimento, lasciatele invariate.
Installare e verificare l'ambiente
Estraete l'archivio, poi aprite un terminale nella sua radice. Tutti i comandi successivi partono da questa stessa directory. Usate un'estrazione dedicata all'esperimento per non mescolare i suoi file con quelli di un altro progetto.
Iniziate preparando le cartelle, verificando Compose, costruendo le immagini e testando l'ambiente:
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prepara il progetto. docker compose config --quiet verifica la configurazione Compose senza visualizzarla; l'assenza di output non è quindi, da sola, un'anomalia. build acquire gpu costruisce i due servizi nominati.
acquire verifica i blocchi del progetto. In questo tutorial non viene scaricato alcun modello preaddestrato: le maschere saranno generate da prepare e la rete verrà addestrata nel percorso. Non trasferite qui la fase di acquisizione dei pesi di un tutorial sui modelli linguistici.
check_environment.py deve confermare che la GPU sia davvero utilizzabile dal contenitore. Il comando pytest esegue poi i test del progetto. Correggete ogni errore prima dell'addestramento; i risultati di generazione non potrebbero riparare un controllo dell'ambiente mancante.
Preparate ora le immagini, quindi ispezionate la loro trasformazione tramite il rumore:
docker compose run --rm gpu python -m mask_diffusion.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli inspect-noise --config configs/minimum.yaml
Dopo prepare, gli insiemi annunciati sono 3 000 maschere di addestramento, 600 di validazione e 600 di test. inspect-noise consente di osservare il percorso in avanti. A questo punto guardate come una forma nota diventa uno stato rumoroso; non state ancora osservando la capacità del modello di generare una forma.
Addestrare, riprendere e valutare
Eseguire il percorso di riferimento
Verifichiamo prima le dimensioni e i gradienti della U-Net, poi addestriamo il modello. I gradienti sono utili qui per controllare che il calcolo permetta davvero di far evolvere i suoi parametri; vedere un'immagine in output non basterebbe a stabilirlo.
La sequenza include anche un'interruzione volontaria e una ripresa. Un addestramento di riferimento completo serve da confronto con un addestramento interrotto, poi ripreso. Non è quindi un'istruzione di interrompere manualmente il primo comando.
docker compose run --rm gpu python -m mask_diffusion.cli inspect-model --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli train --config configs/minimum.yaml --stop-after 1000 --run-name interrupted
docker compose run --rm gpu python -m mask_diffusion.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m mask_diffusion.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli sample --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli evaluate --config configs/minimum.yaml
inspect-model precede i calcoli lunghi. Il primo train produce l'addestramento di riferimento. La chiamata con --stop-after 1000 --run-name interrupted crea il ramo interrotto. La chiamata seguente riprende il suo checkpoint artifacts/checkpoints/interrupted/state.pt con il nome resumed. compare-resume confronta gli stati ottenuti.
sample usa quindi i modelli per produrre gli output e evaluate applica le misure. I numeri presentati qui sotto sono quelli della riproduzione validata dal lettore della revisione r1. Non sono soglie da raggiungere modificando i parametri fino a ottenere una bella figura.
Definire ciò che ogni misura può dirci
La MSE di validazione confronta un rumore predetto con un rumore di riferimento fissato. Risponde a «la rete predice meglio il rumore in questo esercizio?». Non risponde direttamente a «la richiesta di un anello produce un anello?».
La conformità geometrica esamina le immagini prodotte con regole distinte dalla rete. Il progetto usa controlli di componenti, fori e area. Una componente è una zona connessa; un foro è una zona di sfondo racchiusa in una forma; l'area ne misura l'estensione secondo la regola del validatore.
Per visualizzare queste nozioni, pensate alle forme ideali, non a una descrizione esaustiva del classificatore del progetto. Un disco è pieno, un anello ha un foro e una croce ha bracci. Il solo numero di fori non basta a distinguere una croce da un disco. Le decisioni esatte dipendono dalle regole del validatore, in particolare dal modo in cui interpreta i pixel intermedi. Le soglie non sono dettagliate negli estratti di questo articolo: occorre leggerle nel codice di valutazione dell'archivio, senza inventarne di nuove.
La categoria unknown significa che non è stata attribuita nessuna delle tre classi geometriche. Non è un quarto successo. Un'immagine che a occhio sembra vagamente circolare può dunque restare rifiutata dai criteri scelti.
La distanza dal train, cioè dall'insieme di addestramento, è la MSE fra un output e la sua maschera di addestramento più vicina. Qui si confrontano immagini fra loro; non è la MSE di predizione del rumore. Una distanza piccola indica una forte vicinanza secondo questa misura, ma non prova da sola una memorizzazione. Viceversa, una distanza grande non prova una creazione interessante: rumore senza forma può essere molto lontano dagli esempi.
Infine, la diversità riguarda la varietà degli output. Va letta insieme alla conformità e alla vicinanza ai dati di addestramento. Trecento output diversi ma tutti non validi non costituiscono un generatore di forme varie e utilizzabili. Questo articolo non fornisce un valore numerico di diversità o di distanza dal train: non ne dedurremo dunque una conclusione sulla memorizzazione.
Risultati osservati
L'addestramento e la ripresa funzionano nel percorso misurato
L'addestramento principale ha effettuato 2 000 aggiornamenti e trattato 128 000 esempi con ripetizione delle immagini dell'insieme di addestramento. Non si tratta di 128 000 maschere distinte: le stesse immagini pulite possono essere presentate più volte, con tempi e rumori di addestramento estratti.
La MSE di validazione è passata da 1.1551 a 0.0211. La rete è quindi avanzata sul compito effettivamente misurato, la predizione del rumore di validazione.
Due verifiche riguardano la ripresa. Dopo l'arresto dell'addestramento al passo 1 000, la ripresa ha ritrovato gli stessi parametri, con un errore massimo nullo. Anche il sampler ripreso a t=50 ha dato un errore massimo nullo. Queste uguaglianze riguardano i confronti svolti in questo percorso; non promettono un'identità bit per bit su ogni hardware o versione software.
Ma nessuna campagna produce una maschera conforme
Il protocollo incrocia due stati della rete, non addestrata e addestrata, con tre pesi di guidance. Ne derivano sei campagne di 300 campioni ciascuna. La tabella sviluppa questa ripartizione senza aggiungere nuove misure:
| Stato della rete | Guidance | Conformità geometrica | Output classificati unknown |
|---|---|---|---|
| Non addestrata | w=0 |
0/300 |
300 |
| Non addestrata | w=1 |
0/300 |
300 |
| Non addestrata | w=3 |
0/300 |
300 |
| Addestrata | w=0 |
0/300 |
300 |
| Addestrata | w=1 |
0/300 |
300 |
| Addestrata | w=3 |
0/300 |
300 |
«Non addestrata» e «non condizionata» non designano la stessa cosa. La prima descrive lo stato dei pesi; la seconda l'assenza di classe durante una predizione. La rete addestrata può dunque essere usata nel ramo non condizionato con w=0.
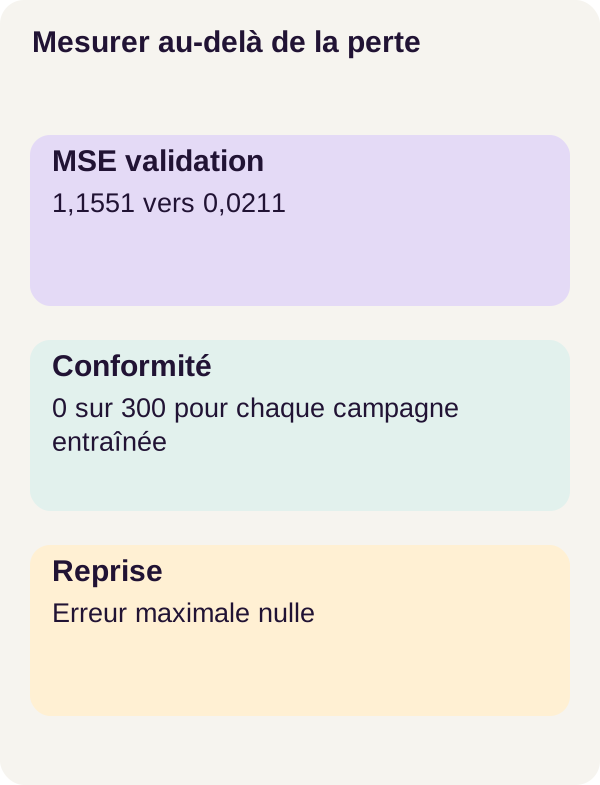
Tutti i 300 output di ogni campagna sono stati classificati unknown. La diminuzione della MSE non dimostra dunque che le generazioni rispettino la forma richiesta. Sarebbe fuorviante presentare soltanto la curva della perdita, o selezionare qualche immagine visivamente favorevole per annunciare un generatore riuscito.
Cosa abbiamo imparato
Una buona risposta a un sottocompito non è ancora un buon risultato finale
Per uno sviluppatore web, l'analogia è quella di una funzione i cui test unitari migliorano mentre il percorso utente completo resta in fallimento. Le due osservazioni non si contraddicono: non riguardano lo stesso livello del sistema.
Qui la perdita misura una media di errori numerici sul rumore. La generazione concatena passi di calcolo; la valutazione finale richiede una forma di cui le proprietà siano accettate. Questi tre oggetti devono restare distinti.
A titolo di illustrazione, non di diagnosi di questa esperienza, una piccola rottura nel bordo di un anello può modificarne l'esistenza del foro. Alcuni pixel possono quindi far cambiare un criterio geometrico, mentre un errore medio evolve poco. Questo aiuta a capire perché il punteggio di un compito numerico non si traduce automaticamente in conformità geometrica.
Riprodurre un fallimento resta un'informazione utile
Il meccanismo di diffusione, le identità di guidance e la conservazione dello stato di ripresa sono verificati nel percorso riportato. Le regole geometriche mostrano contemporaneamente un limite netto: questa configurazione non produce le piccole maschere conformi ricercate.
Una ripresa identica dimostra che il calcolo ha potuto proseguire coerentemente nelle condizioni del test. Non dimostra che il risultato sia buono. Allo stesso modo, un peso di guidance superiore non corregge automaticamente una generazione inadeguata.
Le misure aggregate non permettono di attribuire il fallimento a una causa unica. Dire «basta addestrare più a lungo» o «il validatore è per forza troppo severo» andrebbe oltre quanto è stato stabilito. Sono eventualmente ipotesi da esaminare separatamente, con i loro controlli, non correzioni già validate.
Esercizio: formulare l'ipotesi prima del comando
Prima di eseguire qualsiasi cosa, calcolate guidance(u, c, 0) e guidance(u, c, 1) con valori a vostra scelta. Verificate anche cosa accade quando u e c sono uguali: il peso può ancora modificare la combinazione?
Formulate poi un'ipotesi: passare da w=1 a w=3, a rumore iniziale identico, conserverà, diminuirà o sposterà la diversità? Distinguete ciò che è una certezza algebrica, come le identità ai pesi 0 e 1, da ciò che è una previsione sugli output della rete.
Eseguite ora l'esercizio fornito:
docker compose run --rm gpu python -m mask_diffusion.cli exercise --config configs/exercise.yaml
L'output controlla le identità limite, mantiene lo stesso rumore iniziale e riporta le metriche di w=1 e w=3. Non promette alcun miglioramento.
Confrontate queste osservazioni con la vostra ipotesi. Per interpretare una differenza come effetto del solo peso, pensate anche allo stato del generatore dei rumori intermedi, non solo al rumore di partenza. Infine, non sostituite «più variazioni visibili» con «più forme valide»: una diversità utile deve rispettare i criteri del compito.
Adattare e produrre
Prima di trasformare questa esperienza in un'applicazione, occorre anzitutto affrontarne il limite di generazione. Aggiungere un'API attorno al modello non renderebbe le maschere più conformi.
Un'esperienza aggiuntiva, distinta da r1, potrebbe esaminare una sola ipotesi alla volta: per esempio, studiare l'effetto della durata dell'addestramento conservando dati, calendario e validatore. Bisognerebbe mantenere gli output di riferimento, documentare la modifica e misurare di nuovo rumore, conformità e diversità. Qui non è annunciato alcun risultato di questa variante. Modificare le regole di accettazione dopo aver visto le immagini definirebbe un altro compito, non un miglioramento dimostrato del modello precedente.
Per un uso reale, le maschere sintetiche dovrebbero essere sostituite da dati autorizzati e versionati, con annotazioni e criteri di business espliciti. I fallimenti dovrebbero essere misurati per popolazione pertinente: tipo di immagine, classe o condizione di acquisizione, secondo il bisogno. Andrebbe inoltre seguita la deriva, cioè l'evoluzione dei dati o dei risultati dopo il deployment.
Gestione dei diritti, autenticazione, protezione dell'API, osservabilità, backup, carico e una politica di rifiuto restano da costruire. Una perdita stabile non copre nessuno di questi requisiti. Il tutorial fornisce un'esperienza misurabile, non un servizio pronto a ricevere immagini aziendali.
Risoluzione dei problemi e pulizia
Se il controllo GPU fallisce, verificate il driver e l'installazione di NVIDIA Container Toolkit, poi rieseguite check_environment.py con il comando presentato sopra. Una scheda visibile sull'host ma inaccessibile nel contenitore indica prima di tutto un problema di integrazione Docker/GPU, non una ragione per modificare la U-Net.
Se un controllo di file o checkpoint fallisce, conservate il messaggio e verificate che i file appartengano alla stessa esecuzione e alla stessa configurazione. Non aggirate un fallimento di integrità con un checkpoint esterno non identificato.
Se la perdita diminuisce mentre la conformità resta a zero, non avete necessariamente avviato male il programma: è proprio il limite osservato in questa revisione. Esaminate stati e misure senza trasformare un'attesa di successo in un risultato annunciato.
Per produrre le figure, verificare i checkpoint, visualizzare in anteprima la pulizia e poi arrestare i servizi, usate i comandi del percorso:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
plot.py produce le figure; non costituisce un nuovo addestramento. check_checkpoints.py controlla i checkpoint. L'opzione --dry-run significa che la pulizia viene soltanto visualizzata in anteprima: non cancella i file generati.
Infine, docker compose down --remove-orphans arresta e rimuove le risorse interessate del progetto Compose. I file locali sono conservati in questo percorso. Non è necessario effettuare una pulizia Docker globale, che toccherebbe altri esperimenti.
Fonti primarie e documentazione
I risultati di questo articolo sono quelli della riproduzione r1 del progetto scaricabile. Le fonti seguenti servono ad approfondire i meccanismi e le precauzioni; non costituiscono una validazione indipendente dei suoi output.
Diffusione e architettura. Ho, Jain e Abbeel — Denoising Diffusion Probabilistic Models descrive il quadro DDPM. Ho e Salimans — Classifier-Free Diffusion Guidance presenta la combinazione delle predizioni con e senza condizione; attenzione alla convenzione dei pesi spiegata sopra. Nichol e Dhariwal — Improved Denoising Diffusion Probabilistic Models presenta in particolare il calendario coseno. Il sito degli autori di U-Net spiega l'architettura originale.
Calcolo e ripresa. La documentazione PyTorch distingue modalità di valutazione e tracciamento dei gradienti, espone i limiti della riproducibilità e documenta il caricamento con torch.load. Queste pagine generali non sostituiscono versioni e parametri conservati nell'archivio.
Ambiente. La documentazione Docker Compose — supporto GPU e la guida di installazione NVIDIA Container Toolkit dettagliano l'accesso alla scheda dai contenitori.
Scaricare l'archivio e seguire il percorso completo: aprire il tutorial.