





Imagine una pequeña herramienta gráfica con tres opciones: disco, anillo y cruz. Selecciona «anillo» y solicita una imagen nueva. Para dibujar simplemente esta forma en una aplicación web, bastarían algunas reglas geométricas o un SVG. Pero ¿cómo podría una red neuronal aprender a producirla partiendo únicamente de una imagen de ruido?
Esta es la pregunta de este tutorial. Vamos a fabricar ejemplos cuya construcción conocemos, entrenar un pequeño modelo de difusión y examinar lo que realmente ha aprendido. El programa entregado es un recorrido de Python en línea de comandos, no una interfaz gráfica: las tres formas sirven como terreno de experimentación.
El resultado merece anunciarse desde el principio: el modelo aprende a predecir mejor el ruido, pero esta configuración no produce ninguna máscara aceptada por los criterios geométricos del proyecto. No es un detalle que deba ocultarse tras una curva descendente. Precisamente permite aprender a distinguir un entrenamiento que progresa de un generador que responde a la necesidad.
Descargar el archivo del tutorial.
Lo que vamos a construir
Construimos una difusión condicional sobre imágenes de 32 × 32 píxeles. «Condicional» significa que la red recibe información adicional: la clase solicitada, disco, anillo o cruz. No le transmitimos una descripción en francés; aquí la condición es un identificador de clase.
Las imágenes son máscaras: cada píxel estima qué fracción de su superficie pertenece a la forma. Un píxel completamente exterior vale 0, uno completamente interior vale 1, y uno atravesado por el borde puede tomar un valor intermedio. Solo hay un canal, no tres canales rojo, verde y azul.
El recorrido separa tres operaciones. Durante el entrenamiento, partimos de máscaras conocidas, añadimos un ruido conocido y modificamos los parámetros de la red para que aprenda a predecir ese ruido. Durante la generación, mantenemos fijos esos parámetros y partimos de ruido para construir gradualmente una imagen. Durante la evaluación, reglas externas a la red verifican las salidas.
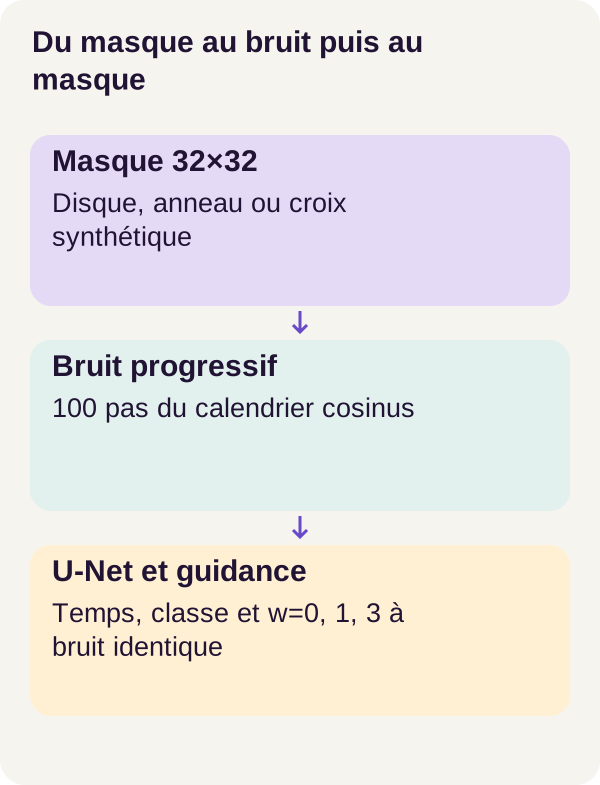
La red es una U-Net, cuyo papel vamos a explicar. También aprende a trabajar sin clase especificada, gracias a una condición especial llamada clase nula. Así podremos comparar sus predicciones con y sin indicación de forma, y combinarlas con la guidance sin clasificador.
El caso es deliberadamente sintético: no produce ni fotografía ni dibujo industrial. Su interés está en otra parte. Un anillo debe, en particular, conservar un agujero; un disco no debe transformarse en fragmentos aislados. Estas propiedades dan preguntas concretas que plantear a los resultados, más allá de «esta imagen parece interesante».
Conceptos que conviene tener presentes
Una imagen ruidosa sigue siendo una matriz de números
Un tensor es una matriz de números de una o más dimensiones. Para nuestra máscara, 1 × 32 × 32 significa un canal, una altura de 32 y una anchura de 32. Un lote de imágenes añade una dimensión delante: número de imágenes, canal, altura, anchura.
El ruido gaussiano también es una matriz, con un valor aleatorio por píxel. «Gaussiano» describe la distribución de esos valores: se reparten alrededor de cero, con más valores pequeños que extremos. Este ruido no es un error de archivo ni una imagen mal descargada. Lo añadimos deliberadamente y conservamos los valores extraídos para saber qué debe predecir la red.
En los cálculos de la red, los píxeles limpios pasan de [0, 1] a [-1, 1] con x * 2 - 1. Así, 0 se convierte en -1, 0.5 se convierte en 0 y 1 sigue siendo 1. En cambio, el ruido y los estados ruidosos no están limitados a ese intervalo.
El recorrido de ida: añadir una dificultad conocida
La difusión directa transforma una máscara limpia, denominada x0, en una máscara ruidosa xt. El índice t indica el nivel de difusión elegido, no una duración en segundos.
La fórmula utilizada es:
xt = √ᾱt x0 + √(1 − ᾱt) ε
Puede leerse sin empezar por una demostración: una parte de la imagen limpia, más una parte de ruido. ε, la letra griega «epsilon», designa el ruido extraído. ᾱt, «alfa barra en el paso t», regula la cantidad de señal conservada. Las raíces cuadradas determinan los coeficientes que se aplican realmente.
Tomemos un ejemplo de cálculo inventado, sobre un único valor, sin relación con una salida medida del modelo. Con x₀ = 1, ᾱₜ = 0.64 y ε = -0.5, obtenemos:
xₜ = 0.8 × 1 + 0.6 × (-0.5) = 0.5.
El resultado no se obtiene borrando el 36 % de los píxeles. Cada valor se transforma mediante la mezcla. Los coeficientes tampoco son dos opacidades cuya suma deba ser 1.
Un calendario de ruido, o noise schedule, fija la evolución de estos coeficientes. El del proyecto es un calendario coseno de 100 pasos. Lo define el programa; no se aprende con los pesos de la red. El principio del calendario coseno se presenta en Improved Denoising Diffusion Probabilistic Models. Esta referencia explica la familia de calendario elegida, sin sustituir los parámetros del proyecto.
Lo que la red aprende realmente
Durante el entrenamiento, la red recibe la imagen ruidosa, el paso t y la clase. Debe devolver el ruido estimado, no directamente un disco o un anillo terminado. Conocemos la respuesta correcta, porque nosotros mismos hemos extraído el ruido ε.
La pérdida, o loss, mide la diferencia entre esta predicción y el ruido inyectado. Aquí es la MSE, mean squared error, o error cuadrático medio: calculamos las diferencias, las elevamos al cuadrado y tomamos su media.
Un segundo ejemplo pedagógico, limitado a dos valores, basta para seguir el cálculo. El ruido real vale [0.2, -0.4] y la red predice [0.1, -0.2]. Los errores al cuadrado valen 0.01 y 0.04, por lo que la MSE vale (0.01 + 0.04) / 2 = 0.025. Un error dos veces mayor contribuye cuatro veces más a esta pérdida.
Los pesos son los números ajustables de la red. Los gradientes indican cómo afecta una variación de esos números a la pérdida; el optimizador los usa para actualizarlos. Por tanto, no codificamos una regla «dibujar un anillo» en la red: ajustamos sus pesos a partir de ejemplos ruidosos y de sus respuestas esperadas.
Atención a los dos sentidos de «paso». Los 100 pasos de difusión describen los niveles de ruido y el recorrido de generación. Las 2 000 actualizaciones anunciadas más adelante describen el entrenamiento de los pesos. No son dos maneras de contar el mismo bucle.
¿Por qué una U-Net?
La U-Net aplica convoluciones, es decir, filtros aprendidos que combinan valores vecinos. Su recorrido descendente reduce la resolución para agregar información; su recorrido ascendente recupera una resolución fina. Las conexiones entre ambos recorridos reintroducen detalles espaciales. El sitio de los autores de U-Net presenta esta arquitectura de dos recorridos.
En src/mask_diffusion/unet.py, ConditionalUNet.forward() combina una representación numérica del tiempo y de la clase, y después la proporciona a los bloques de la red. El tiempo le indica en qué nivel de ruido trabaja. La clase le indica qué familia de máscaras se solicita.
Su salida tiene la misma forma que la imagen ruidosa: una estimación de ruido para cada píxel. Después, el programa de muestreo usa esa estimación para calcular el estado siguiente. Esta distinción entre la red y el cálculo que la rodea es central en DDPM.
Una condición no es una garantía
La clase nula significa «no se ha especificado ninguna clase». No es una cuarta forma que dibujar ni una instrucción de producir una imagen vacía. La misma red debe poder proporcionar una estimación condicional y una estimación no condicional.
El principio de Classifier-Free Diffusion Guidance consiste en aprender también sin condición, retirándola en parte de los ejemplos, y combinar después ambas estimaciones en la generación. No necesitamos añadir un clasificador separado para calcular esta combinación. Evidentemente, esto no elimina la necesidad de evaluar las imágenes después de producirlas.
En este proyecto, la combinación es εu + w(εc − εu), donde u designa la predicción no condicional y c la predicción condicional. La leeremos en el código: w=0 conserva u, w=1 conserva c. Un valor mayor no promete una imagen mejor.
Requisitos de Docker y GPU
Debe poder leer funciones de Python, manipular matrices y ejecutar comandos en un terminal. Son necesarias nociones básicas de Docker; no se supone ningún conocimiento previo de modelos de difusión.
El recorrido requiere Linux x86_64, Docker Compose, el NVIDIA Container Toolkit, una RTX 3090 de 24 Gio, 16 Gio de RAM y 16 Gio de espacio disponible en disco, sin contar las capas Docker compartidas. Son los recursos indicados para este tutorial, no una demostración de compatibilidad con todo el hardware.
Aquí la GPU, la tarjeta gráfica, ejecuta los cálculos de la red con CUDA. Sin embargo, una tarjeta visible para Linux puede ser inaccesible para Docker. Por ello, la comprobación incluida no se limita a enumerar un dispositivo: inicializa CUDA en el contenedor y ejecuta un cálculo. La selección opcional se realiza antes del recorrido con export GPU_DEVICE=0, o con un UUID de tarjeta, su identificador único.
El cálculo está aislado de la red. Los contenedores usan un sistema de archivos de solo lectura, no-new-privileges, la eliminación de capacidades Linux y límites de CPU, RAM y número de procesos. Estas restricciones acotan la ejecución; no demuestran la calidad de las imágenes. Tampoco confunda un cálculo aislado con una instalación totalmente sin conexión: la construcción de imágenes Docker y la adquisición de sus dependencias pueden requerir acceso a la red.
Un checkpoint es una copia de seguridad que permite conservar o reanudar un estado de cálculo. Los artefactos Torch producidos localmente deben seguir siendo fiables: no cargue un checkpoint arbitrario de terceros para sustituir un archivo ausente. La documentación de torch.load recuerda las precauciones de carga.
Datos cuya construcción conocemos
Fabricar una referencia antes de pedir al modelo que aprenda
Para nuestro experimento, no necesitamos recopilar imágenes en Internet. Sabemos definir un disco, un anillo y una cruz mediante reglas geométricas. La función siguiente fabrica los ejemplos de entrenamiento; no es el generador neuronal que evaluaremos después.
Recibe un identificador label, un centro, un radio, un grosor y un ángulo. Los identificadores 0, 1 y 2 designan respectivamente disco, anillo y cruz.
def render_mask(label, center=(0.0, 0.0), radius=0.55, thickness=0.18, angle=0.0):
    # Four subpixels in each direction; occupation fraction is the antialiased pixel.
    axis = (np.arange(128) + 0.5) / 64 - 1
    x, y = np.meshgrid(axis - center[0], axis - center[1])
    u = x * np.cos(angle) + y * np.sin(angle)
    v = -x * np.sin(angle) + y * np.cos(angle)
    distance = np.sqrt(x * x + y * y)
    if label == 0:
        inside = distance <= radius
    elif label == 1:
        inside = (distance <= radius) & (distance >= radius - thickness)
    elif label == 2:
        inside = ((abs(u) <= radius) & (abs(v) <= thickness / 2)) | (
            (abs(v) <= radius) & (abs(u) <= thickness / 2)
        )
    else:
        raise ValueError("Unknown geometric class")
    return inside.reshape(32, 4, 32, 4).mean((1, 3)).astype("float32")[None]
¿Qué acaba de hacer esta función?
axis coloca los centros de 128 pequeños intervalos entre -1 y 1. meshgrid construye las coordenadas de una cuadrícula de 128 × 128 posiciones. Restar center permite desplazar la forma sin cambiar sus reglas. Las coordenadas u y v aplican la rotación utilizada para construir la cruz.
Para el disco, cada posición es interior si su distancia al centro no supera radius. Para el anillo, esta distancia también debe ser al menos igual a radius - thickness: el centro permanece vacío. Para la cruz, el programa reúne dos rectángulos perpendiculares. Un identificador de clase desconocido provoca un error en lugar de elegir una forma por defecto.
¿Por qué una cuadrícula de 128 × 128 si la salida es de 32 × 32? Por el antialiasing, que reduce el efecto de escalera en los contornos. Cada píxel final está representado por cuatro subpíxeles en cada dirección, es decir, 16 subpíxeles. reshape(32, 4, 32, 4).mean((1, 3)) calcula su ocupación media.
Por ejemplo, 12 subpíxeles interiores de 16 dan 0.75. Este gris no es una predicción incierta: representa una fracción de superficie en nuestro método de renderizado. Por tanto, el antialiasing pertenece a los propios datos, y no a un retoque aplicado después de la evaluación.
Por último, astype("float32") elige un almacenamiento numérico de 32 bits. [None] añade la dimensión del canal. Obtenemos una matriz 1 × 32 × 32, sin dimensión de lote en esta etapa.
Separar los datos antes del entrenamiento
La preparación produce tres conjuntos equilibrados. La tabla siguiente detalla los efectivos del proyecto; los efectivos por clase se derivan de este equilibrio.
| Conjunto | Número de máscaras | Máscaras por clase | Función |
|---|---|---|---|
| Entrenamiento | 3 000 | 1 000 | Proporcionar los ejemplos utilizados para modificar los pesos. |
| Validación | 600 | 200 | Medir la pérdida sobre ejemplos separados del entrenamiento. |
| Prueba | 600 | 200 | Conservar un conjunto distinto para la evaluación prevista por el proyecto. |
Cada partición utiliza una semilla distinta para sus extracciones seudoaleatorias. Una semilla inicializa un generador; no es una anotación de imagen. Cada imagen también se somete a hash, y se rechaza cualquier duplicado antes de fijar los conjuntos.
El hash produce una huella del contenido. Permite detectar contenido idéntico, no garantizar que dos formas diferentes nunca sean muy parecidas. En un pequeño universo de discos, anillos y cruces, este matiz importa. La clase nula no añade una cuarta categoría de máscaras a esta tabla: interviene en la forma de condicionar la red.
El código central: aprender el ruido y guiar después el retorno
Generar no es volver a ejecutar el dibujo geométrico
El sampler, o programa de muestreo, parte de un estado ruidoso y calcula los estados siguientes en el orden inverso de la difusión. Aquí llama al modelo dos veces en cada paso, combina los dos ruidos predichos y añade un nuevo ruido gaussiano, salvo en el último paso.
No consulta render_mask() para recuperar la forma esperada. Debe producir una imagen a partir de lo que ha aprendido la red.
def guidance(unconditional, conditional, weight):
    return unconditional + weight * (conditional - unconditional)


def reverse_step(x, epsilon, t, schedule, noise):
    beta = schedule["beta"][t].to(x.device)
    alpha = schedule["alpha"][t].to(x.device)
    abar = schedule["abar"][t].to(x.device)
    previous = schedule["abar"][t - 1].to(x.device)
    mean = (x - beta * epsilon / (1 - abar).sqrt()) / alpha.sqrt()
    variance = beta * (1 - previous) / (1 - abar)
    return mean if t == 1 else mean + variance.sqrt() * noise


@torch.no_grad()
def ancestral_sample(
    model, initial, labels, weight, schedule, generator, start=None, stop=0
):
    x = initial.clone()
    trajectory = [x[0].cpu()]
    start = start or len(schedule["beta"]) - 1
    for t in range(start, stop, -1):
        times = torch.full((len(x),), t, device=x.device, dtype=torch.long)
        u = model(x, times, torch.full_like(labels, NULL_CLASS))
        c = model(x, times, labels)
        eps = guidance(u, c, weight)
        noise = (
            torch.randn(x.shape, device=x.device, generator=generator)
            if t > 1
            else torch.zeros_like(x)
        )
        x = reverse_step(x, eps, t, schedule, noise)
        trajectory.append(x[0].cpu())
    assert torch.isfinite(x).all()
    return x, torch.stack(trajectory)
Leer la guidance con tres números
La primera función aplica exactamente la fórmula anunciada: unconditional + weight * (conditional - unconditional).
Tomemos un ejemplo aritmético ficticio sobre un único valor de ruido, con u = 0.2 y c = 0.5. No son salidas capturadas del modelo.
| Peso del proyecto | Cálculo | Resultado | Sentido de la operación |
|---|---|---|---|
w=0 |
0.2 + 0 × (0.5 - 0.2) |
0.2 |
Conservar la predicción no condicional. |
w=1 |
0.2 + 1 × (0.5 - 0.2) |
0.5 |
Conservar la predicción condicional. |
w=3 |
0.2 + 3 × (0.5 - 0.2) |
1.1 |
Prolongar la diferencia más allá de la predicción condicional. |
w=3 es una extrapolación, no una mezcla al 75 % / 25 %. El valor 1.1 no significa «110 % de confianza»: manipulamos una estimación de ruido, no una probabilidad. Si las dos ramas devuelven exactamente la misma estimación, su diferencia es nula y cambiar w no cambia esta combinación.
Una trampa de notación en las referencias. El artículo de Ho y Salimans escribe la combinación como
(1 + w_article) × c - w_article × u. La convención de nuestro código corresponde aw_projet = 1 + w_article. Mantenga juntas, por tanto, los valores y la fórmula del proyecto: elw=0de este tutorial designa efectivamente la rama no condicional, mientras que el de la fórmula del artículo designa la rama condicional.
Leer un paso de retorno sin perder el hilo
reverse_step() recibe el estado actual x, el ruido predicho epsilon y el número de paso. El calendario proporciona beta, alpha y abar. En esta notación de difusión, alpha corresponde a 1 - beta y abar al producto de los alpha hasta el paso considerado. previous recupera el valor acumulado en el paso anterior.
La línea mean = ... corrige el estado a partir del ruido predicho y de los coeficientes del calendario. La línea variance = ... regula la amplitud del ruido aleatorio usado para extraer el estado siguiente. Por tanto, el ruido predicho epsilon y el ruido recién extraído noise no tienen el mismo papel. El primero procede de la red; el segundo mantiene un paso aleatorio en este sampler.
El retorno contiene este nuevo ruido para t > 1. En t == 1, la función devuelve solo mean. Añadir ruido durante el retorno puede parecer paradójico, pero el programa no recorre hacia atrás el historial exacto de una imagen concreta: construye una trayectoria de generación según la regla de muestreo.
Seguir el bucle y lo que conserva
initial.clone() crea un estado de trabajo sin sobrescribir la matriz proporcionada por quien llama. En cada paso, times contiene el mismo índice t para todas las imágenes del lote. Las llamadas u = model(...) y c = model(...) usan la misma red, con una clase nula y después con las clases solicitadas.
En este extracto, ambas llamadas se realizan incluso para w=0 o w=1: el código no incluye un atajo para estos valores. Para un recorrido completo de 100 pasos, ello representa 200 llamadas a la red por lote, y no 200 actualizaciones de los pesos.
El decorador @torch.no_grad() desactiva el seguimiento de gradientes durante esta generación. Aquí no hay cálculo de pérdida de entrenamiento ni actualización del optimizador. Sin embargo, este decorador no sustituye a un posible model.eval(): PyTorch distingue el modo de evaluación del seguimiento de gradientes. El extracto no muestra cómo prepara quien llama el modo de la red.
Observe también trajectory.append(x[0].cpu()). La trayectoria conserva solo la primera imagen del lote, en la CPU. El valor final x, en cambio, contiene todas las imágenes del lote. Con un inicio en 100 y stop=0, el bucle procesa 100, 99, …, 1, y la trayectoria contiene el estado inicial más los 100 estados calculados, es decir, 101 estados.
La aserción final torch.isfinite(x).all() exige valores numéricos finitos: ni NaN ni infinito. No verifica ni los contornos, ni los agujeros, ni siquiera que los valores se mantengan en [0, 1]. Una matriz numéricamente válida todavía no es una forma válida.
Mismo ruido inicial: necesario, pero no toda la historia
El protocolo compara w=0, w=1 y w=3 con ruido inicial idéntico. Es indispensable para no atribuir al peso de guidance una diferencia creada desde el principio.
Pero el bucle también extrae nuevos ruidos con generator. Para aislar completamente el efecto de w en una comparación emparejada, también hay que recuperar la misma secuencia de extracciones intermedias. El sampler recibe este generador; no lo reinicializa por sí mismo. Por tanto, dos llamadas sucesivas con el mismo objeto generador pueden consumir dos porciones diferentes de su secuencia.
Esta precisión se deduce del código mostrado: conservar initial no basta por sí solo para establecer el control de todas las extracciones. La inicialización y el guardado del generador corresponden al código que llama en el proyecto completo.
La misma cuestión aparece al reanudar. Con start=100 y stop=50, el bucle procesa los pasos 100 a 51 y devuelve el estado en el nivel 50. Reanudar desde este estado con start=50 requiere recuperar también el estado aleatorio correspondiente, así como el mismo modelo y el mismo calendario. La documentación de PyTorch sobre reproducibilidad explica por qué fijar una semilla no garantiza por sí solo resultados idénticos en todos los entornos.
Medir el aprendizaje con un ejercicio de validación fijo
Durante el aprendizaje, el programa extrae un tiempo, añade ε y minimiza el error de predicción de ε. Para comparar dos estados de la red, la siguiente validación utiliza por el contrario tiempos y ruidos fijados de antemano. Es el equivalente de usar los mismos datos de prueba después de cada modificación de una aplicación.
def validation_mse(model, config):
    assert (
        sha("outputs/validation-noise.npz")
        == read_json("outputs/validation-lock.json")["sha256"]
    )
    data = np.load("outputs/validation.npz")
    fixed = np.load("outputs/validation-noise.npz")
    total = 0.0
    model.eval()
    with torch.no_grad():
        for i in range(0, 600, 64):
            x = torch.from_numpy(data["images"][i : i + 64]).cuda() * 2 - 1
            t = torch.from_numpy(fixed["times"][i : i + 64]).cuda()
            eps = torch.from_numpy(fixed["noise"][i : i + 64]).cuda()
            y = torch.from_numpy(data["labels"][i : i + 64]).cuda()
            noisy = sample_noisy_image(
                x, t, eps, cosine_schedule(config["diffusion_steps"])
            )
            total += float((model(noisy, t, y) - eps).square().double().sum())
    model.train()
    return total / (600 * 32 * 32)
La aserción inicial compara la huella SHA-256 de outputs/validation-noise.npz con la registrada en outputs/validation-lock.json. Controla este archivo de ruido fijo; no es una comprobación universal de todos los archivos del proyecto.
A continuación, el programa carga las 600 imágenes de validación, los tiempos, los ruidos y las clases. .cuda() coloca las matrices en la GPU. La transformación * 2 - 1 aplica el cambio de escala de las máscaras explicado antes.
model.eval() activa el modo de evaluación, mientras que torch.no_grad() desactiva el seguimiento de gradientes. Después, sample_noisy_image() fabrica cada entrada ruidosa. Comparamos model(noisy, t, y) con eps, y no con la imagen limpia x: la puntuación sigue refiriéndose al ruido.
El bucle avanza en lotes de 64. Con 600 imágenes, da nueve lotes completos y un último lote de 24. El código suma los errores al cuadrado y después divide entre 600 × 32 × 32 = 614 400 valores de píxel. No hace una media de las medias de los lotes, que daría demasiado peso al último lote, más pequeño.
.double() convierte los errores al cuadrado antes de sumarlos; no transforma toda la red en un modelo que calcule con precisión doble. Por último, model.train() devuelve la red al modo de entrenamiento.
Las constantes 600, 32 y 32 pertenecen al protocolo. Si cambia el tamaño de la validación o de las imágenes en otro experimento, este cálculo deberá evolucionar con los datos. En el recorrido de referencia, manténgalas sin cambios.
Instalar y verificar el entorno
Extraiga el archivo y abra un terminal en su raíz. Todos los comandos siguientes parten de ese mismo directorio. Use una extracción dedicada al experimento para no mezclar sus archivos con los de otro proyecto.
Empiece preparando los directorios, comprobando Compose, construyendo las imágenes y probando el entorno:
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prepara el proyecto. docker compose config --quiet verifica la configuración de Compose sin mostrarla; por tanto, la ausencia de salida no es por sí sola una anomalía. build acquire gpu construye los dos servicios indicados.
acquire verifica los bloqueos del proyecto. En este tutorial no se descarga ningún modelo preentrenado: las máscaras las generará prepare, y la red se entrenará durante el recorrido. No traslade aquí la etapa de adquisición de pesos de un tutorial de modelo de lenguaje.
check_environment.py debe confirmar que la GPU puede usarse realmente desde el contenedor. A continuación, el comando pytest ejecuta las pruebas del proyecto. Corrija cualquier error antes del entrenamiento; los resultados de generación no podrían reparar una comprobación de entorno ausente.
Prepare ahora las imágenes y examine después su transformación mediante el ruido:
docker compose run --rm gpu python -m mask_diffusion.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli inspect-noise --config configs/minimum.yaml
Después de prepare, los conjuntos anunciados son 3 000 máscaras de entrenamiento, 600 de validación y 600 de prueba. inspect-noise permite observar el recorrido de ida. En este punto, observe cómo una forma conocida se convierte en un estado ruidoso; todavía no observa la capacidad del modelo para generar una forma.
Entrenar, reanudar y evaluar
Ejecutar el recorrido de referencia
Primero verificamos las dimensiones y los gradientes de la U-Net, y después entrenamos el modelo. Los gradientes son útiles aquí para comprobar que el cálculo permite realmente que evolucionen sus parámetros; ver una imagen de salida no bastaría para establecerlo.
La secuencia también incluye una interrupción deliberada y una reanudación. Un entrenamiento de referencia completo sirve de comparación con un entrenamiento detenido y después reanudado. Por tanto, no es una instrucción de interrumpir manualmente el primer comando.
docker compose run --rm gpu python -m mask_diffusion.cli inspect-model --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli train --config configs/minimum.yaml --stop-after 1000 --run-name interrupted
docker compose run --rm gpu python -m mask_diffusion.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m mask_diffusion.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli sample --config configs/minimum.yaml
docker compose run --rm gpu python -m mask_diffusion.cli evaluate --config configs/minimum.yaml
inspect-model precede a los cálculos largos. El primer train produce el entrenamiento de referencia. La llamada con --stop-after 1000 --run-name interrupted crea la rama interrumpida. La llamada siguiente reanuda su checkpoint artifacts/checkpoints/interrupted/state.pt con el nombre resumed. compare-resume compara los estados obtenidos.
Después, sample utiliza los modelos para producir las salidas, y evaluate aplica las medidas. Las cifras presentadas a continuación son las de la reproducción del lector validada de la revisión r1. No son umbrales que alcanzar modificando los ajustes hasta obtener una figura bonita.
Definir lo que puede decirnos cada medida
La MSE de validación compara un ruido predicho con un ruido de referencia fijo. Responde a «¿la red predice mejor el ruido en este ejercicio?». No responde directamente a «¿la solicitud de anillo produce un anillo?».
La conformidad geométrica examina las imágenes producidas con reglas distintas de la red. El proyecto utiliza controles de componentes, agujeros y área. Un componente es una zona conectada; un agujero es una zona de fondo encerrada en una forma; el área mide su extensión según la regla del validador.
Para visualizar estas nociones, piense en las formas ideales, no en una descripción exhaustiva del clasificador del proyecto. Un disco está lleno, un anillo tiene un agujero y una cruz tiene brazos. El número de agujeros por sí solo no basta para distinguir una cruz de un disco. Las decisiones exactas dependen de las reglas del validador, en particular de cómo interpreta los píxeles intermedios. Los umbrales no se detallan en los extractos de este artículo: debe leerlos en el código de evaluación del archivo, sin inventar otros nuevos.
La categoría unknown significa que no se ha asignado ninguna de las tres clases geométricas. No es un cuarto éxito. Por tanto, una imagen que parece vagamente circular a la vista puede seguir siendo rechazada por los criterios elegidos.
La distancia al entrenamiento, es decir, al conjunto de entrenamiento, es la MSE entre una salida y su máscara de entrenamiento más cercana. Aquí comparamos imágenes entre sí; no es la MSE de predicción de ruido. Una distancia pequeña indica una gran proximidad según esta medida, pero no demuestra por sí sola una memorización. A la inversa, una distancia grande no demuestra una creación interesante: un ruido sin forma puede estar muy alejado de los ejemplos.
Por último, la diversidad se refiere a la variedad de las salidas. Debe leerse junto con la conformidad y la proximidad a los datos de entrenamiento. Trescientas salidas diferentes pero todas inválidas no constituyen un generador de formas variadas utilizables. Este artículo no proporciona un valor numérico de diversidad ni de distancia al entrenamiento: por tanto, no deduciremos una conclusión sobre la memorización.
Resultados observados
El entrenamiento y la reanudación funcionan en el recorrido medido
El entrenamiento principal realizó 2 000 actualizaciones y procesó 128 000 ejemplos con repetición de las imágenes del conjunto de entrenamiento. No se trata de 128 000 máscaras distintas: las mismas imágenes limpias pueden presentarse varias veces, con tiempos y ruidos de entrenamiento extraídos.
La MSE de validación pasó de 1.1551 a 0.0211. Por tanto, la red progresó en la tarea realmente medida: la predicción del ruido de validación.
Dos comprobaciones se refieren a la reanudación. Después de detener el entrenamiento en el paso 1 000, la reanudación recuperó los mismos parámetros, con un error máximo nulo. El sampler reanudado en t=50 también dio un error máximo nulo. Estas igualdades se refieren a las comparaciones realizadas en este recorrido; no prometen una identidad bit a bit en todo hardware o versión de software.
Sin embargo, ninguna campaña produce una máscara conforme
El protocolo cruza dos estados de la red, no entrenada y entrenada, con tres pesos de guidance. Esto da seis campañas de 300 muestras cada una. La tabla desarrolla esta distribución sin añadir nuevas medidas:
| Estado de la red | Guidance | Conformidad geométrica | Salidas clasificadas como unknown |
|---|---|---|---|
| No entrenada | w=0 |
0/300 |
300 |
| No entrenada | w=1 |
0/300 |
300 |
| No entrenada | w=3 |
0/300 |
300 |
| Entrenada | w=0 |
0/300 |
300 |
| Entrenada | w=1 |
0/300 |
300 |
| Entrenada | w=3 |
0/300 |
300 |
«No entrenada» y «no condicional» no designan lo mismo. La primera describe el estado de los pesos; la segunda describe la ausencia de clase durante una predicción. Por tanto, la red entrenada puede utilizarse en la rama no condicional con w=0.
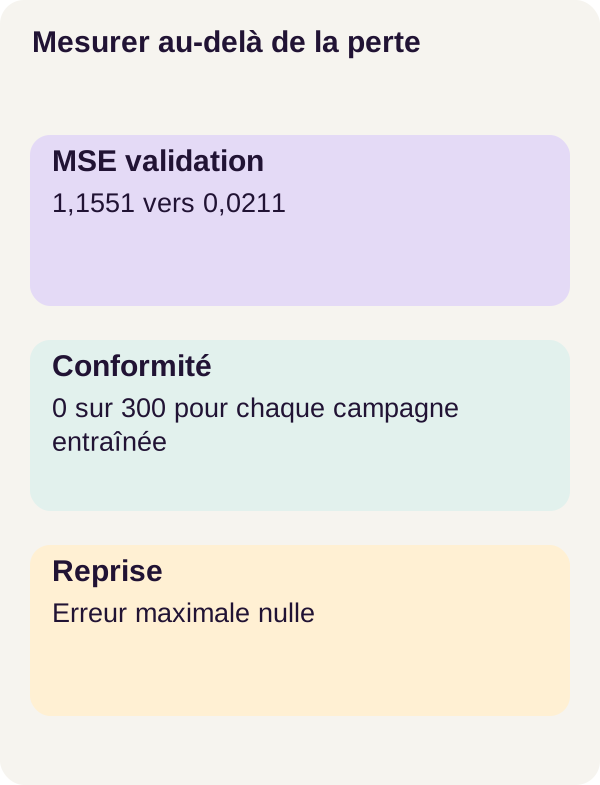
Las 300 salidas de cada campaña se clasificaron todas como unknown. Por tanto, la disminución de la MSE no demuestra que las generaciones respeten la forma solicitada. Sería engañoso presentar únicamente la curva de pérdida, o seleccionar algunas imágenes visualmente favorables para anunciar un generador exitoso.
Lo que hemos aprendido
Una buena respuesta a una subtarea todavía no es un buen resultado final
Para un desarrollador web, la analogía es la de una función cuyas pruebas unitarias progresan mientras el recorrido completo del usuario sigue fallando. Ambas observaciones no se contradicen: no se refieren al mismo nivel del sistema.
Aquí la pérdida mide una media de errores numéricos sobre el ruido. La generación encadena pasos de cálculo; la evaluación final exige una forma cuyas propiedades sean aceptadas. Estos tres objetos deben permanecer diferenciados.
Como ilustración, y no como diagnóstico de este experimento, una pequeña ruptura en el borde de un anillo puede cambiar la existencia de su agujero. Por tanto, unos pocos píxeles pueden hacer cambiar un criterio geométrico, aunque un error medio evolucione poco. Esto ayuda a entender por qué la puntuación de una tarea numérica no se convierte automáticamente en conformidad geométrica.
Reproducir un fracaso sigue siendo información útil
El mecanismo de difusión, las identidades de guidance y la conservación del estado de reanudación se verifican en el recorrido comunicado. Al mismo tiempo, las reglas geométricas muestran un límite claro: esta configuración no produce las pequeñas máscaras conformes buscadas.
Una reanudación idéntica demuestra que el cálculo pudo continuarse de forma coherente en las condiciones de la prueba. No demuestra que el resultado sea bueno. Del mismo modo, un peso de guidance superior no corrige automáticamente una generación inadecuada.
Las medidas agregadas no permiten atribuir el fracaso a una única causa. Decir «basta con entrenar más tiempo» o «el validador es necesariamente demasiado estricto» iría más allá de lo establecido. Son, en todo caso, hipótesis que se deben examinar por separado, con sus propios controles, no correcciones ya validadas.
Ejercicio: plantear la hipótesis antes del comando
Antes de ejecutar nada, calcule guidance(u, c, 0) y guidance(u, c, 1) con valores de su elección. Compruebe también qué ocurre cuando u y c son iguales: ¿puede el peso seguir modificando la combinación?
Formule después una hipótesis: al pasar de w=1 a w=3, con ruido inicial idéntico, ¿se conservará, disminuirá o desplazará la diversidad? Anote qué procede de una certeza algebraica, como las identidades en los pesos 0 y 1, y qué procede de una previsión sobre las salidas de la red.
Ejecute ahora el ejercicio incluido:
docker compose run --rm gpu python -m mask_diffusion.cli exercise --config configs/exercise.yaml
La salida controla las identidades límite, conserva el mismo ruido inicial e informa de las métricas de w=1 y w=3. No promete ninguna mejora.
Compare estas observaciones con su hipótesis. Para interpretar una diferencia como efecto exclusivo del peso, piense también en el estado del generador de ruidos intermedios, no solo en el ruido inicial. Por último, no sustituya «más variaciones visibles» por «más formas válidas»: una diversidad útil debe respetar los criterios de la tarea.
Adaptar y producir
Antes de transformar este experimento en una aplicación, primero hay que abordar su límite de generación. Añadir una API alrededor del modelo no haría las máscaras más conformes.
Un experimento adicional, distinto de r1, podría examinar una sola hipótesis cada vez: por ejemplo, estudiar el efecto de la duración del entrenamiento conservando los datos, el calendario y el validador. Habría que conservar las salidas de referencia, documentar el cambio y medir de nuevo ruido, conformidad y diversidad. Aquí no se anuncia ningún resultado de esta variante. Modificar las reglas de aceptación después de ver las imágenes definiría otra tarea, no una mejora demostrada del modelo anterior.
Para un uso real, las máscaras sintéticas deberían sustituirse por datos autorizados y versionados, con anotaciones y criterios de negocio explícitos. Los fallos deberían medirse por población relevante: tipo de imagen, clase o condición de adquisición, según la necesidad. También habría que seguir la deriva, es decir, la evolución de los datos o de los resultados después del despliegue.
La gestión de derechos, la autenticación, la protección de la API, la observabilidad, las copias de seguridad, la carga y una política de rechazo todavía deben construirse. Una pérdida estable no cubre ninguno de estos requisitos. El tutorial proporciona un experimento medible, no un servicio listo para recibir imágenes de negocio.
Resolución de problemas y limpieza
Si falla la comprobación de la GPU, verifique el controlador y la instalación del NVIDIA Container Toolkit, y después vuelva a ejecutar check_environment.py con el comando mostrado anteriormente. Una tarjeta visible en el host pero inaccesible en el contenedor indica primero un problema de integración Docker/GPU, no un motivo para modificar la U-Net.
Si falla una comprobación de archivo o de checkpoint, conserve su mensaje y verifique que los archivos pertenecen a la misma ejecución y a la misma configuración. No eluda un fallo de integridad con un checkpoint externo no identificado.
Si la pérdida baja mientras la conformidad sigue en cero, no necesariamente ha ejecutado mal el programa: es precisamente el límite observado en esta revisión. Examine los estados y las medidas sin convertir una expectativa de éxito en un resultado anunciado.
Para producir las figuras, verificar los checkpoints, previsualizar la limpieza y después detener los servicios, use los comandos del recorrido:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
plot.py produce las figuras; no constituye un nuevo entrenamiento. check_checkpoints.py controla los checkpoints. La opción --dry-run significa que la limpieza solo se previsualiza: no borra los archivos generados.
Por último, docker compose down --remove-orphans detiene y elimina los recursos afectados del proyecto Compose. En este recorrido se conservan los archivos locales. No es necesario realizar una purga global de Docker, que afectaría a otros experimentos.
Fuentes primarias y documentación
Los resultados de este artículo son los de la reproducción r1 del proyecto descargable. Las siguientes referencias sirven para profundizar en los mecanismos y las precauciones; no constituyen una validación independiente de sus salidas.
Difusión y arquitectura. Ho, Jain y Abbeel — Denoising Diffusion Probabilistic Models describe el marco DDPM. Ho y Salimans — Classifier-Free Diffusion Guidance presenta la combinación de predicciones con y sin condición; atención a la convención de peso explicada anteriormente. Nichol y Dhariwal — Improved Denoising Diffusion Probabilistic Models presenta en particular el calendario coseno. El sitio de los autores de U-Net explica la arquitectura original.
Cálculo y reanudación. La documentación de PyTorch distingue el modo de evaluación y el seguimiento de gradientes, expone los límites de reproducibilidad y documenta la carga con torch.load. Estas páginas generales no sustituyen las versiones y los ajustes conservados en el archivo.
Entorno. La documentación Docker Compose — soporte de GPU y la guía de instalación de NVIDIA Container Toolkit detallan el acceso a la tarjeta desde los contenedores.
Descargar el archivo y seguir el recorrido completo: abrir el tutorial.