





Le problème : une clause déplacée et un délai modifié
Imaginez une fonctionnalité de votre back-office : un utilisateur dépose deux versions d’un guide et souhaite savoir ce qui a changé. Vous pourriez extraire le texte, lancer un diff et afficher les lignes ajoutées ou supprimées. Le principe ressemble à une comparaison de fichiers dans Git.
Mais voici les deux versions du guide fictif « Nova Service Policy ». La seconde utilise une autre police et une autre pagination. Un paragraphe occupe maintenant quatre lignes au lieu de trois ; le suivant passe sur une autre page. Le texte n’a pas forcément changé, mais ses lignes et ses coordonnées ne correspondent plus.
Une modification bien réelle se glisse dans cette nouvelle présentation : « Payment is due within 30 days » devient « Payment is due within 45 days ». Autrement dit, le délai passe de 30 à 45 jours. Un diff ligne à ligne peut noyer cette modification dans les retours à la ligne. À l’inverse, un modèle de similarité peut trouver les deux phrases très proches : elles parlent toujours du même sujet, avec presque les mêmes mots.
Nous avons donc deux questions différentes : quels passages faut-il comparer, puis qu’est-ce qui diffère entre eux ? Retrouver un passage proche ne suffit pas à le déclarer inchangé.
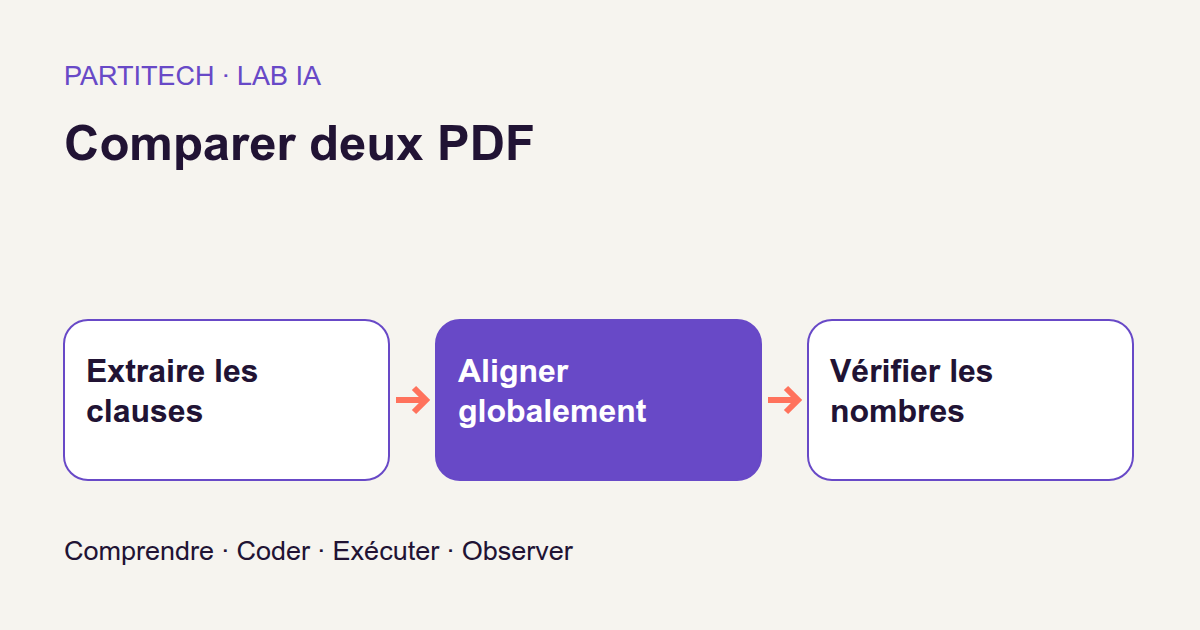
Ce tutoriel construit un comparateur local pour PDF natifs, c’est-à-dire contenant du texte exploitable, et non uniquement les images d’un scan. Son parcours est le suivant : glyphes → clauses → vecteurs de similarité → alignement global → contrôles explicites → passages à relire. Le vocabulaire sera expliqué au fur et à mesure ; vous pouvez aborder le projet avec des bases de Python, de tableaux et de Docker, sans avoir déjà entraîné un modèle.
Le résultat est une liste de candidats à relire avec la provenance des deux PDF. Il ne s’agit ni d’un avis juridique, ni d’une garantie qu’une reformulation conserve le même sens. Nous allons surtout apprendre à faire coopérer un modèle et des règles, plutôt qu’à demander au modèle de tout décider.
Télécharger le projet complet.
Ce que les données donnent réellement
Trois façons de faire évoluer un même guide
Le corpus Nova contient 40 familles et trois paires par famille, soit 120 paires de vrais PDF natifs. Ces fichiers sont générés pour l’expérience : « vrais PDF » signifie que nous traitons réellement ce format, pas que les documents proviennent de clients.
Dans chaque famille, une paire ne change que la présentation. Une autre modifie le délai et de la ponctuation. La troisième insère une clause, en supprime une et reformule un contact. Cette construction permet de savoir quelles différences étaient attendues avant de lancer le comparateur.
Les familles 0 à 9 constituent le développement, soit 30 paires ; les 30 autres constituent le test, soit 90 paires. Une famille ne traverse pas ces deux ensembles. Le développement sert à travailler sur la méthode ; le test sert à mesurer le comportement retenu, sans le corriger après avoir vu ses réponses.
Nous ne séparons pas ici un entraînement neuronal et un test : le modèle préentraîné reste gelé. La séparation sert tout de même à éviter de concevoir les règles sur les exemples utilisés pour annoncer les résultats. La grammaire générative reste commune aux familles ; ce protocole ne représente donc pas automatiquement la diversité de vos documents.
Reconstituer des clauses, pas seulement récupérer une chaîne
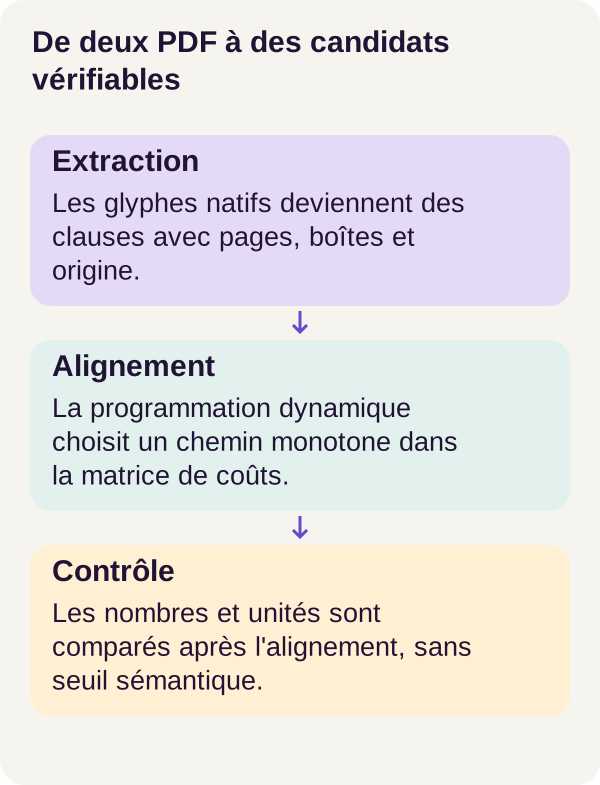
Un glyphe est une forme de caractère dessinée dans le PDF, accompagnée d’une position. Le programme part de ces éléments visibles. Son segmentateur, le code qui découpe le document en passages, groupe les lignes par position et repère les titres en gras pour reformer des clauses.
Ici, une clause est l’unité de passage que nous allons comparer. Ce n’est pas une catégorie juridique reconnue par le programme. Il faut d’abord que l’extraction ait correctement regroupé les éléments du document.
Chaque clause conserve une liste de régions sources : document, empreinte SHA-256, index de page, boîte et identifiants de glyphes. Une boîte est simplement un rectangle qui localise le passage sur la page. Si une clause commence sur une page et se termine sur la suivante, elle garde plusieurs boîtes : on ne peut pas résumer fidèlement cette provenance par un seul rectangle.
Pour un développeur web, cette provenance ressemble au lien entre un résultat affiché et les enregistrements qui l’ont produit. Elle permet de revenir au bon document et aux bonnes zones. L’empreinte SHA-256, calculée à partir du fichier, aide à identifier la version utilisée ; elle ne certifie pas la justesse du rapprochement proposé.
Normaliser sans perdre le chemin vers l’original
Pour comparer les textes, le projet applique NFKC, passe en minuscules et fusionne les espaces. NFKC est une forme de normalisation Unicode : elle rapproche notamment certaines représentations différentes de caractères. La documentation Python de unicodedata.normalize décrit cette opération.
Prenons un exemple pédagogique, indépendant des mesures Nova. La chaîne office peut contenir un seul caractère Unicode pour la ligature ffi. Après NFKC, elle devient office : les trois lettres f, f et i sont séparées. La spécification Unicode détaille cette transformation et les distinctions qu’une normalisation de compatibilité peut effacer.
Si le glyphe de la ligature avait, dans notre exemple, l’identifiant G17, les trois caractères normalisés doivent pouvoir renvoyer à ce même glyphe. Le projet conserve précisément une carte du caractère normalisé vers les glyphes d’origine. Il ne suppose pas qu’un caractère normalisé corresponde toujours à un seul caractère source distinct.
De même, harmoniser Payment, PAYMENT et les espaces facilite la comparaison, mais fait disparaître certaines différences de forme. Le texte normalisé ne permet pas, à lui seul, de reconstruire l’original. C’est la raison de conserver à la fois la représentation de travail et sa provenance. Ce choix de normalisation appartient au protocole ; il faudra en réexaminer la pertinence avant de comparer d’autres types de documents.
Ce que l’extraction ne répare pas
Les en-têtes et pieds de page sont exclus par zone déclarée : leur emplacement est fourni, pas découvert automatiquement par le modèle. Les césures ne sont pas réparées automatiquement. Un mot coupé en fin de ligne peut donc demander un traitement supplémentaire dans un autre corpus.
Une mauvaise extraction ne devient pas correcte parce que le modèle vectoriel est bon. Si un passage manque ou si deux clauses ont été fusionnées par erreur, inspectez d’abord cette étape. Le comparateur travaille sur les clauses qu’il reçoit, pas sur une version idéale du document.
Embeddings : proches n'est pas identiques
Transformer une clause en nombres
Un embedding est un vecteur, c’est-à-dire une liste de nombres qui représente un texte dans un espace appris. Le modèle du POC, ou preuve de concept, est all-MiniLM-L6-v2. Sa carte officielle décrit des vecteurs de 384 dimensions et leur construction par pooling.
Le modèle sert ici d’encodeur : il transforme une entrée en représentation numérique. Il ne rédige pas une analyse des changements. Ses paramètres restent gelés, donc inchangés pendant le parcours. Nous faisons de l’inférence, l’utilisation d’un modèle déjà entraîné, pas un fine-tuning sur Nova.
Le calcul utilise FP32 sur CPU : des nombres flottants sur 32 bits, traités par le processeur. Aucun GPU n’est requis ni exécuté dans ce tutoriel.
Les 384 valeurs ne correspondent pas à 384 champs métier nommés. Nous n’avons pas, par exemple, une case « délai » dans laquelle le modèle rangerait fidèlement le nombre de jours. C’est justement pourquoi nous ajouterons ensuite un contrôle numérique explicite.
Tokens, fenêtres et moyenne pondérée
Un tokenizer découpe le texte en unités que le modèle peut traiter. Ici, il s’agit de WordPiece : un token peut être un mot ou un morceau de mot, pas nécessairement un caractère ou un mot entier. La documentation des tokenizers de Transformers explique ce découpage.
Le pooling rassemble les représentations des tokens pour obtenir un vecteur de passage. Il faut distinguer cette opération de la seconde moyenne utilisée par le projet pour les clauses longues.
Le tokenizer découpe en effet une clause longue en fenêtres de 254 wordpieces de contenu. Le parcours encode toutes les fenêtres, moyenne leurs vecteurs selon leur nombre de tokens, puis normalise le vecteur obtenu. Une clause longue exerce ce chemin dans une famille sur cinq. Nous ne remplaçons donc pas une clause longue par son seul début.
Pour comprendre la pondération, prenons deux fenêtres fictives de 254 et 46 tokens. Avec leurs vecteurs v1 et v2, la moyenne est (254 × v1 + 46 × v2) / 300, et non (v1 + v2) / 2. La petite fenêtre finale ne pèse pas autant que la grande simplement parce qu’elle constitue une fenêtre supplémentaire.
En réduisant les vecteurs à deux dimensions pour pouvoir calculer à la main, supposons v1 = (1 ; 0) et v2 = (0 ; 1). La moyenne vaut environ (0,8467 ; 0,1533). Sa normalisation en longueur donne environ (0,9840 ; 0,1782). Ces valeurs servent uniquement à expliquer le calcul ; ce ne sont pas des sorties de MiniLM.
Encoder toutes les fenêtres évite d’en ignorer une, mais ne crée pas un contexte unique dans lequel chaque token pourrait interagir avec toute la clause. La moyenne condense leurs représentations ; elle ne conserve pas automatiquement tous les détails ni toutes leurs relations.
Comparer les directions, pas certifier une équivalence
La similarité cosinus compare la direction de deux vecteurs. Pour des vecteurs non nuls u et v, elle vaut produit_scalaire(u, v) / (longueur(u) × longueur(v)). Une valeur proche de 1 indique des directions proches. Lorsque les deux vecteurs sont normalisés en longueur, le produit scalaire suffit, comme l’explique la documentation Sentence Transformers.
Un exemple à deux dimensions permet de voir la différence avec une égalité : (1 ; 0) et (2 ; 0) ont la même direction, donc un cosinus de 1, sans être deux listes de nombres identiques. Avec des textes, un score élevé n’est pas non plus un certificat d’équivalence.
Pour n clauses avant et m clauses après, le programme produit une matrice n × m : un tableau avec une ligne par clause ancienne et une colonne par clause nouvelle. La case [i, j] contient la proximité de ces deux clauses.
Revenons aux 30 et 45 jours. Même si leur similarité était de 0,99, ce nombre ne signifierait pas « 99 % de chances que rien n’ait changé ». Il aiderait à reconnaître que les deux passages se correspondent. La différence de délai doit rester visible à l’étape suivante. Proches signifie ici “bons candidats à comparer”, pas “interchangeables”.
Construire le chemin global
Pourquoi ne pas prendre le meilleur voisin de chaque clause ?
Supposons que deux anciennes clauses ressemblent toutes deux à la même clause nouvelle. Si chacune choisit indépendamment son meilleur voisin, le comparateur peut réutiliser ce passage deux fois et ignorer un autre passage.
La fonction align, dans src/pdfdiffai/align.py, choisit plutôt un alignement global. Chaque segment doit apparaître exactement une fois : soit dans un appariement, soit isolé comme insertion ou suppression. Apparier signifie associer une clause de la version avant à une clause de la version après ; cela ne signifie pas les déclarer identiques.
Le chemin est aussi monotone : il avance dans l’ordre des deux documents, sans revenir en arrière. Si une ancienne clause A précède B, leurs correspondances ne peuvent pas se croiser dans la nouvelle version.
Cette contrainte accepte une clause repoussée sur une autre page tant que l’ordre des sections reste globalement conservé. Elle ne permet pas de permuter librement deux sections entières. Nous mesurerons cette limite dans l’exercice.
Transformer la proximité en coût
Nous cherchons le chemin de coût minimal. Un coût faible rend une option attractive ; ce n’est pas une probabilité d’erreur. Le coût d’appariement combine trois termes, fixés avant l’inférence :
0,7 × (1 − cosinus) + pénalité de titre + 0,1 × distance de position relative.
La pénalité de titre vaut 0,2 si les tokens de titre diffèrent, sinon zéro. Une insertion et une suppression coûtent chacune 0,45. Ces valeurs sont des choix du protocole, pas des paramètres appris pendant ce parcours.
Par exemple, avec un cosinus fictif de 0,98, des tokens de titre différents et une distance relative de 0,10, le coût vaut 0,7 × 0,02 + 0,2 + 0,1 × 0,10 = 0,224. La proximité textuelle est forte, mais les autres indices continuent de contribuer.
Supprimer une clause puis en insérer une autre coûte 0,45 + 0,45 = 0,90. Comparer ces coûts aide à comprendre les choix possibles. Ce n’est toutefois pas un seuil de décision indépendant pour chaque paire : l’alignement doit aussi rester compatible avec les autres clauses.
La programmation dynamique : mémoriser les meilleurs débuts de chemin
La programmation dynamique évite de recalculer tous les chemins possibles. Elle conserve la meilleure solution pour chaque couple de débuts de documents, puis s’appuie sur ces résultats pour avancer.
distance[i, j] représente le coût minimal pour traiter les i premières clauses de la version avant et les j premières clauses de la version après. La matrice possède donc n + 1 lignes et m + 1 colonnes. Le zéro permet de représenter un début de document encore vide.
La case distance[0, 0] vaut zéro. Sur la première ligne, seule l’insertion est possible ; sur la première colonne, seule la suppression est possible. Avec le coût 0,45, ces bordures accumulent donc 0, 0,45, 0,90, etc.
Voici l’extrait central du projet. Il intervient à l’intérieur du calcul, après la préparation des matrices et des indices ; ce n’est pas un programme autonome à lancer seul.
value, rank, operation = min(
    (distance[i - 1, j - 1] + cost[i - 1, j - 1], 0, "M"),
    (distance[i - 1, j] + deletion, 1, "D"),
    (distance[i, j - 1] + insertion, 2, "I"),
)
La diagonale, M, apparie deux clauses. Elle reprend le meilleur coût pour leurs préfixes précédents et ajoute le coût de l’appariement courant. cost[i - 1, j - 1] utilise des indices diminués de un parce que cette matrice ne possède pas les bordures vides de distance.
Le mouvement vertical, D, consomme une clause ancienne sans correspondance. Il ajoute le coût de suppression. Le mouvement horizontal, I, consomme une clause nouvelle sans correspondance. Il ajoute le coût d’insertion. « Consommer » signifie ici l’intégrer au résultat d’alignement ; aucune clause n’est effacée des PDF sources.
Chaque option est un tuple contenant le coût, un rang de priorité et le nom de l’opération. Python compare les tuples élément par élément. En cas d’égalité exacte de coût, les rangs 0, 1, 2 donnent la priorité à l’appariement, puis à la suppression, puis à l’insertion. Ce départage rend le choix reproductible ; il n’apporte pas une preuve supplémentaire de justesse.
Un petit alignement à refaire à la main
Prenons un exemple pédagogique : la version avant contient A, B, et la version après A′, X, B′. Nous avons choisi les coûts ci-dessous pour représenter deux correspondances attractives et un passage inséré. Ils ne proviennent pas de l’encodage de Nova.
| Coût d’appariement | A′ | X | B′ |
|---|---|---|---|
| A | 0,10 | 1,20 | 1,20 |
| B | 1,20 | 1,20 | 0,10 |
Avec les insertions et suppressions à 0,45, la matrice des meilleurs coûts cumulés devient :
| Préfixe avant / après | Vide | A′ | A′, X | A′, X, B′ |
|---|---|---|---|---|
| Vide | 0,00 | 0,45 | 0,90 | 1,35 |
| A | 0,45 | 0,10 | 0,55 | 1,00 |
| A, B | 0,90 | 0,55 | 1,00 | 0,65 |
Regardez la dernière case. Apparier B à B′ prolonge le coût 0,55 par 0,10, soit 0,65. Les deux autres options valent chacune 1,00 + 0,45 = 1,45. Le meilleur parcours apparie donc A avec A′, insère X, puis apparie B avec B′.
Il reste à retrouver ce parcours, et pas seulement son coût. Le programme conserve les prédécesseurs, c’est-à-dire l’option choisie dans chaque case. Il remonte depuis (n, m) jusqu’à (0, 0), puis inverse cette liste pour la remettre dans l’ordre de lecture.
Le contrôle final vérifie que chaque segment apparaît exactement une fois. Le résultat est un chemin déterministe, mais plusieurs chemins pourraient avoir le même coût avant départage. Et surtout, le minimum est recherché parmi les chemins monotones autorisés, pas parmi toutes les réorganisations imaginables du document.
Signaler une différence sans confondre les signaux
Retrouver la bonne clause ne termine pas le travail
Après l’alignement, nous savons quels passages comparer. La fonction classify, dans src/pdfdiffai/changes.py, détermine ensuite le type de signal à présenter.
numbers recherche les nombres décimaux avec le mot ou l’unité qui les suit. Pour notre délai, l’information à comparer est conceptuellement « 30 avec days » puis « 45 avec days ». Ces descriptions expliquent la règle ; elles ne prétendent pas reproduire le format JSON interne de cette fonction.
Une différence entre ces éléments déclenche numeric, même avec un cosinus élevé. Regardons l’ordre des conditions dans le code fourni.
def classify(left, right, similarity=None):
    # Similarity is explanatory metadata, never a gate on the numeric check.
    if left is None:
        return {"kind": "insertion", "review": True}
    if right is None:
        return {"kind": "deletion", "review": True}
    a = numbers(left)
    b = numbers(right)
    if a != b:
        return {
            "kind": "numeric",
            "review": True,
            "left_numbers": a,
            "right_numbers": b,
        }
    if lexical(left) == lexical(right):
        return {
            "kind": "unchanged" if left == right else "presentation",
            "review": False,
        }
    return {"kind": "rewording_candidate", "review": True}
D’abord, les clauses absentes d’un côté. left is None produit insertion ; right is None produit deletion. None représente ici l’absence de segment partenaire, pas une chaîne de texte vide. Ces deux catégories demandent une relecture.
Ensuite, les nombres. Les résultats de numbers(left) et numbers(right) sont comparés. S’ils diffèrent, la fonction renvoie immédiatement numeric, avec les valeurs observées à gauche et à droite. Le paramètre similarity n’intervient dans aucune condition de l’extrait : il ne peut donc pas annuler cette alerte.
Puis, la forme lexicale. Si lexical(left) et lexical(right) sont identiques, le programme ne demande pas de relecture. Il distingue néanmoins deux cas : unchanged si les chaînes reçues sont déjà exactement égales ; presentation si elles diffèrent mais deviennent égales après le traitement lexical.
Cette nuance compte : la fonction ne compare pas directement les polices ou les coordonnées. Un changement de police qui laisse les deux chaînes extraites identiques peut donc aboutir à unchanged, pas nécessairement à presentation. Le point commun est review: False, selon les règles du parcours.
Enfin, les autres différences. La fonction renvoie rewording_candidate, littéralement un candidat à une reformulation, avec review: True. Elle ne conclut ni à une modification certaine du sens ni à une équivalence certaine.
Comprendre ce que les catégories ne disent pas
La fonction renvoie une seule catégorie. Si les nombres et la formulation changent ensemble, le contrôle numérique arrive avant et donne numeric. Cela ne signifie pas que le nombre serait la seule différence dans le passage. Il faut garder les deux textes pour la relecture.
De même, une insertion ou une suppression est d’abord une conclusion du chemin d’alignement : aucun partenaire n’a été retenu à cet endroit. Ce n’est pas toujours la preuve que le contenu est réellement nouveau ou supprimé. Le déplacement de sections montrera précisément ce cas.
Le diagnostic numérique couvre la grammaire anglaise du POC, pas toutes les dates, devises, unités ou conventions de documents. Il ne faut pas lui attribuer une conversion générale d’unités, ni supposer qu’il reconnaît tous les nombres écrits en lettres. Ces cas exigeraient des règles et des tests supplémentaires.
Nous conservons ainsi une distinction utile : le modèle rapproche, l’alignement associe, les règles signalent, la personne relit.
Reproduire le parcours validé
Préparer l’environnement CPU
Décompressez le ZIP et ouvrez un terminal à sa racine. Exécutez les commandes une seule fois et dans l’ordre présenté. Le profil validé est CPU : Docker Engine et Compose sont nécessaires ; 16 Gio de RAM et 12 Gio de disque sont recommandés. Ces recommandations ne constituent pas des minima mesurés sur toutes les machines.
Trois services ont des rôles distincts. acquisition dispose du réseau pour récupérer et vérifier les actifs verrouillés. tutorial prépare les données et réalise les contrôles. inference effectue les calculs prévus sans monter les labels ni les opérations gold, c’est-à-dire les annotations et changements attendus qui serviront à l’évaluation. tutorial et inference sont hors réseau.
Cette séparation permet de vérifier que le calcul ne consulte pas discrètement les réponses attendues. Elle ne remplace pas les droits d’accès d’une application réelle.
Commençons par le contrôle préalable, la préparation et la construction des services :
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
Le préflight vérifie les prérequis avant de lancer le reste. Le contrôle Compose doit accepter la configuration et la construction doit se terminer sans erreur. En cas d’échec, corrigez d’abord cette étape plutôt que de poursuivre avec un environnement incomplet.
Acquérir le modèle, puis vérifier le programme
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
L’acquisition utilise les actifs verrouillés du projet. Le contrôle d’environnement vérifie ensuite leur utilisation dans le conteneur ; pytest lance les tests du programme. Ces trois commandes ont des objectifs différents : disposer des fichiers, pouvoir les utiliser et vérifier des comportements attendus du code.
Un test réussi ne prouve pas que tous les rapprochements sur des documents inconnus seront corrects. Conservez le modèle et les dépendances du ZIP pour reproduire le parcours r001 ; les documentations liées dans l’article sont des compléments de compréhension, pas des instructions de mise à niveau.
Générer les documents et inspecter les entrées
docker compose run --rm tutorial python -m pdfdiffai.cli prepare --config configs/minimum.yaml
prepare écrit les PDF, les documents extraits et leur provenance. Avant de vous intéresser aux scores, examinez les passages retrouvés : le délai est-il bien présent ? Les titres et les corps sont-ils regroupés comme prévu ? Une clause à cheval sur deux pages garde-t-elle ses régions sources ?
Passons ensuite aux deux vues pédagogiques du calcul :
docker compose run --rm inference python -m pdfdiffai.cli inspect-similarity --config configs/minimum.yaml
docker compose run --rm inference python -m pdfdiffai.cli explain-alignment --config configs/minimum.yaml
inspect-similarity donne les encodages et la matrice de similarités. L’objectif est de relier une case à deux passages concrets, pas seulement de chercher la plus grande valeur.
explain-alignment expose une petite matrice pédagogique, vérifiée contre une énumération exhaustive : pour cet exemple réduit, le programme peut examiner tous les chemins permis et comparer leur meilleur coût à celui de la programmation dynamique. Ce contrôle porte sur le mécanisme de calcul ; il ne démontre pas que chaque association a le bon sens dans un document réel.
Comparer les alternatives et produire le rapport
docker compose run --rm inference python -m pdfdiffai.cli baseline --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfdiffai.cli evaluate --config configs/minimum.yaml
baseline compare les deux alternatives du projet sur les mêmes clauses. Une baseline est une méthode de référence : elle permet de juger le résultat d’une méthode par rapport à autre chose qu’une impression. Consultez leurs sorties sans attribuer aux alternatives des scores qui ne figurent pas dans les résultats publiés ci-dessous.
evaluate produit le rapport bilatéral, avec les deux versions en regard, les JSON de lignes et le viewer local. Ouvrez outputs/viewer.html, les PNG et les JSON. Pour le délai, suivez le chemin complet : passage ancien, passage nouveau, association retenue, nombres extraits, catégorie et régions sources.
Ne lancez pas encore le nettoyage : il effacera outputs/. Nous allons d’abord interpréter ces résultats, puis exécuter l’exercice.
Définir les mesures avant les chiffres
L’alignement est-il correct ?
Le F1 d’alignement compare les paires prédites aux paires gold, les correspondances attendues du corpus. La précision mesure la part des paires proposées qui sont justes ; le rappel mesure la part des paires attendues qui ont été retrouvées. Leur combinaison vaut F1 = 2 × précision × rappel / (précision + rappel) lorsque ce calcul est défini.
Prenons le décompte de l’exercice que nous lirons ensuite : huit paires proposées, toutes correctes, alors que dix étaient attendues. La précision est 8/8 = 1, mais le rappel n’est que 8/10 = 0,8. Le F1 vaut environ 0,8889, et non 0,8. Une méthode peut donc être précise sur ses appariements tout en en manquant certains.
Combien de passages ont un partenaire ?
La couverture appariée vaut 2 × nombre de paires appariées / nombre total de clauses des deux versions. Le facteur deux vient du fait qu’une paire contient une clause de chaque version.
Cette mesure ne dit pas si les associations sont justes. Apparier tous les passages arbitrairement donnerait une couverture élevée sans garantir un bon F1. À l’inverse, une insertion ou une suppression réelle doit rester sans partenaire : une couverture inférieure à 1 n’est donc pas automatiquement un défaut.
Les clauses isolées restent dans le dénominateur. On ne peut pas faire disparaître les cas difficiles du bilan simplement en choisissant de ne pas les apparier.
Le changement numérique a-t-il été retrouvé au bon endroit ?
Le rappel numérique ne vaut 1 que si chaque changement attendu se trouve dans une clause correctement appariée et si sa différence numérique est signalée. Détecter un nombre différent dans deux mauvaises clauses ne constitue pas un succès.
La précision des candidats est examinée séparément pour les insertions, suppressions, changements numériques et reformulations candidates. Cela permet de distinguer une erreur d’association d’une règle qui enverrait trop de passages à relire.
Pour les paires où seule la pagination varie, le taux de faux changements mesure les passages inutilement envoyés en relecture. Enfin, le temps moyen du protocole ne couvre que l’alignement : il exclut acquisition, rendu PDF et encodage. Ce n’est donc pas le temps complet entre le dépôt des fichiers et l’affichage du résultat dans un back-office.
Les résultats du test Nova
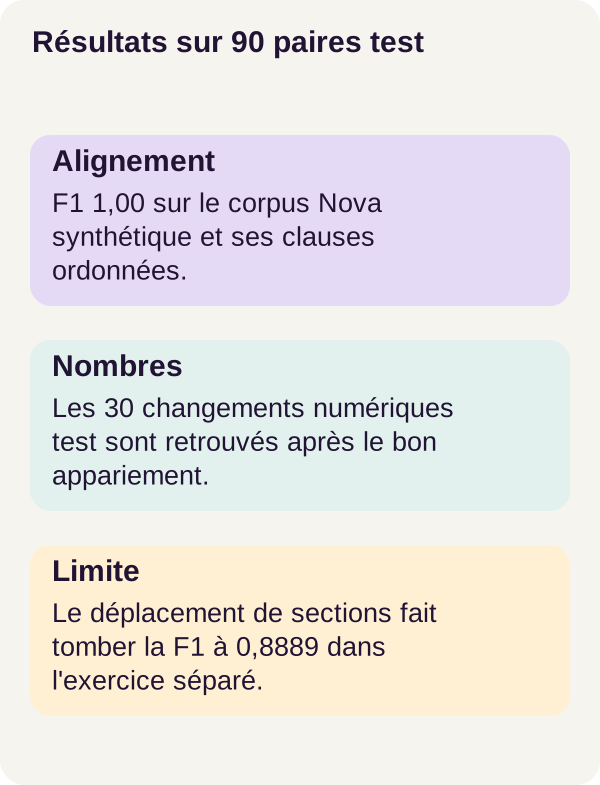
Sur les 90 paires de test, le comparateur dynamique obtient les résultats suivants :
| Mesure | Résultat de référence |
|---|---|
| Alignement | 870 paires gold alignées ; F1 = 1,00 |
| Couverture appariée | 1 740 passages sur 1 800 ; 0,9667 |
| Rappel numérique | 30 changements attendus signalés ; 1,00 |
| Faux changements sur la repagination seule | Taux de 0 sur les 30 paires concernées |
Vérifions le décompte : 2 × 870 = 1 740, puis 1 740 / 1 800 ≈ 0,9667. Les 60 passages restants sont isolés dans l’alignement. Ce nombre est cohérent avec les 30 insertions et les 30 suppressions attendues d’après la construction des paires de test ; il ne désigne pas 60 correspondances oubliées.
Ces chiffres décrivent des PDF Nova contrôlés. Ils ne valident ni un comparateur juridique ni un traitement de mises en page inconnues. La relecture reste nécessaire pour interpréter une différence, et un bon score dans cette distribution ne prédit pas celui d’un autre corpus.
Le résultat négatif : permuter deux sections
L’exercice indépendant change l’ordre de deux sections entières. Le contenu déplacé reste présent, mais le chemin monotone ne peut pas conserver librement des associations qui se croisent.
Le résultat descend à F1 = 0,8889, avec huit appariements gold sur dix et 16 passages appariés sur 20. La couverture correspondante vaut donc 16/20 = 0,8. Deux insertions et deux suppressions sont proposées.
Ces quatre alertes appartiennent à deux catégories dont la précision comme candidats à un changement de contenu est nulle dans cet exercice : elles représentent un déplacement, pas une insertion ou une suppression de contenu démontrée. Un algorithme peut respecter parfaitement son contrat d’ordre et échouer lorsque le document ne respecte plus cette hypothèse.
Synthèse avant l’exercice
Nous avons séparé trois objets : les données extraites, la décision du comparateur et la mesure par rapport aux références. La provenance permet de revenir à la source ; elle ne prouve pas que le choix de partenaire est correct. Le cosinus aide à rapprocher ; il ne neutralise pas une différence de délai. Le chemin global évite les réutilisations ; il limite aussi les déplacements possibles.
L’exercice va mettre ces distinctions à l’épreuve. L’intérêt est de prévoir quel mécanisme sera affecté, puis d’expliquer le résultat plutôt que de se contenter d’un score.
Exercice : prédire avant la correction
Écrire votre hypothèse avant de lancer la commande
Commencez par cette situation : Payment within 30 days et Payment within 45 days reçoivent une similarité presque parfaite. Doivent-elles être classées inchangées ? Retrouvez dans classify la condition qui doit trancher, sans inventer de nouveau seuil de similarité.
Imaginez ensuite que deux sections échangent entièrement leur place sans changer leur contenu. Le chemin global peut-il conserver tous les appariements ? Une insertion proposée prouve-t-elle alors l’apparition d’un nouveau texte ? Distinguez le problème de classement des passages de celui de leur contenu.
Notez vos réponses, puis lancez le scénario fourni :
docker compose run --rm tutorial python -m pdfdiffai.cli exercise --config configs/exercise.yaml
Comparer votre prédiction aux sorties
Pour les 30 et 45 jours, la comparaison numérique garde la priorité et doit demander une relecture. Modifier la valeur explicative de similarité ne change pas les conditions visibles dans classify : aucun test sur cette valeur n’y autorise à ignorer les nombres.
Pour la permutation, l’hypothèse d’ordre est rompue. Le programme peut préférer des insertions et suppressions parce qu’il ne dispose pas d’une opération permettant de déplacer librement une section. Il ne faut pas renommer ces alertes « reformulations certaines ».
Retrouvez dans les sorties les huit appariements corrects, les deux insertions et les deux suppressions, puis revenez aux passages sources. La correction consiste à relier ces alertes au déplacement, sans prétendre que le comparateur a automatiquement résolu ce cas. Reconnaître la limite est le résultat de l’exercice ; une détection générale des déplacements n’est pas une fonctionnalité ajoutée au POC.
Produire les figures et nettoyer
Après l’exercice, générez les figures et lancez le contrôle des fichiers prévu par le parcours :
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
La présence d’une commande nommée check_checkpoints.py ne signifie pas qu’un entraînement vient d’avoir lieu. MiniLM reste gelé ; le script appartient aux contrôles de fichiers du projet.
Ouvrez les figures, outputs/viewer.html et les JSON avant de poursuivre. Conservez les résultats utiles, notamment les cas où un signal d’insertion ou de suppression correspond en réalité à un déplacement.
Les trois dernières commandes arrêtent le projet, affichent puis effacent uniquement outputs/, puis terminent le parcours. Le corpus et les actifs sont conservés.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Le nettoyage ne corrige pas une erreur d’alignement et n’améliore pas une métrique : il remet simplement les sorties à zéro. Aucun nettoyage Docker global n’est demandé.
Adapter, dépanner et nettoyer
Diagnostiquer dans l’ordre du traitement
L’environnement ou l’acquisition échoue ? Commencez par le préflight et check_environment.py, puis contrôlez les checksums d’acquisition, les empreintes attendues des fichiers. Ne remplacez pas les versions verrouillées par des fichiers trouvés ailleurs pour faire disparaître l’erreur.
Les passages sont absents, coupés ou mal regroupés ? Inspectez les glyphes, les régions, les titres détectés et les zones exclues. Un en-tête mal exclu ou une césure non réparée relève d’abord de l’extraction, pas de MiniLM.
Une matrice ou un rapport semble incohérent ? Suivez les JSON d’encodage, d’alignement et d’évaluation. Examinez séparément le partenaire retenu et la catégorie attribuée. Deux passages peuvent être proches mais mal appariés ; un appariement peut être correct alors que la formulation appelle tout de même une relecture.
La formulation change sans alerte ? Vérifiez quelles différences le traitement lexical a effacées et ce que numbers reconnaît réellement. Des insertions et suppressions apparaissent autour de sections déplacées ? Comparez l’ordre des clauses avant de modifier les coûts : une autre pondération ne supprime pas la contrainte de monotonie.
Définir un nouveau périmètre avant d’élargir le comparateur
Pour traiter des documents réels autorisés, constituez des corpus distincts par source, langue et type de mise en page. Mesurez les déplacements, mais aussi les fusions et divisions de clauses, les colonnes, les tableaux et les scans, avant d’ajuster un seuil.
Un appariement élémentaire de ce parcours relie une clause à une clause. Diviser un passage en deux ou en fusionner plusieurs constitue donc une autre difficulté que changer quelques mots. De même, ajouter un OCR pour les scans modifierait les entrées et leurs erreurs possibles : ce serait une extension à évaluer, pas une capacité déjà validée ici.
Dans une interface réelle, distinguez le candidat produit par le comparateur de la conclusion de la personne qui relit. Ajoutez un état « rejeté / incertain », des droits documentaires et une revue humaine. Un utilisateur doit pouvoir retrouver les deux versions, comprendre la catégorie et constater qu’un passage sans partenaire n’est pas nécessairement un contenu supprimé.
Il reste aussi à prévoir une API asynchrone, c’est-à-dire un traitement dont on consulte le résultat après soumission, ainsi que la journalisation, la sauvegarde et la restauration. Ces fonctions sont des travaux de produit, pas des fonctionnalités fournies par le tutoriel.
Enfin, le POC n’est ni une sandbox complète du parseur PDF, ni une politique de conservation. Les documents et les chaînes extraites sont des données, jamais des instructions à exécuter. L’isolement du traitement et les droits sur les fichiers demandent une conception propre au service déployé.
Références pour approfondir
Les références du parcours sont la carte MiniLM officielle, pour le modèle et le pooling, et la documentation NumPy sur les tableaux, pour les dimensions et l’indexation des matrices.
Les compléments liés au fil du texte expliquent la normalisation Unicode, les tokens WordPiece, le cosinus et la comparaison des tuples Python. Les petits calculs illustratifs ne constituent pas de nouvelles mesures sur Nova. Pour reproduire les résultats, les versions, réglages et commandes de référence restent ceux du ZIP r001.