





Il problema: una clausola spostata e una scadenza modificata
Immaginate una funzione del vostro back-office: un utente carica due versioni di una guida e vuole sapere cosa è cambiato. Potreste estrarre il testo, eseguire un diff e mostrare le righe aggiunte o rimosse. Il principio ricorda il confronto di file in Git.
Ma ecco le due versioni della fittizia «Nova Service Policy». La seconda usa un altro carattere e un'altra paginazione. Un paragrafo ora occupa quattro righe invece di tre; il successivo passa a un'altra pagina. Il testo non è necessariamente cambiato, ma le sue righe e coordinate non corrispondono più.
In questa nuova presentazione si nasconde una modifica reale: «Payment is due within 30 days» diventa «Payment is due within 45 days». In altre parole, il termine passa da 30 a 45 giorni. Un diff riga per riga può nascondere questa modifica tra gli a capo. Al contrario, un modello di similarità può trovare le due frasi molto vicine: parlano ancora dello stesso argomento, con quasi le stesse parole.
Abbiamo dunque due domande diverse: quali passaggi confrontare e, poi, che cosa differisce tra loro? Trovare un passaggio vicino non basta per dichiararlo invariato.
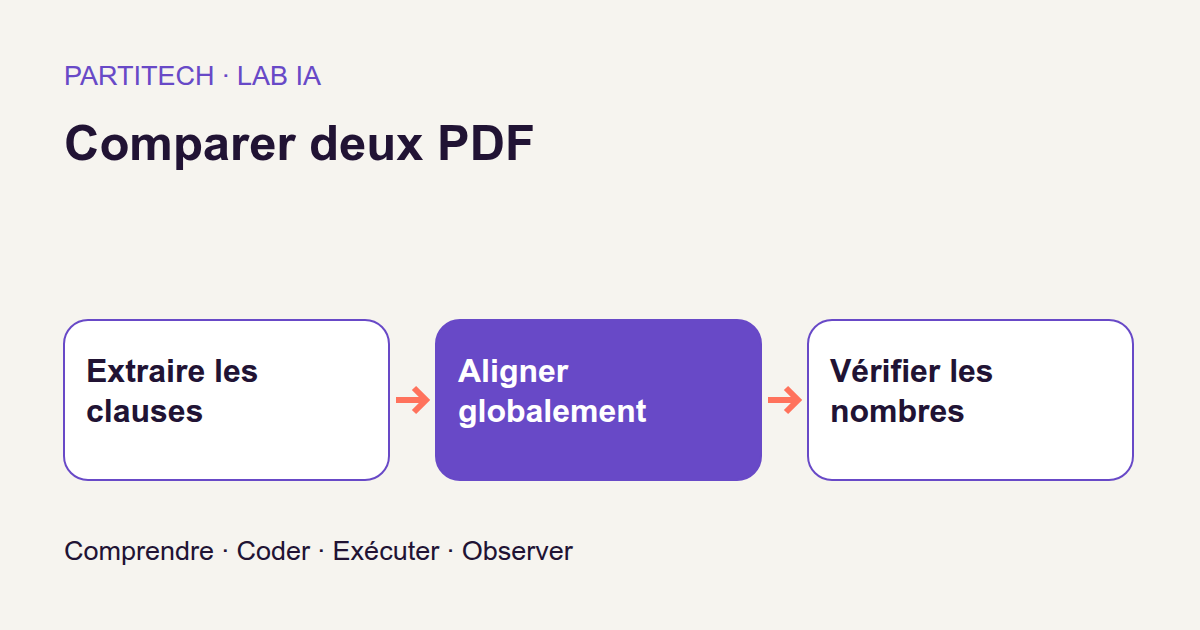
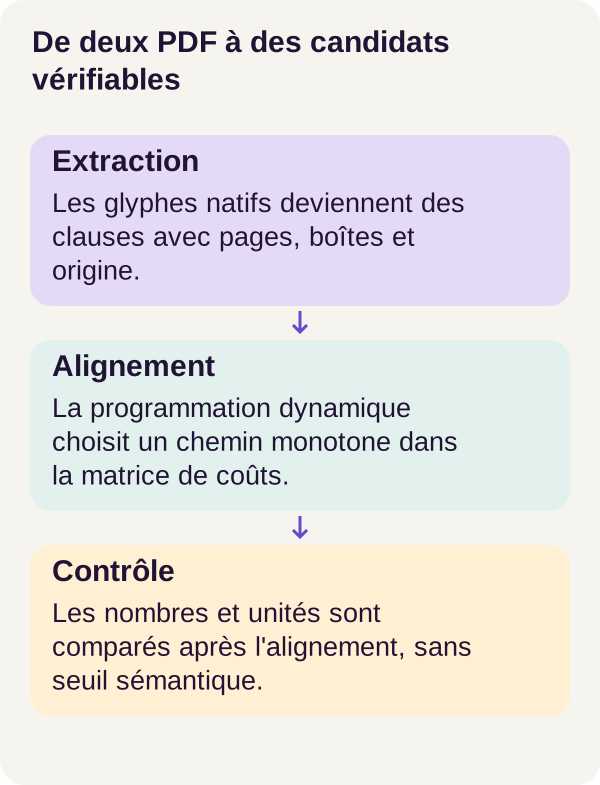
Questo tutorial realizza un comparatore locale per PDF nativi, cioè contenenti testo utilizzabile e non solo immagini di una scansione. Il percorso è: glifi → clausole → vettori di similarità → allineamento globale → controlli espliciti → passaggi da rileggere. Il vocabolario verrà spiegato progressivamente; potete affrontare il progetto con basi di Python, tabelle e Docker, senza aver già addestrato un modello.
Il risultato è un elenco di candidati da rileggere con la provenienza nei due PDF. Non è né un parere legale né una garanzia che una riformulazione conservi lo stesso significato. Impareremo soprattutto a far collaborare un modello e delle regole, anziché chiedere al modello di decidere tutto.
Scaricare il progetto completo.
Ciò che i dati mostrano davvero
Tre modi di modificare una stessa guida
Il corpus Nova contiene 40 famiglie e tre coppie per famiglia, ossia 120 coppie di veri PDF nativi. Questi file sono generati per l'esperimento: «veri PDF» significa che trattiamo realmente questo formato, non che i documenti provengano da clienti.
In ogni famiglia, una coppia cambia soltanto la presentazione. Un'altra modifica il termine e la punteggiatura. La terza inserisce una clausola, ne elimina una e riformula un contatto. Questa costruzione permette di sapere quali differenze erano attese prima di eseguire il comparatore.
Le famiglie da 0 a 9 costituiscono lo sviluppo, cioè 30 coppie; le altre 30 costituiscono il test, cioè 90 coppie. Una famiglia non attraversa i due insiemi. Lo sviluppo serve a lavorare sul metodo; il test serve a misurare il comportamento scelto, senza correggerlo dopo averne visto le risposte.
Qui non separiamo un addestramento neurale e un test: il modello preaddestrato resta congelato. La separazione serve comunque a evitare di progettare le regole sugli esempi usati per annunciare i risultati. La grammatica generativa resta comune alle famiglie; questo protocollo non rappresenta quindi automaticamente la varietà dei vostri documenti.
Ricostruire clausole, non solo recuperare una stringa
Un glifo è la forma di un carattere disegnata nel PDF, accompagnata da una posizione. Il programma parte da questi elementi visibili. Il suo segmentatore, il codice che divide il documento in passaggi, raggruppa le righe per posizione e individua i titoli in grassetto per ricostruire le clausole.
Qui una clausola è l'unità di passaggio che confronteremo. Non è una categoria giuridica riconosciuta dal programma. Occorre prima che l'estrazione abbia raggruppato correttamente gli elementi del documento.
Ogni clausola conserva un elenco di regioni sorgenti: documento, impronta SHA-256, indice di pagina, riquadro e identificatori dei glifi. Un riquadro è semplicemente un rettangolo che localizza il passaggio nella pagina. Se una clausola inizia su una pagina e termina sulla successiva, conserva più riquadri: non si può riassumere fedelmente questa provenienza con un solo rettangolo.
Per uno sviluppatore web, questa provenienza ricorda il legame tra un risultato visualizzato e i record che lo hanno prodotto. Permette di tornare al documento e alle aree giuste. L'impronta SHA-256, calcolata dal file, aiuta a identificare la versione usata; non certifica la correttezza dell'abbinamento proposto.
Normalizzare senza perdere il percorso verso l'originale
Per confrontare i testi, il progetto applica NFKC, converte in minuscolo e unisce gli spazi. NFKC è una forma di normalizzazione Unicode: avvicina in particolare diverse rappresentazioni di caratteri. La documentazione Python di unicodedata.normalize descrive questa operazione.
Prendiamo un esempio didattico, indipendente dalle misure Nova. La stringa office può contenere un unico carattere Unicode per la legatura ffi. Dopo NFKC diventa office: le tre lettere f, f e i sono separate. La specifica Unicode dettaglia questa trasformazione e le distinzioni che una normalizzazione di compatibilità può cancellare.
Se il glifo della legatura avesse, nel nostro esempio, l'identificatore G17, i tre caratteri normalizzati devono poter rimandare a quel medesimo glifo. Il progetto conserva appunto una mappa dal carattere normalizzato ai glifi originali. Non presume che un carattere normalizzato corrisponda sempre a un unico carattere sorgente distinto.
Allo stesso modo, uniformare Payment, PAYMENT e gli spazi facilita il confronto, ma fa sparire alcune differenze di forma. Il testo normalizzato non permette da solo di ricostruire l'originale. Per questo si conservano sia la rappresentazione di lavoro sia la sua provenienza. Questa scelta di normalizzazione appartiene al protocollo; occorrerà riesaminarne la pertinenza prima di confrontare altri tipi di documenti.
Ciò che l'estrazione non ripara
Le intestazioni e i piè di pagina sono esclusi tramite area dichiarata: la loro posizione viene fornita, non scoperta automaticamente dal modello. Le sillabazioni non sono riparate automaticamente. Una parola spezzata a fine riga può quindi richiedere un trattamento aggiuntivo in un altro corpus.
Una cattiva estrazione non diventa corretta perché il modello vettoriale è valido. Se manca un passaggio o due clausole sono state fuse per errore, ispezionate prima questa fase. Il comparatore lavora sulle clausole che riceve, non su una versione ideale del documento.
Embedding: vicini non significa identici
Trasformare una clausola in numeri
Un embedding è un vettore, cioè un elenco di numeri che rappresenta un testo in uno spazio appreso. Il modello del POC, o prova di concetto, è all-MiniLM-L6-v2. La sua scheda ufficiale descrive vettori di 384 dimensioni e la loro costruzione tramite pooling.
Il modello serve qui da encoder: trasforma un input in una rappresentazione numerica. Non redige un'analisi delle modifiche. I suoi parametri restano congelati e quindi invariati durante il percorso. Facciamo inferenza, cioè usiamo un modello già addestrato, non fine-tuning su Nova.
Il calcolo usa FP32 su CPU: numeri in virgola mobile a 32 bit elaborati dal processore. In questo tutorial non è richiesto né usato alcun GPU.
I 384 valori non corrispondono a 384 campi aziendali nominati. Non abbiamo, per esempio, una casella «termine» in cui il modello collochi fedelmente il numero di giorni. Proprio per questo aggiungeremo poi un controllo numerico esplicito.
Token, finestre e media ponderata
Un tokenizer divide il testo in unità che il modello può trattare. Qui si tratta di WordPiece: un token può essere una parola o un pezzo di parola, non necessariamente un carattere o una parola intera. La documentazione dei tokenizer di Transformers spiega questa segmentazione.
Il pooling riunisce le rappresentazioni dei token per ottenere un vettore del passaggio. Occorre distinguere questa operazione dalla seconda media usata dal progetto per le clausole lunghe.
Il tokenizer divide infatti una clausola lunga in finestre di 254 wordpiece di contenuto. Il percorso codifica tutte le finestre, fa la media dei loro vettori in base al numero di token, poi normalizza il vettore ottenuto. Una clausola lunga segue questo percorso in una famiglia su cinque. Non sostituiamo dunque una clausola lunga con il solo inizio.
Per capire la ponderazione, prendiamo due finestre fittizie di 254 e 46 token. Con i vettori v1 e v2, la media è (254 × v1 + 46 × v2) / 300, e non (v1 + v2) / 2. La piccola finestra finale non pesa quanto quella grande solo perché costituisce una finestra aggiuntiva.
Riducendo i vettori a due dimensioni per poter calcolare a mano, supponiamo v1 = (1 ; 0) e v2 = (0 ; 1). La media vale circa (0,8467 ; 0,1533). La sua normalizzazione in lunghezza dà circa (0,9840 ; 0,1782). Questi valori servono solo a spiegare il calcolo; non sono output di MiniLM.
Codificare tutte le finestre evita di ignorarne una, ma non crea un contesto unico in cui ogni token possa interagire con l'intera clausola. La media condensa le loro rappresentazioni; non conserva automaticamente tutti i dettagli né tutte le loro relazioni.
Confrontare le direzioni, non certificare un'equivalenza
La similarità coseno confronta la direzione di due vettori. Per vettori non nulli u e v, vale prodotto_scalare(u, v) / (lunghezza(u) × lunghezza(v)). Un valore vicino a 1 indica direzioni vicine. Quando i due vettori sono normalizzati in lunghezza, basta il prodotto scalare, come spiega la documentazione Sentence Transformers.
Un esempio a due dimensioni mostra la differenza rispetto all'uguaglianza: (1 ; 0) e (2 ; 0) hanno la stessa direzione, dunque un coseno di 1, senza essere due elenchi di numeri identici. Con i testi, un punteggio elevato non è neppure un certificato di equivalenza.
Per n clausole prima e m clausole dopo, il programma produce una matrice n × m: una tabella con una riga per clausola vecchia e una colonna per clausola nuova. La cella [i, j] contiene la vicinanza di queste due clausole.
Torniamo ai 30 e 45 giorni. Anche se la loro similarità fosse 0,99, questo numero non significherebbe «99% di probabilità che nulla sia cambiato». Aiuterebbe a riconoscere che i due passaggi corrispondono. La differenza di termine deve restare visibile nella fase successiva. Vicini significa qui “buoni candidati da confrontare”, non “intercambiabili”.
Costruire il percorso globale
Perché non prendere il miglior vicino di ogni clausola?
Supponiamo che due vecchie clausole assomiglino entrambe alla stessa nuova clausola. Se ognuna sceglie indipendentemente il proprio miglior vicino, il comparatore può riutilizzare quel passaggio due volte e ignorarne un altro.
La funzione align, in src/pdfdiffai/align.py, sceglie invece un allineamento globale. Ogni segmento deve comparire esattamente una volta: in un abbinamento oppure isolato come inserimento o eliminazione. Abbinare significa associare una clausola della versione precedente a una clausola della versione successiva; non significa dichiararle identiche.
Il percorso è anche monotono: avanza nell'ordine dei due documenti senza tornare indietro. Se una vecchia clausola A precede B, le loro corrispondenze non possono incrociarsi nella nuova versione.
Questo vincolo accetta una clausola spinta su un'altra pagina finché l'ordine delle sezioni resta globalmente conservato. Non permette di permutare liberamente due sezioni intere. Misureremo questo limite nell'esercizio.
Trasformare la vicinanza in costo
Cerchiamo il percorso a costo minimo. Un costo basso rende un'opzione attraente; non è una probabilità di errore. Il costo di abbinamento combina tre termini, fissati prima dell'inferenza:
0,7 × (1 − coseno) + penalità di titolo + 0,1 × distanza di posizione relativa.
La penalità di titolo vale 0,2 se i token del titolo differiscono, altrimenti zero. Un inserimento e un'eliminazione costano ciascuno 0,45. Questi valori sono scelte del protocollo, non parametri appresi durante il percorso.
Per esempio, con un coseno fittizio di 0,98, token di titolo diversi e una distanza relativa di 0,10, il costo vale 0,7 × 0,02 + 0,2 + 0,1 × 0,10 = 0,224. La vicinanza testuale è forte, ma gli altri indizi continuano a contribuire.
Eliminare una clausola e poi inserirne un'altra costa 0,45 + 0,45 = 0,90. Confrontare questi costi aiuta a capire le possibili scelte. Non è però una soglia decisionale indipendente per ogni coppia: l'allineamento deve restare compatibile anche con le altre clausole.
Programmazione dinamica: memorizzare i migliori inizi di percorso
La programmazione dinamica evita di ricalcolare tutti i percorsi possibili. Conserva la soluzione migliore per ogni coppia di inizi dei documenti, quindi si appoggia a questi risultati per avanzare.
distance[i, j] rappresenta il costo minimo per trattare le prime i clausole della versione precedente e le prime j clausole della versione successiva. La matrice ha quindi n + 1 righe e m + 1 colonne. Lo zero permette di rappresentare un inizio di documento ancora vuoto.
La cella distance[0, 0] vale zero. Sulla prima riga è possibile soltanto l'inserimento; sulla prima colonna soltanto l'eliminazione. Con il costo 0,45, questi bordi accumulano quindi 0, 0,45, 0,90 e così via.
Ecco l'estratto centrale del progetto. Interviene all'interno del calcolo, dopo la preparazione delle matrici e degli indici; non è un programma autonomo da eseguire da solo.
value, rank, operation = min(
    (distance[i - 1, j - 1] + cost[i - 1, j - 1], 0, "M"),
    (distance[i - 1, j] + deletion, 1, "D"),
    (distance[i, j - 1] + insertion, 2, "I"),
)
La diagonale, M, abbina due clausole. Riprende il miglior costo dei rispettivi prefissi precedenti e aggiunge il costo dell'abbinamento corrente. cost[i - 1, j - 1] usa indici diminuiti di uno perché questa matrice non possiede i bordi vuoti di distance.
Il movimento verticale, D, consuma una vecchia clausola senza corrispondenza. Aggiunge il costo di eliminazione. Il movimento orizzontale, I, consuma una nuova clausola senza corrispondenza. Aggiunge il costo di inserimento. «Consumare» significa qui integrarla nel risultato dell'allineamento; nessuna clausola viene cancellata dai PDF sorgenti.
Ogni opzione è una tupla che contiene il costo, un rango di priorità e il nome dell'operazione. Python confronta le tuple elemento per elemento. In caso di perfetta parità di costo, i ranghi 0, 1, 2 danno priorità all'abbinamento, poi all'eliminazione, poi all'inserimento. Questo spareggio rende la scelta riproducibile; non aggiunge una prova della sua correttezza.
Un piccolo allineamento da rifare a mano
Prendiamo un esempio didattico: la versione precedente contiene A, B, e quella successiva A′, X, B′. Abbiamo scelto i costi seguenti per rappresentare due corrispondenze attraenti e un passaggio inserito. Non provengono dalla codifica di Nova.
| Costo di abbinamento | A′ | X | B′ |
|---|---|---|---|
| A | 0,10 | 1,20 | 1,20 |
| B | 1,20 | 1,20 | 0,10 |
Con inserimenti ed eliminazioni a 0,45, la matrice dei migliori costi cumulati diventa:
| Prefisso prima / dopo | Vuoto | A′ | A′, X | A′, X, B′ |
|---|---|---|---|---|
| Vuoto | 0,00 | 0,45 | 0,90 | 1,35 |
| A | 0,45 | 0,10 | 0,55 | 1,00 |
| A, B | 0,90 | 0,55 | 1,00 | 0,65 |
Guardate l'ultima cella. Abbinare B a B′ prolunga il costo 0,55 di 0,10, cioè 0,65. Le altre due opzioni valgono ciascuna 1,00 + 0,45 = 1,45. Il percorso migliore abbina quindi A ad A′, inserisce X, poi abbina B a B′.
Resta da ritrovare questo percorso, non soltanto il suo costo. Il programma conserva i predecessori, cioè l'opzione scelta in ogni cella. Risale da (n, m) fino a (0, 0), poi inverte l'elenco per rimetterlo nell'ordine di lettura.
Il controllo finale verifica che ogni segmento compaia esattamente una volta. Il risultato è un percorso deterministico, ma più percorsi potrebbero avere lo stesso costo prima dello spareggio. E soprattutto, il minimo viene cercato tra i percorsi monotoni autorizzati, non tra tutte le possibili riorganizzazioni del documento.
Segnalare una differenza senza confondere i segnali
Trovare la clausola giusta non conclude il lavoro
Dopo l'allineamento sappiamo quali passaggi confrontare. La funzione classify, in src/pdfdiffai/changes.py, determina poi il tipo di segnale da presentare.
numbers cerca i numeri decimali con la parola o l'unità che li segue. Per il nostro termine, l'informazione da confrontare è concettualmente «30 con days» e poi «45 con days». Queste descrizioni spiegano la regola; non pretendono di riprodurre il formato JSON interno della funzione.
Una differenza tra questi elementi attiva numeric, anche con un coseno elevato. Guardiamo l'ordine delle condizioni nel codice fornito.
def classify(left, right, similarity=None):
    # Similarity is explanatory metadata, never a gate on the numeric check.
    if left is None:
        return {"kind": "insertion", "review": True}
    if right is None:
        return {"kind": "deletion", "review": True}
    a = numbers(left)
    b = numbers(right)
    if a != b:
        return {
            "kind": "numeric",
            "review": True,
            "left_numbers": a,
            "right_numbers": b,
        }
    if lexical(left) == lexical(right):
        return {
            "kind": "unchanged" if left == right else "presentation",
            "review": False,
        }
    return {"kind": "rewording_candidate", "review": True}
Prima, le clausole assenti da un lato. left is None produce insertion; right is None produce deletion. None rappresenta qui l'assenza del segmento partner, non una stringa di testo vuota. Entrambe le categorie richiedono una rilettura.
Poi, i numeri. I risultati di numbers(left) e numbers(right) vengono confrontati. Se differiscono, la funzione restituisce immediatamente numeric, con i valori osservati a sinistra e a destra. Il parametro similarity non interviene in alcuna condizione dell'estratto: non può quindi annullare questo avviso.
Poi, la forma lessicale. Se lexical(left) e lexical(right) sono identici, il programma non chiede una rilettura. Distingue tuttavia due casi: unchanged se le stringhe ricevute sono già esattamente uguali; presentation se differiscono ma diventano uguali dopo il trattamento lessicale.
Questa sfumatura conta: la funzione non confronta direttamente caratteri tipografici o coordinate. Un cambio di carattere che lasci identiche le due stringhe estratte può dunque dare unchanged, non necessariamente presentation. Il punto comune è review: False, secondo le regole del percorso.
Infine, le altre differenze. La funzione restituisce rewording_candidate, letteralmente un candidato a riformulazione, con review: True. Non conclude né che il significato sia certamente cambiato né che l'equivalenza sia certa.
Capire ciò che le categorie non dicono
La funzione restituisce una sola categoria. Se numeri e formulazione cambiano insieme, il controllo numerico arriva prima e restituisce numeric. Ciò non significa che il numero sia l'unica differenza nel passaggio. Per la rilettura bisogna conservare entrambi i testi.
Allo stesso modo, un inserimento o un'eliminazione è anzitutto una conclusione del percorso di allineamento: in quel punto non è stato scelto alcun partner. Non è sempre la prova che il contenuto sia davvero nuovo o rimosso. Lo spostamento delle sezioni mostrerà proprio questo caso.
La diagnosi numerica copre la grammatica inglese del POC, non tutte le date, valute, unità o convenzioni dei documenti. Non bisogna attribuirle una conversione generale delle unità, né supporre che riconosca tutti i numeri scritti in lettere. Questi casi richiederebbero regole e test aggiuntivi.
Conserviamo così una distinzione utile: il modello avvicina, l'allineamento associa, le regole segnalano, la persona rilegge.
Riprodurre il percorso convalidato
Preparare l'ambiente CPU
Decomprimete lo ZIP e aprite un terminale nella sua radice. Eseguite i comandi una sola volta e nell'ordine indicato. Il profilo convalidato è CPU: sono necessari Docker Engine e Compose; sono consigliati 16 GiB di RAM e 12 GiB di disco. Queste raccomandazioni non sono minimi misurati su tutte le macchine.
Tre servizi hanno ruoli distinti. acquisition dispone della rete per recuperare e verificare le risorse bloccate. tutorial prepara i dati ed esegue i controlli. inference effettua i calcoli previsti senza montare le labels né le operazioni gold, cioè le annotazioni e modifiche attese che serviranno alla valutazione. tutorial e inference sono senza rete.
Questa separazione permette di verificare che il calcolo non consulti di nascosto le risposte attese. Non sostituisce i diritti di accesso di un'applicazione reale.
Iniziamo con il controllo preliminare, la preparazione e la compilazione dei servizi:
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
Il preflight verifica i prerequisiti prima di avviare il resto. Il controllo Compose deve accettare la configurazione e la compilazione deve terminare senza errore. In caso di errore, correggete prima questa fase anziché proseguire con un ambiente incompleto.
Acquisire il modello, poi verificare il programma
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
L'acquisizione usa le risorse bloccate del progetto. Il controllo dell'ambiente ne verifica poi l'uso nel contenitore; pytest esegue i test del programma. Questi tre comandi hanno obiettivi diversi: disporre dei file, poterli usare e verificare comportamenti attesi del codice.
Un test riuscito non prova che tutti gli abbinamenti su documenti sconosciuti saranno corretti. Conservate il modello e le dipendenze dello ZIP per riprodurre il percorso r001; le documentazioni collegate nell'articolo sono complementi per capire, non istruzioni di aggiornamento.
Generare i documenti e ispezionare gli input
docker compose run --rm tutorial python -m pdfdiffai.cli prepare --config configs/minimum.yaml
prepare scrive i PDF, i documenti estratti e la loro provenienza. Prima di interessarvi ai punteggi, esaminate i passaggi ritrovati: il termine è presente? Titoli e corpi sono raggruppati come previsto? Una clausola a cavallo di due pagine conserva le sue regioni sorgenti?
Passiamo quindi alle due viste didattiche del calcolo:
docker compose run --rm inference python -m pdfdiffai.cli inspect-similarity --config configs/minimum.yaml
docker compose run --rm inference python -m pdfdiffai.cli explain-alignment --config configs/minimum.yaml
inspect-similarity fornisce le codifiche e la matrice delle similarità. L'obiettivo è collegare una cella a due passaggi concreti, non soltanto cercare il valore più grande.
explain-alignment mostra una piccola matrice didattica, verificata rispetto a una enumerazione esaustiva: per questo esempio ridotto, il programma può esaminare tutti i percorsi consentiti e confrontare il loro costo migliore con quello della programmazione dinamica. Questo controllo riguarda il meccanismo di calcolo; non dimostra che ogni associazione abbia il giusto significato in un documento reale.
Confrontare le alternative e produrre il rapporto
docker compose run --rm inference python -m pdfdiffai.cli baseline --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfdiffai.cli evaluate --config configs/minimum.yaml
baseline confronta le due alternative del progetto sulle stesse clausole. Una baseline è un metodo di riferimento: permette di giudicare il risultato di un metodo rispetto a qualcosa di diverso da un'impressione. Consultate i loro output senza attribuire alle alternative punteggi che non compaiono nei risultati pubblicati qui sotto.
evaluate produce il rapporto bilaterale, con le due versioni affiancate, i JSON delle righe e il visualizzatore locale. Aprite outputs/viewer.html, i PNG e i JSON. Per il termine, seguite il percorso completo: vecchio passaggio, nuovo passaggio, associazione scelta, numeri estratti, categoria e regioni sorgenti.
Non avviate ancora la pulizia: cancellerà outputs/. Prima interpreteremo questi risultati, poi eseguiremo l'esercizio.
Definire le misure prima dei numeri
L'allineamento è corretto?
L'F1 di allineamento confronta le coppie previste con le coppie gold, le corrispondenze attese del corpus. La precisione misura la quota di coppie proposte che è corretta; il richiamo misura la quota di coppie attese ritrovate. La loro combinazione vale F1 = 2 × precisione × richiamo / (precisione + richiamo) quando il calcolo è definito.
Prendiamo il conteggio dell'esercizio che leggeremo dopo: otto coppie proposte, tutte corrette, mentre dieci erano attese. La precisione è 8/8 = 1, ma il richiamo è soltanto 8/10 = 0,8. L'F1 vale circa 0,8889, non 0,8. Un metodo può dunque essere preciso nei suoi abbinamenti pur mancando alcuni di essi.
Quanti passaggi hanno un partner?
La copertura abbinata vale 2 × numero di coppie abbinate / numero totale di clausole delle due versioni. Il fattore due deriva dal fatto che una coppia contiene una clausola di ogni versione.
Questa misura non dice se le associazioni sono corrette. Abbinare arbitrariamente tutti i passaggi darebbe una copertura elevata senza garantire un buon F1. Al contrario, un inserimento o un'eliminazione reali devono restare senza partner: una copertura inferiore a 1 non è quindi automaticamente un difetto.
Le clausole isolate restano nel denominatore. Non si possono far sparire i casi difficili dal bilancio scegliendo semplicemente di non abbinarli.
La modifica numerica è stata ritrovata nel punto giusto?
Il richiamo numerico vale 1 solo se ogni modifica attesa si trova in una clausola correttamente abbinata e se la sua differenza numerica è segnalata. Rilevare un numero diverso in due clausole sbagliate non è un successo.
La precisione dei candidati viene esaminata separatamente per inserimenti, eliminazioni, modifiche numeriche e candidati a riformulazione. Ciò permette di distinguere un errore di associazione da una regola che manderebbe troppi passaggi in rilettura.
Per le coppie in cui varia solo la paginazione, il tasso di falsi cambiamenti misura i passaggi inviati inutilmente in rilettura. Infine, il tempo medio del protocollo copre solo l'allineamento: esclude acquisizione, rendering PDF e codifica. Non è dunque il tempo completo tra il caricamento dei file e la visualizzazione del risultato in un back-office.
I risultati del test Nova
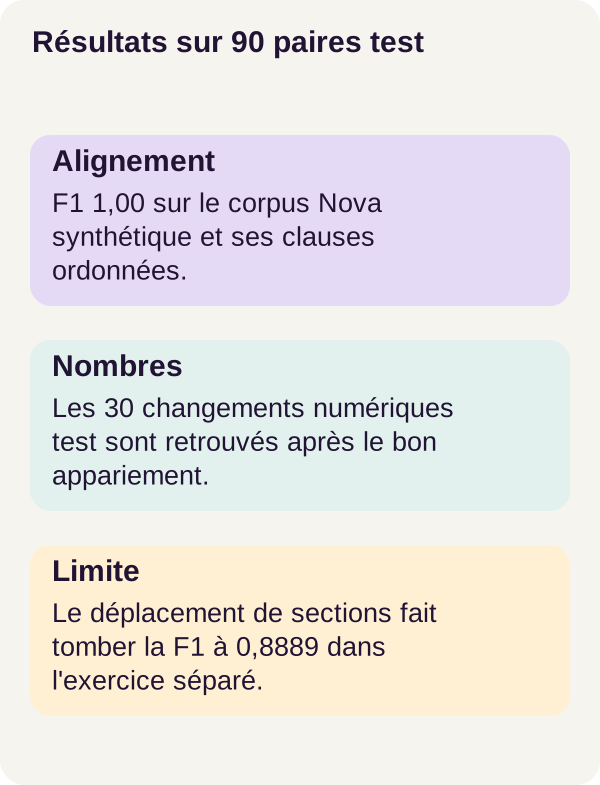
Sulle 90 coppie di test, il comparatore dinamico ottiene i risultati seguenti:
| Misura | Risultato di riferimento |
|---|---|
| Allineamento | 870 coppie gold allineate; F1 = 1,00 |
| Copertura abbinata | 1 740 passaggi su 1 800; 0,9667 |
| Richiamo numerico | 30 modifiche attese segnalate; 1,00 |
| Falsi cambiamenti nella sola ripaginazione | Tasso di 0 sulle 30 coppie interessate |
Verifichiamo il conteggio: 2 × 870 = 1 740, poi 1 740 / 1 800 ≈ 0,9667. I 60 passaggi rimanenti sono isolati nell'allineamento. Questo numero è coerente con i 30 inserimenti e le 30 eliminazioni attesi dalla costruzione delle coppie di test; non indica 60 corrispondenze dimenticate.
Questi numeri descrivono PDF Nova controllati. Non convalidano né un comparatore giuridico né un trattamento di impaginazioni sconosciute. La rilettura resta necessaria per interpretare una differenza, e un buon punteggio in questa distribuzione non predice quello di un altro corpus.
Il risultato negativo: permutare due sezioni
L'esercizio indipendente cambia l'ordine di due sezioni intere. Il contenuto spostato resta presente, ma il percorso monotono non può conservare liberamente associazioni che si incrociano.
Il risultato scende a F1 = 0,8889, con otto abbinamenti gold su dieci e 16 passaggi abbinati su 20. La copertura corrispondente vale dunque 16/20 = 0,8. Vengono proposti due inserimenti e due eliminazioni.
Questi quattro avvisi appartengono a due categorie la cui precisione come candidate a una modifica di contenuto è nulla in questo esercizio: rappresentano uno spostamento, non un inserimento o un'eliminazione di contenuto dimostrati. Un algoritmo può rispettare perfettamente il suo contratto d'ordine e fallire quando il documento non rispetta più questa ipotesi.
Sintesi prima dell'esercizio
Abbiamo separato tre oggetti: i dati estratti, la decisione del comparatore e la misura rispetto ai riferimenti. La provenienza permette di tornare alla sorgente; non prova che la scelta del partner sia corretta. Il coseno aiuta ad avvicinare; non neutralizza una differenza di termine. Il percorso globale evita i riutilizzi; limita anche gli spostamenti possibili.
L'esercizio metterà alla prova queste distinzioni. L'interesse è prevedere quale meccanismo sarà coinvolto, quindi spiegare il risultato anziché limitarsi a un punteggio.
Esercizio: prevedere prima della correzione
Scrivere la vostra ipotesi prima di eseguire il comando
Partite da questa situazione: Payment within 30 days e Payment within 45 days ricevono una similarità quasi perfetta. Devono essere classificate come invariate? Trovate in classify la condizione che deve decidere, senza inventare una nuova soglia di similarità.
Immaginate poi che due sezioni si scambino interamente posizione senza cambiare contenuto. Il percorso globale può conservare tutti gli abbinamenti? Un inserimento proposto prova allora la comparsa di un nuovo testo? Distinguete il problema di classificazione dei passaggi da quello del loro contenuto.
Annotate le vostre risposte, quindi avviate lo scenario fornito:
docker compose run --rm tutorial python -m pdfdiffai.cli exercise --config configs/exercise.yaml
Confrontare la previsione con gli output
Per i 30 e 45 giorni, il confronto numerico mantiene la priorità e deve richiedere una rilettura. Modificare il valore esplicativo di similarità non cambia le condizioni visibili in classify: nessun test su questo valore autorizza a ignorare i numeri.
Per la permutazione, l'ipotesi d'ordine è infranta. Il programma può preferire inserimenti ed eliminazioni perché non dispone di un'operazione che permetta di spostare liberamente una sezione. Non bisogna rinominare questi avvisi «riformulazioni certe».
Ritrovate negli output gli otto abbinamenti corretti, i due inserimenti e le due eliminazioni, poi tornate ai passaggi sorgenti. La correzione consiste nel collegare questi avvisi allo spostamento, senza pretendere che il comparatore abbia risolto automaticamente il caso. Riconoscere il limite è il risultato dell'esercizio; un rilevamento generale degli spostamenti non è una funzionalità aggiunta al POC.
Produrre le figure e pulire
Dopo l'esercizio, generate le figure ed eseguite il controllo dei file previsto dal percorso:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
La presenza di un comando chiamato check_checkpoints.py non significa che sia appena avvenuto un addestramento. MiniLM resta congelato; lo script fa parte dei controlli sui file del progetto.
Aprite le figure, outputs/viewer.html e i JSON prima di proseguire. Conservate i risultati utili, soprattutto i casi in cui un segnale di inserimento o eliminazione corrisponde in realtà a uno spostamento.
Gli ultimi tre comandi arrestano il progetto, mostrano poi cancellano solo outputs/, quindi terminano il percorso. Il corpus e le risorse sono conservati.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
La pulizia non corregge un errore di allineamento né migliora una metrica: si limita a reimpostare gli output a zero. Non è richiesta alcuna pulizia Docker globale.
Adattare, risolvere problemi e pulire
Diagnosticare nell'ordine del trattamento
L'ambiente o l'acquisizione fallisce? Iniziate da preflight e check_environment.py, poi controllate i checksum di acquisizione e le impronte attese dei file. Non sostituite le versioni bloccate con file trovati altrove per far sparire l'errore.
I passaggi sono assenti, tagliati o mal raggruppati? Ispezionate i glifi, le regioni, i titoli rilevati e le aree escluse. Un'intestazione esclusa male o una sillabazione non riparata riguarda prima di tutto l'estrazione, non MiniLM.
Una matrice o un rapporto sembrano incoerenti? Seguite i JSON di codifica, allineamento e valutazione. Esaminate separatamente il partner scelto e la categoria assegnata. Due passaggi possono essere vicini ma male abbinati; un abbinamento può essere corretto mentre la formulazione richiede comunque una rilettura.
La formulazione cambia senza avviso? Verificate quali differenze il trattamento lessicale ha cancellato e cosa riconosce davvero numbers. Inserimenti ed eliminazioni compaiono intorno a sezioni spostate? Confrontate l'ordine delle clausole prima di modificare i costi: una ponderazione diversa non elimina il vincolo di monotonia.
Definire un nuovo perimetro prima di ampliare il comparatore
Per trattare documenti reali autorizzati, costituite corpus distinti per fonte, lingua e tipo di impaginazione. Misurate gli spostamenti, ma anche fusioni e divisioni di clausole, colonne, tabelle e scansioni, prima di adeguare una soglia.
Un abbinamento elementare di questo percorso collega una clausola a una clausola. Dividere un passaggio in due o fonderne più di uno costituisce quindi una difficoltà diversa dal cambiare alcune parole. Allo stesso modo, aggiungere un OCR per le scansioni modificherebbe gli input e i loro possibili errori: sarebbe un'estensione da valutare, non una capacità già convalidata qui.
In un'interfaccia reale, distinguete il candidato prodotto dal comparatore dalla conclusione della persona che rilegge. Aggiungete uno stato «rifiutato / incerto», diritti documentali e una revisione umana. Un utente deve poter ritrovare le due versioni, comprendere la categoria e constatare che un passaggio senza partner non è necessariamente un contenuto eliminato.
Resta inoltre da prevedere un'API asincrona, cioè un trattamento il cui risultato si consulta dopo l'invio, oltre a registrazione, salvataggio e ripristino. Queste funzioni sono lavori di prodotto, non funzionalità fornite dal tutorial.
Infine, il POC non è né una sandbox completa del parser PDF né una politica di conservazione. I documenti e le stringhe estratte sono dati, mai istruzioni da eseguire. L'isolamento del trattamento e i diritti sui file richiedono una progettazione propria del servizio distribuito.
Riferimenti per approfondire
I riferimenti del percorso sono la scheda ufficiale di MiniLM, per il modello e il pooling, e la documentazione NumPy sugli array, per le dimensioni e l'indicizzazione delle matrici.
I complementi collegati nel testo spiegano la normalizzazione Unicode, i token WordPiece, il coseno e il confronto delle tuple Python. I piccoli calcoli illustrativi non costituiscono nuove misure su Nova. Per riprodurre i risultati, versioni, impostazioni e comandi di riferimento restano quelli dello ZIP r001.