





El problema: una cláusula desplazada y un plazo modificado
Imagine una función de su back office: un usuario carga dos versiones de una guía y quiere saber qué ha cambiado. Podría extraer el texto, ejecutar un diff y mostrar las líneas añadidas o eliminadas. El principio se parece a comparar archivos en Git.
Pero aquí están las dos versiones de la guía ficticia «Nova Service Policy». La segunda utiliza otra fuente y otra paginación. Un párrafo ocupa ahora cuatro líneas en lugar de tres; el siguiente pasa a otra página. El texto no ha cambiado necesariamente, pero sus líneas y sus coordenadas ya no coinciden.
Un cambio muy real se desliza en esta nueva presentación: «Payment is due within 30 days» pasa a ser «Payment is due within 45 days». Es decir, el plazo pasa de 30 a 45 días. Un diff línea por línea puede ocultar este cambio entre los saltos de línea. Por el contrario, un modelo de similitud puede considerar muy próximas ambas frases: siguen hablando del mismo tema, con casi las mismas palabras.
Por tanto, tenemos dos preguntas distintas: ¿qué pasajes hay que comparar y, después, qué difiere entre ellos? Encontrar un pasaje parecido no basta para declararlo sin cambios.
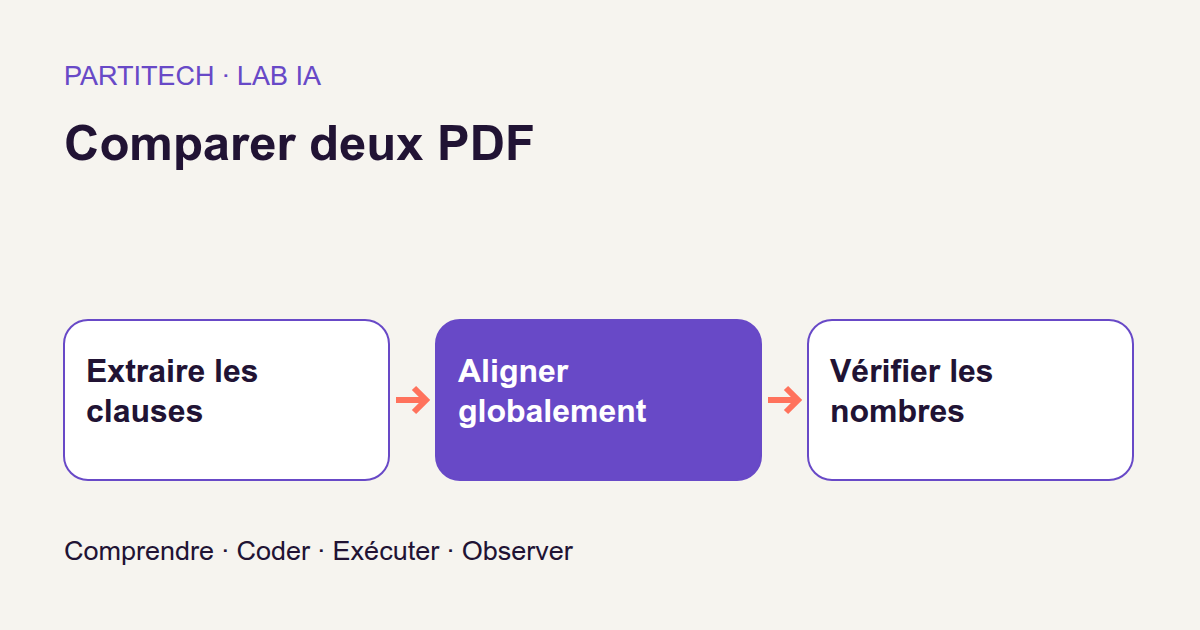
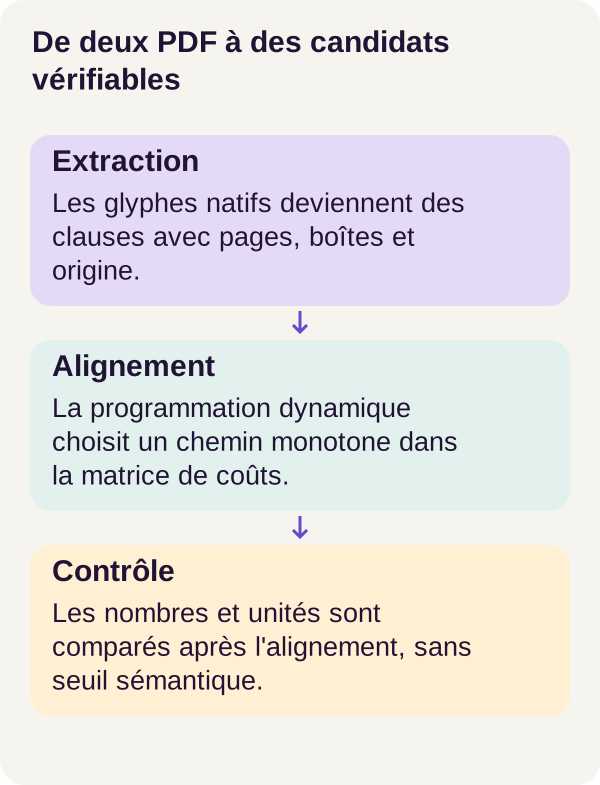
Este tutorial construye un comparador local para PDF nativos, es decir, que contienen texto utilizable y no solo las imágenes de un escaneo. Su recorrido es: glifos → cláusulas → vectores de similitud → alineamiento global → controles explícitos → pasajes para releer. El vocabulario se explicará progresivamente; puede abordar el proyecto con nociones básicas de Python, tablas y Docker, sin haber entrenado antes un modelo.
El resultado es una lista de candidatos para releer con la procedencia de ambos PDF. No es ni una opinión jurídica ni una garantía de que una reformulación conserve el mismo sentido. Sobre todo aprenderemos a hacer que cooperen un modelo y unas reglas, en vez de pedirle al modelo que lo decida todo.
Descargar el proyecto completo.
Lo que los datos muestran realmente
Tres formas de modificar una misma guía
El corpus Nova contiene 40 familias y tres pares por familia, es decir, 120 pares de PDF nativos reales. Estos archivos se generan para el experimento: «PDF reales» significa que procesamos realmente este formato, no que los documentos procedan de clientes.
En cada familia, un par solo cambia la presentación. Otro modifica el plazo y la puntuación. El tercero inserta una cláusula, elimina otra y reformula un contacto. Esta construcción permite saber qué diferencias se esperaban antes de ejecutar el comparador.
Las familias 0 a 9 forman el desarrollo, es decir, 30 pares; las otras 30 forman la prueba, es decir, 90 pares. Ninguna familia atraviesa ambos conjuntos. El desarrollo sirve para trabajar el método; la prueba sirve para medir el comportamiento elegido, sin corregirlo tras ver sus respuestas.
Aquí no separamos un entrenamiento neuronal de una prueba: el modelo preentrenado permanece congelado. La separación sirve aun así para evitar diseñar las reglas con los ejemplos utilizados para anunciar los resultados. La gramática generativa sigue siendo común a las familias; por tanto, este protocolo no representa automáticamente la diversidad de sus documentos.
Reconstruir cláusulas, no solo recuperar una cadena
Un glifo es una forma de carácter dibujada en el PDF, acompañada de una posición. El programa parte de estos elementos visibles. Su segmentador, el código que divide el documento en pasajes, agrupa las líneas por posición y detecta los títulos en negrita para reconstruir cláusulas.
Aquí una cláusula es la unidad de pasaje que vamos a comparar. No es una categoría jurídica reconocida por el programa. Primero hay que comprobar que la extracción haya agrupado correctamente los elementos del documento.
Cada cláusula conserva una lista de regiones de origen: documento, huella SHA-256, índice de página, caja e identificadores de glifos. Una caja es simplemente un rectángulo que sitúa el pasaje en la página. Si una cláusula empieza en una página y termina en la siguiente, conserva varias cajas: esta procedencia no puede resumirse fielmente en un único rectángulo.
Para un desarrollador web, esta procedencia se parece al vínculo entre un resultado mostrado y los registros que lo produjeron. Permite volver al documento y a las zonas correctas. La huella SHA-256, calculada a partir del archivo, ayuda a identificar la versión utilizada; no certifica la corrección de la asociación propuesta.
Normalizar sin perder el camino hacia el original
Para comparar los textos, el proyecto aplica NFKC, pasa a minúsculas y fusiona los espacios. NFKC es una forma de normalización Unicode: aproxima, entre otras cosas, distintas representaciones de caracteres. La documentación de Python sobre unicodedata.normalize describe esta operación.
Tomemos un ejemplo pedagógico, independiente de las mediciones de Nova. La cadena office puede contener un único carácter Unicode para la ligadura ffi. Tras NFKC, se convierte en office: las tres letras f, f e i quedan separadas. La especificación Unicode detalla esta transformación y las distinciones que una normalización de compatibilidad puede borrar.
Si el glifo de la ligadura tuviera, en nuestro ejemplo, el identificador G17, los tres caracteres normalizados deben poder remitir a ese mismo glifo. El proyecto conserva precisamente un mapa del carácter normalizado a los glifos originales. No supone que un carácter normalizado corresponda siempre a un único carácter de origen distinto.
Del mismo modo, homogeneizar Payment, PAYMENT y los espacios facilita la comparación, pero hace desaparecer ciertas diferencias de forma. El texto normalizado no permite por sí solo reconstruir el original. Por eso se conservan a la vez la representación de trabajo y su procedencia. Esta elección de normalización pertenece al protocolo; habrá que reconsiderar su pertinencia antes de comparar otros tipos de documentos.
Lo que la extracción no repara
Los encabezados y pies de página se excluyen mediante una zona declarada: se proporciona su ubicación, no la descubre automáticamente el modelo. Las palabras partidas no se reparan automáticamente. Por tanto, una palabra cortada al final de una línea puede requerir tratamiento adicional en otro corpus.
Una extracción deficiente no se vuelve correcta porque el modelo vectorial sea bueno. Si falta un pasaje o dos cláusulas se han fusionado por error, inspeccione primero esta etapa. El comparador trabaja con las cláusulas que recibe, no con una versión ideal del documento.
Embeddings: cercano no es idéntico
Transformar una cláusula en números
Un embedding es un vector, es decir, una lista de números que representa un texto en un espacio aprendido. El modelo de la prueba de concepto, o POC, es all-MiniLM-L6-v2. Su ficha oficial describe vectores de 384 dimensiones y su construcción mediante pooling.
Aquí el modelo sirve como codificador: transforma una entrada en una representación numérica. No redacta un análisis de los cambios. Sus parámetros permanecen congelados, por lo que no cambian durante el recorrido. Hacemos inferencia, es decir, usamos un modelo ya entrenado, no un fine-tuning sobre Nova.
El cálculo utiliza FP32 en CPU: números de coma flotante de 32 bits procesados por el procesador. No se requiere ni se ejecuta ninguna GPU en este tutorial.
Los 384 valores no corresponden a 384 campos de negocio con nombre. No tenemos, por ejemplo, una casilla «plazo» en la que el modelo colocaría fielmente el número de días. Precisamente por eso añadiremos después un control numérico explícito.
Tokens, ventanas y media ponderada
Un tokenizer divide el texto en unidades que el modelo puede procesar. Aquí se trata de WordPiece: un token puede ser una palabra o un fragmento de palabra, no necesariamente un carácter o una palabra completa. La documentación sobre tokenizers de Transformers explica esta división.
El pooling reúne las representaciones de los tokens para obtener un vector de pasaje. Hay que distinguir esta operación de la segunda media que el proyecto utiliza para las cláusulas largas.
En efecto, el tokenizer divide una cláusula larga en ventanas de 254 wordpieces de contenido. El recorrido codifica todas las ventanas, promedia sus vectores según su número de tokens y luego normaliza el vector obtenido. Una cláusula larga sigue este camino en una familia de cada cinco. Por tanto, no sustituimos una cláusula larga por su solo comienzo.
Para comprender la ponderación, tomemos dos ventanas ficticias de 254 y 46 tokens. Con sus vectores v1 y v2, la media es (254 × v1 + 46 × v2) / 300, y no (v1 + v2) / 2. La pequeña ventana final no pesa tanto como la grande solo por constituir una ventana adicional.
Al reducir los vectores a dos dimensiones para poder calcular a mano, supongamos v1 = (1 ; 0) y v2 = (0 ; 1). La media vale aproximadamente (0,8467 ; 0,1533). Su normalización en longitud da aproximadamente (0,9840 ; 0,1782). Estos valores solo sirven para explicar el cálculo; no son salidas de MiniLM.
Codificar todas las ventanas evita ignorar una de ellas, pero no crea un contexto único en el que cada token pueda interactuar con toda la cláusula. La media condensa sus representaciones; no conserva automáticamente todos los detalles ni todas sus relaciones.
Comparar direcciones, no certificar una equivalencia
La similitud coseno compara la dirección de dos vectores. Para vectores no nulos u y v, vale producto_escalar(u, v) / (longitud(u) × longitud(v)). Un valor cercano a 1 indica direcciones próximas. Cuando ambos vectores están normalizados en longitud, basta el producto escalar, como explica la documentación de Sentence Transformers.
Un ejemplo en dos dimensiones permite ver la diferencia con una igualdad: (1 ; 0) y (2 ; 0) tienen la misma dirección, por tanto un coseno de 1, sin ser dos listas de números idénticas. Con textos, una puntuación alta tampoco es un certificado de equivalencia.
Para n cláusulas antes y m cláusulas después, el programa produce una matriz n × m: una tabla con una fila por cláusula antigua y una columna por cláusula nueva. La celda [i, j] contiene la proximidad de estas dos cláusulas.
Volvamos a los 30 y 45 días. Aunque su similitud fuera de 0,99, ese número no significaría «un 99 % de probabilidad de que nada haya cambiado». Ayudaría a reconocer que ambos pasajes se corresponden. La diferencia de plazo debe seguir siendo visible en la siguiente etapa. Cercanos significa aquí “buenos candidatos para comparar”, no “intercambiables”.
Construir el camino global
¿Por qué no elegir el mejor vecino de cada cláusula?
Supongamos que dos cláusulas antiguas se parecen ambas a la misma cláusula nueva. Si cada una elige de manera independiente a su mejor vecina, el comparador puede reutilizar ese pasaje dos veces e ignorar otro.
La función align, en src/pdfdiffai/align.py, elige en cambio un alineamiento global. Cada segmento debe aparecer exactamente una vez: bien en un emparejamiento, bien aislado como inserción o eliminación. Emparejar significa asociar una cláusula de la versión anterior con una cláusula de la versión posterior; no significa declararlas idénticas.
El camino también es monótono: avanza en el orden de ambos documentos, sin volver atrás. Si una cláusula antigua A precede a B, sus correspondencias no pueden cruzarse en la nueva versión.
Esta restricción acepta una cláusula desplazada a otra página siempre que el orden de las secciones se conserve en conjunto. No permite permutar libremente dos secciones enteras. Mediremos este límite en el ejercicio.
Transformar la proximidad en coste
Buscamos el camino de coste mínimo. Un coste bajo hace atractiva una opción; no es una probabilidad de error. El coste de emparejamiento combina tres términos, fijados antes de la inferencia:
0,7 × (1 − coseno) + penalización de título + 0,1 × distancia de posición relativa.
La penalización de título vale 0,2 si los tokens del título difieren; en caso contrario, cero. Una inserción y una eliminación cuestan cada una 0,45. Estos valores son elecciones del protocolo, no parámetros aprendidos durante este recorrido.
Por ejemplo, con un coseno ficticio de 0,98, tokens de título distintos y una distancia relativa de 0,10, el coste vale 0,7 × 0,02 + 0,2 + 0,1 × 0,10 = 0,224. La proximidad textual es fuerte, pero los demás indicios siguen contribuyendo.
Eliminar una cláusula e insertar otra cuesta 0,45 + 0,45 = 0,90. Comparar estos costes ayuda a comprender las elecciones posibles. Sin embargo, no es un umbral de decisión independiente para cada par: el alineamiento también debe seguir siendo compatible con las demás cláusulas.
Programación dinámica: memorizar los mejores inicios de camino
La programación dinámica evita recalcular todos los caminos posibles. Conserva la mejor solución para cada pareja de inicios de documentos y se apoya después en esos resultados para avanzar.
distance[i, j] representa el coste mínimo para tratar las i primeras cláusulas de la versión anterior y las j primeras cláusulas de la versión posterior. Por tanto, la matriz tiene n + 1 filas y m + 1 columnas. El cero permite representar un inicio de documento aún vacío.
La celda distance[0, 0] vale cero. En la primera fila solo es posible la inserción; en la primera columna solo es posible la eliminación. Con el coste 0,45, estos bordes acumulan por tanto 0, 0,45, 0,90, etc.
Este es el fragmento central del proyecto. Interviene dentro del cálculo, después de preparar las matrices y los índices; no es un programa autónomo para ejecutar por sí solo.
value, rank, operation = min(
    (distance[i - 1, j - 1] + cost[i - 1, j - 1], 0, "M"),
    (distance[i - 1, j] + deletion, 1, "D"),
    (distance[i, j - 1] + insertion, 2, "I"),
)
La diagonal, M, empareja dos cláusulas. Recupera el mejor coste de sus prefijos anteriores y añade el coste del emparejamiento actual. cost[i - 1, j - 1] usa índices reducidos en uno porque esta matriz no tiene los bordes vacíos de distance.
El movimiento vertical, D, consume una cláusula antigua sin correspondencia. Añade el coste de eliminación. El movimiento horizontal, I, consume una cláusula nueva sin correspondencia. Añade el coste de inserción. «Consumir» significa aquí integrarla en el resultado del alineamiento; no se borra ninguna cláusula de los PDF de origen.
Cada opción es una tupla que contiene el coste, un rango de prioridad y el nombre de la operación. Python compara las tuplas elemento a elemento. En caso de igualdad exacta de coste, los rangos 0, 1, 2 dan prioridad al emparejamiento, después a la eliminación y después a la inserción. Este desempate hace reproducible la elección; no aporta una prueba adicional de corrección.
Un pequeño alineamiento para rehacer a mano
Tomemos un ejemplo pedagógico: la versión anterior contiene A, B y la versión posterior A′, X, B′. Elegimos los costes siguientes para representar dos correspondencias atractivas y un pasaje insertado. No proceden de la codificación de Nova.
| Coste de emparejamiento | A′ | X | B′ |
|---|---|---|---|
| A | 0,10 | 1,20 | 1,20 |
| B | 1,20 | 1,20 | 0,10 |
Con inserciones y eliminaciones a 0,45, la matriz de los mejores costes acumulados pasa a ser:
| Prefijo anterior / posterior | Vacío | A′ | A′, X | A′, X, B′ |
|---|---|---|---|---|
| Vacío | 0,00 | 0,45 | 0,90 | 1,35 |
| A | 0,45 | 0,10 | 0,55 | 1,00 |
| A, B | 0,90 | 0,55 | 1,00 | 0,65 |
Observe la última celda. Emparejar B con B′ prolonga el coste 0,55 en 0,10, es decir, 0,65. Las otras dos opciones valen cada una 1,00 + 0,45 = 1,45. Por tanto, el mejor recorrido empareja A con A′, inserta X y después empareja B con B′.
Queda por recuperar este recorrido, y no solo su coste. El programa conserva los predecesores, es decir, la opción elegida en cada celda. Sube desde (n, m) hasta (0, 0) y luego invierte esta lista para devolverla al orden de lectura.
El control final comprueba que cada segmento aparece exactamente una vez. El resultado es un camino determinista, pero varios caminos podrían tener el mismo coste antes del desempate. Y, sobre todo, el mínimo se busca entre los caminos monótonos permitidos, no entre todas las reorganizaciones imaginables del documento.
Señalar una diferencia sin confundir las señales
Encontrar la cláusula correcta no termina el trabajo
Después del alineamiento sabemos qué pasajes comparar. La función classify, en src/pdfdiffai/changes.py, determina a continuación el tipo de señal que se debe presentar.
numbers busca números decimales con la palabra o unidad que los sigue. Para nuestro plazo, la información que se compara es conceptualmente «30 con days» y después «45 con days». Estas descripciones explican la regla; no pretenden reproducir el formato JSON interno de esta función.
Una diferencia entre estos elementos activa numeric, incluso con un coseno alto. Veamos el orden de las condiciones en el código proporcionado.
def classify(left, right, similarity=None):
    # Similarity is explanatory metadata, never a gate on the numeric check.
    if left is None:
        return {"kind": "insertion", "review": True}
    if right is None:
        return {"kind": "deletion", "review": True}
    a = numbers(left)
    b = numbers(right)
    if a != b:
        return {
            "kind": "numeric",
            "review": True,
            "left_numbers": a,
            "right_numbers": b,
        }
    if lexical(left) == lexical(right):
        return {
            "kind": "unchanged" if left == right else "presentation",
            "review": False,
        }
    return {"kind": "rewording_candidate", "review": True}
Primero, las cláusulas ausentes en uno de los lados. left is None produce insertion; right is None produce deletion. Aquí None representa la ausencia de un segmento asociado, no una cadena de texto vacía. Ambas categorías requieren relectura.
Después, los números. Se comparan los resultados de numbers(left) y numbers(right). Si difieren, la función devuelve inmediatamente numeric, con los valores observados a izquierda y derecha. El parámetro similarity no interviene en ninguna condición del fragmento: no puede anular esta alerta.
Luego, la forma léxica. Si lexical(left) y lexical(right) son idénticos, el programa no pide relectura. No obstante, distingue dos casos: unchanged si las cadenas recibidas ya son exactamente iguales; presentation si difieren pero se vuelven iguales después del tratamiento léxico.
Este matiz importa: la función no compara directamente las fuentes ni las coordenadas. Un cambio de fuente que deja idénticas ambas cadenas extraídas puede dar lugar a unchanged, no necesariamente a presentation. El punto común es review: False, según las reglas del recorrido.
Por último, las demás diferencias. La función devuelve rewording_candidate, literalmente un candidato a reformulación, con review: True. No concluye ni que haya una modificación cierta del sentido ni una equivalencia cierta.
Comprender lo que las categorías no dicen
La función devuelve una única categoría. Si los números y la formulación cambian a la vez, el control numérico llega primero y da numeric. Eso no significa que el número sea la única diferencia del pasaje. Hay que conservar ambos textos para la relectura.
Del mismo modo, una inserción o una eliminación es ante todo una conclusión del camino de alineamiento: no se ha seleccionado ningún socio en ese lugar. No siempre demuestra que el contenido sea realmente nuevo o eliminado. El desplazamiento de secciones mostrará precisamente este caso.
El diagnóstico numérico cubre la gramática inglesa del POC, no todas las fechas, divisas, unidades o convenciones documentales. No se le debe atribuir una conversión general de unidades ni suponer que reconoce todos los números escritos con letras. Estos casos exigirían reglas y pruebas adicionales.
Conservamos así una distinción útil: el modelo aproxima, el alineamiento asocia, las reglas señalan, la persona relee.
Reproducir el recorrido validado
Preparar el entorno de CPU
Descomprima el ZIP y abra un terminal en su raíz. Ejecute las órdenes una sola vez y en el orden indicado. El perfil validado es CPU: se necesitan Docker Engine y Compose; se recomiendan 16 GiB de RAM y 12 GiB de disco. Estas recomendaciones no constituyen mínimos medidos en todas las máquinas.
Tres servicios tienen funciones distintas. acquisition dispone de red para recuperar y verificar los activos bloqueados. tutorial prepara los datos y realiza los controles. inference ejecuta los cálculos previstos sin montar los labels ni las operaciones gold, es decir, las anotaciones y cambios esperados que servirán para la evaluación. tutorial e inference no tienen red.
Esta separación permite comprobar que el cálculo no consulta discretamente las respuestas esperadas. No sustituye los derechos de acceso de una aplicación real.
Comencemos por el control previo, la preparación y la construcción de los servicios:
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
El preflight comprueba los requisitos antes de iniciar el resto. El control de Compose debe aceptar la configuración y la construcción debe terminar sin errores. Si falla, corrija primero esta etapa en lugar de continuar con un entorno incompleto.
Adquirir el modelo y después verificar el programa
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
La adquisición utiliza los activos bloqueados del proyecto. El control del entorno verifica después su uso en el contenedor; pytest ejecuta las pruebas del programa. Estas tres órdenes tienen objetivos distintos: disponer de los archivos, poder utilizarlos y comprobar los comportamientos esperados del código.
Una prueba correcta no demuestra que todas las asociaciones en documentos desconocidos vayan a ser correctas. Conserve el modelo y las dependencias del ZIP para reproducir el recorrido r001; las documentaciones vinculadas en el artículo son complementos de comprensión, no instrucciones de actualización.
Generar los documentos e inspeccionar las entradas
docker compose run --rm tutorial python -m pdfdiffai.cli prepare --config configs/minimum.yaml
prepare escribe los PDF, los documentos extraídos y su procedencia. Antes de interesarse por las puntuaciones, examine los pasajes recuperados: ¿está presente el plazo? ¿Los títulos y cuerpos se agrupan como estaba previsto? ¿Una cláusula que abarca dos páginas conserva sus regiones de origen?
Pasemos a las dos vistas pedagógicas del cálculo:
docker compose run --rm inference python -m pdfdiffai.cli inspect-similarity --config configs/minimum.yaml
docker compose run --rm inference python -m pdfdiffai.cli explain-alignment --config configs/minimum.yaml
inspect-similarity proporciona las codificaciones y la matriz de similitudes. El objetivo es relacionar una celda con dos pasajes concretos, no solo buscar el valor más alto.
explain-alignment muestra una pequeña matriz pedagógica, verificada mediante una enumeración exhaustiva: para este ejemplo reducido, el programa puede examinar todos los caminos permitidos y comparar su mejor coste con el de la programación dinámica. Este control se refiere al mecanismo de cálculo; no demuestra que cada asociación tenga el sentido correcto en un documento real.
Comparar las alternativas y producir el informe
docker compose run --rm inference python -m pdfdiffai.cli baseline --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdfdiffai.cli evaluate --config configs/minimum.yaml
baseline compara las dos alternativas del proyecto sobre las mismas cláusulas. Una baseline es un método de referencia: permite juzgar el resultado de un método frente a algo más que una impresión. Consulte sus salidas sin atribuir a las alternativas puntuaciones que no figuren en los resultados publicados más abajo.
evaluate produce el informe bilateral, con ambas versiones frente a frente, los JSON de líneas y el visor local. Abra outputs/viewer.html, los PNG y los JSON. Para el plazo, siga el recorrido completo: pasaje antiguo, pasaje nuevo, asociación elegida, números extraídos, categoría y regiones de origen.
No ejecute todavía la limpieza: borrará outputs/. Primero interpretaremos estos resultados y después ejecutaremos el ejercicio.
Definir las medidas antes que las cifras
¿Es correcto el alineamiento?
El F1 de alineamiento compara los pares predichos con los pares gold, las correspondencias esperadas del corpus. La precisión mide la proporción de pares propuestos que son correctos; el recall mide la proporción de pares esperados que se han encontrado. Su combinación vale F1 = 2 × precisión × recall / (precisión + recall) cuando este cálculo está definido.
Tomemos el recuento del ejercicio que leeremos después: ocho pares propuestos, todos correctos, mientras que se esperaban diez. La precisión es 8/8 = 1, pero el recall solo es 8/10 = 0,8. El F1 vale aproximadamente 0,8889, y no 0,8. Por tanto, un método puede ser preciso en sus emparejamientos y aun así dejar algunos sin encontrar.
¿Cuántos pasajes tienen un socio?
La cobertura emparejada vale 2 × número de pares emparejados / número total de cláusulas de ambas versiones. El factor dos procede de que un par contiene una cláusula de cada versión.
Esta medida no dice si las asociaciones son correctas. Emparejar arbitrariamente todos los pasajes daría una cobertura alta sin garantizar un buen F1. Por el contrario, una inserción o eliminación real debe quedarse sin socio: una cobertura inferior a 1 no es automáticamente un defecto.
Las cláusulas aisladas permanecen en el denominador. No se pueden hacer desaparecer los casos difíciles del balance simplemente eligiendo no emparejarlos.
¿Se encontró el cambio numérico en el lugar correcto?
El recall numérico solo vale 1 si cada cambio esperado se encuentra en una cláusula correctamente emparejada y se señala su diferencia numérica. Detectar un número distinto en dos cláusulas equivocadas no constituye un éxito.
La precisión de los candidatos se examina por separado para inserciones, eliminaciones, cambios numéricos y candidatos a reformulación. Esto permite distinguir un error de asociación de una regla que enviaría demasiados pasajes a releer.
Para los pares en los que solo varía la paginación, la tasa de falsos cambios mide los pasajes enviados innecesariamente a relectura. Por último, el tiempo medio del protocolo solo cubre el alineamiento: excluye adquisición, renderizado PDF y codificación. Por tanto, no es el tiempo completo entre la carga de los archivos y la visualización del resultado en un back office.
Resultados de la prueba Nova
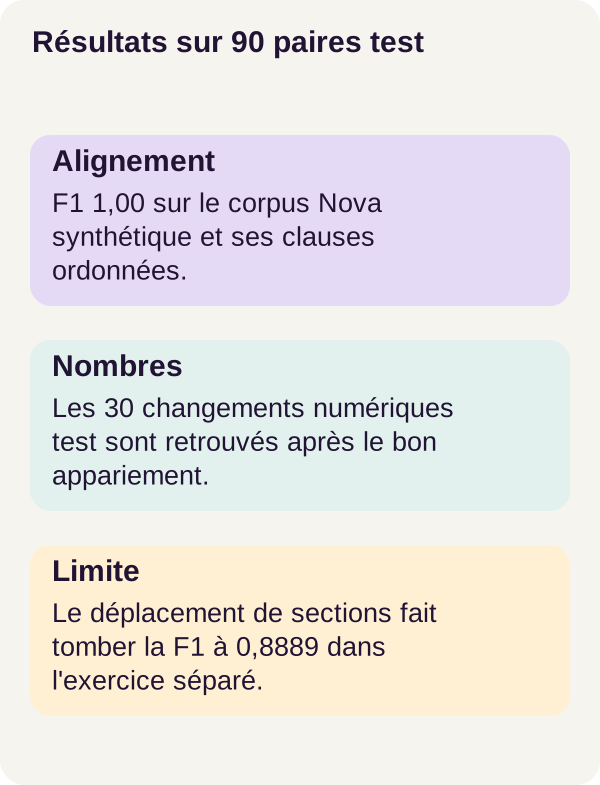
En los 90 pares de prueba, el comparador dinámico obtiene los siguientes resultados:
| Medida | Resultado de referencia |
|---|---|
| Alineamiento | 870 pares gold alineados; F1 = 1,00 |
| Cobertura emparejada | 1 740 pasajes de 1 800; 0,9667 |
| Recall numérico | 30 cambios esperados señalados; 1,00 |
| Falsos cambios en la sola repaginación | Tasa de 0 en los 30 pares afectados |
Comprobemos el recuento: 2 × 870 = 1 740, después 1 740 / 1 800 ≈ 0,9667. Los 60 pasajes restantes están aislados en el alineamiento. Este número concuerda con las 30 inserciones y las 30 eliminaciones esperadas según la construcción de los pares de prueba; no designa 60 correspondencias olvidadas.
Estas cifras describen PDF Nova controlados. No validan ni un comparador jurídico ni el tratamiento de maquetaciones desconocidas. Sigue siendo necesaria una relectura para interpretar una diferencia, y una buena puntuación en esta distribución no predice la de otro corpus.
El resultado negativo: permutar dos secciones
El ejercicio independiente cambia el orden de dos secciones enteras. El contenido desplazado sigue presente, pero el camino monótono no puede conservar libremente asociaciones que se cruzan.
El resultado baja a F1 = 0,8889, con ocho emparejamientos gold de diez y 16 pasajes emparejados de 20. Por tanto, la cobertura correspondiente vale 16/20 = 0,8. Se proponen dos inserciones y dos eliminaciones.
Estas cuatro alertas pertenecen a dos categorías cuya precisión como candidatas a un cambio de contenido es nula en este ejercicio: representan un desplazamiento, no una inserción o eliminación de contenido demostrada. Un algoritmo puede respetar perfectamente su contrato de orden y fallar cuando el documento deja de respetar esta hipótesis.
Síntesis antes del ejercicio
Hemos separado tres objetos: los datos extraídos, la decisión del comparador y la medida frente a las referencias. La procedencia permite volver a la fuente; no demuestra que la elección del socio sea correcta. El coseno ayuda a aproximar; no neutraliza una diferencia de plazo. El camino global evita reutilizaciones; también limita los desplazamientos posibles.
El ejercicio pondrá a prueba estas distinciones. El interés es prever qué mecanismo se verá afectado y explicar después el resultado, en vez de limitarse a una puntuación.
Ejercicio: predecir antes de la corrección
Escriba su hipótesis antes de ejecutar la orden
Comience por esta situación: Payment within 30 days y Payment within 45 days reciben una similitud casi perfecta. ¿Deben clasificarse como sin cambios? Busque en classify la condición que debe decidirlo, sin inventar un nuevo umbral de similitud.
Imagine después que dos secciones intercambian completamente su lugar sin cambiar su contenido. ¿Puede el camino global conservar todos los emparejamientos? ¿Una inserción propuesta demuestra entonces la aparición de un texto nuevo? Distinga el problema de clasificación de los pasajes del de su contenido.
Anote sus respuestas y después ejecute el escenario proporcionado:
docker compose run --rm tutorial python -m pdfdiffai.cli exercise --config configs/exercise.yaml
Comparar su predicción con las salidas
Para los 30 y 45 días, la comparación numérica conserva la prioridad y debe solicitar una relectura. Modificar el valor explicativo de similitud no cambia las condiciones visibles en classify: ninguna prueba sobre ese valor permite ignorar los números.
Para la permutación, se rompe la hipótesis de orden. El programa puede preferir inserciones y eliminaciones porque no dispone de una operación que permita desplazar libremente una sección. No se deben renombrar estas alertas como «reformulaciones ciertas».
Encuentre en las salidas los ocho emparejamientos correctos, las dos inserciones y las dos eliminaciones, y vuelva después a los pasajes de origen. La corrección consiste en vincular estas alertas con el desplazamiento, sin pretender que el comparador haya resuelto automáticamente este caso. Reconocer el límite es el resultado del ejercicio; una detección general de desplazamientos no es una funcionalidad añadida al POC.
Producir las figuras y limpiar
Después del ejercicio, genere las figuras y ejecute el control de archivos previsto por el recorrido:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
La presencia de una orden llamada check_checkpoints.py no significa que haya tenido lugar un entrenamiento. MiniLM sigue congelado; el script forma parte de los controles de archivos del proyecto.
Abra las figuras, outputs/viewer.html y los JSON antes de continuar. Conserve los resultados útiles, en especial los casos en que una señal de inserción o eliminación corresponde en realidad a un desplazamiento.
Las tres últimas órdenes detienen el proyecto, muestran y luego borran únicamente outputs/, y terminan el recorrido. El corpus y los activos se conservan.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
La limpieza no corrige un error de alineamiento ni mejora una métrica: simplemente restablece las salidas a cero. No se solicita ninguna limpieza global de Docker.
Adaptar, solucionar problemas y limpiar
Diagnosticar en el orden del tratamiento
¿Falla el entorno o la adquisición? Empiece por el preflight y check_environment.py, y después controle los checksums de adquisición y las huellas esperadas de los archivos. No sustituya las versiones bloqueadas por archivos encontrados en otro lugar para hacer desaparecer el error.
¿Faltan pasajes, están cortados o mal agrupados? Inspeccione los glifos, las regiones, los títulos detectados y las zonas excluidas. Un encabezado mal excluido o una palabra partida sin reparar pertenece primero a la extracción, no a MiniLM.
¿Una matriz o un informe parecen incoherentes? Siga los JSON de codificación, alineamiento y evaluación. Examine por separado el socio seleccionado y la categoría asignada. Dos pasajes pueden ser próximos pero estar mal emparejados; un emparejamiento puede ser correcto aunque la formulación siga requiriendo relectura.
¿La formulación cambia sin alerta? Compruebe qué diferencias ha borrado el tratamiento léxico y qué reconoce realmente numbers. ¿Aparecen inserciones y eliminaciones alrededor de secciones desplazadas? Compare el orden de las cláusulas antes de modificar los costes: otra ponderación no elimina la restricción de monotonía.
Definir un nuevo alcance antes de ampliar el comparador
Para tratar documentos reales autorizados, constituya corpus distintos por fuente, idioma y tipo de maquetación. Mida los desplazamientos, pero también las fusiones y divisiones de cláusulas, las columnas, las tablas y los escaneos, antes de ajustar un umbral.
Un emparejamiento elemental de este recorrido vincula una cláusula con una cláusula. Dividir un pasaje en dos o fusionar varios constituye por tanto otra dificultad distinta de cambiar unas palabras. Del mismo modo, añadir OCR para los escaneos modificaría las entradas y sus posibles errores: sería una extensión que evaluar, no una capacidad ya validada aquí.
En una interfaz real, distinga el candidato producido por el comparador de la conclusión de la persona que relee. Añada un estado «rechazado / incierto», derechos documentales y revisión humana. Un usuario debe poder recuperar ambas versiones, comprender la categoría y constatar que un pasaje sin socio no es necesariamente contenido eliminado.
También queda por prever una API asíncrona, es decir, un tratamiento cuyo resultado se consulta después del envío, junto con el registro, la copia de seguridad y la restauración. Estas funciones son trabajo de producto, no funcionalidades proporcionadas por el tutorial.
Por último, el POC no es ni un sandbox completo del analizador PDF ni una política de conservación. Los documentos y las cadenas extraídas son datos, nunca instrucciones que ejecutar. El aislamiento del tratamiento y los derechos sobre los archivos requieren un diseño propio del servicio desplegado.
Referencias para profundizar
Las referencias del recorrido son la ficha oficial de MiniLM, para el modelo y el pooling, y la documentación de NumPy sobre arrays, para las dimensiones y la indexación de matrices.
Los complementos vinculados a lo largo del texto explican la normalización Unicode, los tokens WordPiece, el coseno y la comparación de tuplas de Python. Los pequeños cálculos ilustrativos no constituyen nuevas mediciones sobre Nova. Para reproducir los resultados, las versiones, ajustes y órdenes de referencia siguen siendo los del ZIP r001.