





Vous ajoutez un import de factures à une application web. Le téléchargement fonctionne, le PDF s'ouvre et votre extracteur retrouve les nombres présents dans la page. Il ne reste plus qu'à remplir les champs du formulaire… mais lequel de ces nombres est le total ?
Une expression régulière peut reconnaître 250.16. Elle ne dit pas, à elle seule, s'il s'agit du montant à payer, d'une taxe ou d'un sous-total. Pour le savoir, nous lisons les libellés autour du nombre et nous regardons où il est placé. Notre programme va lui aussi exploiter le texte et sa position.
Nous allons construire un extracteur de champs avec Python, Docker et LayoutLM. Nous suivrons la facture fictive AL-01-03 : son sous-total vaut 250.00, sa taxe 0.16, son total 250.16. Ces valeurs constituent notre fil rouge, pas une règle comptable à apprendre au modèle. Nous voulons retrouver les montants écrits dans le document, pas recalculer ou inventer un champ manquant.
Le résultat recherché tient en une phrase : retrouver une valeur, déterminer son rôle et montrer d'où elle vient. Nous comparerons aussi le réseau à des règles simples. L'objectif est de comprendre ce qu'apporte chaque méthode, pas de supposer que celle qui utilise une IA sera forcément meilleure.
Télécharger le projet complet du tutoriel
Ce que vous allez construire et apprendre
Notre programme prend des PDF contenant du texte natif et renvoie six champs : numéro de facture, date, fournisseur, sous-total, taxe et total. Chaque valeur conserve sa page, ses mots et leurs rectangles. Un champ absent ou ambigu peut rester vide.
Un PDF natif contient ici des caractères que le programme peut extraire. Ce n'est pas le même point de départ qu'un scan ne contenant qu'une image : celui-ci demanderait d'abord une reconnaissance optique de caractères, ou OCR. Cette étape n'appartient pas au parcours présenté.
La chaîne de traitement est la suivante :
PDF → mots et rectangles → sous-tokens → LayoutLM → étiquettes par mot → champs accompagnés de leur provenance.
Imaginez une opération de surlignage : le programme doit associer certains mots au « total », d'autres à la « date », et laisser les mots sans rôle dans nos six champs de côté. Une étiquette décrit le rôle choisi ; le rectangle permet de retrouver le mot sur la page.
LayoutLM associe des représentations apprises du texte et des positions. Dans ce tutoriel, il classe des tokens ; il ne rédige pas une réponse et ne lit pas directement les pixels d'un scan. Le code Python extrait les données, prépare les entrées, rassemble les prédictions et vérifie les résultats.
Nous apprendrons à mettre les coordonnées à une échelle commune, à conserver le lien entre les mots et leurs fragments, à entraîner le classifieur et à traiter une page trop longue pour entrer dans une seule fenêtre. Nous verrons ensuite comment mesurer la qualité de l'extraction sans confondre une bonne valeur avec une bonne localisation.
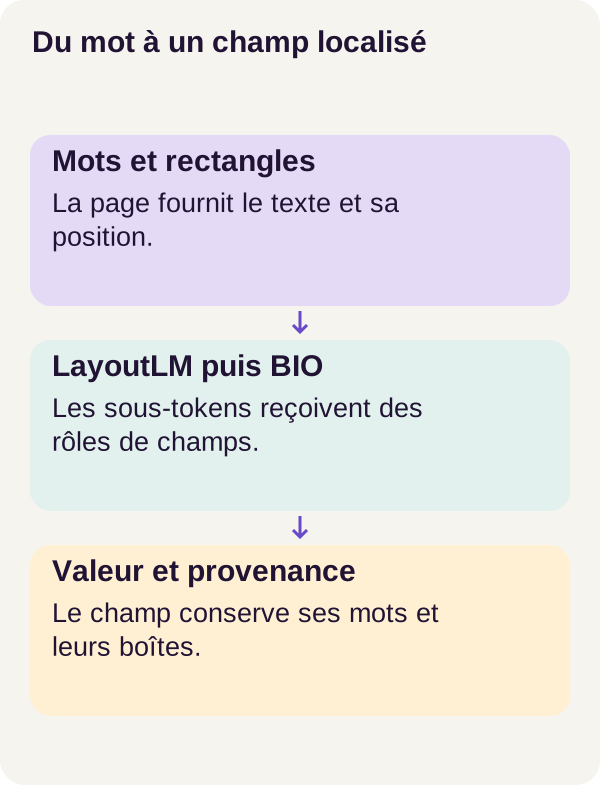
Une boîte localise un mot ; une étiquette décrit son rôle. La provenance permet de revenir à la page.
Préparer l'environnement
Vous devez savoir utiliser Python, un terminal et Docker. Il n'est pas nécessaire de connaître déjà LayoutLM. Nous expliquerons les notions neuronales au moment où elles apparaissent : un tenseur est ici un tableau de nombres, et l'entraînement ajuste les paramètres du modèle à partir d'exemples annotés.
Le parcours a été validé sous Linux avec une RTX 3090 de 24 Gio. Le README prévoit 32 Gio de RAM et 24 Gio de disque : ce sont des indications de dimensionnement, pas des minima mesurés sur toutes les machines. La RAM est la mémoire de l'ordinateur ; les 24 Gio de la carte graphique correspondent à sa mémoire propre, la VRAM.
Prévoyez Docker Engine, Compose et un GPU NVIDIA utilisable par les conteneurs. Conservez les dépendances et les configurations du ZIP pour reproduire le parcours r002.
Vérifier que Docker voit votre GPU
Un GPU visible sur l'hôte ne garantit pas qu'un programme Docker puisse l'utiliser. Le script suivant contrôle l'hôte et Docker ; nous vérifierons ensuite CUDA depuis le conteneur. CUDA est l'environnement de calcul utilisé ici pour exécuter les opérations du réseau sur le GPU.
NVIDIA Container Toolkit fournit l'intégration entre le moteur Docker et les pilotes NVIDIA de l'hôte. Son installation dépend de votre système : utilisez la documentation officielle NVIDIA.
Décompressez le ZIP, puis ouvrez un terminal dans son dossier racine, celui qui contient README.md et compose.yaml. Toutes les commandes suivantes partent de ce dossier. Commencez par les contrôles préalables.
sh scripts/preflight.sh
Corrigez tout contrôle bloquant avant de poursuivre. Le script de préparation crée ensuite les répertoires nécessaires, Compose valide sa configuration, puis construit les trois services.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
Chaque service a un rôle : acquisition télécharge les actifs, tutorial prépare les données et entraîne le modèle, inference prédit à partir des PDF et des poids enregistrés. Les poids sont les paramètres numériques appris par le réseau.
Pour vous repérer dans les fichiers, assets/ conserve le modèle et les checkpoints, data/generated/ contient le corpus et outputs/ reçoit les résultats. Un checkpoint est une sauvegarde d'un état d'entraînement ; nous l'utiliserons aussi pour vérifier une reprise après interruption.
L'inférence dispose des entrées et des poids en lecture seule, sans annotations de référence ni accès réseau. Le fichier Compose complet du ZIP détaille les montages et les restrictions. Cette séparation empêche, dans ce parcours, de donner les réponses attendues au service chargé de les prédire. Elle ne remplace pas les contrôles d'accès d'une application réelle.
Acquérir le modèle une fois
Nous utilisons microsoft/layoutlm-base-uncased. Sa révision 30e3cdd39c11f09757b0fcf7598533d05052acef est figée pour retrouver les mêmes fichiers. scripts/acquire.py contrôle leurs tailles et les empreintes définies dans locks/models.lock.json, puis les stocke dans assets/model/.
Vous pouvez rapprocher ce verrouillage de celui des dépendances d'un projet web : conserver un nom ne suffit pas, il faut aussi savoir quelle version et quels fichiers ont été utilisés. Internet sert à cette acquisition ; le chargement du modèle utilise ensuite les fichiers locaux.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
Vérifions maintenant l'environnement depuis Docker, puis les tests. Le premier contrôle complète celui de l'hôte : c'est l'accès effectif du programme conteneurisé au GPU qui compte.
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
À observer : le parcours validé obtient 26 tests réussis. Ces tests contrôlent notamment les coordonnées, l'alignement, les fenêtres et les cas invalides. Ils vérifient des comportements du programme ; ils ne garantissent pas que le modèle saura traiter vos propres factures.
Comprendre les données avant de prédire
Trois groupes de documents, trois rôles
Le corpus synthétique comporte 600 pages et 50 familles de mise en page. « Synthétique » signifie que les factures sont générées pour l'expérience, plutôt que collectées auprès de vrais clients. Une famille rassemble des documents partageant un gabarit de mise en page.
La séparation se fait par familles : 420 pages d'entraînement, 84 de validation et 96 de test. L'entraînement sert à ajuster les paramètres. La validation sert à sélectionner le checkpoint. Le test mesure ensuite le résultat final sur des documents qui n'ont pas servi à ces décisions.
Pourquoi ne pas mélanger toutes les pages au hasard ? Parce qu'une méthode pourrait réussir en reconnaissant un gabarit déjà rencontré, sans bien se comporter face à une nouvelle présentation. Séparer les familles réduit ce risque, sans reproduire toute la diversité du monde réel.
Lire une facture avant de lire les tenseurs
Les factures fictives Alder contiennent du texte anglais natif. pdfplumber en extrait les mots et leurs rectangles ; sa documentation sur l'extraction de texte décrit ces objets. Les annotations associent les mots aux champs attendus : ce sont les réponses de référence utilisées pour apprendre et pour mesurer, jamais pour prédire.
Créons les données et inspectons un lot, ou batch : un ensemble d'entrées préparées pour le modèle.
docker compose run --rm tutorial python -m pdflayout.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdflayout.cli inspect-batch --config configs/minimum.yaml
Observez les identifiants de tokens, les rectangles et les étiquettes. Pour AL-01-03, trois mots nous intéressent particulièrement :
| Identifiant du mot | Texte extrait | Rôle attendu |
|---|---|---|
55 |
250.00 |
Sous-total |
58 |
0.16 |
Taxe |
62 |
250.16 |
Total |
Ces correspondances viennent du cas de référence. Le modèle reçoit le texte et sa position ; pendant l'entraînement, l'annotation lui indique le rôle qu'il devait reconnaître.
Les identifiants restent stables pour distinguer deux occurrences portant le même texte. C'est comparable à deux lignes de base de données qui ont la même valeur mais pas la même clé : retrouver 250.16 quelque part ne signifie pas avoir retrouvé le bon mot.
Huit pages de test n'ont pas de total. Une valeur absente n'est ni un zéro, ni une invitation à la recalculer. Le programme doit pouvoir s'abstenir. Nous vérifierons plus loin ce que mesure cette abstention.
Construire une référence simple
Avant d'entraîner le réseau, commençons par une méthode que vous pourriez écrire sans apprentissage : des expressions régulières associées à la proximité des libellés. Cette baseline, ou méthode de référence, permet de savoir si les indices du corpus suffisent déjà à des règles simples.
L'idée n'est pas seulement de reconnaître la forme d'un montant. Il faut aussi l'associer au bon libellé, comme « TOTAL » ou « SUBTOTAL ». Le code du ZIP définit les règles réellement comparées.
docker compose run --rm tutorial python -m pdflayout.cli baseline --config configs/minimum.yaml
Conservez ce résultat pour l'évaluation finale. Il répond à une question pratique : le réseau fait-il mieux qu'une solution plus simple sur les documents qui nous intéressent ? Un bon score isolé ne permet pas de le savoir.
Donner au modèle des mots et des positions
Nous avons maintenant des mots, des rectangles et des annotations. Il reste à les convertir en tableaux que le réseau pourra utiliser, sans perdre le lien avec le document.
Mettre tous les rectangles à la même échelle
Une boîte contient x0, top, x1, bottom : les limites gauche, haute, droite et basse du mot. Si vous avez déjà manipulé les dimensions d'un élément dans une page web, le principe du rectangle englobant est familier. Il faut simplement travailler dans le repère de la page PDF préparée, pas dans celui d'une fenêtre de navigateur.
Nous transformons les coordonnées de cette page canonique, c'est-à-dire ramenée à un repère commun, en entiers compris entre 0 et 1000. La rotation et le cadrage doivent être pris en compte avant cette étape. Mettre à l'échelle une boîte mal orientée ne corrigerait pas son orientation.
Dans src/pdflayout/align.py, cette fonction vérifie puis normalise chaque rectangle.
def normalize_bbox(box, width, height):
    if (
        width <= 0
        or height <= 0
        or not (0 <= box[0] <= box[2] <= width and 0 <= box[1] <= box[3] <= height)
    ):
        raise ValueError("Invalid canonical box")
    return [
        round(1000 * box[0] / width),
        round(1000 * box[1] / height),
        round(1000 * box[2] / width),
        round(1000 * box[3] / height),
    ]
Les deux coordonnées horizontales sont divisées par la largeur ; les deux verticales, par la hauteur. La multiplication par 1000 donne l'échelle attendue et round() arrondit les valeurs. Le contrôle initial rejette des dimensions de page non positives, une boîte inversée ou une boîte située hors de la page.
Prenons un exemple numérique pédagogique, indépendant des coordonnées réelles d'AL-01-03. Sur une page de largeur 600 et de hauteur 800, la boîte [300, 560, 360, 576] devient [500, 700, 600, 720]. Son bord gauche se situe à 50 % de la largeur ; son bord haut à 70 % de la hauteur.
Si l'on double la page et toutes les coordonnées de la boîte, on obtient le même rectangle normalisé. Voilà l'intérêt : représenter la position relative, pas seulement une distance dépendante du format. Ces nombres décrivent une géométrie, pas une probabilité. La documentation LayoutLM détaille le format attendu pour les boîtes.
Des mots aux sous-tokens
Le modèle ne manipule pas directement les chaînes Python. Un tokenizer transforme le texte en unités appartenant à son vocabulaire, puis en identifiants numériques. Celui de ce parcours utilise WordPiece, qui peut découper un mot en plusieurs sous-tokens. Le cours Hugging Face sur WordPiece explique ce découpage.
Un identifiant de token et un identifiant de mot n'ont donc pas le même rôle. Le premier indique une entrée du vocabulaire du modèle. Le second permet de revenir à une occurrence précise dans le PDF.
Pour chaque sous-token, nous répétons la boîte du mot d'origine. Il ne s'agit pas de prétendre connaître la position exacte de chaque fragment à l'intérieur du mot : tous les fragments restent rattachés au même rectangle source.
Il faut également convertir les annotations. Nous utilisons la convention BIO :
| Étiquette | Signification |
|---|---|
B-TOTAL |
Début d'une entité de type TOTAL. |
I-TOTAL |
Suite de cette même entité. |
O |
Mot extérieur aux champs à extraire. |
Une entité est ici un ensemble de mots portant un même rôle, par exemple la valeur du total. Une valeur sur un seul mot n'a besoin que d'une étiquette B. Avec deux étiquettes par type de champ, plus O, nos six champs donnent treize étiquettes : 6 × 2 + 1.
Le projet choisit de superviser seulement le premier sous-token de chaque mot : c'est sur lui que l'on compare la prédiction à l'étiquette attendue. Les autres sous-tokens, les tokens spéciaux et le remplissage reçoivent -100, la valeur ignorée par la fonction de perte.
La fonction suivante traduit les annotations des mots vers cette représentation.
def align_word_labels(word_ids, first_flags, word_labels, label_to_id):
    return [
        label_to_id[word_labels[word]] if word is not None and first else -100
        for word, first in zip(word_ids, first_flags)
    ]
word_ids retrouve le mot source et first_flags identifie son premier sous-token. word_labels contient les annotations par mot ; label_to_id traduit les noms d'étiquettes en nombres. La compréhension de liste parcourt ces correspondances et renvoie soit l'identifiant de l'étiquette, soit -100.
Supposons, pour illustrer la règle, qu'un mot étiqueté B-TOTAL soit découpé en trois fragments. Le premier reçoit l'identifiant de B-TOTAL ; les deux autres reçoivent -100. Ce n'est pas une trace de la tokenisation d'AL-01-03, mais un exemple du mécanisme d'alignement.
O et -100 ne sont pas interchangeables. O est une vraie réponse à apprendre : « ce mot n'appartient pas à un champ ». -100 signifie : « ne calcule pas de perte de classification sur cette position ». Les autres fragments du mot restent des entrées textuelles du réseau, même sans étiquette supervisée propre. La documentation sur la classification de tokens présente ce principe d'alignement.
Cette règle évite de multiplier le poids d'un mot dans la supervision simplement parce que le tokenizer l'a découpé en plusieurs morceaux.
Charger et entraîner LayoutLM
Nous n'allons pas apprendre à tout le réseau à partir de zéro. Nous chargeons un encodeur préentraîné, puis nous l'adaptons à nos annotations : c'est le fine-tuning, ou ajustement d'un modèle déjà entraîné. La fiche du modèle LayoutLM présente le modèle de départ.
Un encodeur transforme ses entrées en représentations numériques. LayoutLM utilise une architecture Transformer pour combiner le texte et les positions avec le contexte des autres tokens. L'idée est qu'un montant ne soit pas classé uniquement d'après ses chiffres, mais aussi d'après les indices qui l'entourent.
Une couche de classification, appelée aussi tête de classification, transforme ensuite la représentation de chaque token en treize scores, un par étiquette BIO. Ces scores bruts sont les logits. Ils ne sont ni un JSON final ni des valeurs de facture : le code devra encore les regrouper et les décoder.
La fonction du projet charge l'encodeur et initialise la couche adaptée à nos étiquettes.
def create_model(config):
    names = label_names(config["fields"])
    model, info = LayoutLMForTokenClassification.from_pretrained(
        "assets/model",
        num_labels=len(names),
        id2label=dict(enumerate(names)),
        label2id={name: i for i, name in enumerate(names)},
        local_files_only=True,
        use_safetensors=True,
        output_loading_info=True,
    )
    assert all(key.startswith("classifier.") for key in info["missing_keys"]), info
    assert not info["mismatched_keys"] and not info["error_msgs"], info
    assert all(p.requires_grad for p in model.parameters())
    return model.cuda(), info
num_labels fixe le nombre de classes. id2label et label2id conservent la correspondance dans les deux sens entre les noms et leurs identifiants. local_files_only=True impose le modèle acquis localement, tandis que use_safetensors=True demande le chargement des poids au format Safetensors.
Les informations de chargement servent aux contrôles suivants : les paramètres manquants ne sont acceptés que dans la nouvelle couche classifier, et les incohérences de dimensions ou erreurs de chargement sont refusées. Le programme ne poursuit donc pas silencieusement avec un chargement incohérent.
Enfin, requires_grad indique que les paramètres peuvent participer au calcul des gradients ; model.cuda() place le modèle sur le GPU. Tous les paramètres sont entraînables : nous ajustons aussi l'encodeur, pas seulement la nouvelle couche de classification. C'est la boucle d'entraînement qui effectuera cet ajustement.
Pour lire les tableaux, imaginons un lot de deux fenêtres de 128 positions. Les identifiants ont une forme [2, 128], les boîtes [2, 128, 4] et les logits [2, 128, 13]. Ce sont des dimensions d'exemple : deux fenêtres, 128 positions par fenêtre, treize scores par position. Ce n'est pas une configuration supplémentaire à appliquer au projet.
Une perte pour apprendre, pas seulement un score pour constater
Comment le modèle progresse-t-il ? On compare ses logits aux étiquettes attendues avec une fonction de perte, ici l'entropie croisée. Elle pénalise notamment le fait de favoriser une mauvaise étiquette. L'entraînement calcule ensuite des gradients, qui indiquent comment une variation des paramètres influence cette perte, puis l'optimiseur ajuste les paramètres. Le tutoriel PyTorch sur l'optimisation décrit ce cycle.
Le code suivant additionne les erreurs des positions supervisées et compte ces positions.
def supervised_sum(logits, labels):
    count = int((labels != -100).sum())
    if not count:
        raise ValueError("No supervised tokens")
    loss = torch.nn.functional.cross_entropy(
        logits.reshape(-1, logits.shape[-1]),
        labels.reshape(-1),
        ignore_index=-100,
        reduction="sum",
    )
    return loss, count
labels != -100 repère les positions à prendre en compte. Si aucune n'est supervisée, la fonction refuse le lot au lieu de poursuivre avec un signal d'apprentissage vide.
logits.reshape(-1, logits.shape[-1]) rassemble les positions en lignes tout en gardant les treize classes en colonnes. labels.reshape(-1) aligne les réponses attendues. ignore_index=-100 écarte les cibles ignorées et reduction="sum" additionne les pertes. La documentation de cross_entropy précise ces paramètres ; la fonction reçoit directement les logits, sans conversion préalable en probabilités dans cet extrait.
La boucle divise ensuite cette somme par le nombre de tokens supervisés du groupe d'accumulation : plusieurs lots dont on cumule les contributions avant une mise à jour. On calcule ainsi une moyenne par position supervisée, plutôt qu'une moyenne où chaque lot aurait arbitrairement le même poids.
Un petit calcul illustre la différence. Supposons un lot de 10 positions avec une perte totale de 20, puis un lot de 30 positions avec une perte totale de 30. La moyenne globale vaut (20 + 30) / (10 + 30) = 1,25. Faire la moyenne des deux moyennes donnerait (2 + 1) / 2 = 1,5. Cet exemple numérique explique la normalisation ; il ne décrit pas des pertes mesurées pendant le parcours.
Traiter les pages longues sans perdre les mots
Que se passe-t-il si une facture contient trop de texte ? Le modèle accepte des fenêtres de 512 tokens, tokens spéciaux compris. Le projet utilise au plus 510 sous-tokens de texte par fenêtre, avec un recouvrement de 128. Une partie du texte apparaît donc dans deux fenêtres voisines.
Cette limite porte sur les tokens, pas sur les mots : un mot découpé en trois fragments occupe trois positions. Couper simplement le texte à la limite pourrait faire disparaître la fin de la facture, précisément là où un total peut se trouver.
Le fenêtrage résout le problème de longueur, mais crée une nouvelle question : quelle prédiction conserver lorsqu'un même mot apparaît dans plusieurs fenêtres ?
Nous fusionnons les logits au niveau du mot en donnant davantage de poids aux positions éloignées des bords. Ce choix favorise les positions entourées de davantage de contexte dans la fenêtre ; il ne prouve pas que leur prédiction soit toujours meilleure. Voici la fonction complète.
def merge_logits(windows, logits, word_count):
    classes = logits[0].shape[-1]
    total = torch.zeros(word_count, classes, dtype=torch.float64)
    weights = torch.zeros(word_count, dtype=torch.float64)
    contributions = torch.zeros(word_count, dtype=torch.long)
    for window, values in zip(windows, logits):
        length = len(window["input_ids"])
        for token, (word, first) in enumerate(
            zip(window["word_ids"], window["first_flags"])
        ):
            if not first:
                continue
            weight = min(16, token, length - 1 - token)
            assert weight > 0
            total[word] += weight * values[token].double().cpu()
            weights[word] += weight
            contributions[word] += 1
    if not bool((weights > 0).all()):
        raise ValueError("A word was dropped by windowing")
    return total / weights[:, None], contributions.tolist()
total contient un vecteur de scores par mot ; weights conserve la somme des poids et contributions compte les contributions reçues. La boucle ne retient que les premiers sous-tokens, comme pour la supervision.
La variable weight, calculée par min(16, token, length - 1 - token), mesure la proximité des deux bords et plafonne le poids à 16. Une position près d'un bord pèse moins qu'une position suffisamment à l'intérieur. assert weight > 0 vérifie qu'une contribution conservée a un poids positif.
Nous additionnons les scores pondérés, puis divisons chaque vecteur par sa somme de poids. Dans weights[:, None], la dimension supplémentaire permet d'appliquer le même diviseur à toutes les classes d'un mot. Les valeurs sont accumulées sur CPU en float64, comme l'indiquent .double().cpu() et l'initialisation des tableaux.
Voici un exemple de calcul, pas une sortie observée : un mot reçoit, pour une même classe, un logit de 2 avec un poids de 4, puis un logit de 6 avec un poids de 12. Le score fusionné vaut (4 × 2 + 12 × 6) / (4 + 12) = 5. Cette opération est répétée pour chaque classe. Le résultat reste un logit, pas une probabilité.
Enfin, le contrôle weights > 0 exige une contribution pour chaque mot. Si un mot disparaît lors du découpage, la fonction lève une erreur plutôt que de produire discrètement une extraction incomplète. contributions permet de voir combien de fenêtres ont participé à la prédiction de chaque mot.
Entraîner, comparer et reprendre
Nous allons entraîner deux variantes : layout, avec les rectangles réels, et neutral, avec des rectangles nuls pendant l'entraînement et l'inférence. « Nuls » signifie ici des coordonnées à zéro, pas des mots supprimés.
La variante neutre permet de poser une question précise : le modèle peut-il apprendre cette tâche sans les différences de position entre les boîtes ? Le texte reste présent. Elle n'efface pas non plus l'ordre des tokens dans la séquence. Nous retirons un signal géométrique variable, pas toute l'information du document.
Nous contrôlons également la reprise d'entraînement. Les commandes suivantes entraînent le modèle principal interrompu, la variante neutre, une référence continue, puis reprennent le modèle interrompu dans un autre processus.
docker compose run --rm tutorial python -m pdflayout.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdflayout.cli train-neutral --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdflayout.cli train-continuous --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdflayout.cli train-resume --config configs/minimum.yaml
Une époque correspond à un passage sur les exemples d'entraînement. Le parcours principal prévoit cinq époques, avec une interruption après deux pour tester la reprise. La référence continue réalise le parcours sans cette coupure ; la reprise recharge l'état interrompu pour effectuer les trois époques restantes.
Pourquoi ne pas vérifier seulement que le score final est proche ? Parce que deux modèles différents peuvent obtenir le même score sur un petit corpus. Reprendre la même expérience demande de retrouver l'état de calcul, pas simplement d'atteindre une performance ressemblante.
La comparaison suivante vérifie notamment les paramètres, l'optimiseur et les états aléatoires.
docker compose run --rm tutorial python -m pdflayout.cli verify-resume --config configs/minimum.yaml
Résultat du parcours validé : une reprise exacte, avec un écart maximal nul entre les paramètres comparés. Cela contrôle cette procédure et cet environnement. Ne supposez pas la même identité numérique après un changement de matériel ou de dépendance.
Prédire sans consulter les annotations
Nous arrivons à l'inférence : utiliser le modèle entraîné pour produire des prédictions, sans ajuster ses paramètres avec les réponses attendues.
Le service d'inférence ne monte pas le répertoire des annotations. Il charge les mots, les boîtes et les poids, fusionne les fenêtres, puis décode les étiquettes. La situation doit ressembler à celle d'un document reçu par votre application : le texte est disponible, sa correction ne l'est pas.
docker compose run --rm inference python -m pdflayout.cli predict --config configs/minimum.yaml
Ouvrez outputs/example.json. Pour AL-01-03, la variante layout retrouve TOTAL = 250.16 sur le mot 62, avec sa boîte dans la page. Elle retrouve aussi le sous-total et la taxe attendus. Suivez ces liens jusqu'aux mots : ce fichier ne se contente pas d'annoncer des nombres, il indique quelles occurrences ont été retenues.
Passer des étiquettes aux champs
Le décodeur rassemble les suites BIO en entités. Si un I est incohérent, il le répare en début d'entité et compte cette réparation. Par exemple, une suite pédagogique O, I-TOTAL peut devenir O, B-TOTAL : une continuation sans début devient un nouveau début. Réparer la forme de la suite ne prouve pas que le mot choisi est le bon.
Pour chaque champ, le programme renvoie une valeur lorsqu'il existe un seul candidat. Aucun candidat ou plusieurs candidats conduisent à une valeur vide, avec les ambiguïtés conservées. Il ne choisit donc pas arbitrairement entre deux totaux possibles ; l'application peut demander une vérification humaine.
Attention au sens d'une sortie vide : elle peut correspondre à un champ absent, mais aussi à un échec de détection ou à une ambiguïté. La provenance et les candidats aident à analyser le résultat ; ils ne constituent ni une garantie de justesse ni une garantie comptable.
Comprendre les métriques avant les résultats
Une métrique est une mesure du comportement du programme. Nous en utilisons plusieurs parce qu'elles ne répondent pas toutes à la même question.
Avons-nous retrouvé les bonnes entités ?
Une entité est correcte si son type et ses identifiants de mots correspondent exactement à la référence. Sur une page où le même montant apparaît deux fois, prendre la mauvaise occurrence reste donc une erreur, même si la chaîne de caractères est identique.
La précision mesure la proportion d'entités prédites qui sont correctes. Le rappel mesure la proportion d'entités attendues qui ont été retrouvées.
Prenons un exemple de calcul : nous prédisons quatre entités, trois sont correctes, et cinq étaient attendues. La précision vaut 3 / 4 = 0,75, le rappel 3 / 5 = 0,60. Le F1 combine les deux : 2 × précision × rappel / (précision + rappel). Il vaut ici environ 0,667. Ce n'est pas un score du tutoriel, mais une illustration de la formule.
Le micro-F1 rassemble les comptes de toutes les entités avant le calcul. Le macro-F1 calcule le F1 de chaque type de champ, puis en fait la moyenne. Cette seconde lecture évite davantage qu'un champ difficile soit masqué par les autres.
La facture est-elle entièrement correcte ?
L'exactitude documentaire exige que tous les champs soient corrects sur une facture. Dans un exemple de dix factures, neuf entièrement correctes donnent 0,9. Beaucoup de champs isolés peuvent être justes alors que peu de documents sont entièrement réussis : un seul champ erroné suffit à faire échouer le document.
Le taux d'erreur des montants compare les valeurs numériques. Plus il est bas, mieux c'est. Ce contrôle ne remplace pas celui des entités : retrouver le bon nombre sur le mauvais mot peut préserver la valeur numérique tout en perdant la bonne provenance.
La provenance et l'abstention sont-elles pertinentes ?
Une provenance valide signifie que les références pointent correctement vers les mots et les boîtes de la page. Elle ne garantit pas que ces mots portent le bon rôle. Une référence techniquement valide peut renvoyer au sous-total alors que l'on cherchait le total.
L'abstention sur les factures sans total vérifie que le programme ne leur attribue pas un total inventé. Mais un système qui ne renvoie jamais rien pourrait réussir ce seul critère tout en ratant tous les champs présents. Gardons cette limite en tête avant de lire les résultats.
Lançons l'évaluation, qui peut accéder aux annotations séparément de l'inférence.
docker compose run --rm tutorial python -m pdflayout.cli evaluate --config configs/minimum.yaml
Résultats du parcours r002
Les résultats suivants portent sur les 96 pages de test, avec 568 entités attendues. Ils proviennent de outputs/evaluation.json. Ce compte est cohérent avec six champs par page et huit totaux absents : 96 × 6 − 8 = 568.
Sur mobile, faites défiler le tableau horizontalement.
| Méthode | Micro-F1 | Macro-F1 des champs | Exactitude documentaire | Erreur des montants |
|---|---|---|---|---|
| Règles simples | 1,00 | 1,00 | 1,00 | 0,00 |
| LayoutLM, rectangles réels | 1,00 | 1,00 | 1,00 | 0,00 |
| LayoutLM, entraînement neutre | 1,00 | 1,00 | 1,00 | 0,00 |
| Rectangles masqués seulement à l'inférence | 0,00 | 0,00 | 0,00 | 1,00 |
Deux façons très différentes de « retirer les positions »
Les trois premières méthodes atteignent les mêmes scores. La dernière ligne, en revanche, correspond au modèle entraîné avec les vrais rectangles, auxquels on substitue des zéros seulement au moment de prédire.
Ce n'est pas la variante neutre. neutral a appris dès le départ avec cette représentation constante. Le modèle masqué, lui, reçoit brusquement des positions différentes de celles avec lesquelles il a appris à travailler.
L'analogie avec une application web peut aider : prévoir dès sa conception qu'un champ sera toujours constant n'est pas la même chose que remplacer sa valeur par zéro après avoir construit des traitements qui s'appuient dessus. Pour le réseau, la différence tient aux exemples d'entraînement qui ont guidé ses paramètres.
Le masquage tardif mesure une sensibilité à une modification des entrées ; il ne démontre pas que la tâche serait impossible à apprendre sans géométrie. La réussite de neutral montre justement l'inverse sur ce corpus.
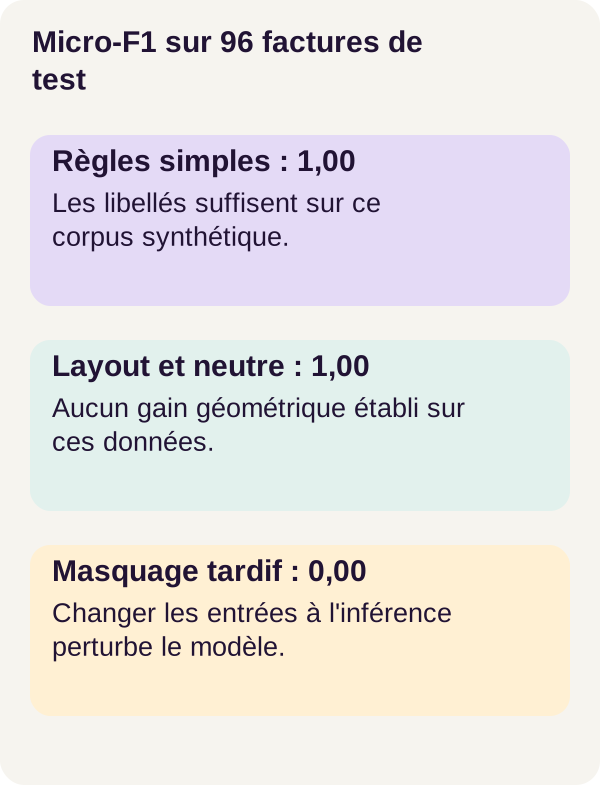
Ces scores décrivent le corpus synthétique du tutoriel. Ils n'établissent pas un avantage du modèle géométrique sur les règles simples.
Les trois premières méthodes réussissent aussi les sous-groupes des huit pages longues, des huit pages à montants répétés et des huit pages sans total.
La variante masquée ne prédit aucune entité. Son abstention sur les totaux absents vaut donc 1, mais cette valeur isolée cache son échec sur les champs présents. De même, un taux de provenance valide de 1 peut accompagner une sortie vide : aucune référence invalide n'a été produite, sans qu'une seule extraction utile ait été obtenue.
La conclusion n'est donc pas « la géométrie ne sert jamais ». Elle est plus précise : sur ce corpus, les règles simples et le modèle neutre suffisent déjà à atteindre les mêmes scores que LayoutLM avec les rectangles réels. Nous avons compris et mesuré le mécanisme, pas établi sa supériorité sur toutes les factures.
Tester ce qui doit échouer
Un test négatif soumet au programme une situation qui doit être refusée. Les tests lancés au début vérifient notamment les boîtes invalides, les mots perdus par le fenêtrage et les entrées incohérentes.
Leur intérêt est concret : un résultat apparemment plausible est difficile à diagnostiquer si une partie du document a disparu avant la prédiction. Mieux vaut signaler l'entrée invalide que masquer le problème avec une sortie rassurante.
Consultez les tests pour voir les cas exacts avant d'adapter vos documents. Réussir les cas couverts ne signifie pas que toutes les situations possibles ont été explorées.
Ce que nous avons appris
Nous sommes partis d'un montant dans une page pour arriver à un champ relié à sa source. Le texte fournit des indices lexicaux ; les rectangles donnent une localisation. LayoutLM combine leurs représentations, puis la couche de classification propose des rôles pour les tokens.
L'alignement permet de revenir des sous-tokens aux mots. Le fenêtrage traite une page longue, et la fusion évite d'avoir plusieurs décisions indépendantes pour une même occurrence. Le décodeur assemble ensuite les entités et conserve les ambiguïtés.
Enfin, la traçabilité, la justesse et l'intérêt de l'apprentissage sont trois questions distinctes. Une boîte valide n'assure pas un bon champ ; un score parfait sur un corpus synthétique ne garantit pas un service fiable ; un réseau complexe n'apporte pas nécessairement un gain sur des règles simples. Les résultats du parcours illustrent ces différences.
Exercice : prévoir avant de déplacer
Revenons à notre problème de total et de sous-total. Nous allons échanger les positions des blocs TOTAL et SUBTOTAL, sans changer leurs valeurs. Avant d'exécuter, écrivez votre hypothèse : quels indices resteront disponibles aux règles, au modèle géométrique et au modèle neutre ? Le déplacement doit-il nécessairement modifier leurs prédictions ? Pourquoi ?
Le projet fournit cette modification dans configs/exercise.yaml. Comparez les deux pages de l'expérience et notez les champs qui, selon vous, devraient changer. Exécutez ensuite la variante préparée.
docker compose run --rm tutorial python -m pdflayout.cli exercise --config configs/exercise.yaml
Comparez votre prédiction aux résultats d'exercice. La référence validée retrouve les douze entités avec les règles, layout et neutral ; la variante masquée n'en retrouve aucune. La correction détaillée est dans lesson/SOLUTIONS.md.
Pourquoi le déplacement ne suffit-il pas à mettre ces méthodes en difficulté ? Les libellés restent ici suffisamment discriminants. Changer la position d'un bloc ne fait pas disparaître tous les autres indices. Cette expérience ne démontre donc pas, à elle seule, l'utilité de la géométrie.
Pour une expérience personnelle, choisissez ensuite une seule modification dans le générateur, par exemple rendre un libellé ambigu. Prédisez l'effet sur chaque méthode avant de régénérer les données et de rejouer le parcours. Conservez séparément vos résultats et ceux de référence.
Cette nouvelle expérience n'a pas de résultat annoncé. L'intérêt est précisément de mesurer ce qui change, puis d'expliquer les erreurs ou les réussites, y compris lorsqu'elles contredisent votre intuition.
Observer les figures et contrôler les checkpoints
Générez les figures depuis vos propres résultats, puis contrôlez les fichiers de modèle attendus.
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Les figures du dossier outputs/ permettent d'inspecter la facture, les sous-tokens et les résultats. Vérifiez la correspondance entre un champ, son mot et sa boîte avant de vous contenter du tableau agrégé.
Pour AL-01-03, le contrôle visuel consiste notamment à retrouver le mot 62 portant 250.16, puis à vérifier que le champ TOTAL renvoie bien à cette occurrence. Une moyenne ne remplace pas cette lecture d'un exemple.
En cas de problème
Commencez par identifier l'étape qui échoue : accès au GPU, acquisition, préparation des mots, découpage ou prédiction. Modifier le modèle ne résoudrait pas une boîte mal orientée avant même son entrée dans le réseau.
Sur mobile, faites défiler le tableau horizontalement.
| Symptôme | Vérification et correction |
|---|---|
| GPU absent dans Docker | Comparez le preflight hôte et le contrôle conteneur. Corrigez l'intégration NVIDIA Container Toolkit avant l'entraînement. |
| Modèle absent ou acquisition interrompue | Consultez les erreurs de scripts/acquire.py, vérifiez la place libre et relancez l'acquisition prévue ; conservez le modèle et la révision verrouillés. |
| Boîte rejetée | Vérifiez les dimensions, le cadrage et la rotation de la page canonique. Une boîte hors page ne doit pas être rendue valide en masquant l'erreur. |
| Mot perdu lors du découpage | Inspectez les identifiants et les premiers sous-tokens des fenêtres. Le contrôle doit rester actif. |
| Entrée sans texte exploitable | Vérifiez que le PDF contient du texte natif. Les scans nécessitent une étape OCR supplémentaire, hors du parcours validé ici. |
Arrêter et nettoyer
Avant de nettoyer, conservez les résultats et les figures que vous souhaitez étudier. La première commande arrête le projet, le script supprime uniquement les résultats de outputs/, puis le dernier arrêt termine le parcours.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Les actifs du modèle, les checkpoints dans assets/ et les données générées sont conservés. Aucune purge Docker globale n'est nécessaire. Le nettoyage ne signifie donc pas que les poids ou le corpus devront être téléchargés ou générés de nouveau.
Du tutoriel à une application réelle
Le premier travail n'est pas d'ajouter un endpoint à ce script : c'est de vérifier qu'il fonctionne sur les documents de votre application. Des factures métier imposent une ingestion contrôlée, une diversité de langues et de formats, une stratégie OCR pour les scans et une gestion des pages multiples.
Constituez un corpus annoté représentatif avec une séparation des fournisseurs ou des gabarits, puis analysez les erreurs par champ et par type de document. Un score global peut masquer une difficulté sur les dates d'un fournisseur ou les totaux d'un format particulier. Ces exemples décrivent les analyses à prévoir, pas des erreurs déjà mesurées ici.
Ajoutez selon vos besoins authentification, autorisations documentaires, protection des données, limites de taille, file de traitement, journalisation et supervision. Définissez les cas d'abstention et une validation humaine pour les valeurs ambiguës. La provenance conservée peut aider à cette relecture, mais l'interface et le processus métier restent à construire.
Versionnez les modèles, les configurations et les données d'évaluation pour détecter les régressions. Ce moteur pédagogique n'établit aucune conformité comptable et ne constitue pas, à lui seul, un service de production.
Pour aller plus loin
Commencez par tester des factures de gabarits réellement différents avec des annotations vérifiées. Comparez les erreurs des règles et du modèle sur des libellés volontairement ambigus : c'est une façon de rechercher les situations où l'apprentissage pourrait apporter un gain, puis de le mesurer.
Une autre extension consiste à ajouter une chaîne OCR pour obtenir des mots et des boîtes à partir de scans. Elle introduit ses propres erreurs ; il faudra évaluer cette nouvelle chaîne, pas lui attribuer les scores du parcours sur texte natif.
Enfin, vous pouvez construire une interface qui montre chaque valeur avec sa zone source et permet une correction humaine. Ce prolongement relie directement la mécanique du tutoriel à un besoin d'application web : laisser l'utilisateur vérifier une proposition au lieu de lui présenter un nombre sans origine.
Sources pour approfondir
Le README, le code et les leçons du ZIP constituent le parcours reproductible utilisé ici. Les scores publiés sont ceux du parcours r002 ; les exemples numériques signalés dans l'article servent uniquement à expliquer les calculs.
La documentation LayoutLM de Transformers, version 4.56.2 décrit les entrées textuelles et géométriques ainsi que la classification de tokens. La fiche du modèle LayoutLM présente le modèle préentraîné.
Pour approfondir les étapes intermédiaires, consultez la documentation de pdfplumber, le cours sur WordPiece et le guide de classification de tokens. Les explications sur l'apprentissage s'appuient aussi sur la documentation de l'entropie croisée PyTorch et son tutoriel d'optimisation des paramètres.
Ces compléments documentaires ne remplacent pas les fichiers verrouillés du ZIP. Les documentations en ligne peuvent évoluer indépendamment de l'environnement validé ; conservez les versions et les commandes du projet pour le reproduire.