





Está añadiendo una importación de facturas a una aplicación web. La descarga funciona, el PDF se abre y su extractor encuentra los números de la página. Solo queda rellenar los campos del formulario… pero ¿cuál de esos números es el total?
Una expresión regular puede reconocer 250.16. Por sí sola no indica si es el importe a pagar, un impuesto o un subtotal. Para saberlo, leemos las etiquetas cercanas al número y observamos dónde está situado. Nuestro programa también aprovechará el texto y la posición.
Vamos a construir un extractor de campos con Python, Docker y LayoutLM. Seguiremos la factura ficticia AL-01-03: su subtotal es 250.00, su impuesto 0.16 y su total 250.16. Estos valores son nuestro hilo conductor, no una regla contable que el modelo deba aprender. Queremos recuperar los importes escritos en el documento, no recalcular ni inventar un campo ausente.
El resultado buscado cabe en una frase: encontrar un valor, determinar su función y mostrar de dónde procede. También compararemos la red con reglas sencillas. El objetivo es entender qué aporta cada método, no suponer que el que utiliza IA será necesariamente mejor.
Descargar el proyecto completo del tutorial
Lo que va a construir y aprender
Nuestro programa toma PDF con texto nativo y devuelve seis campos: número de factura, fecha, proveedor, subtotal, impuesto y total. Cada valor conserva su página, sus palabras y sus rectángulos. Un campo ausente o ambiguo puede quedar vacío.
Aquí, un PDF nativo contiene caracteres que el programa puede extraer. No es el mismo punto de partida que un escaneo que solo contiene una imagen: este necesitaría primero reconocimiento óptico de caracteres, u OCR. Esta etapa no forma parte del recorrido presentado.
La cadena de procesamiento es la siguiente:
PDF → palabras y rectángulos → subtokens → LayoutLM → etiquetas por palabra → campos acompañados de su procedencia.
Imagine una operación de resaltado: el programa debe asociar unas palabras con «total», otras con «fecha» y dejar aparte las palabras que no tienen función en nuestros seis campos. Una etiqueta describe la función elegida; el rectángulo permite volver a encontrar la palabra en la página.
LayoutLM combina representaciones aprendidas del texto y de las posiciones. En este tutorial, clasifica tokens; no redacta una respuesta ni lee directamente los píxeles de un escaneo. El código Python extrae los datos, prepara las entradas, reúne las predicciones y comprueba los resultados.
Aprenderemos a llevar las coordenadas a una escala común, conservar el vínculo entre palabras y fragmentos, entrenar el clasificador y tratar una página demasiado larga para una sola ventana. Después veremos cómo medir la calidad de la extracción sin confundir un valor correcto con una buena localización.
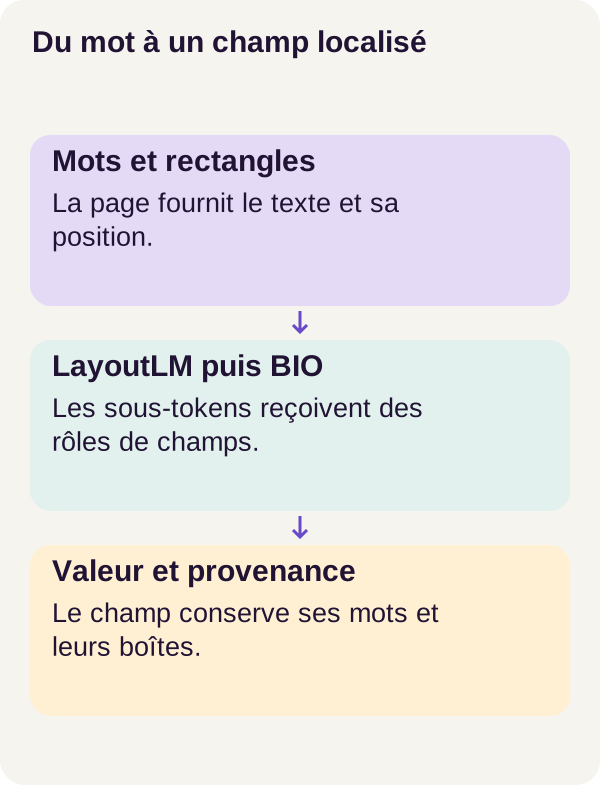
Una caja localiza una palabra; una etiqueta describe su función. La procedencia permite volver a la página.
Preparar el entorno
Debe saber usar Python, una terminal y Docker. No es necesario conocer ya LayoutLM. Explicaremos los conceptos neuronales cuando aparezcan: un tensor es aquí una tabla de números, y el entrenamiento ajusta los parámetros del modelo a partir de ejemplos anotados.
El recorrido se validó en Linux con una RTX 3090 de 24 GiB. El README prevé 32 GiB de RAM y 24 GiB de disco: son indicaciones de dimensionamiento, no mínimos medidos en todas las máquinas. La RAM es la memoria del ordenador; los 24 GiB de la tarjeta gráfica corresponden a su propia memoria, la VRAM.
Prepare Docker Engine, Compose y una GPU NVIDIA que los contenedores puedan usar. Conserve las dependencias y configuraciones del ZIP para reproducir el recorrido r002.
Comprobar que Docker ve su GPU
Que una GPU sea visible en el host no garantiza que un programa Docker pueda utilizarla. El siguiente script comprueba el host y Docker; después verificaremos CUDA desde el contenedor. CUDA es el entorno de cálculo utilizado aquí para ejecutar las operaciones de la red en la GPU.
NVIDIA Container Toolkit proporciona la integración entre el motor Docker y los controladores NVIDIA del host. Su instalación depende de su sistema: use la documentación oficial de NVIDIA.
Descomprima el ZIP y abra una terminal en su carpeta raíz, la que contiene README.md y compose.yaml. Todos los comandos siguientes parten de esta carpeta. Empiece por las comprobaciones previas.
sh scripts/preflight.sh
Corrija cualquier comprobación bloqueante antes de continuar. Después, el script de preparación crea los directorios necesarios, Compose valida su configuración y construye los tres servicios.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
Cada servicio tiene una función: acquisition descarga los recursos, tutorial prepara los datos y entrena el modelo, e inference predice a partir de los PDF y los pesos guardados. Los pesos son los parámetros numéricos aprendidos por la red.
Para orientarse en los archivos, assets/ conserva el modelo y los checkpoints, data/generated/ contiene el corpus y outputs/ recibe los resultados. Un checkpoint es una copia de un estado de entrenamiento; también lo utilizaremos para comprobar una reanudación tras una interrupción.
La inferencia dispone de las entradas y de los pesos en solo lectura, sin anotaciones de referencia ni acceso a la red. El archivo Compose completo del ZIP detalla los montajes y las restricciones. Esta separación evita, en este recorrido, dar las respuestas esperadas al servicio encargado de predecirlas. No sustituye los controles de acceso de una aplicación real.
Adquirir el modelo una vez
Usamos microsoft/layoutlm-base-uncased. Su revisión 30e3cdd39c11f09757b0fcf7598533d05052acef queda fijada para recuperar los mismos archivos. scripts/acquire.py comprueba sus tamaños y las huellas definidas en locks/models.lock.json, y luego los guarda en assets/model/.
Puede comparar este bloqueo con el de las dependencias de un proyecto web: conservar un nombre no basta; también hay que saber qué versión y qué archivos se utilizaron. Internet sirve para esta adquisición; después, la carga del modelo utiliza archivos locales.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
Comprobemos ahora el entorno desde Docker y luego las pruebas. El primer control completa el del host: lo importante es el acceso efectivo del programa en contenedor a la GPU.
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Qué observar: el recorrido validado obtiene 26 pruebas correctas. Estas pruebas comprueban, entre otras cosas, las coordenadas, la alineación, las ventanas y los casos no válidos. Verifican comportamientos del programa; no garantizan que el modelo sepa tratar sus propias facturas.
Entender los datos antes de predecir
Tres grupos de documentos, tres funciones
El corpus sintético incluye 600 páginas y 50 familias de diseño. «Sintético» significa que las facturas se generan para el experimento en vez de recogerse de clientes reales. Una familia reúne documentos que comparten una plantilla de diseño.
La separación se hace por familias: 420 páginas de entrenamiento, 84 de validación y 96 de prueba. El entrenamiento ajusta los parámetros. La validación selecciona el checkpoint. La prueba mide después el resultado final en documentos que no se usaron para esas decisiones.
¿Por qué no mezclar todas las páginas al azar? Porque un método podría tener éxito reconociendo una plantilla ya vista sin comportarse bien frente a una presentación nueva. Separar las familias reduce este riesgo, sin reproducir toda la diversidad del mundo real.
Leer una factura antes de leer los tensores
Las facturas ficticias de Alder contienen texto nativo en inglés. pdfplumber extrae sus palabras y rectángulos; su documentación sobre extracción de texto describe estos objetos. Las anotaciones asocian las palabras a los campos esperados: son las respuestas de referencia usadas para aprender y medir, nunca para predecir.
Creemos los datos e inspeccionemos un lote, o batch: un conjunto de entradas preparadas para el modelo.
docker compose run --rm tutorial python -m pdflayout.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdflayout.cli inspect-batch --config configs/minimum.yaml
Observe los identificadores de tokens, los rectángulos y las etiquetas. Para AL-01-03, nos interesan especialmente tres palabras:
| Identificador de palabra | Texto extraído | Función esperada |
|---|---|---|
55 |
250.00 |
Subtotal |
58 |
0.16 |
Impuesto |
62 |
250.16 |
Total |
Estas correspondencias proceden del caso de referencia. El modelo recibe el texto y su posición; durante el entrenamiento, la anotación le indica la función que debía reconocer.
Los identificadores se mantienen estables para distinguir dos apariciones con el mismo texto. Se parece a dos filas de base de datos con el mismo valor pero distinta clave: encontrar 250.16 en algún lugar no significa haber encontrado la palabra correcta.
Ocho páginas de prueba no tienen total. Un valor ausente no es un cero ni una invitación a recalcularlo. El programa debe poder abstenerse. Más adelante comprobaremos qué mide esta abstención.
Construir una referencia sencilla
Antes de entrenar la red, empecemos por un método que podría escribir sin aprendizaje: expresiones regulares asociadas a la proximidad de las etiquetas. Esta baseline, o método de referencia, permite saber si los indicios del corpus ya bastan para reglas sencillas.
La idea no es solo reconocer la forma de un importe. También hay que asociarlo a la etiqueta correcta, como «TOTAL» o «SUBTOTAL». El código del ZIP define las reglas que realmente se comparan.
docker compose run --rm tutorial python -m pdflayout.cli baseline --config configs/minimum.yaml
Conserve este resultado para la evaluación final. Responde a una pregunta práctica: ¿la red funciona mejor que una solución más sencilla en los documentos que nos interesan? Un buen resultado aislado no permite saberlo.
Dar al modelo palabras y posiciones
Ahora tenemos palabras, rectángulos y anotaciones. Falta convertirlos en tablas que la red pueda usar sin perder el vínculo con el documento.
Llevar todos los rectángulos a la misma escala
Una caja contiene x0, top, x1, bottom: los límites izquierdo, superior, derecho e inferior de la palabra. Si ya ha manipulado las dimensiones de un elemento en una página web, el principio del rectángulo delimitador le resultará familiar. Solo hay que trabajar en el sistema de coordenadas de la página PDF preparada, no en el de una ventana del navegador.
Transformamos las coordenadas de esta página canónica, es decir, llevada a un sistema común, en enteros entre 0 y 1000. La rotación y el recorte deben tenerse en cuenta antes de este paso. Escalar una caja mal orientada no corregiría su orientación.
En src/pdflayout/align.py, esta función valida y normaliza cada rectángulo.
def normalize_bbox(box, width, height):
    if (
        width <= 0
        or height <= 0
        or not (0 <= box[0] <= box[2] <= width and 0 <= box[1] <= box[3] <= height)
    ):
        raise ValueError("Invalid canonical box")
    return [
        round(1000 * box[0] / width),
        round(1000 * box[1] / height),
        round(1000 * box[2] / width),
        round(1000 * box[3] / height),
    ]
Las dos coordenadas horizontales se dividen por la anchura; las dos verticales, por la altura. La multiplicación por 1000 da la escala esperada y round() redondea los valores. El control inicial rechaza dimensiones de página no positivas, una caja invertida o una caja situada fuera de la página.
Tomemos un ejemplo numérico pedagógico, independiente de las coordenadas reales de AL-01-03. En una página de anchura 600 y altura 800, la caja [300, 560, 360, 576] pasa a ser [500, 700, 600, 720]. Su borde izquierdo está al 50 % de la anchura; su borde superior, al 70 % de la altura.
Si duplicamos la página y todas las coordenadas de la caja, obtenemos el mismo rectángulo normalizado. Esa es la utilidad: representar una posición relativa, no solo una distancia dependiente del formato. Estos números describen una geometría, no una probabilidad. La documentación de LayoutLM detalla el formato esperado para las cajas.
De palabras a subtokens
El modelo no manipula directamente cadenas Python. Un tokenizer transforma el texto en unidades de su vocabulario y después en identificadores numéricos. El de este recorrido usa WordPiece, que puede dividir una palabra en varios subtokens. El curso de Hugging Face sobre WordPiece explica esta división.
Por tanto, un identificador de token y un identificador de palabra no tienen la misma función. El primero indica una entrada del vocabulario del modelo. El segundo permite volver a una aparición concreta en el PDF.
Para cada subtoken repetimos la caja de la palabra original. No pretendemos conocer la posición exacta de cada fragmento dentro de la palabra: todos los fragmentos siguen vinculados al mismo rectángulo de origen.
También hay que convertir las anotaciones. Usamos la convención BIO:
| Etiqueta | Significado |
|---|---|
B-TOTAL |
Inicio de una entidad de tipo TOTAL. |
I-TOTAL |
Continuación de esa misma entidad. |
O |
Palabra externa a los campos que se deben extraer. |
Una entidad es aquí un conjunto de palabras con la misma función, por ejemplo el valor del total. Un valor de una sola palabra solo necesita una etiqueta B. Con dos etiquetas por tipo de campo, más O, nuestros seis campos dan trece etiquetas: 6 × 2 + 1.
El proyecto decide supervisar solo el primer subtoken de cada palabra: ahí se compara la predicción con la etiqueta esperada. Los demás subtokens, los tokens especiales y el relleno reciben -100, el valor que la función de pérdida ignora.
La siguiente función traduce las anotaciones de las palabras a esta representación.
def align_word_labels(word_ids, first_flags, word_labels, label_to_id):
    return [
        label_to_id[word_labels[word]] if word is not None and first else -100
        for word, first in zip(word_ids, first_flags)
    ]
word_ids recupera la palabra fuente y first_flags identifica su primer subtoken. word_labels contiene las anotaciones por palabra; label_to_id traduce los nombres de etiquetas en números. La comprensión de lista recorre estas correspondencias y devuelve el identificador de etiqueta o -100.
Supongamos, para ilustrar la regla, que una palabra etiquetada B-TOTAL se divide en tres fragmentos. El primero recibe el identificador de B-TOTAL; los otros dos reciben -100. No es un rastro de la tokenización de AL-01-03, sino un ejemplo del mecanismo de alineación.
O y -100 no son intercambiables. O es una respuesta real que hay que aprender: «esta palabra no pertenece a un campo». -100 significa: «no calcules pérdida de clasificación en esta posición». Los demás fragmentos de la palabra siguen siendo entradas textuales de la red, incluso sin su propia etiqueta supervisada. La documentación sobre clasificación de tokens presenta este principio de alineación.
Esta regla evita multiplicar el peso de una palabra en la supervisión simplemente porque el tokenizer la dividió en varias partes.
Cargar y entrenar LayoutLM
No aprenderemos toda la red desde cero. Cargamos un codificador preentrenado y lo adaptamos a nuestras anotaciones: es el fine-tuning, o ajuste de un modelo ya entrenado. La ficha del modelo LayoutLM presenta el modelo inicial.
Un codificador transforma sus entradas en representaciones numéricas. LayoutLM usa una arquitectura Transformer para combinar texto y posiciones con el contexto de los demás tokens. Así, un importe no se clasifica solo por sus cifras, sino también por los indicios que lo rodean.
Una capa de clasificación, también llamada cabeza de clasificación, transforma la representación de cada token en trece puntuaciones, una por etiqueta BIO. Estas puntuaciones brutas son los logits. No son un JSON final ni valores de factura: el código todavía debe agruparlos y decodificarlos.
La función del proyecto carga el codificador e inicializa la capa adaptada a nuestras etiquetas.
def create_model(config):
    names = label_names(config["fields"])
    model, info = LayoutLMForTokenClassification.from_pretrained(
        "assets/model",
        num_labels=len(names),
        id2label=dict(enumerate(names)),
        label2id={name: i for i, name in enumerate(names)},
        local_files_only=True,
        use_safetensors=True,
        output_loading_info=True,
    )
    assert all(key.startswith("classifier.") for key in info["missing_keys"]), info
    assert not info["mismatched_keys"] and not info["error_msgs"], info
    assert all(p.requires_grad for p in model.parameters())
    return model.cuda(), info
num_labels fija el número de clases. id2label y label2id conservan la correspondencia en ambos sentidos entre nombres e identificadores. local_files_only=True impone el modelo adquirido localmente, mientras que use_safetensors=True solicita cargar los pesos en formato Safetensors.
La información de carga sirve para los controles siguientes: los parámetros ausentes solo se aceptan en la nueva capa classifier, y se rechazan las incoherencias de dimensión o errores de carga. El programa no continúa silenciosamente con una carga incoherente.
Por último, requires_grad indica que los parámetros pueden participar en el cálculo de gradientes; model.cuda() coloca el modelo en la GPU. Todos los parámetros se entrenan: ajustamos también el codificador, no solo la nueva capa de clasificación. El bucle de entrenamiento realizará ese ajuste.
Para leer las tablas, imaginemos un lote de dos ventanas de 128 posiciones. Los identificadores tienen forma [2, 128], las cajas [2, 128, 4] y los logits [2, 128, 13]. Son dimensiones de ejemplo: dos ventanas, 128 posiciones por ventana y trece puntuaciones por posición. No es una configuración adicional que deba aplicar al proyecto.
Una pérdida para aprender, no solo una puntuación que constatar
¿Cómo progresa el modelo? Comparamos sus logits con las etiquetas esperadas mediante una función de pérdida, aquí la entropía cruzada. Penaliza, entre otras cosas, favorecer una etiqueta incorrecta. El entrenamiento calcula después gradientes, que indican cómo influye una variación de parámetros en esa pérdida, y el optimizador ajusta los parámetros. El tutorial de optimización de PyTorch describe este ciclo.
El código siguiente suma los errores de las posiciones supervisadas y cuenta esas posiciones.
def supervised_sum(logits, labels):
    count = int((labels != -100).sum())
    if not count:
        raise ValueError("No supervised tokens")
    loss = torch.nn.functional.cross_entropy(
        logits.reshape(-1, logits.shape[-1]),
        labels.reshape(-1),
        ignore_index=-100,
        reduction="sum",
    )
    return loss, count
labels != -100 localiza las posiciones que se deben tener en cuenta. Si ninguna está supervisada, la función rechaza el lote en vez de continuar con una señal de aprendizaje vacía.
logits.reshape(-1, logits.shape[-1]) reúne las posiciones en filas y mantiene las trece clases en columnas. labels.reshape(-1) alinea las respuestas esperadas. ignore_index=-100 excluye los objetivos ignorados y reduction="sum" suma las pérdidas. La documentación de cross_entropy precisa estos parámetros; la función recibe directamente los logits, sin convertirlos antes en probabilidades.
El bucle divide después esta suma por el número de tokens supervisados del grupo de acumulación: varios lotes cuyas contribuciones se acumulan antes de una actualización. Así se calcula una media por posición supervisada, no una media en la que cada lote tendría arbitrariamente el mismo peso.
Un cálculo pequeño ilustra la diferencia. Supongamos un lote de 10 posiciones con pérdida total 20, y luego uno de 30 posiciones con pérdida total 30. La media global es (20 + 30) / (10 + 30) = 1,25. Promediar ambas medias daría (2 + 1) / 2 = 1,5. Este ejemplo numérico explica la normalización; no describe pérdidas medidas durante el recorrido.
Tratar páginas largas sin perder palabras
¿Qué ocurre si una factura contiene demasiado texto? El modelo admite ventanas de 512 tokens, tokens especiales incluidos. El proyecto usa como máximo 510 subtokens de texto por ventana, con un solapamiento de 128. Por tanto, una parte del texto aparece en dos ventanas vecinas.
Este límite se refiere a tokens, no a palabras: una palabra dividida en tres fragmentos ocupa tres posiciones. Cortar simplemente el texto en el límite podría hacer desaparecer el final de la factura, precisamente donde puede estar un total.
El uso de ventanas resuelve el problema de longitud, pero plantea otra pregunta: ¿qué predicción conservar cuando la misma palabra aparece en varias ventanas?
Fusionamos los logits a nivel de palabra dando más peso a las posiciones alejadas de los bordes. Esta elección favorece las posiciones rodeadas de más contexto en la ventana; no demuestra que su predicción sea siempre mejor. Esta es la función completa.
def merge_logits(windows, logits, word_count):
    classes = logits[0].shape[-1]
    total = torch.zeros(word_count, classes, dtype=torch.float64)
    weights = torch.zeros(word_count, dtype=torch.float64)
    contributions = torch.zeros(word_count, dtype=torch.long)
    for window, values in zip(windows, logits):
        length = len(window["input_ids"])
        for token, (word, first) in enumerate(
            zip(window["word_ids"], window["first_flags"])
        ):
            if not first:
                continue
            weight = min(16, token, length - 1 - token)
            assert weight > 0
            total[word] += weight * values[token].double().cpu()
            weights[word] += weight
            contributions[word] += 1
    if not bool((weights > 0).all()):
        raise ValueError("A word was dropped by windowing")
    return total / weights[:, None], contributions.tolist()
total contiene un vector de puntuaciones por palabra; weights guarda la suma de los pesos y contributions cuenta las contribuciones recibidas. El bucle conserva únicamente los primeros subtokens, como en la supervisión.
La variable weight, calculada con min(16, token, length - 1 - token), mide la proximidad a los dos bordes y limita el peso a 16. Una posición próxima a un borde pesa menos que otra suficientemente interior. assert weight > 0 comprueba que una contribución conservada tiene peso positivo.
Sumamos las puntuaciones ponderadas y dividimos cada vector por su suma de pesos. En weights[:, None], la dimensión extra permite aplicar el mismo divisor a todas las clases de una palabra. Los valores se acumulan en CPU como float64, como indican .double().cpu() y la inicialización de las tablas.
Este es un ejemplo de cálculo, no una salida observada: una palabra recibe, para la misma clase, un logit de 2 con peso 4 y otro de 6 con peso 12. La puntuación fusionada es (4 × 2 + 12 × 6) / (4 + 12) = 5. La operación se repite para cada clase. El resultado sigue siendo un logit, no una probabilidad.
Por último, el control weights > 0 exige una contribución para cada palabra. Si una palabra desaparece al dividir, la función lanza un error en vez de producir discretamente una extracción incompleta. contributions permite ver cuántas ventanas participaron en la predicción de cada palabra.
Entrenar, comparar y reanudar
Entrenaremos dos variantes: layout, con rectángulos reales, y neutral, con rectángulos nulos durante el entrenamiento y la inferencia. «Nulos» significa aquí coordenadas en cero, no palabras eliminadas.
La variante neutra permite formular una pregunta concreta: ¿puede el modelo aprender esta tarea sin las diferencias de posición entre cajas? El texto sigue presente. Tampoco elimina el orden de los tokens en la secuencia. Quitamos una señal geométrica variable, no toda la información del documento.
También comprobamos la reanudación del entrenamiento. Los siguientes comandos entrenan el modelo principal interrumpido, la variante neutra, una referencia continua y luego reanudan el modelo interrumpido en otro proceso.
docker compose run --rm tutorial python -m pdflayout.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdflayout.cli train-neutral --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdflayout.cli train-continuous --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdflayout.cli train-resume --config configs/minimum.yaml
Una época corresponde a una pasada por los ejemplos de entrenamiento. El recorrido principal prevé cinco épocas, con una interrupción tras dos para probar la reanudación. La referencia continua realiza el recorrido sin ese corte; la reanudación recarga el estado interrumpido para efectuar las tres épocas restantes.
¿Por qué no comprobar solo que la puntuación final sea parecida? Porque dos modelos distintos pueden obtener la misma puntuación en un corpus pequeño. Reanudar el mismo experimento exige recuperar el estado de cálculo, no solo alcanzar un rendimiento similar.
La siguiente comparación comprueba en particular los parámetros, el optimizador y los estados aleatorios.
docker compose run --rm tutorial python -m pdflayout.cli verify-resume --config configs/minimum.yaml
Resultado del recorrido validado: una reanudación exacta, con una desviación máxima nula entre los parámetros comparados. Esto controla este procedimiento y este entorno. No suponga la misma identidad numérica después de cambiar el hardware o las dependencias.
Predecir sin consultar las anotaciones
Llegamos a la inferencia: usar el modelo entrenado para producir predicciones sin ajustar sus parámetros con las respuestas esperadas.
El servicio de inferencia no monta el directorio de anotaciones. Carga las palabras, las cajas y los pesos, fusiona las ventanas y luego decodifica las etiquetas. La situación debe parecerse a la de un documento recibido por su aplicación: el texto está disponible, su corrección no.
docker compose run --rm inference python -m pdflayout.cli predict --config configs/minimum.yaml
Abra outputs/example.json. Para AL-01-03, la variante layout encuentra TOTAL = 250.16 en la palabra 62, con su caja en la página. También encuentra el subtotal y el impuesto esperados. Siga estos enlaces hasta las palabras: este archivo no se limita a anunciar números, sino que indica qué apariciones se retuvieron.
Pasar de etiquetas a campos
El decodificador reúne las secuencias BIO en entidades. Si un I es incoherente, lo repara como inicio de entidad y cuenta esta reparación. Por ejemplo, una secuencia pedagógica O, I-TOTAL puede convertirse en O, B-TOTAL: una continuación sin inicio se convierte en un nuevo inicio. Reparar la forma de la secuencia no prueba que la palabra elegida sea correcta.
Para cada campo, el programa devuelve un valor cuando existe un único candidato. Ningún candidato o varios candidatos dan lugar a un valor vacío, manteniendo las ambigüedades. Por tanto, no elige arbitrariamente entre dos posibles totales; la aplicación puede solicitar una comprobación humana.
Atención al significado de una salida vacía: puede corresponder a un campo ausente, pero también a un fallo de detección o a una ambigüedad. La procedencia y los candidatos ayudan a analizar el resultado; no constituyen una garantía de corrección ni una garantía contable.
Entender las métricas antes de los resultados
Una métrica es una medida del comportamiento del programa. Usamos varias porque no todas responden a la misma pregunta.
¿Hemos encontrado las entidades correctas?
Una entidad es correcta si su tipo y sus identificadores de palabra coinciden exactamente con la referencia. En una página donde el mismo importe aparece dos veces, tomar la aparición incorrecta sigue siendo un error aunque la cadena de caracteres sea idéntica.
La precisión mide la proporción de entidades predichas que son correctas. La recuperación mide la proporción de entidades esperadas que se han encontrado.
Tomemos un ejemplo de cálculo: predecimos cuatro entidades, tres son correctas y se esperaban cinco. La precisión es 3 / 4 = 0,75, la recuperación 3 / 5 = 0,60. El F1 combina ambos: 2 × precisión × recuperación / (precisión + recuperación). Aquí vale aproximadamente 0,667. No es una puntuación del tutorial, sino una ilustración de la fórmula.
El micro-F1 reúne los recuentos de todas las entidades antes del cálculo. El macro-F1 calcula el F1 de cada tipo de campo y luego hace la media. Esta segunda lectura evita mejor que un campo difícil quede oculto por los demás.
¿La factura es totalmente correcta?
La exactitud documental exige que todos los campos sean correctos en una factura. En un ejemplo de diez facturas, nueve completamente correctas dan 0,9. Muchos campos aislados pueden ser correctos aunque pocos documentos tengan éxito completo: basta un campo erróneo para que falle el documento.
La tasa de error de importes compara los valores numéricos. Cuanto más baja, mejor. Este control no sustituye el de entidades: encontrar el número correcto en la palabra equivocada puede conservar el valor numérico y perder la procedencia correcta.
¿Son pertinentes la procedencia y la abstención?
Una procedencia válida significa que las referencias apuntan correctamente a las palabras y las cajas de la página. No garantiza que esas palabras tengan la función correcta. Una referencia técnicamente válida puede remitir al subtotal cuando se buscaba el total.
La abstención en facturas sin total comprueba que el programa no les asigne un total inventado. Pero un sistema que nunca devolviera nada podría superar solo este criterio y fallar todos los campos presentes. Tengamos este límite presente antes de leer los resultados.
Ejecutemos la evaluación, que puede acceder a las anotaciones por separado de la inferencia.
docker compose run --rm tutorial python -m pdflayout.cli evaluate --config configs/minimum.yaml
Resultados del recorrido r002
Los siguientes resultados corresponden a las 96 páginas de prueba, con 568 entidades esperadas. Proceden de outputs/evaluation.json. Este recuento es coherente con seis campos por página y ocho totales ausentes: 96 × 6 − 8 = 568.
En móvil, desplace la tabla horizontalmente.
| Método | Micro-F1 | Macro-F1 de campos | Exactitud documental | Error de importes |
|---|---|---|---|---|
| Reglas sencillas | 1,00 | 1,00 | 1,00 | 0,00 |
| LayoutLM, rectángulos reales | 1,00 | 1,00 | 1,00 | 0,00 |
| LayoutLM, entrenamiento neutro | 1,00 | 1,00 | 1,00 | 0,00 |
| Rectángulos enmascarados solo en inferencia | 0,00 | 0,00 | 0,00 | 1,00 |
Dos formas muy distintas de «eliminar las posiciones»
Los tres primeros métodos alcanzan las mismas puntuaciones. La última fila, en cambio, corresponde al modelo entrenado con las cajas reales, a las que se sustituyen ceros solo al predecir.
No es la variante neutra. neutral aprendió desde el principio con esta representación constante. El modelo enmascarado recibe de repente posiciones distintas de aquellas con las que aprendió a trabajar.
Puede ayudar una analogía con una aplicación web: prever desde el diseño que un campo será siempre constante no es lo mismo que reemplazar su valor por cero después de crear tratamientos que se apoyan en él. Para la red, la diferencia está en los ejemplos de entrenamiento que guiaron sus parámetros.
El enmascaramiento tardío mide la sensibilidad a una modificación de las entradas; no demuestra que la tarea fuera imposible de aprender sin geometría. El éxito de neutral muestra precisamente lo contrario en este corpus.
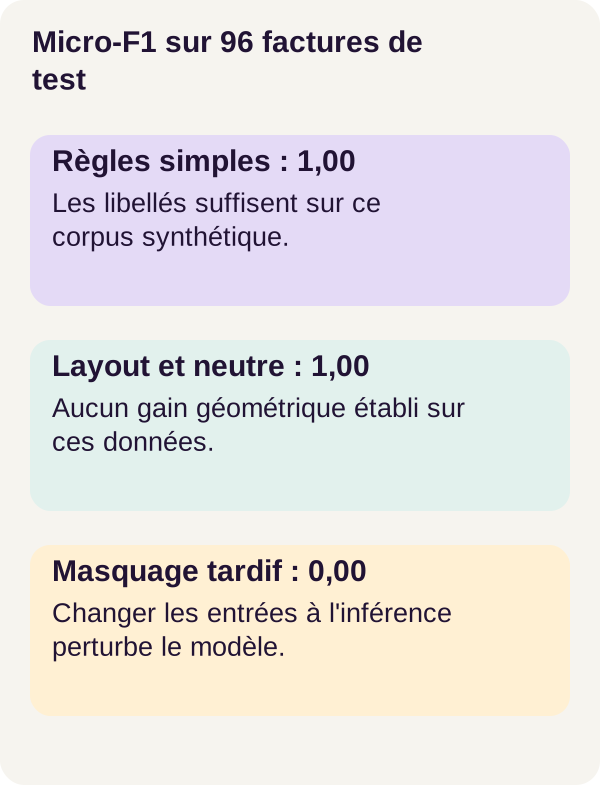
Estas puntuaciones describen el corpus sintético del tutorial. No establecen una ventaja del modelo geométrico sobre reglas sencillas.
Los tres primeros métodos también tienen éxito en los subgrupos de las ocho páginas largas, las ocho páginas con importes repetidos y las ocho páginas sin total.
La variante enmascarada no predice ninguna entidad. Por tanto, su abstención en los totales ausentes vale 1, pero este valor aislado oculta su fallo en los campos presentes. Del mismo modo, una tasa de procedencia válida de 1 puede acompañar una salida vacía: no se produjo ninguna referencia inválida sin que se lograra una sola extracción útil.
Por tanto, la conclusión no es «la geometría no sirve nunca». Es más precisa: en este corpus, las reglas sencillas y el modelo neutro ya bastan para alcanzar las mismas puntuaciones que LayoutLM con los rectángulos reales. Hemos entendido y medido el mecanismo, no establecido su superioridad en todas las facturas.
Probar lo que debe fallar
Una prueba negativa somete al programa a una situación que debe rechazar. Las pruebas ejecutadas al principio verifican, entre otras cosas, las cajas no válidas, las palabras perdidas por las ventanas y las entradas incoherentes.
Su interés es concreto: un resultado aparentemente plausible es difícil de diagnosticar si una parte del documento desapareció antes de la predicción. Es mejor señalar una entrada no válida que ocultar el problema con una salida tranquilizadora.
Consulte las pruebas para ver los casos exactos antes de adaptar sus documentos. Superar los casos cubiertos no significa que se hayan explorado todas las situaciones posibles.
Lo que hemos aprendido
Partimos de un importe en una página para llegar a un campo vinculado a su fuente. El texto aporta indicios léxicos; los rectángulos proporcionan una localización. LayoutLM combina sus representaciones y la capa de clasificación propone funciones para los tokens.
La alineación permite volver de los subtokens a las palabras. Las ventanas tratan una página larga y la fusión evita varias decisiones independientes para una misma aparición. Después, el decodificador ensambla las entidades y conserva las ambigüedades.
Por último, la trazabilidad, la corrección y el interés del aprendizaje son tres preguntas distintas. Una caja válida no asegura un buen campo; una puntuación perfecta en un corpus sintético no garantiza un servicio fiable; una red compleja no aporta necesariamente una ganancia frente a reglas sencillas. Los resultados del recorrido ilustran estas diferencias.
Ejercicio: predecir antes de desplazar
Volvamos a nuestro problema de total y subtotal. Vamos a intercambiar las posiciones de los bloques TOTAL y SUBTOTAL sin cambiar sus valores. Antes de ejecutar, escriba su hipótesis: ¿qué indicios seguirán disponibles para las reglas, el modelo geométrico y el neutro? ¿Debe el desplazamiento modificar necesariamente sus predicciones? ¿Por qué?
El proyecto proporciona esta modificación en configs/exercise.yaml. Compare las dos páginas del experimento y anote los campos que cree que deberían cambiar. Ejecute después la variante preparada.
docker compose run --rm tutorial python -m pdflayout.cli exercise --config configs/exercise.yaml
Compare su predicción con los resultados del ejercicio. La referencia validada recupera las doce entidades con las reglas, layout y neutral; la variante enmascarada no recupera ninguna. La corrección detallada está en lesson/SOLUTIONS.md.
¿Por qué el desplazamiento no basta para dificultar estas técnicas? Las etiquetas siguen siendo suficientemente discriminantes. Cambiar la posición de un bloque no hace desaparecer todos los demás indicios. Por tanto, este experimento no demuestra por sí solo la utilidad de la geometría.
Para un experimento personal, elija después una sola modificación en el generador, por ejemplo hacer ambigua una etiqueta. Prediga el efecto sobre cada método antes de regenerar los datos y repetir el recorrido. Conserve por separado sus resultados y los de referencia.
Este nuevo experimento no tiene un resultado anunciado. El interés consiste precisamente en medir qué cambia y explicar después los errores o los aciertos, incluso cuando contradicen su intuición.
Observar las figuras y controlar los checkpoints
Genere las figuras a partir de sus propios resultados y compruebe después los archivos de modelo esperados.
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Las figuras de la carpeta outputs/ permiten inspeccionar la factura, los subtokens y los resultados. Compruebe la correspondencia entre un campo, su palabra y su caja antes de conformarse con la tabla agregada.
Para AL-01-03, el control visual consiste en particular en encontrar la palabra 62 que contiene 250.16 y comprobar que el campo TOTAL remite a esa aparición. Una media no sustituye esta lectura de un ejemplo.
En caso de problema
Empiece por identificar la etapa que falla: acceso a la GPU, adquisición, preparación de palabras, división o predicción. Modificar el modelo no resolvería una caja mal orientada antes incluso de que entre en la red.
En móvil, desplace la tabla horizontalmente.
| Síntoma | Comprobación y corrección |
|---|---|
| GPU ausente en Docker | Compare el preflight del host y el control del contenedor. Corrija la integración de NVIDIA Container Toolkit antes del entrenamiento. |
| Modelo ausente o adquisición interrumpida | Consulte los errores de scripts/acquire.py, compruebe el espacio libre y reinicie la adquisición prevista; conserve el modelo y la revisión bloqueados. |
| Caja rechazada | Compruebe las dimensiones, el recorte y la rotación de la página canónica. Una caja fuera de página no debe hacerse válida ocultando el error. |
| Palabra perdida durante la división | Inspeccione los identificadores y los primeros subtokens de las ventanas. El control debe mantenerse activo. |
| Entrada sin texto utilizable | Compruebe que el PDF contiene texto nativo. Los escaneos necesitan una etapa OCR adicional, fuera del recorrido validado aquí. |
Detener y limpiar
Antes de limpiar, conserve los resultados y las figuras que quiera estudiar. El primer comando detiene el proyecto, el script elimina solo los resultados de outputs/ y el último cierre termina el recorrido.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Los recursos del modelo, los checkpoints de assets/ y los datos generados se conservan. No hace falta ninguna purga global de Docker. Por tanto, la limpieza no significa que los pesos o el corpus tengan que descargarse o generarse de nuevo.
Del tutorial a una aplicación real
El primer trabajo no es añadir un endpoint a este script: es comprobar que funciona con los documentos de su aplicación. Las facturas empresariales exigen una ingesta controlada, diversidad de idiomas y formatos, una estrategia OCR para escaneos y gestión de varias páginas.
Construya un corpus anotado representativo con una separación por proveedores o plantillas y analice los errores por campo y tipo de documento. Una puntuación global puede ocultar una dificultad con las fechas de un proveedor o los totales de un formato concreto. Estos ejemplos describen los análisis que deben preverse, no errores ya medidos aquí.
Añada según sus necesidades autenticación, autorizaciones documentales, protección de datos, límites de tamaño, cola de procesamiento, registro y supervisión. Defina los casos de abstención y una validación humana para valores ambiguos. La procedencia conservada puede ayudar a esta revisión, pero la interfaz y el proceso empresarial todavía deben construirse.
Versione los modelos, las configuraciones y los datos de evaluación para detectar regresiones. Este motor pedagógico no establece ninguna conformidad contable y no constituye por sí solo un servicio de producción.
Para ir más lejos
Empiece por probar facturas con plantillas realmente distintas y anotaciones verificadas. Compare los errores de las reglas y del modelo en etiquetas deliberadamente ambiguas: así podrá buscar situaciones en las que el aprendizaje podría aportar una ganancia y medirla.
Otra extensión consiste en añadir una cadena OCR para obtener palabras y cajas a partir de escaneos. Introduce sus propios errores; habrá que evaluar esta nueva cadena, sin atribuirle las puntuaciones del recorrido sobre texto nativo.
Por último, puede construir una interfaz que muestre cada valor con su zona de origen y permita una corrección humana. Esta ampliación vincula directamente la mecánica del tutorial con una necesidad de aplicación web: permitir al usuario verificar una propuesta en vez de mostrarle un número sin procedencia.
Fuentes para profundizar
El README, el código y las lecciones del ZIP constituyen el recorrido reproducible utilizado aquí. Las puntuaciones publicadas son las del recorrido r002; los ejemplos numéricos señalados en el artículo solo sirven para explicar los cálculos.
La documentación de LayoutLM de Transformers, versión 4.56.2 describe las entradas textuales y geométricas y la clasificación de tokens. La ficha del modelo LayoutLM presenta el modelo preentrenado.
Para profundizar en las etapas intermedias, consulte la documentación de pdfplumber, el curso sobre WordPiece y la guía de clasificación de tokens. Las explicaciones sobre aprendizaje también se apoyan en la documentación de la entropía cruzada de PyTorch y su tutorial de optimización de parámetros.
Estos complementos documentales no sustituyen los archivos bloqueados del ZIP. La documentación en línea puede evolucionar independientemente del entorno validado; conserve las versiones y los comandos del proyecto para reproducirlo.