





State aggiungendo l'importazione di fatture a un'applicazione web. Il caricamento funziona, il PDF si apre e l'estrattore trova i numeri presenti nella pagina. Resta soltanto da compilare i campi del modulo... ma quale di questi numeri è il totale?
Un'espressione regolare può riconoscere 250.16. Da sola, però, non dice se si tratta dell'importo da pagare, di un'imposta o di un subtotale. Per capirlo, leggiamo le etichette intorno al numero e osserviamo dove è collocato. Anche il nostro programma userà il testo e la sua posizione.
Costruiremo un estrattore di campi con Python, Docker e LayoutLM. Seguiremo la fattura fittizia AL-01-03: il suo subtotale è 250.00, l'imposta è 0.16 e il totale è 250.16. Questi valori sono il nostro filo conduttore, non una regola contabile da insegnare al modello. Vogliamo ritrovare gli importi scritti nel documento, non ricalcolare o inventare un campo mancante.
Il risultato cercato si riassume in una frase: ritrovare un valore, determinarne il ruolo e mostrare da dove proviene. Confronteremo inoltre la rete con regole semplici. L'obiettivo è capire il contributo di ciascun metodo, non presumere che quello che usa l'IA sia necessariamente migliore.
Scaricare il progetto completo del tutorial
Cosa costruirete e imparerete
Il nostro programma riceve PDF contenenti testo nativo e restituisce sei campi: numero di fattura, data, fornitore, subtotale, imposta e totale. Ogni valore conserva la propria pagina, le parole e i relativi rettangoli. Un campo assente o ambiguo può restare vuoto.
Qui un PDF nativo contiene caratteri che il programma può estrarre. Non è lo stesso punto di partenza di una scansione che contiene soltanto un'immagine: quest'ultima richiederebbe prima un riconoscimento ottico dei caratteri, o OCR. Questa fase non fa parte del percorso presentato.
La catena di elaborazione è la seguente:
PDF → parole e rettangoli → sotto-token → LayoutLM → etichette per parola → campi con la loro provenienza.
Immaginate un'operazione di evidenziazione: il programma deve associare alcune parole al «totale», altre alla «data» e lasciare da parte le parole che non hanno un ruolo nei nostri sei campi. Un'etichetta descrive il ruolo scelto; il rettangolo permette di ritrovare la parola nella pagina.
LayoutLM associa rappresentazioni apprese del testo e delle posizioni. In questo tutorial, classifica token; non redige una risposta e non legge direttamente i pixel di una scansione. Il codice Python estrae i dati, prepara gli input, riunisce le previsioni e verifica i risultati.
Impareremo a riportare le coordinate a una scala comune, a mantenere il legame tra le parole e i loro frammenti, ad addestrare il classificatore e a gestire una pagina troppo lunga per entrare in un'unica finestra. Vedremo poi come misurare la qualità dell'estrazione senza confondere un valore corretto con una localizzazione corretta.
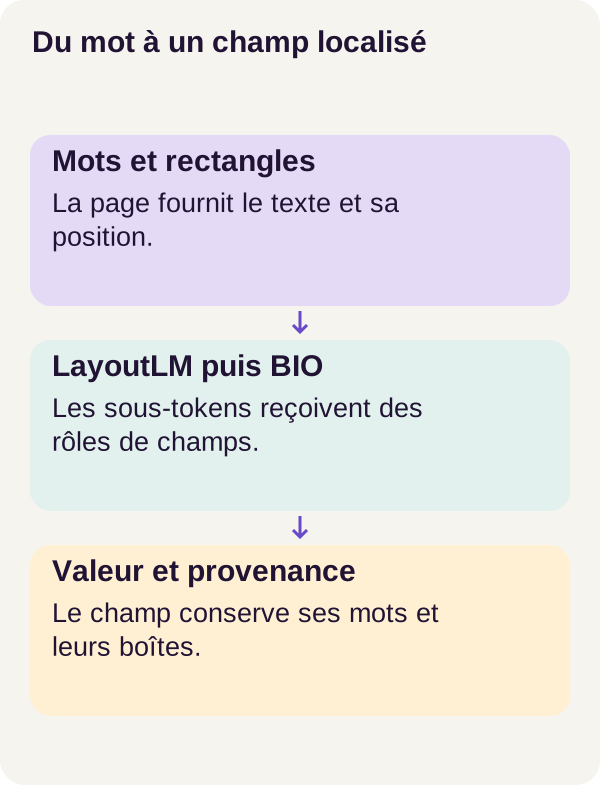
Un riquadro localizza una parola; un'etichetta ne descrive il ruolo. La provenienza consente di tornare alla pagina.
Preparare l'ambiente
Dovete saper usare Python, un terminale e Docker. Non è necessario conoscere già LayoutLM. Spiegheremo le nozioni neurali quando appariranno: qui un tensore è una tabella di numeri e l'addestramento adatta i parametri del modello a partire da esempi annotati.
Il percorso è stato convalidato su Linux con una RTX 3090 da 24 GiB. Il README indica 32 GiB di RAM e 24 GiB di disco: sono indicazioni di dimensionamento, non minimi misurati su tutte le macchine. La RAM è la memoria del computer; i 24 GiB della scheda grafica corrispondono alla sua memoria dedicata, la VRAM.
Prevedete Docker Engine, Compose e una GPU NVIDIA utilizzabile dai contenitori. Conservate le dipendenze e le configurazioni dello ZIP per riprodurre il percorso r002.
Verificare che Docker veda la GPU
Una GPU visibile sull'host non garantisce che un programma Docker possa usarla. Lo script seguente controlla l'host e Docker; poi verificheremo CUDA dal contenitore. CUDA è l'ambiente di calcolo usato qui per eseguire le operazioni della rete sulla GPU.
NVIDIA Container Toolkit fornisce l'integrazione tra il motore Docker e i driver NVIDIA dell'host. L'installazione dipende dal sistema in uso: consultate la documentazione ufficiale NVIDIA.
Decomprimete lo ZIP, quindi aprite un terminale nella sua cartella radice, quella che contiene README.md e compose.yaml. Tutti i comandi seguenti partono da questa cartella. Iniziate con i controlli preliminari.
sh scripts/preflight.sh
Correggete ogni controllo bloccante prima di proseguire. Lo script di preparazione crea poi le directory necessarie, Compose convalida la configurazione e quindi costruisce i tre servizi.
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial inference
Ogni servizio ha un ruolo: acquisition scarica le risorse, tutorial prepara i dati e addestra il modello, inference effettua previsioni a partire dai PDF e dai pesi salvati. I pesi sono i parametri numerici appresi dalla rete.
Per orientarvi nei file, assets/ conserva il modello e i checkpoint, data/generated/ contiene il corpus e outputs/ riceve i risultati. Un checkpoint è il salvataggio di uno stato di addestramento; lo useremo anche per verificare una ripresa dopo un'interruzione.
L'inferenza dispone degli input e dei pesi in sola lettura, senza annotazioni di riferimento né accesso alla rete. Il file Compose completo dello ZIP descrive in dettaglio i montaggi e le restrizioni. In questo percorso, questa separazione impedisce di fornire le risposte attese al servizio incaricato di prevederle. Non sostituisce i controlli di accesso di un'applicazione reale.
Acquisire il modello una sola volta
Usiamo microsoft/layoutlm-base-uncased. La sua revisione 30e3cdd39c11f09757b0fcf7598533d05052acef è fissata per ritrovare gli stessi file. scripts/acquire.py ne controlla le dimensioni e le impronte definite in locks/models.lock.json, poi li memorizza in assets/model/.
Potete avvicinare questo blocco a quello delle dipendenze di un progetto web: conservare un nome non basta, occorre sapere anche quale versione e quali file sono stati usati. Internet serve per questa acquisizione; in seguito il caricamento del modello usa i file locali.
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
Verifichiamo ora l'ambiente da Docker, quindi i test. Il primo controllo completa quello dell'host: ciò che conta è l'accesso effettivo alla GPU da parte del programma nel contenitore.
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Da osservare: il percorso convalidato ottiene 26 test riusciti. Questi test controllano in particolare le coordinate, l'allineamento, le finestre e i casi non validi. Verificano i comportamenti del programma; non garantiscono che il modello saprà elaborare le vostre fatture.
Capire i dati prima di prevedere
Tre gruppi di documenti, tre ruoli
Il corpus sintetico comprende 600 pagine e 50 famiglie di impaginazione. «Sintetico» significa che le fatture sono generate per l'esperimento, anziché raccolte presso clienti reali. Una famiglia riunisce documenti che condividono un modello di impaginazione.
La separazione avviene per famiglie: 420 pagine di addestramento, 84 di convalida e 96 di test. L'addestramento serve ad adattare i parametri. La convalida serve a selezionare il checkpoint. Il test misura poi il risultato finale su documenti che non sono serviti a queste decisioni.
Perché non mescolare tutte le pagine casualmente? Perché un metodo potrebbe riuscire riconoscendo un modello già incontrato, senza comportarsi bene davanti a una nuova presentazione. Separare le famiglie riduce questo rischio, senza riprodurre tutta la diversità del mondo reale.
Leggere una fattura prima di leggere i tensori
Le fatture fittizie Alder contengono testo inglese nativo. pdfplumber ne estrae le parole e i rettangoli; la sua documentazione sull'estrazione del testo descrive questi oggetti. Le annotazioni associano le parole ai campi attesi: sono le risposte di riferimento usate per apprendere e misurare, mai per prevedere.
Creiamo i dati e ispezioniamo un lotto, o batch: un insieme di input preparati per il modello.
docker compose run --rm tutorial python -m pdflayout.cli prepare --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdflayout.cli inspect-batch --config configs/minimum.yaml
Osservate gli identificativi dei token, i rettangoli e le etichette. Per AL-01-03, ci interessano in particolare tre parole:
| Identificativo della parola | Testo estratto | Ruolo atteso |
|---|---|---|
55 |
250.00 |
Subtotale |
58 |
0.16 |
Imposta |
62 |
250.16 |
Totale |
Queste corrispondenze provengono dal caso di riferimento. Il modello riceve il testo e la sua posizione; durante l'addestramento, l'annotazione gli indica il ruolo che doveva riconoscere.
Gli identificativi restano stabili per distinguere due occorrenze con lo stesso testo. È paragonabile a due righe di una base dati che hanno lo stesso valore ma non la stessa chiave: trovare 250.16 da qualche parte non significa avere trovato la parola corretta.
Otto pagine di test non hanno totale. Un valore assente non è né uno zero né un invito a ricalcolarlo. Il programma deve poter astenersi. Vedremo più avanti cosa misura questa astensione.
Costruire un riferimento semplice
Prima di addestrare la rete, iniziamo con un metodo che potreste scrivere senza apprendimento: espressioni regolari associate alla vicinanza delle etichette. Questa baseline, o metodo di riferimento, consente di sapere se gli indizi del corpus sono già sufficienti per regole semplici.
L'idea non è soltanto riconoscere la forma di un importo. Occorre anche associarlo all'etichetta corretta, come «TOTAL» o «SUBTOTAL». Il codice dello ZIP definisce le regole realmente confrontate.
docker compose run --rm tutorial python -m pdflayout.cli baseline --config configs/minimum.yaml
Conservate questo risultato per la valutazione finale. Risponde a una domanda pratica: la rete fa meglio di una soluzione più semplice sui documenti che ci interessano? Un buon punteggio isolato non consente di saperlo.
Fornire al modello parole e posizioni
Ora abbiamo parole, rettangoli e annotazioni. Resta da convertirli in tabelle che la rete possa usare, senza perdere il legame con il documento.
Portare tutti i rettangoli alla stessa scala
Un riquadro contiene x0, top, x1, bottom: i limiti sinistro, superiore, destro e inferiore della parola. Se avete già manipolato le dimensioni di un elemento in una pagina web, il principio del rettangolo di delimitazione vi è familiare. Occorre semplicemente lavorare nel sistema di riferimento della pagina PDF preparata, non in quello di una finestra del browser.
Trasformiamo le coordinate di questa pagina canonica, cioè riportata a un riferimento comune, in numeri interi compresi tra 0 e 1000. Rotazione e ritaglio devono essere considerati prima di questa fase. Mettere in scala un riquadro orientato male non ne correggerebbe l'orientamento.
In src/pdflayout/align.py, questa funzione verifica e poi normalizza ogni riquadro.
def normalize_bbox(box, width, height):
    if (
        width <= 0
        or height <= 0
        or not (0 <= box[0] <= box[2] <= width and 0 <= box[1] <= box[3] <= height)
    ):
        raise ValueError("Invalid canonical box")
    return [
        round(1000 * box[0] / width),
        round(1000 * box[1] / height),
        round(1000 * box[2] / width),
        round(1000 * box[3] / height),
    ]
Le due coordinate orizzontali sono divise per la larghezza; le due verticali per l'altezza. La moltiplicazione per 1000 fornisce la scala attesa e round() arrotonda i valori. Il controllo iniziale rifiuta dimensioni di pagina non positive, un riquadro invertito o un riquadro esterno alla pagina.
Prendiamo un esempio numerico didattico, indipendente dalle coordinate reali di AL-01-03. Su una pagina larga 600 e alta 800, il riquadro [300, 560, 360, 576] diventa [500, 700, 600, 720]. Il suo bordo sinistro si trova al 50% della larghezza; quello superiore al 70% dell'altezza.
Se raddoppiamo la pagina e tutte le coordinate del riquadro, otteniamo lo stesso rettangolo normalizzato. Ecco l'interesse: rappresentare la posizione relativa, non soltanto una distanza dipendente dal formato. Questi numeri descrivono una geometria, non una probabilità. La documentazione di LayoutLM dettaglia il formato atteso per i riquadri.
Dalle parole ai sotto-token
Il modello non manipola direttamente le stringhe Python. Un tokenizer trasforma il testo in unità appartenenti al suo vocabolario, poi in identificativi numerici. Quello di questo percorso usa WordPiece, che può dividere una parola in più sotto-token. Il corso Hugging Face su WordPiece spiega questa segmentazione.
Un identificativo di token e un identificativo di parola non hanno quindi lo stesso ruolo. Il primo indica una voce del vocabolario del modello. Il secondo permette di tornare a un'occorrenza precisa nel PDF.
Per ogni sotto-token, ripetiamo il riquadro della parola originale. Non si tratta di pretendere di conoscere la posizione esatta di ciascun frammento all'interno della parola: tutti i frammenti restano collegati allo stesso rettangolo sorgente.
Occorre inoltre convertire le annotazioni. Usiamo la convenzione BIO:
| Etichetta | Significato |
|---|---|
B-TOTAL |
Inizio di un'entità di tipo TOTAL. |
I-TOTAL |
Continuazione della stessa entità. |
O |
Parola esterna ai campi da estrarre. |
Un'entità è qui un insieme di parole con lo stesso ruolo, per esempio il valore del totale. Un valore su una sola parola richiede soltanto un'etichetta B. Con due etichette per tipo di campo, più O, i nostri sei campi producono tredici etichette: 6 × 2 + 1.
Il progetto sceglie di supervisionare soltanto il primo sotto-token di ogni parola: è su questo che si confronta la previsione con l'etichetta attesa. Gli altri sotto-token, i token speciali e il riempimento ricevono -100, il valore ignorato dalla funzione di perdita.
La funzione seguente traduce le annotazioni delle parole in questa rappresentazione.
def align_word_labels(word_ids, first_flags, word_labels, label_to_id):
    return [
        label_to_id[word_labels[word]] if word is not None and first else -100
        for word, first in zip(word_ids, first_flags)
    ]
word_ids ritrova la parola sorgente e first_flags identifica il suo primo sotto-token. word_labels contiene le annotazioni per parola; label_to_id traduce i nomi delle etichette in numeri. La list comprehension percorre queste corrispondenze e restituisce l'identificativo dell'etichetta oppure -100.
Supponiamo, per illustrare la regola, che una parola etichettata B-TOTAL sia divisa in tre frammenti. Il primo riceve l'identificativo di B-TOTAL; gli altri due ricevono -100. Non è una traccia della tokenizzazione di AL-01-03, ma un esempio del meccanismo di allineamento.
O e -100 non sono intercambiabili. O è una vera risposta da apprendere: «questa parola non appartiene a un campo». -100 significa: «non calcolare la perdita di classificazione su questa posizione». Gli altri frammenti della parola restano input testuali della rete, anche senza una propria etichetta supervisionata. La documentazione sulla classificazione dei token presenta questo principio di allineamento.
Questa regola evita di moltiplicare il peso di una parola nella supervisione soltanto perché il tokenizer l'ha divisa in più parti.
Caricare e addestrare LayoutLM
Non insegneremo all'intera rete partendo da zero. Carichiamo un encoder preaddestrato, poi lo adattiamo alle nostre annotazioni: è il fine-tuning, ovvero l'adattamento di un modello già addestrato. La scheda del modello LayoutLM presenta il modello di partenza.
Un encoder trasforma i suoi input in rappresentazioni numeriche. LayoutLM usa un'architettura Transformer per combinare testo e posizioni con il contesto degli altri token. L'idea è che un importo non venga classificato soltanto in base alle sue cifre, ma anche in base agli indizi che lo circondano.
Uno strato di classificazione, chiamato anche testa di classificazione, trasforma poi la rappresentazione di ogni token in tredici punteggi, uno per etichetta BIO. Questi punteggi grezzi sono i logit. Non sono né un JSON finale né valori della fattura: il codice dovrà ancora raggrupparli e decodificarli.
La funzione del progetto carica l'encoder e inizializza lo strato adattato alle nostre etichette.
def create_model(config):
    names = label_names(config["fields"])
    model, info = LayoutLMForTokenClassification.from_pretrained(
        "assets/model",
        num_labels=len(names),
        id2label=dict(enumerate(names)),
        label2id={name: i for i, name in enumerate(names)},
        local_files_only=True,
        use_safetensors=True,
        output_loading_info=True,
    )
    assert all(key.startswith("classifier.") for key in info["missing_keys"]), info
    assert not info["mismatched_keys"] and not info["error_msgs"], info
    assert all(p.requires_grad for p in model.parameters())
    return model.cuda(), info
num_labels imposta il numero di classi. id2label e label2id conservano la corrispondenza nei due sensi fra i nomi e i loro identificativi. local_files_only=True impone il modello acquisito localmente, mentre use_safetensors=True richiede il caricamento dei pesi nel formato Safetensors.
Le informazioni di caricamento servono ai controlli seguenti: i parametri mancanti sono accettati soltanto nel nuovo strato classifier, mentre incoerenze di dimensione o errori di caricamento vengono rifiutati. Il programma non prosegue dunque silenziosamente con un caricamento incoerente.
Infine, requires_grad indica che i parametri possono partecipare al calcolo dei gradienti; model.cuda() colloca il modello sulla GPU. Tutti i parametri sono addestrabili: adattiamo anche l'encoder, non soltanto il nuovo strato di classificazione. Sarà il ciclo di addestramento a effettuare questo adattamento.
Per leggere le tabelle, immaginiamo un lotto di due finestre da 128 posizioni. Gli identificativi hanno forma [2, 128], i riquadri [2, 128, 4] e i logit [2, 128, 13]. Sono dimensioni d'esempio: due finestre, 128 posizioni per finestra, tredici punteggi per posizione. Non è una configurazione aggiuntiva da applicare al progetto.
Una perdita per apprendere, non soltanto un punteggio da constatare
Come progredisce il modello? Confrontiamo i suoi logit con le etichette attese mediante una funzione di perdita, qui l'entropia incrociata. Essa penalizza, tra l'altro, il fatto di favorire un'etichetta errata. L'addestramento calcola poi i gradienti, che indicano come una variazione dei parametri influenza questa perdita, quindi l'ottimizzatore adegua i parametri. Il tutorial PyTorch sull'ottimizzazione descrive questo ciclo.
Il codice seguente somma gli errori delle posizioni supervisionate e le conta.
def supervised_sum(logits, labels):
    count = int((labels != -100).sum())
    if not count:
        raise ValueError("No supervised tokens")
    loss = torch.nn.functional.cross_entropy(
        logits.reshape(-1, logits.shape[-1]),
        labels.reshape(-1),
        ignore_index=-100,
        reduction="sum",
    )
    return loss, count
labels != -100 individua le posizioni da considerare. Se nessuna è supervisionata, la funzione rifiuta il lotto invece di proseguire con un segnale di apprendimento vuoto.
logits.reshape(-1, logits.shape[-1]) riunisce le posizioni in righe mantenendo le tredici classi in colonne. labels.reshape(-1) allinea le risposte attese. ignore_index=-100 esclude gli obiettivi ignorati e reduction="sum" somma le perdite. La documentazione di cross_entropy precisa questi parametri; in questo estratto la funzione riceve direttamente i logit, senza una precedente conversione in probabilità.
Il ciclo divide poi questa somma per il numero di token supervisionati del gruppo di accumulo: più lotti di cui si accumulano i contributi prima di un aggiornamento. Si calcola così una media per posizione supervisionata, anziché una media in cui ogni lotto avrebbe arbitrariamente lo stesso peso.
Un piccolo calcolo illustra la differenza. Supponiamo un lotto di 10 posizioni con una perdita totale di 20, poi un lotto di 30 posizioni con una perdita totale di 30. La media globale vale (20 + 30) / (10 + 30) = 1,25. Fare la media delle due medie darebbe (2 + 1) / 2 = 1,5. Questo esempio numerico spiega la normalizzazione; non descrive perdite misurate durante il percorso.
Gestire le pagine lunghe senza perdere le parole
Che cosa succede se una fattura contiene troppo testo? Il modello accetta finestre di 512 token, token speciali inclusi. Il progetto usa al massimo 510 sotto-token di testo per finestra, con una sovrapposizione di 128. Una parte del testo compare quindi in due finestre vicine.
Questo limite riguarda i token, non le parole: una parola divisa in tre frammenti occupa tre posizioni. Tagliare semplicemente il testo al limite potrebbe far scomparire la fine della fattura, proprio dove può trovarsi un totale.
Il finestramento risolve il problema della lunghezza, ma crea una nuova domanda: quale previsione conservare quando la stessa parola appare in più finestre?
Fondiamo i logit a livello della parola assegnando più peso alle posizioni lontane dai bordi. Questa scelta favorisce le posizioni circondate da più contesto nella finestra; non dimostra che la loro previsione sia sempre migliore. Ecco la funzione completa.
def merge_logits(windows, logits, word_count):
    classes = logits[0].shape[-1]
    total = torch.zeros(word_count, classes, dtype=torch.float64)
    weights = torch.zeros(word_count, dtype=torch.float64)
    contributions = torch.zeros(word_count, dtype=torch.long)
    for window, values in zip(windows, logits):
        length = len(window["input_ids"])
        for token, (word, first) in enumerate(
            zip(window["word_ids"], window["first_flags"])
        ):
            if not first:
                continue
            weight = min(16, token, length - 1 - token)
            assert weight > 0
            total[word] += weight * values[token].double().cpu()
            weights[word] += weight
            contributions[word] += 1
    if not bool((weights > 0).all()):
        raise ValueError("A word was dropped by windowing")
    return total / weights[:, None], contributions.tolist()
total contiene un vettore di punteggi per parola; weights conserva la somma dei pesi e contributions conta i contributi ricevuti. Il ciclo conserva soltanto i primi sotto-token, come per la supervisione.
La variabile weight, calcolata da min(16, token, length - 1 - token), misura la vicinanza ai due bordi e limita il peso a 16. Una posizione vicina a un bordo pesa meno di una abbastanza interna. assert weight > 0 verifica che un contributo mantenuto abbia un peso positivo.
Sommiamo i punteggi ponderati, poi dividiamo ogni vettore per la sua somma di pesi. In weights[:, None], la dimensione aggiuntiva permette di applicare lo stesso divisore a tutte le classi di una parola. I valori sono accumulati sulla CPU in float64, come indicano .double().cpu() e l'inizializzazione delle tabelle.
Ecco un esempio di calcolo, non un output osservato: per una stessa classe, una parola riceve un logit di 2 con peso 4, poi un logit di 6 con peso 12. Il punteggio fuso vale (4 × 2 + 12 × 6) / (4 + 12) = 5. Questa operazione si ripete per ogni classe. Il risultato resta un logit, non una probabilità.
Infine, il controllo weights > 0 esige un contributo per ogni parola. Se una parola scompare durante il ritaglio, la funzione solleva un errore invece di produrre silenziosamente un'estrazione incompleta. contributions permette di vedere quante finestre hanno partecipato alla previsione di ciascuna parola.
Addestrare, confrontare e riprendere
Addestreremo due varianti: layout, con i rettangoli reali, e neutral, con rettangoli nulli durante l'addestramento e l'inferenza. Qui «nulli» significa coordinate a zero, non parole eliminate.
La variante neutra permette di porre una domanda precisa: il modello può apprendere questo compito senza le differenze di posizione tra i riquadri? Il testo resta presente. Non cancella neppure l'ordine dei token nella sequenza. Rimuoviamo un segnale geometrico variabile, non tutte le informazioni del documento.
Controlliamo anche la ripresa dell'addestramento. I comandi seguenti addestrano il modello principale interrotto, la variante neutra, un riferimento continuo, poi riprendono il modello interrotto in un altro processo.
docker compose run --rm tutorial python -m pdflayout.cli train --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdflayout.cli train-neutral --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdflayout.cli train-continuous --config configs/minimum.yaml
docker compose run --rm tutorial python -m pdflayout.cli train-resume --config configs/minimum.yaml
Un'epoca corrisponde a un passaggio sugli esempi di addestramento. Il percorso principale prevede cinque epoche, con un'interruzione dopo due per testare la ripresa. Il riferimento continuo esegue il percorso senza questa interruzione; la ripresa ricarica lo stato interrotto per effettuare le tre epoche rimanenti.
Perché non verificare soltanto che il punteggio finale sia vicino? Perché due modelli diversi possono ottenere lo stesso punteggio su un corpus piccolo. Riprendere lo stesso esperimento richiede di ritrovare lo stato del calcolo, non soltanto di raggiungere una prestazione simile.
Il confronto seguente verifica in particolare i parametri, l'ottimizzatore e gli stati casuali.
docker compose run --rm tutorial python -m pdflayout.cli verify-resume --config configs/minimum.yaml
Risultato del percorso convalidato: una ripresa esatta, con uno scarto massimo nullo tra i parametri confrontati. Questo controlla questa procedura e questo ambiente. Non supponete la stessa identità numerica dopo un cambiamento di hardware o di dipendenza.
Prevedere senza consultare le annotazioni
Arriviamo all'inferenza: usare il modello addestrato per produrre previsioni, senza adattarne i parametri alle risposte attese.
Il servizio di inferenza non monta la directory delle annotazioni. Carica le parole, i riquadri e i pesi, fonde le finestre, poi decodifica le etichette. La situazione deve somigliare a quella di un documento ricevuto dalla vostra applicazione: il testo è disponibile, la sua correttezza no.
docker compose run --rm inference python -m pdflayout.cli predict --config configs/minimum.yaml
Aprite outputs/example.json. Per AL-01-03, la variante layout ritrova TOTAL = 250.16 sulla parola 62, con il suo riquadro nella pagina. Ritrova anche il subtotale e l'imposta attesi. Seguite questi legami fino alle parole: questo file non si limita ad annunciare numeri, indica quali occorrenze sono state scelte.
Passare dalle etichette ai campi
Il decoder riunisce le sequenze BIO in entità. Se una I è incoerente, la corregge in inizio di entità e conta questa correzione. Per esempio, una sequenza didattica O, I-TOTAL può diventare O, B-TOTAL: una continuazione senza inizio diventa un nuovo inizio. Correggere la forma della sequenza non dimostra che la parola scelta sia quella giusta.
Per ogni campo, il programma restituisce un valore quando esiste un solo candidato. Nessun candidato o più candidati conducono a un valore vuoto, conservando le ambiguità. Non sceglie dunque arbitrariamente fra due possibili totali; l'applicazione può richiedere una verifica umana.
Attenzione al significato di un output vuoto: può corrispondere a un campo assente, ma anche a un fallimento di rilevamento o a un'ambiguità. La provenienza e i candidati aiutano ad analizzare il risultato; non costituiscono né una garanzia di correttezza né una garanzia contabile.
Capire le metriche prima dei risultati
Una metrica è una misura del comportamento del programma. Ne usiamo diverse perché non rispondono tutte alla stessa domanda.
Abbiamo ritrovato le entità corrette?
Un'entità è corretta se il suo tipo e i suoi identificativi di parola corrispondono esattamente al riferimento. In una pagina in cui lo stesso importo compare due volte, prendere l'occorrenza sbagliata resta dunque un errore, anche se la stringa di caratteri è identica.
La precisione misura la proporzione di entità previste che sono corrette. Il richiamo misura la proporzione di entità attese che sono state ritrovate.
Prendiamo un esempio di calcolo: prevediamo quattro entità, tre sono corrette e cinque erano attese. La precisione vale 3 / 4 = 0,75, il richiamo 3 / 5 = 0,60. L'F1 combina entrambi: 2 × precisione × richiamo / (precisione + richiamo). Qui vale circa 0,667. Non è un punteggio del tutorial, ma un'illustrazione della formula.
Il micro-F1 riunisce i conteggi di tutte le entità prima del calcolo. Il macro-F1 calcola l'F1 di ogni tipo di campo, poi ne fa la media. Questa seconda lettura evita maggiormente che un campo difficile venga nascosto dagli altri.
La fattura è interamente corretta?
L'esattezza documentale richiede che tutti i campi siano corretti su una fattura. In un esempio di dieci fatture, nove interamente corrette danno 0,9. Molti campi isolati possono essere corretti mentre pochi documenti riescono integralmente: basta un solo campo errato per far fallire il documento.
Il tasso di errore degli importi confronta i valori numerici. Più è basso, meglio è. Questo controllo non sostituisce quello delle entità: ritrovare il numero corretto sulla parola sbagliata può preservare il valore numerico facendo però perdere la giusta provenienza.
La provenienza e l'astensione sono pertinenti?
Una provenienza valida significa che i riferimenti puntano correttamente alle parole e ai riquadri della pagina. Non garantisce che tali parole abbiano il ruolo giusto. Un riferimento tecnicamente valido può rimandare al subtotale mentre cercavamo il totale.
L'astensione sulle fatture senza totale verifica che il programma non attribuisca loro un totale inventato. Ma un sistema che non restituisce mai nulla potrebbe riuscire con questo solo criterio pur sbagliando tutti i campi presenti. Teniamo presente questo limite prima di leggere i risultati.
Lanciamo la valutazione, che può accedere alle annotazioni separatamente dall'inferenza.
docker compose run --rm tutorial python -m pdflayout.cli evaluate --config configs/minimum.yaml
Risultati del percorso r002
I risultati seguenti riguardano le 96 pagine di test, con 568 entità attese. Provengono da outputs/evaluation.json. Questo conteggio è coerente con sei campi per pagina e otto totali assenti: 96 × 6 − 8 = 568.
Su mobile, fate scorrere la tabella orizzontalmente.
| Metodo | Micro-F1 | Macro-F1 dei campi | Esattezza documentale | Errore degli importi |
|---|---|---|---|---|
| Regole semplici | 1,00 | 1,00 | 1,00 | 0,00 |
| LayoutLM, rettangoli reali | 1,00 | 1,00 | 1,00 | 0,00 |
| LayoutLM, addestramento neutro | 1,00 | 1,00 | 1,00 | 0,00 |
| Rettangoli mascherati solo nell'inferenza | 0,00 | 0,00 | 0,00 | 1,00 |
Due modi molto diversi di «rimuovere le posizioni»
I primi tre metodi raggiungono gli stessi punteggi. L'ultima riga, invece, corrisponde al modello addestrato con i rettangoli reali, ai quali vengono sostituiti zeri soltanto al momento della previsione.
Non è la variante neutra. neutral ha appreso fin dall'inizio con questa rappresentazione costante. Il modello mascherato, invece, riceve improvvisamente posizioni diverse da quelle con cui ha imparato a lavorare.
L'analogia con un'applicazione web può aiutare: prevedere fin dalla progettazione che un campo sia sempre costante non è la stessa cosa che sostituirne il valore con zero dopo avere costruito elaborazioni che vi si appoggiano. Per la rete, la differenza sta negli esempi di addestramento che ne hanno guidato i parametri.
Il mascheramento tardivo misura la sensibilità a una modifica degli input; non dimostra che il compito sarebbe impossibile da apprendere senza geometria. Il successo di neutral mostra proprio il contrario su questo corpus.
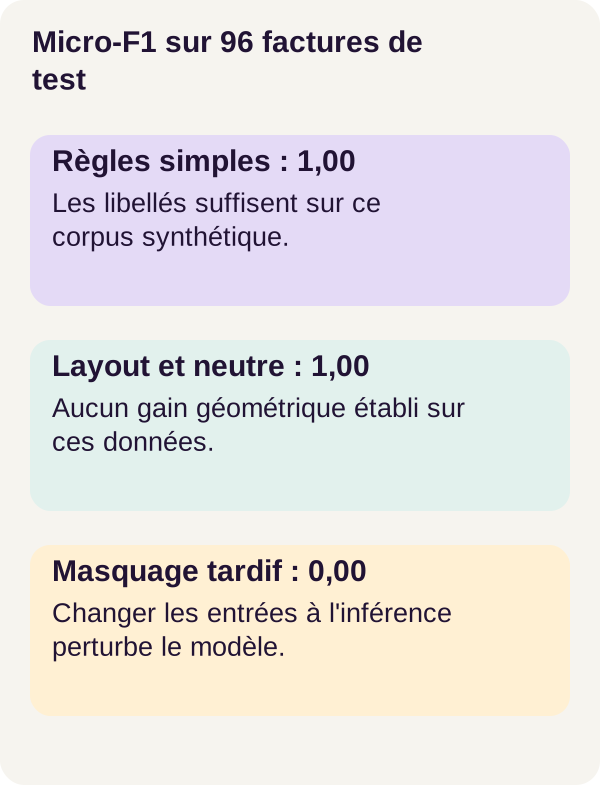
Questi punteggi descrivono il corpus sintetico del tutorial. Non stabiliscono un vantaggio del modello geometrico sulle regole semplici.
I primi tre metodi riescono anche nei sottogruppi delle otto pagine lunghe, delle otto pagine con importi ripetuti e delle otto pagine senza totale.
La variante mascherata non prevede alcuna entità. La sua astensione sui totali assenti vale quindi 1, ma questo valore isolato nasconde il suo fallimento sui campi presenti. Allo stesso modo, un tasso di provenienza valida pari a 1 può accompagnare un output vuoto: non è stato prodotto alcun riferimento non valido, senza ottenere neppure una sola estrazione utile.
La conclusione non è dunque «la geometria non serve mai». È più precisa: su questo corpus, le regole semplici e il modello neutro bastano già a raggiungere gli stessi punteggi di LayoutLM con i rettangoli reali. Abbiamo compreso e misurato il meccanismo, non ne abbiamo dimostrato la superiorità su tutte le fatture.
Testare ciò che deve fallire
Un test negativo sottopone al programma una situazione che deve essere rifiutata. I test avviati all'inizio verificano in particolare i riquadri non validi, le parole perse dal finestramento e gli input incoerenti.
Il loro interesse è concreto: un risultato apparentemente plausibile è difficile da diagnosticare se una parte del documento è scomparsa prima della previsione. È preferibile segnalare l'input non valido piuttosto che nascondere il problema con un output rassicurante.
Consultate i test per vedere i casi esatti prima di adattare i vostri documenti. Riuscire nei casi coperti non significa che tutte le situazioni possibili siano state esplorate.
Cosa abbiamo imparato
Siamo partiti da un importo in una pagina per arrivare a un campo collegato alla sua fonte. Il testo fornisce indizi lessicali; i rettangoli forniscono una localizzazione. LayoutLM combina le loro rappresentazioni, poi lo strato di classificazione propone ruoli per i token.
L'allineamento permette di tornare dai sotto-token alle parole. Il finestramento gestisce una pagina lunga e la fusione evita di avere più decisioni indipendenti per la stessa occorrenza. Il decoder riunisce poi le entità e conserva le ambiguità.
Infine, tracciabilità, correttezza e interesse dell'apprendimento sono tre questioni distinte. Un riquadro valido non assicura un buon campo; un punteggio perfetto su un corpus sintetico non garantisce un servizio affidabile; una rete complessa non apporta necessariamente un vantaggio rispetto a regole semplici. I risultati del percorso illustrano queste differenze.
Esercizio: prevedere prima di spostare
Torniamo al nostro problema di totale e subtotale. Scambieremo le posizioni dei blocchi TOTAL e SUBTOTAL, senza cambiarne i valori. Prima di eseguire, scrivete la vostra ipotesi: quali indizi resteranno disponibili alle regole, al modello geometrico e al modello neutro? Lo spostamento deve necessariamente modificare le loro previsioni? Perché?
Il progetto fornisce questa modifica in configs/exercise.yaml. Confrontate le due pagine dell'esperimento e annotate i campi che, secondo voi, dovrebbero cambiare. Eseguite quindi la variante preparata.
docker compose run --rm tutorial python -m pdflayout.cli exercise --config configs/exercise.yaml
Confrontate la vostra previsione con i risultati dell'esercizio. Il riferimento convalidato ritrova le dodici entità con le regole, layout e neutral; la variante mascherata non ne ritrova nessuna. La correzione dettagliata è in lesson/SOLUTIONS.md.
Perché lo spostamento non basta a mettere in difficoltà questi metodi? Qui le etichette restano sufficientemente discriminanti. Cambiare la posizione di un blocco non fa scomparire tutti gli altri indizi. Questo esperimento non dimostra quindi, da solo, l'utilità della geometria.
Per un esperimento personale, scegliete poi una sola modifica nel generatore, per esempio rendere ambigua un'etichetta. Prevedete l'effetto su ciascun metodo prima di rigenerare i dati e di ripetere il percorso. Conservate separatamente i vostri risultati e quelli di riferimento.
Questo nuovo esperimento non ha un risultato annunciato. L'interesse consiste proprio nel misurare ciò che cambia, poi spiegare gli errori o i successi, anche quando contraddicono la vostra intuizione.
Osservare le figure e controllare i checkpoint
Generate le figure a partire dai vostri risultati, poi controllate i file di modello attesi.
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Le figure nella cartella outputs/ permettono di ispezionare la fattura, i sotto-token e i risultati. Verificate la corrispondenza fra un campo, la sua parola e il suo riquadro prima di accontentarvi della tabella aggregata.
Per AL-01-03, il controllo visivo consiste in particolare nel ritrovare la parola 62 che contiene 250.16, quindi verificare che il campo TOTAL rimandi davvero a questa occorrenza. Una media non sostituisce la lettura di un esempio.
In caso di problema
Iniziate identificando la fase che fallisce: accesso alla GPU, acquisizione, preparazione delle parole, segmentazione o previsione. Modificare il modello non risolverebbe un riquadro male orientato ancor prima del suo ingresso nella rete.
Su mobile, fate scorrere la tabella orizzontalmente.
| Sintomo | Verifica e correzione |
|---|---|
| GPU assente in Docker | Confrontate il preflight dell'host e il controllo del contenitore. Correggete l'integrazione di NVIDIA Container Toolkit prima dell'addestramento. |
| Modello assente o acquisizione interrotta | Consultate gli errori di scripts/acquire.py, verificate lo spazio libero e riavviate l'acquisizione prevista; conservate il modello e la revisione bloccati. |
| Riquadro rifiutato | Verificate le dimensioni, il ritaglio e la rotazione della pagina canonica. Un riquadro fuori pagina non deve diventare valido mascherando l'errore. |
| Parola persa durante la segmentazione | Ispezionate gli identificativi e i primi sotto-token delle finestre. Il controllo deve restare attivo. |
| Input senza testo utilizzabile | Verificate che il PDF contenga testo nativo. Le scansioni richiedono una fase OCR aggiuntiva, fuori dal percorso convalidato qui. |
Arrestare e pulire
Prima di pulire, conservate i risultati e le figure che desiderate studiare. Il primo comando arresta il progetto, lo script elimina soltanto i risultati di outputs/, poi l'ultimo arresto termina il percorso.
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Le risorse del modello, i checkpoint in assets/ e i dati generati vengono conservati. Non è necessaria alcuna pulizia Docker globale. La pulizia non significa quindi che i pesi o il corpus debbano essere scaricati o generati di nuovo.
Dal tutorial a un'applicazione reale
Il primo lavoro non consiste nell'aggiungere un endpoint a questo script: consiste nel verificare che funzioni sui documenti della vostra applicazione. Le fatture aziendali richiedono un'acquisizione controllata, una varietà di lingue e formati, una strategia OCR per le scansioni e una gestione delle pagine multiple.
Costituite un corpus annotato rappresentativo con una separazione per fornitori o modelli, poi analizzate gli errori per campo e per tipo di documento. Un punteggio globale può nascondere una difficoltà sulle date di un fornitore o sui totali di un formato particolare. Questi esempi descrivono le analisi da prevedere, non errori già misurati qui.
Aggiungete secondo le vostre necessità autenticazione, autorizzazioni documentali, protezione dei dati, limiti di dimensione, coda di elaborazione, registrazione e supervisione. Definite i casi di astensione e una convalida umana per i valori ambigui. La provenienza conservata può aiutare questa rilettura, ma l'interfaccia e il processo aziendale restano da costruire.
Versionate modelli, configurazioni e dati di valutazione per rilevare le regressioni. Questo motore didattico non stabilisce alcuna conformità contabile e non costituisce, da solo, un servizio di produzione.
Per andare oltre
Iniziate testando fatture con modelli realmente diversi e annotazioni verificate. Confrontate gli errori delle regole e del modello su etichette volutamente ambigue: è un modo per cercare le situazioni in cui l'apprendimento potrebbe apportare un vantaggio, quindi misurarlo.
Un'altra estensione consiste nell'aggiungere una catena OCR per ottenere parole e riquadri dalle scansioni. Introduce i propri errori; occorrerà valutare questa nuova catena, non attribuirle i punteggi del percorso su testo nativo.
Infine, potete costruire un'interfaccia che mostri ogni valore con la sua zona sorgente e permetta una correzione umana. Questo prolungamento collega direttamente il meccanismo del tutorial a un'esigenza di applicazione web: lasciare che l'utente verifichi una proposta invece di presentargli un numero senza origine.
Fonti per approfondire
Il README, il codice e le lezioni dello ZIP costituiscono il percorso riproducibile usato qui. I punteggi pubblicati sono quelli del percorso r002; gli esempi numerici segnalati nell'articolo servono soltanto a spiegare i calcoli.
La documentazione LayoutLM di Transformers, versione 4.56.2 descrive gli input testuali e geometrici oltre alla classificazione dei token. La scheda del modello LayoutLM presenta il modello preaddestrato.
Per approfondire le fasi intermedie, consultate la documentazione di pdfplumber, il corso su WordPiece e la guida alla classificazione dei token. Le spiegazioni sull'apprendimento si basano anche sulla documentazione dell'entropia incrociata PyTorch e sul suo tutorial di ottimizzazione dei parametri.
Questi materiali documentari non sostituiscono i file bloccati dello ZIP. Le documentazioni online possono evolvere indipendentemente dall'ambiente convalidato; conservate le versioni e i comandi del progetto per riprodurlo.