





Imaginez un petit outil 3D dans une application web. Vous déplacez un point autour d’une bouée et vous voulez savoir : est-il dans la matière, dans le trou central ou à l’extérieur ? À quelle distance se trouve la surface la plus proche ?
Une manière de représenter l’objet consiste à conserver ses sommets et les triangles qui les relient : c’est un maillage. Nous allons explorer une autre représentation. Au lieu de demander au réseau de produire directement des triangles, nous lui apprenons une fonction : donnez-lui trois coordonnées, il renvoie une distance signée.
Le signe indique de quel côté de la surface se trouve le point. La valeur absolue indique sa distance à cette surface. À partir de cette fonction, nous pouvons observer des coupes de l’objet, puis en extraire un maillage.
La question du tutoriel est précise : apprendre les bonnes distances suffit-il, ou une règle supplémentaire sur la manière dont elles varient dans l’espace améliore-t-elle le résultat ? Nous comparerons les deux approches sur une forme dont la géométrie est connue. Nous pourrons ainsi vérifier les réponses, pas seulement regarder si l’objet ressemble à une bouée.
Télécharger l'archive du tutoriel.
Ce que nous construisons
Notre forme cible est un tore : imaginez un tube circulaire refermé sur lui-même, comme une bouée. Son rayon majeur vaut R=0,55 : il va du centre de l’objet au centre du tube. Son rayon mineur vaut r=0,18 : il mesure l’épaisseur du tube depuis son centre jusqu’à sa surface.
Les coordonnées sont celles de l’expérience, sans unité physique imposée. Une distance de 0,01 ne signifie donc pas automatiquement un centimètre ou un millimètre.
Nous entraînons un MLP, pour multilayer perceptron, autrement dit un réseau de couches entièrement connectées. Son contrat ressemble à celui d’une fonction de votre application : entrée (x, y, z), sortie numérique. Cette sortie, un scalaire, doit être négative dans la matière, positive à l’extérieur et nulle sur la surface.
Deux modèles partent exactement de la même initialisation et voient les mêmes lots de points. Le premier apprend uniquement à retrouver les distances de référence. Le second reçoit les mêmes exemples, mais ajoute une pénalité eikonale, pondérée par λ=0,1. Nous allons prendre le temps d’expliquer ce terme : il ne demande pas une seconde forme, mais un comportement particulier de la fonction entre les points.
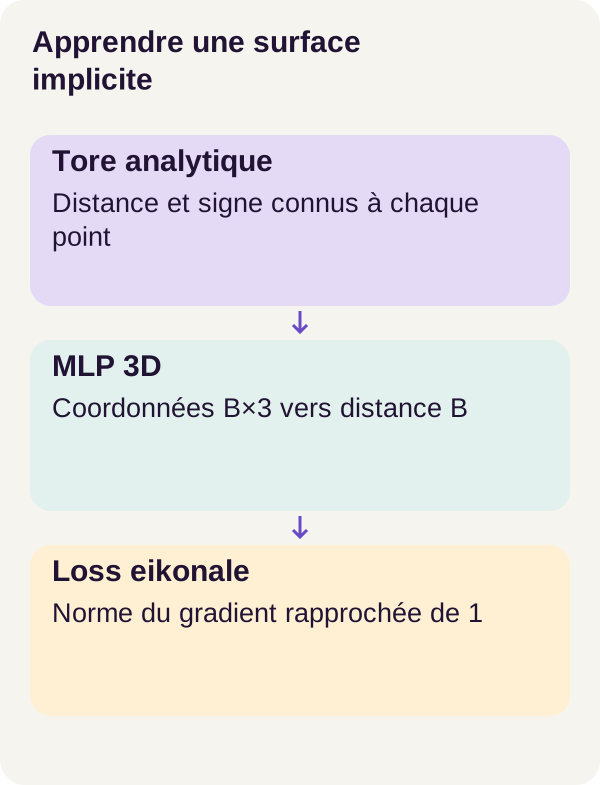
À l’arrivée, le parcours fournit deux champs appris, leurs mesures et leurs maillages extraits. Il vérifie aussi qu’un entraînement interrompu peut reprendre correctement. Il ne construit pas une interface web, ne lit pas de scan et ne reconstruit pas un objet réel à partir de photographies.
Pourquoi entraîner un réseau alors que nous connaissons déjà la formule du tore ? Pour cet objet précis, la formule est une excellente solution directe. Ici, elle joue le rôle d’une référence fiable : elle permet d’apprendre le mécanisme neuronal, de détecter ses erreurs et de comprendre ce que change la pénalité. Le tutoriel ne cherche pas à démontrer que l’IA remplace avantageusement cette formule.
Concepts utiles
Un champ : une valeur pour chaque position
Un champ associe une valeur à une position. Pensez à une fonction qui donnerait la température à différents endroits d’une pièce. Ici, la valeur n’est pas une température, mais une distance signée à la surface du tore.
Une SDF, pour signed distance function, utilise la convention suivante : une valeur de −0,05 signifie « dans la matière, à 0,05 unité de la surface » ; +0,05 signifie « hors de la matière, à la même distance » ; 0 désigne la surface elle-même.
Attention au trou de la bouée : le centre de l’objet n’est pas forcément à l’intérieur de sa matière. Dans notre tore, l’origine (0, 0, 0) est dans le trou. Sa distance signée est positive.
Voici quelques valeurs calculées directement avec la formule du tore, et non prédites par le réseau. Dans les coordonnées entre parenthèses, le point sert de séparateur décimal pour éviter de confondre nombres et axes.
Point (x, y, z) |
Distance signée analytique | Interprétation |
|---|---|---|
(0.55, 0, 0) |
−0,18 |
Centre du tube : dans la matière. |
(0.73, 0, 0) |
0 |
Surface extérieure, puisque 0,55 + 0,18 = 0,73. |
(0.37, 0, 0) |
0 |
Surface intérieure, tournée vers le trou. |
(0, 0, 0) |
+0,37 |
Centre du trou : hors de la matière. |
(0.78, 0, 0) |
+0,05 |
À 0,05 unité au-delà de la surface extérieure. |
(0.55, 0, 0.18) |
0 |
Haut du tube. |
Ces valeurs sont des calculs géométriques. Avec des nombres flottants, un zéro théorique peut apparaître comme un très petit nombre proche de zéro.
Une fonction apprise plutôt qu’une liste de triangles
Dans une couche entièrement connectée, chaque unité reçoit toutes les valeurs de la couche précédente et les combine avec des coefficients ajustables. Les transformations non linéaires permettent à l’ensemble de représenter autre chose qu’un simple plan ; le réseau exact est fourni dans le projet.
Les poids sont les nombres ajustables du réseau. Pendant l’entraînement, ils changent pour rapprocher les distances prédites des distances connues. Une fois entraîné, le modèle utilise ces poids pour répondre à de nouvelles coordonnées : c’est l’inférence.
Nous notons cette fonction fθ(x, y, z), où θ représente l’ensemble des paramètres appris. Elle définit une représentation implicite : la surface n’est pas une liste stockée directement, elle est définie par la condition fθ(x, y, z) = 0.
Une isosurface regroupe les points auxquels une fonction attribue la même valeur. Le niveau zéro nous intéresse pour retrouver la frontière de l’objet. De la même manière, fixer z=0 permet d’étudier une coupe du champ dans un plan.
DeepSDF présente le principe d’une représentation continue par distances signées. Notre expérience reste beaucoup plus ciblée : un seul tore et des distances analytiques, pas une reproduction de toute la méthode de cet article de recherche.
Le réseau peut être interrogé à des coordonnées qui ne figurent pas dans son jeu d’entraînement. Cela ne signifie pas qu’il est exact partout : nous devrons mesurer ses erreurs, et ne pas supposer sa fiabilité en dehors du domaine étudié.
Le gradient spatial : dans quelle direction la valeur change-t-elle ?
Déplaçons légèrement notre point. Si la distance prédite change beaucoup, la fonction a une pente forte dans cette direction. Si elle change peu, sa pente est faible.
Le gradient spatial, noté ∇xfθ, rassemble les trois dérivées par rapport aux coordonnées. Ici, le x de la notation désigne le point complet, pas seulement son premier axe. On obtient un vecteur de trois nombres : variations selon x, y et z.
Sa norme L2 est sa longueur : pour un gradient [a, b, c], elle vaut √(a² + b² + c²). Par exemple, [1, 0, 0] a une norme de 1 ; [2, 0, 0], une norme de 2.
Pour une véritable distance signée, cette norme vaut 1 là où la fonction est différentiable. L’idée intuitive est la suivante : près d’une surface régulière, avancer d’une petite distance dans la direction perpendiculaire fait varier la distance signée d’autant. Ce n’est pas vrai pour un déplacement quelconque : glisser le long de la surface ne produit pas la même variation.
Certaines positions particulières n’ont pas de direction de surface la plus proche unique. La propriété ne doit donc pas se lire comme une exigence de dérivabilité parfaite en chaque point de l’espace.
La pénalité eikonale : une préférence, pas une garantie
La pénalité encourage le réseau à avoir une norme de gradient proche de 1 aux points échantillonnés. C’est une régularisation : nous n’indiquons pas seulement quelles réponses apprendre, mais aussi une propriété souhaitée de la fonction.
La formule du tutoriel est :
Perte totale = MAE de distance + λ × moyenne((‖∇xfθ(x)‖₂ − 1)²).
La perte est le nombre que l’entraînement cherche à réduire. La MAE, pour mean absolute error, est la moyenne des écarts absolus aux distances de référence. La seconde partie pénalise les normes trop éloignées de 1. Avec λ=0,1, cette seconde valeur est multipliée par 0,1 avant addition ; cela ne veut pas dire qu’elle représente exactement 10 % de la perte totale.
Pourquoi garder les distances de référence ? Prenons deux fonctions très simples : f(x,y,z)=x et g(x,y,z)=x−0,3. Elles ont toutes deux un gradient de norme 1, mais leur surface zéro se trouve respectivement en x=0 et en x=0,3. La fonction h(x,y,z)=−x conserve le même plan que f, tout en inversant intérieur et extérieur.
La norme du gradient ne suffit donc ni à placer la bonne surface ni à choisir son signe. Dans notre expérience, les distances supervisées apportent ces informations. Le travail Implicit Geometric Regularization permet d’approfondir le rôle d’une contrainte de gradient ; son protocole de reconstruction n’est pas celui de notre tore analytique.
Il reste une difficulté de programmation : pour que cette pénalité modifie les poids, PyTorch doit pouvoir dériver un calcul qui contient déjà un gradient. C’est le rôle de create_graph=True, que nous allons suivre dans le code.
Prérequis Docker et GPU
Vous devez savoir lire des fonctions Python, manipuler des tableaux et lancer des commandes dans un terminal. Les concepts de géométrie neuronale sont introduits ici ; aucune expérience préalable des SDF n’est nécessaire.
Le parcours prévu utilise Linux x86_64, Docker Compose, NVIDIA Container Toolkit, une RTX 3090 de 24 Gio, 16 Gio de RAM et 16 Gio de disque, hors couches Docker partagées. La VRAM est la mémoire de la carte graphique ; elle est distincte de la RAM de la machine. Conservez ces conditions pour suivre le parcours présenté, plutôt que d’interpréter les explications comme la validation d’une autre configuration.
Pour choisir la carte, exportez GPU_DEVICE=0 ou son UUID avant la séquence. L’UUID est son identifiant ; il permet de désigner une carte précise. Le contrôle d’environnement initialise CUDA, l’environnement de calcul NVIDIA utilisé ici, et lance un calcul dans le conteneur.
Voir la carte depuis Linux ne suffit pas à établir que Docker peut l’utiliser. Le guide officiel NVIDIA Container Toolkit documente cette intégration avec le pilote de l’hôte.
Les calculs GPU sont sans réseau. Les conteneurs appliquent un système de fichiers en lecture seule, no-new-privileges, la suppression des capacités Linux et des limites CPU, RAM et PID. Ces réglages bornent les droits et les ressources des processus ; ils ne remplacent pas les tests du modèle.
Un checkpoint est une sauvegarde d’état utilisée pour retrouver le modèle ou reprendre son entraînement. Ceux du parcours sont produits localement : n’en chargez pas depuis une source arbitraire. Leur fiabilité dépend aussi de leur provenance.
Données : une vérité géométrique contrôlable
Trois jeux de points, trois responsabilités
Une annotation, ou label, est ici une distance signée calculée avec la formule exacte. Il ne s’agit ni d’une catégorie choisie par un humain ni d’une réponse fournie par un autre modèle.
Le programme prépare trois ensembles avec des graines distinctes. Une graine initialise le générateur pseudo-aléatoire : elle permet de retrouver les mêmes tirages dans l’environnement du projet.
| Ensemble | Nombre de points | Rôle |
|---|---|---|
Entraînement, ou train |
65 536 | Fournir les exemples qui servent à ajuster les poids. |
| Validation | 16 384 | Observer les erreurs sur un ensemble séparé de l’apprentissage. |
| Test | 32 768 | Mesurer les résultats présentés plus loin. |
Chaque ensemble contient moitié de points uniformes dans le cube [-1,1]³, moitié de points construits près de la surface. Les premiers explorent le volume ; les seconds concentrent une partie de l’apprentissage près de la frontière qui nous intéresse.
Une grille 64³ est réservée à l’extraction. Cela représente 64 × 64 × 64 = 262 144 positions d’évaluation, et non 262 144 exemples d’entraînement supplémentaires. Elle n’est jamais utilisée pour entraîner le réseau.
Lire les deux fonctions sans les confondre
Dans l’extrait, np désigne NumPy ; R et r sont les deux rayons définis plus haut. Le projet complet fournit les imports et les constantes.
generate_points() fabrique des coordonnées. torus_sdf() calcule ensuite la distance de référence de coordonnées qu’on lui transmet. La première fonction ne retourne pas elle-même les labels et aucune des deux n’enregistre les fichiers : l’enchaînement et la sauvegarde appartiennent à l’étape de préparation du projet.
def torus_sdf(points):
    return (
        np.sqrt(
            (np.sqrt(points[..., 0] ** 2 + points[..., 1] ** 2) - R) ** 2
            + points[..., 2] ** 2
        )
        - r
    )


def generate_points(n, seed, std=0.04):
    rng = np.random.default_rng(seed)
    uniform = rng.uniform(-1, 1, (n // 2, 3))
    u = rng.uniform(0, 2 * np.pi, n // 2)
    v = rng.uniform(0, 2 * np.pi, n // 2)
    surface = np.stack(
        [
            (R + r * np.cos(v)) * np.cos(u),
            (R + r * np.cos(v)) * np.sin(u),
            r * np.sin(v),
        ],
        -1,
    )
    near = np.clip(surface + rng.normal(0, std, surface.shape), -1, 1)
    return np.concatenate([uniform, near]).astype("float32")
Comment la formule retrouve-t-elle une distance ?
L’expression points[..., 0] sélectionne les coordonnées x ; les indices 1 et 2 sélectionnent y et z. Les points de suspension conservent les dimensions précédentes, ce qui permet d’effectuer le calcul sur un tableau de points.
Le calcul se lit en trois étapes. √(x²+y²) donne d’abord la distance à l’axe vertical du tore. Soustraire R recentre ensuite cette distance sur le cercle qui passe au centre du tube. Enfin, √((√(x²+y²)−R)²+z²)−r mesure l’écart à la surface du tube.
Prenons le point (0.78, 0, 0). Sa distance à l’axe est 0,78. Nous retirons 0,55, obtenons 0,23, puis retirons le rayon du tube 0,18. Résultat : 0,05, positif. Nous sommes bien à l’extérieur.
Au point (0.55, 0, 0), le même calcul donne 0−0,18=−0,18. Dans le trou, à l’origine, il donne 0,55−0,18=0,37. La même formule explique donc les trois situations, sans règle séparée pour le trou.
Pourquoi ajouter du bruit aux coordonnées ?
uniform contient n // 2 points répartis dans le cube. Les angles u et v construisent ensuite autant de positions sur la surface du tore : u fait le tour de la bouée, v fait le tour de son tube. np.stack(..., -1) réunit les trois coordonnées sur le dernier axe.
Le programme ajoute à ces positions un bruit gaussien, c’est-à-dire des déplacements aléatoires centrés sur zéro. Le paramètre std=0.04 est leur écart-type par coordonnée, pas une distance maximale autorisée à la surface ; la documentation NumPy de Generator.normal précise cette convention. np.clip ramène les coordonnées dans l’intervalle [-1,1]. Enfin, les deux groupes sont réunis et convertis en float32, des nombres flottants stockés sur 32 bits.
Une nuance utile : les angles sont tirés uniformément, mais cela ne correspond pas à un échantillonnage uniforme en aire sur toute la surface du tore. Le protocole utilise ce générateur précis ; nous ne lui attribuons pas une autre distribution.
Le bruit déplace les points, pas leurs réponses de référence. Une fois les coordonnées obtenues, leur distance est recalculée par la formule analytique. Nous ne simulons donc pas ici des annotations de distance bruitées comme celles que pourrait produire un capteur.
La préparation enregistre les jeux et contrôle que les points sont distincts entre partitions. Les trois ensembles concernent cependant le même tore et le même mécanisme de génération : un bon résultat de test ne mesure pas une capacité à apprendre toutes les formes 3D.
Installer et vérifier l'environnement
Extrayez l’archive et placez votre terminal à sa racine. Toutes les commandes suivantes partent de ce même répertoire. Les extraits Python expliquent le mécanisme ; le ZIP fournit le projet qui les entoure.
Commencez par préparer et contrôler l’environnement :
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prépare le projet. docker compose config --quiet vérifie la configuration Compose ; build construit les images utilisées par les services acquire et gpu.
Le nom acquire peut rappeler les tutoriels qui téléchargent un modèle préentraîné. Ici, il valide un manifeste sans poids à télécharger : nous allons apprendre le champ à partir de points générés localement. Cela ne signifie pas que construire les images Docker ne nécessite jamais de réseau.
Le contrôle d’environnement doit réussir avant l’entraînement. La commande pytest exécute ensuite les tests fournis. Une réussite à ce stade contrôle le programme et son environnement ; elle ne prouve pas encore que le réseau appris représente correctement le tore.
Préparez maintenant les données, inspectez le contrat du réseau, puis vérifiez la perte :
docker compose run --rm gpu python -m neural_sdf.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli inspect-model --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli check-loss --config configs/minimum.yaml
La notation B×3 → B signifie : pour un lot de B points à trois coordonnées, obtenir une distance par point. Par exemple, dix points entrent sous la forme d’un tableau 10×3 ; dix distances doivent en sortir.
Dans PyTorch, ces tableaux sont des tenseurs : des nombres organisés selon des dimensions, que le programme peut traiter sur le GPU. Une perte scalaire est un tenseur qui ne contient qu’une valeur.
Ce contrôle de dimensions n’est pas décoratif. Avec prediction et labels de forme B, leur soustraction compare chaque prédiction à son label. Un tableau B×1 soustrait à un tableau B peut être automatiquement étendu en B×B : le programme comparerait alors toutes les paires au lieu des seules paires correspondantes. C’est un effet du broadcasting de PyTorch, pas une mesure correcte de nos distances.
check-loss vérifie un autre contrat : la pénalité doit effectivement avoir un gradient vers les poids. Regardons comment ce contrôle est construit.
Le code central : rendre la pénalité eikonale entraînable
Deux gradients, deux questions
En développement web, une même donnée peut passer par plusieurs fonctions avant d’être enregistrée. Ici, nous devons aussi suivre une chaîne, mais une chaîne de calculs différentiables.
Le gradient spatial répond à « que devient la distance si je déplace le point ? ». Le gradient de la perte par rapport aux paramètres répond à « comment la perte varie-t-elle si je change les poids ? ». L’optimiseur utilise le second pour ajuster le réseau.
La pénalité fait le lien entre les deux : elle dépend du gradient spatial, qui dépend lui-même des poids. Pour apprendre cette propriété, il faut conserver cette dépendance lors du calcul.
Le graphe de calcul est la trace des opérations et de leurs dépendances : quel résultat vient de quels nombres, multiplications ou autres transformations ? PyTorch s’en sert pour propager les dérivées. Il ne s’agit pas d’un graphique affiché à l’écran.
def sdf_eikonal_loss(model, points, labels, weight=0.1, create_graph=True):
    points = points.detach().requires_grad_(True)
    prediction = model(points)
    gradient = torch.autograd.grad(prediction.sum(), points, create_graph=create_graph)[
        0
    ]
    distance = (prediction - labels).abs().mean()
    eikonal = (gradient.norm(dim=-1) - 1).square().mean()
    return distance + weight * eikonal, distance, eikonal


def check_loss(config):
    model = torch.nn.Linear(3, 1, bias=False).cuda()
    with torch.no_grad():
        model.weight.copy_(torch.tensor([[2.0, 0, 0]], device="cuda"))
    x = torch.randn(10, 3, device="cuda", requires_grad=True)
    gradient = torch.autograd.grad(model(x).sum(), x, create_graph=True)[0]
    penalty = (gradient.norm(dim=-1) - 1).square().mean()
    weight_gradient = torch.autograd.grad(penalty, model.weight)[0]
    assert torch.allclose(weight_gradient, torch.tensor([[2.0, 0, 0]], device="cuda"))
    return {
        "affine_gradient": [2.0, 0, 0],
        "penalty": float(penalty),
        "weight_gradient": weight_gradient.tolist(),
    }
Suivre sdf_eikonal_loss()
Préparer les coordonnées. points.detach() coupe leur éventuel historique de calcul ; requires_grad_(True) demande ensuite de suivre les variations de la sortie par rapport à ces coordonnées. Cela ne gèle pas les poids du modèle et ne déplace pas les points. Cela prépare les entrées au calcul de dérivées. La documentation de detach() précise cette rupture avec le graphe précédent.
Prédire les distances. model(points) applique le réseau aux coordonnées. Avec le contrat B×3 → B, prediction et labels portent une valeur par point.
Calculer la pente dans l’espace. torch.autograd.grad() reçoit la somme des prédictions et les coordonnées. Pour ce réseau qui traite chaque point indépendamment des autres points du lot, dériver la somme permet de retrouver le gradient de chaque prédiction par rapport à son propre point. Le résultat possède la forme B×3.
Le [0] à la fin de l’appel sélectionne le premier élément du tuple renvoyé par PyTorch, celui qui correspond à points. Il ne sélectionne pas uniquement le premier point du lot. La documentation de torch.autograd.grad décrit ce calcul et ses paramètres.
Calculer les deux erreurs. (prediction - labels).abs().mean() donne la MAE de distance. gradient.norm(dim=-1) calcule une norme par point en réunissant ses trois dérivées. On soustrait 1, on élève l’écart au carré, puis on moyenne : c’est la pénalité eikonale.
Retourner le total et ses composantes. La fonction renvoie trois nombres tensoriels : la perte totale, la MAE et la pénalité non pondérée. Les conserver séparément permet de voir quelle composante s’améliore ou se dégrade.
La fonction ne met pas elle-même les poids à jour. L’appel ultérieur à loss.backward() calcule leurs gradients ; l’optimiseur réalise ensuite la mise à jour. Il ne faut pas confondre calculer une perte, calculer son gradient et appliquer une modification aux paramètres.
Un calcul de perte que l’on peut refaire à la main
Voici trois prédictions fictives, choisies pour expliquer la formule. Elles ne proviennent pas du modèle entraîné ni des fichiers de résultats.
| Point | Distance de référence | Prédiction fictive | Écart absolu |
|---|---|---|---|
(0.55, 0, 0) |
−0,18 |
−0,16 |
0,02 |
(0.73, 0, 0) |
0 |
0,01 |
0,01 |
(0.78, 0, 0) |
0,05 |
0,02 |
0,03 |
La MAE vaut (0,02 + 0,01 + 0,03) / 3 = 0,02.
Supposons maintenant que les normes des gradients prédits à ces trois points valent respectivement 0,8, 1,0 et 1,2. La pénalité vaut ((0,8−1)² + (1−1)² + (1,2−1)²) / 3, soit environ 0,026667.
Avec λ=0,1, la perte totale vaut donc 0,02 + 0,1 × 0,026667 ≈ 0,022667. Nous n’ajoutons pas directement 0,026667 : la pondération compte.
Pourquoi create_graph=True est indispensable ici
PyTorch sait calculer un gradient numérique sans conserver toutes les dépendances permettant de le dériver à nouveau. Or la pénalité dépend précisément d’un gradient que nous voulons ensuite dériver par rapport aux poids.
create_graph=True construit le graphe du calcul de dérivée. Le chemin reste donc disponible : poids → distances → gradients spatiaux → pénalité. Avec False, on peut encore obtenir un nombre pour la pénalité, sans pouvoir utiliser ce chemin pour entraîner les poids.
Le tutoriel officiel Double Backward with Custom Functions approfondit cette différence entre calculer une dérivée et pouvoir dériver son calcul. Ce complément explique le mécanisme ; il ne demande pas de remplacer le code du projet par une fonction autograd personnalisée.
Lire le test affine : pourquoi attend-on [2, 0, 0] ?
check_loss() choisit une couche linéaire à trois entrées, une sortie et aucun biais. Il fixe ses poids à [2, 0, 0]. La fonction calculée est donc simplement f(x,y,z)=2x.
Quel que soit le point, son gradient spatial est [2, 0, 0]. Sa norme vaut 2 et la pénalité vaut (2−1)²=1. Les dix points aléatoires ne compliquent pas cette vérification : pour cette fonction, la pente est constante.
Mais le test va plus loin : il dérive la pénalité par rapport aux poids. Près du coefficient positif a=2, pour une fonction f(x,y,z)=a×x, la pénalité vaut (a−1)². Sa dérivée vaut 2×(a−1), donc 2 en a=2. Les deux autres composantes valent zéro. Cela explique l’assertion sur [[2.0, 0, 0]].
Le gradient spatial et le gradient vers les poids ont ici les mêmes valeurs numériques, mais ce sont deux objets différents. Le premier décrit la variation dans l’espace ; le second vérifie que la régularisation peut participer à l’apprentissage.
Le contrôle porte sur la pénalité seule, sans la multiplication par λ. Il attend donc 2 sur le premier poids, pas 0,2. Une sortie numérique plausible de la perte ne suffirait pas à remplacer cette assertion.
Entraîner, reprendre, évaluer et extraire
Nous pouvons maintenant suivre la séquence complète. La première commande entraîne la variante eikonale. La deuxième entraîne la variante distance seule, qui sert de point de comparaison.
Les commandes suivantes interrompent un entraînement après le pas 500, reprennent l’état sauvegardé, comparent la reprise au parcours de référence, évaluent les deux champs, puis extraient leurs isosurfaces.
docker compose run --rm gpu python -m neural_sdf.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli train --config configs/minimum.yaml --variant distance
docker compose run --rm gpu python -m neural_sdf.cli train --config configs/minimum.yaml --stop-after 500 --run-name interrupted
docker compose run --rm gpu python -m neural_sdf.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m neural_sdf.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli evaluate --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli mesh --config configs/minimum.yaml
Un lot, ou batch, est un groupe de points traité ensemble. Une initialisation fixe les poids avant leur première mise à jour. Partir des mêmes poids et présenter les mêmes lots aux deux variantes réduit les différences parasites dans la comparaison : nous étudions l’ajout de la pénalité, pas deux jeux d’exemples différents.
La reprise nécessite davantage que le seul poids final d’une couche. L’état de l’optimiseur et celui du générateur pseudo-aléatoire font partie du parcours contrôlé. C’est comparable à la reprise d’un traitement applicatif : retrouver le dernier résultat ne suffit pas si l’on a perdu l’état qui détermine la prochaine opération.
Les résultats publiés plus loin proviennent de la reproduction lecteur validée de cette séquence. Le tutoriel ne fournit pas ici de durée d’entraînement de référence ni de comparaison de rapidité entre les variantes : n’en déduisez pas un gain de temps à partir des seuls scores de qualité.
Comment passer d’une fonction à des triangles ?
L’étape mesh évalue le champ sur sa grille indépendante 64³, puis extrait le niveau zéro. Le principe de marching cubes consiste à parcourir les cellules de la grille et à construire des triangles à partir des valeurs qui encadrent le niveau recherché. La documentation de scikit-image décrit cette extraction, les sommets et les faces qu’elle retourne.
Une analogie en une dimension permet de comprendre l’interpolation. Sur un segment de longueur 0,1, supposons que les valeurs aux extrémités soient −0,02 et +0,03. Une interpolation linéaire place le zéro à 0,02 / (0,02 + 0,03) = 0,4 du segment, soit à 0,04 de la première extrémité. Cet exemple explique le principe ; ce n’est pas une mesure du maillage du tutoriel.
Le maillage est une approximation discrète du champ appris. La résolution de la grille influence ce qui peut être visible ou manqué. Augmenter cette résolution ne réentraîne pas le réseau et ne corrige pas automatiquement ses distances.
Mesures avant les résultats
MAE globale : le réseau donne-t-il les bonnes distances ?
La MAE de distance moyenne |prédiction − référence| sur les points évalués. Une erreur positive et une erreur négative ne s’annulent pas. Plus cette moyenne est basse, plus les valeurs prédites sont proches des distances analytiques dans la population considérée.
Elle est évaluée sur validation et sur test. Elle conserve l’unité des coordonnées de l’expérience : ce n’est ni un pourcentage ni un taux de points correctement classés à l’intérieur ou à l’extérieur.
MAE près de la surface : comment se comporte la frontière ?
Le calcul ne garde que les points dont la distance analytique satisfait le seuil de proximité déclaré dans le projet. On moyenne ensuite les erreurs sur cette sous-population.
Le seuil numérique n’est pas reproduit dans ce texte : consultez celui du parcours fourni plutôt que d’en choisir un après lecture des résultats. Surtout, la sélection repose sur la distance de référence, pas sur la distance que le modèle estime lui-même. Une prédiction erronée ne doit pas pouvoir s’exclure de sa propre évaluation.
Ne confondez pas « moitié des points générés près de la surface » et « nombre de points retenus par ce seuil ». Les déplacements gaussiens ne constituent pas une bande stricte ; certains points uniformes peuvent aussi être proches de la surface. Le nombre publié de 13 832 points vient de la sélection d’évaluation, pas de la simple division de 32 768 par deux.
Erreur de norme de gradient : la pente a-t-elle la bonne longueur ?
Cette métrique moyenne l’écart absolu |‖∇f‖₂−1|. Elle n’est pas la pénalité d’entraînement, qui moyenne les écarts au carré.
Reprenons les normes pédagogiques 0,8, 1,0 et 1,2. L’erreur absolue moyenne vaut (0,2 + 0 + 0,2) / 3 ≈ 0,133333, alors que la pénalité au carré vaut environ 0,026667. Les deux nombres décrivent les mêmes trois normes selon des conventions différentes ; ils ne sont pas interchangeables.
Cette métrique ne vérifie pas directement l’orientation du gradient ni l’emplacement de la surface. Les fonctions planes de notre exemple avaient toutes une norme correcte, malgré des surfaces déplacées ou des signes inversés.
Mesures du maillage : que vaut l’objet finalement extrait ?
Un sommet est un point du maillage ; une face est ici un triangle reliant trois sommets. Leurs nombres décrivent la sortie de l’extraction. Davantage de triangles ne signifie pas automatiquement davantage de précision.
L’écart analytique moyen des sommets mesure leur distance à la vraie surface du tore : pour chaque sommet extrait, on calcule la valeur absolue de la SDF analytique, puis on moyenne.
Il faut regarder ces nombres en plus de la MAE du champ : les sommets du maillage ne sont pas la même population que les points de test. Cette moyenne de distances des sommets à la surface ne certifie pas non plus à elle seule que toute la forme a été couverte, que tous les triangles sont utilisables ou que la structure géométrique est correcte.
Résultats observés
Les nombres suivants sont ceux de la reproduction r1 du tutoriel. Les calculs pédagogiques précédents n’entrent pas dans ces mesures.
Comparer les deux champs sur le test
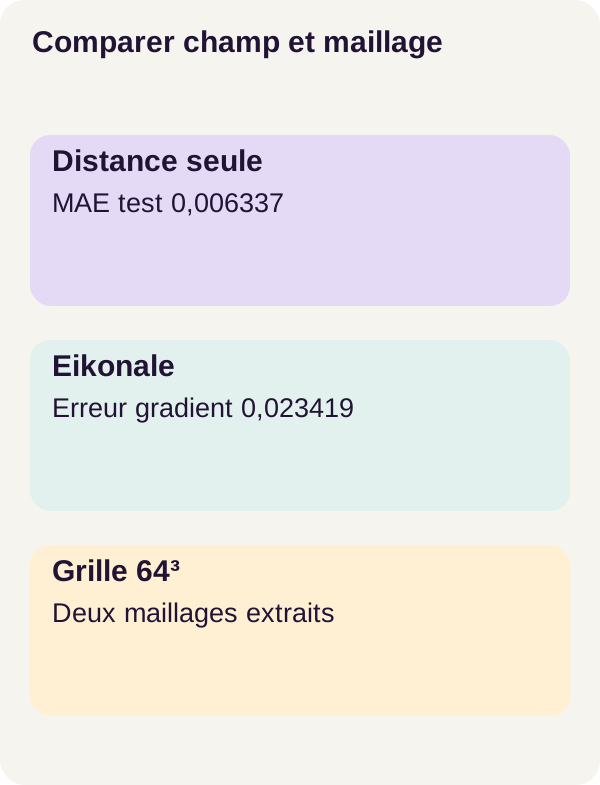
Le jeu de test contient 32 768 points. La mesure près de la surface porte sur 13 832 points. Pour les trois métriques ci-dessous, une valeur plus basse est préférable.
| Mesure sur le test | Distance seule | Distance + pénalité eikonale |
|---|---|---|
| MAE globale de distance | 0,006337 |
0,008552 |
| MAE près de la surface | 0,004770 |
0,004700 |
| Erreur absolue moyenne de norme de gradient | 0,024407 |
0,023419 |
La variante eikonale améliore légèrement la MAE près de la surface et l’erreur de norme du gradient. En revanche, sa MAE globale est plus haute. La contrainte supplémentaire n’améliore donc pas tous les indicateurs en même temps.
On peut rendre les écarts plus concrets par une simple soustraction des valeurs publiées : la MAE globale augmente de 0,002215, la MAE près de la surface diminue de 0,000070, et l’erreur de norme diminue de 0,000988. Ce sont des différences calculées à partir des arrondis affichés, pas de nouvelles campagnes de mesure.
Le tableau ne donne pas de dispersion sur plusieurs initialisations indépendantes. Il permet de décrire ce compromis observé, pas d’affirmer qu’un écart aussi petit se reproduira systématiquement.
Comparer les maillages extraits
La même résolution 64³ a permis d’extraire les deux maillages.
| Mesure d’extraction | Distance seule | Distance + pénalité eikonale |
|---|---|---|
| Sommets | 5 448 | 5 864 |
| Faces | 10 896 | 11 728 |
| Écart analytique moyen des sommets | 0,005149 |
0,005189 |
La variante eikonale produit davantage de sommets et de faces, mais son écart analytique moyen des sommets est légèrement plus élevé. Un maillage plus fourni n’est donc pas ici un maillage plus proche de la surface selon cette mesure.
Le léger gain de MAE près de la surface ne doit pas être présenté comme un gain démontré sur le maillage. Le premier score porte sur des points de test sélectionnés ; le second sur les sommets issus de l’extraction. Ce ne sont ni la même population ni le même calcul.
La reprise après interruption a retrouvé les paramètres avec une erreur maximale nulle, ainsi que l’optimiseur, le générateur et l’initialisation partagée. Ce résultat valide la reprise dans le parcours testé ; il ne constitue pas une mesure supplémentaire de qualité géométrique.
Ce que nous avons appris
Nous avons appris à représenter une forme par une fonction de coordonnées, puis à revenir à des triangles. Le réseau ne reçoit pas un ordre vague comme « dessine un tore » : il apprend des couples point–distance dont la réponse est contrôlable.
La pénalité eikonale ajoute une préférence sur la variation spatiale de cette fonction. Pour qu’elle influence les poids, le calcul doit conserver la possibilité de dériver le gradient spatial. C’est précisément ce que le test affine rend visible.
Une contrainte utile ne garantit pas que tous les scores progressent. Dans cette expérience, la variante régularisée améliore légèrement deux indicateurs du champ, tandis que la distance seule garde la meilleure MAE globale et le plus faible écart moyen des sommets extraits.
Enfin, trois objets doivent rester distincts : la forme analytique qui sert de référence, le champ neuronal qui l’approxime et le maillage échantillonné depuis ce champ. La grille peut masquer ou introduire des artefacts sans changement des poids. Un résultat sur ce tore ne valide donc pas une reconstruction de scan réel.
Exercice : hypothèse avant commande
Avant de lancer la commande, revenez à la fonction du contrôle : f(x,y,z)=2x. Prédisez ce qui arrive lorsque create_graph=True devient False.
Écrivez séparément vos réponses : la distance reste-t-elle calculable ? Le gradient spatial peut-il encore valoir [2,0,0] ? La pénalité peut-elle encore afficher 1 ? Et PyTorch dispose-t-il toujours du chemin nécessaire pour dériver cette pénalité par rapport aux poids ?
Lancez ensuite le contrôle négatif prévu par le projet :
docker compose run --rm gpu python -m neural_sdf.cli exercise --config configs/exercise.yaml
Lisez le statut du contrôle et confrontez-le à votre prédiction. Le point à comprendre est qu’une valeur de pénalité peut rester calculable alors que sa dépendance différentiable aux poids n’est plus disponible. Une erreur attendue du contrôle est alors une information utile, pas une raison de masquer le problème pour continuer.
« Gradient indisponible » ne veut pas dire « gradient mathématique égal à zéro ». Dans notre cas affine, nous savons calculer sa valeur à la main : elle n’est pas nulle. C’est le chemin de calcul nécessaire à PyTorch qui manque.
Conservez le parcours de référence. Le cas affine fournit une prédiction à vérifier : observez le statut réellement renvoyé par votre commande, plutôt que d’attendre une phrase de sortie particulière. Les valeurs calculées à la main expliquent le mécanisme ; elles ne remplacent pas cette observation.
Adapter et produire
Changer une hypothèse dans une expérience séparée
Une prolongation pédagogique consiste à faire varier la pondération eikonale dans une copie du projet, en gardant les données, l’initialisation et la grille comparables. Avant la mesure, notez quels indicateurs vous pensez voir évoluer, puis réexécutez le parcours adapté.
Cette proposition n’a pas de résultat préannoncé. Changer λ crée une autre expérience ; ses scores ne doivent pas remplacer silencieusement ceux de r1. L’archive reste la référence pour les paramètres et les commandes du parcours présenté.
Pourquoi un scan réel change le problème
Ici, nous connaissons la distance signée de n’importe quel point grâce à une formule. Un ensemble de points provenant d’un scan n’apporte pas automatiquement cette même information partout dans l’espace. L’acquisition, les unités, les repères, le bruit, les trous et la manière d’établir intérieur et extérieur deviennent des sujets à traiter explicitement.
Avant une application réelle, il faudrait aussi préciser les droits sur les données, les critères d’acceptation et l’usage du maillage : visualisation, traitement ultérieur ou autre besoin. Les seuils de rejet doivent dépendre de cet usage, pas seulement d’une impression visuelle favorable.
L’exploitation demande enfin une gestion des accès aux artefacts, des sauvegardes, un suivi des erreurs et de la dérive, ainsi que des mesures de charge. Le code fourni n’apporte ni pipeline de scan, ni validation clinique ou industrielle, ni service exposé.
Dépannage et nettoyage
Si CUDA échoue, vérifiez le pilote, la carte sélectionnée et l’intégration Docker en suivant le guide du NVIDIA Container Toolkit. Relancez ensuite le contrôle d’environnement avant de modifier le réseau.
Si une erreur de gradient apparaît, distinguez une valeur numérique incorrecte d’un chemin de dérivation absent. Vérifiez requires_grad, create_graph et l’absence d’une désactivation des gradients autour du calcul concerné. Prédire des distances sans calculer leurs dérivées et évaluer une pénalité de gradient ne demandent pas les mêmes conditions d’exécution. Ne retirez pas l’assertion du contrôle affine pour obtenir un succès apparent.
Si aucun niveau zéro n’est présent dans la grille, examinez les valeurs du champ, le domaine interrogé et le modèle chargé avant de conclure à un échec de l’apprentissage. Une extraction ne peut pas révéler un passage par zéro que les valeurs échantillonnées ne permettent pas de retrouver. Ne remplacez pas automatiquement le niveau zéro par un autre seuil : vous changeriez la surface recherchée.
Après l’exercice, générez les figures, vérifiez les checkpoints, prévisualisez le nettoyage, puis arrêtez les services :
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
--dry-run signifie que le nettoyage est une prévisualisation : il conserve les fichiers locaux. Examinez ce qui est annoncé avant toute suppression ultérieure. La dernière commande arrête les ressources Compose du projet et ses conteneurs orphelins ; ce n’est pas une purge globale de Docker.
Gardez les sorties nécessaires à vos comparaisons, surtout avant de lancer une variante de l’expérience.
Sources primaires et documentation
Les références ci-dessous approfondissent les concepts. Elles ne remplacent pas les versions et paramètres contenus dans l’archive pour reproduire les résultats r1.
Park et al. — DeepSDF présente la représentation continue par distances signées. Gropp et al. — Implicit Geometric Regularization étudie la régularisation géométrique par une propriété de gradient. Leurs expériences sont distinctes de celle du tore analytique présentée ici.
La documentation PyTorch — automatic differentiation, la référence torch.autograd.grad et le tutoriel Double Backward with Custom Functions expliquent les dérivées et les graphes nécessaires à leur propagation. Les pages sur detach() et le broadcasting complètent la lecture du code.
La référence NumPy — Generator.normal décrit le tirage du bruit gaussien utilisé pour déplacer les points.
La référence scikit-image — marching cubes détaille l’extraction d’une isosurface depuis un volume échantillonné. Le guide d’installation NVIDIA Container Toolkit concerne l’accès au GPU depuis les conteneurs.