





Immaginate un piccolo strumento 3D in un'applicazione web. Spostate un punto attorno a un salvagente e volete sapere: si trova nella materia, nel foro centrale oppure all'esterno? A quale distanza si trova la superficie più vicina?
Un modo per rappresentare l'oggetto consiste nel conservare i suoi vertici e i triangoli che li collegano: questa è una mesh. Esploreremo un'altra rappresentazione. Invece di chiedere alla rete di produrre direttamente triangoli, le insegniamo una funzione: datele tre coordinate e restituisce una distanza con segno.
Il segno indica da quale lato della superficie si trova il punto. Il valore assoluto indica la distanza da quella superficie. A partire da questa funzione possiamo osservare sezioni dell'oggetto, quindi estrarne una mesh.
La domanda del tutorial è precisa: imparare le distanze corrette è sufficiente, oppure una regola aggiuntiva sul modo in cui variano nello spazio migliora il risultato? Confronteremo i due approcci su una forma dalla geometria nota. Potremo così verificare le risposte, non limitarci a guardare se l'oggetto assomiglia a un salvagente.
Scaricare l'archivio del tutorial.
Cosa costruiamo
La nostra forma obiettivo è un toro: immaginate un tubo circolare richiuso su se stesso, come un salvagente. Il suo raggio maggiore è R=0,55: va dal centro dell'oggetto al centro del tubo. Il suo raggio minore è r=0,18: misura lo spessore del tubo dal suo centro fino alla superficie.
Le coordinate sono quelle dell'esperimento, senza un'unità fisica imposta. Una distanza di 0,01 non significa quindi automaticamente un centimetro o un millimetro.
Addestriamo un MLP, per multilayer perceptron, cioè una rete di livelli interamente connessi. Il suo contratto assomiglia a quello di una funzione della vostra applicazione: ingresso (x, y, z), uscita numerica. Questa uscita, uno scalare, deve essere negativa nella materia, positiva all'esterno e nulla sulla superficie.
Due modelli partono esattamente dalla stessa inizializzazione e vedono gli stessi lotti di punti. Il primo impara soltanto a ritrovare le distanze di riferimento. Il secondo riceve gli stessi esempi, ma aggiunge una penalità eikonale, pesata da λ=0,1. Dedicheremo tempo a spiegare questo termine: non richiede una seconda forma, bensì un comportamento particolare della funzione tra i punti.
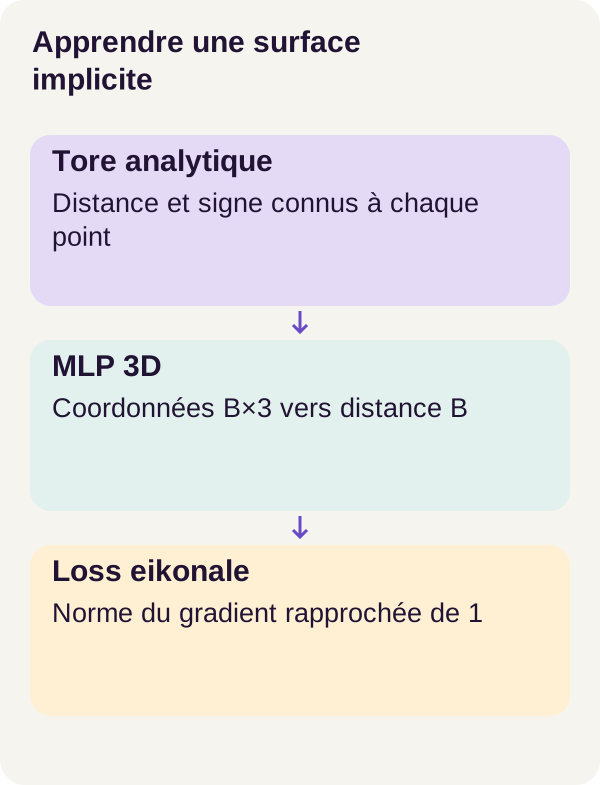
Al termine, il percorso fornisce due campi appresi, le loro misure e le mesh estratte. Verifica inoltre che un addestramento interrotto possa riprendere correttamente. Non costruisce un'interfaccia web, non legge una scansione e non ricostruisce un oggetto reale a partire da fotografie.
Perché addestrare una rete se conosciamo già la formula del toro? Per questo oggetto specifico, la formula è un'eccellente soluzione diretta. Qui svolge il ruolo di riferimento affidabile: permette di apprendere il meccanismo neurale, rilevarne gli errori e capire cosa cambia la penalità. Il tutorial non cerca di dimostrare che l'IA sostituisca vantaggiosamente questa formula.
Concetti utili
Un campo: un valore per ogni posizione
Un campo associa un valore a una posizione. Pensate a una funzione che indicasse la temperatura in punti diversi di una stanza. Qui il valore non è una temperatura, ma una distanza con segno dalla superficie del toro.
Una SDF, per signed distance function, usa la seguente convenzione: un valore di −0,05 significa «nella materia, a 0,05 unità dalla superficie»; +0,05 significa «fuori dalla materia, alla stessa distanza»; 0 indica la superficie stessa.
Attenzione al foro del salvagente: il centro dell'oggetto non è necessariamente all'interno della sua materia. Nel nostro toro, l'origine (0, 0, 0) è nel foro. La sua distanza con segno è positiva.
Ecco alcuni valori calcolati direttamente con la formula del toro, e non previsti dalla rete. Nelle coordinate tra parentesi, il punto funge da separatore decimale per non confondere i numeri con gli assi.
Punto (x, y, z) |
Distanza con segno analitica | Interpretazione |
|---|---|---|
(0.55, 0, 0) |
−0,18 |
Centro del tubo: nella materia. |
(0.73, 0, 0) |
0 |
Superficie esterna, poiché 0,55 + 0,18 = 0,73. |
(0.37, 0, 0) |
0 |
Superficie interna, rivolta verso il foro. |
(0, 0, 0) |
+0,37 |
Centro del foro: fuori dalla materia. |
(0.78, 0, 0) |
+0,05 |
A 0,05 unità oltre la superficie esterna. |
(0.55, 0, 0.18) |
0 |
Parte superiore del tubo. |
Questi valori sono calcoli geometrici. Con numeri in virgola mobile, uno zero teorico può apparire come un numero piccolissimo vicino a zero.
Una funzione appresa invece di un elenco di triangoli
In uno strato interamente connesso, ogni unità riceve tutti i valori dello strato precedente e li combina con coefficienti regolabili. Le trasformazioni non lineari permettono all'insieme di rappresentare qualcosa di diverso da un semplice piano; la rete esatta è fornita nel progetto.
I pesi sono i numeri regolabili della rete. Durante l'addestramento cambiano per avvicinare le distanze previste a quelle note. Una volta addestrato, il modello usa questi pesi per rispondere a nuove coordinate: è l'inferenza.
Indichiamo questa funzione con fθ(x, y, z), dove θ rappresenta l'insieme dei parametri appresi. Definisce una rappresentazione implicita: la superficie non è un elenco memorizzato direttamente, ma è definita dalla condizione fθ(x, y, z) = 0.
Un'isosuperficie riunisce i punti ai quali una funzione assegna lo stesso valore. Il livello zero ci interessa per ritrovare il confine dell'oggetto. Allo stesso modo, fissare z=0 permette di studiare una sezione del campo in un piano.
DeepSDF presenta il principio di una rappresentazione continua mediante distanze con segno. Il nostro esperimento resta molto più mirato: un solo toro e distanze analitiche, non una riproduzione dell'intero metodo di questo articolo di ricerca.
La rete può essere interrogata con coordinate che non figurano nel suo set di addestramento. Ciò non significa che sia esatta ovunque: dovremo misurarne gli errori e non presupporne l'affidabilità fuori dal dominio studiato.
Il gradiente spaziale: in quale direzione cambia il valore?
Spostiamo leggermente il nostro punto. Se la distanza prevista cambia molto, la funzione ha una pendenza elevata in quella direzione. Se cambia poco, la pendenza è debole.
Il gradiente spaziale, indicato con ∇xfθ, riunisce le tre derivate rispetto alle coordinate. Qui la x della notazione indica il punto completo, non soltanto il suo primo asse. Si ottiene un vettore di tre numeri: variazioni secondo x, y e z.
La sua norma L2 è la sua lunghezza: per un gradiente [a, b, c], vale √(a² + b² + c²). Per esempio, [1, 0, 0] ha norma 1; [2, 0, 0], norma 2.
Per una vera distanza con segno, questa norma vale 1 nei punti in cui la funzione è differenziabile. L'idea intuitiva è la seguente: vicino a una superficie regolare, avanzare di una piccola distanza nella direzione perpendicolare fa variare la distanza con segno della stessa quantità. Non vale per uno spostamento qualsiasi: scivolare lungo la superficie non produce la stessa variazione.
Alcune posizioni particolari non hanno una direzione unica verso la superficie più vicina. La proprietà non va quindi letta come un requisito di perfetta differenziabilità in ogni punto dello spazio.
La penalità eikonale: una preferenza, non una garanzia
La penalità incoraggia la rete ad avere una norma del gradiente prossima a 1 nei punti campionati. È una regolarizzazione: non indichiamo soltanto quali risposte imparare, ma anche una proprietà desiderata della funzione.
La formula del tutorial è:
Perdita totale = MAE di distanza + λ × media((‖∇xfθ(x)‖₂ − 1)²).
La perdita è il numero che l'addestramento cerca di ridurre. La MAE, per mean absolute error, è la media degli scarti assoluti dalle distanze di riferimento. La seconda parte penalizza le norme troppo lontane da 1. Con λ=0,1, questo secondo valore viene moltiplicato per 0,1 prima dell'addizione; ciò non significa che rappresenti esattamente il 10% della perdita totale.
Perché conservare le distanze di riferimento? Prendiamo due funzioni molto semplici: f(x,y,z)=x e g(x,y,z)=x−0,3. Hanno entrambe un gradiente di norma 1, ma la loro superficie zero si trova rispettivamente in x=0 e in x=0,3. La funzione h(x,y,z)=−x conserva lo stesso piano di f, invertendo però interno ed esterno.
La norma del gradiente non basta dunque né a collocare la superficie corretta né a sceglierne il segno. Nel nostro esperimento, le distanze supervisionate forniscono queste informazioni. Il lavoro Implicit Geometric Regularization permette di approfondire il ruolo di un vincolo sul gradiente; il suo protocollo di ricostruzione non è quello del nostro toro analitico.
Resta una difficoltà di programmazione: affinché questa penalità modifichi i pesi, PyTorch deve poter derivare un calcolo che contiene già un gradiente. È il ruolo di create_graph=True, che seguiremo nel codice.
Prerequisiti Docker e GPU
Dovete saper leggere funzioni Python, manipolare array e lanciare comandi in un terminale. I concetti di geometria neurale sono introdotti qui; non è richiesta alcuna esperienza precedente con le SDF.
Il percorso previsto usa Linux x86_64, Docker Compose, NVIDIA Container Toolkit, una RTX 3090 da 24 GiB, 16 GiB di RAM e 16 GiB di disco, esclusi gli strati Docker condivisi. La VRAM è la memoria della scheda grafica; è distinta dalla RAM della macchina. Mantenete queste condizioni per seguire il percorso presentato, invece di interpretare le spiegazioni come la convalida di un'altra configurazione.
Per scegliere la scheda, esportate GPU_DEVICE=0 o il suo UUID prima della sequenza. L'UUID è il suo identificatore; permette di indicare una scheda precisa. Il controllo dell'ambiente inizializza CUDA, l'ambiente di calcolo NVIDIA usato qui, e avvia un calcolo nel contenitore.
Vedere la scheda da Linux non basta a stabilire che Docker possa usarla. La guida ufficiale NVIDIA Container Toolkit documenta questa integrazione con il driver dell'host.
I calcoli GPU sono senza rete. I contenitori applicano un file system in sola lettura, no-new-privileges, la rimozione delle capacità Linux e limiti per CPU, RAM e PID. Queste impostazioni delimitano diritti e risorse dei processi; non sostituiscono i test del modello.
Un checkpoint è un salvataggio di stato usato per ritrovare il modello o riprenderne l'addestramento. Quelli del percorso sono prodotti localmente: non caricateli da una fonte arbitraria. La loro affidabilità dipende anche dalla provenienza.
Dati: una verità geometrica controllabile
Tre set di punti, tre responsabilità
Un'annotazione, o label, è qui una distanza con segno calcolata con la formula esatta. Non è né una categoria scelta da una persona né una risposta fornita da un altro modello.
Il programma prepara tre insiemi con semi distinti. Un seme inizializza il generatore pseudo-casuale: permette di ritrovare le stesse estrazioni nell'ambiente del progetto.
| Insieme | Numero di punti | Ruolo |
|---|---|---|
Addestramento, o train |
65 536 | Fornire gli esempi che servono a regolare i pesi. |
| Validazione | 16 384 | Osservare gli errori su un insieme separato dall'apprendimento. |
| Test | 32 768 | Misurare i risultati presentati più avanti. |
Ogni insieme contiene per metà punti uniformi nel cubo [-1,1]³, per metà punti costruiti vicino alla superficie. I primi esplorano il volume; i secondi concentrano parte dell'apprendimento vicino al confine che ci interessa.
Una griglia 64³ è riservata all'estrazione. Rappresenta 64 × 64 × 64 = 262 144 posizioni di valutazione, e non 262 144 esempi di addestramento aggiuntivi. Non viene mai usata per addestrare la rete.
Leggere le due funzioni senza confonderle
Nell'estratto, np indica NumPy; R e r sono i due raggi definiti sopra. Il progetto completo fornisce gli import e le costanti.
generate_points() crea coordinate. torus_sdf() calcola poi la distanza di riferimento delle coordinate che riceve. La prima funzione non restituisce direttamente le label e nessuna delle due salva i file: la concatenazione e il salvataggio appartengono alla fase di preparazione del progetto.
def torus_sdf(points):
    return (
        np.sqrt(
            (np.sqrt(points[..., 0] ** 2 + points[..., 1] ** 2) - R) ** 2
            + points[..., 2] ** 2
        )
        - r
    )


def generate_points(n, seed, std=0.04):
    rng = np.random.default_rng(seed)
    uniform = rng.uniform(-1, 1, (n // 2, 3))
    u = rng.uniform(0, 2 * np.pi, n // 2)
    v = rng.uniform(0, 2 * np.pi, n // 2)
    surface = np.stack(
        [
            (R + r * np.cos(v)) * np.cos(u),
            (R + r * np.cos(v)) * np.sin(u),
            r * np.sin(v),
        ],
        -1,
    )
    near = np.clip(surface + rng.normal(0, std, surface.shape), -1, 1)
    return np.concatenate([uniform, near]).astype("float32")
Come la formula ritrova una distanza?
L'espressione points[..., 0] seleziona le coordinate x; gli indici 1 e 2 selezionano y e z. I puntini di sospensione conservano le dimensioni precedenti, consentendo di eseguire il calcolo su un array di punti.
Il calcolo si legge in tre fasi. √(x²+y²) dà dapprima la distanza dall'asse verticale del toro. Sottrarre R ricentra poi questa distanza sul cerchio che passa per il centro del tubo. Infine, √((√(x²+y²)−R)²+z²)−r misura lo scarto dalla superficie del tubo.
Prendiamo il punto (0.78, 0, 0). La sua distanza dall'asse è 0,78. Togliamo 0,55, otteniamo 0,23, poi togliamo il raggio del tubo 0,18. Risultato: 0,05, positivo. Siamo effettivamente all'esterno.
Nel punto (0.55, 0, 0), lo stesso calcolo dà 0−0,18=−0,18. Nel foro, all'origine, dà 0,55−0,18=0,37. La stessa formula spiega quindi le tre situazioni, senza una regola separata per il foro.
Perché aggiungere rumore alle coordinate?
uniform contiene n // 2 punti distribuiti nel cubo. Gli angoli u e v costruiscono poi altrettante posizioni sulla superficie del toro: u percorre il salvagente, v percorre il suo tubo. np.stack(..., -1) riunisce le tre coordinate sull'ultimo asse.
Il programma aggiunge a queste posizioni un rumore gaussiano, cioè spostamenti casuali centrati su zero. Il parametro std=0.04 è la loro deviazione standard per coordinata, non una distanza massima autorizzata dalla superficie; la documentazione NumPy di Generator.normal precisa questa convenzione. np.clip riporta le coordinate nell'intervallo [-1,1]. Infine, i due gruppi sono riuniti e convertiti in float32, numeri in virgola mobile memorizzati su 32 bit.
Una sfumatura utile: gli angoli sono estratti uniformemente, ma questo non corrisponde a un campionamento uniforme per area su tutta la superficie del toro. Il protocollo usa questo generatore preciso; non gli attribuiamo un'altra distribuzione.
Il rumore sposta i punti, non le loro risposte di riferimento. Una volta ottenute le coordinate, la loro distanza viene ricalcolata con la formula analitica. Non simuliamo quindi qui annotazioni di distanza rumorose come quelle che potrebbe produrre un sensore.
La preparazione salva i set e controlla che i punti siano distinti tra le partizioni. I tre insiemi riguardano tuttavia lo stesso toro e lo stesso meccanismo di generazione: un buon risultato di test non misura la capacità di apprendere tutte le forme 3D.
Installare e verificare l'ambiente
Estraete l'archivio e portate il terminale alla sua radice. Tutti i comandi seguenti partono da questa stessa directory. Gli estratti Python spiegano il meccanismo; lo ZIP fornisce il progetto che li contiene.
Iniziate preparando e controllando l'ambiente:
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prepara il progetto. docker compose config --quiet verifica la configurazione Compose; build costruisce le immagini usate dai servizi acquire e gpu.
Il nome acquire può ricordare tutorial che scaricano un modello preaddestrato. Qui convalida un manifesto senza pesi da scaricare: impareremo il campo da punti generati localmente. Ciò non significa che costruire immagini Docker non richieda mai la rete.
Il controllo dell'ambiente deve riuscire prima dell'addestramento. Il comando pytest esegue poi i test forniti. Un successo in questa fase controlla programma e ambiente; non dimostra ancora che la rete appresa rappresenti correttamente il toro.
Preparate ora i dati, ispezionate il contratto della rete, quindi verificate la perdita:
docker compose run --rm gpu python -m neural_sdf.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli inspect-model --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli check-loss --config configs/minimum.yaml
La notazione B×3 → B significa: per un lotto di B punti con tre coordinate, ottenere una distanza per punto. Per esempio, dieci punti entrano come array 10×3; devono uscirne dieci distanze.
In PyTorch, questi array sono tensori: numeri organizzati secondo dimensioni, che il programma può elaborare sulla GPU. Una perdita scalare è un tensore con un solo valore.
Questo controllo delle dimensioni non è decorativo. Con prediction e labels di forma B, la sottrazione confronta ogni previsione con la sua label. Un array B×1 sottratto a un array B può essere esteso automaticamente in B×B: il programma confronterebbe tutte le coppie anziché le sole coppie corrispondenti. È un effetto del broadcasting di PyTorch, non una misura corretta delle nostre distanze.
check-loss verifica un altro contratto: la penalità deve avere effettivamente un gradiente verso i pesi. Vediamo come è costruito questo controllo.
Il codice centrale: rendere addestrabile la penalità eikonale
Due gradienti, due domande
Nello sviluppo web, uno stesso dato può passare attraverso più funzioni prima di essere salvato. Qui dobbiamo seguire anch'noi una catena, ma una catena di calcoli differenziabili.
Il gradiente spaziale risponde a «come cambia la distanza se sposto il punto?». Il gradiente della perdita rispetto ai parametri risponde a «come varia la perdita se cambio i pesi?». L'ottimizzatore usa il secondo per regolare la rete.
La penalità collega i due: dipende dal gradiente spaziale, che dipende a sua volta dai pesi. Per apprendere questa proprietà, occorre conservare questa dipendenza durante il calcolo.
Il grafo di calcolo è la traccia delle operazioni e delle loro dipendenze: quale risultato proviene da quali numeri, moltiplicazioni o altre trasformazioni? PyTorch lo usa per propagare le derivate. Non è un grafico mostrato sullo schermo.
def sdf_eikonal_loss(model, points, labels, weight=0.1, create_graph=True):
    points = points.detach().requires_grad_(True)
    prediction = model(points)
    gradient = torch.autograd.grad(prediction.sum(), points, create_graph=create_graph)[
        0
    ]
    distance = (prediction - labels).abs().mean()
    eikonal = (gradient.norm(dim=-1) - 1).square().mean()
    return distance + weight * eikonal, distance, eikonal


def check_loss(config):
    model = torch.nn.Linear(3, 1, bias=False).cuda()
    with torch.no_grad():
        model.weight.copy_(torch.tensor([[2.0, 0, 0]], device="cuda"))
    x = torch.randn(10, 3, device="cuda", requires_grad=True)
    gradient = torch.autograd.grad(model(x).sum(), x, create_graph=True)[0]
    penalty = (gradient.norm(dim=-1) - 1).square().mean()
    weight_gradient = torch.autograd.grad(penalty, model.weight)[0]
    assert torch.allclose(weight_gradient, torch.tensor([[2.0, 0, 0]], device="cuda"))
    return {
        "affine_gradient": [2.0, 0, 0],
        "penalty": float(penalty),
        "weight_gradient": weight_gradient.tolist(),
    }
Seguire sdf_eikonal_loss()
Preparare le coordinate. points.detach() interrompe la loro eventuale cronologia di calcolo; requires_grad_(True) chiede poi di seguire le variazioni dell'uscita rispetto a queste coordinate. Ciò non blocca i pesi del modello né sposta i punti. Prepara gli ingressi al calcolo delle derivate. La documentazione di detach() precisa questa rottura con il grafo precedente.
Prevedere le distanze. model(points) applica la rete alle coordinate. Con il contratto B×3 → B, prediction e labels hanno un valore per punto.
Calcolare la pendenza nello spazio. torch.autograd.grad() riceve la somma delle previsioni e le coordinate. Per questa rete, che tratta ogni punto indipendentemente dagli altri punti del lotto, derivare la somma permette di ritrovare il gradiente di ogni previsione rispetto al proprio punto. Il risultato ha forma B×3.
Il [0] alla fine della chiamata seleziona il primo elemento della tupla restituita da PyTorch, quello che corrisponde a points. Non seleziona soltanto il primo punto del lotto. La documentazione di torch.autograd.grad descrive questo calcolo e i suoi parametri.
Calcolare i due errori. (prediction - labels).abs().mean() dà la MAE di distanza. gradient.norm(dim=-1) calcola una norma per punto riunendo le sue tre derivate. Si sottrae 1, si eleva lo scarto al quadrato, poi se ne fa la media: è la penalità eikonale.
Restituire il totale e le sue componenti. La funzione restituisce tre numeri tensoriali: la perdita totale, la MAE e la penalità non pesata. Mantenerli separati permette di vedere quale componente migliora o peggiora.
La funzione non aggiorna da sola i pesi. La successiva chiamata a loss.backward() ne calcola i gradienti; l'ottimizzatore esegue poi l'aggiornamento. Non bisogna confondere calcolare una perdita, calcolarne il gradiente e applicare una modifica ai parametri.
Un calcolo della perdita ripetibile a mano
Ecco tre previsioni fittizie, scelte per spiegare la formula. Non provengono dal modello addestrato né dai file dei risultati.
| Punto | Distanza di riferimento | Previsione fittizia | Scarto assoluto |
|---|---|---|---|
(0.55, 0, 0) |
−0,18 |
−0,16 |
0,02 |
(0.73, 0, 0) |
0 |
0,01 |
0,01 |
(0.78, 0, 0) |
0,05 |
0,02 |
0,03 |
La MAE vale (0,02 + 0,01 + 0,03) / 3 = 0,02.
Supponiamo ora che le norme dei gradienti previsti nei tre punti valgano rispettivamente 0,8, 1,0 e 1,2. La penalità vale ((0,8−1)² + (1−1)² + (1,2−1)²) / 3, cioè circa 0,026667.
Con λ=0,1, la perdita totale vale dunque 0,02 + 0,1 × 0,026667 ≈ 0,022667. Non aggiungiamo direttamente 0,026667: la pesatura conta.
Perché create_graph=True è indispensabile qui
PyTorch sa calcolare un gradiente numerico senza conservare tutte le dipendenze che permettono di derivarlo nuovamente. La penalità dipende proprio da un gradiente che vogliamo poi derivare rispetto ai pesi.
create_graph=True costruisce il grafo del calcolo della derivata. Il percorso resta quindi disponibile: pesi → distanze → gradienti spaziali → penalità. Con False, si può ancora ottenere un numero per la penalità, senza poter usare questo percorso per addestrare i pesi.
Il tutorial ufficiale Double Backward with Custom Functions approfondisce la differenza tra calcolare una derivata e poter derivarne il calcolo. Questo complemento spiega il meccanismo; non richiede di sostituire il codice del progetto con una funzione autograd personalizzata.
Leggere il test affine: perché si attende [2, 0, 0]?
check_loss() sceglie uno strato lineare con tre ingressi, un'uscita e nessun bias. Fissa i pesi a [2, 0, 0]. La funzione calcolata è quindi semplicemente f(x,y,z)=2x.
Qualunque sia il punto, il suo gradiente spaziale è [2, 0, 0]. La sua norma vale 2 e la penalità vale (2−1)²=1. I dieci punti casuali non complicano questa verifica: per questa funzione la pendenza è costante.
Ma il test va oltre: deriva la penalità rispetto ai pesi. Vicino al coefficiente positivo a=2, per f(x,y,z)=a×x, la penalità vale (a−1)². La derivata vale 2×(a−1), quindi 2 in a=2. Le altre due componenti valgono zero. Questo spiega l'asserzione su [[2.0, 0, 0]].
Il gradiente spaziale e il gradiente verso i pesi hanno qui gli stessi valori numerici, ma sono due oggetti diversi. Il primo descrive la variazione nello spazio; il secondo verifica che la regolarizzazione possa partecipare all'apprendimento.
Il controllo riguarda la sola penalità, senza la moltiplicazione per λ. Attende quindi 2 sul primo peso, non 0,2. Un'uscita numerica plausibile della perdita non basterebbe a sostituire questa asserzione.
Addestrare, riprendere, valutare ed estrarre
Possiamo ora seguire la sequenza completa. Il primo comando addestra la variante eikonale. Il secondo addestra la variante della sola distanza, che serve come confronto.
I comandi seguenti interrompono un addestramento dopo il passo 500, riprendono lo stato salvato, confrontano la ripresa con il percorso di riferimento, valutano i due campi, quindi ne estraggono le isosuperfici.
docker compose run --rm gpu python -m neural_sdf.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli train --config configs/minimum.yaml --variant distance
docker compose run --rm gpu python -m neural_sdf.cli train --config configs/minimum.yaml --stop-after 500 --run-name interrupted
docker compose run --rm gpu python -m neural_sdf.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m neural_sdf.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli evaluate --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli mesh --config configs/minimum.yaml
Un lotto, o batch, è un gruppo di punti elaborati insieme. Un'inizializzazione fissa i pesi prima del loro primo aggiornamento. Partire dagli stessi pesi e presentare gli stessi lotti alle due varianti riduce le differenze estranee al confronto: studiamo l'aggiunta della penalità, non due insiemi di esempi diversi.
La ripresa richiede più del solo peso finale di un livello. Lo stato dell'ottimizzatore e quello del generatore pseudo-casuale fanno parte del percorso controllato. È paragonabile alla ripresa di un'elaborazione applicativa: ritrovare l'ultimo risultato non basta se si è perso lo stato che determina l'operazione successiva.
I risultati pubblicati più avanti provengono dalla riproduzione, validata dal lettore, di questa sequenza. Il tutorial non fornisce qui una durata di addestramento di riferimento né un confronto di velocità tra le varianti: non deducete un risparmio di tempo dai soli punteggi di qualità.
Come passare da una funzione ai triangoli?
Il passaggio mesh valuta il campo sulla sua griglia indipendente 64³, quindi estrae il livello zero. Il principio dei marching cubes consiste nel percorrere le celle della griglia e costruire triangoli a partire dai valori che racchiudono il livello cercato. La documentazione di scikit-image descrive questa estrazione, i vertici e le facce restituiti.
Un'analogia in una dimensione permette di comprendere l'interpolazione. Su un segmento lungo 0,1, supponiamo che i valori alle estremità siano −0,02 e +0,03. Un'interpolazione lineare colloca lo zero a 0,02 / (0,02 + 0,03) = 0,4 del segmento, cioè a 0,04 dalla prima estremità. Questo esempio spiega il principio; non è una misura della mesh del tutorial.
La mesh è un'approssimazione discreta del campo appreso. La risoluzione della griglia influisce su ciò che può essere visibile o non rilevato. Aumentare questa risoluzione non riaddestra la rete e non corregge automaticamente le sue distanze.
Misure prima dei risultati
MAE globale: la rete restituisce le distanze corrette?
La MAE è la distanza media |previsione − riferimento| sui punti valutati. Un errore positivo e uno negativo non si annullano. Più questa media è bassa, più i valori previsti sono vicini alle distanze analitiche nella popolazione considerata.
Viene valutata su validazione e su test. Conserva l'unità delle coordinate dell'esperimento: non è né una percentuale né un tasso di punti classificati correttamente all'interno o all'esterno.
MAE vicino alla superficie: come si comporta il confine?
Il calcolo conserva solo i punti la cui distanza analitica soddisfa la soglia di prossimità dichiarata nel progetto. Le deviazioni vengono poi mediate su questa sottopopolazione.
La soglia numerica non è riprodotta in questo testo: consultate quella del percorso fornito anziché sceglierne una dopo aver letto i risultati. Soprattutto, la selezione si basa sulla distanza di riferimento, non sulla distanza stimata dal modello stesso. Una previsione errata non deve potersi escludere dalla propria valutazione.
Non confuse «metà dei punti generati vicino alla superficie» con «numero di punti trattenuti da questa soglia». Gli spostamenti gaussiani non costituiscono una fascia rigorosa; anche alcuni punti uniformi possono essere vicini alla superficie. Il numero pubblicato di 13 832 punti deriva dalla selezione di valutazione, non dalla semplice divisione di 32 768 per due.
Errore della norma del gradiente: la pendenza ha la lunghezza corretta?
Questa metrica calcola la media dello scarto assoluto |‖∇f‖₂−1|. Non è la penalità di addestramento, che calcola la media degli scarti al quadrato.
Riprendiamo le norme didattiche 0,8, 1,0 e 1,2. L'errore assoluto medio vale (0,2 + 0 + 0,2) / 3 ≈ 0,133333, mentre la penalità al quadrato vale circa 0,026667. I due numeri descrivono le stesse tre norme secondo convenzioni diverse; non sono intercambiabili.
Questa metrica non verifica direttamente né l'orientamento del gradiente né la posizione della superficie. Le funzioni piane del nostro esempio avevano tutte una norma corretta, pur con superfici spostate o segni invertiti.
Misure della mesh: quanto vale infine l'oggetto estratto?
Un vertice è un punto della mesh; una faccia è qui un triangolo che collega tre vertici. Il loro numero descrive l'output dell'estrazione. Più triangoli non significa automaticamente maggiore precisione.
Lo scarto analitico medio dei vertici misura la loro distanza dalla vera superficie del toro: per ciascun vertice estratto si calcola il valore assoluto della SDF analitica, poi se ne fa la media.
Questi numeri vanno osservati oltre alla MAE del campo: i vertici della mesh non appartengono alla stessa popolazione dei punti di test. Questa media delle distanze dei vertici dalla superficie non certifica neppure, da sola, che l'intera forma sia stata coperta, che tutti i triangoli siano utilizzabili o che la struttura geometrica sia corretta.
Risultati osservati
I numeri seguenti sono quelli della riproduzione r1 del tutorial. I calcoli didattici precedenti non entrano in queste misure.
Confrontare i due campi sul test
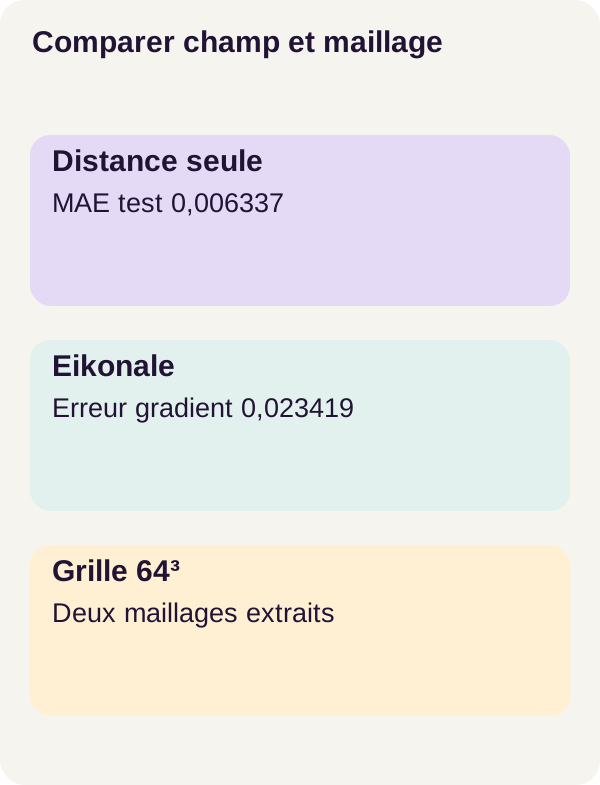
Il set di test contiene 32 768 punti. La misura vicino alla superficie riguarda 13 832 punti. Per le tre metriche seguenti, un valore più basso è preferibile.
| Misura sul test | Solo distanza | Distanza + penalità eikonale |
|---|---|---|
| MAE globale della distanza | 0,006337 |
0,008552 |
| MAE vicino alla superficie | 0,004770 |
0,004700 |
| Errore assoluto medio della norma del gradiente | 0,024407 |
0,023419 |
La variante eikonale migliora leggermente la MAE vicino alla superficie e l'errore della norma del gradiente. Tuttavia, la sua MAE globale è più alta. Il vincolo aggiuntivo non migliora quindi tutti gli indicatori contemporaneamente.
Possiamo rendere gli scarti più concreti con una semplice sottrazione dei valori pubblicati: la MAE globale aumenta di 0,002215, la MAE vicino alla superficie diminuisce di 0,000070 e l'errore della norma diminuisce di 0,000988. Sono differenze calcolate a partire dagli arrotondamenti visualizzati, non nuove campagne di misura.
La tabella non fornisce una dispersione su più inizializzazioni indipendenti. Permette di descrivere questo compromesso osservato, non di affermare che uno scarto così piccolo si riprodurrà sistematicamente.
Confrontare le mesh estratte
La stessa risoluzione 64³ ha permesso di estrarre entrambe le mesh.
| Misura di estrazione | Solo distanza | Distanza + penalità eikonale |
|---|---|---|
| Vertici | 5 448 | 5 864 |
| Facce | 10 896 | 11 728 |
| Scarto analitico medio dei vertici | 0,005149 |
0,005189 |
La variante eikonale produce più vertici e facce, ma il suo scarto analitico medio dei vertici è leggermente più elevato. Una mesh più ricca non è quindi, in questo caso, una mesh più vicina alla superficie secondo questa misura.
Il lieve miglioramento della MAE vicino alla superficie non deve essere presentato come un guadagno dimostrato sulla mesh. Il primo punteggio riguarda punti di test selezionati; il secondo i vertici derivati dall'estrazione. Non sono né la stessa popolazione né lo stesso calcolo.
La ripresa dopo l'interruzione ha ritrovato i parametri con un errore massimo nullo, nonché l'ottimizzatore, il generatore e l'inizializzazione condivisa. Questo risultato convalida la ripresa nel percorso testato; non costituisce una misura aggiuntiva della qualità geometrica.
Cosa abbiamo imparato
Abbiamo imparato a rappresentare una forma mediante una funzione di coordinate, quindi a tornare ai triangoli. La rete non riceve un ordine vago come «disegna un toro»: apprende coppie punto-distanza la cui risposta è controllabile.
La penalità eikonale aggiunge una preferenza sulla variazione spaziale di questa funzione. Per influire sui pesi, il calcolo deve conservare la possibilità di derivare il gradiente spaziale. È proprio ciò che rende visibile il test affine.
Un vincolo utile non garantisce che tutti i punteggi migliorino. In questo esperimento, la variante regolarizzata migliora leggermente due indicatori del campo, mentre la sola distanza conserva la migliore MAE globale e il più basso scarto medio dei vertici estratti.
Infine, tre oggetti devono restare distinti: la forma analitica che serve da riferimento, il campo neurale che la approssima e la mesh campionata da questo campo. La griglia può nascondere o introdurre artefatti senza cambiare i pesi. Un risultato su questo toro non convalida quindi una ricostruzione da scansione reale.
Esercizio: un'ipotesi prima del comando
Prima di lanciare il comando, tornate alla funzione del controllo: f(x,y,z)=2x. Prevedete cosa accade quando create_graph=True diventa False.
Scrivete separatamente le vostre risposte: la distanza resta calcolabile? Il gradiente spaziale può ancora valere [2,0,0]? La penalità può ancora visualizzare 1? E PyTorch dispone ancora del percorso necessario per derivare questa penalità rispetto ai pesi?
Avviate poi il controllo negativo previsto dal progetto:
docker compose run --rm gpu python -m neural_sdf.cli exercise --config configs/exercise.yaml
Leggete lo stato del controllo e confrontatelo con la vostra previsione. Il punto da comprendere è che un valore di penalità può restare calcolabile mentre la sua dipendenza differenziabile dai pesi non è più disponibile. Un errore atteso del controllo è allora un'informazione utile, non un motivo per nascondere il problema e proseguire.
«Gradiente non disponibile» non significa «gradiente matematico uguale a zero». Nel nostro caso affine, sappiamo calcolarne il valore a mano: non è nullo. Manca il percorso di calcolo necessario a PyTorch.
Conservate il percorso di riferimento. Il caso affine fornisce una previsione da verificare: osservate lo stato effettivamente restituito dal vostro comando, anziché attendere una frase di output particolare. I valori calcolati a mano spiegano il meccanismo; non sostituiscono questa osservazione.
Adattare e produrre
Modificare un'ipotesi in un esperimento separato
Un'estensione didattica consiste nel variare la ponderazione eikonale in una copia del progetto, mantenendo comparabili i dati, l'inizializzazione e la griglia. Prima della misura, annotate quali indicatori pensate di vedere evolvere, poi rieseguite il percorso adattato.
Questa proposta non ha un risultato preannunciato. Modificare λ crea un altro esperimento; i suoi punteggi non devono sostituire silenziosamente quelli di r1. L'archivio resta il riferimento per i parametri e i comandi del percorso presentato.
Perché una scansione reale cambia il problema
Qui conosciamo la distanza con segno di qualunque punto grazie a una formula. Un insieme di punti provenienti da una scansione non apporta automaticamente la stessa informazione ovunque nello spazio. Acquisizione, unità, riferimenti, rumore, lacune e modo di stabilire interno ed esterno diventano aspetti da trattare esplicitamente.
Prima di un'applicazione reale, occorrerebbe precisare anche i diritti sui dati, i criteri di accettazione e l'uso della mesh: visualizzazione, trattamento successivo o altra esigenza. Le soglie di rifiuto devono dipendere da questo uso, non solo da un'impressione visiva favorevole.
L'esercizio richiede infine una gestione degli accessi agli artefatti, dei backup, un monitoraggio degli errori e della deriva, nonché misure di carico. Il codice fornito non offre né pipeline di scansione, né convalida clinica o industriale, né servizio esposto.
Risoluzione dei problemi e pulizia
Se CUDA non funziona, verificate il driver, la scheda selezionata e l'integrazione Docker seguendo la guida di NVIDIA Container Toolkit. Rieseguite poi il controllo dell'ambiente prima di modificare la rete.
Se compare un errore di gradiente, distinguete un valore numerico scorretto da un percorso di derivazione assente. Verificate requires_grad, create_graph e l'assenza di una disattivazione dei gradienti attorno al calcolo interessato. Prevedere distanze senza calcolarne le derivate e valutare una penalità di gradiente non richiedono le stesse condizioni di esecuzione. Non rimuovete l'asserzione del controllo affine per ottenere un successo apparente.
Se nella griglia non è presente alcun livello zero, esaminate i valori del campo, il dominio interrogato e il modello caricato prima di concludere che l'apprendimento sia fallito. Un'estrazione non può rivelare un passaggio per zero che i valori campionati non permettono di trovare. Non sostituite automaticamente il livello zero con un'altra soglia: cambiereste la superficie cercata.
Dopo l'esercizio, generate le figure, verificate i checkpoint, visualizzate in anteprima la pulizia, poi arrestate i servizi:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
--dry-run significa che la pulizia è una visualizzazione in anteprima: conserva i file locali. Esaminate ciò che viene annunciato prima di qualsiasi eliminazione successiva. L'ultimo comando arresta le risorse Compose del progetto e i suoi contenitori orfani; non è una pulizia globale di Docker.
Conservate gli output necessari ai vostri confronti, soprattutto prima di lanciare una variante dell'esperimento.
Fonti primarie e documentazione
I riferimenti seguenti approfondiscono i concetti. Non sostituiscono le versioni e i parametri contenuti nell'archivio per riprodurre i risultati r1.
Park et al. — DeepSDF presenta la rappresentazione continua mediante distanze con segno. Gropp et al. — Implicit Geometric Regularization studia la regolarizzazione geometrica attraverso una proprietà del gradiente. I loro esperimenti sono distinti da quello del toro analitico presentato qui.
La documentazione PyTorch — automatic differentiation, il riferimento torch.autograd.grad e il tutorial Double Backward with Custom Functions spiegano le derivate e i grafi necessari alla loro propagazione. Le pagine su detach() e sul broadcasting completano la lettura del codice.
Il riferimento NumPy — Generator.normal descrive il campionamento del rumore gaussiano usato per spostare i punti.
Il riferimento scikit-image — marching cubes illustra l'estrazione di un'isosuperficie da un volume campionato. La guida di installazione NVIDIA Container Toolkit riguarda l'accesso alla GPU dai contenitori.