





Imagine una pequeña herramienta 3D en una aplicación web. Mueve un punto alrededor de una dona y quiere saber: ¿está dentro del material, en el agujero central o fuera? ¿A qué distancia está la superficie más cercana?
Una forma de representar el objeto consiste en conservar sus vértices y los triángulos que los unen: es una malla. Vamos a explorar otra representación. En lugar de pedir a la red que produzca directamente triángulos, le enseñamos una función: se le dan tres coordenadas y devuelve una distancia con signo.
El signo indica en qué lado de la superficie está el punto. El valor absoluto indica su distancia a esa superficie. A partir de esta función podemos observar secciones del objeto y después extraer una malla.
La pregunta del tutorial es concreta: ¿basta con aprender las distancias correctas o una regla adicional sobre cómo varían en el espacio mejora el resultado? Compararemos ambos enfoques con una forma cuya geometría conocemos. Así podremos comprobar las respuestas, no solo mirar si el objeto se parece a una dona.
Descargar el archivo del tutorial.
Lo que construimos
Nuestra forma objetivo es un toro: imagine un tubo circular cerrado sobre sí mismo, como una dona. Su radio mayor es R=0,55: va desde el centro del objeto hasta el centro del tubo. Su radio menor es r=0,18: mide el grosor del tubo desde su centro hasta la superficie.
Las coordenadas son las del experimento, sin una unidad física impuesta. Por tanto, una distancia de 0,01 no significa automáticamente un centímetro ni un milímetro.
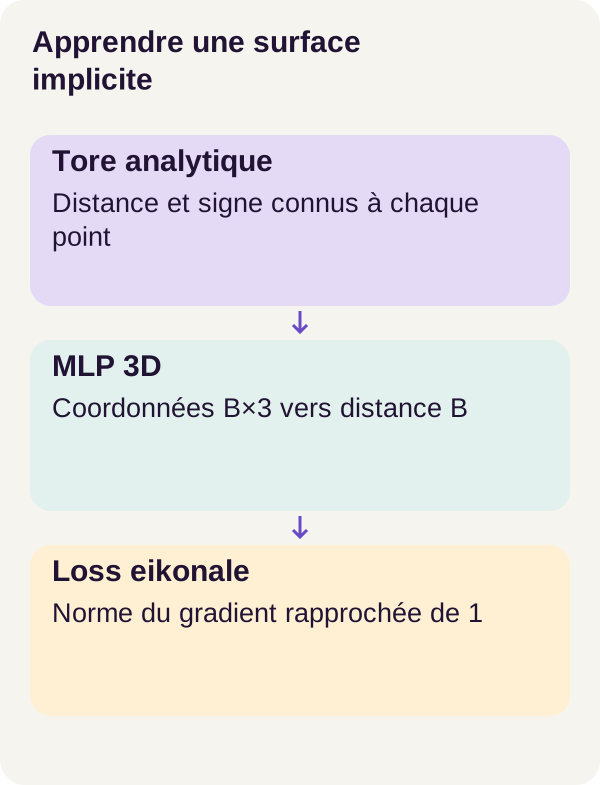
Entrenamos un MLP, de multilayer perceptron, es decir, una red de capas totalmente conectadas. Su contrato se parece al de una función de su aplicación: entrada (x, y, z), salida numérica. Esta salida, un escalar, debe ser negativa dentro del material, positiva fuera y nula en la superficie.
Dos modelos parten exactamente de la misma inicialización y ven los mismos lotes de puntos. El primero aprende únicamente a recuperar las distancias de referencia. El segundo recibe los mismos ejemplos, pero añade una penalización eikonal, ponderada por λ=0,1. Explicaremos este término: no pide una segunda forma, sino un comportamiento particular de la función entre los puntos.
Al final, el recorrido proporciona dos campos aprendidos, sus mediciones y sus mallas extraídas. También comprueba que un entrenamiento interrumpido puede reanudarse correctamente. No construye una interfaz web, no lee un escaneo ni reconstruye un objeto real a partir de fotografías.
¿Por qué entrenar una red si ya conocemos la fórmula del toro? Para este objeto concreto, la fórmula es una excelente solución directa. Aquí desempeña el papel de referencia fiable: permite aprender el mecanismo neuronal, detectar sus errores y comprender qué cambia la penalización. El tutorial no pretende demostrar que la IA sustituya ventajosamente esta fórmula.
Conceptos útiles
Un campo: un valor para cada posición
Un campo asocia un valor a una posición. Piense en una función que diera la temperatura en distintos lugares de una habitación. Aquí el valor no es una temperatura, sino una distancia con signo a la superficie del toro.
Una SDF, de signed distance function, usa la siguiente convención: un valor de −0,05 significa «dentro del material, a 0,05 unidades de la superficie»; +0,05 significa «fuera del material, a la misma distancia»; 0 designa la propia superficie.
Atención al agujero de la dona: el centro del objeto no está necesariamente dentro de su material. En nuestro toro, el origen (0, 0, 0) está en el agujero. Su distancia con signo es positiva.
Estos son algunos valores calculados directamente con la fórmula del toro, no predichos por la red. En las coordenadas entre paréntesis, el punto sirve de separador decimal para no confundir números y ejes.
Punto (x, y, z) |
Distancia con signo analítica | Interpretación |
|---|---|---|
(0.55, 0, 0) |
−0,18 |
Centro del tubo: dentro del material. |
(0.73, 0, 0) |
0 |
Superficie exterior, ya que 0,55 + 0,18 = 0,73. |
(0.37, 0, 0) |
0 |
Superficie interior, orientada hacia el agujero. |
(0, 0, 0) |
+0,37 |
Centro del agujero: fuera del material. |
(0.78, 0, 0) |
+0,05 |
A 0,05 unidades más allá de la superficie exterior. |
(0.55, 0, 0.18) |
0 |
Parte superior del tubo. |
Estos valores son cálculos geométricos. Con números de coma flotante, un cero teórico puede aparecer como un número muy pequeño próximo a cero.
Una función aprendida en lugar de una lista de triángulos
En una capa totalmente conectada, cada unidad recibe todos los valores de la capa anterior y los combina con coeficientes ajustables. Las transformaciones no lineales permiten al conjunto representar algo distinto de un simple plano; la red exacta se proporciona en el proyecto.
Los pesos son los números ajustables de la red. Durante el entrenamiento cambian para acercar las distancias predichas a las conocidas. Una vez entrenado, el modelo usa estos pesos para responder a nuevas coordenadas: es la inferencia.
Llamamos a esta función fθ(x, y, z), donde θ representa el conjunto de parámetros aprendidos. Define una representación implícita: la superficie no es una lista almacenada directamente, sino que está definida por la condición fθ(x, y, z) = 0.
Una isosuperficie reúne los puntos a los que una función asigna el mismo valor. El nivel cero nos interesa para recuperar el límite del objeto. Del mismo modo, fijar z=0 permite estudiar una sección del campo en un plano.
DeepSDF presenta el principio de una representación continua mediante distancias con signo. Nuestro experimento es mucho más específico: un solo toro y distancias analíticas, no una reproducción de todo el método de este artículo de investigación.
La red puede consultarse con coordenadas que no figuran en su conjunto de entrenamiento. Eso no significa que sea exacta en todas partes: tendremos que medir sus errores y no suponer su fiabilidad fuera del dominio estudiado.
El gradiente espacial: ¿en qué dirección cambia el valor?
Desplacemos ligeramente nuestro punto. Si la distancia predicha cambia mucho, la función tiene una pendiente pronunciada en esa dirección. Si cambia poco, su pendiente es suave.
El gradiente espacial, denotado ∇xfθ, reúne las tres derivadas respecto a las coordenadas. Aquí la x de la notación designa el punto completo, no solo su primer eje. Se obtiene un vector de tres números: variaciones según x, y y z.
Su norma L2 es su longitud: para un gradiente [a, b, c], vale √(a² + b² + c²). Por ejemplo, [1, 0, 0] tiene norma 1; [2, 0, 0], norma 2.
Para una verdadera distancia con signo, esta norma vale 1 donde la función es diferenciable. La idea intuitiva es la siguiente: cerca de una superficie regular, avanzar una pequeña distancia en la dirección perpendicular hace variar la distancia con signo en la misma cantidad. No ocurre así con un desplazamiento cualquiera: deslizarse a lo largo de la superficie no produce la misma variación.
Algunas posiciones particulares no tienen una dirección única hacia la superficie más cercana. Por tanto, esta propiedad no debe interpretarse como una exigencia de diferenciabilidad perfecta en cada punto del espacio.
La penalización eikonal: una preferencia, no una garantía
La penalización anima a la red a tener una norma de gradiente próxima a 1 en los puntos muestreados. Es una regularización: no solo indicamos qué respuestas aprender, sino también una propiedad deseada de la función.
La fórmula del tutorial es:
Pérdida total = MAE de distancia + λ × media((‖∇xfθ(x)‖₂ − 1)²).
La pérdida es el número que el entrenamiento intenta reducir. La MAE, de mean absolute error, es la media de las diferencias absolutas con las distancias de referencia. La segunda parte penaliza las normas demasiado alejadas de 1. Con λ=0,1, este segundo valor se multiplica por 0,1 antes de sumarse; eso no significa que represente exactamente el 10 % de la pérdida total.
¿Por qué conservar las distancias de referencia? Tomemos dos funciones muy simples: f(x,y,z)=x y g(x,y,z)=x−0,3. Ambas tienen un gradiente de norma 1, pero su superficie cero se encuentra respectivamente en x=0 y en x=0,3. La función h(x,y,z)=−x conserva el mismo plano que f, invirtiendo a la vez interior y exterior.
Por tanto, la norma del gradiente no basta ni para colocar la superficie correcta ni para elegir su signo. En nuestro experimento, las distancias supervisadas aportan esta información. El trabajo Implicit Geometric Regularization permite profundizar en el papel de una restricción de gradiente; su protocolo de reconstrucción no es el de nuestro toro analítico.
Queda una dificultad de programación: para que esta penalización modifique los pesos, PyTorch debe poder derivar un cálculo que ya contiene un gradiente. Esta es la función de create_graph=True, que seguiremos en el código.
Requisitos de Docker y GPU
Debe saber leer funciones de Python, manipular matrices y ejecutar comandos en una terminal. Los conceptos de geometría neuronal se introducen aquí; no se necesita experiencia previa con SDF.
El recorrido previsto usa Linux x86_64, Docker Compose, NVIDIA Container Toolkit, una RTX 3090 de 24 GiB, 16 GiB de RAM y 16 GiB de disco, sin contar las capas Docker compartidas. La VRAM es la memoria de la tarjeta gráfica; es distinta de la RAM de la máquina. Mantenga estas condiciones para seguir el recorrido presentado, en vez de interpretar las explicaciones como una validación de otra configuración.
Para elegir la tarjeta, exporte GPU_DEVICE=0 o su UUID antes de la secuencia. El UUID es su identificador; permite designar una tarjeta concreta. La comprobación de entorno inicializa CUDA, el entorno de cálculo de NVIDIA utilizado aquí, y ejecuta un cálculo en el contenedor.
Ver la tarjeta desde Linux no basta para demostrar que Docker puede usarla. La guía oficial de NVIDIA Container Toolkit documenta esta integración con el controlador del anfitrión.
Los cálculos de GPU no usan red. Los contenedores aplican un sistema de archivos de solo lectura, no-new-privileges, la eliminación de capacidades Linux y límites de CPU, RAM y PID. Estos ajustes delimitan los permisos y recursos de los procesos; no sustituyen las pruebas del modelo.
Un checkpoint es una copia de estado para recuperar el modelo o reanudar su entrenamiento. Los del recorrido se producen localmente: no los cargue desde una fuente arbitraria. Su fiabilidad también depende de su procedencia.
Datos: una verdad geométrica verificable
Tres conjuntos de puntos, tres responsabilidades
Una anotación, o label, es aquí una distancia con signo calculada con la fórmula exacta. No es una categoría elegida por una persona ni una respuesta proporcionada por otro modelo.
El programa prepara tres conjuntos con semillas distintas. Una semilla inicializa el generador seudoaleatorio: permite recuperar los mismos sorteos en el entorno del proyecto.
| Conjunto | Número de puntos | Función |
|---|---|---|
Entrenamiento, o train |
65 536 | Proporcionar los ejemplos que sirven para ajustar los pesos. |
| Validación | 16 384 | Observar los errores en un conjunto separado del aprendizaje. |
| Prueba | 32 768 | Medir los resultados presentados más adelante. |
Cada conjunto contiene la mitad de puntos uniformes en el cubo [-1,1]³ y la otra mitad de puntos construidos cerca de la superficie. Los primeros exploran el volumen; los segundos concentran parte del aprendizaje cerca del límite que nos interesa.
Una cuadrícula 64³ se reserva para la extracción. Representa 64 × 64 × 64 = 262 144 posiciones de evaluación, no 262 144 ejemplos de entrenamiento adicionales. Nunca se usa para entrenar la red.
Leer las dos funciones sin confundirlas
En el fragmento, np designa NumPy; R y r son los dos radios definidos anteriormente. El proyecto completo proporciona las importaciones y las constantes.
generate_points() fabrica coordenadas. Después, torus_sdf() calcula la distancia de referencia a partir de las coordenadas que recibe. La primera función no devuelve por sí misma los labels y ninguna de las dos guarda archivos: el encadenamiento y el guardado pertenecen a la etapa de preparación del proyecto.
def torus_sdf(points):
    return (
        np.sqrt(
            (np.sqrt(points[..., 0] ** 2 + points[..., 1] ** 2) - R) ** 2
            + points[..., 2] ** 2
        )
        - r
    )


def generate_points(n, seed, std=0.04):
    rng = np.random.default_rng(seed)
    uniform = rng.uniform(-1, 1, (n // 2, 3))
    u = rng.uniform(0, 2 * np.pi, n // 2)
    v = rng.uniform(0, 2 * np.pi, n // 2)
    surface = np.stack(
        [
            (R + r * np.cos(v)) * np.cos(u),
            (R + r * np.cos(v)) * np.sin(u),
            r * np.sin(v),
        ],
        -1,
    )
    near = np.clip(surface + rng.normal(0, std, surface.shape), -1, 1)
    return np.concatenate([uniform, near]).astype("float32")
¿Cómo recupera la fórmula una distancia?
La expresión points[..., 0] selecciona las coordenadas x; los índices 1 y 2 seleccionan y y z. Los puntos suspensivos conservan las dimensiones anteriores, lo que permite efectuar el cálculo sobre una matriz de puntos.
El cálculo se lee en tres etapas. √(x²+y²) da primero la distancia al eje vertical del toro. Restar R vuelve a centrar esta distancia en el círculo que pasa por el centro del tubo. Por último, √((√(x²+y²)−R)²+z²)−r mide la separación respecto a la superficie del tubo.
Tomemos el punto (0.78, 0, 0). Su distancia al eje es 0,78. Restamos 0,55, obtenemos 0,23 y después restamos el radio del tubo 0,18. Resultado: 0,05, positivo. Estamos fuera.
En el punto (0.55, 0, 0), el mismo cálculo da 0−0,18=−0,18. En el agujero, en el origen, da 0,55−0,18=0,37. La misma fórmula explica por tanto las tres situaciones, sin una regla separada para el agujero.
¿Por qué añadir ruido a las coordenadas?
uniform contiene n // 2 puntos repartidos en el cubo. Los ángulos u y v construyen después el mismo número de posiciones sobre la superficie del toro: u recorre la dona y v recorre su tubo. np.stack(..., -1) reúne las tres coordenadas en el último eje.
El programa añade a estas posiciones ruido gaussiano, es decir, desplazamientos aleatorios centrados en cero. El parámetro std=0.04 es su desviación estándar por coordenada, no una distancia máxima permitida a la superficie; la documentación de NumPy de Generator.normal precisa esta convención. np.clip devuelve las coordenadas al intervalo [-1,1]. Por último, los dos grupos se reúnen y se convierten a float32, números de coma flotante almacenados en 32 bits.
Un matiz útil: los ángulos se extraen uniformemente, pero eso no corresponde a un muestreo uniforme por área en toda la superficie del toro. El protocolo usa este generador concreto; no le atribuimos otra distribución.
El ruido desplaza los puntos, no sus respuestas de referencia. Una vez obtenidas las coordenadas, su distancia se recalcula mediante la fórmula analítica. Por tanto, aquí no simulamos anotaciones de distancia ruidosas como las que podría producir un sensor.
La preparación guarda los conjuntos y comprueba que los puntos son distintos entre particiones. Sin embargo, los tres conjuntos se refieren al mismo toro y al mismo mecanismo de generación: un buen resultado de prueba no mide la capacidad de aprender todas las formas 3D.
Instalar y comprobar el entorno
Extraiga el archivo y sitúe su terminal en su raíz. Todos los comandos siguientes parten de este mismo directorio. Los fragmentos de Python explican el mecanismo; el ZIP proporciona el proyecto que los rodea.
Empiece preparando y comprobando el entorno:
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquire gpu
docker compose run --rm acquire python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm gpu python scripts/check_environment.py --config configs/minimum.yaml
docker compose run --rm gpu python -m pytest -q
setup.sh prepara el proyecto. docker compose config --quiet verifica la configuración de Compose; build construye las imágenes utilizadas por los servicios acquire y gpu.
El nombre acquire puede recordar los tutoriales que descargan un modelo preentrenado. Aquí valida un manifiesto sin pesos que descargar: vamos a aprender el campo a partir de puntos generados localmente. Eso no significa que construir imágenes Docker nunca requiera red.
La comprobación de entorno debe tener éxito antes del entrenamiento. Después, el comando pytest ejecuta las pruebas proporcionadas. Un éxito en esta fase comprueba el programa y su entorno; todavía no demuestra que la red aprendida represente correctamente el toro.
Ahora prepare los datos, inspeccione el contrato de la red y compruebe la pérdida:
docker compose run --rm gpu python -m neural_sdf.cli prepare --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli inspect-model --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli check-loss --config configs/minimum.yaml
La notación B×3 → B significa: para un lote de B puntos con tres coordenadas, obtener una distancia por punto. Por ejemplo, diez puntos entran en forma de una matriz 10×3; deben salir diez distancias.
En PyTorch, estas matrices son tensores: números organizados según dimensiones que el programa puede procesar en la GPU. Una pérdida escalar es un tensor que contiene un único valor.
Esta comprobación de dimensiones no es decorativa. Con prediction y labels de forma B, su resta compara cada predicción con su label. Una matriz B×1 restada de una matriz B puede extenderse automáticamente a B×B: el programa compararía entonces todos los pares en vez de solo los pares correspondientes. Es un efecto del broadcasting de PyTorch, no una medida correcta de nuestras distancias.
check-loss verifica otro contrato: la penalización debe tener realmente un gradiente hacia los pesos. Veamos cómo se construye esta comprobación.
El código central: hacer entrenable la penalización eikonal
Dos gradientes, dos preguntas
En desarrollo web, un mismo dato puede pasar por varias funciones antes de guardarse. Aquí también debemos seguir una cadena, pero una cadena de cálculos diferenciables.
El gradiente espacial responde a «¿qué ocurre con la distancia si muevo el punto?». El gradiente de la pérdida respecto a los parámetros responde a «¿cómo varía la pérdida si cambio los pesos?». El optimizador usa el segundo para ajustar la red.
La penalización une ambos: depende del gradiente espacial, que a su vez depende de los pesos. Para aprender esta propiedad, hay que conservar esta dependencia durante el cálculo.
El grafo de cálculo es el rastro de las operaciones y sus dependencias: ¿qué resultado procede de qué números, multiplicaciones u otras transformaciones? PyTorch lo utiliza para propagar derivadas. No es un gráfico mostrado en pantalla.
def sdf_eikonal_loss(model, points, labels, weight=0.1, create_graph=True):
    points = points.detach().requires_grad_(True)
    prediction = model(points)
    gradient = torch.autograd.grad(prediction.sum(), points, create_graph=create_graph)[
        0
    ]
    distance = (prediction - labels).abs().mean()
    eikonal = (gradient.norm(dim=-1) - 1).square().mean()
    return distance + weight * eikonal, distance, eikonal


def check_loss(config):
    model = torch.nn.Linear(3, 1, bias=False).cuda()
    with torch.no_grad():
        model.weight.copy_(torch.tensor([[2.0, 0, 0]], device="cuda"))
    x = torch.randn(10, 3, device="cuda", requires_grad=True)
    gradient = torch.autograd.grad(model(x).sum(), x, create_graph=True)[0]
    penalty = (gradient.norm(dim=-1) - 1).square().mean()
    weight_gradient = torch.autograd.grad(penalty, model.weight)[0]
    assert torch.allclose(weight_gradient, torch.tensor([[2.0, 0, 0]], device="cuda"))
    return {
        "affine_gradient": [2.0, 0, 0],
        "penalty": float(penalty),
        "weight_gradient": weight_gradient.tolist(),
    }
Seguir sdf_eikonal_loss()
Preparar las coordenadas. points.detach() corta su posible historial de cálculo; después, requires_grad_(True) pide seguir las variaciones de la salida respecto a estas coordenadas. Esto no congela los pesos del modelo ni desplaza los puntos. Prepara las entradas para el cálculo de derivadas. La documentación de detach() precisa esta ruptura con el grafo anterior.
Predecir las distancias. model(points) aplica la red a las coordenadas. Con el contrato B×3 → B, prediction y labels llevan un valor por punto.
Calcular la pendiente en el espacio. torch.autograd.grad() recibe la suma de las predicciones y las coordenadas. Para esta red, que trata cada punto independientemente de los demás puntos del lote, derivar la suma permite recuperar el gradiente de cada predicción respecto a su propio punto. El resultado tiene la forma B×3.
El [0] al final de la llamada selecciona el primer elemento de la tupla devuelta por PyTorch, el que corresponde a points. No selecciona solo el primer punto del lote. La documentación de torch.autograd.grad describe este cálculo y sus parámetros.
Calcular los dos errores. (prediction - labels).abs().mean() da la MAE de distancia. gradient.norm(dim=-1) calcula una norma por punto reuniendo sus tres derivadas. Se resta 1, se eleva la diferencia al cuadrado y luego se promedia: es la penalización eikonal.
Devolver el total y sus componentes. La función devuelve tres números tensoriales: la pérdida total, la MAE y la penalización sin ponderar. Conservarlos por separado permite ver qué componente mejora o empeora.
La función no actualiza por sí misma los pesos. La llamada posterior a loss.backward() calcula sus gradientes; el optimizador realiza después la actualización. No hay que confundir calcular una pérdida, calcular su gradiente y aplicar una modificación a los parámetros.
Un cálculo de pérdida que se puede rehacer a mano
Aquí hay tres predicciones ficticias, elegidas para explicar la fórmula. No proceden del modelo entrenado ni de los archivos de resultados.
| Punto | Distancia de referencia | Predicción ficticia | Diferencia absoluta |
|---|---|---|---|
(0.55, 0, 0) |
−0,18 |
−0,16 |
0,02 |
(0.73, 0, 0) |
0 |
0,01 |
0,01 |
(0.78, 0, 0) |
0,05 |
0,02 |
0,03 |
La MAE vale (0,02 + 0,01 + 0,03) / 3 = 0,02.
Supongamos ahora que las normas de los gradientes predichos en estos tres puntos valen respectivamente 0,8, 1,0 y 1,2. La penalización vale ((0,8−1)² + (1−1)² + (1,2−1)²) / 3, es decir, aproximadamente 0,026667.
Con λ=0,1, la pérdida total vale por tanto 0,02 + 0,1 × 0,026667 ≈ 0,022667. No añadimos directamente 0,026667: la ponderación importa.
Por qué create_graph=True es indispensable aquí
PyTorch sabe calcular un gradiente numérico sin conservar todas las dependencias que permiten derivarlo de nuevo. Sin embargo, la penalización depende precisamente de un gradiente que después queremos derivar respecto a los pesos.
create_graph=True construye el grafo del cálculo de la derivada. El camino queda disponible: pesos → distancias → gradientes espaciales → penalización. Con False, todavía puede obtenerse un número para la penalización, sin poder usar este camino para entrenar los pesos.
El tutorial oficial Double Backward with Custom Functions profundiza en esta diferencia entre calcular una derivada y poder derivar su cálculo. Este complemento explica el mecanismo; no pide sustituir el código del proyecto por una función autograd personalizada.
Leer la prueba afín: ¿por qué se espera [2, 0, 0]?
check_loss() elige una capa lineal con tres entradas, una salida y ningún sesgo. Fija sus pesos en [2, 0, 0]. Por tanto, la función calculada es simplemente f(x,y,z)=2x.
Sea cual sea el punto, su gradiente espacial es [2, 0, 0]. Su norma vale 2 y la penalización vale (2−1)²=1. Los diez puntos aleatorios no complican esta comprobación: para esta función, la pendiente es constante.
Pero la prueba va más lejos: deriva la penalización respecto a los pesos. Cerca del coeficiente positivo a=2, para una función f(x,y,z)=a×x, la penalización vale (a−1)². Su derivada vale 2×(a−1), por tanto 2 en a=2. Los otros dos componentes valen cero. Esto explica la aserción sobre [[2.0, 0, 0]].
El gradiente espacial y el gradiente hacia los pesos tienen aquí los mismos valores numéricos, pero son dos objetos diferentes. El primero describe la variación en el espacio; el segundo verifica que la regularización puede participar en el aprendizaje.
La comprobación se refiere solo a la penalización, sin multiplicarla por λ. Por tanto espera 2 en el primer peso, no 0,2. Una salida numérica plausible de la pérdida no bastaría para sustituir esta aserción.
Entrenar, reanudar, evaluar y extraer
Ahora podemos seguir la secuencia completa. El primer comando entrena la variante eikonal. El segundo entrena la variante de distancia sola, que sirve como punto de comparación.
Los siguientes comandos interrumpen un entrenamiento después del paso 500, reanudan el estado guardado, comparan la reanudación con el recorrido de referencia, evalúan ambos campos y después extraen sus isosuperficies.
docker compose run --rm gpu python -m neural_sdf.cli train --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli train --config configs/minimum.yaml --variant distance
docker compose run --rm gpu python -m neural_sdf.cli train --config configs/minimum.yaml --stop-after 500 --run-name interrupted
docker compose run --rm gpu python -m neural_sdf.cli train --config configs/minimum.yaml --resume artifacts/checkpoints/interrupted/state.pt --run-name resumed
docker compose run --rm gpu python -m neural_sdf.cli compare-resume --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli evaluate --config configs/minimum.yaml
docker compose run --rm gpu python -m neural_sdf.cli mesh --config configs/minimum.yaml
Un lote, o batch, es un grupo de puntos tratado conjuntamente. Una inicialización fija los pesos antes de su primera actualización. Partir de los mismos pesos y presentar los mismos lotes a las dos variantes reduce las diferencias parásitas de la comparación: estudiamos la adición de la penalización, no dos juegos de ejemplos distintos.
La reanudación requiere más que el peso final de una capa. El estado del optimizador y el del generador seudoaleatorio forman parte del recorrido controlado. Es comparable a reanudar un proceso de una aplicación: recuperar el último resultado no basta si se ha perdido el estado que determina la siguiente operación.
Los resultados publicados más adelante proceden de la reproducción para lectores validada de esta secuencia. El tutorial no proporciona aquí una duración de entrenamiento de referencia ni una comparación de rapidez entre variantes: no deduzca una ganancia de tiempo únicamente a partir de las puntuaciones de calidad.
¿Cómo pasar de una función a triángulos?
La etapa mesh evalúa el campo en su cuadrícula independiente 64³ y después extrae el nivel cero. El principio de marching cubes consiste en recorrer las celdas de la cuadrícula y construir triángulos a partir de los valores que encierran el nivel buscado. La documentación de scikit-image describe esta extracción y los vértices y caras que devuelve.
Una analogía en una dimensión permite comprender la interpolación. En un segmento de longitud 0,1, supongamos que los valores de los extremos son −0,02 y +0,03. Una interpolación lineal sitúa el cero a 0,02 / (0,02 + 0,03) = 0,4 del segmento, es decir, a 0,04 del primer extremo. Este ejemplo explica el principio; no es una medida de la malla del tutorial.
La malla es una aproximación discreta del campo aprendido. La resolución de la cuadrícula influye en lo que puede verse o pasarse por alto. Aumentar esa resolución no vuelve a entrenar la red ni corrige automáticamente sus distancias.
Mediciones antes de los resultados
MAE global: ¿da la red las distancias correctas?
La MAE de distancia es la media de |predicción − referencia| en los puntos evaluados. Un error positivo y uno negativo no se anulan. Cuanto menor sea esta media, más próximos estarán los valores predichos a las distancias analíticas en la población considerada.
Se evalúa en validación y en prueba. Conserva la unidad de las coordenadas del experimento: no es ni un porcentaje ni una tasa de puntos clasificados correctamente dentro o fuera.
MAE cerca de la superficie: ¿cómo se comporta el límite?
El cálculo solo conserva los puntos cuya distancia analítica satisface el umbral de proximidad declarado en el proyecto. Después se promedian los errores en esta subpoblación.
El umbral numérico no se reproduce en este texto: consulte el del recorrido proporcionado en lugar de elegir uno tras leer los resultados. Sobre todo, la selección se basa en la distancia de referencia, no en la distancia estimada por el propio modelo. Una predicción errónea no debe poder excluirse de su propia evaluación.
No confunda «la mitad de los puntos generados cerca de la superficie» con «el número de puntos retenidos por este umbral». Los desplazamientos gaussianos no forman una banda estricta; algunos puntos uniformes también pueden estar cerca de la superficie. El número publicado de 13 832 puntos procede de la selección de evaluación, no de dividir simplemente 32 768 entre dos.
Error de norma de gradiente: ¿tiene la pendiente la longitud correcta?
Esta métrica promedia la diferencia absoluta |‖∇f‖₂−1|. No es la penalización de entrenamiento, que promedia las diferencias al cuadrado.
Retomemos las normas pedagógicas 0,8, 1,0 y 1,2. El error absoluto medio vale (0,2 + 0 + 0,2) / 3 ≈ 0,133333, mientras que la penalización al cuadrado vale aproximadamente 0,026667. Ambos números describen las mismas tres normas según convenciones diferentes; no son intercambiables.
Esta métrica no verifica directamente la orientación del gradiente ni la posición de la superficie. Las funciones planas de nuestro ejemplo tenían todas una norma correcta, pese a sus superficies desplazadas o sus signos invertidos.
Mediciones de la malla: ¿qué vale finalmente el objeto extraído?
Un vértice es un punto de la malla; una cara es aquí un triángulo que une tres vértices. Sus cantidades describen la salida de la extracción. Más triángulos no significan automáticamente más precisión.
La desviación analítica media de los vértices mide su distancia a la superficie real del toro: para cada vértice extraído se calcula el valor absoluto de la SDF analítica y después se promedia.
Hay que observar estos números además de la MAE del campo: los vértices de la malla no son la misma población que los puntos de prueba. Esta media de distancias de los vértices a la superficie tampoco certifica por sí sola que se haya cubierto toda la forma, que todos los triángulos sean utilizables o que la estructura geométrica sea correcta.
Resultados observados
Los siguientes números son los de la reproducción r1 del tutorial. Los cálculos pedagógicos anteriores no entran en estas mediciones.
Comparar los dos campos en la prueba
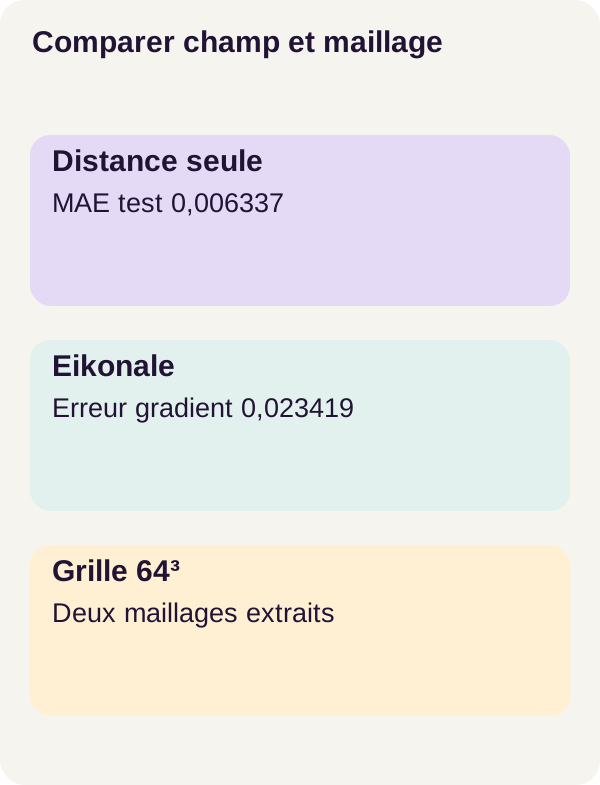
El conjunto de prueba contiene 32 768 puntos. La medición cerca de la superficie se refiere a 13 832 puntos. Para las tres métricas siguientes, un valor menor es preferible.
| Medida en la prueba | Solo distancia | Distancia + penalización eikonal |
|---|---|---|
| MAE global de distancia | 0,006337 |
0,008552 |
| MAE cerca de la superficie | 0,004770 |
0,004700 |
| Error absoluto medio de norma de gradiente | 0,024407 |
0,023419 |
La variante eikonal mejora ligeramente la MAE cerca de la superficie y el error de norma del gradiente. Sin embargo, su MAE global es más alta. Por tanto, la restricción adicional no mejora todos los indicadores al mismo tiempo.
Las diferencias se pueden hacer más concretas mediante una simple resta de los valores publicados: la MAE global aumenta 0,002215, la MAE cerca de la superficie disminuye 0,000070 y el error de norma disminuye 0,000988. Son diferencias calculadas a partir de los redondeos mostrados, no nuevas campañas de medición.
La tabla no ofrece dispersión entre varias inicializaciones independientes. Permite describir este compromiso observado, no afirmar que una diferencia tan pequeña se reproducirá sistemáticamente.
Comparar las mallas extraídas
La misma resolución 64³ permitió extraer las dos mallas.
| Medida de extracción | Solo distancia | Distancia + penalización eikonal |
|---|---|---|
| Vértices | 5 448 | 5 864 |
| Caras | 10 896 | 11 728 |
| Desviación analítica media de los vértices | 0,005149 |
0,005189 |
La variante eikonal produce más vértices y caras, pero su desviación analítica media de los vértices es ligeramente mayor. Por tanto, en esta medida una malla más densa no es una malla más próxima a la superficie.
La ligera mejora de MAE cerca de la superficie no debe presentarse como una mejora demostrada de la malla. La primera puntuación se refiere a puntos de prueba seleccionados; la segunda, a los vértices surgidos de la extracción. No son ni la misma población ni el mismo cálculo.
La reanudación tras la interrupción recuperó los parámetros con un error máximo nulo, además del optimizador, el generador y la inicialización compartida. Este resultado valida la reanudación en el recorrido probado; no constituye una medición adicional de calidad geométrica.
Lo que hemos aprendido
Hemos aprendido a representar una forma mediante una función de coordenadas y después a volver a los triángulos. La red no recibe una orden vaga como «dibuja un toro»: aprende pares punto-distancia cuya respuesta puede comprobarse.
La penalización eikonal añade una preferencia sobre la variación espacial de esta función. Para que influya en los pesos, el cálculo debe conservar la posibilidad de derivar el gradiente espacial. Eso es precisamente lo que la prueba afín hace visible.
Una restricción útil no garantiza que todas las puntuaciones mejoren. En este experimento, la variante regularizada mejora ligeramente dos indicadores del campo, mientras que la distancia sola conserva la mejor MAE global y la menor desviación media de los vértices extraídos.
Por último, deben mantenerse distintos tres objetos: la forma analítica que sirve de referencia, el campo neuronal que la aproxima y la malla muestreada a partir de ese campo. La cuadrícula puede ocultar o introducir artefactos sin cambiar los pesos. Por tanto, un resultado sobre este toro no valida una reconstrucción de un escaneo real.
Ejercicio: hipótesis antes del comando
Antes de ejecutar el comando, vuelva a la función de la comprobación: f(x,y,z)=2x. Prediga qué ocurre cuando create_graph=True pasa a ser False.
Escriba por separado sus respuestas: ¿sigue siendo calculable la distancia? ¿Puede el gradiente espacial seguir valiendo [2,0,0]? ¿Puede la penalización seguir mostrando 1? ¿Y PyTorch conserva todavía el camino necesario para derivar esta penalización respecto a los pesos?
Después ejecute la comprobación negativa prevista por el proyecto:
docker compose run --rm gpu python -m neural_sdf.cli exercise --config configs/exercise.yaml
Lea el estado de la comprobación y compárelo con su predicción. El punto que debe comprender es que un valor de penalización puede seguir siendo calculable aunque ya no esté disponible su dependencia diferenciable respecto a los pesos. Un error esperado de la comprobación es entonces información útil, no una razón para ocultar el problema y continuar.
«Gradiente no disponible» no significa «gradiente matemático igual a cero». En nuestro caso afín sabemos calcular su valor a mano: no es nulo. Lo que falta es el camino de cálculo que PyTorch necesita.
Conserve el recorrido de referencia. El caso afín ofrece una predicción que comprobar: observe el estado que devuelve realmente su comando, en lugar de esperar una frase concreta de salida. Los valores calculados a mano explican el mecanismo; no sustituyen esta observación.
Adaptar y producir
Cambiar una hipótesis en un experimento separado
Una ampliación pedagógica consiste en variar la ponderación eikonal en una copia del proyecto, manteniendo comparables los datos, la inicialización y la cuadrícula. Antes de medir, anote qué indicadores cree que cambiarán y después vuelva a ejecutar el recorrido adaptado.
Esta propuesta no tiene un resultado anunciado de antemano. Cambiar λ crea otro experimento; sus puntuaciones no deben sustituir silenciosamente las de r1. El archivo sigue siendo la referencia para los parámetros y los comandos del recorrido presentado.
Por qué un escaneo real cambia el problema
Aquí conocemos la distancia con signo de cualquier punto gracias a una fórmula. Un conjunto de puntos procedente de un escaneo no aporta automáticamente esa misma información en todo el espacio. La adquisición, las unidades, los sistemas de referencia, el ruido, los agujeros y la manera de establecer interior y exterior pasan a ser asuntos que hay que tratar explícitamente.
Antes de una aplicación real, también habría que precisar los derechos sobre los datos, los criterios de aceptación y el uso de la malla: visualización, procesamiento posterior u otra necesidad. Los umbrales de rechazo deben depender de ese uso, no solo de una impresión visual favorable.
La explotación requiere además gestionar los accesos a los artefactos, las copias de seguridad, el seguimiento de errores y de la deriva, así como medidas de carga. El código proporcionado no aporta ni canalización de escaneo, ni validación clínica o industrial, ni servicio expuesto.
Solución de problemas y limpieza
Si CUDA falla, compruebe el controlador, la tarjeta seleccionada y la integración Docker siguiendo la guía de NVIDIA Container Toolkit. Después vuelva a ejecutar la comprobación de entorno antes de modificar la red.
Si aparece un error de gradiente, distinga entre un valor numérico incorrecto y un camino de derivación ausente. Compruebe requires_grad, create_graph y que no se hayan desactivado los gradientes alrededor del cálculo afectado. Predecir distancias sin calcular sus derivadas y evaluar una penalización de gradiente no requieren las mismas condiciones de ejecución. No quite la aserción de la comprobación afín para obtener un éxito aparente.
Si no hay ningún nivel cero en la cuadrícula, examine los valores del campo, el dominio consultado y el modelo cargado antes de concluir que el aprendizaje ha fallado. Una extracción no puede revelar un cruce por cero que los valores muestreados no permiten encontrar. No sustituya automáticamente el nivel cero por otro umbral: cambiaría la superficie buscada.
Después del ejercicio, genere las figuras, compruebe los checkpoints, previsualice la limpieza y después detenga los servicios:
docker compose run --rm gpu python lesson/figures/plot.py
docker compose run --rm gpu python scripts/check_checkpoints.py
docker compose run --rm gpu python scripts/clean.py --scope generated --dry-run
docker compose down --remove-orphans
--dry-run significa que la limpieza es una previsualización: conserva los archivos locales. Examine lo anunciado antes de cualquier eliminación posterior. El último comando detiene los recursos Compose del proyecto y sus contenedores huérfanos; no es una limpieza global de Docker.
Conserve las salidas necesarias para sus comparaciones, especialmente antes de ejecutar una variante del experimento.
Fuentes primarias y documentación
Las referencias siguientes profundizan en los conceptos. No sustituyen las versiones ni los parámetros contenidos en el archivo para reproducir los resultados r1.
Park et al. — DeepSDF presenta la representación continua mediante distancias con signo. Gropp et al. — Implicit Geometric Regularization estudia la regularización geométrica mediante una propiedad del gradiente. Sus experimentos son distintos del toro analítico presentado aquí.
La documentación PyTorch — automatic differentiation, la referencia torch.autograd.grad y el tutorial Double Backward with Custom Functions explican las derivadas y los grafos necesarios para propagarlas. Las páginas sobre detach() y el broadcasting completan la lectura del código.
La referencia NumPy — Generator.normal describe la extracción de ruido gaussiano utilizada para desplazar los puntos.
La referencia scikit-image — marching cubes detalla la extracción de una isosuperficie a partir de un volumen muestreado. La guía de instalación de NVIDIA Container Toolkit se refiere al acceso a la GPU desde los contenedores.