





Imaginez le journal d’activité d’un back-office : un document est importé, indexé, affecté à une équipe, puis envoyé en revue. La plupart des dossiers suivent des chemins assez réguliers. Mais certains sautent une étape, repassent plusieurs fois en révision ou mettent beaucoup plus longtemps à avancer.
Vous pourriez écrire une série de conditions pour les repérer. Mais comment distinguer un chemin réellement inhabituel d’une variante normale que vos règles n’avaient pas prévue ? Et que se passe-t-il si l’équipe change sa manière de travailler ?
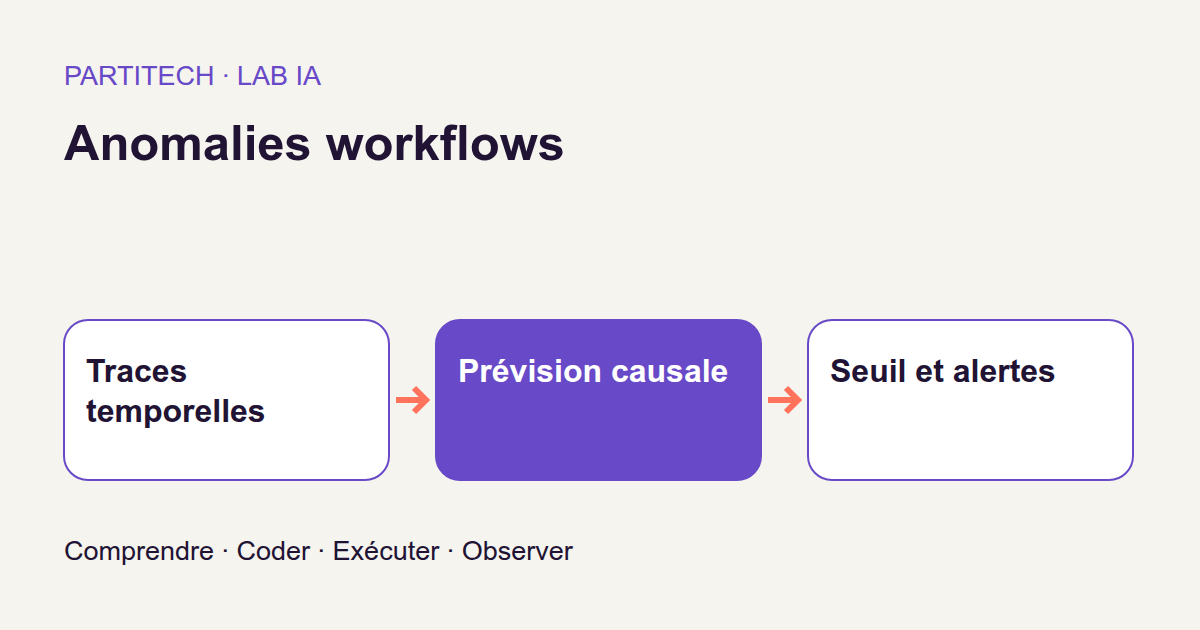
Nous allons construire un détecteur qui apprend à prévoir le prochain événement et son délai, puis compare cette prévision à ce qui se produit réellement. Lorsqu’il est suffisamment surpris, il signale le dossier pour vérification. Il ne décide ni qu’une personne a commis une faute, ni qu’un document est non conforme.
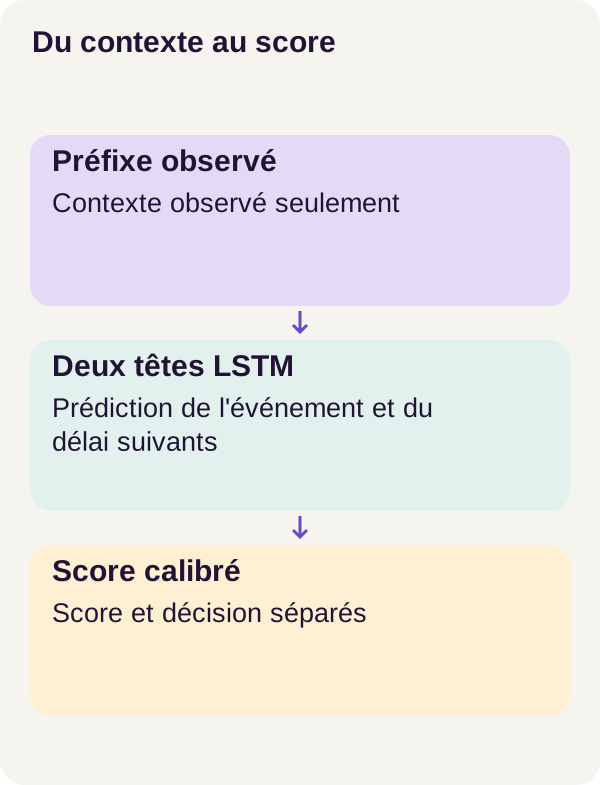
Le parcours est concret : journal d’événements → préfixe observé → prédiction → mesure de surprise → seuil → alerte à examiner. Nous entraînerons un petit réseau récurrent, le comparerons à deux méthodes simples et testerons sa réaction à une nouvelle pratique pourtant acceptable.
Le modèle ne reçoit ni les identités, ni les familles de dossiers, ni les horodatages absolus. Les données sont synthétiques : elles permettent une expérience contrôlée, pas une mesure de la fréquence des incidents dans une entreprise. Les petits exemples de calcul ajoutés au fil de l’article sont pédagogiques ; les résultats de référence r004 sont présentés séparément.
Télécharger le projet complet, révision r004
Définir une anomalie comme une surprise, pas comme une non-conformité
Lire une trace comme un journal applicatif
Une GED, ou gestion électronique des documents, conserve des documents et les opérations qui les concernent. Un workflow est leur parcours entre différentes étapes. Une trace est la suite ordonnée des événements d’un même dossier ; un préfixe est le début de cette suite, jusqu’à une position donnée.
Le vocabulaire du projet contient huit événements : IMPORT, INDEXATION, AFFECTATION, REVUE, REVISION, APPROBATION, PUBLICATION et ARCHIVAGE. Quatre rôles fictifs indiquent le rôle associé à l’événement, sans fournir une identité individuelle.
Prenons ce préfixe illustratif : IMPORT → INDEXATION → AFFECTATION → REVUE. À cet instant, nous savons que la revue a eu lieu. Nous ne savons pas encore si l’étape suivante sera une révision ou une approbation, ni combien de temps elle prendra.
Une trace normale du simulateur peut inclure REVISION → REVUE et peut omettre la publication. Il ne faut donc pas assimiler toute boucle ou toute étape absente à une erreur. Les perturbations injectées — saut, boucle, permutation et délai allongé — servent à tester le détecteur dans ce corpus. Elles ne définissent pas une politique documentaire universelle.
Séparer apprendre, régler et mesurer
Le modèle apprend les chemins normaux sur l’ensemble d’entraînement, appelé train. L’ensemble de validation sert ici à fixer le seuil d’alerte. Le test mesure ensuite la règle obtenue, sans réajuster ce seuil pour améliorer les chiffres.
Les populations explicitement décrites dans le protocole sont les suivantes :
| Ensemble | Traces normales | Traces perturbées explicitement dénombrées |
|---|---|---|
| Entraînement | 840 | Aucune dans l’apprentissage décrit |
| Validation utilisée pour le seuil | 90 | Non utilisées pour choisir le seuil |
| Test | 90 | 90 |
Point de vigilance sur le décompte global. Le corpus est annoncé comme comprenant 120 familles de dix traces, soit 1 200 traces. Les effectifs explicitement dénombrés ci-dessus totalisent 1 110 traces. La description fournie ne précise pas l’affectation des 90 restantes : ce point reste à vérifier dans la génération du corpus. Nous conservons les populations annoncées pour l’apprentissage, la calibration et le test, sans compléter cette différence par une répartition supposée.
La séparation respecte aussi le temps : l’entraînement précède la validation, qui précède le test. Chaque famille possède sa propre fenêtre temporelle. Les dossiers, les traces et les fenêtres ne traversent pas les ensembles, aussi appelés splits.
Cela ne signifie pas que les suites de symboles sont entièrement différentes. Un début comme IMPORT → INDEXATION peut apparaître partout. Avec seulement huit événements, interdire tout préfixe commun créerait un problème artificiel. Ce sont les dossiers et leurs fenêtres qui doivent rester séparés, pas le vocabulaire nécessaire pour décrire leur activité.
Refuser une source invalide avant de chercher une anomalie
Le programme distingue une donnée mal formée d’un événement peu fréquent. Une durée négative, un type d’événement inconnu ou un ordre source dupliqué invalident l’entrée avant le calcul statistique.
Des horodatages égaux sont autorisés. L’ordre source, qui permet de départager les événements, fixe alors leur succession. Un délai nul est donc une observation valide, pas une anomalie automatique.
Le flux est vérifié comme non décroissant avant le tri stable. Pourquoi cet ordre de traitement ? Supposons, à titre d’illustration, qu’un export présente 10 h 05 puis 10 h 02. Trier immédiatement les lignes donnerait une chronologie apparemment propre, en cachant l’incohérence de la source. Le parcours préfère signaler le problème plutôt que le transformer en surprise statistique.
Ce que le modèle sait à chaque instant
À la position courante, trois informations lui sont fournies : l’événement, son rôle et le délai déjà écoulé depuis l’événement précédent. Ce délai est transformé en log1p(délai) / 10.
log1p(x) calcule le logarithme naturel de 1 + x. Le logarithme compresse les grandes valeurs ; l’ajout de 1 rend aussi le délai nul utilisable. Avec des durées illustratives de 9, 99 et 999 secondes, l’entrée temporelle vaut respectivement environ 0,2303, 0,4605 et 0,6908. Le réseau ne reçoit donc pas directement 9, 99 et 999. La documentation de torch.log1p précise ce calcul.
Attention au décalage : le délai en entrée concerne le passé ; celui à prédire concerne l’étape suivante. Le modèle ne reçoit ni cet événement suivant, ni son rôle, ni le type de perturbation, ni l’ID du dossier, ni sa famille, ni le temps absolu. Les événements futurs servent de cibles d’apprentissage, pas d’entrées à la même position.
Une alerte sur cette transition ne peut être calculée qu’après l’arrivée du prochain événement. Si celui-ci arrive après une longue attente, le programme peut alors comparer le délai observé à sa prévision. En revanche, ce parcours ne fournit pas une alarme qui se déclencherait pendant une attente toujours en cours. Ce serait un mécanisme supplémentaire à concevoir et à évaluer.
Ici, causal signifie « sans lire le futur ». Cela ne signifie pas « capable d’expliquer la cause métier ». Un test modifie un suffixe futur — la fin de la trace — et vérifie que les scores bruts du préfixe inchangé ne changent pas.
Le modèle causal et ses deux têtes
Un petit état qui avance avec le dossier
Un LSTM, pour Long Short-Term Memory, est un réseau qui traite une séquence dans l’ordre et met à jour un état numérique à chaque position. Imaginez une fonction qui parcourt un tableau d’événements en conservant un résumé de ce qu’elle a lu. Ici, la manière de construire ce résumé est apprise, plutôt qu’écrite sous forme de conditions.
Le LSTM du projet est unidirectionnel, avec 64 unités. Il lit seulement vers l’avant. Son état est initialisé à zéro pour chaque dossier : le résumé du dossier précédent ne devient pas le contexte du suivant. Les mécanismes internes et les états du LSTM sont décrits dans la documentation PyTorch 2.8.
Avant cette lecture, les catégories deviennent des vecteurs. Un embedding est ici une ligne d’un tableau de nombres appris : chaque événement obtient 16 valeurs, chaque rôle 8. Il ne s’agit pas de comprendre linguistiquement le mot REVUE, mais d’apprendre une représentation utile de sa catégorie. La documentation de Embedding décrit ce principe de table de correspondance.
En ajoutant la valeur temporelle, on obtient 16 + 8 + 1 = 25 nombres par position. Le LSTM les transforme en un état de 64 valeurs. Deux têtes, c’est-à-dire deux petites couches de sortie, utilisent ce même état : l’une prédit l’événement suivant, l’autre les paramètres du délai suivant.
Suivre les dimensions dans le code
Voici le premier extrait du projet, conservé tel quel :
import torch
from torch import nn
import torch.nn.functional as F
from .events import make_prefix_targets


class SequenceModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.events = nn.Embedding(8, 16)
        self.roles = nn.Embedding(4, 8)
        self.lstm = nn.LSTM(25, 64, batch_first=True)
        self.event_head = nn.Linear(64, 8)
        self.delay_head = nn.Linear(64, 2)

    def forward(self, event, role, previous):
        x = torch.cat(
            [self.events(event), self.roles(role), previous.unsqueeze(-1)], -1
        )
        # No state argument: every batch starts fresh, no state crosses cases.
        hidden, _ = self.lstm(x)
        logits = self.event_head(hidden)
        parameters = self.delay_head(hidden)
        return logits, parameters[..., 0], F.softplus(parameters[..., 1]) + 0.001
Un tenseur est un tableau numérique qui peut avoir plusieurs axes. Pour lire ce code, appelons B le nombre de traces du lot et T le nombre de positions après remplissage. Les noms d’événements et de rôles sont convertis en identifiants entiers ; event, role et previous ont chacun une forme [B, T].
self.events(event) retourne [B, T, 16], et self.roles(role) retourne [B, T, 8]. previous.unsqueeze(-1) ajoute un axe au délai pour obtenir [B, T, 1]. Enfin, torch.cat(..., -1) assemble ces trois blocs sur le dernier axe : nous retrouvons [B, T, 25].
batch_first=True signifie que le premier axe désigne le lot. hidden contient ensuite un état de 64 valeurs à chaque position, donc [B, T, 64], pas seulement un résumé final par trace. L’absence d’état transmis à self.lstm(x) réinitialise les états à cet appel ; le modèle ne conserve pas automatiquement une session d’un appel à l’autre.
La tête event_head produit [B, T, 8] : huit logits, ou scores bruts, pour les huit événements. Ces nombres ne sont pas encore des probabilités. La tête delay_head produit [B, T, 2], dont les composantes deviennent mu et raw_sigma.
mu décrit le centre de la distribution prévue de log(1 + délai). sigma décrit sa dispersion, sous forme d’écart-type : une petite valeur exprime une prévision temporelle plus resserrée.
La dernière ligne utilise softplus(raw_sigma) + 0.001 pour conserver une dispersion positive. Softplus est une transformation lisse fondée sur log(1 + exp(x)) ; elle laisse le réseau apprendre sans autoriser un écart-type négatif. Cette contrainte porte sur sigma, pas sur mu : l’extrait ne borne pas directement le délai obtenu en reconvertissant mu.
Apprendre le prochain événement : pénaliser la surprise
Pendant l’entraînement, le programme connaît l’événement qui suit chaque préfixe normal. Il demande au modèle de lui attribuer une probabilité élevée. La fonction de perte, ou loss, est le nombre que l’apprentissage cherche à réduire.
Pour la partie événement, nous utilisons l’entropie croisée, ou cross-entropy. Avec une cible catégorielle, elle correspond à −log(probabilité de l’événement réellement observé).
Exemple pédagogique : si le modèle attribue une probabilité de 0,8 à l’événement qui se produit, sa perte vaut environ 0,2231. S’il lui attribue seulement 0,05, elle vaut environ 2,9957. Plus ce qui arrive était jugé improbable, plus la surprise est forte.
Le code passe directement les logits à F.cross_entropy, qui effectue le calcul approprié. Il n’est pas nécessaire d’appliquer un softmax au préalable dans cet extrait. Avec reduction="none", nous conservons une perte par position, au lieu d’obtenir immédiatement une moyenne globale.
Apprendre le délai sans confondre ses deux échelles
La cible temporelle est z = log(1 + délai suivant). Cette cible n’est pas divisée par dix. La division par dix concernait seulement la caractéristique du délai précédent fournie en entrée.
Le modèle approxime z par une distribution gaussienne, une courbe en cloche de centre mu et d’écart-type sigma. Le calcul de perte temporelle est :
NLL_délai = log(sigma) + (z − mu)² / (2 × sigma²)
NLL signifie negative log-likelihood, ou opposé du logarithme de la vraisemblance. Le terme au carré pénalise l’écart entre la cible et le centre prévu, relativement à la dispersion annoncée. log(sigma) évite qu’élargir indéfiniment cette dispersion soit gratuit. La constante de la gaussienne est omise, conformément au parcours. La documentation de GaussianNLLLoss présente la formule générale avec la variance ; ici, cette variance vaut sigma² et le calcul est écrit directement.
Prenons un exemple numérique distinct des sorties entraînées : mu = log(11) et sigma = 0,5. Un délai observé de 10 secondes donne z = mu, donc une perte d’environ −0,6931. Un délai de 30 secondes donne environ 1,4538. Il est plus éloigné du centre annoncé et reçoit une pénalité plus élevée.
Une perte temporelle négative n’est pas une probabilité négative. Nous travaillons avec une densité continue, pas avec la probabilité d’une catégorie ; la hauteur d’une densité peut dépasser 1, et la constante est ici retirée. Ne convertissez donc pas cette NLL en « pourcentage de risque ».
Le masque : ne pas apprendre sur le remplissage
Les traces n’ont pas toutes la même longueur. Pour les ranger dans un lot rectangulaire, on ajoute du padding, ou remplissage, à droite. Le masque booléen indique les positions réelles qui possèdent une cible : True pour une position utile, False pour une position ajoutée.
La construction du lot, située entre les deux extraits dans le fichier source, prépare les tenseurs et ce masque. La fonction suivante reçoit ces données :
def components(logits, mu, sigma, targets, z, mask):
    if (
        mask.dtype != torch.bool
        or not mask.any(1).all()
        or ((mask[:, 1:] & ~mask[:, :-1]).any())
    ):
        raise ValueError("Nonempty real prefix mask required")
    # Select before calculating: a padded NaN target cannot contaminate loss.
    event = torch.zeros_like(mu)
    delay = torch.zeros_like(mu)
    event[mask] = F.cross_entropy(logits[mask], targets[mask], reduction="none")
    delay[mask] = torch.log(sigma[mask]) + (z[mask] - mu[mask]).square() / (
        2 * sigma[mask].square()
    )
    return event, delay
La première condition demande un masque booléen, au moins une position réelle par trace et aucun retour de False vers True. Ainsi, [True, True, False, False] convient, mais [True, False, True, False] est refusé : le contenu réel doit former un préfixe continu.
event et delay sont initialisés à zéro. Les calculs ne sont ensuite exécutés que sur les éléments sélectionnés par mask. Le point important est sélectionner avant de calculer, et non calculer partout puis multiplier par zéro : un NaN, valeur numérique indéfinie, reste problématique même multiplié par zéro. Un NaN situé dans une cible de padding ne doit pas contaminer les pertes réelles.
Cette fonction retourne deux tableaux de pertes ; elle n’effectue pas encore la moyenne finale. La boucle du projet moyenne d’abord les positions de chaque trace, puis les traces du lot. Une trace longue ne pèse donc pas davantage uniquement parce qu’elle comporte plus d’étapes.
Exemple pédagogique : une trace de deux positions avec perte 2 partout et une trace de huit positions avec perte 1 partout donnent une moyenne par trace de (2 + 1) / 2 = 1,5. Moyennées directement sur les dix positions, elles donneraient (2 × 2 + 8 × 1) / 10 = 1,2. Ce ne sont pas les mêmes pondérations.
Les contrôles visibles concernent le masque. Ils ne constituent pas, à eux seuls, une validation exhaustive de toutes les formes, valeurs et dispersions que l’on pourrait transmettre directement à components().
Revenir aux secondes : une médiane, pas une moyenne
Le parcours utilise expm1(mu), c’est-à-dire exp(mu) − 1, pour revenir à une durée. Dans cette approximation gaussienne de z, c’est une médiane conditionnelle : elle partage la distribution prévue en deux moitiés, compte tenu du préfixe. Ce n’est pas sa moyenne.
Dans notre exemple mu = log(11) et sigma = 0,5, la médiane vaut 10 secondes, tandis que la moyenne de la variable transformée vaudrait exp(mu + sigma² / 2) − 1, soit environ 11,4646 secondes. La transformation logarithmique rend ces deux résumés différents. La documentation SciPy de la loi lognormale permet d’approfondir la transformation exponentielle d’une gaussienne ; nous retranchons ici 1 pour retrouver le délai.
Autre nuance : la NLL publiée est calculée dans l’espace z, pas directement comme une densité en secondes. Changer de variable dans une densité demanderait un facteur 1 / (1 + délai), appelé Jacobien ; son opposé du logarithme ajoute log(1 + délai) à la NLL, avec la constante gaussienne pour la forme complète. Nous ne faisons pas ce changement dans le score r004 : le modifier changerait le détecteur et sa calibration.
Pourquoi comparer quatre méthodes ?
La méthode règles encode les transitions du simulateur. C’est une référence explicite, qui dispose de cette connaissance du générateur ; ce n’est pas une politique métier universelle.
Le bigramme compte les transitions entre deux événements successifs dans train. Il apprend une fréquence locale sans conserver tout le préfixe. Son lissage additif de 1 ajoute un pseudo-compte aux possibilités : une transition jamais observée ne reçoit pas automatiquement une probabilité nulle. Par exemple, avec 12 transitions sortantes et huit suites possibles, une suite encore absente recevrait (0 + 1) / (12 + 8) = 0,05.
Le LSTM événement minimise seulement l’entropie croisée. Le LSTM joint minimise l’entropie croisée plus 0,1 fois la NLL de délai. Tous reçoivent les mêmes préfixes disponibles, même s’ils n’en exploitent pas toute l’information de la même façon. Le LSTM événement conserve notamment les entrées décrites plus haut : son nom désigne son objectif d’apprentissage, pas la suppression du délai passé en entrée.
Le poids 0,1 concerne l’entraînement. Nous rencontrerons plus loin un poids 0,5 pour construire le score d’alerte : ces deux nombres n’ont pas le même rôle.
Reproduire le parcours complet
Étape 1 — préparer et vérifier le calcul dans Docker
Vous devez pouvoir lire du Python, manipuler des tableaux et utiliser un terminal avec Docker. Les notions de probabilités et de tenseurs servent aux calculs que nous venons de détailler. Le parcours utilise FP32 sur CUDA : des nombres flottants sur 32 bits, calculés sur un GPU NVIDIA.
Décompressez le ZIP dans un nouveau dossier et placez le terminal à sa racine. Toutes les commandes suivantes partent de ce répertoire. Conservez les versions et les ressources prévues par les fichiers du projet ; les extraits de l’article ne remplacent pas son environnement complet.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference calibration
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Le préflight vérifie Docker, le GPU, la mémoire et le disque. setup.sh prépare l’environnement du projet ; docker compose config --quiet contrôle la configuration, puis build construit les services.
L’étape acquisition ne télécharge ici aucun modèle préentraîné : locks/models.lock.json ne déclare aucun fichier externe. Le réseau est initialisé localement et entraîné sur les traces. Cette étape est conservée pour contrôler les actifs du parcours, pas pour récupérer un grand modèle de langage.
check_environment.py exécute réellement un LSTM et ses gradients dans Docker. Un GPU visible sur l’hôte ne suffit donc pas. Le gradient indique comment la perte varie lorsque les paramètres changent ; c’est ce qui permet de les ajuster pendant l’apprentissage. Les tests pytest vérifient ensuite les comportements du programme, indépendamment des métriques de détection.
À observer : chaque commande doit réussir avant la suivante. Ne remplacez pas un échec de calcul dans le conteneur par la seule présence du GPU dans Linux.
Étape 2 — préparer les traces et examiner le mécanisme
docker compose run --rm tutorial python -m ged_anomalies_workflows.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m ged_anomalies_workflows.cli baseline --config configs/minimum.yaml
docker compose run --rm inference python -m ged_anomalies_workflows.cli inspect-mechanism --config configs/minimum.yaml
prepare construit le corpus. Retrouvez les populations annoncées, les partitions temporelles et les contrôles de source, notamment le point de décompte signalé plus haut. baseline fournit les références simples ; inspect-mechanism permet d’examiner les calculs avant l’entraînement complet.
Suivez un préfixe : quelle information est disponible, quel événement sert de cible et à quel intervalle correspond le délai ? Cette lecture évite de découvrir seulement à la fin qu’une colonne contenait une réponse future.
Étape 3 — entraîner, noter et calibrer
sh scripts/train_variants.sh
docker compose run --rm inference python -m ged_anomalies_workflows.cli score --config configs/minimum.yaml
docker compose run --rm calibration python -m ged_anomalies_workflows.cli calibrate --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_anomalies_workflows.cli evaluate --config configs/minimum.yaml
train_variants.sh orchestre les entraînements des deux LSTM. score applique les modèles aux préfixes. calibrate fixe les seuils sur les traces normales de validation. Enfin, evaluate mesure les résultats. Les explications suivantes détaillent ce que signifient ces sorties ; conservez-les avant de lancer l’exercice.
L’apprentissage utilise AdamW, avec un taux de 0,003, un weight decay de 0,001, un clipping de norme 1, des lots de 32 traces et 25 époques. Le protocole effectue 27 mises à jour par époque. Les deux LSTM partagent la seed 17.
Une époque est un passage sur l’ensemble d’entraînement ; un lot, ou batch, regroupe plusieurs traces pour un calcul. L’optimiseur ajuste les paramètres après ce calcul. Le taux règle l’échelle de la mise à jour, et le weight decay ajoute une réduction des poids selon la règle d’AdamW. Le clipping de norme limite la norme du gradient utilisé : il ne signifie pas « chaque poids doit rester inférieur à 1 ».
Vérifier une reprise, pas seulement un score proche
Le parcours compare un entraînement continu de 25 époques à une interruption après dix époques, suivie d’une reprise de quinze. Un checkpoint est une sauvegarde de l’état nécessaire pour continuer : modèle, optimiseur, ordre d’échantillonnage des données (sampler), générateurs aléatoires (RNG) et historique.
Recharger uniquement les poids n’est pas suffisant pour reproduire exactement la suite. De même, deux entraînements qui terminent avec le même rappel ne sont pas nécessairement identiques. La reprise doit retrouver les états prévus par le protocole. La documentation PyTorch sur la reproductibilité rappelle aussi que l’identité numérique n’est pas garantie après un changement de plateforme ou de version.
Les checkpoints locaux sont considérés comme des états de confiance. L’audit public recharge des poids JSON et des sorties de préfixes, sans charger de pickle externe. Ce choix décrit ce parcours ; ne remplacez pas ces fichiers par un checkpoint téléchargé arbitrairement.
Calibrer un score comparable avant le test
Mettre les deux composantes à une échelle utilisable
Nous disposons maintenant de plusieurs mesures de surprise, mais pas encore d’une règle d’alerte. La méthode règles donne 0 ou 1. Le bigramme et le LSTM événement utilisent la surprise de l’événement observé.
Pour le LSTM joint, additionner directement l’entropie croisée et la NLL de délai ferait dépendre le résultat de leurs échelles numériques. Le projet les centre et réduit séparément, en utilisant uniquement la moyenne et l’écart-type calculés sur les préfixes normaux de train :
composante standardisée = (valeur − moyenne_train) / écart_type_train
On soustrait le niveau habituel, puis on divise par la dispersion habituelle. Un résultat de 2 signifie « deux écarts-types au-dessus de la moyenne d’entraînement », pas « deux fois plus dangereux ».
Le score joint additionne ensuite les deux composantes standardisées avec le poids fixe de 0,5 prévu par le parcours. Cette pondération appartient à la construction du score, pas à la perte d’entraînement pondérée à 0,1.
Exemple pédagogique, avec des paramètres fictifs : une surprise événement de 1,4, une moyenne de 1 et un écart-type de 0,2 donnent 2. Une NLL de délai de 1,5, une moyenne de −0,5 et un écart-type de 1 donnent également 2. Les deux composantes sont désormais exprimées relativement à leur dispersion habituelle. Appliquer un poids de 0,5 à une composante de 2 ramène sa contribution à 1. Ces calculs illustrent la standardisation et la pondération ; l’assemblage exécuté reste celui de la commande score du ZIP. Les valeurs négatives ne sont pas effacées avant la standardisation.
Une composante constante ou non finie est refusée. Une dispersion nulle empêcherait cette division ; remplacer discrètement le résultat par zéro masquerait le problème. Les statistiques ne sont pas recalculées sur le test pour rendre ses scores plus favorables.
Passer du préfixe à la trace
Le score d’une trace est le maximum de ses scores causaux : une seule transition très surprenante peut suffire. Pendant une lecture progressive, il s’agit du maximum des scores déjà calculables ; le score final utilise tous les préfixes observés.
Ce choix a une conséquence simple : une trace longue offre plus d’occasions d’obtenir un score élevé. L’évaluation conserve donc des strates de longueur, autrement dit des groupes de traces de tailles comparables. Une bonne moyenne globale pourrait cacher davantage de faux positifs sur les dossiers longs.
Le quantile à 95 % : un rang exact, pas une promesse
Chaque méthode trie les scores de ses 90 traces normales de validation et retient la valeur d’indice ceil(0,95 × 90) − 1. ceil arrondit vers l’entier supérieur : ceil(85,5) − 1 = 85. Avec des indices commençant à zéro, cela désigne la 86e valeur dans l’ordre croissant.
L’alerte exige ensuite score > seuil. Une égalité n’alerte pas. Si toutes les valeurs étaient distinctes, seules les quatre valeurs situées après la 86e dépasseraient le seuil sur cette validation : 4 / 90 ≈ 4,44 %. Avec des égalités, il peut y en avoir moins.
Ce détail empêche deux contresens. Le quantile empirique à 95 % ne signifie pas « exactement 5 % de faux positifs », et encore moins « jamais plus de 5 % sur les futurs dossiers ». Il définit une procédure reproductible sur un échantillon donné.
Les anomalies de validation ne servent pas à choisir ce seuil. Le test vient ensuite. Cette calibration ne transforme pas non plus le score en probabilité d’incident : les seuils restent propres aux échelles des méthodes. Un changement de pratique ou des dépendances temporelles peuvent modifier leur comportement.
Lire les métriques avant les résultats
Précision, rappel et faux positifs : trois questions différentes
Une trace perturbée correctement signalée est un vrai positif. Une trace normale qui alerte est un faux positif. Une perturbation non signalée est un faux négatif.
Reprenons un petit exemple : sur dix traces perturbées, huit alertent ; une trace normale alerte aussi. La précision vaut 8 / 9 : parmi les neuf alertes, combien correspondent à une perturbation ? Le rappel vaut 8 / 10 : parmi les dix perturbations, combien ont été repérées ?
Le taux de faux positifs divise, lui, le nombre de traces normales signalées par le nombre total de traces normales. Il n’est pas égal à 1 − précision, dont le dénominateur est le nombre d’alertes.
Ces mesures évaluent la détection des perturbations définies par le générateur. Elles ne notent ni la gravité d’un dossier ni la responsabilité d’une personne.
L’average precision mesure un classement, pas un seul seuil
L’average precision, ou AP, examine ce qui se passe lorsque l’on descend le seuil dans le classement des scores. Chaque groupe nouvellement inclus change la précision et le rappel. L’AP additionne les précisions pondérées par les gains de rappel : AP = somme(gain_de_rappel × précision). La documentation scikit-learn donne cette définition ; elle ne remplace pas l’évaluateur du ZIP et n’ajoute aucune dépendance au parcours.
Ici, les scores égaux sont traités ensemble. Imaginez seulement deux traces de score identique, l’une perturbée et l’autre normale. Aucun seuil ne permet de prendre la première sans la seconde. Les départager artificiellement en plaçant la perturbation avant la normale embellirait le classement sans information supplémentaire.
Une AP de 1 et un faux positif au seuil retenu peuvent coexister. Si toutes les perturbations sont mieux classées que les traces normales, le classement est parfait ; un seuil fixé auparavant sur validation peut néanmoins être assez bas pour inclure aussi une trace normale. On ne le remonte pas après avoir regardé le test.
Deux sens différents du mot délai
L’erreur de prédiction du délai s’exprime ici en secondes. Elle compare la durée prévue à la durée effectivement observée.
Le délai de détection, lui, est exprimé en nombre d’événements après la perturbation. Une médiane de 0 signifie que la détection ne demande pas d’événement supplémentaire pour au moins la moitié des cas détectés, selon ce repère. Cela ne signifie ni zéro seconde d’attente, ni zéro milliseconde de calcul, ni une anticipation de la perturbation.
Cette médiane ne porte que sur les cas détectés. Une méthode pourrait détecter rapidement quelques cas et en manquer beaucoup d’autres : il faut donc la lire avec le rappel. Les alertes avant perturbation méritent également une inspection séparée, plutôt que d’être assimilées à de bonnes anticipations.
Résultats : une amélioration synthétique à interpréter avec prudence
Les décisions au seuil fixé sur validation
Le test comprend 90 traces normales et 90 perturbées. La part de perturbations est donc de 50 % : c’est une prévalence artificielle, pas un chiffre observé en production.
Voici les comptes et les taux du parcours r004. Les faux négatifs du tableau sont déduits des 90 perturbations et des détections publiées ; les taux sont arrondis à six décimales.
Sur mobile, faites défiler le tableau horizontalement.
| Méthode | Perturbations détectées | Perturbations manquées | Faux positifs | Rappel | Précision | Taux de faux positifs |
|---|---|---|---|---|---|---|
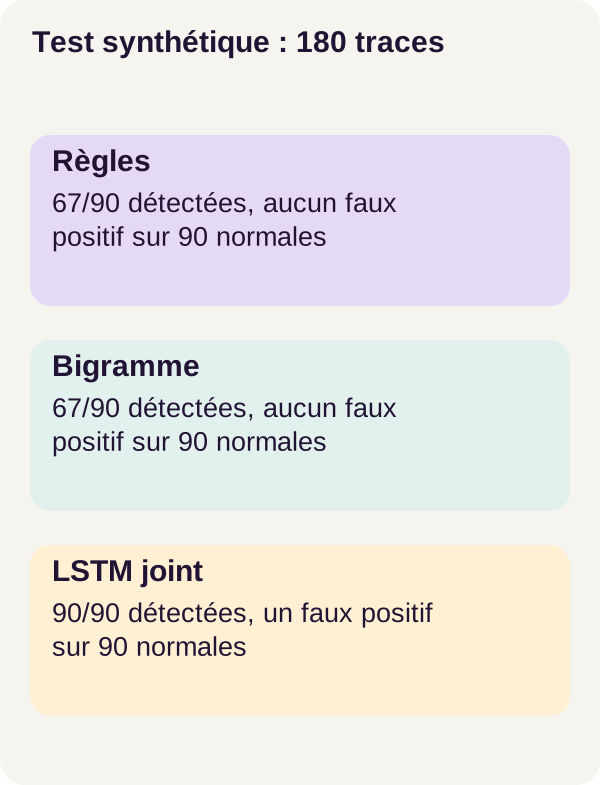
| Règles | 67/90 | 23 | 0/90 | 0,744444 | 1 | 0 |
| Bigramme | 67/90 | 23 | 0/90 | 0,744444 | 1 | 0 |
| LSTM événement | 67/90 | 23 | 4/90 | 0,744444 | 0,943662 | 0,044444 |
| LSTM joint événement+délai | 90/90 | 0 | 1/90 | 1 | 0,989011 | 0,011111 |
Le modèle joint retrouve toutes les perturbations de ce test, avec une fausse alerte. Sa précision vaut 90 / 91 = 0,989011, tandis que son taux de faux positifs vaut 1 / 90 = 0,011111. Le LSTM événement retrouve autant de perturbations que les méthodes simples, mais ajoute quatre faux positifs : sa complexité n’apporte pas de gain sur ces décisions.
La médiane de délai de détection du joint vaut 0 événement parmi les cas détectés. Les trois autres méthodes laissent chacune 23 perturbations non détectées après le changement.
Le classement et les erreurs de prédiction
Les seuils et AP publiés sont les suivants. Les seuils ne se comparent pas comme une échelle commune de gravité.
| Méthode | Seuil | Average precision, environ |
|---|---|---|
| Règles | 0 | 0,872222 |
| Bigramme | 1,391023 | 0,887963 |
| LSTM événement | 1,386817 | 0,905482 |
| LSTM joint événement+délai | 4,284417 | 1 |
Le cas des règles permet de comprendre leur AP. Le score 1 regroupe 67 perturbations, sans trace normale : la précision est 1 et le rappel atteint 67 / 90. En ajoutant le groupe de score 0, on inclut les 23 perturbations restantes et les 90 traces normales : la précision devient 0,5. L’AP vaut donc 67 / 90 × 1 + 23 / 90 × 0,5 ≈ 0,872222. Ce calcul est dérivé des comptes publiés, pas d’une nouvelle exécution.
Sur les 1 198 préfixes de test, l’entropie croisée moyenne est de 1,494473 pour le modèle événement et de 1,290952 pour le joint. L’erreur absolue médiane du délai du joint est de 8,026882 secondes. Ce sont des mesures de prévision sur ce corpus ; une entropie croisée de 1,29 n’est pas une proportion de 129 %.
Le modèle joint améliore donc la détection dans cette expérience. Le tableau ne donne toutefois pas le détail des 23 perturbations manquées par les autres méthodes : il ne permet pas, à lui seul, d’affirmer que chacune est un délai allongé.
Pourquoi 98,9 % de précision ne se transporte pas en production
Faisons un calcul purement illustratif, sans supposer que le modèle conserverait ses performances sur de vrais dossiers. Sur 10 000 traces dont seulement 100 seraient perturbées, imaginons un rappel de 1 et le même taux de faux positifs de 1 / 90.
Le système signalerait les 100 perturbations, mais aussi 9 900 / 90 = 110 traces normales. La précision serait alors 100 / (100 + 110) ≈ 47,62 %, et non 98,9 %.
Les taux supposés n’ont pas changé ; la population, si. C’est pourquoi les résultats du test équilibré ne permettent pas de prévoir seuls la charge d’une file de revue humaine.
Exercice : une nouvelle pratique normale
Prédire avant de lancer
L’équipe accepte maintenant une double boucle REVISION → REVUE comme pratique normale. Nous ne réentraînons pas le modèle et ne recalibrons pas le seuil. Un réseau qui a rarement rencontré cette répétition peut-il continuer à la considérer comme suspecte ? Une règle qui vérifie seulement les transitions locales réagira-t-elle forcément de la même façon ?
Écrivez votre hypothèse pour les quatre méthodes, puis lancez l’exercice. Les résultats initiaux et la calibration sont conservés et contrôlés par empreinte, ou hash, afin de ne pas les remplacer discrètement.
docker compose run --rm tutorial python -m ged_anomalies_workflows.cli exercise --config configs/minimum.yaml
Comparer à la correction du parcours
Les 60 traces de l’exercice sont désormais normales. Les règles et le bigramme n’en signalent aucune. Les deux LSTM les signalent toutes : 60 faux positifs sur 60, soit 100 % dans cet ensemble.
Ce résultat ne contredit pas le bon score du joint au test. Le détecteur a appris une certaine fréquence des parcours ; la pratique a changé sans que son apprentissage ni son seuil changent. Une suite peut donc être peu attendue statistiquement et parfaitement acceptable pour l’équipe.
Les transitions locales peuvent déjà être admises, alors que leur répétition dans un historique plus long reste inhabituelle pour le modèle séquentiel. C’est une interprétation du mécanisme à confronter aux sorties, pas une explication causale complète de chaque alerte.
L’exercice ne demande pas de relever le seuil jusqu’à faire disparaître ces alertes. Il demande de qualifier la nouvelle pratique, créer une nouvelle révision et prévoir un ensemble de contrôle séparé. Réentraîner ou recalibrer après cette décision constituera une nouvelle expérience, dont le résultat n’est pas annoncé ici.
Produisez ensuite les figures et contrôlez les checkpoints, avant de nettoyer :
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Dépanner, nettoyer et préparer la production
Conserver les erreurs utiles
Si Docker ne rend pas le GPU disponible, suivez le diagnostic du préflight, puis relancez dans un nouveau dossier extrait. Le contrôle d’environnement doit réussir son calcul dans le conteneur ; l’état du GPU sur l’hôte ne le remplace pas.
Si une trace est refusée pour une durée négative, un événement inconnu ou un ordre source dupliqué, inspectez l’export avant le modèle. Ne contournez pas le refus avec un tri qui ferait disparaître l’incohérence initiale.
Si la reprise diffère du parcours continu, conservez les checkpoints pour inspection. Comparez les états restaurés et les versions, plutôt que de vous satisfaire d’un score final proche. Avant toute suppression, gardez les résultats et figures utiles.
Nettoyer seulement ce qui est prévu
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Le premier docker compose down arrête les services du projet. Le script affiche puis supprime uniquement outputs; le dernier arrêt termine le parcours. Il ne supprime ni modèles, ni données, ni volumes globaux, ni autres projets. Aucun nettoyage Docker général n’est requis.
L’isolation du parcours a un périmètre précis
Les services utilisent un système de fichiers racine en lecture seule, aucune capacité Linux supplémentaire, no-new-privileges, des limites CPU, mémoire et processus, ainsi qu’un répertoire temporaire en tmpfs. Les rôles apprentissage, inférence et calibration ne montent que les ressources nécessaires à leurs opérations.
Ces restrictions limitent les accès et les ressources disponibles. Elles ne signifient pas qu’aucune sortie ne peut être écrite : les emplacements nécessaires sont prévus selon les rôles. De même, l’absence de téléchargement de poids tiers ne signifie pas que la construction de l’image est sans réseau : elle peut résoudre les dépendances définies dans le fichier de build. Les calculs du modèle sont, eux, isolés du réseau.
Cette séparation réduit notamment les risques de lecture accidentelle des labels dans l’exercice. Elle n’est ni une protection contre un administrateur Docker ni une certification de sécurité.
Concevoir une alerte que quelqu’un peut traiter
Dans une application réelle, il faudrait présenter le préfixe observé, l’événement et le délai concernés, le score, le seuil et leurs versions. Cela permettrait à un opérateur de comprendre ce qui a déclenché l’alerte, sans prétendre que le modèle explique la cause du retard ou de la répétition. Cette interface est un travail de produit à ajouter, pas une fonctionnalité déjà démontrée ici.
Une supervision réelle doit aussi gérer les fuseaux horaires, les arrivées tardives, les événements concurrents et l’identité des dossiers. Un ordre total pratique pour un tableau de données ne décrit pas toute la causalité d’un workflow parallèle. Si deux opérations sont simultanées, les ordonner par convention ne prouve pas que l’une a causé l’autre.
Il reste à ajouter authentification, droits, filtrage, API, file de revue humaine, versionnage des modèles, observabilité, tests de charge, sauvegarde et évaluation métier. Il faut surtout définir qui reçoit une alerte, quel contexte lui est accessible, comment elle est clôturée et ce que coûte une fausse alerte ou une perturbation manquée.
Un changement de processus demande une revue métier, une version des règles, un nouvel entraînement lorsqu’il est justifié et un jeu de contrôle séparé. Les analyses par longueur et les alertes avant perturbation aident à diagnostiquer le système ; elles ne remplacent pas cette décision humaine.
Aucune alerte de ce tutoriel n’automatise une action sur une personne ou un dossier. Le détecteur constitue un outil de tri pour examiner des parcours, pas un arbitre administratif.
Synthèse
Nous avons construit un modèle qui apprend à prédire la suite d’un journal normal, plutôt qu’à reconnaître directement une liste de fautes. Le LSTM garde un contexte séquentiel, ses deux têtes prévoient l’événement et le délai, et les pertes mesurent l’écart avec ce qui arrive effectivement.
Le masque évite d’apprendre sur le remplissage. Les statistiques d’entraînement rendent les composantes du score utilisables ensemble. La validation fixe le seuil avant le test, avec une règle stricte pour les égalités. Enfin, précision, rappel, classement et délai de détection répondent à des questions distinctes.
Le joint détecte les 90 perturbations du test synthétique avec un faux positif. Pourtant, les deux LSTM signalent les 60 traces de la nouvelle pratique normale. Apprendre ce qui est fréquent n’est pas apprendre ce qui est autorisé. C’est cette distinction qui doit accompagner l’alerte jusqu’à l’interface et à la personne chargée de l’examiner.
Sources primaires et compléments
Les références du parcours sont la documentation PyTorch de LSTM, celle de cross_entropy et l’étude de Brown et al. sur les logs. Cette dernière étudie des réseaux récurrents avec attention pour détecter des anomalies dans des journaux système ; elle fournit un contexte de recherche, pas les résultats de ce corpus documentaire ni une architecture d’attention ajoutée au code présenté.
Les liens complémentaires intégrés dans les explications documentent les embeddings, les transformations numériques, la perte gaussienne, AdamW, la reproductibilité et l’average precision. Ils éclairent les mécanismes et les exemples de calcul ; ils ne constituent pas de nouvelles exécutions du projet. Pour reproduire r004, conservez les fichiers et les versions du ZIP.