





Imagine el registro de actividad de un back office: se importa un documento, se indexa, se asigna a un equipo y después se envía a revisión. La mayoría de los expedientes siguen recorridos bastante regulares. Pero algunos se saltan una etapa, vuelven varias veces a revisión o tardan mucho más en avanzar.
Podría escribir una serie de condiciones para detectarlos. Pero ¿cómo distinguir un recorrido realmente inusual de una variante normal que sus reglas no habían previsto? ¿Y qué ocurre si el equipo cambia su forma de trabajar?
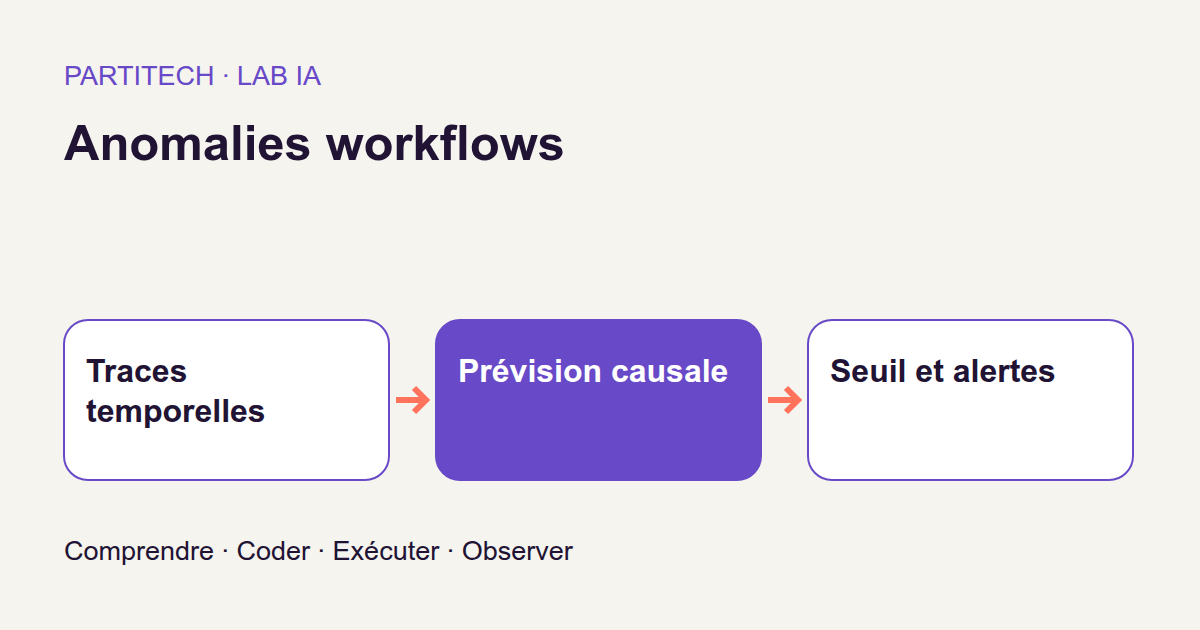
Vamos a construir un detector que aprende a predecir el siguiente evento y su demora, y después compara esa previsión con lo que sucede realmente. Cuando la sorpresa es suficiente, señala el expediente para revisarlo. No decide ni que una persona haya cometido una falta ni que un documento no cumpla los requisitos.
El recorrido es concreto: registro de eventos → prefijo observado → predicción → medida de sorpresa → umbral → alerta que examinar. Entrenaremos una pequeña red recurrente, la compararemos con dos métodos simples y probaremos su reacción ante una práctica nueva pero aceptable.
El modelo no recibe identidades, familias de expedientes ni marcas de tiempo absolutas. Los datos son sintéticos: permiten un experimento controlado, no medir la frecuencia de incidentes en una empresa. Los pequeños ejemplos de cálculo añadidos a lo largo del artículo son pedagógicos; los resultados de referencia r004 se presentan por separado.
Descargar el proyecto completo, revisión r004
Definir una anomalía como una sorpresa, no como un incumplimiento
Leer una traza como un registro de aplicación
Un GED, o gestor electrónico de documentos, conserva los documentos y las operaciones que les conciernen. Un workflow es su recorrido entre distintas etapas. Una traza es la secuencia ordenada de eventos de un mismo expediente; un prefijo es el inicio de esa secuencia, hasta una posición determinada.
El vocabulario del proyecto contiene ocho eventos: IMPORT, INDEXATION, AFFECTATION, REVUE, REVISION, APPROBATION, PUBLICATION y ARCHIVAGE. Cuatro roles ficticios indican el rol asociado al evento, sin proporcionar una identidad individual.
Tomemos este prefijo ilustrativo: IMPORT → INDEXATION → AFFECTATION → REVUE. En ese momento sabemos que se ha producido la revisión. Todavía no sabemos si la siguiente etapa será una revisión adicional o una aprobación, ni cuánto tiempo tardará.
Una traza normal del simulador puede incluir REVISION → REVUE y puede omitir la publicación. Por tanto, no hay que equiparar cualquier bucle o etapa ausente con un error. Las perturbaciones introducidas —salto, bucle, permutación y demora prolongada— sirven para probar el detector en este corpus. No definen una política documental universal.
Separar el aprendizaje, el ajuste y la medición
El modelo aprende los recorridos normales en el conjunto de entrenamiento, llamado train. El conjunto de validación sirve aquí para fijar el umbral de alerta. Después, el test mide la regla obtenida, sin reajustar ese umbral para mejorar las cifras.
Las poblaciones descritas explícitamente en el protocolo son las siguientes:
| Conjunto | Trazas normales | Trazas perturbadas enumeradas explícitamente |
|---|---|---|
| Entrenamiento | 840 | Ninguna en el aprendizaje descrito |
| Validación utilizada para el umbral | 90 | No utilizadas para elegir el umbral |
| Test | 90 | 90 |
Punto de atención sobre el recuento total. Se anuncia que el corpus comprende 120 familias de diez trazas, es decir, 1.200 trazas. Los efectivos enumerados explícitamente arriba suman 1.110 trazas. La descripción proporcionada no precisa la asignación de las 90 restantes: este punto debe verificarse en la generación del corpus. Conservamos las poblaciones anunciadas para el aprendizaje, la calibración y el test, sin completar esta diferencia con una distribución supuesta.
La separación también respeta el tiempo: el entrenamiento precede a la validación, que precede al test. Cada familia tiene su propia ventana temporal. Los expedientes, las trazas y las ventanas no cruzan entre conjuntos, también llamados splits.
Esto no significa que las secuencias de símbolos sean completamente distintas. Un inicio como IMPORT → INDEXATION puede aparecer en todas partes. Con solo ocho eventos, prohibir cualquier prefijo común crearía un problema artificial. Deben permanecer separados los expedientes y sus ventanas, no el vocabulario necesario para describir su actividad.
Rechazar una fuente no válida antes de buscar una anomalía
El programa distingue un dato mal formado de un evento poco frecuente. Una duración negativa, un tipo de evento desconocido o un orden de origen duplicado invalidan la entrada antes del cálculo estadístico.
Se permiten marcas de tiempo iguales. El orden de origen, que permite desempatar los eventos, fija entonces su sucesión. Por tanto, una demora nula es una observación válida, no una anomalía automática.
El flujo se comprueba como no decreciente antes de la ordenación estable. ¿Por qué este orden de tratamiento? Supongamos, a modo de ejemplo, que una exportación muestra las 10:05 y después las 10:02. Ordenar inmediatamente las filas daría una cronología aparentemente correcta, ocultando la incoherencia de la fuente. El recorrido prefiere señalar el problema antes que transformarlo en una sorpresa estadística.
Lo que sabe el modelo en cada instante
En la posición actual recibe tres informaciones: el evento, su rol y la demora ya transcurrida desde el evento anterior. Esta demora se transforma en log1p(demora) / 10.
log1p(x) calcula el logaritmo natural de 1 + x. El logaritmo comprime los valores grandes; sumar 1 también permite utilizar una demora nula. Con duraciones ilustrativas de 9, 99 y 999 segundos, la entrada temporal vale respectivamente aproximadamente 0,2303, 0,4605 y 0,6908. Así que la red no recibe directamente 9, 99 y 999. La documentación de torch.log1p precisa este cálculo.
Atención al desfase: la demora de entrada se refiere al pasado; la que se predice se refiere a la etapa siguiente. El modelo no recibe ese evento siguiente, ni su rol, ni el tipo de perturbación, ni el ID del expediente, ni su familia, ni el tiempo absoluto. Los eventos futuros sirven como objetivos de aprendizaje, no como entradas en la misma posición.
Una alerta sobre esta transición solo puede calcularse tras la llegada del siguiente evento. Si llega después de una espera larga, el programa puede comparar entonces la demora observada con su previsión. En cambio, este recorrido no proporciona una alarma que se active durante una espera todavía en curso. Habría que diseñar y evaluar un mecanismo adicional.
Aquí, causal significa «sin leer el futuro». No significa «capaz de explicar la causa de negocio». Una prueba modifica un sufijo futuro —el final de la traza— y verifica que las puntuaciones brutas del prefijo sin cambios no varían.
El modelo causal y sus dos cabezas
Un pequeño estado que avanza con el expediente
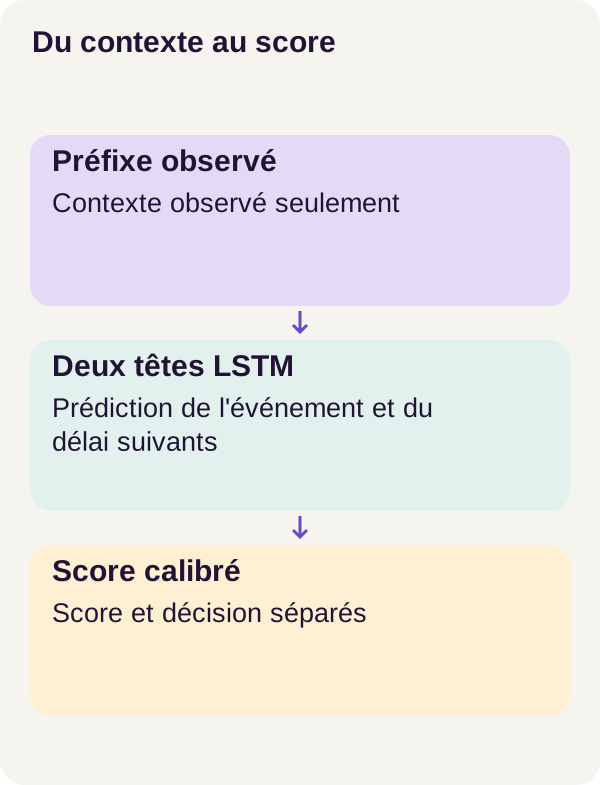
Un LSTM, por Long Short-Term Memory, es una red que procesa una secuencia en orden y actualiza un estado numérico en cada posición. Imagine una función que recorre una tabla de eventos mientras conserva un resumen de lo que ha leído. Aquí se aprende la manera de construir ese resumen, en lugar de escribirla como una serie de condiciones.
El LSTM del proyecto es unidireccional, con 64 unidades. Lee únicamente hacia adelante. Su estado se inicializa a cero para cada expediente: el resumen del expediente anterior no se convierte en el contexto del siguiente. Los mecanismos internos y los estados del LSTM se describen en la documentación de PyTorch 2.8.
Antes de esta lectura, las categorías se convierten en vectores. Un embedding es aquí una fila de una tabla de números aprendidos: cada evento obtiene 16 valores y cada rol 8. No se trata de comprender lingüísticamente la palabra REVUE, sino de aprender una representación útil de su categoría. La documentación de Embedding describe este principio de tabla de correspondencia.
Al añadir el valor temporal, obtenemos 16 + 8 + 1 = 25 números por posición. El LSTM los transforma en un estado de 64 valores. Dos cabezas, es decir, dos pequeñas capas de salida, usan ese mismo estado: una predice el siguiente evento y la otra los parámetros de la siguiente demora.
Seguir las dimensiones en el código
Este es el primer extracto del proyecto, conservado tal cual:
import torch
from torch import nn
import torch.nn.functional as F
from .events import make_prefix_targets


class SequenceModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.events = nn.Embedding(8, 16)
        self.roles = nn.Embedding(4, 8)
        self.lstm = nn.LSTM(25, 64, batch_first=True)
        self.event_head = nn.Linear(64, 8)
        self.delay_head = nn.Linear(64, 2)

    def forward(self, event, role, previous):
        x = torch.cat(
            [self.events(event), self.roles(role), previous.unsqueeze(-1)], -1
        )
        # No state argument: every batch starts fresh, no state crosses cases.
        hidden, _ = self.lstm(x)
        logits = self.event_head(hidden)
        parameters = self.delay_head(hidden)
        return logits, parameters[..., 0], F.softplus(parameters[..., 1]) + 0.001
Un tensor es una tabla numérica que puede tener varios ejes. Para leer este código, llamemos B al número de trazas del lote y T al número de posiciones después del relleno. Los nombres de eventos y roles se convierten en identificadores enteros; event, role y previous tienen cada uno la forma [B, T].
self.events(event) devuelve [B, T, 16], y self.roles(role) devuelve [B, T, 8]. previous.unsqueeze(-1) añade un eje a la demora para obtener [B, T, 1]. Por último, torch.cat(..., -1) reúne estos tres bloques en el último eje: volvemos a encontrar [B, T, 25].
batch_first=True significa que el primer eje designa el lote. hidden contiene después un estado de 64 valores en cada posición, por tanto [B, T, 64], y no solo un resumen final por traza. La ausencia de estado transmitido a self.lstm(x) reinicializa los estados en esta llamada; el modelo no conserva automáticamente una sesión de una llamada a otra.
La cabeza event_head produce [B, T, 8]: ocho logits, o puntuaciones brutas, para los ocho eventos. Estos números todavía no son probabilidades. La cabeza delay_head produce [B, T, 2], cuyas componentes se convierten en mu y raw_sigma.
mu describe el centro de la distribución prevista de log(1 + demora). sigma describe su dispersión, en forma de desviación estándar: un valor pequeño expresa una previsión temporal más concentrada.
La última línea usa softplus(raw_sigma) + 0.001 para mantener una dispersión positiva. Softplus es una transformación suave basada en log(1 + exp(x)); permite que la red aprenda sin autorizar una desviación estándar negativa. Esta restricción se aplica a sigma, no a mu: el extracto no limita directamente la demora obtenida al reconvertir mu.
Aprender el siguiente evento: penalizar la sorpresa
Durante el entrenamiento, el programa conoce el evento que sigue a cada prefijo normal. Pide al modelo que le asigne una probabilidad alta. La función de pérdida, o loss, es el número que el aprendizaje intenta reducir.
Para la parte del evento utilizamos la entropía cruzada, o cross-entropy. Con un objetivo categórico, corresponde a −log(probabilidad del evento realmente observado).
Ejemplo pedagógico: si el modelo asigna una probabilidad de 0,8 al evento que sucede, su pérdida vale aproximadamente 0,2231. Si le asigna solo 0,05, vale aproximadamente 2,9957. Cuanto más improbable se consideraba lo que ocurre, mayor es la sorpresa.
El código pasa directamente los logits a F.cross_entropy, que realiza el cálculo adecuado. No es necesario aplicar antes un softmax en este extracto. Con reduction="none", conservamos una pérdida por posición, en lugar de obtener de inmediato una media global.
Aprender la demora sin confundir sus dos escalas
El objetivo temporal es z = log(1 + demora siguiente). Este objetivo no se divide por diez. La división por diez solo se aplicaba a la característica de la demora anterior proporcionada como entrada.
El modelo aproxima z mediante una distribución gaussiana, una curva de campana con centro mu y desviación estándar sigma. El cálculo de la pérdida temporal es:
NLL_demora = log(sigma) + (z − mu)² / (2 × sigma²)
NLL significa negative log-likelihood, u opuesto del logaritmo de la verosimilitud. El término al cuadrado penaliza la distancia entre el objetivo y el centro previsto, en relación con la dispersión anunciada. log(sigma) evita que ampliar indefinidamente esta dispersión resulte gratuito. La constante de la gaussiana se omite, de acuerdo con el recorrido. La documentación de GaussianNLLLoss presenta la fórmula general con la varianza; aquí esta varianza vale sigma² y el cálculo se escribe directamente.
Tomemos un ejemplo numérico distinto de las salidas entrenadas: mu = log(11) y sigma = 0,5. Una demora observada de 10 segundos da z = mu, por lo que la pérdida es aproximadamente −0,6931. Una demora de 30 segundos da aproximadamente 1,4538. Está más alejada del centro anunciado y recibe una penalización mayor.
Una pérdida temporal negativa no es una probabilidad negativa. Trabajamos con una densidad continua, no con la probabilidad de una categoría; la altura de una densidad puede superar 1 y aquí se ha retirado la constante. Por tanto, no convierta esta NLL en un «porcentaje de riesgo».
La máscara: no aprender sobre el relleno
Las trazas no tienen todas la misma longitud. Para colocarlas en un lote rectangular, se añade padding, o relleno, a la derecha. La máscara booleana indica las posiciones reales que poseen un objetivo: True para una posición útil, False para una posición añadida.
La construcción del lote, situada entre los dos extractos del archivo fuente, prepara los tensores y esta máscara. La función siguiente recibe estos datos:
def components(logits, mu, sigma, targets, z, mask):
    if (
        mask.dtype != torch.bool
        or not mask.any(1).all()
        or ((mask[:, 1:] & ~mask[:, :-1]).any())
    ):
        raise ValueError("Nonempty real prefix mask required")
    # Select before calculating: a padded NaN target cannot contaminate loss.
    event = torch.zeros_like(mu)
    delay = torch.zeros_like(mu)
    event[mask] = F.cross_entropy(logits[mask], targets[mask], reduction="none")
    delay[mask] = torch.log(sigma[mask]) + (z[mask] - mu[mask]).square() / (
        2 * sigma[mask].square()
    )
    return event, delay
La primera condición exige una máscara booleana, al menos una posición real por traza y ningún regreso de False a True. Así, [True, True, False, False] es válido, pero [True, False, True, False] se rechaza: el contenido real debe formar un prefijo continuo.
event y delay se inicializan a cero. Los cálculos se ejecutan después solo sobre los elementos seleccionados por mask. El punto importante es seleccionar antes de calcular, y no calcular en todas partes para luego multiplicar por cero: un NaN, valor numérico indefinido, sigue siendo problemático incluso multiplicado por cero. Un NaN en un objetivo de padding no debe contaminar las pérdidas reales.
Esta función devuelve dos tablas de pérdidas; todavía no realiza la media final. El bucle del proyecto promedia primero las posiciones de cada traza y después las trazas del lote. Así, una traza larga no pesa más solo porque contiene más etapas.
Ejemplo pedagógico: una traza de dos posiciones con pérdida 2 en todas partes y una traza de ocho posiciones con pérdida 1 en todas partes dan una media por traza de (2 + 1) / 2 = 1,5. Si se promediaran directamente las diez posiciones, darían (2 × 2 + 8 × 1) / 10 = 1,2. No son las mismas ponderaciones.
Los controles visibles se refieren a la máscara. Por sí solos no constituyen una validación exhaustiva de todas las formas, valores y dispersiones que se podrían transmitir directamente a components().
Volver a los segundos: una mediana, no una media
El recorrido utiliza expm1(mu), es decir, exp(mu) − 1, para volver a una duración. En esta aproximación gaussiana de z, se trata de una mediana condicional: divide la distribución prevista en dos mitades, dado el prefijo. No es su media.
En nuestro ejemplo mu = log(11) y sigma = 0,5, la mediana vale 10 segundos, mientras que la media de la variable transformada valdría exp(mu + sigma² / 2) − 1, es decir, aproximadamente 11,4646 segundos. La transformación logarítmica hace que estos dos resúmenes sean distintos. La documentación de SciPy sobre la distribución lognormal permite profundizar en la transformación exponencial de una gaussiana; aquí restamos 1 para recuperar la demora.
Otro matiz: la NLL publicada se calcula en el espacio z, no directamente como una densidad en segundos. Cambiar de variable en una densidad requeriría un factor 1 / (1 + demora), llamado jacobiano; su opuesto del logaritmo añade log(1 + demora) a la NLL, junto con la constante gaussiana para la forma completa. No hacemos este cambio en la puntuación r004: modificarlo cambiaría el detector y su calibración.
¿Por qué comparar cuatro métodos?
El método de reglas codifica las transiciones del simulador. Es una referencia explícita, que dispone de ese conocimiento del generador; no es una política de negocio universal.
El bigrama cuenta las transiciones entre dos eventos sucesivos en train. Aprende una frecuencia local sin conservar todo el prefijo. Su suavizado aditivo de 1 añade un seudoconteo a las posibilidades: una transición nunca observada no recibe automáticamente una probabilidad nula. Por ejemplo, con 12 transiciones salientes y ocho continuaciones posibles, una continuación aún ausente recibiría (0 + 1) / (12 + 8) = 0,05.
El LSTM de eventos minimiza solo la entropía cruzada. El LSTM conjunto minimiza la entropía cruzada más 0,1 veces la NLL de demora. Todos reciben los mismos prefijos disponibles, aunque no aprovechen toda la información de la misma manera. El LSTM de eventos conserva en particular las entradas descritas antes: su nombre designa su objetivo de aprendizaje, no la eliminación de la demora pasada de entrada.
El peso 0,1 se refiere al entrenamiento. Más adelante encontraremos un peso 0,5 para construir la puntuación de alerta: estos dos números no tienen la misma función.
Reproducir el recorrido completo
Paso 1 — preparar y verificar el cálculo en Docker
Debe poder leer Python, manipular tablas y usar una terminal con Docker. Las nociones de probabilidades y tensores sirven para los cálculos que acabamos de detallar. El recorrido utiliza FP32 sobre CUDA: números de coma flotante de 32 bits calculados en una GPU NVIDIA.
Descomprima el ZIP en una carpeta nueva y sitúe la terminal en su raíz. Todos los comandos siguientes parten de este directorio. Conserve las versiones y los recursos previstos por los archivos del proyecto; los extractos del artículo no sustituyen su entorno completo.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference calibration
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
El preflight verifica Docker, la GPU, la memoria y el disco. setup.sh prepara el entorno del proyecto; docker compose config --quiet controla la configuración y luego build construye los servicios.
La etapa acquisition no descarga aquí ningún modelo preentrenado: locks/models.lock.json no declara ningún archivo externo. La red se inicializa localmente y se entrena con las trazas. Esta etapa se conserva para controlar los activos del recorrido, no para recuperar un gran modelo de lenguaje.
check_environment.py ejecuta realmente un LSTM y sus gradientes en Docker. Por tanto, no basta con que haya una GPU visible en el host. El gradiente indica cómo varía la pérdida cuando cambian los parámetros; eso permite ajustarlos durante el aprendizaje. Después, las pruebas pytest verifican los comportamientos del programa, independientemente de las métricas de detección.
Para observar: cada comando debe ejecutarse correctamente antes del siguiente. No sustituya un fallo de cálculo en el contenedor por la mera presencia de la GPU en Linux.
Paso 2 — preparar las trazas y examinar el mecanismo
docker compose run --rm tutorial python -m ged_anomalies_workflows.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m ged_anomalies_workflows.cli baseline --config configs/minimum.yaml
docker compose run --rm inference python -m ged_anomalies_workflows.cli inspect-mechanism --config configs/minimum.yaml
prepare construye el corpus. Localice las poblaciones anunciadas, las particiones temporales y los controles de fuente, en particular el punto de recuento señalado antes. baseline proporciona las referencias simples; inspect-mechanism permite examinar los cálculos antes del entrenamiento completo.
Siga un prefijo: ¿qué información está disponible, qué evento sirve de objetivo y a qué intervalo corresponde la demora? Esta lectura evita descubrir solo al final que una columna contenía una respuesta futura.
Paso 3 — entrenar, puntuar y calibrar
sh scripts/train_variants.sh
docker compose run --rm inference python -m ged_anomalies_workflows.cli score --config configs/minimum.yaml
docker compose run --rm calibration python -m ged_anomalies_workflows.cli calibrate --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_anomalies_workflows.cli evaluate --config configs/minimum.yaml
train_variants.sh orquesta los entrenamientos de los dos LSTM. score aplica los modelos a los prefijos. calibrate fija los umbrales sobre las trazas normales de validación. Por último, evaluate mide los resultados. Las explicaciones siguientes detallan el significado de estas salidas; consérvelas antes de realizar el ejercicio.
El aprendizaje utiliza AdamW, con una tasa de 0,003, un weight decay de 0,001, clipping de norma 1, lotes de 32 trazas y 25 épocas. El protocolo realiza 27 actualizaciones por época. Los dos LSTM comparten la semilla 17.
Una época es un paso por el conjunto de entrenamiento; un lote, o batch, agrupa varias trazas para un cálculo. El optimizador ajusta los parámetros después de este cálculo. La tasa regula la escala de la actualización, y el weight decay añade una reducción de los pesos según la regla de AdamW. El clipping de norma limita la norma del gradiente utilizado: no significa «cada peso debe permanecer por debajo de 1».
Verificar una reanudación, no solo una puntuación cercana
El recorrido compara un entrenamiento continuo de 25 épocas con una interrupción tras diez épocas, seguida de una reanudación de quince. Un checkpoint es una copia del estado necesario para continuar: modelo, optimizador, orden de muestreo de los datos (sampler), generadores aleatorios (RNG) e historial.
Recargar únicamente los pesos no basta para reproducir exactamente la continuación. Del mismo modo, dos entrenamientos que terminan con el mismo recall no son necesariamente idénticos. La reanudación debe recuperar los estados previstos por el protocolo. La documentación de PyTorch sobre reproducibilidad también recuerda que la identidad numérica no está garantizada tras un cambio de plataforma o versión.
Los checkpoints locales se consideran estados de confianza. La auditoría pública recarga pesos JSON y salidas de prefijos, sin cargar un pickle externo. Esta elección describe este recorrido; no sustituya estos archivos por un checkpoint descargado arbitrariamente.
Calibrar una puntuación comparable antes del test
Llevar los dos componentes a una escala utilizable
Ahora disponemos de varias medidas de sorpresa, pero todavía no de una regla de alerta. El método de reglas da 0 o 1. El bigrama y el LSTM de eventos utilizan la sorpresa del evento observado.
Para el LSTM conjunto, sumar directamente la entropía cruzada y la NLL de demora haría que el resultado dependiera de sus escalas numéricas. El proyecto las centra y reduce por separado, utilizando únicamente la media y la desviación estándar calculadas sobre los prefijos normales de train:
componente estandarizado = (valor − media_train) / desviación_estándar_train
Se resta el nivel habitual y después se divide por la dispersión habitual. Un resultado de 2 significa «dos desviaciones estándar por encima de la media de entrenamiento», no «dos veces más peligroso».
La puntuación conjunta suma después los dos componentes estandarizados con el peso fijo de 0,5 previsto por el recorrido. Esta ponderación pertenece a la construcción de la puntuación, no a la pérdida de entrenamiento ponderada con 0,1.
Ejemplo pedagógico, con parámetros ficticios: una sorpresa de evento de 1,4, una media de 1 y una desviación estándar de 0,2 dan 2. Una NLL de demora de 1,5, una media de −0,5 y una desviación estándar de 1 también dan 2. Ambos componentes se expresan ahora en relación con su dispersión habitual. Aplicar un peso de 0,5 a un componente de 2 reduce su contribución a 1. Estos cálculos ilustran la estandarización y la ponderación; el ensamblaje ejecutado sigue siendo el de la orden score del ZIP. Los valores negativos no se eliminan antes de la estandarización.
Se rechaza un componente constante o no finito. Una dispersión nula impediría esta división; sustituir discretamente el resultado por cero ocultaría el problema. Las estadísticas no se recalculan sobre el test para hacer que sus puntuaciones resulten más favorables.
Pasar del prefijo a la traza
La puntuación de una traza es el máximo de sus puntuaciones causales: una única transición muy sorprendente puede bastar. Durante una lectura progresiva, se trata del máximo de las puntuaciones que ya se pueden calcular; la puntuación final utiliza todos los prefijos observados.
Esta elección tiene una consecuencia sencilla: una traza larga ofrece más oportunidades de obtener una puntuación alta. La evaluación conserva por tanto estratos de longitud, es decir, grupos de trazas de tamaños comparables. Una buena media global podría ocultar más falsos positivos en los expedientes largos.
El cuantil del 95 %: un rango exacto, no una promesa
Cada método ordena las puntuaciones de sus 90 trazas normales de validación y retiene el valor de índice ceil(0,95 × 90) − 1. ceil redondea al entero superior: ceil(85,5) − 1 = 85. Con índices que comienzan en cero, esto designa el 86.º valor en orden ascendente.
La alerta exige después puntuación > umbral. Una igualdad no genera alerta. Si todos los valores fueran distintos, solo los cuatro valores situados después del 86.º superarían el umbral en esta validación: 4 / 90 ≈ 4,44 %. Con empates puede haber menos.
Este detalle evita dos malentendidos. El cuantil empírico del 95 % no significa «exactamente un 5 % de falsos positivos», y mucho menos «nunca más de un 5 % en los futuros expedientes». Define un procedimiento reproducible sobre una muestra dada.
Las anomalías de validación no se usan para elegir este umbral. Después llega el test. Esta calibración tampoco transforma la puntuación en una probabilidad de incidente: los umbrales siguen siendo propios de las escalas de los métodos. Un cambio de práctica o dependencias temporales pueden modificar su comportamiento.
Leer las métricas antes de los resultados
Precisión, recall y falsos positivos: tres preguntas distintas
Una traza perturbada correctamente señalada es un verdadero positivo. Una traza normal que genera una alerta es un falso positivo. Una perturbación no señalada es un falso negativo.
Retomemos un pequeño ejemplo: de diez trazas perturbadas, ocho generan alerta; una traza normal también genera una alerta. La precisión vale 8 / 9: de las nueve alertas, ¿cuántas corresponden a una perturbación? El recall vale 8 / 10: de las diez perturbaciones, ¿cuántas se han detectado?
La tasa de falsos positivos divide el número de trazas normales señaladas entre el número total de trazas normales. No es igual a 1 − precisión, cuyo denominador es el número de alertas.
Estas medidas evalúan la detección de las perturbaciones definidas por el generador. No puntúan ni la gravedad de un expediente ni la responsabilidad de una persona.
La average precision mide una clasificación, no un único umbral
La average precision, o AP, examina lo que ocurre cuando se baja el umbral en la clasificación de las puntuaciones. Cada grupo incluido recientemente cambia la precisión y el recall. La AP suma las precisiones ponderadas por los aumentos de recall: AP = suma(aumento_de_recall × precisión). La documentación de scikit-learn da esta definición; no sustituye al evaluador del ZIP ni añade ninguna dependencia al recorrido.
Aquí, las puntuaciones iguales se tratan juntas. Imagine solo dos trazas con la misma puntuación, una perturbada y otra normal. Ningún umbral permite tomar la primera sin la segunda. Desempatarlas artificialmente colocando la perturbada antes que la normal embellecería la clasificación sin información adicional.
Una AP de 1 y un falso positivo en el umbral elegido pueden coexistir. Si todas las perturbaciones se clasifican mejor que las trazas normales, la clasificación es perfecta; sin embargo, un umbral fijado antes en validación puede ser lo bastante bajo para incluir también una traza normal. No se eleva después de observar el test.
Dos sentidos distintos de la palabra demora
El error de predicción de la demora se expresa aquí en segundos. Compara la duración prevista con la duración realmente observada.
La demora de detección, en cambio, se expresa en número de eventos después de la perturbación. Una mediana de 0 significa que la detección no requiere ningún evento adicional para al menos la mitad de los casos detectados, según esta referencia. No significa ni cero segundos de espera, ni cero milisegundos de cálculo, ni una anticipación de la perturbación.
Esta mediana se refiere solo a los casos detectados. Un método puede detectar pronto algunos casos y pasar por alto muchos otros; por tanto, debe leerse junto con la sensibilidad. Las alertas anteriores a la perturbación también merecen una revisión aparte, en vez de considerarlas buenas anticipaciones.
Resultados: una mejora sintética que debe interpretarse con cautela
Las decisiones con el umbral fijado en validación
El test incluye 90 trazas normales y 90 perturbadas. La proporción de perturbaciones es, por tanto, del 50 %: se trata de una prevalencia artificial, no de una cifra observada en producción.
Estos son los recuentos y las tasas del recorrido r004. Los falsos negativos de la tabla se deducen de las 90 perturbaciones y de las detecciones publicadas; las tasas se redondean a seis decimales.
En móvil, desplace la tabla horizontalmente.
| Método | Perturbaciones detectadas | Perturbaciones no detectadas | Falsos positivos | Sensibilidad | Precisión | Tasa de falsos positivos |
|---|---|---|---|---|---|---|
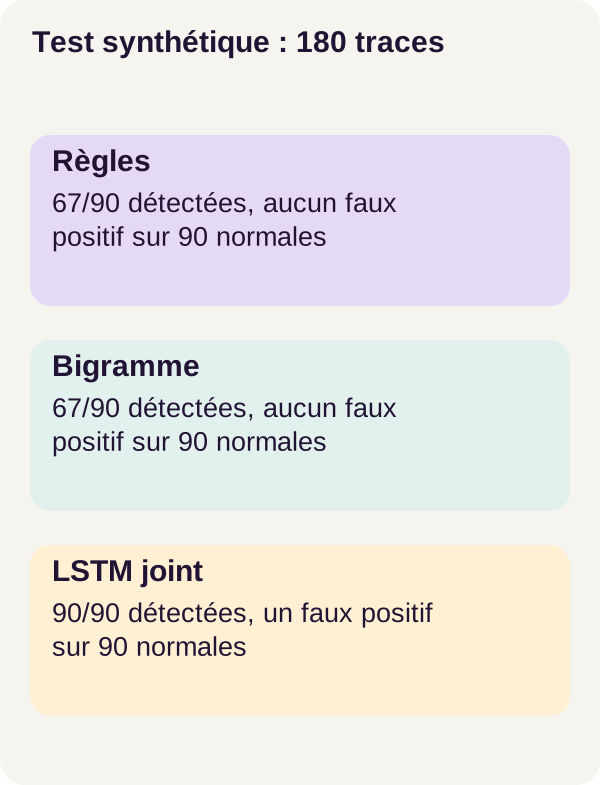
| Reglas | 67/90 | 23 | 0/90 | 0,744444 | 1 | 0 |
| Bigrama | 67/90 | 23 | 0/90 | 0,744444 | 1 | 0 |
| LSTM de eventos | 67/90 | 23 | 4/90 | 0,744444 | 0,943662 | 0,044444 |
| LSTM conjunto evento+demora | 90/90 | 0 | 1/90 | 1 | 0,989011 | 0,011111 |
El modelo conjunto recupera todas las perturbaciones de este test, con una alerta falsa. Su precisión es 90 / 91 = 0,989011, mientras que su tasa de falsos positivos es 1 / 90 = 0,011111. El LSTM de eventos recupera tantas perturbaciones como los métodos simples, pero añade cuatro falsos positivos: su complejidad no aporta una mejora en estas decisiones.
La mediana de la demora de detección del modelo conjunto es de 0 eventos entre los casos detectados. Los otros tres métodos dejan cada uno 23 perturbaciones sin detectar después del cambio.
La clasificación y los errores de predicción
Los umbrales y las AP publicados son los siguientes. Los umbrales no se comparan como una escala común de gravedad.
| Método | Umbral | Average precision, aproximadamente |
|---|---|---|
| Reglas | 0 | 0,872222 |
| Bigrama | 1,391023 | 0,887963 |
| LSTM de eventos | 1,386817 | 0,905482 |
| LSTM conjunto evento+demora | 4,284417 | 1 |
El caso de las reglas permite comprender su AP. La puntuación 1 reúne 67 perturbaciones, sin ninguna traza normal: la precisión es 1 y la sensibilidad alcanza 67 / 90. Al añadir el grupo con puntuación 0, se incluyen las 23 perturbaciones restantes y las 90 trazas normales: la precisión pasa a 0,5. Por tanto, la AP es 67 / 90 × 1 + 23 / 90 × 0,5 ≈ 0,872222. Este cálculo se deriva de los recuentos publicados, no de una nueva ejecución.
En los 1 198 prefijos de test, la entropía cruzada media es 1,494473 para el modelo de eventos y 1,290952 para el conjunto. El error absoluto mediano de la demora del conjunto es de 8,026882 segundos. Son medidas de predicción sobre este corpus; una entropía cruzada de 1,29 no es una proporción del 129 %.
El modelo conjunto mejora, por tanto, la detección en este experimento. Sin embargo, la tabla no detalla las 23 perturbaciones que los otros métodos no detectaron: por sí sola no permite afirmar que cada una sea una demora alargada.
Por qué una precisión del 98,9 % no se traslada a producción
Hagamos un cálculo puramente ilustrativo, sin suponer que el modelo mantendría sus prestaciones con expedientes reales. En 10 000 trazas de las que solo 100 estuvieran perturbadas, imaginemos una sensibilidad de 1 y la misma tasa de falsos positivos de 1 / 90.
El sistema señalaría las 100 perturbaciones, pero también 9 900 / 90 = 110 trazas normales. La precisión sería entonces 100 / (100 + 110) ≈ 47,62 %, y no 98,9 %.
Las tasas supuestas no han cambiado; sí lo ha hecho la población. Por eso, los resultados del test equilibrado no bastan para predecir la carga de una cola de revisión humana.
Ejercicio: una nueva práctica normal
Predecir antes de ejecutar
El equipo acepta ahora un doble bucle REVISION → REVUE como práctica normal. No reentrenamos el modelo ni recalibramos el umbral. ¿Puede una red que rara vez ha encontrado esta repetición seguir considerándola sospechosa? ¿Una regla que solo comprueba transiciones locales reaccionará necesariamente igual?
Escriba su hipótesis para los cuatro métodos y ejecute el ejercicio. Los resultados iniciales y la calibración se conservan y se controlan mediante una huella, o hash, para no sustituirlos discretamente.
docker compose run --rm tutorial python -m ged_anomalies_workflows.cli exercise --config configs/minimum.yaml
Comparar con la corrección del recorrido
Las 60 trazas del ejercicio son ahora normales. Las reglas y el bigrama no señalan ninguna. Los dos LSTM las señalan todas: 60 falsos positivos de 60, es decir, el 100 % en este conjunto.
Este resultado no contradice la buena puntuación del modelo conjunto en el test. El detector aprendió cierta frecuencia de recorridos; la práctica cambió sin que cambiaran su aprendizaje ni su umbral. Una secuencia puede ser estadísticamente poco esperada y perfectamente aceptable para el equipo.
Las transiciones locales ya pueden estar admitidas, mientras que su repetición en un historial más largo sigue siendo inusual para el modelo secuencial. Es una interpretación del mecanismo que debe contrastarse con las salidas, no una explicación causal completa de cada alerta.
El ejercicio no pide elevar el umbral hasta hacer desaparecer estas alertas. Pide calificar la nueva práctica, crear una nueva revisión y prever un conjunto de control separado. Reentrenar o recalibrar después de esa decisión constituirá un experimento nuevo, cuyo resultado no se anuncia aquí.
Genere después las figuras y compruebe los checkpoints antes de limpiar:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Solucionar problemas, limpiar y preparar la producción
Conservar los errores útiles
Si Docker no pone la GPU a disposición, siga el diagnóstico del preflight y vuelva a ejecutar el recorrido en una carpeta recién extraída. La comprobación del entorno debe completar su cálculo en el contenedor; el estado de la GPU en el host no la sustituye.
Si se rechaza una traza por una duración negativa, un evento desconocido o un orden de origen duplicado, inspeccione la exportación antes que el modelo. No eluda el rechazo con una ordenación que haría desaparecer la incoherencia inicial.
Si la reanudación difiere del recorrido continuo, conserve los checkpoints para inspeccionarlos. Compare los estados restaurados y las versiones, en vez de conformarse con una puntuación final parecida. Antes de borrar nada, guarde los resultados y las figuras útiles.
Limpiar solo lo previsto
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
El primer docker compose down detiene los servicios del proyecto. El script muestra y después elimina únicamente outputs; la última detención termina el recorrido. No elimina modelos, datos, volúmenes globales ni otros proyectos. No se requiere una limpieza general de Docker.
El aislamiento del recorrido tiene un perímetro preciso
Los servicios usan un sistema de archivos raíz de solo lectura, ninguna capacidad Linux adicional, no-new-privileges, límites de CPU, memoria y procesos, así como un directorio temporal en tmpfs. Los roles de aprendizaje, inferencia y calibración solo montan los recursos necesarios para sus operaciones.
Estas restricciones limitan los accesos y los recursos disponibles. No significan que no pueda escribirse ninguna salida: los lugares necesarios están previstos según los roles. Asimismo, la ausencia de descarga de pesos de terceros no significa que la construcción de la imagen no tenga red: puede resolver las dependencias definidas en el archivo de build. Los cálculos del modelo sí están aislados de la red.
Esta separación reduce, en particular, los riesgos de leer accidentalmente las etiquetas en el ejercicio. No es una protección frente a un administrador de Docker ni una certificación de seguridad.
Diseñar una alerta que alguien pueda tratar
En una aplicación real habría que mostrar el prefijo observado, el evento y la demora implicados, la puntuación, el umbral y sus versiones. Esto permitiría a un operador entender qué activó la alerta, sin afirmar que el modelo explica la causa del retraso o de la repetición. Esta interfaz es trabajo de producto que queda por añadir, no una funcionalidad ya demostrada aquí.
Una supervisión real también debe gestionar las zonas horarias, las llegadas tardías, los eventos concurrentes y la identidad de los expedientes. Un orden total práctico para una tabla de datos no describe toda la causalidad de un flujo de trabajo paralelo. Si dos operaciones son simultáneas, ordenarlas por convención no prueba que una haya causado la otra.
Quedan por añadir autenticación, permisos, filtrado, API, cola de revisión humana, versionado de modelos, observabilidad, pruebas de carga, copia de seguridad y evaluación de negocio. Sobre todo, hay que definir quién recibe una alerta, a qué contexto tiene acceso, cómo se cierra y qué cuesta una falsa alerta o una perturbación no detectada.
Un cambio de proceso exige una revisión de negocio, una versión de las reglas, un nuevo entrenamiento cuando esté justificado y un conjunto de control separado. Los análisis por longitud y las alertas antes de la perturbación ayudan a diagnosticar el sistema; no sustituyen esa decisión humana.
Ninguna alerta de este tutorial automatiza una acción sobre una persona o un expediente. El detector es una herramienta de clasificación para examinar recorridos, no un árbitro administrativo.
Síntesis
Hemos construido un modelo que aprende a predecir la continuación de un registro normal, en vez de reconocer directamente una lista de faltas. El LSTM conserva un contexto secuencial, sus dos cabezas predicen el evento y la demora, y las pérdidas miden la diferencia con lo que ocurre realmente.
La máscara evita aprender sobre el relleno. Las estadísticas de entrenamiento hacen que los componentes de la puntuación puedan utilizarse juntos. La validación fija el umbral antes del test, con una regla estricta para las igualdades. Por último, precisión, sensibilidad, clasificación y demora de detección responden a preguntas distintas.
El modelo conjunto detecta las 90 perturbaciones del test sintético con un falso positivo. Sin embargo, ambos LSTM señalan las 60 trazas de la nueva práctica normal. Aprender lo que es frecuente no equivale a aprender lo que está permitido. Esta distinción debe acompañar la alerta hasta la interfaz y hasta la persona encargada de examinarla.
Fuentes primarias y complementos
Las referencias del recorrido son la documentación de PyTorch sobre LSTM, la de cross_entropy y el estudio de Brown et al. sobre logs. Este último estudia redes recurrentes con atención para detectar anomalías en registros de sistemas; aporta un contexto de investigación, no los resultados de este corpus documental ni una arquitectura de atención añadida al código presentado.
Los enlaces complementarios integrados en las explicaciones documentan los embeddings, las transformaciones numéricas, la pérdida gaussiana, AdamW, la reproducibilidad y la average precision. Aclaran los mecanismos y los ejemplos de cálculo; no constituyen nuevas ejecuciones del proyecto. Para reproducir r004, conserve los archivos y las versiones del ZIP.