





Immaginate il registro delle attività di un back office: un documento viene importato, indicizzato, assegnato a un team, quindi inviato in revisione. La maggior parte delle pratiche segue percorsi piuttosto regolari. Alcune, però, saltano una fase, tornano più volte in revisione o impiegano molto più tempo per avanzare.
Potreste scrivere una serie di condizioni per individuarle. Ma come distinguere un percorso davvero insolito da una variante normale che le vostre regole non avevano previsto? E cosa succede se il team cambia il proprio modo di lavorare?
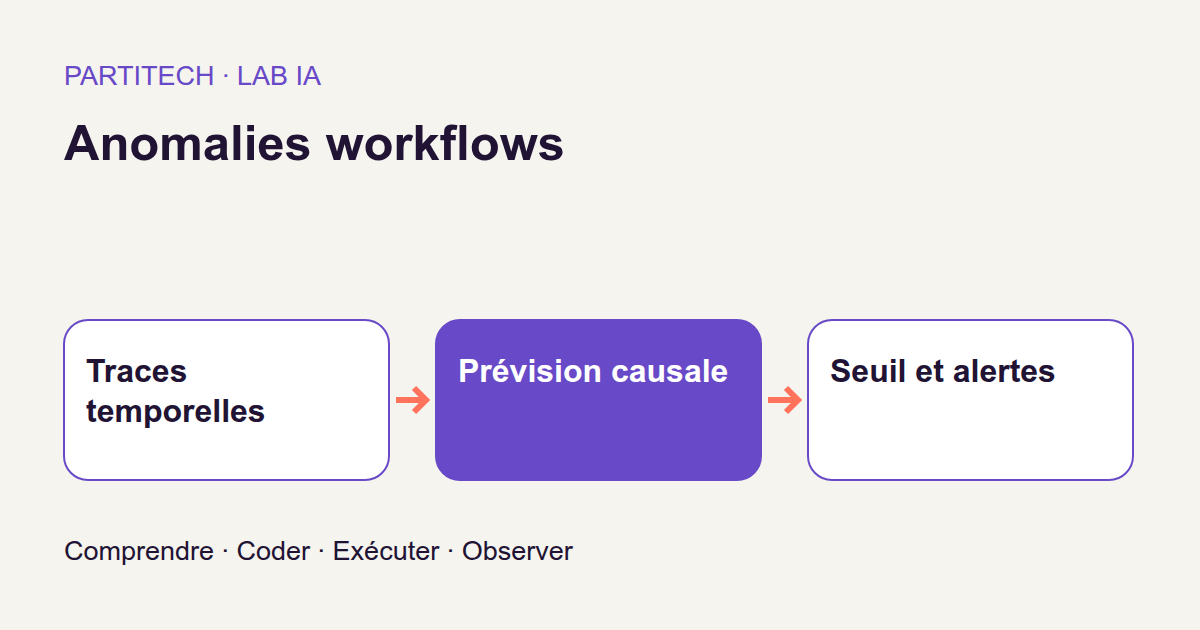
Costruiremo un rilevatore che impara a prevedere l'evento successivo e il suo ritardo, quindi confronta questa previsione con ciò che accade realmente. Quando è sufficientemente sorpreso, segnala la pratica per una verifica. Non decide né che una persona abbia commesso un errore, né che un documento non sia conforme.
Il percorso è concreto: registro degli eventi → prefisso osservato → previsione → misura della sorpresa → soglia → avviso da esaminare. Addestreremo una piccola rete ricorrente, la confronteremo con due metodi semplici e testeremo la sua reazione a una nuova pratica comunque accettabile.
Il modello non riceve né le identità, né le famiglie delle pratiche, né le marche temporali assolute. I dati sono sintetici: permettono un esperimento controllato, non di misurare la frequenza degli incidenti in un'azienda. I piccoli esempi di calcolo inseriti nell'articolo sono didattici; i risultati di riferimento r004 sono presentati separatamente.
Scaricare il progetto completo, revisione r004
Definire un'anomalia come sorpresa, non come non conformità
Leggere una traccia come un registro applicativo
Una GED, o gestione elettronica dei documenti, conserva i documenti e le operazioni che li riguardano. Un workflow è il loro percorso tra fasi diverse. Una traccia è la successione ordinata degli eventi di una stessa pratica; un prefisso è l'inizio di questa successione, fino a una determinata posizione.
Il vocabolario del progetto contiene otto eventi: IMPORT, INDEXATION, AFFECTATION, REVUE, REVISION, APPROBATION, PUBLICATION e ARCHIVAGE. Quattro ruoli fittizi indicano il ruolo associato all'evento, senza fornire un'identità individuale.
Prendiamo questo prefisso illustrativo: IMPORT → INDEXATION → AFFECTATION → REVUE. In questo momento sappiamo che la revisione ha avuto luogo. Non sappiamo ancora se la fase successiva sarà una revisione o un'approvazione, né quanto tempo richiederà.
Una traccia normale del simulatore può includere REVISION → REVUE e può omettere la pubblicazione. Non bisogna quindi assimilare ogni ciclo o ogni fase assente a un errore. Le perturbazioni introdotte — salto, ciclo, permutazione e ritardo prolungato — servono a testare il rilevatore in questo corpus. Non definiscono una politica documentale universale.
Separare apprendimento, regolazione e misurazione
Il modello apprende i percorsi normali sull'insieme di addestramento, chiamato train. L'insieme di validazione serve qui a fissare la soglia di avviso. Il test misura poi la regola ottenuta, senza riaggiustare tale soglia per migliorare i numeri.
Le popolazioni descritte esplicitamente nel protocollo sono le seguenti:
| Insieme | Tracce normali | Tracce perturbate conteggiate esplicitamente |
|---|---|---|
| Addestramento | 840 | Nessuna nell'apprendimento descritto |
| Validazione usata per la soglia | 90 | Non usate per scegliere la soglia |
| Test | 90 | 90 |
Punto di attenzione sul conteggio complessivo. Il corpus è annunciato come composto da 120 famiglie di dieci tracce, ossia 1.200 tracce. Gli effettivi conteggiati esplicitamente sopra totalizzano 1.110 tracce. La descrizione fornita non precisa l'assegnazione delle 90 restanti: questo punto resta da verificare nella generazione del corpus. Manteniamo le popolazioni annunciate per apprendimento, calibrazione e test, senza colmare questa differenza con una ripartizione supposta.
La separazione rispetta anche il tempo: l'addestramento precede la validazione, che precede il test. Ogni famiglia possiede la propria finestra temporale. Le pratiche, le tracce e le finestre non attraversano gli insiemi, chiamati anche split.
Questo non significa che le sequenze di simboli siano completamente diverse. Un inizio come IMPORT → INDEXATION può comparire ovunque. Con solo otto eventi, vietare ogni prefisso comune creerebbe un problema artificiale. Sono le pratiche e le loro finestre a dover restare separate, non il vocabolario necessario per descriverne l'attività.
Rifiutare una fonte non valida prima di cercare un'anomalia
Il programma distingue un dato malformato da un evento poco frequente. Una durata negativa, un tipo di evento sconosciuto o un ordine di origine duplicato invalidano l'input prima del calcolo statistico.
Marche temporali uguali sono consentite. L'ordine di origine, che permette di discriminare gli eventi, ne fissa allora la successione. Un ritardo nullo è quindi un'osservazione valida, non un'anomalia automatica.
Il flusso viene verificato come non decrescente prima dell'ordinamento stabile. Perché questo ordine di elaborazione? Supponiamo, a scopo illustrativo, che un'esportazione mostri le 10:05 e poi le 10:02. Ordinare subito le righe darebbe una cronologia apparentemente corretta, nascondendo l'incoerenza della fonte. Il percorso preferisce segnalare il problema piuttosto che trasformarlo in una sorpresa statistica.
Ciò che il modello sa in ogni istante
Nella posizione corrente gli vengono fornite tre informazioni: l'evento, il suo ruolo e il ritardo già trascorso dall'evento precedente. Questo ritardo è trasformato in log1p(ritardo) / 10.
log1p(x) calcola il logaritmo naturale di 1 + x. Il logaritmo comprime i valori grandi; l'aggiunta di 1 rende utilizzabile anche il ritardo nullo. Con durate illustrative di 9, 99 e 999 secondi, l'input temporale vale rispettivamente circa 0,2303, 0,4605 e 0,6908. La rete non riceve quindi direttamente 9, 99 e 999. La documentazione di torch.log1p precisa questo calcolo.
Attenzione allo sfasamento: il ritardo in ingresso riguarda il passato; quello da prevedere riguarda la fase successiva. Il modello non riceve né questo evento successivo, né il suo ruolo, né il tipo di perturbazione, né l'ID della pratica, né la sua famiglia, né il tempo assoluto. Gli eventi futuri servono come obiettivi di apprendimento, non come input nella stessa posizione.
Un avviso su questa transizione può essere calcolato solo dopo l'arrivo dell'evento successivo. Se questo arriva dopo una lunga attesa, il programma può allora confrontare il ritardo osservato con la sua previsione. Questo percorso non fornisce invece un allarme che si attiverebbe durante un'attesa ancora in corso. Sarebbe un meccanismo aggiuntivo da progettare e valutare.
Qui, causale significa «senza leggere il futuro». Non significa «capace di spiegare la causa operativa». Un test modifica un suffisso futuro — la fine della traccia — e verifica che i punteggi grezzi del prefisso invariato non cambino.
Il modello causale e le sue due teste
Un piccolo stato che avanza con la pratica
Un LSTM, per Long Short-Term Memory, è una rete che elabora una sequenza nell'ordine e aggiorna uno stato numerico a ogni posizione. Immaginate una funzione che percorre una tabella di eventi conservando un riepilogo di ciò che ha letto. Qui il modo di costruire questo riepilogo viene appreso, anziché scritto sotto forma di condizioni.
L'LSTM del progetto è unidirezionale, con 64 unità. Legge solo in avanti. Il suo stato viene inizializzato a zero per ogni pratica: il riepilogo della pratica precedente non diventa il contesto della successiva. I meccanismi interni e gli stati dell'LSTM sono descritti nella documentazione PyTorch 2.8.
Prima di questa lettura, le categorie diventano vettori. Un embedding è qui una riga di una tabella di numeri appresi: ogni evento riceve 16 valori, ogni ruolo 8. Non si tratta di comprendere linguisticamente la parola REVUE, ma di apprendere una rappresentazione utile della sua categoria. La documentazione di Embedding descrive questo principio di tabella di corrispondenza.
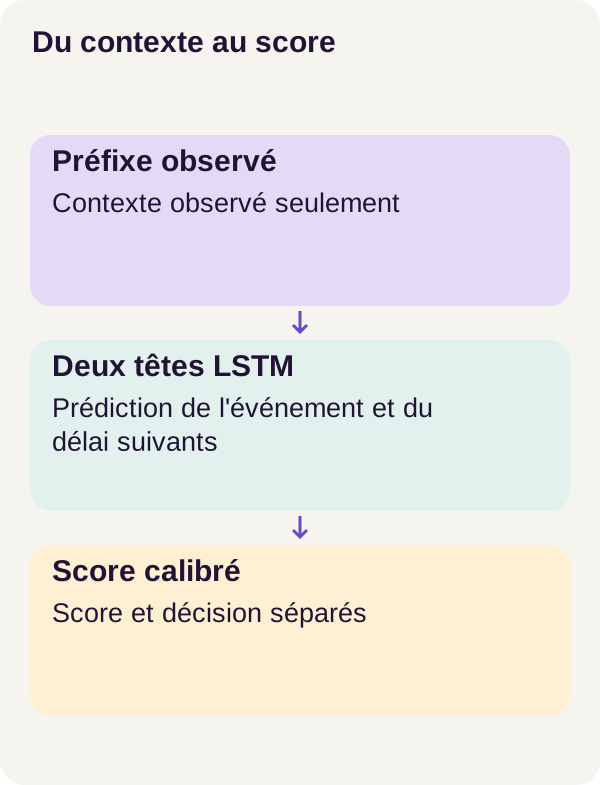
Aggiungendo il valore temporale si ottengono 16 + 8 + 1 = 25 numeri per posizione. L'LSTM li trasforma in uno stato di 64 valori. Due teste, cioè due piccoli livelli di uscita, usano questo stesso stato: una prevede l'evento successivo, l'altra i parametri del ritardo successivo.
Seguire le dimensioni nel codice
Ecco il primo estratto del progetto, conservato così com'è:
import torch
from torch import nn
import torch.nn.functional as F
from .events import make_prefix_targets


class SequenceModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.events = nn.Embedding(8, 16)
        self.roles = nn.Embedding(4, 8)
        self.lstm = nn.LSTM(25, 64, batch_first=True)
        self.event_head = nn.Linear(64, 8)
        self.delay_head = nn.Linear(64, 2)

    def forward(self, event, role, previous):
        x = torch.cat(
            [self.events(event), self.roles(role), previous.unsqueeze(-1)], -1
        )
        # No state argument: every batch starts fresh, no state crosses cases.
        hidden, _ = self.lstm(x)
        logits = self.event_head(hidden)
        parameters = self.delay_head(hidden)
        return logits, parameters[..., 0], F.softplus(parameters[..., 1]) + 0.001
Un tensore è una tabella numerica che può avere più assi. Per leggere questo codice, chiamiamo B il numero di tracce del lotto e T il numero di posizioni dopo il riempimento. I nomi degli eventi e dei ruoli sono convertiti in identificatori interi; event, role e previous hanno ciascuno forma [B, T].
self.events(event) restituisce [B, T, 16] e self.roles(role) restituisce [B, T, 8]. previous.unsqueeze(-1) aggiunge un asse al ritardo per ottenere [B, T, 1]. Infine, torch.cat(..., -1) riunisce questi tre blocchi sull'ultimo asse: ritroviamo [B, T, 25].
batch_first=True significa che il primo asse designa il lotto. hidden contiene poi uno stato di 64 valori a ogni posizione, quindi [B, T, 64], non solo un riepilogo finale per traccia. L'assenza di stato trasmesso a self.lstm(x) reimposta gli stati a questa chiamata; il modello non conserva automaticamente una sessione da una chiamata all'altra.
La testa event_head produce [B, T, 8]: otto logit, o punteggi grezzi, per gli otto eventi. Questi numeri non sono ancora probabilità. La testa delay_head produce [B, T, 2], le cui componenti diventano mu e raw_sigma.
mu descrive il centro della distribuzione prevista di log(1 + ritardo). sigma ne descrive la dispersione, sotto forma di deviazione standard: un valore piccolo esprime una previsione temporale più concentrata.
L'ultima riga usa softplus(raw_sigma) + 0.001 per mantenere una dispersione positiva. Softplus è una trasformazione liscia basata su log(1 + exp(x)); permette alla rete di apprendere senza autorizzare una deviazione standard negativa. Questo vincolo riguarda sigma, non mu: l'estratto non limita direttamente il ritardo ottenuto riconvertendo mu.
Apprendere l'evento successivo: penalizzare la sorpresa
Durante l'addestramento, il programma conosce l'evento che segue ogni prefisso normale. Chiede al modello di assegnargli una probabilità elevata. La funzione di perdita, o loss, è il numero che l'apprendimento cerca di ridurre.
Per la parte evento utilizziamo l'entropia incrociata, o cross-entropy. Con un obiettivo categoriale, corrisponde a −log(probabilità dell'evento realmente osservato).
Esempio didattico: se il modello assegna una probabilità di 0,8 all'evento che si verifica, la sua perdita vale circa 0,2231. Se gli assegna solo 0,05, vale circa 2,9957. Più ciò che accadeva era giudicato improbabile, maggiore è la sorpresa.
Il codice passa direttamente i logit a F.cross_entropy, che esegue il calcolo appropriato. Non è necessario applicare prima un softmax in questo estratto. Con reduction="none", conserviamo una perdita per posizione, invece di ottenere subito una media globale.
Apprendere il ritardo senza confondere le sue due scale
L'obiettivo temporale è z = log(1 + ritardo successivo). Questo obiettivo non viene diviso per dieci. La divisione per dieci riguardava solo la caratteristica del ritardo precedente fornita in ingresso.
Il modello approssima z con una distribuzione gaussiana, una curva a campana con centro mu e deviazione standard sigma. Il calcolo della perdita temporale è:
NLL_ritardo = log(sigma) + (z − mu)² / (2 × sigma²)
NLL significa negative log-likelihood, ossia opposto del logaritmo della verosimiglianza. Il termine al quadrato penalizza lo scarto tra l'obiettivo e il centro previsto, in rapporto alla dispersione dichiarata. log(sigma) evita che allargare indefinitamente questa dispersione sia gratuito. La costante della gaussiana è omessa, conformemente al percorso. La documentazione di GaussianNLLLoss presenta la formula generale con la varianza; qui questa varianza vale sigma² e il calcolo è scritto direttamente.
Prendiamo un esempio numerico distinto dagli output addestrati: mu = log(11) e sigma = 0,5. Un ritardo osservato di 10 secondi dà z = mu, quindi una perdita di circa −0,6931. Un ritardo di 30 secondi dà circa 1,4538. È più lontano dal centro annunciato e riceve una penalità più elevata.
Una perdita temporale negativa non è una probabilità negativa. Lavoriamo con una densità continua, non con la probabilità di una categoria; l'altezza di una densità può superare 1 e qui la costante viene rimossa. Non convertite quindi questa NLL in una «percentuale di rischio».
La maschera: non apprendere sul riempimento
Le tracce non hanno tutte la stessa lunghezza. Per disporle in un lotto rettangolare, si aggiunge del padding, o riempimento, a destra. La maschera booleana indica le posizioni reali che possiedono un obiettivo: True per una posizione utile, False per una posizione aggiunta.
La costruzione del lotto, situata tra i due estratti nel file sorgente, prepara i tensori e questa maschera. La funzione seguente riceve questi dati:
def components(logits, mu, sigma, targets, z, mask):
    if (
        mask.dtype != torch.bool
        or not mask.any(1).all()
        or ((mask[:, 1:] & ~mask[:, :-1]).any())
    ):
        raise ValueError("Nonempty real prefix mask required")
    # Select before calculating: a padded NaN target cannot contaminate loss.
    event = torch.zeros_like(mu)
    delay = torch.zeros_like(mu)
    event[mask] = F.cross_entropy(logits[mask], targets[mask], reduction="none")
    delay[mask] = torch.log(sigma[mask]) + (z[mask] - mu[mask]).square() / (
        2 * sigma[mask].square()
    )
    return event, delay
La prima condizione richiede una maschera booleana, almeno una posizione reale per traccia e nessun ritorno da False a True. Così, [True, True, False, False] va bene, mentre [True, False, True, False] viene rifiutato: il contenuto reale deve formare un prefisso continuo.
event e delay sono inizializzati a zero. I calcoli vengono poi eseguiti solo sugli elementi selezionati da mask. Il punto importante è selezionare prima di calcolare, non calcolare ovunque e poi moltiplicare per zero: un NaN, valore numerico indefinito, resta problematico anche moltiplicato per zero. Un NaN in un obiettivo di padding non deve contaminare le perdite reali.
Questa funzione restituisce due tabelle di perdite; non esegue ancora la media finale. Il ciclo del progetto fa prima la media delle posizioni di ogni traccia, poi delle tracce del lotto. Una traccia lunga non pesa quindi di più soltanto perché comporta più fasi.
Esempio didattico: una traccia di due posizioni con perdita 2 ovunque e una traccia di otto posizioni con perdita 1 ovunque danno una media per traccia di (2 + 1) / 2 = 1,5. Facendo direttamente la media sulle dieci posizioni, darebbero (2 × 2 + 8 × 1) / 10 = 1,2. Non sono le stesse ponderazioni.
I controlli visibili riguardano la maschera. Non costituiscono, da soli, una validazione esaustiva di tutte le forme, i valori e le dispersioni che si potrebbero trasmettere direttamente a components().
Tornare ai secondi: una mediana, non una media
Il percorso usa expm1(mu), cioè exp(mu) − 1, per tornare a una durata. In questa approssimazione gaussiana di z, è una mediana condizionale: divide in due metà la distribuzione prevista, dato il prefisso. Non è la sua media.
Nel nostro esempio mu = log(11) e sigma = 0,5, la mediana vale 10 secondi, mentre la media della variabile trasformata varrebbe exp(mu + sigma² / 2) − 1, cioè circa 11,4646 secondi. La trasformazione logaritmica rende diversi questi due riassunti. La documentazione SciPy della legge lognormale permette di approfondire la trasformazione esponenziale di una gaussiana; qui sottraiamo 1 per ritrovare il ritardo.
Un'altra sfumatura: la NLL pubblicata è calcolata nello spazio z, non direttamente come densità in secondi. Cambiare variabile in una densità richiederebbe un fattore 1 / (1 + ritardo), chiamato Jacobiano; il suo opposto del logaritmo aggiunge log(1 + ritardo) alla NLL, con la costante gaussiana per la forma completa. Non effettuiamo questo cambiamento nel punteggio r004: modificarlo cambierebbe il rilevatore e la sua calibrazione.
Perché confrontare quattro metodi?
Il metodo delle regole codifica le transizioni del simulatore. È un riferimento esplicito, che dispone di questa conoscenza del generatore; non è una politica operativa universale.
Il bigramma conta le transizioni tra due eventi successivi in train. Apprende una frequenza locale senza conservare l'intero prefisso. Il suo smoothing additivo di 1 aggiunge uno pseudo-conteggio alle possibilità: una transizione mai osservata non riceve automaticamente probabilità zero. Per esempio, con 12 transizioni uscenti e otto continuazioni possibili, una continuazione ancora assente riceverebbe (0 + 1) / (12 + 8) = 0,05.
L'LSTM evento minimizza soltanto l'entropia incrociata. L'LSTM congiunto minimizza l'entropia incrociata più 0,1 volte la NLL del ritardo. Tutti ricevono gli stessi prefissi disponibili, anche se non sfruttano tutte le informazioni nello stesso modo. L'LSTM evento conserva in particolare gli input descritti sopra: il suo nome designa il suo obiettivo di apprendimento, non l'eliminazione del ritardo passato in ingresso.
Il peso 0,1 riguarda l'addestramento. Più avanti incontreremo un peso 0,5 per costruire il punteggio di avviso: questi due numeri non hanno lo stesso ruolo.
Riprodurre il percorso completo
Fase 1 — preparare e verificare il calcolo in Docker
Dovete saper leggere Python, manipolare tabelle e usare un terminale con Docker. Le nozioni di probabilità e tensori servono ai calcoli appena descritti. Il percorso usa FP32 su CUDA: numeri in virgola mobile a 32 bit, calcolati su una GPU NVIDIA.
Decomprimete lo ZIP in una nuova cartella e collocate il terminale nella sua radice. Tutti i comandi seguenti partono da questa directory. Conservate le versioni e le risorse previste dai file del progetto; gli estratti dell'articolo non sostituiscono il suo ambiente completo.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference calibration
docker compose run --rm acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm tutorial python scripts/check_environment.py
docker compose run --rm tutorial python -m pytest -q
Il preflight verifica Docker, la GPU, la memoria e il disco. setup.sh prepara l'ambiente del progetto; docker compose config --quiet controlla la configurazione, poi build costruisce i servizi.
La fase acquisition non scarica qui alcun modello preaddestrato: locks/models.lock.json non dichiara alcun file esterno. La rete viene inizializzata localmente e addestrata sulle tracce. Questa fase viene mantenuta per controllare gli asset del percorso, non per recuperare un grande modello linguistico.
check_environment.py esegue realmente un LSTM e i suoi gradienti in Docker. Una GPU visibile sull'host non basta quindi. Il gradiente indica come la perdita varia quando i parametri cambiano; è ciò che consente di aggiustarli durante l'apprendimento. I test pytest verificano poi i comportamenti del programma, indipendentemente dalle metriche di rilevamento.
Da osservare: ogni comando deve riuscire prima di quello successivo. Non sostituite un errore di calcolo nel contenitore con la sola presenza della GPU in Linux.
Fase 2 — preparare le tracce ed esaminare il meccanismo
docker compose run --rm tutorial python -m ged_anomalies_workflows.cli prepare --config configs/minimum.yaml
docker compose run --rm inference python -m ged_anomalies_workflows.cli baseline --config configs/minimum.yaml
docker compose run --rm inference python -m ged_anomalies_workflows.cli inspect-mechanism --config configs/minimum.yaml
prepare costruisce il corpus. Ritrovate le popolazioni annunciate, le partizioni temporali e i controlli di origine, in particolare il punto di conteggio segnalato sopra. baseline fornisce i riferimenti semplici; inspect-mechanism permette di esaminare i calcoli prima dell'addestramento completo.
Seguite un prefisso: quale informazione è disponibile, quale evento serve da obiettivo e a quale intervallo corrisponde il ritardo? Questa lettura evita di scoprire soltanto alla fine che una colonna conteneva una risposta futura.
Fase 3 — addestrare, assegnare punteggi e calibrare
sh scripts/train_variants.sh
docker compose run --rm inference python -m ged_anomalies_workflows.cli score --config configs/minimum.yaml
docker compose run --rm calibration python -m ged_anomalies_workflows.cli calibrate --config configs/minimum.yaml
docker compose run --rm tutorial python -m ged_anomalies_workflows.cli evaluate --config configs/minimum.yaml
train_variants.sh orchestra gli addestramenti dei due LSTM. score applica i modelli ai prefissi. calibrate fissa le soglie sulle tracce normali di validazione. Infine evaluate misura i risultati. Le spiegazioni seguenti dettagliano il significato di questi output; conservateli prima di lanciare l'esercizio.
L'apprendimento usa AdamW, con un tasso di 0,003, un weight decay di 0,001, un clipping di norma 1, lotti di 32 tracce e 25 epoche. Il protocollo effettua 27 aggiornamenti per epoca. I due LSTM condividono il seed 17.
Un'epoca è un passaggio sull'insieme di addestramento; un lotto, o batch, raggruppa più tracce per un calcolo. L'ottimizzatore aggiusta i parametri dopo questo calcolo. Il tasso regola la scala dell'aggiornamento e il weight decay aggiunge una riduzione dei pesi secondo la regola di AdamW. Il clipping di norma limita la norma del gradiente usato: non significa «ogni peso deve restare inferiore a 1».
Verificare una ripresa, non solo un punteggio vicino
Il percorso confronta un addestramento continuo di 25 epoche con un'interruzione dopo dieci epoche, seguita da una ripresa di quindici. Un checkpoint è un salvataggio dello stato necessario per continuare: modello, ottimizzatore, ordine di campionamento dei dati (sampler), generatori casuali (RNG) e cronologia.
Ricaricare solo i pesi non basta per riprodurre esattamente la continuazione. Allo stesso modo, due addestramenti che terminano con lo stesso richiamo non sono necessariamente identici. La ripresa deve ritrovare gli stati previsti dal protocollo. La documentazione PyTorch sulla riproducibilità ricorda anche che l'identità numerica non è garantita dopo un cambio di piattaforma o di versione.
I checkpoint locali sono considerati stati fidati. L'audit pubblico ricarica pesi JSON e output di prefissi, senza caricare pickle esterni. Questa scelta descrive questo percorso; non sostituite questi file con un checkpoint scaricato arbitrariamente.
Calibrare un punteggio comparabile prima del test
Portare le due componenti a una scala utilizzabile
Ora disponiamo di diverse misure di sorpresa, ma non ancora di una regola di avviso. Il metodo delle regole dà 0 o 1. Il bigramma e l'LSTM evento usano la sorpresa dell'evento osservato.
Per l'LSTM congiunto, sommare direttamente l'entropia incrociata e la NLL del ritardo farebbe dipendere il risultato dalle loro scale numeriche. Il progetto le centra e riduce separatamente, usando soltanto la media e la deviazione standard calcolate sui prefissi normali di train:
componente standardizzata = (valore − media_train) / deviazione_standard_train
Si sottrae il livello abituale, poi si divide per la dispersione abituale. Un risultato di 2 significa «due deviazioni standard sopra la media di addestramento», non «due volte più pericoloso».
Il punteggio congiunto somma poi le due componenti standardizzate con il peso fisso di 0,5 previsto dal percorso. Questa ponderazione appartiene alla costruzione del punteggio, non alla perdita di addestramento ponderata a 0,1.
Esempio didattico, con parametri fittizi: una sorpresa evento di 1,4, una media di 1 e una deviazione standard di 0,2 danno 2. Una NLL di ritardo di 1,5, una media di −0,5 e una deviazione standard di 1 danno anch'esse 2. Le due componenti sono ora espresse rispetto alla loro dispersione abituale. Applicare un peso di 0,5 a una componente pari a 2 riporta il suo contributo a 1. Questi calcoli illustrano standardizzazione e ponderazione; l'assemblaggio eseguito resta quello del comando score dello ZIP. I valori negativi non vengono eliminati prima della standardizzazione.
Una componente costante o non finita viene rifiutata. Una dispersione nulla impedirebbe questa divisione; sostituire silenziosamente il risultato con zero nasconderebbe il problema. Le statistiche non vengono ricalcolate sul test per rendere più favorevoli i suoi punteggi.
Passare dal prefisso alla traccia
Il punteggio di una traccia è il massimo dei suoi punteggi causali: può bastare una sola transizione molto sorprendente. Durante una lettura progressiva, è il massimo dei punteggi già calcolabili; il punteggio finale usa tutti i prefissi osservati.
Questa scelta ha una conseguenza semplice: una traccia lunga offre più occasioni di ottenere un punteggio elevato. La valutazione conserva quindi strati di lunghezza, ossia gruppi di tracce di dimensioni comparabili. Una buona media globale potrebbe nascondere più falsi positivi sulle pratiche lunghe.
Il quantile al 95%: un rango esatto, non una promessa
Ogni metodo ordina i punteggi delle sue 90 tracce normali di validazione e trattiene il valore di indice ceil(0,95 × 90) − 1. ceil arrotonda all'intero superiore: ceil(85,5) − 1 = 85. Con indici che iniziano da zero, questo designa l'86° valore in ordine crescente.
L'avviso richiede poi punteggio > soglia. Un'uguaglianza non genera avviso. Se tutti i valori fossero distinti, solo i quattro valori dopo l'86° supererebbero la soglia su questa validazione: 4 / 90 ≈ 4,44 %. In presenza di uguaglianze, possono essercene meno.
Questo dettaglio evita due fraintendimenti. Il quantile empirico al 95% non significa «esattamente il 5% di falsi positivi», e ancora meno «mai più del 5% sulle pratiche future». Definisce una procedura riproducibile su un campione dato.
Le anomalie di validazione non servono a scegliere questa soglia. Il test viene dopo. Questa calibrazione non trasforma neppure il punteggio in probabilità di incidente: le soglie restano proprie delle scale dei metodi. Un cambiamento di pratica o dipendenze temporali possono modificarne il comportamento.
Leggere le metriche prima dei risultati
Precisione, richiamo e falsi positivi: tre domande diverse
Una traccia perturbata correttamente segnalata è un vero positivo. Una traccia normale che genera un avviso è un falso positivo. Una perturbazione non segnalata è un falso negativo.
Riprendiamo un piccolo esempio: su dieci tracce perturbate, otto generano un avviso; anche una traccia normale lo genera. La precisione vale 8 / 9: tra i nove avvisi, quanti corrispondono a una perturbazione? Il richiamo vale 8 / 10: tra le dieci perturbazioni, quante sono state individuate?
Il tasso di falsi positivi divide invece il numero di tracce normali segnalate per il numero totale di tracce normali. Non è uguale a 1 − precisione, il cui denominatore è il numero di avvisi.
Queste misure valutano il rilevamento delle perturbazioni definite dal generatore. Non valutano né la gravità di una pratica né la responsabilità di una persona.
L'average precision misura una classifica, non una sola soglia
L'average precision, o AP, esamina ciò che accade quando si abbassa la soglia nella classifica dei punteggi. Ogni gruppo appena incluso modifica precisione e richiamo. L'AP somma le precisioni ponderate dai guadagni di richiamo: AP = somma(guadagno_di_richiamo × precisione). La documentazione scikit-learn fornisce questa definizione; non sostituisce il valutatore dello ZIP e non aggiunge alcuna dipendenza al percorso.
Qui i punteggi uguali vengono trattati insieme. Immaginate solo due tracce con punteggio identico, una perturbata e l'altra normale. Nessuna soglia consente di prendere la prima senza la seconda. Separarle artificialmente mettendo la perturbata prima della normale abbellirebbe la classifica senza informazioni aggiuntive.
Un'AP di 1 e un falso positivo alla soglia scelta possono coesistere. Se tutte le perturbazioni sono meglio classificate delle tracce normali, la classifica è perfetta; una soglia fissata in precedenza sulla validazione può tuttavia essere abbastanza bassa da includere anche una traccia normale. Non la si alza dopo aver guardato il test.
Due significati diversi della parola ritardo
L'errore di previsione del ritardo si esprime qui in secondi. Confronta la durata prevista con quella effettivamente osservata.
Il ritardo di rilevamento, invece, è espresso in numero di eventi dopo la perturbazione. Una mediana di 0 significa che il rilevamento non richiede un evento aggiuntivo per almeno metà dei casi rilevati, secondo questo riferimento. Non significa né zero secondi di attesa, né zero millisecondi di calcolo, né un'anticipazione della perturbazione.
Questa mediana riguarda solo i casi rilevati. Un metodo potrebbe rilevare rapidamente alcuni casi e mancarne molti altri: va quindi letta insieme al richiamo. Anche gli avvisi prima della perturbazione meritano un'ispezione separata, anziché essere assimilati a buone anticipazioni.
Risultati: un miglioramento sintetico da interpretare con prudenza
Le decisioni alla soglia fissata sulla validazione
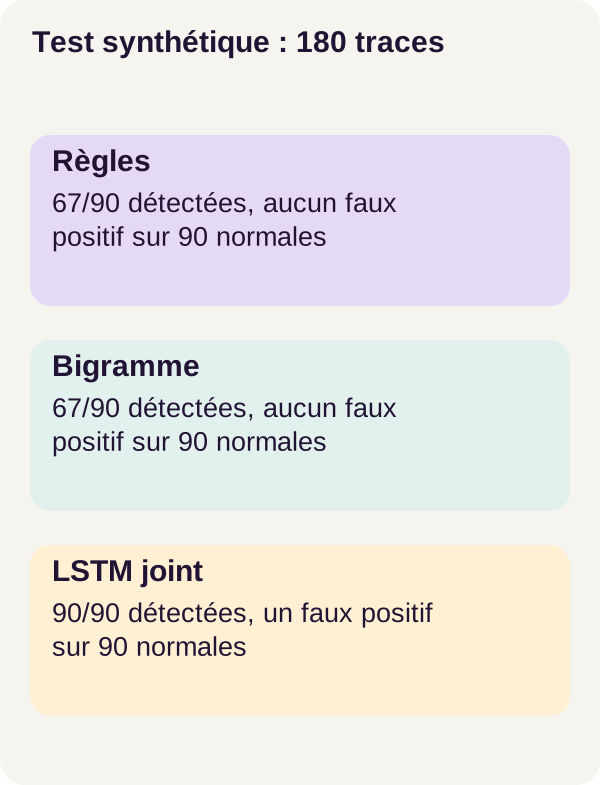
Il test comprende 90 tracce normali e 90 perturbate. La quota di perturbazioni è quindi del 50%: è una prevalenza artificiale, non un dato osservato in produzione.
Ecco i conteggi e i tassi del percorso r004. I falsi negativi della tabella sono dedotti dalle 90 perturbazioni e dai rilevamenti pubblicati; i tassi sono arrotondati a sei decimali.
Su mobile, scorrete la tabella orizzontalmente.
| Metodo | Perturbazioni rilevate | Perturbazioni mancate | Falsi positivi | Richiamo | Precisione | Tasso di falsi positivi |
|---|---|---|---|---|---|---|
| Regole | 67/90 | 23 | 0/90 | 0,744444 | 1 | 0 |
| Bigramma | 67/90 | 23 | 0/90 | 0,744444 | 1 | 0 |
| LSTM evento | 67/90 | 23 | 4/90 | 0,744444 | 0,943662 | 0,044444 |
| LSTM congiunto evento+ritardo | 90/90 | 0 | 1/90 | 1 | 0,989011 | 0,011111 |
Il modello congiunto ritrova tutte le perturbazioni di questo test, con un falso avviso. La sua precisione vale 90 / 91 = 0,989011, mentre il suo tasso di falsi positivi vale 1 / 90 = 0,011111. L'LSTM evento ritrova tante perturbazioni quanto i metodi semplici, ma aggiunge quattro falsi positivi: la sua complessità non apporta guadagno su queste decisioni.
La mediana del ritardo di rilevamento del congiunto vale 0 evento tra i casi rilevati. Gli altri tre metodi lasciano ciascuno 23 perturbazioni non rilevate dopo il cambiamento.
La classifica e gli errori di previsione
Le soglie e le AP pubblicate sono le seguenti. Le soglie non si confrontano come una scala comune di gravità.
| Metodo | Soglia | Average precision, circa |
|---|---|---|
| Regole | 0 | 0,872222 |
| Bigramma | 1,391023 | 0,887963 |
| LSTM evento | 1,386817 | 0,905482 |
| LSTM congiunto evento+ritardo | 4,284417 | 1 |
Il caso delle regole permette di comprenderne l'AP. Il punteggio 1 raggruppa 67 perturbazioni, senza traccia normale: la precisione è 1 e il richiamo raggiunge 67 / 90. Aggiungendo il gruppo con punteggio 0, si includono le 23 perturbazioni restanti e le 90 tracce normali: la precisione diventa 0,5. L'AP vale quindi 67 / 90 × 1 + 23 / 90 × 0,5 ≈ 0,872222. Questo calcolo è derivato dai conteggi pubblicati, non da una nuova esecuzione.
Sui 1.198 prefissi di test, l'entropia incrociata media è 1,494473 per il modello evento e 1,290952 per il congiunto. L'errore assoluto mediano del ritardo del congiunto è di 8,026882 secondi. Sono misure di previsione su questo corpus; un'entropia incrociata di 1,29 non è una proporzione del 129%.
Il modello congiunto migliora dunque il rilevamento in questo esperimento. La tabella non fornisce tuttavia il dettaglio delle 23 perturbazioni mancate dagli altri metodi: da sola non consente di affermare che ciascuna sia un ritardo prolungato.
Perché il 98,9% di precisione non si trasferisce in produzione
Facciamo un calcolo puramente illustrativo, senza supporre che il modello conserverebbe le sue prestazioni su pratiche reali. Su 10.000 tracce di cui solo 100 sarebbero perturbate, immaginiamo un richiamo pari a 1 e lo stesso tasso di falsi positivi di 1 / 90.
Il sistema segnalerebbe le 100 perturbazioni, ma anche 9 900 / 90 = 110 tracce normali. La precisione sarebbe allora 100 / (100 + 110) ≈ 47,62 %, e non 98,9%.
I tassi supposti non sono cambiati; è cambiata la popolazione. Ecco perché i risultati del test bilanciato non consentono da soli di prevedere il carico di una coda di revisione umana.
Esercizio: una nuova pratica normale
Prevedere prima di avviare
Il team accetta ora un doppio ciclo REVISION → REVUE come pratica normale. Non riaddestriamo il modello e non ricalibriamo la soglia. Una rete che ha incontrato raramente questa ripetizione può continuare a considerarla sospetta? Una regola che verifica soltanto le transizioni locali reagirà necessariamente allo stesso modo?
Scrivete la vostra ipotesi per i quattro metodi, poi lanciate l'esercizio. I risultati iniziali e la calibrazione sono conservati e controllati tramite impronta, o hash, per non sostituirli silenziosamente.
docker compose run --rm tutorial python -m ged_anomalies_workflows.cli exercise --config configs/minimum.yaml
Confrontare con la correzione del percorso
Le 60 tracce dell'esercizio sono ormai normali. Le regole e il bigramma non ne segnalano nessuna. I due LSTM le segnalano tutte: 60 falsi positivi su 60, cioè 100% in questo insieme.
Questo risultato non contraddice il buon punteggio del congiunto nel test. Il rilevatore ha appreso una certa frequenza dei percorsi; la pratica è cambiata senza che il suo apprendimento né la sua soglia cambiassero. Una sequenza può dunque essere poco attesa statisticamente e perfettamente accettabile per il team.
Le transizioni locali possono già essere ammesse, mentre la loro ripetizione in una cronologia più lunga resta insolita per il modello sequenziale. È un'interpretazione del meccanismo da confrontare con gli output, non una spiegazione causale completa di ogni avviso.
L'esercizio non chiede di alzare la soglia fino a far sparire questi avvisi. Chiede di qualificare la nuova pratica, creare una nuova revisione e prevedere un insieme di controllo separato. Riaddestrare o ricalibrare dopo questa decisione costituirà un nuovo esperimento, il cui risultato non è annunciato qui.
Produrre quindi le figure e controllare i checkpoint, prima di pulire:
docker compose run --rm tutorial python lesson/figures/plot.py
docker compose run --rm tutorial python scripts/check_checkpoints.py
Risolvere i problemi, pulire e preparare la produzione
Conservare gli errori utili
Se Docker non rende disponibile la GPU, seguite la diagnosi del preflight, poi rilanciate in una nuova cartella estratta. Il controllo dell'ambiente deve riuscire nel suo calcolo nel contenitore; lo stato della GPU sull'host non lo sostituisce.
Se una traccia viene rifiutata per una durata negativa, un evento sconosciuto o un ordine di origine duplicato, ispezionate l'esportazione prima del modello. Non aggirate il rifiuto con un ordinamento che farebbe sparire l'incoerenza iniziale.
Se la ripresa differisce dal percorso continuo, conservate i checkpoint per l'ispezione. Confrontate gli stati ripristinati e le versioni, anziché accontentarvi di un punteggio finale vicino. Prima di qualsiasi eliminazione, mantenete i risultati e le figure utili.
Pulire solo ciò che è previsto
docker compose down
docker compose run --rm tutorial python scripts/clean.py --outputs-only
docker compose down
Il primo docker compose down arresta i servizi del progetto. Lo script mostra poi elimina solo outputs; l'ultimo arresto conclude il percorso. Non elimina né modelli, né dati, né volumi globali, né altri progetti. Non è richiesta alcuna pulizia generale di Docker.
L'isolamento del percorso ha un perimetro preciso
I servizi usano un filesystem radice in sola lettura, nessuna capacità Linux aggiuntiva, no-new-privileges, limiti di CPU, memoria e processi, nonché una directory temporanea in tmpfs. I ruoli di addestramento, inferenza e calibrazione montano solo le risorse necessarie alle loro operazioni.
Queste restrizioni limitano gli accessi e le risorse disponibili. Non significano che nessun output possa essere scritto: le posizioni necessarie sono previste secondo i ruoli. Allo stesso modo, l'assenza di download di pesi terzi non significa che la costruzione dell'immagine sia senza rete: può risolvere le dipendenze definite nel file di build. I calcoli del modello sono invece isolati dalla rete.
Questa separazione riduce in particolare i rischi di lettura accidentale delle etichette nell'esercizio. Non è né una protezione contro un amministratore Docker né una certificazione di sicurezza.
Progettare un avviso che qualcuno possa gestire
In un'applicazione reale, occorrerebbe presentare il prefisso osservato, l'evento e il ritardo interessati, il punteggio, la soglia e le loro versioni. Ciò permetterebbe a un operatore di capire che cosa ha attivato l'avviso, senza pretendere che il modello spieghi la causa del ritardo o della ripetizione. Questa interfaccia è un lavoro di prodotto da aggiungere, non una funzionalità già dimostrata qui.
Una supervisione reale deve anche gestire fusi orari, arrivi tardivi, eventi concorrenti e identità delle pratiche. Un ordine totale pratico per una tabella di dati non descrive tutta la causalità di un workflow parallelo. Se due operazioni sono simultanee, ordinarle per convenzione non prova che una abbia causato l'altra.
Restano da aggiungere autenticazione, diritti, filtraggio, API, coda di revisione umana, versionamento dei modelli, osservabilità, test di carico, backup e valutazione operativa. Occorre soprattutto definire chi riceve un avviso, quale contesto gli è accessibile, come viene chiuso e quanto costa un falso avviso o una perturbazione mancata.
Un cambiamento di processo richiede una revisione operativa, una versione delle regole, un nuovo addestramento quando è giustificato e un set di controllo separato. Le analisi per lunghezza e gli avvisi prima della perturbazione aiutano a diagnosticare il sistema; non sostituiscono questa decisione umana.
Nessun avviso di questo tutorial automatizza un'azione su una persona o una pratica. Il rilevatore costituisce uno strumento di selezione per esaminare percorsi, non un arbitro amministrativo.
Sintesi
Abbiamo costruito un modello che impara a prevedere la sequenza di un registro normale, anziché riconoscere direttamente un elenco di errori. L'LSTM conserva un contesto sequenziale, le sue due teste prevedono l'evento e il ritardo, e le perdite misurano lo scarto rispetto a ciò che accade effettivamente.
La maschera evita di apprendere sul riempimento. Le statistiche di addestramento rendono le componenti del punteggio utilizzabili insieme. La validazione fissa la soglia prima del test, con una regola rigorosa per le uguaglianze. Infine, precisione, richiamo, classifica e ritardo di rilevamento rispondono a domande distinte.
Il congiunto rileva le 90 perturbazioni del test sintetico con un falso positivo. Eppure, i due LSTM segnalano le 60 tracce della nuova pratica normale. Apprendere ciò che è frequente non significa apprendere ciò che è autorizzato. È questa distinzione che deve accompagnare l'avviso fino all'interfaccia e alla persona incaricata di esaminarlo.
Fonti primarie e approfondimenti
I riferimenti del percorso sono la documentazione PyTorch di LSTM, quella di cross_entropy e lo studio di Brown et al. sui log. Quest'ultimo studia reti ricorrenti con attenzione per rilevare anomalie nei registri di sistema; fornisce un contesto di ricerca, non i risultati di questo corpus documentale né un'architettura di attenzione aggiunta al codice presentato.
I link complementari integrati nelle spiegazioni documentano embedding, trasformazioni numeriche, perdita gaussiana, AdamW, riproducibilità e average precision. Chiariscono i meccanismi e gli esempi di calcolo; non costituiscono nuove esecuzioni del progetto. Per riprodurre r004, conservate i file e le versioni dello ZIP.