





Imaginez une page de back-office qui affiche des notes de maintenance. Vous aimeriez y repérer automatiquement une référence de matériel, un site et une échéance, puis montrer ces éléments à la personne chargée de les vérifier. Le problème n’est pas seulement de construire un modèle : il faut d’abord lui fournir des exemples correctement annotés.
Or, dans une GED, ou gestion électronique de documents, une équipe ne peut pas forcément relire et annoter toute la collection. Par quelles notes commencer ? Les premières dans la liste ? Un tirage au hasard ? Celles sur lesquelles le modèle hésite ?
C’est la question de l’annotation active : entraîner un premier modèle avec un petit ensemble annoté, lui faire examiner les textes encore disponibles, puis choisir les prochains documents à faire annoter. On espère ainsi rendre les nouvelles annotations plus utiles à l’apprentissage. Mais cette utilité doit se mesurer, pas se déduire du nom de la méthode.
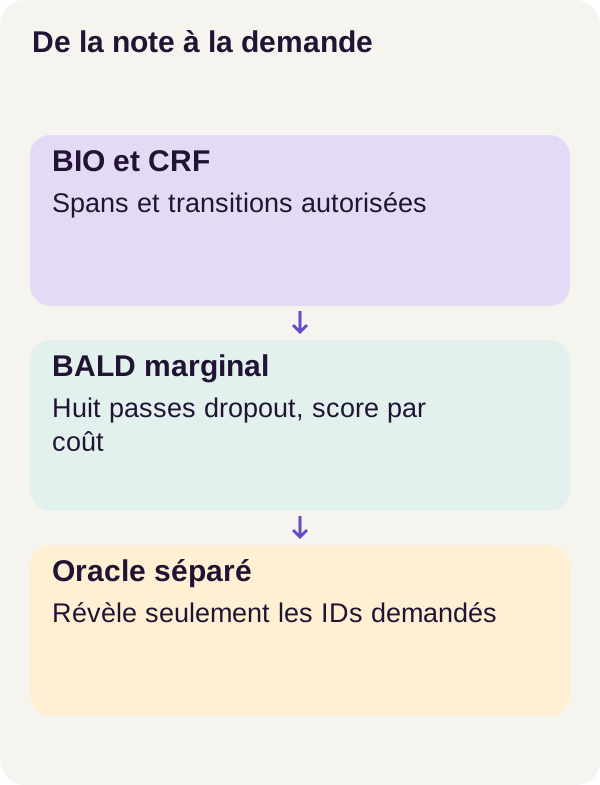
Nous allons construire cette boucle sur des notes fictives. Un BiLSTM-CRF repère des entités dans le texte, une file de sélection choisit des notes sous un budget, puis un oracle séparé révèle uniquement les annotations demandées. Nous expliquerons ces termes avant d’exécuter le projet : il ne s’agit ni de demander des réponses à un chatbot, ni de développer une interface de revue complète.
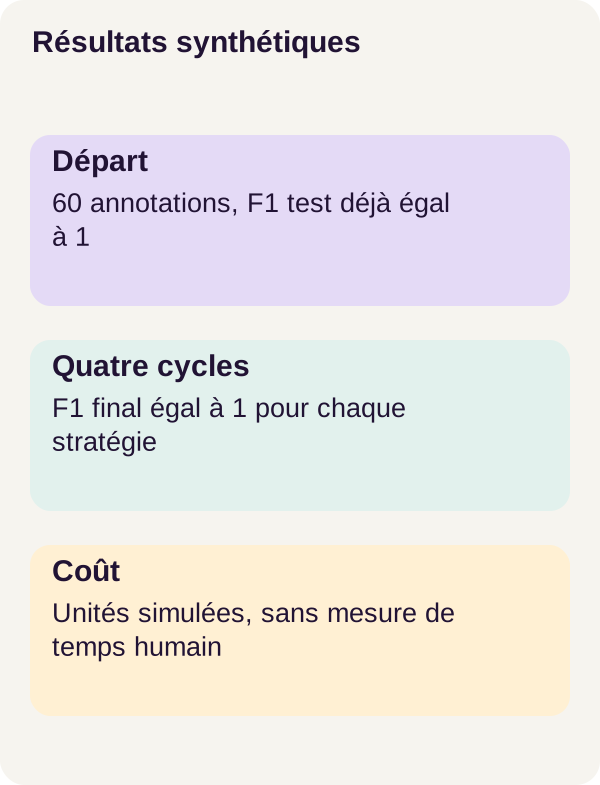
Le parcours est une démonstration reproductible, pas une mesure de productivité humaine. L’oracle est un programme qui possède déjà les bonnes réponses du corpus synthétique. Aucun annotateur, délai, abandon ou temps de travail n’est observé. Le coût est une règle publiée : 5 + nombre de tokens par note. Nous conserverons cette distinction jusque dans la lecture des résultats.
Télécharger le projet complet, révision r001
Les données et la règle de non-fuite
Repérer une entité, c’est retrouver un morceau de texte précis
Une entité est ici une portion de texte à laquelle nous attribuons un type : REFERENCE, SITE ou ECHEANCE. Une annotation indique à la fois ce type et les caractères concernés. Le modèle devra apprendre à proposer les mêmes informations sur une note dont il ne connaît pas les annotations.
Prenons cette phrase, ajoutée uniquement pour expliquer le mécanisme :
Prévoir AX-14 à Lyon Nord avant le 18 octobre.
Nous souhaitons y repérer AX-14 comme référence, Lyon Nord comme site et 18 octobre comme échéance. Une telle portion est appelée un span. Les offsets sont ses positions dans le texte d’origine : ils permettent de surligner la bonne occurrence, même si la même valeur apparaît plusieurs fois.
Dans cet exemple pédagogique, en comptant les caractères à partir de zéro et en excluant la borne de fin, AX-14 occupe [8, 13), Lyon Nord occupe [16, 25) et 18 octobre occupe [35, 45). La notation [8, 13) signifie « du caractère 8 inclus au caractère 13 exclu ». Ce sont les positions de cette phrase illustrative, pas une nouvelle sortie du projet.
Le corpus conserve les offsets, y compris avec les accents, la ponctuation et les références contenant un tiret. Pour une future interface, retenez l’enjeu : les positions doivent toujours désigner la même version du texte. Modifier les espaces ou les caractères après avoir calculé les offsets peut déplacer le surlignage.
Répartir les notes avant d’apprendre
Le corpus contient 1 800 notes synthétiques, organisées en 120 familles de 15 notes. Il est réparti en 1 260 notes d’entraînement, 270 de validation et 270 de test. Chaque note peut contenir une référence, un site et une échéance ; leur présence n’est pas obligatoire.
Ces trois ensembles, souvent appelés splits, n’ont pas le même rôle. L’entraînement fournit les exemples à partir desquels le modèle apprend. La validation constitue un ensemble distinct pour les contrôles de développement. Le test sert à mesurer le résultat, sans alimenter les demandes d’annotation du pool.
Une famille reste entièrement dans un seul ensemble. On évite ainsi de répartir les variantes d’une même famille entre entraînement et test. Cela ne rend pas le corpus représentatif d’une entreprise : son vocabulaire et sa grammaire restent ceux d’un générateur pédagogique contrôlé.
Transformer les spans en étiquettes BIO
Le réseau ne reçoit pas directement des chaînes à surligner. Le texte est découpé en tokens, c’est-à-dire en unités manipulées par le programme, puis chaque token reçoit une étiquette. Un token n’est pas nécessairement un mot entier ; le découpage exact reste celui du projet.
Nous utilisons la convention BIO : B- marque le début d’une entité, I- sa continuation et O une position extérieure aux entités recherchées. Avec trois types, nous obtenons sept étiquettes : O, B-REFERENCE, I-REFERENCE, B-SITE, I-SITE, B-ECHEANCE et I-ECHEANCE.
Pour comprendre la convention, supposons simplement que Lyon et Nord soient deux tokens successifs. Nous étiquetons Lyon avec B-SITE, puis Nord avec I-SITE. Le I- signifie « je continue une entité déjà commencée », pas « je commence une autre catégorie ».
Ainsi, I-SITE ne peut suivre que B-SITE ou I-SITE. Après O, il faut ouvrir le site avec B-SITE. Après B-REFERENCE, on ne peut pas poursuivre directement avec I-SITE : le type changerait au milieu de l’entité.
Le vocabulaire est construit à partir des textes d’entraînement seulement. Les phrases forment des fenêtres d’au plus 128 tokens, sans chevauchement. Le découpage ne consulte pas les annotations cachées pour choisir une frontière commode : si une entité traverse une frontière, le corpus est considéré comme invalide. Cette restriction fait partie du parcours démontré ; ce n’est pas une solution générale aux documents de toute longueur.
L’oracle ne doit intervenir qu’après la sélection
La graine aléatoire, ou seed, vaut 17. Elle sert ici à choisir 60 notes d’entraînement initiales, laissant 1 200 notes dans le pool. Le pool est la réserve de notes dont le texte est disponible, mais dont les annotations ne sont pas encore révélées au parcours d’apprentissage.
Pour un développeur web, imaginez deux services avec des droits différents. Le premier sait dresser une liste d’identifiants à traiter. Le second possède les annotations et ne les retourne que pour une demande autorisée.
Le projet matérialise cette séparation : le processus qui classe le pool ne monte ni l’oracle ni les fichiers de labels cachés. Il écrit une demande d’IDs et en calcule une empreinte, ou hash, afin d’identifier la demande enregistrée. L’oracle ouvre ensuite uniquement les fichiers demandés, refuse un doublon, une note hors entraînement ou un coût incohérent, puis retourne les spans.
Le hash identifie la demande ; l’absence d’accès aux labels empêche de les lire pendant la sélection. Ce sont deux rôles différents. Une simple convention « ne pas regarder les réponses » serait moins vérifiable qu’un processus qui ne dispose pas des fichiers.
Sans cette séparation, on pourrait choisir les notes en connaissant déjà les erreurs du modèle sur leurs vraies annotations. On ne mesurerait plus une stratégie qui découvre les réponses progressivement, mais une stratégie aidée par les réponses qu’elle est censée demander.
BiLSTM-CRF : des tokens à une séquence valide
Le nom combine deux mécanismes. Le BiLSTM donne un contexte à chaque token. Le CRF évalue les enchaînements d’étiquettes pour produire une séquence qui respecte les règles BIO. Décomposons le trajet plutôt que de considérer l’ensemble comme une boîte noire.
Des identifiants aux scores d’étiquettes
Un embedding est un vecteur, donc une liste de nombres, associé à un token du vocabulaire. Ici, chaque vecteur contient 64 valeurs, apprises depuis zéro avec le reste du modèle. Ce ne sont pas des représentations récupérées auprès d’un grand modèle préentraîné. La documentation de torch.nn.Embedding décrit cette table de correspondance entre identifiants et vecteurs.
Le LSTM, pour Long Short-Term Memory, est un réseau qui parcourt une séquence en conservant un état. La version bidirectionnelle effectue ce parcours dans les deux sens. Un token bénéficie ainsi du contexte qui le précède et de celui qui le suit. Avec 64 unités dans chaque sens, les deux sorties réunies donnent 128 valeurs par token, conformément au fonctionnement décrit dans la documentation LSTM 2.8.
Deux couches de dropout à 0,25 encadrent le LSTM. Le dropout met temporairement à zéro des composantes numériques tirées au hasard ; il ne retire pas les mots de la note et ne supprime pas définitivement des paramètres. Le rôle de ce mécanisme dans notre mesure d’incertitude arrive à la section suivante.
Enfin, une projection transforme les 128 valeurs en sept scores d’émission, un par étiquette BIO. Une émission indique dans quelle mesure le modèle favorise une étiquette à cette position. Ce score brut n’est pas encore une probabilité ni un span terminé.
Pour une fenêtre illustrative de dix tokens, le trajet se lit donc ainsi : dix identifiants, puis un tableau 10 × 64, un tableau contextualisé 10 × 128 et enfin 10 × 7 scores. Un tenseur est simplement le tableau numérique qui porte ces valeurs.
Pourquoi ne pas choisir la meilleure étiquette à chaque position ?
Parce qu’une succession de bons choix locaux peut former une séquence interdite. Voici un petit calcul pédagogique sur Lyon Nord, réduit à trois étiquettes pour rester lisible. Ces scores sont inventés pour l’explication, pas extraits d’un entraînement.
| Token | Score O |
Score B-SITE |
Score I-SITE |
|---|---|---|---|
| Lyon | 3 | 2 | 0 |
| Nord | 0 | 1 | 4 |
Choisir le plus grand nombre de chaque ligne donne O → I-SITE, avec un total de 3 + 4 = 7. Mais cette séquence annonce une continuation sans avoir ouvert de site.
Supposons, pour ce calcul, que tous les scores de début, de fin et de transitions autorisées valent zéro. La meilleure séquence légale devient B-SITE → I-SITE, de score 2 + 4 = 6. Le choix global n’est donc pas forcément une suite de maxima locaux.
Le CRF, pour Conditional Random Field ou champ aléatoire conditionnel, attribue précisément un score à un chemin complet. Il combine les émissions, un score de début, un score de fin et les transitions entre étiquettes successives. Dans ce projet, une transition est indexée dans le sens précédente vers courante.
Inscrire les règles BIO dans le calcul
Le code suivant construit les autorisations de début et de transition. TAGS est la liste d’étiquettes du projet ; cet extrait s’utilise dans son environnement, fourni dans le ZIP.
def bio_constraints(tags=TAGS):
    start = torch.tensor([not t.startswith("I-") for t in tags])
    transitions = torch.ones((len(tags), len(tags)), dtype=torch.bool)
    for previous, a in enumerate(tags):
        for current, b in enumerate(tags):
            if b.startswith("I-"):
                transitions[previous, current] = a in ["B-" + b[2:], "I-" + b[2:]]
    return start, transitions
start est un tableau de booléens : une valeur vraie autorise l’étiquette à commencer la séquence. Les trois étiquettes I- sont donc interdites au départ.
transitions est une matrice 7 × 7, initialement remplie de valeurs vraies. La boucle examine chaque couple. Si l’étiquette courante b commence par I-, b[2:] récupère son type, par exemple SITE. La transition ne reste autorisée que si l’étiquette précédente est B-SITE ou I-SITE.
En revanche, un B- peut ouvrir une nouvelle entité et O peut sortir d’une entité. La fonction définit ce qui est autorisé, pas le score appris de chaque transition. Le CRF exploite ensuite ces contraintes pendant l’entraînement et le décodage.
Cette nuance est importante : le projet ne produit pas une séquence illégale pour la réparer après coup. Les chemins interdits sont exclus du calcul prévu. Une séquence valide peut néanmoins être fausse : rien n’empêche un modèle de sélectionner un mauvais site tout en respectant parfaitement BIO.
Apprendre avec tous les chemins, prédire avec le meilleur
Deux calculs utilisent le même ensemble de chemins autorisés, mais répondent à des questions différentes.
Viterbi cherche le meilleur chemin. Il conserve les meilleurs scores intermédiaires et les prédécesseurs correspondants, puis remonte ces choix à la fin. Ces retours arrière reconstruisent la séquence complète. On évite ainsi d’énumérer explicitement toutes les combinaisons d’étiquettes.
La normalisation logZ additionne le poids de tous les chemins autorisés. Chaque score devient un poids positif par exponentiation. Z est leur somme et logZ son logarithme. La probabilité d’un chemin s’écrit alors exp(score_du_chemin - logZ).
La fonction de perte, appelée NLL pour negative log-likelihood, vaut logZ - score_gold. gold désigne ici la séquence de référence révélée pour l’apprentissage. Réduire cette perte pousse le modèle à attribuer davantage de probabilité à la bonne séquence, relativement aux autres chemins légaux. Le tutoriel BiLSTM-CRF de PyTorch développe la distinction entre normalisation et décodage.
Dans notre exemple à deux tokens, les cinq chemins légaux ont les scores 3, 4, 2, 3 et 6. On obtient logZ ≈ 6,2257. Si la référence est B-SITE → I-SITE, sa perte vaut donc environ 0,2257, et sa probabilité environ 0,7979. Être le meilleur chemin ne signifie pas avoir une probabilité de 1.
Le calcul se fait en log-space, c’est-à-dire dans l’espace des logarithmes, pour limiter les difficultés numériques. L’opération log-sum-exp permet de calculer de façon stabilisée le logarithme d’une somme d’exponentielles. Elle ne remplace pas la somme par le maximum : ce serait changer le problème.
Obtenir une probabilité par token sans oublier le contexte
Pour choisir les notes à annoter, nous avons besoin de marginales CRF : la probabilité de chaque étiquette à chaque position, en tenant compte des chemins complets. Le terme « marginale » signifie que l’on rassemble les possibilités concernant les autres positions pour se concentrer sur celle-ci.
Ce n’est pas un simple softmax appliqué indépendamment aux sept émissions. Le calcul avant-arrière combine les contributions qui arrivent à une position et celles qui en repartent. Avec la convention du projet, la formule est exp(alpha + beta - logZ). À chaque token réel, les sept probabilités doivent sommer à 1.
Dans le parcours, ce calcul utilise la précision FP64 à partir des émissions FP32, pour limiter les erreurs d’arrondi. L’entraînement GPU reste en FP32 : on ne passe pas tout le réseau en double précision. Le petit treillis présenté pour expliquer les chemins comporte trois tags ; le modèle du tutoriel en utilise bien sept.
Incertitude : ce que BALD approxime réellement
Nous savons maintenant prédire des entités. Reste à choisir les prochaines notes à annoter, sans regarder leurs réponses. La stratégie étudiée compare plusieurs prédictions du même réseau avec dropout actif.
Faire varier le calcul, sans réentraîner huit modèles
Le parcours effectue huit passes avec dropout. Les paramètres appris restent les mêmes, mais les masques de dropout varient et produisent huit distributions marginales par token. On appelle cette répétition Monte Carlo dropout : plusieurs calculs aléatoires servent à approcher une quantité que l’on ne calcule pas exactement.
Le dropout standard de PyTorch est actif à l’entraînement et désactivé en mode évaluation. Pour estimer le désaccord, il faut donc conserver cette variation pendant les passes prévues à cet effet. Ce n’est ni huit nouveaux entraînements, ni huit équipes d’annotateurs indépendantes.
BALD désigne un critère d’apprentissage actif fondé sur le désaccord. Dans son cadre bayésien, il vise l’information qu’une réponse pourrait apporter sur les paramètres du modèle. L’article sur BALD avec dropout présente une approximation par passes stochastiques. Ici, nous appliquons un calcul de ce type aux marginales de tokens d’un CRF, pas directement à toutes ses séquences possibles.
Hésiter de la même façon n’est pas se contredire
Une entropie mesure à quel point une distribution est répartie entre plusieurs possibilités. Avec deux choix de probabilités 0,5 et 0,5, elle est plus élevée qu’avec 0,9 et 0,1. Le calcul du projet utilise le logarithme naturel ; les valeurs d’entropie ne sont donc pas des pourcentages.
Pour un token, nous calculons : l’entropie de la distribution moyenne, moins la moyenne des entropies. La première regarde les prédictions toutes ensemble ; la seconde regarde combien chaque passe hésite individuellement.
Prenons deux passes et deux étiquettes, uniquement pour pouvoir calculer à la main. Le projet utilise huit passes et sept étiquettes, mais la soustraction est la même.
Premier cas : les deux passes répondent [0,5 ; 0,5]. Leur moyenne est [0,5 ; 0,5]. L’entropie de la moyenne vaut environ 0,6931, tout comme l’entropie moyenne. Le désaccord calculé vaut donc 0. Les passes hésitent, mais elles hésitent de manière identique.
Second cas : une passe répond [0,9 ; 0,1], l’autre [0,1 ; 0,9]. La moyenne reste [0,5 ; 0,5], donc son entropie reste 0,6931. Chaque passe est cependant plus tranchée : son entropie vaut environ 0,3251. La différence atteint environ 0,3681.
La distribution moyenne est identique dans les deux cas, mais pas le désaccord. Voilà ce que cette soustraction permet de distinguer. À l’inverse, plusieurs passes peuvent être très sûres de la même mauvaise réponse : un faible score ne garantit pas une annotation correcte.
Du désaccord d’un token à la priorité d’une note
Le programme additionne les contributions des tokens réels sur les fenêtres d’une note, puis divise par son coût : 5 + nombre de tokens. Le padding, ou remplissage ajouté pour regrouper des séquences de longueurs différentes, est exclu par un masque. Ce remplissage facilite le calcul par lots ; il ne doit pas créer une information fictive.
Le score est donc une approximation marginale par token de type BALD, rapportée au coût. Les tokens sont liés par le CRF ; additionner leurs contributions ne calcule pas l’information mutuelle conditionnelle exacte de toute la séquence et peut compter des signaux dépendants. Le résultat n’est ni une probabilité d’erreur ni une mesure du bénéfice humain d’une annotation.
Voici la fonction source. probabilities a la forme M × T × K : nombre de passes, nombre de positions, nombre d’étiquettes. Dans le parcours, M = 8 et K = 7.
import math
import torch


def marginal_bald_score(probabilities, mask, cost):
    # M x T x K; sum token-wise proxy, not joint-sequence mutual information.
    if (
        probabilities.ndim != 3
        or probabilities.shape[1] != len(mask)
        or probabilities.shape[0] < 2
        or cost <= 0
        or not torch.isfinite(probabilities).all()
        or (probabilities < 0).any()
    ):
        raise ValueError("Invalid dropout marginals/cost")
    if not torch.allclose(
        probabilities[:, mask].sum(-1),
        torch.ones_like(probabilities[:, mask, 0]),
        atol=1e-5,
    ):
        raise ValueError("Real-token marginals must normalize")
    entropy = lambda p: -(
        torch.where(p > 0, p * torch.log(p.clamp_min(1e-30)), torch.zeros_like(p))
    ).sum(-1)
    values = entropy(probabilities.mean(0)) - entropy(probabilities).mean(0)
    if values[mask].min() < -1e-5:
        raise ValueError("Negative information proxy beyond rounding tolerance")
    return float(values[mask].clamp_min(0).sum() / cost), values.masked_fill(~mask, 0)
Le premier bloc vérifie notamment les trois dimensions, l’accord entre le nombre de positions et la longueur du masque, la présence d’au moins deux passes, les valeurs non finies ou négatives et un coût inférieur ou égal à zéro. Le bloc suivant contrôle que chaque distribution de token réel somme à 1. Il ne suffit pas d’avoir un tableau de nombres positifs pour avoir des probabilités cohérentes.
La petite fonction entropy effectue la somme sur la dernière dimension, celle des étiquettes. Le traitement des zéros évite de leur faire contribuer un log(0) ; clamp_min(1e-30) protège l’argument du logarithme. Puis probabilities.mean(0) moyenne les passes avant de calculer une entropie, tandis que entropy(probabilities).mean(0) moyenne les entropies déjà calculées.
En arithmétique exacte, cette différence est non négative pour des distributions valides. Le seuil -1e-5 tolère de minuscules écarts d’arrondi ; une valeur plus négative provoque une erreur. clamp_min(0) retire ces petits résidus négatifs du score additionné.
La fonction retourne deux objets : un score scalaire divisé par le coût et un vecteur de contributions dont les positions de padding sont mises à zéro. Ce second objet conserve les valeurs avant le clamp_min(0) du score ; de très petits résidus négatifs peuvent donc encore y apparaître.
L’extrait suppose un masque booléen contenant au moins un token réel et un coût scalaire fini. Il ne vérifie pas à lui seul tous ces prérequis et ne recalcule pas le coût depuis le texte. Le contrôle de cohérence du coût par le protocole et l’oracle reste une étape distincte. Modifier silencieusement une distribution ou un coût pour éviter un refus changerait l’expérience.
Dépenser un budget, pas remplir un quota de documents
Avec notre règle, une note de vingt tokens coûte 25 unités. Ce n’est pas vingt-cinq secondes. Le 5 représente une composante fixe du coût simulé, et le nombre de tokens sa composante variable.
Autre exemple pédagogique : une note dont la somme des contributions vaut 0,6 et le coût 100 reçoit une priorité de 0,006. Une autre, avec une somme de 0,4 et un coût 40, reçoit 0,01. La seconde passe devant, malgré une contribution brute plus faible, parce que le classement se fait par unité de coût.
La référence, ou baseline, est une sélection aléatoire à priorité déterministe et sans remplacement : une fois sélectionnée, une note ne revient pas dans la réserve à annoter. « Déterministe » signifie ici que le même parcours peut retrouver l’ordre prévu, pas que cet ordre exploite l’incertitude du modèle.
Aléatoire et BALD partagent les 60 notes initiales, les plafonds, l’architecture et le test. Chaque cycle ajoute au plus 4 000 unités. Une note qui ne tient pas dans le budget restant est sautée, puis la file continue. Avec 30 unités restantes, une note coûtant 35 peut ainsi être écartée alors qu’une suivante coûtant 20 entre encore dans le cycle : cet exemple illustre la règle, sans ajouter une mesure au parcours.
On obtient un classement avec contrôle du budget, pas une preuve que l’ensemble choisi est optimal. Deux stratégies peuvent terminer le même nombre de cycles avec des dépenses différentes. Nous comparerons donc F1 au coût cumulé réellement consommé, pas uniquement au numéro du cycle.
Exécuter les 21 commandes attestées
Préparer l’environnement et vérifier les calculs
Vous devez pouvoir lire du Python et utiliser un terminal avec Docker. Les notions utiles sont les tenseurs, les probabilités, les séquences et les gradients. Les exemples précédents donnent les repères de lecture ; les blocs de code s’insèrent dans le projet complet, pas dans un script isolé à reconstituer.
Le profil de référence utilise Linux et une RTX 3090 de 24 Gio, avec 16 Gio de RAM et 10 Gio de disque de travail, auxquels s’ajoute le stockage Docker. Ce sont des recommandations de préparation, pas des minima mesurés sur toutes les configurations. La RAM est la mémoire de la machine ; les 24 Gio de la carte sont sa mémoire vidéo.
L’intégration entre Docker et le GPU NVIDIA doit être opérationnelle. La documentation NVIDIA Container Toolkit décrit cette intégration. Un GPU visible sur l’hôte ne suffit pas : check_environment.py effectue un forward et un backward du BiLSTM-CRF dans le conteneur. Le forward produit les scores à partir des entrées ; le backward calcule les gradients nécessaires à l’apprentissage.
Décompressez le ZIP dans un nouveau répertoire et placez le terminal à sa racine. Toutes les commandes suivantes partent de ce dossier. Nous enchaînerons les 15 commandes du parcours principal, celle de l’exercice et les cinq commandes finales, soit les 21 commandes du parcours fourni.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference initialization oracle
docker compose run --rm --no-deps acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm --no-deps tutorial python scripts/check_environment.py
docker compose run --rm --no-deps tutorial python -m pytest -q
Le préflight contrôle l’environnement ; le setup prépare le projet ; Compose vérifie sa configuration puis construit les services. L’acquisition vérifie un registre vide : aucun modèle préentraîné n’est requis. Cette étape n’a donc pas à télécharger un LLM ou des embeddings externes.
Le contrôle d’environnement vérifie ensuite le calcul dans Docker, puis pytest exécute les tests du projet. Un code de retour nul signale la réussite de chaque commande. Les tests du programme ne remplacent pas la mesure de qualité des entités, qui vient plus loin.
Créer le corpus et révéler les premières annotations
Les services ne jouent pas tous le même rôle. initialization lance les opérations d’amorçage ; oracle révèle les annotations autorisées ; les rôles d’apprentissage et d’inférence restent séparés. Les montages du fichier Compose matérialisent les accès prévus. Les calculs sont isolés du réseau et l’oracle ne réserve pas de GPU.
docker compose run --rm --no-deps tutorial python -m ged_annotation_active_entites.cli prepare --config configs/minimum.yaml
docker compose run --rm --no-deps initialization python -m ged_annotation_active_entites.cli request-initial --config configs/minimum.yaml
docker compose run --rm --no-deps oracle python -m ged_annotation_active_entites.cli reveal --config configs/minimum.yaml
docker compose run --rm --no-deps initialization python -m ged_annotation_active_entites.cli baseline --config configs/minimum.yaml
docker compose run --rm --no-deps initialization python -m ged_annotation_active_entites.cli predict --config configs/minimum.yaml --cycle 0
prepare construit le corpus et ses partitions. Vérifiez les comptes 1 260 / 270 / 270 et la séparation des familles avant d’interpréter une métrique.
request-initial demande les 60 notes initiales, puis reveal fournit leurs spans. Les deux opérations restent distinctes : la demande existe avant que les annotations soient retournées. La commande baseline construit le point de départ et predict --cycle 0 produit les prédictions de ce cycle initial.
Le cycle 0 n’est pas le modèle non entraîné. C’est le point de comparaison obtenu après l’apprentissage sur les annotations initiales, avant les quatre cycles supplémentaires d’annotation. Confondre ces deux états changerait entièrement l’interprétation du résultat.
Inspecter le mécanisme avant de multiplier les cycles
docker compose run --rm --no-deps tutorial python -m ged_annotation_active_entites.cli inspect-mechanism --config configs/minimum.yaml
Cette étape sert à relier les calculs à leurs représentations. Sur une séquence, distinguez le chemin BIO choisi des distributions marginales. Vérifiez que chaque token réel possède une distribution de masse totale 1 et que les positions de remplissage ne contribuent pas au score de sélection.
Le treillis simplifié à trois tags aide à lire le mécanisme ; il ne décrit pas une réduction du modèle réel à trois étiquettes. De même, les petits exemples numériques de cet article sont des explications, pas de nouveaux résultats d’entraînement.
Lancer quatre cycles, puis évaluer
sh scripts/run_all.sh
docker compose run --rm --no-deps tutorial python -m ged_annotation_active_entites.cli evaluate --config configs/minimum.yaml
run_all.sh enchaîne sélection, révélation et apprentissage pendant quatre cycles. Les annotations obtenues enrichissent progressivement l’ensemble d’apprentissage. Chaque stratégie respecte ses plafonds, mais ne demande pas nécessairement les mêmes notes.
À chaque cycle, le modèle repart des mêmes paramètres non entraînés, puis apprend pendant huit époques sur les annotations alors disponibles. Une époque est un passage sur les exemples d’entraînement ; un cycle d’annotation comprend la sélection de nouvelles notes et l’entraînement qui suit. Huit époques ne signifient donc pas huit nouvelles demandes d’annotation.
Ce choix n’est pas un fine-tuning continu du modèle du cycle précédent. Les annotations s’accumulent, mais les poids repartent du même état initial à chaque cycle. Cela fixe les conditions de comparaison des stratégies ; réutiliser les poids du cycle précédent constituerait une autre expérience.
L’optimiseur est AdamW, avec lr=0,003, weight_decay=0,001, un batch de 16 et un clipping à 1. Un batch est un lot d’exemples traité pendant l’apprentissage. Les gradients décrivent comment la perte varie avec les paramètres ; l’optimiseur s’en sert pour les ajuster. Le taux lr règle l’amplitude de ces mises à jour, tandis que le weight decay applique une régularisation des poids. La documentation AdamW précise ce mécanisme.
Le clipping limite l’amplitude des gradients selon la règle du projet. Il ne limite ni le score F1 ni le nombre de notes sélectionnées. Pour comprendre le principe d’une limitation de norme, la documentation clip_grad_norm_ fournit un complément.
Reprendre une interruption, ce n’est pas recommencer un cycle
Le parcours vérifie aussi une interruption après l’époque 4 du cycle 2. Cette fois, il faut reprendre l’entraînement déjà commencé, pas revenir aux paramètres initiaux du cycle.
Le checkpoint, ou point de sauvegarde, doit restituer le modèle, l’optimiseur, le sampler qui organise l’échantillonnage, les RNG ou générateurs pseudo-aléatoires, le pool, la demande et les annotations. Restaurer seulement les poids ne suffit pas : une file différente ou de nouveaux tirages de dropout peuvent modifier la suite.
Le contrôle exige que les sélections et prédictions futures restent identiques à celles du parcours sans interruption. C’est plus exigeant qu’obtenir le même F1 final : deux modèles peuvent avoir la même note sans avoir suivi la même expérience.
Cette vérification concerne l’environnement reproduit. La documentation PyTorch sur la reproductibilité rappelle qu’une graine identique ne garantit pas des résultats identiques après un changement de version ou de plateforme.
Lire F1 et coût avec un exemple
Une frontière presque juste reste une erreur d’extraction
La mesure porte sur des spans exacts : les bornes de caractères et le type doivent correspondre à la référence. Elle ne se contente pas de vérifier que certains mots se recouvrent.
Si la référence attend AX-14, mais que le modèle prédit seulement AX, il manque l’entité exacte attendue : c’est un faux négatif. Il a aussi émis une entité qui ne correspond pas à la référence : c’est un faux positif. Les deux comptes ne représentent pas deux notes erronées ; ils décrivent les deux côtés d’une même extraction incorrecte.
La précision mesure la proportion de spans prédits qui sont justes. Le rappel mesure la proportion des spans attendus qui ont été retrouvés. Le F1 combine les deux par une moyenne harmonique, afin qu’une bonne précision ne masque pas un mauvais rappel, ou l’inverse.
Reprenons l’exemple du parcours : 8 spans corrects, 2 prédictions en trop et 2 spans oubliés. La précision vaut 8 / (8 + 2) = 0,8, le rappel vaut aussi 0,8, et le F1 vaut 2 × précision × rappel / (précision + rappel) = 0,8.
Le rapport conserve les types d’entités, leurs supports, c’est-à-dire leurs effectifs de référence, et des diagnostics de frontière. Ces détails aident à comprendre une erreur ; ils ne transforment pas une correspondance partielle en succès pour le F1 exact.
Mettre le budget, et non le cycle, sur l’axe horizontal
La courbe place F1 en ordonnée, sur l’axe vertical, et les unités d’annotation réellement consommées en abscisse, sur l’axe horizontal. Le numéro du cycle ne suffit pas : deux files peuvent avoir demandé des notes de longueurs différentes et dépensé des coûts différents.
Par exemple, comparer une méthode après 3 000 unités et une autre après 4 000 unités ne mesure pas directement leur qualité à budget égal. Il faudrait disposer des points correspondants. Le parcours ne fabrique pas un gain en interpolant entre des budgets différents.
Enfin, une seule seed est exécutée. Il n’y a ni moyenne sur trois seeds ni ruban d’incertitude autour des courbes. Retrouver exactement un parcours contrôle sa reproductibilité ; cela ne mesure pas la variabilité que l’on observerait avec d’autres tirages initiaux.
Résultats du parcours principal
Sur les 270 documents de test, le F1 exact vaut déjà 1 après les 60 annotations initiales. Il reste à 1 après les quatre cycles supplémentaires, pour les deux stratégies principales : aléatoire et BALD.
Les coûts finaux publiés sont 18 661 unités pour aléatoire et 18 620 pour BALD. L’écart de 41 unités provient de l’ordre de sélection et du coût des notes. Il ne correspond pas à des minutes de travail économisées.
Que peut-on conclure ? Le modèle réussit déjà le test au point de départ de cette comparaison. Ajouter des annotations ne peut pas faire monter un F1 déjà égal à 1. Le corpus et le point de départ ne permettent donc plus de distinguer les stratégies par cette mesure.
Ce résultat ne démontre ni un gain de BALD, ni son inutilité générale. Il ne prouve pas non plus que 60 annotations constituent le minimum nécessaire : nous n’avons pas mesuré tous les budgets plus petits. La réussite porte sur ces notes synthétiques et ce test, pas sur les documents d’une GED réelle.
La boucle conserve pourtant son intérêt pédagogique : demandes autorisées, coût contrôlé, sélections distinctes, apprentissage et reprise sont observables. On apprend à vérifier le mécanisme sans transformer un score au plafond en démonstration de rentabilité.
Hypothèse puis exercice de redondance
Prédire avant de lancer le scénario
Imaginez que les premières notes classées par BALD/coût aient de nombreuses reformulations très proches. Le modèle peut leur attribuer des scores élevés sans que chacune apporte autant de nouveauté qu’une note réellement différente.
Avant de lancer l’exercice, écrivez votre hypothèse : deux copies proches de chacune des dix notes initialement les mieux classées vont-elles concentrer la sélection sur des informations répétées ? Un filtre de diversité peut-il l’éviter, et que risque-t-il d’écarter au passage ? Distinguez votre prédiction sur le coût de celle sur le F1 : elles ne sont pas obligées d’évoluer ensemble.
Le filtre fourni utilise une similarité de Jaccard avec un seuil de 0,85. Pour comprendre la formule, prenons deux ensembles d’éléments : leur similarité est le nombre d’éléments communs, divisé par le nombre d’éléments présents dans au moins un des deux ensembles. L’identité donne 1 ; l’absence d’éléments communs donne 0.
Dans un exemple mathématique, 9 éléments communs sur une union de 10 donnent 0,9, au-dessus de 0,85. Huit éléments communs sur une union de dix donnent 0,8, en dessous. Ces petits ensembles illustrent le seuil ; ils ne remplacent pas la représentation et la règle de comparaison du code de l’exercice. La documentation SciPy sur Jaccard décrit sa version en distance, égale à 1 - similarité : ne confondez pas les deux sens du score.
Une ressemblance élevée n’est pas forcément une redondance sans intérêt. Deux phrases peuvent se ressembler presque entièrement alors qu’une référence ou une échéance importante a changé. Le filtre limite une forme de proximité ; il ne sait pas, par principe, quelles annotations seront les plus utiles.
Exécuter, puis comparer à son hypothèse
sh scripts/run_exercise.sh
Le scénario crée deux copies proches par note concernée, puis relance quatre cycles pour BALD seul et quatre cycles pour BALD avec filtre. Le test, le vocabulaire et les 60 annotations initiales restent fixes. Aucun gain de F1 ni aucune économie n’est imposé à l’expérience.
La correction consiste à comparer coût, types couverts et F1, sans modifier le test après avoir observé les résultats. Les types couverts permettent notamment de vérifier qu’une sélection ne concentre pas toute son attention sur une seule catégorie d’entités.
Dans le résultat fourni, le F1 final reste à 1 dans les deux variantes. Les coûts sont 18 645 unités avec les doublons et 18 617 avec le filtre de diversité, soit un écart de 28 unités. Ces valeurs appartiennent à l’exercice ; elles ne remplacent pas les coûts du parcours principal.
Le filtre change la sélection et sa dépense simulée, mais la mesure au plafond ne montre pas d’amélioration de qualité. On ne peut donc pas annoncer que la diversité est universellement utile, ni convertir cet écart en temps d’annotation gagné.
Produire les figures et nettoyer
Après avoir comparé l’exercice à votre hypothèse, produisez les figures et contrôlez les checkpoints. Conservez les sorties utiles après les deux premières commandes et avant le nettoyage, car clean.py --outputs-only effacera les résultats.
docker compose run --rm --no-deps tutorial python lesson/figures/plot.py
docker compose run --rm --no-deps tutorial python scripts/check_checkpoints.py
docker compose down
docker compose run --rm --no-deps tutorial python scripts/clean.py --outputs-only
docker compose down
plot.py génère les figures depuis les sorties. check_checkpoints.py contrôle les fichiers de sauvegarde. Les commandes docker compose down encadrent ensuite le nettoyage du projet.
Le script de nettoyage affiche et efface seulement outputs. Il ne supprime ni le corpus, ni les checkpoints, ni les fichiers d’autres projets Docker. C’est aussi pourquoi il faut conserver un checkpoint divergent pour inspection, plutôt que le supprimer avant de comprendre l’écart.
Dépannage, nettoyage et limites produit
Retrouver la cause d’un écart
Docker ne voit pas le GPU. Suivez le diagnostic du préflight et recommencez dans un nouveau dossier extrait. Distinguez la visibilité de la carte dans Linux de la réussite du calcul dans le conteneur ; check_environment.py vérifie cette seconde étape.
Une distribution marginale est rejetée. Examinez les dimensions, les valeurs non finies ou négatives, la normalisation sur les tokens réels et le masque. Un coût positif ne suffit pas non plus à établir qu’il correspond à la note demandée : l’oracle contrôle cette cohérence séparément. Ne remplacez pas les probabilités par des nombres arbitraires pour obtenir un score.
Une annotation traverse une fenêtre. Le corpus ne respecte plus le contrat de découpage du parcours. Déplacer la frontière en consultant les labels cachés contournerait précisément la règle étudiée. Pour un nouveau corpus, il faut définir et évaluer une stratégie de découpage adaptée, au lieu de masquer cette erreur.
La reprise diverge. Conservez les checkpoints et inspectez le modèle, l’optimiseur, l’ordre d’échantillonnage, les états aléatoires et la file d’annotation. Des sorties finales différentes peuvent venir d’un état restauré incomplètement, pas uniquement d’un mauvais modèle. Le nettoyage ciblé reste celui de la section précédente.
Ce qu’il manque pour une vraie équipe d’annotation
Le tutoriel remplace l’humain par un oracle parfait. Une application réelle doit au contraire définir les entités avec les métiers, former les annotateurs et mesurer leurs temps, coûts, erreurs et abandons. Une référence ambiguë, une échéance imprécise ou un désaccord entre deux personnes ne se résument pas au nombre de tokens.
L’équipe doit disposer du consentement et des droits d’accès requis pour les documents qu’elle utilise. Elle doit conserver le texte, ses offsets et ses révisions, prévoir les nouveaux types d’entités et gérer les erreurs de l’oracle réel — qu’il s’agisse d’une personne ou d’un processus de validation.
La couche produit demande aussi authentification, API, journaux, supervision, tests de charge, sauvegarde, restauration et revue humaine. Ces éléments sont des travaux à prévoir, pas des fonctionnalités déjà démontrées par cette boucle d’apprentissage.
Enfin, le modèle propose des spans à corriger ; il ne valide aucun statut, aucune personne et aucun accès. Détecter une date dans une note ne certifie pas que l’échéance a été approuvée. Le rôle de l’interface serait de présenter une proposition et sa source, sans les confondre avec une décision métier.
Synthèse
Nous sommes partis d’une question pratique : quelles notes faut-il annoter ensuite ? Le BiLSTM transforme les tokens en scores contextualisés ; le CRF organise ces scores en chemins BIO autorisés et fournit des marginales. Les passes avec dropout permettent ensuite de construire un score de désaccord, rapporté à un coût explicite.
La sélection n’a de sens que si elle ne connaît pas déjà les réponses. La séparation entre labels cachés, demande et oracle rend cette condition vérifiable. Le contrôle du budget et la reprise des états permettent de suivre exactement ce qui a été demandé et appris.
Il reste trois distinctions à garder : validité BIO et justesse des spans ; désaccord du modèle et probabilité d’erreur ; coût simulé et travail humain. Une mesure ne peut pas se substituer à l’autre.
Sur ce corpus, toutes les stratégies présentées atteignent F1 = 1. L’absence de gain observé est le résultat à retenir, pas un défaut à dissimuler. Le parcours nous apprend à construire et à examiner une boucle d’annotation active ; il ne démontre pas qu’elle améliore la productivité d’une équipe.
Sources primaires et compléments
Les données, paramètres, commandes et résultats présentés sont ceux du projet r001 lié en début d’article. Les phrases, petits treillis et calculs ajoutés pour l’explication sont des exemples pédagogiques, distincts des mesures de ce parcours.
Les références principales sont le tutoriel BiLSTM-CRF de PyTorch, la documentation torch.nn.LSTM 2.8 et l’article BALD avec dropout. Les liens complémentaires intégrés au fil du texte détaillent embeddings, dropout, calculs numériques, optimisation, reproductibilité, Jaccard et accès GPU.
Ces documentations éclairent les mécanismes ; elles ne remplacent pas les fichiers et dépendances du ZIP pour reproduire la révision r001.