





Imagine una página de back office que muestra notas de mantenimiento. Le gustaría identificar automáticamente una referencia de equipo, un sitio y una fecha límite, y mostrar esos elementos a la persona encargada de verificarlos. El problema no consiste solo en construir un modelo: antes hay que proporcionarle ejemplos correctamente anotados.
Sin embargo, en una GED, o gestión electrónica de documentos, un equipo no siempre puede revisar y anotar toda la colección. ¿Por qué notas empezar? ¿Las primeras de la lista? ¿Una selección al azar? ¿Aquellas sobre las que el modelo duda?
Esa es la cuestión del aprendizaje activo: entrenar un primer modelo con un pequeño conjunto anotado, hacerle examinar los textos aún disponibles y elegir después los próximos documentos que deben anotarse. Se espera así que las nuevas anotaciones resulten más útiles para el aprendizaje. Pero esa utilidad debe medirse, no deducirse del nombre del método.
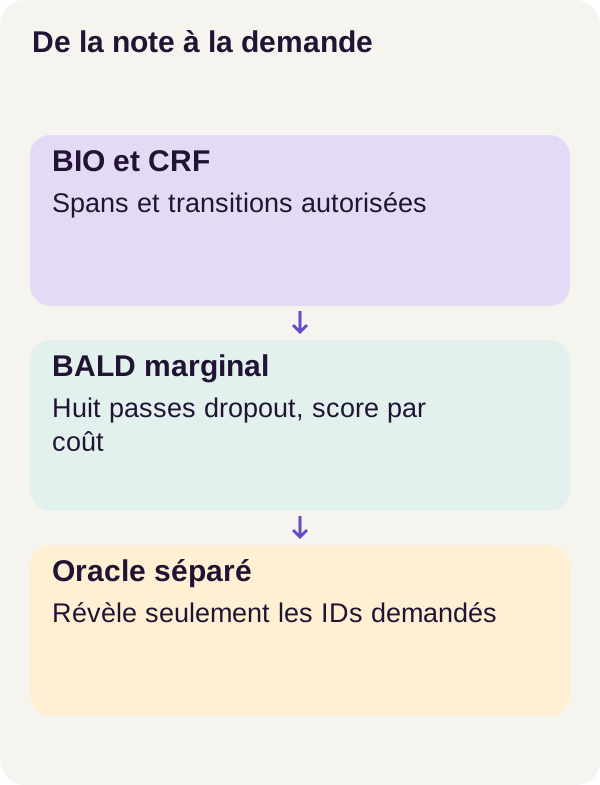
Construiremos este ciclo con notas ficticias. Un BiLSTM-CRF detecta entidades en el texto, una cola de selección elige notas con un presupuesto y un oráculo separado revela únicamente las anotaciones solicitadas. Explicaremos estos términos antes de ejecutar el proyecto: no se trata ni de pedir respuestas a un chatbot ni de desarrollar una interfaz completa de revisión.
El recorrido es una demostración reproducible, no una medición de productividad humana. El oráculo es un programa que ya posee las respuestas correctas del corpus sintético. No se observa ningún anotador, plazo, abandono ni tiempo de trabajo. El coste es una regla publicada: 5 + número de tokens por nota. Mantendremos esta distinción incluso al leer los resultados.
Descargar el proyecto completo, revisión r001
Los datos y la regla de no filtración
Detectar una entidad es recuperar un fragmento de texto preciso
Una entidad es aquí una porción de texto a la que asignamos un tipo: REFERENCE, SITE o ECHEANCE. Una anotación indica tanto ese tipo como los caracteres implicados. El modelo deberá aprender a proponer la misma información en una nota cuyas anotaciones desconoce.
Tomemos esta frase, añadida únicamente para explicar el mecanismo:
Prévoir AX-14 à Lyon Nord avant le 18 octobre.
Queremos detectar en ella AX-14 como referencia, Lyon Nord como sitio y 18 octobre como fecha límite. Una porción así se llama span. Los offsets son sus posiciones en el texto original: permiten resaltar la ocurrencia correcta, incluso si el mismo valor aparece varias veces.
En este ejemplo pedagógico, contando los caracteres desde cero y excluyendo el límite final, AX-14 ocupa [8, 13), Lyon Nord ocupa [16, 25) y 18 octobre ocupa [35, 45). La notación [8, 13) significa «del carácter 8 incluido al carácter 13 excluido». Son las posiciones de esta frase ilustrativa, no una nueva salida del proyecto.
El corpus conserva los offsets, incluidos los acentos, la puntuación y las referencias que contienen un guion. Para una futura interfaz, recuerde lo esencial: las posiciones siempre deben señalar la misma versión del texto. Modificar espacios o caracteres después de calcular los offsets puede desplazar el resaltado.
Repartir las notas antes de aprender
El corpus contiene 1.800 notas sintéticas, organizadas en 120 familias de 15 notas. Se reparte en 1.260 notas de entrenamiento, 270 de validación y 270 de prueba. Cada nota puede contener una referencia, un sitio y una fecha límite; su presencia no es obligatoria.
Estos tres conjuntos, llamados a menudo splits, no desempeñan el mismo papel. El entrenamiento proporciona los ejemplos a partir de los cuales aprende el modelo. La validación constituye un conjunto distinto para los controles de desarrollo. La prueba sirve para medir el resultado, sin alimentar las solicitudes de anotación del pool.
Una familia permanece íntegramente en un único conjunto. Así se evita repartir variantes de una misma familia entre entrenamiento y prueba. Esto no hace que el corpus sea representativo de una empresa: su vocabulario y su gramática siguen siendo los de un generador pedagógico controlado.
Transformar los spans en etiquetas BIO
La red no recibe directamente cadenas que haya que resaltar. El texto se divide en tokens, es decir, unidades que manipula el programa, y cada token recibe una etiqueta. Un token no es necesariamente una palabra completa; la segmentación exacta es la del proyecto.
Utilizamos la convención BIO: B- marca el inicio de una entidad, I- su continuación y O una posición fuera de las entidades buscadas. Con tres tipos obtenemos siete etiquetas: O, B-REFERENCE, I-REFERENCE, B-SITE, I-SITE, B-ECHEANCE e I-ECHEANCE.
Para entender la convención, supongamos simplemente que Lyon y Nord son dos tokens consecutivos. Etiquetamos Lyon con B-SITE y después Nord con I-SITE. La I- significa «continúo una entidad ya iniciada», no «inicio otra categoría».
Así, I-SITE solo puede seguir a B-SITE o a I-SITE. Después de O, hay que abrir el sitio con B-SITE. Después de B-REFERENCE, no se puede continuar directamente con I-SITE: el tipo cambiaría en medio de la entidad.
El vocabulario se construye solo a partir de los textos de entrenamiento. Las frases forman ventanas de hasta 128 tokens, sin solapamiento. La segmentación no consulta las anotaciones ocultas para escoger un límite conveniente: si una entidad atraviesa un límite, el corpus se considera inválido. Esta restricción forma parte del recorrido mostrado; no es una solución general para documentos de cualquier longitud.
El oráculo solo debe intervenir después de la selección
La semilla aleatoria, o seed, vale 17. Sirve aquí para elegir 60 notas iniciales de entrenamiento, dejando 1.200 notas en el pool. El pool es la reserva de notas cuyo texto está disponible pero cuyas anotaciones aún no se han revelado al proceso de aprendizaje.
Para un desarrollador web, imagine dos servicios con permisos distintos. El primero sabe elaborar una lista de identificadores que deben tratarse. El segundo posee las anotaciones y solo las devuelve para una solicitud autorizada.
El proyecto materializa esta separación: el proceso que clasifica el pool no monta ni el oráculo ni los archivos de etiquetas ocultas. Escribe una solicitud de IDs y calcula su huella, o hash, para identificar la solicitud registrada. Después, el oráculo abre únicamente los archivos solicitados, rechaza un duplicado, una nota fuera del entrenamiento o un coste incoherente y devuelve los spans.
El hash identifica la solicitud; la ausencia de acceso a las etiquetas impide leerlas durante la selección. Son dos funciones distintas. Una simple convención de «no mirar las respuestas» sería menos verificable que un proceso que no dispone de los archivos.
Sin esta separación, se podrían elegir las notas conociendo ya los errores del modelo en sus anotaciones reales. Ya no se mediría una estrategia que descubre las respuestas progresivamente, sino una estrategia ayudada por las respuestas que se supone que debe solicitar.
BiLSTM-CRF: de los tokens a una secuencia válida
El nombre combina dos mecanismos. El BiLSTM aporta contexto a cada token. El CRF evalúa las sucesiones de etiquetas para producir una secuencia que respete las reglas BIO. Descompongamos el recorrido en vez de considerar el conjunto como una caja negra.
De identificadores a puntuaciones de etiquetas
Un embedding es un vector, es decir, una lista de números, asociado a un token del vocabulario. Aquí, cada vector contiene 64 valores, aprendidos desde cero con el resto del modelo. No son representaciones recuperadas de un gran modelo preentrenado. La documentación de torch.nn.Embedding describe esta tabla de correspondencia entre identificadores y vectores.
El LSTM, por Long Short-Term Memory, es una red que recorre una secuencia conservando un estado. La versión bidireccional hace este recorrido en ambos sentidos. Así, un token se beneficia del contexto que le precede y del que le sigue. Con 64 unidades en cada sentido, las dos salidas reunidas proporcionan 128 valores por token, conforme al funcionamiento descrito en la documentación LSTM 2.8.
Dos capas de dropout a 0,25 rodean el LSTM. El dropout pone temporalmente a cero componentes numéricos elegidos al azar; no elimina las palabras de la nota ni borra parámetros de forma definitiva. El papel de este mecanismo en nuestra medida de incertidumbre aparece en la siguiente sección.
Por último, una proyección transforma los 128 valores en siete puntuaciones de emisión, una por etiqueta BIO. Una emisión indica en qué medida el modelo favorece una etiqueta en esa posición. Esa puntuación bruta aún no es una probabilidad ni un span terminado.
Para una ventana ilustrativa de diez tokens, el recorrido se lee así: diez identificadores, después una tabla 10 × 64, una tabla contextualizada 10 × 128 y finalmente 10 × 7 puntuaciones. Un tensor es simplemente la tabla numérica que contiene esos valores.
¿Por qué no elegir la mejor etiqueta en cada posición?
Porque una sucesión de buenas elecciones locales puede formar una secuencia prohibida. He aquí un pequeño cálculo pedagógico sobre Lyon Nord, reducido a tres etiquetas para que siga siendo legible. Estas puntuaciones se inventaron para la explicación, no se extrajeron de un entrenamiento.
| Token | Puntuación O |
Puntuación B-SITE |
Puntuación I-SITE |
|---|---|---|---|
| Lyon | 3 | 2 | 0 |
| Nord | 0 | 1 | 4 |
Elegir el número mayor de cada fila da O → I-SITE, con un total de 3 + 4 = 7. Pero esta secuencia anuncia una continuación sin haber abierto un sitio.
Supongamos, para este cálculo, que todas las puntuaciones de inicio, final y transiciones permitidas valen cero. La mejor secuencia legal pasa a ser B-SITE → I-SITE, con una puntuación de 2 + 4 = 6. Por tanto, la elección global no es necesariamente una sucesión de máximos locales.
El CRF, por Conditional Random Field o campo aleatorio condicional, asigna precisamente una puntuación a un camino completo. Combina las emisiones, una puntuación de inicio, una de final y las transiciones entre etiquetas sucesivas. En este proyecto, una transición se indexa en el sentido anterior hacia actual.
Inscribir las reglas BIO en el cálculo
El siguiente código construye las autorizaciones de inicio y de transición. TAGS es la lista de etiquetas del proyecto; este extracto se utiliza en su entorno, incluido en el ZIP.
def bio_constraints(tags=TAGS):
    start = torch.tensor([not t.startswith("I-") for t in tags])
    transitions = torch.ones((len(tags), len(tags)), dtype=torch.bool)
    for previous, a in enumerate(tags):
        for current, b in enumerate(tags):
            if b.startswith("I-"):
                transitions[previous, current] = a in ["B-" + b[2:], "I-" + b[2:]]
    return start, transitions
start es una tabla de booleanos: un valor verdadero permite que la etiqueta inicie la secuencia. Por tanto, las tres etiquetas I- están prohibidas al comienzo.
transitions es una matriz 7 × 7, inicialmente llena de valores verdaderos. El bucle examina cada pareja. Si la etiqueta actual b empieza por I-, b[2:] recupera su tipo, por ejemplo SITE. La transición solo sigue autorizada si la etiqueta anterior es B-SITE o I-SITE.
En cambio, una B- puede abrir una nueva entidad y O puede salir de una entidad. La función define lo que está permitido, no la puntuación aprendida de cada transición. Después, el CRF explota estas restricciones durante el entrenamiento y la decodificación.
Este matiz es importante: el proyecto no produce una secuencia ilegal para repararla después. Los caminos prohibidos se excluyen del cálculo previsto. Una secuencia válida puede seguir siendo falsa: nada impide que un modelo seleccione un sitio equivocado respetando perfectamente BIO.
Aprender con todos los caminos, predecir con el mejor
Dos cálculos utilizan el mismo conjunto de caminos permitidos, pero responden a preguntas distintas.
Viterbi busca el mejor camino. Conserva las mejores puntuaciones intermedias y los predecesores correspondientes, y luego remonta esas elecciones al final. Estos retrocesos reconstruyen la secuencia completa. Así se evita enumerar explícitamente todas las combinaciones de etiquetas.
La normalización logZ suma el peso de todos los caminos permitidos. Cada puntuación se convierte en un peso positivo mediante exponenciación. Z es su suma y logZ su logaritmo. La probabilidad de un camino se escribe entonces exp(score_du_chemin - logZ).
La función de pérdida, llamada NLL por negative log-likelihood, vale logZ - score_gold. Aquí, gold designa la secuencia de referencia revelada para el aprendizaje. Reducir esta pérdida empuja al modelo a asignar más probabilidad a la secuencia correcta, en relación con los demás caminos legales. El tutorial BiLSTM-CRF de PyTorch desarrolla la diferencia entre normalización y decodificación.
En nuestro ejemplo de dos tokens, los cinco caminos legales tienen las puntuaciones 3, 4, 2, 3 y 6. Se obtiene logZ ≈ 6,2257. Si la referencia es B-SITE → I-SITE, su pérdida vale aproximadamente 0,2257 y su probabilidad aproximadamente 0,7979. Ser el mejor camino no significa tener una probabilidad de 1.
El cálculo se realiza en log-space, es decir, en el espacio de los logaritmos, para limitar las dificultades numéricas. La operación log-sum-exp permite calcular de forma estabilizada el logaritmo de una suma de exponenciales. No sustituye la suma por el máximo: hacerlo cambiaría el problema.
Obtener una probabilidad por token sin olvidar el contexto
Para elegir las notas que deben anotarse, necesitamos marginales CRF: la probabilidad de cada etiqueta en cada posición, teniendo en cuenta los caminos completos. El término «marginal» significa que se reúnen las posibilidades relativas a las demás posiciones para concentrarse en esta.
No es un simple softmax aplicado de manera independiente a las siete emisiones. El cálculo hacia delante-hacia atrás combina las contribuciones que llegan a una posición y las que salen de ella. Con la convención del proyecto, la fórmula es exp(alpha + beta - logZ). En cada token real, las siete probabilidades deben sumar 1.
En el recorrido, este cálculo usa precisión FP64 a partir de emisiones FP32, para limitar los errores de redondeo. El entrenamiento GPU permanece en FP32: no se pasa toda la red a doble precisión. El pequeño entramado presentado para explicar los caminos contiene tres tags; el modelo del tutorial utiliza efectivamente siete.
Incertidumbre: lo que BALD aproxima realmente
Ahora sabemos predecir entidades. Falta elegir las próximas notas que deben anotarse, sin mirar sus respuestas. La estrategia estudiada compara varias predicciones de la misma red con dropout activo.
Hacer variar el cálculo sin reentrenar ocho modelos
El recorrido efectúa ocho pasadas con dropout. Los parámetros aprendidos siguen siendo los mismos, pero las máscaras de dropout varían y producen ocho distribuciones marginales por token. Esta repetición se llama Monte Carlo dropout: varios cálculos aleatorios sirven para aproximar una cantidad que no se calcula exactamente.
El dropout estándar de PyTorch está activo en el entrenamiento y desactivado en modo evaluación. Para estimar el desacuerdo, hay que conservar por tanto esta variación durante las pasadas previstas para ello. No son ni ocho nuevos entrenamientos ni ocho equipos independientes de anotadores.
BALD designa un criterio de aprendizaje activo basado en el desacuerdo. En su marco bayesiano, busca la información que una respuesta podría aportar sobre los parámetros del modelo. El artículo sobre BALD con dropout presenta una aproximación mediante pasadas estocásticas. Aquí aplicamos un cálculo de este tipo a las marginales de tokens de un CRF, no directamente a todas sus secuencias posibles.
Dudar de la misma forma no es contradecirse
Una entropía mide hasta qué punto una distribución se reparte entre varias posibilidades. Con dos probabilidades 0,5 y 0,5, es mayor que con 0,9 y 0,1. El cálculo del proyecto utiliza el logaritmo natural; por tanto, los valores de entropía no son porcentajes.
Para un token calculamos: la entropía de la distribución media, menos la media de las entropías. La primera observa todas las predicciones juntas; la segunda observa cuánto duda individualmente cada pasada.
Tomemos dos pasadas y dos etiquetas, únicamente para poder calcular a mano. El proyecto utiliza ocho pasadas y siete etiquetas, pero la resta es la misma.
Primer caso: las dos pasadas responden [0,5 ; 0,5]. Su media es [0,5 ; 0,5]. La entropía de la media vale aproximadamente 0,6931, igual que la entropía media. Por tanto, el desacuerdo calculado vale 0. Las pasadas dudan, pero dudan de forma idéntica.
Segundo caso: una pasada responde [0,9 ; 0,1] y la otra [0,1 ; 0,9]. La media sigue siendo [0,5 ; 0,5], por lo que su entropía sigue siendo 0,6931. Sin embargo, cada pasada es más tajante: su entropía vale aproximadamente 0,3251. La diferencia alcanza aproximadamente 0,3681.
La distribución media es idéntica en ambos casos, pero el desacuerdo no. Eso es lo que permite distinguir esta resta. A la inversa, varias pasadas pueden estar muy seguras de la misma respuesta equivocada: una puntuación baja no garantiza una anotación correcta.
Del desacuerdo de un token a la prioridad de una nota
El programa suma las contribuciones de los tokens reales en las ventanas de una nota y después divide por su coste: 5 + número de tokens. El padding, o relleno añadido para agrupar secuencias de longitudes distintas, se excluye mediante una máscara. Este relleno facilita el cálculo por lotes; no debe crear información ficticia.
Por tanto, la puntuación es una aproximación marginal por token de tipo BALD, relativa al coste. Los tokens están vinculados por el CRF; sumar sus contribuciones no calcula la información mutua condicional exacta de toda la secuencia y puede contar señales dependientes. El resultado no es ni una probabilidad de error ni una medida del beneficio humano de una anotación.
Esta es la función fuente. probabilities tiene la forma M × T × K: número de pasadas, número de posiciones, número de etiquetas. En el recorrido, M = 8 y K = 7.
import math
import torch


def marginal_bald_score(probabilities, mask, cost):
    # M x T x K; sum token-wise proxy, not joint-sequence mutual information.
    if (
        probabilities.ndim != 3
        or probabilities.shape[1] != len(mask)
        or probabilities.shape[0] < 2
        or cost <= 0
        or not torch.isfinite(probabilities).all()
        or (probabilities < 0).any()
    ):
        raise ValueError("Invalid dropout marginals/cost")
    if not torch.allclose(
        probabilities[:, mask].sum(-1),
        torch.ones_like(probabilities[:, mask, 0]),
        atol=1e-5,
    ):
        raise ValueError("Real-token marginals must normalize")
    entropy = lambda p: -(
        torch.where(p > 0, p * torch.log(p.clamp_min(1e-30)), torch.zeros_like(p))
    ).sum(-1)
    values = entropy(probabilities.mean(0)) - entropy(probabilities).mean(0)
    if values[mask].min() < -1e-5:
        raise ValueError("Negative information proxy beyond rounding tolerance")
    return float(values[mask].clamp_min(0).sum() / cost), values.masked_fill(~mask, 0)
El primer bloque comprueba, entre otras cosas, las tres dimensiones, la concordancia entre el número de posiciones y la longitud de la máscara, la presencia de al menos dos pasadas, valores no finitos o negativos y un coste menor o igual que cero. El bloque siguiente comprueba que cada distribución de token real sume 1. No basta con tener una tabla de números positivos para disponer de probabilidades coherentes.
La pequeña función entropy realiza la suma sobre la última dimensión, la de las etiquetas. El tratamiento de los ceros evita que contribuyan con un log(0); clamp_min(1e-30) protege el argumento del logaritmo. Después, probabilities.mean(0) promedia las pasadas antes de calcular una entropía, mientras que entropy(probabilities).mean(0) promedia las entropías ya calculadas.
En aritmética exacta, esta diferencia no es negativa para distribuciones válidas. El umbral -1e-5 tolera minúsculas diferencias de redondeo; un valor más negativo provoca un error. clamp_min(0) elimina esos pequeños residuos negativos de la puntuación sumada.
La función devuelve dos objetos: una puntuación escalar dividida por el coste y un vector de contribuciones cuyas posiciones de padding se ponen a cero. Este segundo objeto conserva los valores anteriores al clamp_min(0) de la puntuación; por tanto, todavía pueden aparecer en él residuos negativos muy pequeños.
El extracto supone una máscara booleana que contiene al menos un token real y un coste escalar finito. No comprueba por sí solo todos estos requisitos previos ni recalcula el coste desde el texto. El control de coherencia del coste mediante el protocolo y el oráculo sigue siendo una etapa distinta. Modificar silenciosamente una distribución o un coste para evitar un rechazo cambiaría el experimento.
Gastar un presupuesto, no llenar un cupo de documentos
Con nuestra regla, una nota de veinte tokens cuesta 25 unidades. No son veinticinco segundos. El 5 representa un componente fijo del coste simulado y el número de tokens su componente variable.
Otro ejemplo pedagógico: una nota cuya suma de contribuciones vale 0,6 y cuyo coste es 100 recibe una prioridad de 0,006. Otra, con una suma de 0,4 y un coste de 40, recibe 0,01. La segunda queda por delante, pese a una contribución bruta menor, porque la clasificación se realiza por unidad de coste.
La referencia, o baseline, es una selección aleatoria de prioridad determinista y sin reemplazo: una vez seleccionada, una nota no vuelve a la reserva por anotar. «Determinista» significa aquí que el mismo recorrido puede recuperar el orden previsto, no que ese orden aproveche la incertidumbre del modelo.
Aleatorio y BALD comparten las 60 notas iniciales, los límites, la arquitectura y la prueba. Cada ciclo añade como máximo 4.000 unidades. Una nota que no cabe en el presupuesto restante se salta y la cola continúa. Con 30 unidades restantes, una nota que cuesta 35 puede descartarse mientras otra posterior que cuesta 20 aún entra en el ciclo: este ejemplo ilustra la regla, sin añadir una medición al recorrido.
Se obtiene una clasificación con control de presupuesto, no una prueba de que el conjunto elegido sea óptimo. Dos estrategias pueden terminar el mismo número de ciclos con gastos diferentes. Compararemos por tanto F1 con el coste acumulado realmente consumido, no solo con el número de ciclo.
Ejecutar los 21 comandos documentados
Preparar el entorno y comprobar los cálculos
Debe poder leer Python y utilizar una terminal con Docker. Las nociones útiles son los tensores, las probabilidades, las secuencias y los gradientes. Los ejemplos anteriores ofrecen puntos de referencia para la lectura; los bloques de código se integran en el proyecto completo, no en un script aislado que haya que reconstruir.
El perfil de referencia utiliza Linux y una RTX 3090 de 24 Gio, con 16 Gio de RAM y 10 Gio de disco de trabajo, a los que se añade el almacenamiento Docker. Son recomendaciones de preparación, no mínimos medidos en todas las configuraciones. La RAM es la memoria de la máquina; los 24 Gio de la tarjeta son su memoria de vídeo.
La integración entre Docker y la GPU NVIDIA debe estar operativa. La documentación de NVIDIA Container Toolkit describe esta integración. Que una GPU sea visible en el host no basta: check_environment.py ejecuta un forward y un backward del BiLSTM-CRF en el contenedor. El forward produce las puntuaciones a partir de las entradas; el backward calcula los gradientes necesarios para el aprendizaje.
Descomprima el ZIP en un directorio nuevo y sitúe la terminal en su raíz. Todos los comandos siguientes parten de esa carpeta. Encadenaremos los 15 comandos del recorrido principal, el del ejercicio y los cinco comandos finales: los 21 comandos del recorrido proporcionado.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference initialization oracle
docker compose run --rm --no-deps acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm --no-deps tutorial python scripts/check_environment.py
docker compose run --rm --no-deps tutorial python -m pytest -q
El preflight controla el entorno; el setup prepara el proyecto; Compose comprueba su configuración y después construye los servicios. La adquisición comprueba un registro vacío: no se requiere ningún modelo preentrenado. Por tanto, esta etapa no tiene que descargar un LLM ni embeddings externos.
El control del entorno comprueba después el cálculo en Docker y pytest ejecuta las pruebas del proyecto. Un código de retorno nulo indica que cada comando se ha ejecutado correctamente. Las pruebas del programa no sustituyen la medición de la calidad de las entidades, que llega más adelante.
Crear el corpus y revelar las primeras anotaciones
Los servicios no desempeñan todos el mismo papel. initialization ejecuta las operaciones de arranque; oracle revela las anotaciones autorizadas; las funciones de aprendizaje e inferencia permanecen separadas. Los montajes del archivo Compose materializan los accesos previstos. Los cálculos están aislados de la red y el oráculo no reserva GPU.
docker compose run --rm --no-deps tutorial python -m ged_annotation_active_entites.cli prepare --config configs/minimum.yaml
docker compose run --rm --no-deps initialization python -m ged_annotation_active_entites.cli request-initial --config configs/minimum.yaml
docker compose run --rm --no-deps oracle python -m ged_annotation_active_entites.cli reveal --config configs/minimum.yaml
docker compose run --rm --no-deps initialization python -m ged_annotation_active_entites.cli baseline --config configs/minimum.yaml
docker compose run --rm --no-deps initialization python -m ged_annotation_active_entites.cli predict --config configs/minimum.yaml --cycle 0
prepare construye el corpus y sus particiones. Compruebe los conteos 1.260 / 270 / 270 y la separación de familias antes de interpretar una métrica.
request-initial solicita las 60 notas iniciales y después reveal proporciona sus spans. Las dos operaciones siguen siendo distintas: la solicitud existe antes de que se devuelvan las anotaciones. El comando baseline construye el punto de partida y predict --cycle 0 produce las predicciones de este ciclo inicial.
El ciclo 0 no es el modelo sin entrenar. Es el punto de comparación obtenido tras aprender con las anotaciones iniciales, antes de los cuatro ciclos adicionales de anotación. Confundir ambos estados cambiaría por completo la interpretación del resultado.
Inspeccionar el mecanismo antes de multiplicar los ciclos
docker compose run --rm --no-deps tutorial python -m ged_annotation_active_entites.cli inspect-mechanism --config configs/minimum.yaml
Esta etapa sirve para relacionar los cálculos con sus representaciones. En una secuencia, distinga el camino BIO elegido de las distribuciones marginales. Compruebe que cada token real posee una distribución de masa total 1 y que las posiciones de relleno no contribuyen a la puntuación de selección.
El entramado simplificado con tres tags ayuda a leer el mecanismo; no describe una reducción del modelo real a tres etiquetas. Del mismo modo, los pequeños ejemplos numéricos de este artículo son explicaciones, no nuevos resultados de entrenamiento.
Ejecutar cuatro ciclos y después evaluar
sh scripts/run_all.sh
docker compose run --rm --no-deps tutorial python -m ged_annotation_active_entites.cli evaluate --config configs/minimum.yaml
run_all.sh encadena selección, revelación y aprendizaje durante cuatro ciclos. Las anotaciones obtenidas enriquecen progresivamente el conjunto de entrenamiento. Cada estrategia respeta sus límites, pero no solicita necesariamente las mismas notas.
En cada ciclo, el modelo parte de los mismos parámetros sin entrenar y aprende durante ocho épocas con las anotaciones entonces disponibles. Una época es un paso por los ejemplos de entrenamiento; un ciclo de anotación incluye la selección de nuevas notas y el aprendizaje posterior. Ocho épocas no significan ocho nuevas solicitudes de anotación.
Esta elección no es un fine-tuning continuo del modelo del ciclo anterior. Las anotaciones se acumulan, pero los pesos parten del mismo estado inicial en cada ciclo. Esto fija las condiciones de comparación de las estrategias; reutilizar los pesos del ciclo anterior constituiría otro experimento.
El optimizador es AdamW, con lr=0,003, weight_decay=0,001, un batch de 16 y un clipping a 1. Un batch es un lote de ejemplos tratado durante el aprendizaje. Los gradientes describen cómo varía la pérdida con los parámetros; el optimizador los utiliza para ajustarlos. La tasa lr regula la amplitud de estas actualizaciones, mientras que el weight decay aplica una regularización de los pesos. La documentación de AdamW precisa este mecanismo.
El clipping limita la amplitud de los gradientes según la regla del proyecto. No limita ni la puntuación F1 ni el número de notas seleccionadas. Para entender el principio de una limitación de norma, la documentación de clip_grad_norm_ ofrece información adicional.
Reanudar una interrupción no es reiniciar un ciclo
El recorrido también comprueba una interrupción después de la época 4 del ciclo 2. Esta vez hay que reanudar el aprendizaje ya iniciado, no volver a los parámetros iniciales del ciclo.
El checkpoint, o punto de guardado, debe restaurar el modelo, el optimizador, el sampler que organiza el muestreo, los RNG o generadores pseudoaleatorios, el pool, la solicitud y las anotaciones. Restaurar solo los pesos no basta: una cola distinta o nuevas extracciones de dropout pueden modificar lo que sigue.
El control exige que las selecciones y predicciones futuras sigan siendo idénticas a las del recorrido sin interrupción. Es más exigente que obtener el mismo F1 final: dos modelos pueden tener la misma puntuación sin haber seguido el mismo experimento.
Esta comprobación concierne al entorno reproducido. La documentación de PyTorch sobre reproducibilidad recuerda que una semilla idéntica no garantiza resultados idénticos tras un cambio de versión o plataforma.
Leer F1 y coste con un ejemplo
Una frontera casi correcta sigue siendo un error de extracción
La medición se refiere a spans exactos: los límites de caracteres y el tipo deben coincidir con la referencia. No se limita a comprobar que algunas palabras se solapan.
Si la referencia espera AX-14, pero el modelo predice solo AX, falta la entidad exacta esperada: es un falso negativo. También ha emitido una entidad que no corresponde a la referencia: es un falso positivo. Ambos conteos no representan dos notas erróneas; describen los dos lados de una misma extracción incorrecta.
La precisión mide la proporción de spans predichos que son correctos. El recall mide la proporción de spans esperados que se han recuperado. El F1 combina ambos mediante una media armónica, para que una buena precisión no oculte un mal recall, ni a la inversa.
Retomemos el ejemplo del recorrido: 8 spans correctos, 2 predicciones de más y 2 spans olvidados. La precisión vale 8 / (8 + 2) = 0,8, el recall también vale 0,8 y el F1 vale 2 × precisión × recall / (precisión + recall) = 0,8.
El informe conserva los tipos de entidades, sus soportes, es decir, sus efectivos de referencia, y diagnósticos de frontera. Estos detalles ayudan a comprender un error; no transforman una coincidencia parcial en éxito para el F1 exacto.
Colocar el presupuesto, no el ciclo, en el eje horizontal
La curva sitúa F1 en ordenadas, en el eje vertical, y las unidades de anotación realmente consumidas en abscisas, en el eje horizontal. El número de ciclo no basta: dos colas pueden haber solicitado notas de longitudes distintas y gastado costes diferentes.
Por ejemplo, comparar un método tras 3.000 unidades y otro tras 4.000 unidades no mide directamente su calidad con el mismo presupuesto. Habría que disponer de los puntos correspondientes. El recorrido no fabrica una ganancia interpolando entre presupuestos distintos.
Por último, solo se ejecuta una seed. No hay ni promedio sobre tres seeds ni banda de incertidumbre alrededor de las curvas. Recuperar exactamente un recorrido controla su reproducibilidad; no mide la variabilidad que se observaría con otras selecciones iniciales.
Resultados del recorrido principal
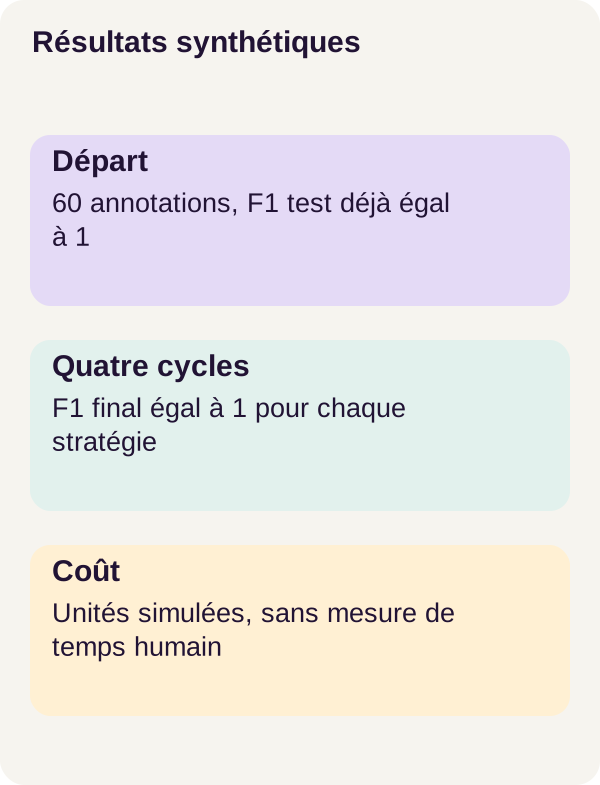
En los 270 documentos de prueba, el F1 exacto ya vale 1 después de las 60 anotaciones iniciales. Permanece en 1 después de los cuatro ciclos adicionales, para las dos estrategias principales: aleatoria y BALD.
Los costes finales publicados son 18.661 unidades para aleatoria y 18.620 para BALD. La diferencia de 41 unidades procede del orden de selección y del coste de las notas. No corresponde a minutos de trabajo ahorrados.
¿Qué se puede concluir? El modelo ya supera la prueba en el punto de partida de esta comparación. Añadir anotaciones no puede elevar un F1 que ya es igual a 1. Por tanto, el corpus y el punto de partida ya no permiten distinguir las estrategias mediante esta medida.
Este resultado no demuestra ni una ganancia de BALD ni su inutilidad general. Tampoco prueba que 60 anotaciones sean el mínimo necesario: no hemos medido todos los presupuestos más pequeños. El éxito se refiere a estas notas sintéticas y a esta prueba, no a los documentos de una GED real.
El ciclo conserva, sin embargo, su interés pedagógico: solicitudes autorizadas, coste controlado, selecciones distintas, aprendizaje y reanudación son observables. Se aprende a comprobar el mecanismo sin convertir una puntuación en el techo en una demostración de rentabilidad.
Hipótesis y después ejercicio de redundancia
Predecir antes de ejecutar el escenario
Imagine que las primeras notas clasificadas por BALD/coste tienen numerosas reformulaciones muy cercanas. El modelo puede asignarles puntuaciones elevadas sin que cada una aporte tanta novedad como una nota realmente diferente.
Antes de ejecutar el ejercicio, escriba su hipótesis: ¿dos copias cercanas de cada una de las diez notas inicialmente mejor clasificadas concentrarán la selección en información repetida? ¿Puede un filtro de diversidad evitarlo y qué corre el riesgo de descartar a cambio? Distinga su predicción sobre el coste de la relativa al F1: no tienen por qué evolucionar juntas.
El filtro proporcionado utiliza una similitud de Jaccard con un umbral de 0,85. Para entender la fórmula, tomemos dos conjuntos de elementos: su similitud es el número de elementos comunes dividido por el número de elementos presentes en al menos uno de los dos conjuntos. La identidad da 1; la ausencia de elementos comunes da 0.
En un ejemplo matemático, 9 elementos comunes sobre una unión de 10 dan 0,9, por encima de 0,85. Ocho elementos comunes sobre una unión de diez dan 0,8, por debajo. Estos pequeños conjuntos ilustran el umbral; no sustituyen la representación y la regla de comparación del código del ejercicio. La documentación de SciPy sobre Jaccard describe su versión como distancia, igual a 1 - similitud: no confunda ambos sentidos de la puntuación.
Una similitud elevada no es necesariamente una redundancia sin interés. Dos frases pueden parecerse casi por completo aunque haya cambiado una referencia o una fecha límite importante. El filtro limita una forma de proximidad; por principio, no sabe qué anotaciones serán las más útiles.
Ejecutar y comparar después con la hipótesis
sh scripts/run_exercise.sh
El escenario crea dos copias cercanas por cada nota afectada y después relanza cuatro ciclos para BALD solo y cuatro ciclos para BALD con filtro. La prueba, el vocabulario y las 60 anotaciones iniciales permanecen fijos. El experimento no impone ninguna ganancia de F1 ni ningún ahorro.
La corrección consiste en comparar coste, tipos cubiertos y F1, sin modificar la prueba después de observar los resultados. Los tipos cubiertos permiten en particular comprobar que una selección no concentre toda su atención en una sola categoría de entidades.
En el resultado proporcionado, el F1 final permanece en 1 en ambas variantes. Los costes son 18.645 unidades con los duplicados y 18.617 con el filtro de diversidad, una diferencia de 28 unidades. Estos valores pertenecen al ejercicio; no sustituyen los costes del recorrido principal.
El filtro cambia la selección y su gasto simulado, pero la medición en el techo no muestra una mejora de calidad. Por tanto, no se puede anunciar que la diversidad sea universalmente útil ni convertir esta diferencia en tiempo de anotación ganado.
Producir las figuras y limpiar
Después de comparar el ejercicio con su hipótesis, produzca las figuras y compruebe los checkpoints. Conserve las salidas útiles después de los dos primeros comandos y antes de la limpieza, porque clean.py --outputs-only borrará los resultados.
docker compose run --rm --no-deps tutorial python lesson/figures/plot.py
docker compose run --rm --no-deps tutorial python scripts/check_checkpoints.py
docker compose down
docker compose run --rm --no-deps tutorial python scripts/clean.py --outputs-only
docker compose down
plot.py genera las figuras a partir de las salidas. check_checkpoints.py comprueba los archivos de guardado. Los comandos docker compose down enmarcan después la limpieza del proyecto.
El script de limpieza muestra y borra solo outputs. No elimina ni el corpus, ni los checkpoints, ni los archivos de otros proyectos Docker. Por eso hay que conservar un checkpoint divergente para inspeccionarlo, en lugar de borrarlo antes de comprender la diferencia.
Solución de problemas, limpieza y límites de producto
Encontrar la causa de una diferencia
Docker no ve la GPU. Siga el diagnóstico del preflight y vuelva a empezar en una carpeta recién extraída. Distinga la visibilidad de la tarjeta en Linux de la ejecución correcta del cálculo en el contenedor; check_environment.py comprueba esta segunda etapa.
Se rechaza una distribución marginal. Examine las dimensiones, los valores no finitos o negativos, la normalización en los tokens reales y la máscara. Tampoco basta un coste positivo para demostrar que corresponde a la nota solicitada: el oráculo comprueba esta coherencia por separado. No sustituya las probabilidades por números arbitrarios para obtener una puntuación.
Una anotación atraviesa una ventana. El corpus ya no respeta el contrato de segmentación del recorrido. Mover el límite consultando las etiquetas ocultas sortearía precisamente la regla estudiada. Para un corpus nuevo, hay que definir y evaluar una estrategia de segmentación adaptada, en vez de ocultar este error.
La reanudación diverge. Conserve los checkpoints e inspeccione el modelo, el optimizador, el orden de muestreo, los estados aleatorios y la cola de anotación. Unas salidas finales diferentes pueden proceder de un estado restaurado de forma incompleta, no solo de un modelo equivocado. La limpieza específica sigue siendo la de la sección anterior.
Lo que falta para un verdadero equipo de anotación
El tutorial sustituye al humano por un oráculo perfecto. En cambio, una aplicación real debe definir las entidades con las áreas de negocio, formar a los anotadores y medir sus tiempos, costes, errores y abandonos. Una referencia ambigua, una fecha límite imprecisa o un desacuerdo entre dos personas no se reducen al número de tokens.
El equipo debe disponer del consentimiento y los derechos de acceso necesarios para los documentos que utiliza. Debe conservar el texto, sus offsets y sus revisiones, prever los nuevos tipos de entidades y gestionar los errores del oráculo real, ya sea una persona o un proceso de validación.
La capa de producto también requiere autenticación, API, registros, supervisión, pruebas de carga, copia de seguridad, restauración y revisión humana. Estos elementos son trabajos por prever, no funcionalidades ya demostradas por este ciclo de aprendizaje.
Por último, el modelo propone spans que deben corregirse; no valida ningún estado, ninguna persona ni ningún acceso. Detectar una fecha en una nota no certifica que la fecha límite haya sido aprobada. La función de la interfaz sería presentar una propuesta y su fuente, sin confundirlas con una decisión de negocio.
Síntesis
Partimos de una pregunta práctica: ¿qué notas hay que anotar a continuación? El BiLSTM transforma los tokens en puntuaciones contextualizadas; el CRF organiza estas puntuaciones en caminos BIO permitidos y proporciona marginales. Las pasadas con dropout permiten después construir una puntuación de desacuerdo, referida a un coste explícito.
La selección solo tiene sentido si no conoce ya las respuestas. La separación entre etiquetas ocultas, solicitud y oráculo hace verificable esta condición. El control del presupuesto y la reanudación de estados permiten seguir exactamente lo que se ha solicitado y aprendido.
Quedan tres distinciones que conservar: validez BIO y exactitud de los spans; desacuerdo del modelo y probabilidad de error; coste simulado y trabajo humano. Una medición no puede sustituir a otra.
En este corpus, todas las estrategias presentadas alcanzan F1 = 1. La ausencia de ganancia observada es el resultado que hay que recordar, no un defecto que ocultar. El recorrido enseña a construir y examinar un ciclo de aprendizaje activo; no demuestra que mejore la productividad de un equipo.
Fuentes primarias y complementos
Los datos, parámetros, comandos y resultados presentados son los del proyecto r001 enlazado al inicio del artículo. Las frases, pequeños entramados y cálculos añadidos para la explicación son ejemplos pedagógicos, distintos de las mediciones de este recorrido.
Las referencias principales son el tutorial BiLSTM-CRF de PyTorch, la documentación de torch.nn.LSTM 2.8 y el artículo BALD con dropout. Los enlaces complementarios integrados a lo largo del texto detallan embeddings, dropout, cálculos numéricos, optimización, reproducibilidad, Jaccard y acceso a GPU.
Estas documentaciones aclaran los mecanismos; no sustituyen los archivos y las dependencias del ZIP para reproducir la revisión r001.