





Immaginate una pagina di back office che mostra note di manutenzione. Vorreste individuarvi automaticamente un riferimento di materiale, un sito e una scadenza, quindi mostrare questi elementi alla persona incaricata di verificarli. Il problema non è soltanto costruire un modello: occorre prima fornirgli esempi annotati correttamente.
In una GED, o gestione elettronica dei documenti, un team non può necessariamente rileggere e annotare l'intera raccolta. Da quali note iniziare? Le prime della lista? Un'estrazione casuale? Quelle sulle quali il modello esita?
È la questione dell'annotazione attiva: addestrare un primo modello con un piccolo insieme annotato, fargli esaminare i testi ancora disponibili e poi scegliere i documenti successivi da annotare. Si spera così di rendere le nuove annotazioni più utili all'apprendimento. Ma questa utilità va misurata, non dedotta dal nome del metodo.
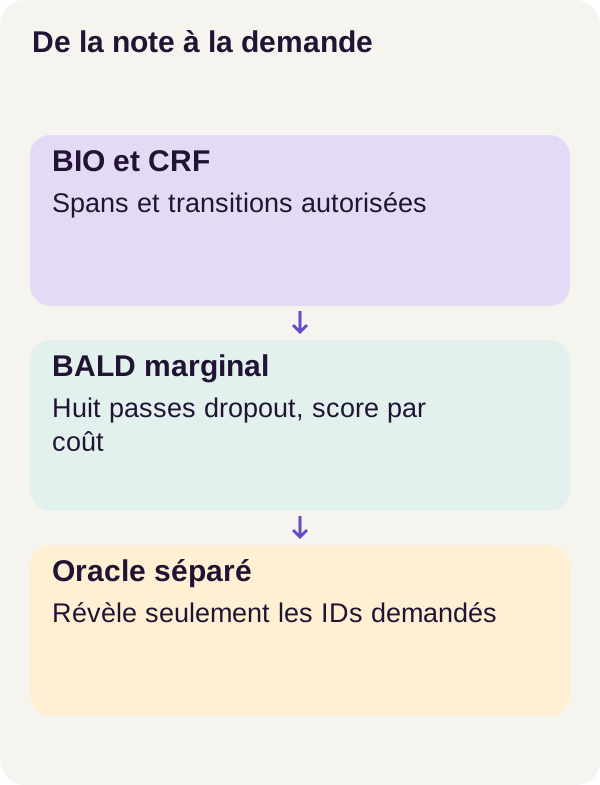
Costruiremo questo ciclo su note fittizie. Un BiLSTM-CRF individua entità nel testo, una coda di selezione sceglie note entro un budget, poi un oracolo separato rivela soltanto le annotazioni richieste. Spiegheremo questi termini prima di eseguire il progetto: non si tratta né di chiedere risposte a un chatbot né di sviluppare un'interfaccia di revisione completa.
Il percorso è una dimostrazione riproducibile, non una misura della produttività umana. L'oracolo è un programma che possiede già le risposte corrette del corpus sintetico. Non si osservano annotatori, ritardi, abbandoni o tempo di lavoro. Il costo è una regola pubblicata: 5 + numero di token per nota. Manterremo questa distinzione anche nella lettura dei risultati.
Scaricare il progetto completo, revisione r001
I dati e la regola contro la fuga di informazioni
Individuare un'entità significa ritrovare una precisa porzione di testo
Un'entità è qui una porzione di testo alla quale attribuiamo un tipo: REFERENCE, SITE o ECHEANCE. Un'annotazione indica sia il tipo sia i caratteri interessati. Il modello dovrà imparare a proporre le stesse informazioni su una nota di cui non conosce le annotazioni.
Prendiamo questa frase, aggiunta soltanto per spiegare il meccanismo:
Prévoir AX-14 à Lyon Nord avant le 18 octobre.
Vogliamo individuarvi AX-14 come riferimento, Lyon Nord come sito e 18 octobre come scadenza. Una simile porzione è chiamata span. Gli offset sono le sue posizioni nel testo originale: consentono di evidenziare l'occorrenza corretta, anche se lo stesso valore compare più volte.
In questo esempio didattico, contando i caratteri a partire da zero ed escludendo il limite finale, AX-14 occupa [8, 13), Lyon Nord occupa [16, 25) e 18 octobre occupa [35, 45). La notazione [8, 13) significa «dal carattere 8 incluso al carattere 13 escluso». Sono le posizioni di questa frase illustrativa francese, non un nuovo output del progetto.
Il corpus conserva gli offset, anche con accenti, punteggiatura e riferimenti contenenti un trattino. Per una futura interfaccia, ricordate il punto essenziale: le posizioni devono sempre designare la stessa versione del testo. Modificare spazi o caratteri dopo aver calcolato gli offset può spostare l'evidenziazione.
Ripartire le note prima di imparare
Il corpus contiene 1 800 note sintetiche, organizzate in 120 famiglie di 15 note. È ripartito in 1 260 note di addestramento, 270 di validazione e 270 di test. Ogni nota può contenere un riferimento, un sito e una scadenza; la loro presenza non è obbligatoria.
Questi tre insiemi, spesso chiamati split, non hanno lo stesso ruolo. L'addestramento fornisce gli esempi dai quali il modello apprende. La validazione costituisce un insieme distinto per i controlli di sviluppo. Il test serve a misurare il risultato, senza alimentare le richieste di annotazione del pool.
Una famiglia resta interamente in un solo insieme. Si evita così di distribuire le varianti di una stessa famiglia fra addestramento e test. Questo non rende il corpus rappresentativo di un'azienda: il suo vocabolario e la sua grammatica restano quelli di un generatore didattico controllato.
Trasformare gli span in etichette BIO
La rete non riceve direttamente stringhe da evidenziare. Il testo viene suddiviso in token, cioè unità manipolate dal programma, poi ogni token riceve un'etichetta. Un token non è necessariamente una parola intera; la segmentazione esatta resta quella del progetto.
Usiamo la convenzione BIO: B- segna l'inizio di un'entità, I- la sua continuazione e O una posizione esterna alle entità cercate. Con tre tipi otteniamo sette etichette: O, B-REFERENCE, I-REFERENCE, B-SITE, I-SITE, B-ECHEANCE e I-ECHEANCE.
Per capire la convenzione, supponiamo semplicemente che Lyon e Nord siano due token successivi. Etichettiamo Lyon con B-SITE, poi Nord con I-SITE. I- significa «continuo un'entità già iniziata», non «inizio un'altra categoria».
Quindi I-SITE può seguire solo B-SITE o I-SITE. Dopo O, bisogna aprire il sito con B-SITE. Dopo B-REFERENCE, non si può proseguire direttamente con I-SITE: il tipo cambierebbe nel mezzo dell'entità.
Il vocabolario è costruito a partire dai soli testi di addestramento. Le frasi formano finestre di al massimo 128 token, senza sovrapposizione. La segmentazione non consulta le annotazioni nascoste per scegliere un confine comodo: se un'entità attraversa un confine, il corpus è considerato non valido. Questa restrizione fa parte del percorso mostrato; non è una soluzione generale per documenti di qualsiasi lunghezza.
L'oracolo deve intervenire soltanto dopo la selezione
Il seme casuale, o seed, vale 17. Serve qui a scegliere 60 note iniziali di addestramento, lasciando 1 200 note nel pool. Il pool è la riserva di note il cui testo è disponibile, ma le cui annotazioni non sono ancora rivelate al percorso di apprendimento.
Per uno sviluppatore web, immaginate due servizi con diritti diversi. Il primo sa compilare un elenco di identificativi da trattare. Il secondo possiede le annotazioni e le restituisce soltanto per una richiesta autorizzata.
Il progetto concretizza questa separazione: il processo che classifica il pool non monta né l'oracolo né i file delle etichette nascoste. Scrive una richiesta di ID e ne calcola un'impronta, o hash, per identificare la richiesta registrata. L'oracolo apre poi soltanto i file richiesti, rifiuta un duplicato, una nota fuori dall'addestramento o un costo incoerente, quindi restituisce gli span.
L'hash identifica la richiesta; l'assenza di accesso alle etichette impedisce di leggerle durante la selezione. Sono due ruoli diversi. Una semplice convenzione «non guardare le risposte» sarebbe meno verificabile di un processo che non dispone dei file.
Senza questa separazione, si potrebbero scegliere le note conoscendo già gli errori del modello sulle loro vere annotazioni. Non si misurerebbe più una strategia che scopre le risposte progressivamente, ma una strategia aiutata dalle risposte che dovrebbe chiedere.
BiLSTM-CRF: dai token a una sequenza valida
Il nome combina due meccanismi. Il BiLSTM fornisce un contesto a ogni token. Il CRF valuta le successioni di etichette per produrre una sequenza che rispetta le regole BIO. Scomponiamo il percorso invece di considerare l'insieme una scatola nera.
Dagli identificativi ai punteggi delle etichette
Un embedding è un vettore, quindi una lista di numeri, associato a un token del vocabolario. Qui ogni vettore contiene 64 valori, appresi da zero insieme al resto del modello. Non sono rappresentazioni ottenute da un grande modello preaddestrato. La documentazione di torch.nn.Embedding descrive questa tabella di corrispondenza fra identificativi e vettori.
Il LSTM, per Long Short-Term Memory, è una rete che percorre una sequenza mantenendo uno stato. La versione bidirezionale compie questo percorso in entrambi i sensi. Un token beneficia quindi del contesto che lo precede e di quello che lo segue. Con 64 unità in ciascun senso, le due uscite riunite forniscono 128 valori per token, come descritto nella documentazione LSTM 2.8.
Due livelli di dropout a 0,25 circondano il LSTM. Il dropout azzera temporaneamente componenti numeriche estratte a caso; non rimuove le parole dalla nota né elimina definitivamente parametri. Il ruolo di questo meccanismo nella nostra misura d'incertezza arriva nella sezione seguente.
Infine, una proiezione trasforma i 128 valori in sette punteggi di emissione, uno per etichetta BIO. Un'emissione indica quanto il modello favorisca un'etichetta in quella posizione. Questo punteggio grezzo non è ancora né una probabilità né uno span concluso.
Per una finestra illustrativa di dieci token, il percorso si legge quindi così: dieci identificativi, poi una tabella 10 × 64, una tabella contestualizzata 10 × 128 e infine 10 × 7 punteggi. Un tensore è semplicemente la tabella numerica che contiene questi valori.
Perché non scegliere l'etichetta migliore in ogni posizione?
Perché una successione di buone scelte locali può formare una sequenza vietata. Ecco un piccolo calcolo didattico su Lyon Nord, ridotto a tre etichette per restare leggibile. Questi punteggi sono inventati per la spiegazione, non estratti da un addestramento.
| Token | Punteggio O |
Punteggio B-SITE |
Punteggio I-SITE |
|---|---|---|---|
| Lyon | 3 | 2 | 0 |
| Nord | 0 | 1 | 4 |
Scegliere il numero più grande di ogni riga dà O → I-SITE, per un totale di 3 + 4 = 7. Ma questa sequenza annuncia una continuazione senza aver aperto un sito.
Supponiamo, per questo calcolo, che tutti i punteggi di inizio, fine e transizioni autorizzate valgano zero. La migliore sequenza legale diventa B-SITE → I-SITE, con punteggio 2 + 4 = 6. La scelta globale non è quindi necessariamente una successione di massimi locali.
Il CRF, per Conditional Random Field o campo casuale condizionale, assegna precisamente un punteggio a un percorso completo. Combina le emissioni, un punteggio iniziale, un punteggio finale e le transizioni fra etichette successive. In questo progetto, una transizione è indicizzata nel senso precedente verso corrente.
Inserire le regole BIO nel calcolo
Il codice seguente costruisce le autorizzazioni di inizio e transizione. TAGS è l'elenco di etichette del progetto; questo estratto si usa nel suo ambiente, fornito nello ZIP.
def bio_constraints(tags=TAGS):
    start = torch.tensor([not t.startswith("I-") for t in tags])
    transitions = torch.ones((len(tags), len(tags)), dtype=torch.bool)
    for previous, a in enumerate(tags):
        for current, b in enumerate(tags):
            if b.startswith("I-"):
                transitions[previous, current] = a in ["B-" + b[2:], "I-" + b[2:]]
    return start, transitions
start è un array di booleani: un valore vero autorizza l'etichetta a iniziare la sequenza. Le tre etichette I- sono quindi vietate all'inizio.
transitions è una matrice 7 × 7, inizialmente riempita di valori veri. Il ciclo esamina ogni coppia. Se l'etichetta corrente b inizia con I-, b[2:] ne recupera il tipo, per esempio SITE. La transizione resta autorizzata soltanto se l'etichetta precedente è B-SITE o I-SITE.
Al contrario, un B- può aprire una nuova entità e O può uscire da un'entità. La funzione definisce ciò che è autorizzato, non il punteggio appreso di ogni transizione. Il CRF sfrutta poi questi vincoli durante l'addestramento e la decodifica.
Questa sfumatura è importante: il progetto non produce una sequenza illegale per correggerla a posteriori. I percorsi vietati sono esclusi dal calcolo previsto. Una sequenza valida può tuttavia essere errata: nulla impedisce a un modello di selezionare un sito sbagliato rispettando perfettamente BIO.
Imparare con tutti i percorsi, predire con il migliore
Due calcoli usano lo stesso insieme di percorsi autorizzati, ma rispondono a domande diverse.
Viterbi cerca il percorso migliore. Conserva i migliori punteggi intermedi e i predecessori corrispondenti, poi risale queste scelte alla fine. Questi ritorni all'indietro ricostruiscono la sequenza completa. Si evita così di enumerare esplicitamente tutte le combinazioni di etichette.
La normalizzazione logZ somma il peso di tutti i percorsi autorizzati. Ogni punteggio diventa un peso positivo tramite esponenziazione. Z è la loro somma e logZ il suo logaritmo. La probabilità di un percorso si scrive allora exp(score_du_chemin - logZ).
La funzione di perdita, chiamata NLL per negative log-likelihood, vale logZ - score_gold. gold designa qui la sequenza di riferimento rivelata per l'apprendimento. Ridurre questa perdita spinge il modello ad attribuire più probabilità alla sequenza corretta rispetto agli altri percorsi legali. Il tutorial BiLSTM-CRF di PyTorch approfondisce la distinzione fra normalizzazione e decodifica.
Nel nostro esempio con due token, i cinque percorsi legali hanno i punteggi 3, 4, 2, 3 e 6. Si ottiene logZ ≈ 6,2257. Se il riferimento è B-SITE → I-SITE, la sua perdita vale quindi circa 0,2257 e la sua probabilità circa 0,7979. Essere il percorso migliore non significa avere probabilità 1.
Il calcolo avviene in log-space, cioè nello spazio dei logaritmi, per limitare le difficoltà numeriche. L'operazione log-sum-exp permette di calcolare in modo stabilizzato il logaritmo di una somma di esponenziali. Non sostituisce la somma con il massimo: ciò cambierebbe il problema.
Ottenere una probabilità per token senza dimenticare il contesto
Per scegliere le note da annotare, abbiamo bisogno di marginali CRF: la probabilità di ogni etichetta in ogni posizione, tenendo conto dei percorsi completi. Il termine «marginale» significa che si raccolgono le possibilità relative alle altre posizioni per concentrarsi su questa.
Non è un semplice softmax applicato indipendentemente alle sette emissioni. Il calcolo forward-backward combina i contributi che arrivano a una posizione e quelli che ne partono. Con la convenzione del progetto, la formula è exp(alpha + beta - logZ). A ogni token reale, le sette probabilità devono sommare a 1.
Nel percorso, questo calcolo usa la precisione FP64 a partire dalle emissioni FP32, per limitare gli errori di arrotondamento. L'addestramento GPU resta in FP32: non si porta l'intera rete in doppia precisione. Il piccolo reticolo presentato per spiegare i percorsi comprende tre tag; il modello del tutorial ne usa effettivamente sette.
Incertezza: ciò che BALD approssima realmente
Ora sappiamo predire le entità. Resta da scegliere le prossime note da annotare, senza guardare le loro risposte. La strategia studiata confronta più predizioni della stessa rete con dropout attivo.
Far variare il calcolo, senza riaddestrare otto modelli
Il percorso effettua otto passaggi con dropout. I parametri appresi restano gli stessi, ma le maschere di dropout variano e producono otto distribuzioni marginali per token. Questa ripetizione è chiamata Monte Carlo dropout: più calcoli casuali servono ad approssimare una quantità che non viene calcolata esattamente.
Il dropout standard di PyTorch è attivo durante l'addestramento e disattivato in modalità valutazione. Per stimare il disaccordo, occorre quindi mantenere questa variazione durante i passaggi previsti a tale scopo. Non sono né otto nuovi addestramenti né otto team di annotatori indipendenti.
BALD indica un criterio di apprendimento attivo basato sul disaccordo. Nel suo quadro bayesiano, mira all'informazione che una risposta potrebbe apportare sui parametri del modello. L'articolo su BALD con dropout presenta un'approssimazione mediante passaggi stocastici. Qui applichiamo un calcolo di questo tipo alle marginali dei token di un CRF, non direttamente a tutte le sue sequenze possibili.
Esitare allo stesso modo non significa contraddirsi
Un'entropia misura quanto una distribuzione sia ripartita fra più possibilità. Con due probabilità 0,5 e 0,5 è più elevata che con 0,9 e 0,1. Il calcolo del progetto usa il logaritmo naturale; i valori di entropia non sono quindi percentuali.
Per un token calcoliamo: l'entropia della distribuzione media, meno la media delle entropie. La prima guarda tutte le predizioni insieme; la seconda osserva quanto esiti individualmente ogni passaggio.
Prendiamo due passaggi e due etichette, solo per poter calcolare a mano. Il progetto usa otto passaggi e sette etichette, ma la sottrazione è la stessa.
Primo caso: entrambi i passaggi rispondono [0,5 ; 0,5]. La loro media è [0,5 ; 0,5]. L'entropia della media vale circa 0,6931, come l'entropia media. Il disaccordo calcolato vale quindi 0. I passaggi esitano, ma esitano in modo identico.
Secondo caso: un passaggio risponde [0,9 ; 0,1], l'altro [0,1 ; 0,9]. La media resta [0,5 ; 0,5], quindi la sua entropia resta 0,6931. Tuttavia ogni passaggio è più netto: la sua entropia vale circa 0,3251. La differenza raggiunge circa 0,3681.
La distribuzione media è identica nei due casi, ma non il disaccordo. Ecco cosa questa sottrazione permette di distinguere. Al contrario, più passaggi possono essere molto sicuri della stessa risposta sbagliata: un punteggio basso non garantisce un'annotazione corretta.
Dal disaccordo di un token alla priorità di una nota
Il programma somma i contributi dei token reali sulle finestre di una nota, poi divide per il suo costo: 5 + numero di token. Il padding, o riempimento aggiunto per raggruppare sequenze di lunghezze diverse, è escluso da una maschera. Questo riempimento facilita il calcolo a lotti; non deve creare informazione fittizia.
Il punteggio è quindi un'approssimazione marginale per token di tipo BALD, rapportata al costo. I token sono legati dal CRF; sommare i loro contributi non calcola l'informazione mutua condizionale esatta dell'intera sequenza e può contare segnali dipendenti. Il risultato non è né una probabilità di errore né una misura del beneficio umano di un'annotazione.
Ecco la funzione sorgente. probabilities ha forma M × T × K: numero di passaggi, numero di posizioni, numero di etichette. Nel percorso, M = 8 e K = 7.
import math
import torch


def marginal_bald_score(probabilities, mask, cost):
    # M x T x K; sum token-wise proxy, not joint-sequence mutual information.
    if (
        probabilities.ndim != 3
        or probabilities.shape[1] != len(mask)
        or probabilities.shape[0] < 2
        or cost <= 0
        or not torch.isfinite(probabilities).all()
        or (probabilities < 0).any()
    ):
        raise ValueError("Invalid dropout marginals/cost")
    if not torch.allclose(
        probabilities[:, mask].sum(-1),
        torch.ones_like(probabilities[:, mask, 0]),
        atol=1e-5,
    ):
        raise ValueError("Real-token marginals must normalize")
    entropy = lambda p: -(
        torch.where(p > 0, p * torch.log(p.clamp_min(1e-30)), torch.zeros_like(p))
    ).sum(-1)
    values = entropy(probabilities.mean(0)) - entropy(probabilities).mean(0)
    if values[mask].min() < -1e-5:
        raise ValueError("Negative information proxy beyond rounding tolerance")
    return float(values[mask].clamp_min(0).sum() / cost), values.masked_fill(~mask, 0)
Il primo blocco verifica in particolare le tre dimensioni, la corrispondenza fra il numero di posizioni e la lunghezza della maschera, la presenza di almeno due passaggi, i valori non finiti o negativi e un costo minore o uguale a zero. Il blocco seguente controlla che ogni distribuzione di token reale sommi a 1. Non basta avere una tabella di numeri positivi per avere probabilità coerenti.
La piccola funzione entropy effettua la somma sull'ultima dimensione, quella delle etichette. Il trattamento degli zeri evita che contribuiscano con un log(0); clamp_min(1e-30) protegge l'argomento del logaritmo. Poi probabilities.mean(0) fa la media dei passaggi prima di calcolare un'entropia, mentre entropy(probabilities).mean(0) fa la media delle entropie già calcolate.
In aritmetica esatta, questa differenza non è negativa per distribuzioni valide. La soglia -1e-5 tollera piccolissimi scarti di arrotondamento; un valore più negativo provoca un errore. clamp_min(0) rimuove questi piccoli residui negativi dal punteggio sommato.
La funzione restituisce due oggetti: un punteggio scalare diviso per il costo e un vettore di contributi le cui posizioni di padding sono impostate a zero. Il secondo oggetto conserva i valori prima del clamp_min(0) del punteggio; vi possono quindi ancora comparire piccolissimi residui negativi.
L'estratto presuppone una maschera booleana contenente almeno un token reale e un costo scalare finito. Non verifica da solo tutti questi prerequisiti e non ricalcola il costo dal testo. Il controllo di coerenza del costo da parte del protocollo e dell'oracolo resta un passaggio distinto. Modificare silenziosamente una distribuzione o un costo per evitare un rifiuto cambierebbe l'esperimento.
Spendere un budget, non riempire una quota di documenti
Con la nostra regola, una nota di venti token costa 25 unità. Non sono venticinque secondi. Il 5 rappresenta una componente fissa del costo simulato e il numero di token la sua componente variabile.
Altro esempio didattico: una nota la cui somma dei contributi vale 0,6 e il costo 100 riceve una priorità di 0,006. Un'altra, con una somma di 0,4 e un costo di 40, riceve 0,01. La seconda passa davanti, nonostante un contributo grezzo più basso, perché la classifica avviene per unità di costo.
Il riferimento, o baseline, è una selezione casuale con priorità deterministica e senza reinserimento: una volta selezionata, una nota non torna nella riserva da annotare. «Deterministica» significa qui che lo stesso percorso può ritrovare l'ordine previsto, non che questo ordine sfrutti l'incertezza del modello.
Casuale e BALD condividono le 60 note iniziali, i limiti, l'architettura e il test. Ogni ciclo aggiunge al massimo 4 000 unità. Una nota che non rientra nel budget residuo viene saltata, poi la coda prosegue. Con 30 unità rimanenti, una nota che costa 35 può quindi essere esclusa mentre una successiva da 20 entra ancora nel ciclo: questo esempio illustra la regola, senza aggiungere una misura al percorso.
Si ottiene una classifica con controllo del budget, non la prova che l'insieme scelto sia ottimale. Due strategie possono terminare lo stesso numero di cicli con spese diverse. Confronteremo quindi F1 con il costo cumulato realmente consumato, non solo con il numero del ciclo.
Eseguire i 21 comandi attestati
Preparare l'ambiente e verificare i calcoli
Dovete poter leggere Python e usare un terminale con Docker. Le nozioni utili sono tensori, probabilità, sequenze e gradienti. Gli esempi precedenti offrono punti di riferimento per la lettura; i blocchi di codice si inseriscono nel progetto completo, non in uno script isolato da ricostruire.
Il profilo di riferimento usa Linux e una RTX 3090 da 24 GiB, con 16 GiB di RAM e 10 GiB di spazio di lavoro su disco, ai quali si aggiunge lo spazio Docker. Sono raccomandazioni di preparazione, non minimi misurati su tutte le configurazioni. La RAM è la memoria della macchina; i 24 GiB della scheda sono la sua memoria video.
L'integrazione tra Docker e la GPU NVIDIA deve essere operativa. La documentazione NVIDIA Container Toolkit descrive questa integrazione. Una GPU visibile sull'host non basta: check_environment.py esegue un forward e un backward del BiLSTM-CRF nel contenitore. Il forward produce i punteggi a partire dagli input; il backward calcola i gradienti necessari all'apprendimento.
Estraete lo ZIP in una nuova directory e posizionate il terminale alla sua radice. Tutti i comandi seguenti partono da questa cartella. Eseguiremo in sequenza i 15 comandi del percorso principale, quello dell'esercizio e i cinque comandi finali, ossia i 21 comandi del percorso fornito.
sh scripts/preflight.sh
sh scripts/setup.sh
docker compose config --quiet
docker compose build acquisition tutorial learning inference initialization oracle
docker compose run --rm --no-deps acquisition python scripts/acquire.py --config configs/minimum.yaml
docker compose run --rm --no-deps tutorial python scripts/check_environment.py
docker compose run --rm --no-deps tutorial python -m pytest -q
Il preflight controlla l'ambiente; il setup prepara il progetto; Compose verifica la configurazione e poi costruisce i servizi. L'acquisizione controlla un registro vuoto: non è richiesto alcun modello preaddestrato. Questo passaggio non deve quindi scaricare un LLM o embedding esterni.
Il controllo dell'ambiente verifica poi il calcolo in Docker, quindi pytest esegue i test del progetto. Un codice di uscita nullo segnala il successo di ogni comando. I test del programma non sostituiscono la misura della qualità delle entità, che arriva più avanti.
Creare il corpus e rivelare le prime annotazioni
I servizi non svolgono tutti lo stesso ruolo. initialization avvia le operazioni di inizializzazione; oracle rivela le annotazioni autorizzate; i ruoli di apprendimento e inferenza restano separati. I montaggi del file Compose concretizzano gli accessi previsti. I calcoli sono isolati dalla rete e l'oracolo non riserva una GPU.
docker compose run --rm --no-deps tutorial python -m ged_annotation_active_entites.cli prepare --config configs/minimum.yaml
docker compose run --rm --no-deps initialization python -m ged_annotation_active_entites.cli request-initial --config configs/minimum.yaml
docker compose run --rm --no-deps oracle python -m ged_annotation_active_entites.cli reveal --config configs/minimum.yaml
docker compose run --rm --no-deps initialization python -m ged_annotation_active_entites.cli baseline --config configs/minimum.yaml
docker compose run --rm --no-deps initialization python -m ged_annotation_active_entites.cli predict --config configs/minimum.yaml --cycle 0
prepare costruisce il corpus e le sue partizioni. Verificate i conteggi 1 260 / 270 / 270 e la separazione delle famiglie prima di interpretare una metrica.
request-initial richiede le 60 note iniziali, poi reveal fornisce i loro span. Le due operazioni restano distinte: la richiesta esiste prima che le annotazioni vengano restituite. Il comando baseline costruisce il punto di partenza e predict --cycle 0 produce le predizioni di questo ciclo iniziale.
Il ciclo 0 non è il modello non addestrato. È il punto di confronto ottenuto dopo l'apprendimento sulle annotazioni iniziali, prima dei quattro cicli aggiuntivi di annotazione. Confondere questi due stati cambierebbe completamente l'interpretazione del risultato.
Ispezionare il meccanismo prima di moltiplicare i cicli
docker compose run --rm --no-deps tutorial python -m ged_annotation_active_entites.cli inspect-mechanism --config configs/minimum.yaml
Questo passaggio serve a collegare i calcoli alle loro rappresentazioni. In una sequenza, distinguete il percorso BIO scelto dalle distribuzioni marginali. Verificate che ogni token reale abbia una distribuzione di massa totale 1 e che le posizioni di riempimento non contribuiscano al punteggio di selezione.
Il reticolo semplificato a tre tag aiuta a leggere il meccanismo; non descrive una riduzione del modello reale a tre etichette. Allo stesso modo, i piccoli esempi numerici di questo articolo sono spiegazioni, non nuovi risultati di addestramento.
Eseguire quattro cicli, poi valutare
sh scripts/run_all.sh
docker compose run --rm --no-deps tutorial python -m ged_annotation_active_entites.cli evaluate --config configs/minimum.yaml
run_all.sh concatena selezione, rivelazione e apprendimento per quattro cicli. Le annotazioni ottenute arricchiscono progressivamente l'insieme di apprendimento. Ogni strategia rispetta i propri limiti, ma non richiede necessariamente le stesse note.
A ogni ciclo, il modello riparte dagli stessi parametri non addestrati, poi apprende per otto epoche sulle annotazioni allora disponibili. Un'epoca è un passaggio sugli esempi di addestramento; un ciclo di annotazione comprende la selezione di nuove note e l'apprendimento seguente. Otto epoche non significano quindi otto nuove richieste di annotazione.
Questa scelta non è un fine-tuning continuo del modello del ciclo precedente. Le annotazioni si accumulano, ma i pesi ripartono dallo stesso stato iniziale a ogni ciclo. Ciò fissa le condizioni di confronto delle strategie; riutilizzare i pesi del ciclo precedente costituirebbe un altro esperimento.
L'ottimizzatore è AdamW, con lr=0,003, weight_decay=0,001, un batch di 16 e un clipping a 1. Un batch è un lotto di esempi trattato durante l'apprendimento. I gradienti descrivono come la perdita varia con i parametri; l'ottimizzatore li usa per regolarli. Il tasso lr regola l'ampiezza di questi aggiornamenti, mentre il weight decay applica una regolarizzazione dei pesi. La documentazione AdamW precisa questo meccanismo.
Il clipping limita l'ampiezza dei gradienti secondo la regola del progetto. Non limita né il punteggio F1 né il numero di note selezionate. Per comprendere il principio di una limitazione della norma, la documentazione clip_grad_norm_ offre un approfondimento.
Riprendere un'interruzione non significa ricominciare un ciclo
Il percorso verifica anche un'interruzione dopo l'epoca 4 del ciclo 2. Questa volta bisogna riprendere l'apprendimento già avviato, non tornare ai parametri iniziali del ciclo.
Il checkpoint, o punto di salvataggio, deve ripristinare il modello, l'ottimizzatore, il sampler che organizza il campionamento, gli RNG o generatori pseudo-casuali, il pool, la richiesta e le annotazioni. Ripristinare solo i pesi non basta: una coda diversa o nuovi sorteggi di dropout possono modificare il seguito.
Il controllo richiede che le selezioni e le predizioni future restino identiche a quelle del percorso senza interruzione. È più esigente che ottenere lo stesso F1 finale: due modelli possono avere lo stesso punteggio senza aver seguito lo stesso esperimento.
Questa verifica riguarda l'ambiente riprodotto. La documentazione PyTorch sulla riproducibilità ricorda che un seme identico non garantisce risultati identici dopo un cambio di versione o piattaforma.
Leggere F1 e costo con un esempio
Un confine quasi giusto resta un errore di estrazione
La misura riguarda span esatti: i limiti dei caratteri e il tipo devono corrispondere al riferimento. Non si limita a verificare che alcune parole si sovrappongano.
Se il riferimento attende AX-14, ma il modello predice soltanto AX, manca l'entità esatta attesa: è un falso negativo. Ha anche emesso un'entità che non corrisponde al riferimento: è un falso positivo. I due conteggi non rappresentano due note errate; descrivono i due lati della stessa estrazione scorretta.
La precisione misura la proporzione di span predetti che sono corretti. Il recall misura la proporzione degli span attesi che sono stati ritrovati. L'F1 combina i due con una media armonica, affinché una buona precisione non mascheri un recall scarso, o viceversa.
Riprendiamo l'esempio del percorso: 8 span corretti, 2 predizioni in eccesso e 2 span dimenticati. La precisione vale 8 / (8 + 2) = 0,8, anche il recall vale 0,8, e l'F1 vale 2 × precisione × recall / (precisione + recall) = 0,8.
Il rapporto conserva i tipi di entità, i loro supporti, cioè le loro numerosità di riferimento, e diagnosi di confine. Questi dettagli aiutano a comprendere un errore; non trasformano una corrispondenza parziale in successo per l'F1 esatto.
Mettere il budget, non il ciclo, sull'asse orizzontale
La curva pone F1 in ordinata, sull'asse verticale, e le unità di annotazione realmente consumate in ascissa, sull'asse orizzontale. Il numero del ciclo non basta: due code possono aver richiesto note di lunghezze diverse e sostenuto costi diversi.
Per esempio, confrontare un metodo dopo 3 000 unità e un altro dopo 4 000 unità non misura direttamente la loro qualità a budget uguale. Occorrerebbe disporre dei punti corrispondenti. Il percorso non fabbrica un guadagno interpolando fra budget diversi.
Infine, viene eseguito un solo seed. Non c'è né una media su tre seed né una banda d'incertezza attorno alle curve. Ritrovare esattamente un percorso ne controlla la riproducibilità; non misura la variabilità che si osserverebbe con altri sorteggi iniziali.
Risultati del percorso principale
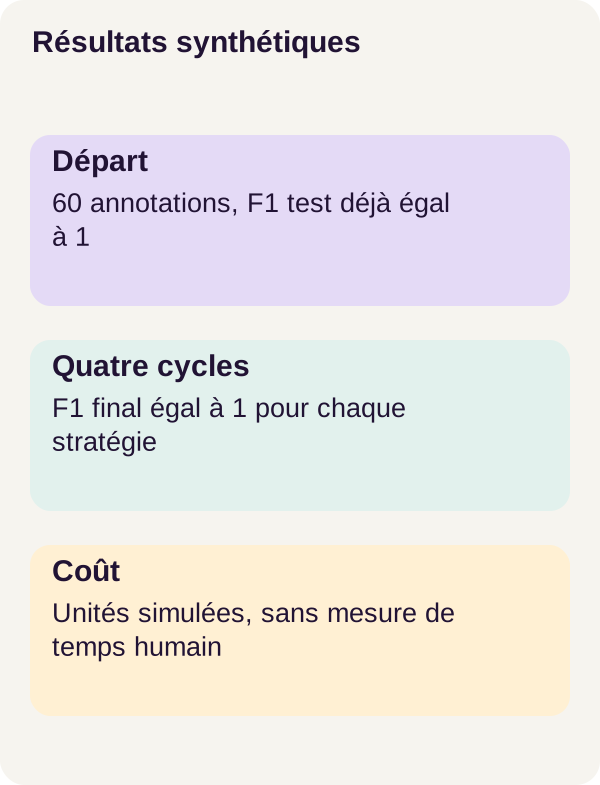
Sui 270 documenti di test, l'F1 esatto vale già 1 dopo le 60 annotazioni iniziali. Rimane a 1 dopo i quattro cicli aggiuntivi, per le due strategie principali: casuale e BALD.
I costi finali pubblicati sono 18 661 unità per il casuale e 18 620 per BALD. Lo scarto di 41 unità deriva dall'ordine di selezione e dal costo delle note. Non corrisponde a minuti di lavoro risparmiati.
Che cosa possiamo concludere? Il modello supera già il test al punto di partenza di questo confronto. Aggiungere annotazioni non può far salire un F1 già uguale a 1. Il corpus e il punto di partenza non permettono quindi più di distinguere le strategie con questa misura.
Questo risultato non dimostra né un guadagno di BALD né la sua inutilità generale. Non prova nemmeno che 60 annotazioni siano il minimo necessario: non abbiamo misurato tutti i budget inferiori. Il successo riguarda queste note sintetiche e questo test, non i documenti di una GED reale.
Il ciclo conserva tuttavia il proprio interesse didattico: richieste autorizzate, costo controllato, selezioni distinte, apprendimento e ripresa sono osservabili. Si impara a verificare il meccanismo senza trasformare un punteggio al massimo in una dimostrazione di redditività.
Ipotesi, poi esercizio di ridondanza
Predire prima di avviare lo scenario
Immaginate che le prime note classificate da BALD/costo abbiano numerose riformulazioni molto vicine. Il modello può assegnare loro punteggi elevati senza che ciascuna apporti tanta novità quanto una nota realmente diversa.
Prima di avviare l'esercizio, scrivete la vostra ipotesi: due copie vicine di ciascuna delle dieci note inizialmente meglio classificate concentreranno la selezione su informazioni ripetute? Un filtro di diversità può evitarlo, e che cosa rischia di escludere? Distinguete la vostra previsione sul costo da quella sull'F1: non sono obbligate a evolvere insieme.
Il filtro fornito usa una similarità di Jaccard con soglia 0,85. Per comprendere la formula, prendiamo due insiemi di elementi: la loro similarità è il numero di elementi comuni diviso per il numero di elementi presenti in almeno uno dei due insiemi. L'identità dà 1; l'assenza di elementi comuni dà 0.
In un esempio matematico, 9 elementi comuni su un'unione di 10 danno 0,9, sopra 0,85. Otto elementi comuni su un'unione di dieci danno 0,8, sotto. Questi piccoli insiemi illustrano la soglia; non sostituiscono la rappresentazione e la regola di confronto del codice dell'esercizio. La documentazione SciPy su Jaccard descrive la sua versione come distanza, uguale a 1 - similarità: non confondete i due sensi del punteggio.
Una forte somiglianza non è necessariamente una ridondanza senza interesse. Due frasi possono assomigliarsi quasi interamente mentre un riferimento o una scadenza importante è cambiata. Il filtro limita una forma di prossimità; non sa, per principio, quali annotazioni saranno più utili.
Eseguire, poi confrontare con la propria ipotesi
sh scripts/run_exercise.sh
Lo scenario crea due copie vicine per nota interessata, poi rilancia quattro cicli per BALD da solo e quattro cicli per BALD con filtro. Il test, il vocabolario e le 60 annotazioni iniziali restano fissi. Nessun guadagno di F1 né risparmio viene imposto all'esperimento.
La correzione consiste nel confrontare costo, tipi coperti e F1, senza modificare il test dopo aver osservato i risultati. I tipi coperti permettono in particolare di verificare che una selezione non concentri tutta la propria attenzione su una sola categoria di entità.
Nel risultato fornito, l'F1 finale resta a 1 nelle due varianti. I costi sono 18 645 unità con i duplicati e 18 617 con il filtro di diversità, cioè uno scarto di 28 unità. Questi valori appartengono all'esercizio; non sostituiscono i costi del percorso principale.
Il filtro modifica la selezione e la sua spesa simulata, ma la misura al massimo non mostra un miglioramento della qualità. Non si può quindi annunciare che la diversità sia universalmente utile, né convertire questo scarto in tempo di annotazione guadagnato.
Produrre le figure e pulire
Dopo aver confrontato l'esercizio con la vostra ipotesi, producete le figure e controllate i checkpoint. Conservate gli output utili dopo i primi due comandi e prima della pulizia, perché clean.py --outputs-only cancellerà i risultati.
docker compose run --rm --no-deps tutorial python lesson/figures/plot.py
docker compose run --rm --no-deps tutorial python scripts/check_checkpoints.py
docker compose down
docker compose run --rm --no-deps tutorial python scripts/clean.py --outputs-only
docker compose down
plot.py genera le figure dagli output. check_checkpoints.py controlla i file di salvataggio. I comandi docker compose down delimitano poi la pulizia del progetto.
Lo script di pulizia mostra e cancella solo outputs. Non elimina né il corpus, né i checkpoint, né i file di altri progetti Docker. Per questo bisogna anche conservare un checkpoint divergente per ispezionarlo, invece di eliminarlo prima di comprendere lo scarto.
Risoluzione dei problemi, pulizia e limiti del prodotto
Ritrovare la causa di uno scarto
Docker non vede la GPU. Seguite la diagnosi del preflight e ricominciate in una nuova cartella estratta. Distinguete la visibilità della scheda in Linux dal successo del calcolo nel contenitore; check_environment.py verifica questo secondo passaggio.
Una distribuzione marginale viene rifiutata. Esaminate le dimensioni, i valori non finiti o negativi, la normalizzazione sui token reali e la maschera. Un costo positivo non basta nemmeno a stabilire che corrisponda alla nota richiesta: l'oracolo controlla separatamente questa coerenza. Non sostituite le probabilità con numeri arbitrari per ottenere un punteggio.
Un'annotazione attraversa una finestra. Il corpus non rispetta più il contratto di segmentazione del percorso. Spostare il confine consultando le etichette nascoste aggirerebbe proprio la regola studiata. Per un nuovo corpus occorre definire e valutare una strategia di segmentazione adatta, anziché mascherare questo errore.
La ripresa diverge. Conservate i checkpoint e ispezionate il modello, l'ottimizzatore, l'ordine di campionamento, gli stati casuali e la coda di annotazione. Output finali diversi possono derivare da uno stato ripristinato in modo incompleto, non soltanto da un modello sbagliato. La pulizia mirata resta quella della sezione precedente.
Ciò che manca a un vero team di annotazione
Il tutorial sostituisce l'essere umano con un oracolo perfetto. Un'applicazione reale deve invece definire le entità con i team di business, formare gli annotatori e misurarne tempi, costi, errori e abbandoni. Un riferimento ambiguo, una scadenza imprecisa o un disaccordo fra due persone non si riducono al numero di token.
Il team deve disporre del consenso e dei diritti di accesso richiesti per i documenti utilizzati. Deve conservare il testo, i suoi offset e le sue revisioni, prevedere nuovi tipi di entità e gestire gli errori dell'oracolo reale, sia esso una persona o un processo di validazione.
Il livello di prodotto richiede anche autenticazione, API, registri, supervisione, test di carico, salvataggio, ripristino e revisione umana. Questi elementi sono lavori da pianificare, non funzionalità già dimostrate da questo ciclo di apprendimento.
Infine, il modello propone span da correggere; non convalida alcuno stato, persona o accesso. Individuare una data in una nota non certifica che la scadenza sia stata approvata. Il ruolo dell'interfaccia sarebbe presentare una proposta e la sua fonte, senza confonderle con una decisione aziendale.
Sintesi
Siamo partiti da una domanda pratica: quali note bisogna annotare dopo? Il BiLSTM trasforma i token in punteggi contestualizzati; il CRF organizza questi punteggi in percorsi BIO autorizzati e fornisce marginali. I passaggi con dropout permettono poi di costruire un punteggio di disaccordo, rapportato a un costo esplicito.
La selezione ha senso solo se non conosce già le risposte. La separazione fra etichette nascoste, richiesta e oracolo rende questa condizione verificabile. Il controllo del budget e la ripresa degli stati consentono di seguire esattamente ciò che è stato richiesto e appreso.
Restano tre distinzioni da mantenere: validità BIO e correttezza degli span; disaccordo del modello e probabilità di errore; costo simulato e lavoro umano. Una misura non può sostituirsi all'altra.
Su questo corpus, tutte le strategie presentate raggiungono F1 = 1. L'assenza di guadagno osservato è il risultato da ricordare, non un difetto da nascondere. Il percorso insegna a costruire ed esaminare un ciclo di annotazione attiva; non dimostra che migliori la produttività di un team.
Fonti primarie e approfondimenti
I dati, i parametri, i comandi e i risultati presentati sono quelli del progetto r001 collegato all'inizio dell'articolo. Le frasi, i piccoli reticoli e i calcoli aggiunti per la spiegazione sono esempi didattici, distinti dalle misure di questo percorso.
I riferimenti principali sono il tutorial BiLSTM-CRF di PyTorch, la documentazione torch.nn.LSTM 2.8 e l'articolo BALD con dropout. I collegamenti complementari inseriti nel testo trattano embedding, dropout, calcoli numerici, ottimizzazione, riproducibilità, Jaccard e accesso alla GPU.
Queste documentazioni chiariscono i meccanismi; non sostituiscono i file e le dipendenze dello ZIP per riprodurre la revisione r001.